
Voice AI-infrastructuur: de stack van 2026 uitgelegd
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Voice AI-infrastructuur is de verzameling modellen, verbindingen, tools en services waarmee een AI-agent naar een gesprek kan luisteren, kan bepalen wat te doen, acties kan uitvoeren in andere systemen en hardop kan antwoorden. Met toonaangevende providers zoals ElevenLabs gebeurt dit allemaal in een fractie van een seconde.
Een voice agent in productie draait op een stack van lagen, waaronder spraakherkenning, beurtwisseling, een groot taalmodel, orkestratie, tools, kennisophaling, spraaksynthese, telefonie en monitoring.
Deze gids legt de AI-agentarchitectuur achter een werkende voice agent uit. Elke sectie behandelt wat een laag doet, waarom die belangrijk is in de bredere infrastructuur en hoe ElevenAgents die implementeert, met Eleven v4 als voorbeeld voor de stemlaag.
Hoe voice AI-infrastructuur samenwerkt
Een voice agent zet audio om in tekst, redeneert op basis van die invoer, genereert een antwoord en zet dat antwoord vervolgens terug om in audio die de klant hoort. Die reeks acties bestaat uit een robuuste stack van AI-agentarchitectuur.
Dit zijn de belangrijkste lagen die in 2026 bijdragen aan voice AI-infrastructuur:
- Spraakherkenning: Automatic Speech Recognition-technologie (ASR) zet de audio van de beller om in tekst voor verwerking.
- Beurtwisseling: Beurtwisseling bepaalt wanneer de beller is uitgesproken en wanneer de agent moet stoppen met praten, voor een vloeiender en responsiever gesprek.
- Taalmodel(len): Interpreteert het getranscribeerde verzoek en genereert een antwoord, nadat de benodigde context is opgehaald.
- Orkestratie: Een AI-orkestratielaag routeert het gesprek tussen prompts, subagents, tools en mensen.
- Tools en MCP: Verbindt de agent met externe systemen, zoals CRM-platforms of contactcenters, om taken uit te voeren.
- Kennis en geheugen: Levert feiten en context over de beller via Retrieval Augmented Generation.
- Spraaksynthese: Gebruikt Text to Speech om het gegenereerde tekstantwoord om te zetten in audio.
- Transport en telefonie: Verzorgt audio tussen de agent en de beller.
- Guardrails, testen en monitoring: Houdt de agent bij zijn taak en meetbaar.
Samen zorgen deze onderdelen voor realtime gesprekken tussen AI-agents en bellende klanten.
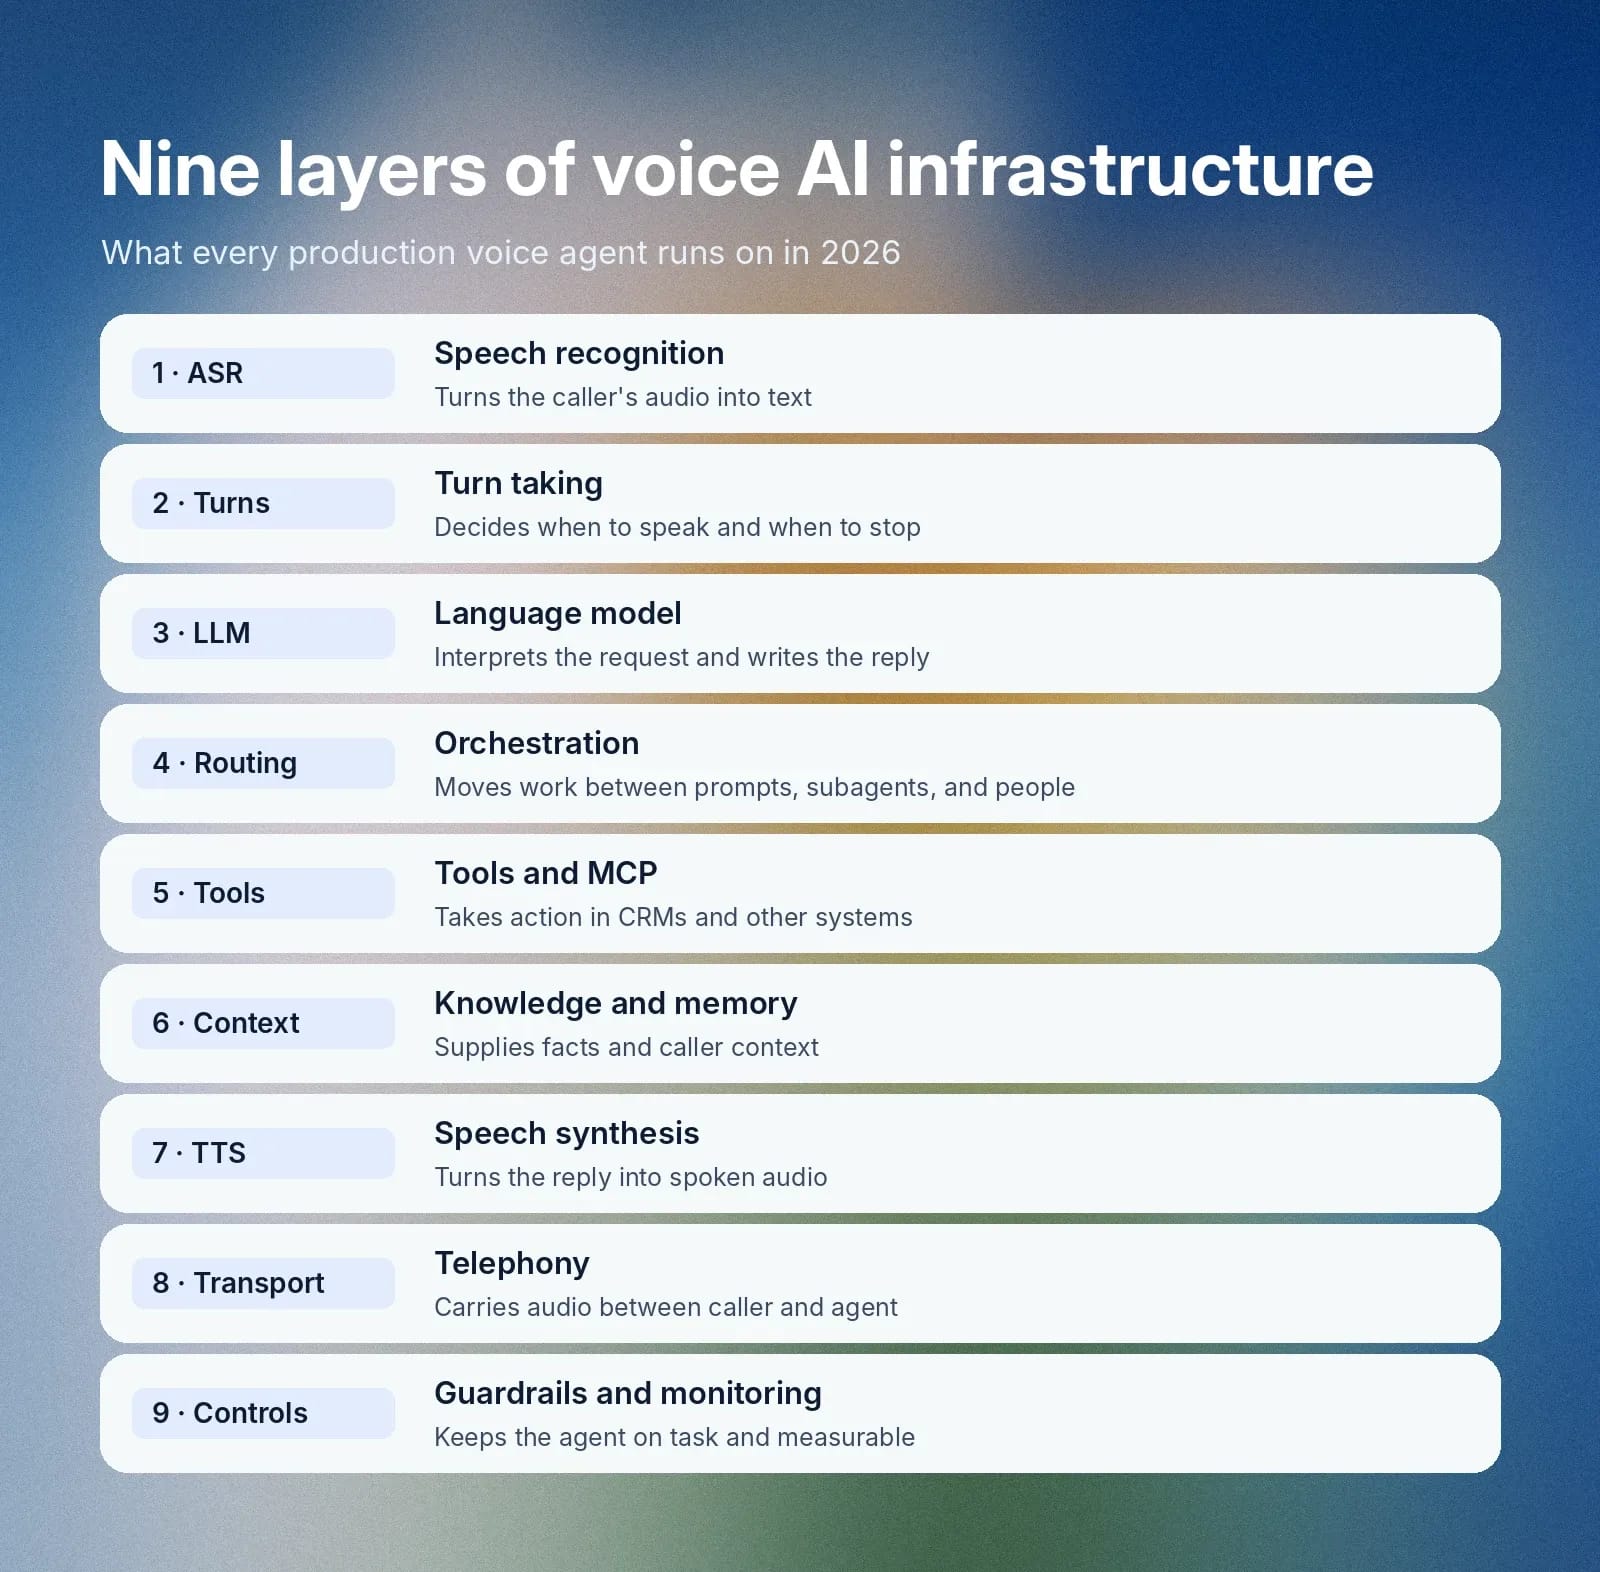
Diagram van voice AI-architectuur
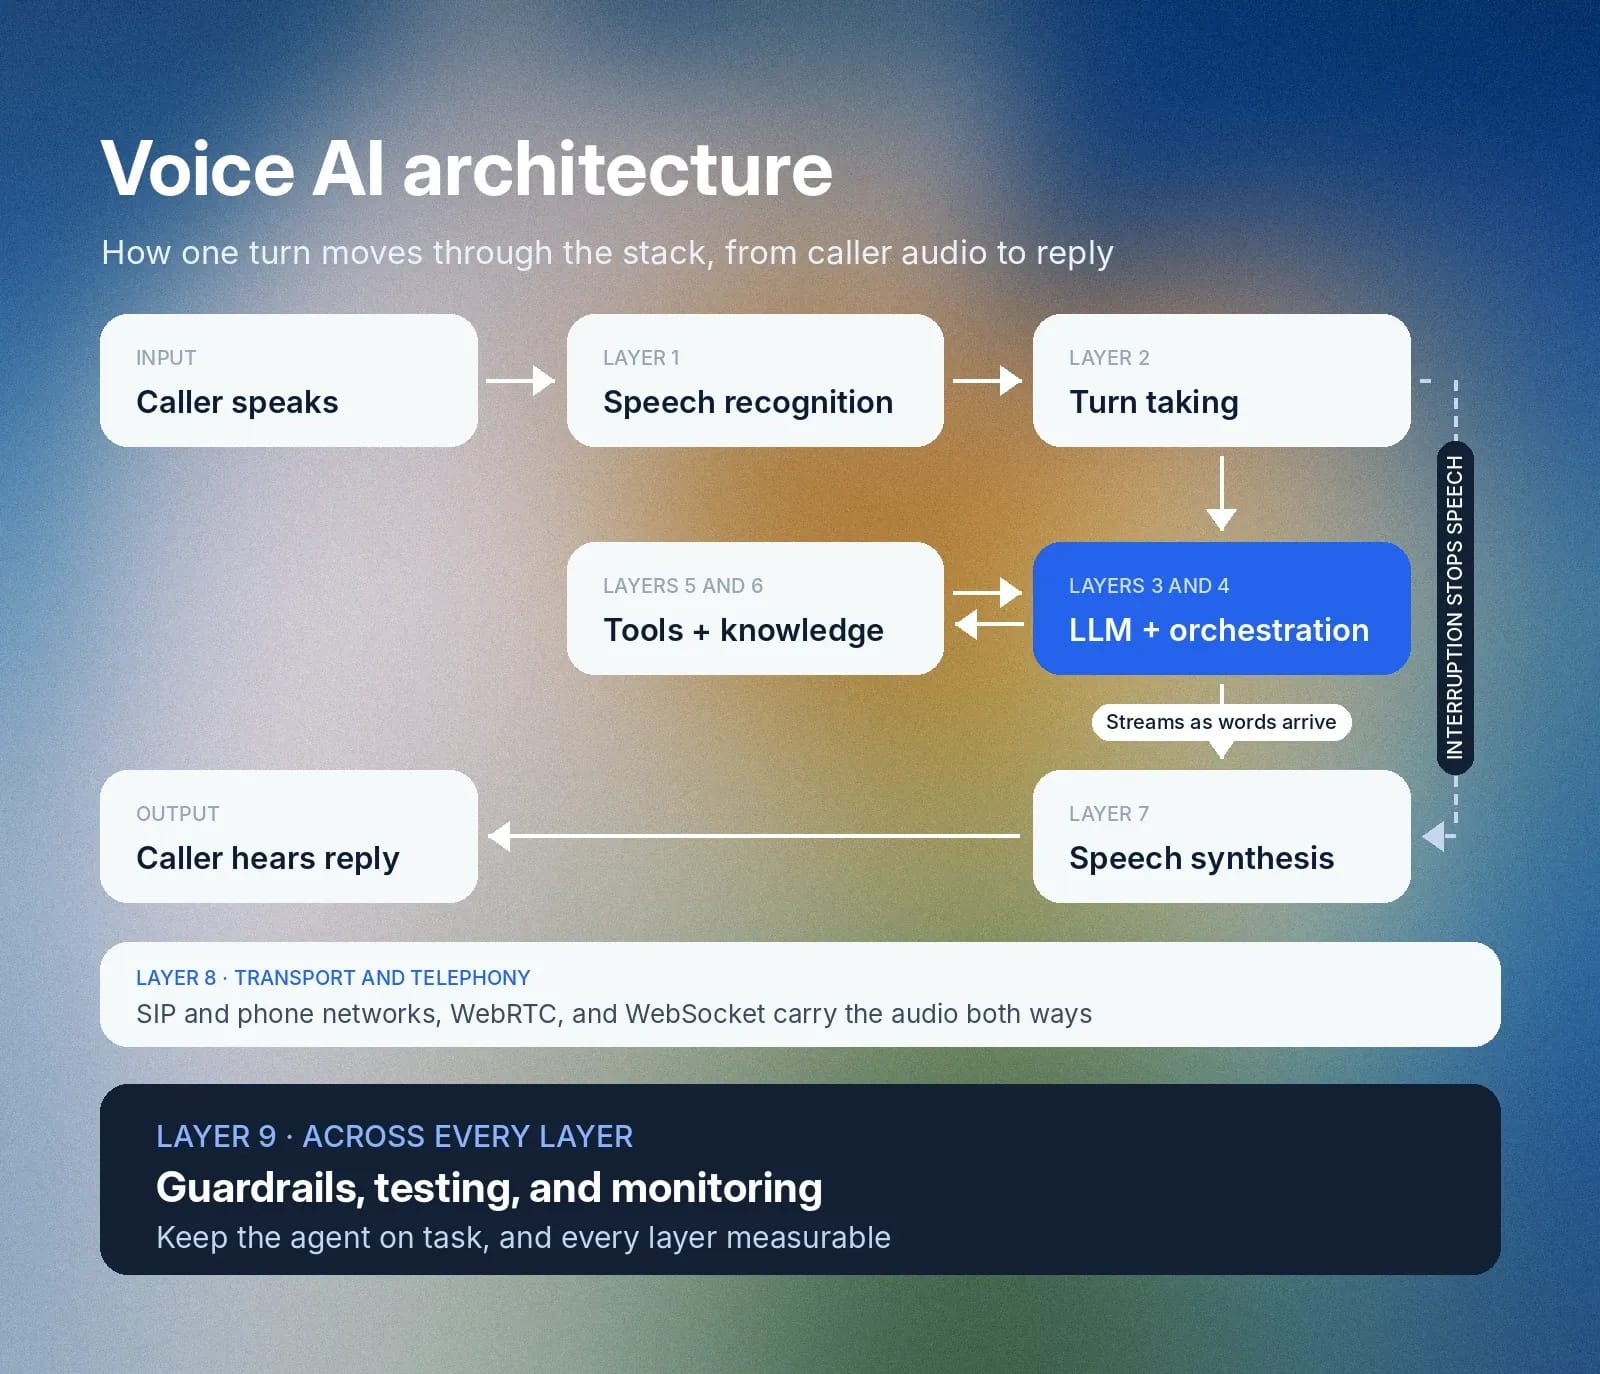
De flow is geen rechte lijn. ElevenAgents begint te spreken nadat het „genoeg woorden en een komma” van het taalmodel ontvangt. Daardoor begint audio af te spelen voordat het volledige antwoord bestaat. Tool calls en kennisophaling vinden midden in een beurt plaats. Onderbrekingen kunnen binnenkomen en worden natuurlijk afgehandeld door de agent terwijl die spraak genereert.
Twee manieren om voice AI-architectuur te bouwen
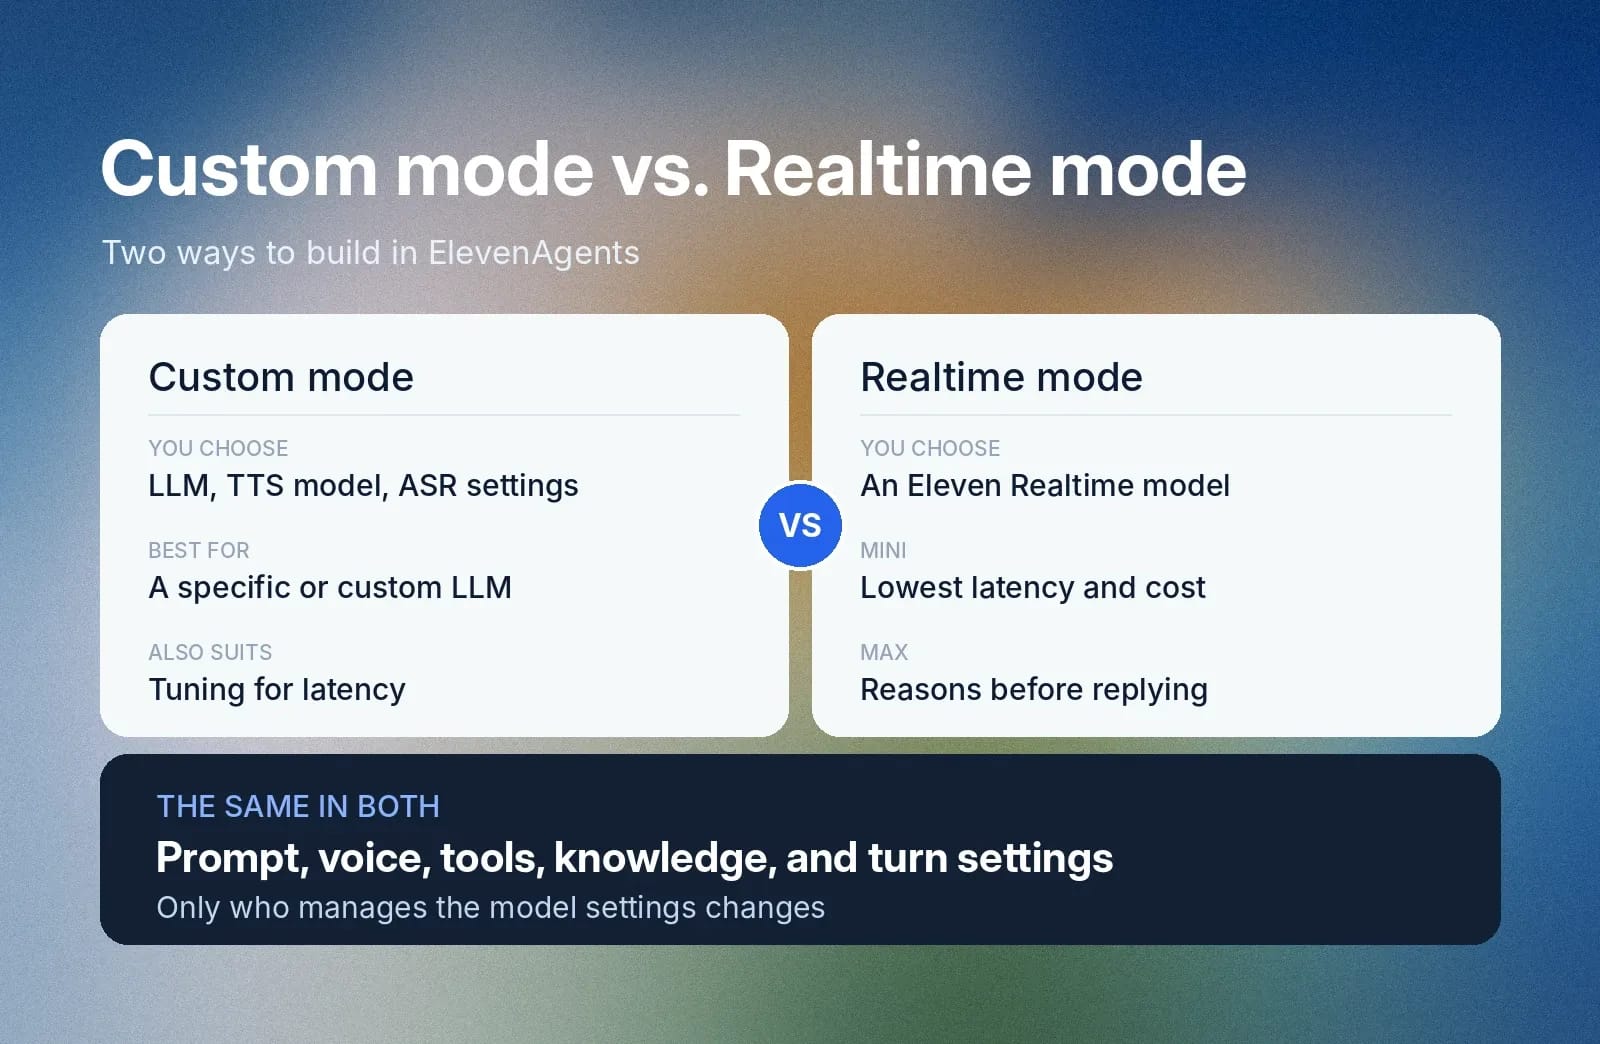
ElevenAgents ondersteunt twee stemmodi. In de Custom-modus kies je zelf het taalmodel, het Text to Speech-model en de instellingen voor spraakherkenning.
In de Realtime-modus selecteer je een Eleven Realtime-model en beheert ElevenLabs die instellingen voor je. Eleven Realtime v1 Mini is de standaard en heeft de laagste latency en kosten. Eleven Realtime v1 Max redeneert voordat het antwoordt, wat geschikt is voor complexere instructies en situaties waarin tools in meerdere stappen nodig zijn.
De systeemprompt, gekozen stem, tools, gekoppelde kennisbank en beurtinstellingen werken hetzelfde in beide modi. De Custom-modus is de beste keuze wanneer je een specifiek taalmodel, een aangepast LLM of een specifiek TTS-model nodig hebt (voor prestaties of latencyoptimalisatie.)
Spraakherkenning: audio omzetten in tekst
Spraakherkenning, ook wel ASR of speech to text genoemd, is de eerste laag van de stack.
Wat het doet
Het model transcribeert de audio van de beller continu terwijl die spreekt. Daardoor kan de rest van de pipeline al beginnen voordat de zin is afgelopen, wat latency bespaart. Geavanceerde modellen kunnen omgaan met sterke accenten, verschillende spreeksnelheden en achtergrondgeluid.
Waarom dit belangrijk is voor voice AI-infrastructuur
Transcriptie is waarschijnlijk een van de belangrijkste lagen in de stack, omdat fouten hier doorwerken in alle volgende fasen. Een boekingsreferentie verkeerd verstaan? Het verkeerde klantrecord wordt bijgewerkt. De naam van een medicijn verkeerd verstaan? Mogelijk desastreus.
In het Trust Framework for Healthcare toont ElevenLabs hoe groot de gevolgen van één verkeerd verstane lettergreep kunnen zijn: hydroxyzine versus hydralazine.
Hoe ElevenAgents dit doet
ElevenAgents gebruikt Scribe v2 Realtime, dat spraak in ongeveer 150 ms transcribeert. ElevenLabs heeft het getraind voor rumoerige achtergronden, uiteenlopende accenten en identificatiegegevens zoals namen, e-mailadressen en ID's. Op de meertalige FLEURS-benchmark voor 30 talen rapporteerde ElevenLabs het laagste woordfoutenpercentage van alle ASR-modellen met lage latency.
Je schakelt dit in onder het gedeelte Advanced van de agentconfiguratie. In dezelfde hierboven genoemde whitepaper meldt ElevenLabs dat Scribe v2 Medical bij publicatie elk model op de openbare Eka Medical ASR-benchmark overtreft met een woordfoutenpercentage van 7,0%.
Nauwkeurige (en snelle) transcriptie geeft de volgende lagen de schone invoer die ze nodig hebben, zonder significante latency toe te voegen.
Beurtwisseling: weten wanneer je moet spreken en stoppen
Beurtwisseling is de set regels die bepaalt wanneer de agent antwoordt en wanneer die luistert. Gespreksbeurten goed kunnen begrijpen en erop kunnen reageren, onderscheidt een gesprek van een verouderd IVR-telefoonmenu.
Wat het doet
Een component voor beurtwisseling biedt voice AI-infrastructuur enkele functies:
- Spraakactiviteitsdetectie (VAD): VAD classificeert binnenkomende audio tientallen keren per seconde als spraak of stilte.
- Detectie van het einde van een beurt: Beoordeelt op basis van toon, ritme en woordcontext of de beller is uitgesproken.
- Barge-in: Laat de beller onderbreken, waarna de agent stopt met praten zodat de gebruiker verder kan gaan.
- Backchannels: Korte bevestigingen zoals „ja” die de beurt niet overnemen.
Waarom dit belangrijk is
Een pauze van ongeveer 200 ms is de gebruikelijke pauze tussen sprekers in een menselijk gesprek. Een agent die te vroeg antwoordt, onderbreekt bellers, terwijl een agent die te lang wacht stiltes creëert waardoor het gesprek kapot of niet-responsief voelt.
Neem bijvoorbeeld een beller die zegt: „Ik wil vrijdagmiddag boeken, maar...” en pauzeert. Een stiltemeter antwoordt tijdens de pauze en mist de toevoeging. Een model dat de woorden en het ritme leest, wacht zodat de gebruiker kan afmaken: „Het kan niet tussen 15.00 en 17.00 uur, want dan ben ik bezet.”
De ene agent interpreteert de bedoeling van de beller verkeerd en plant de afspraak op het verkeerde moment. De andere vermijdt dankzij effectieve beurtwisseling de opgegeven periode.
Hoe ElevenAgents dit doet
ElevenAgents gebruikt een eigen model voor beurtwisseling dat toon, ritme en woordcontext analyseert in plaats van alleen op stiltemeters te vertrouwen. Wanneer een beller onderbreekt, bereikt het signaal dat de agent stopt binnen 200 ms.
ElevenLabs meet met Eleven v4 Turbo op ElevenAgents een mediaan van ~150 ms van request tot hoorbare spraak.
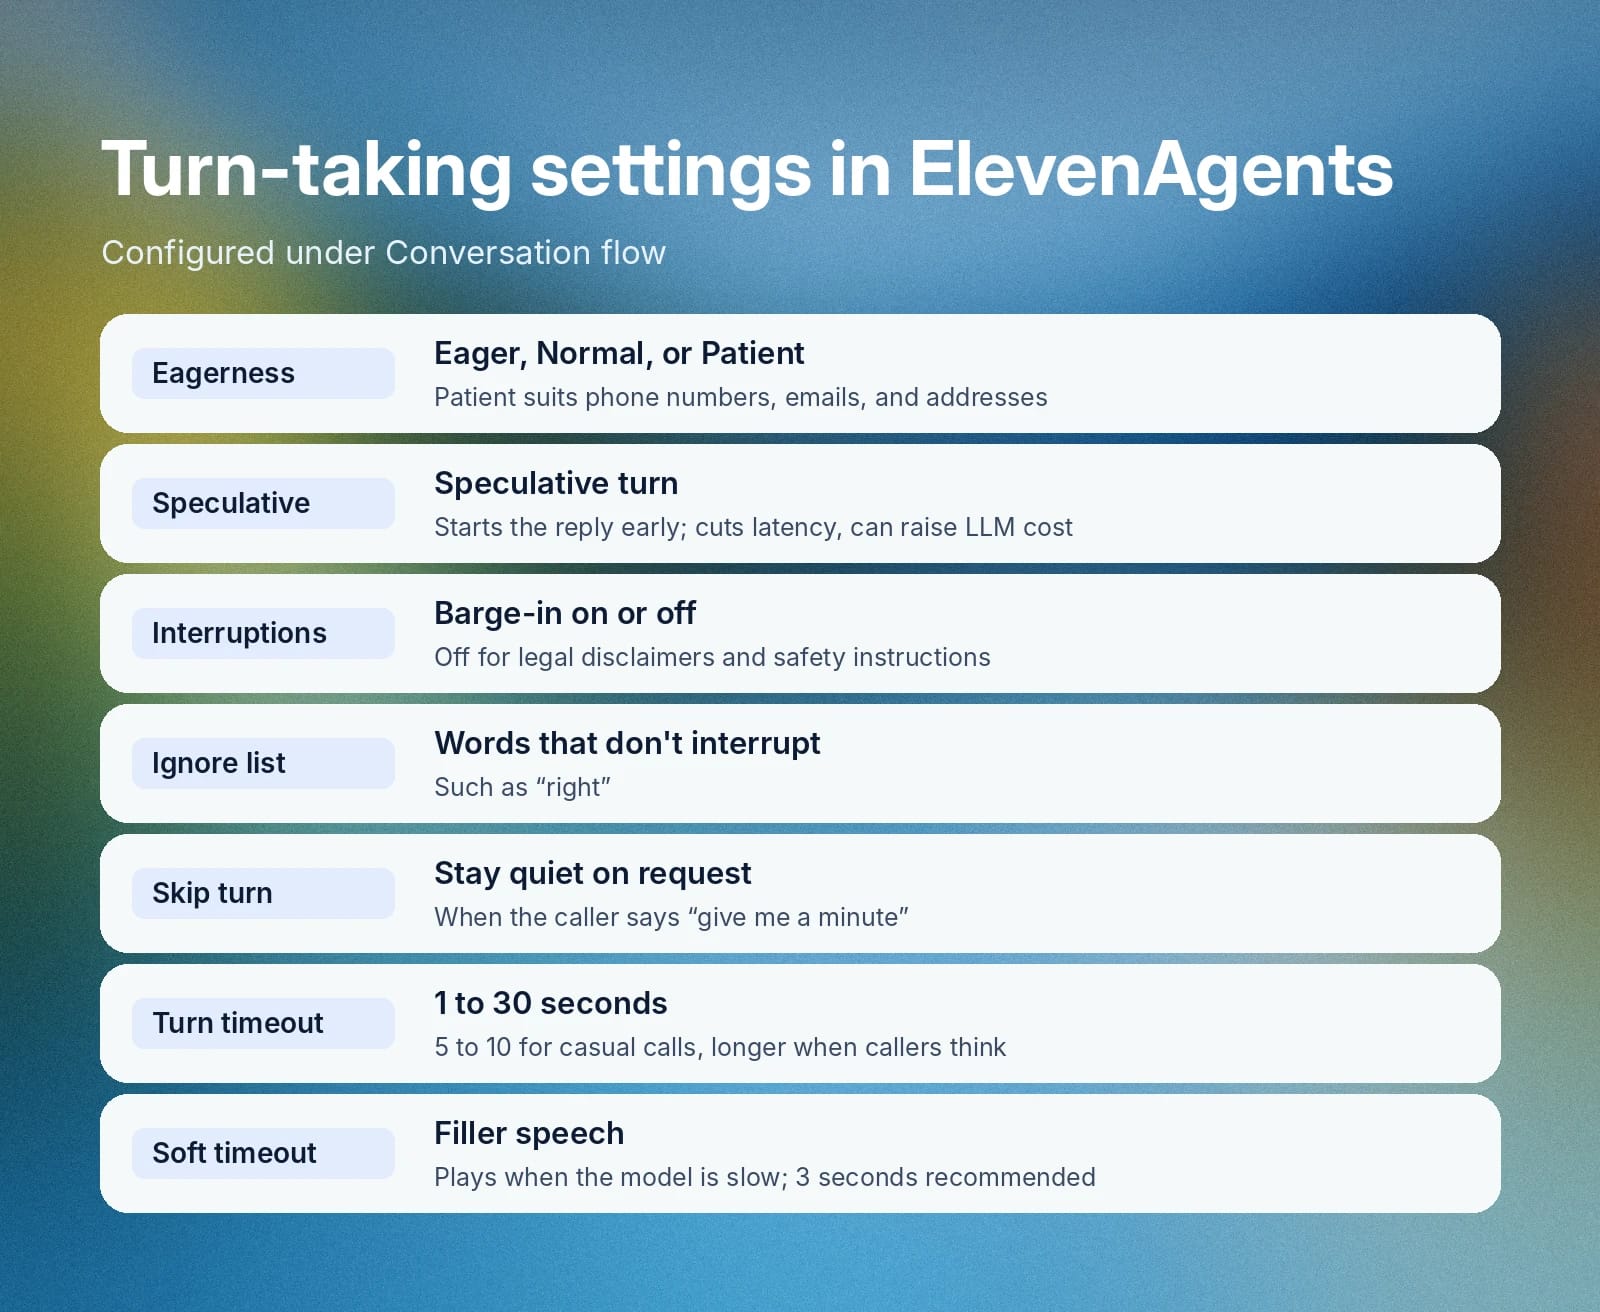
Je kunt dit gedrag configureren via Conversation flow:
Instelling
Wat het bepaalt
Gretigheid van beurtwisseling
Eager antwoordt zo snel mogelijk. Normal is de uitgebalanceerde standaard. Patient wacht langer en past bij telefoonnummers, adressen en e-mailadressen.
Speculatieve beurt
Start het antwoord van het taalmodel voordat vaststaat dat de beller is uitgesproken. Dit verlaagt latency en kan de LLM-kosten verhogen.
Onderbrekingen
Schakel ze uit wanneer elk woord gehoord moet worden, zoals bij juridische disclaimers en veiligheidsinstructies.
Negeerlijst
Woorden zoals „goed” die de agent niet mogen onderbreken.
Tool voor beurt overslaan
Houdt de agent stil wanneer de beller zegt: „geef me een minuut”.
Time-out voor beurt
Neemt een beurt na 1 tot 30 seconden stilte. Gebruik 5 tot 10 seconden voor informele gesprekken en 10 tot 30 seconden wanneer bellers tijd nodig hebben om na te denken.
Zachte time-out
Speelt opvulspraak af zoals „Hhmmmm...ja.” wanneer het model traag is. Bereik: 0,5 tot 8 seconden; 3 seconden wordt aanbevolen.
Detectie van rumoerige omgeving
Een Enterprise-instelling die stemmen op de achtergrond detecteert en de beller vraagt naar een stillere plek te gaan, maximaal één keer per gesprek.
Workflows kunnen de gretigheid van beurtwisseling tijdens een gesprek wijzigen. Je client ontvangt ook een vad_score-event: een kans van 0 tot 1 dat de gebruiker spreekt.
Goed afgestemde beurtwisseling bepaalt of bellers de agent als attent of abrupt ervaren. Lees voor meer over deze concepten onze volledige gids over beurtwisseling.
Het taalmodel: redeneren en het antwoord genereren
Het grote taalmodel (LLM) is de redeneerlaag. Het leest het transcript, de instructies en het gesprek tot nu toe, en schrijft vervolgens het antwoord of besluit een tool aan te roepen.
Wat het doet
Een gescripte voice bot herkent een handvol opdrachten. Een LLM interpreteert verzoeken die op veel verschillende manieren zijn geformuleerd, behoudt context tussen beurten en bepaalt wanneer informatie moet worden opgehaald of een overdracht nodig is.
Waarom dit belangrijk is
Modellen verschillen in redeneerdiepte, snelheid en kosten. In een live spraakgesprek telt reactietijd net zo zwaar als de kwaliteit van het antwoord. De modelkeuze is dus zowel een latency- als kostenbeslissing.
Hoe ElevenAgents dit doet
ElevenAgents biedt je één interface voor modellen van Google, OpenAI en Anthropic, plus open modellen die ElevenLabs host. Je kunt ook je eigen LLM verbinden door een endpoint op te geven en credentials als secrets op te slaan. ElevenLabs berekent kosten van LLM's van derden door tegen het gepubliceerde tarief van de provider, zonder opslag.
Je kunt het model per subagent kiezen. The Enterprise Conversational Agent Playbook, deel 2, adviseert modellen met hogere prestaties te reserveren voor complex redeneren en goedkopere modellen met lage latency te gebruiken voor taken zoals intentclassificatie en veelgestelde vragen.
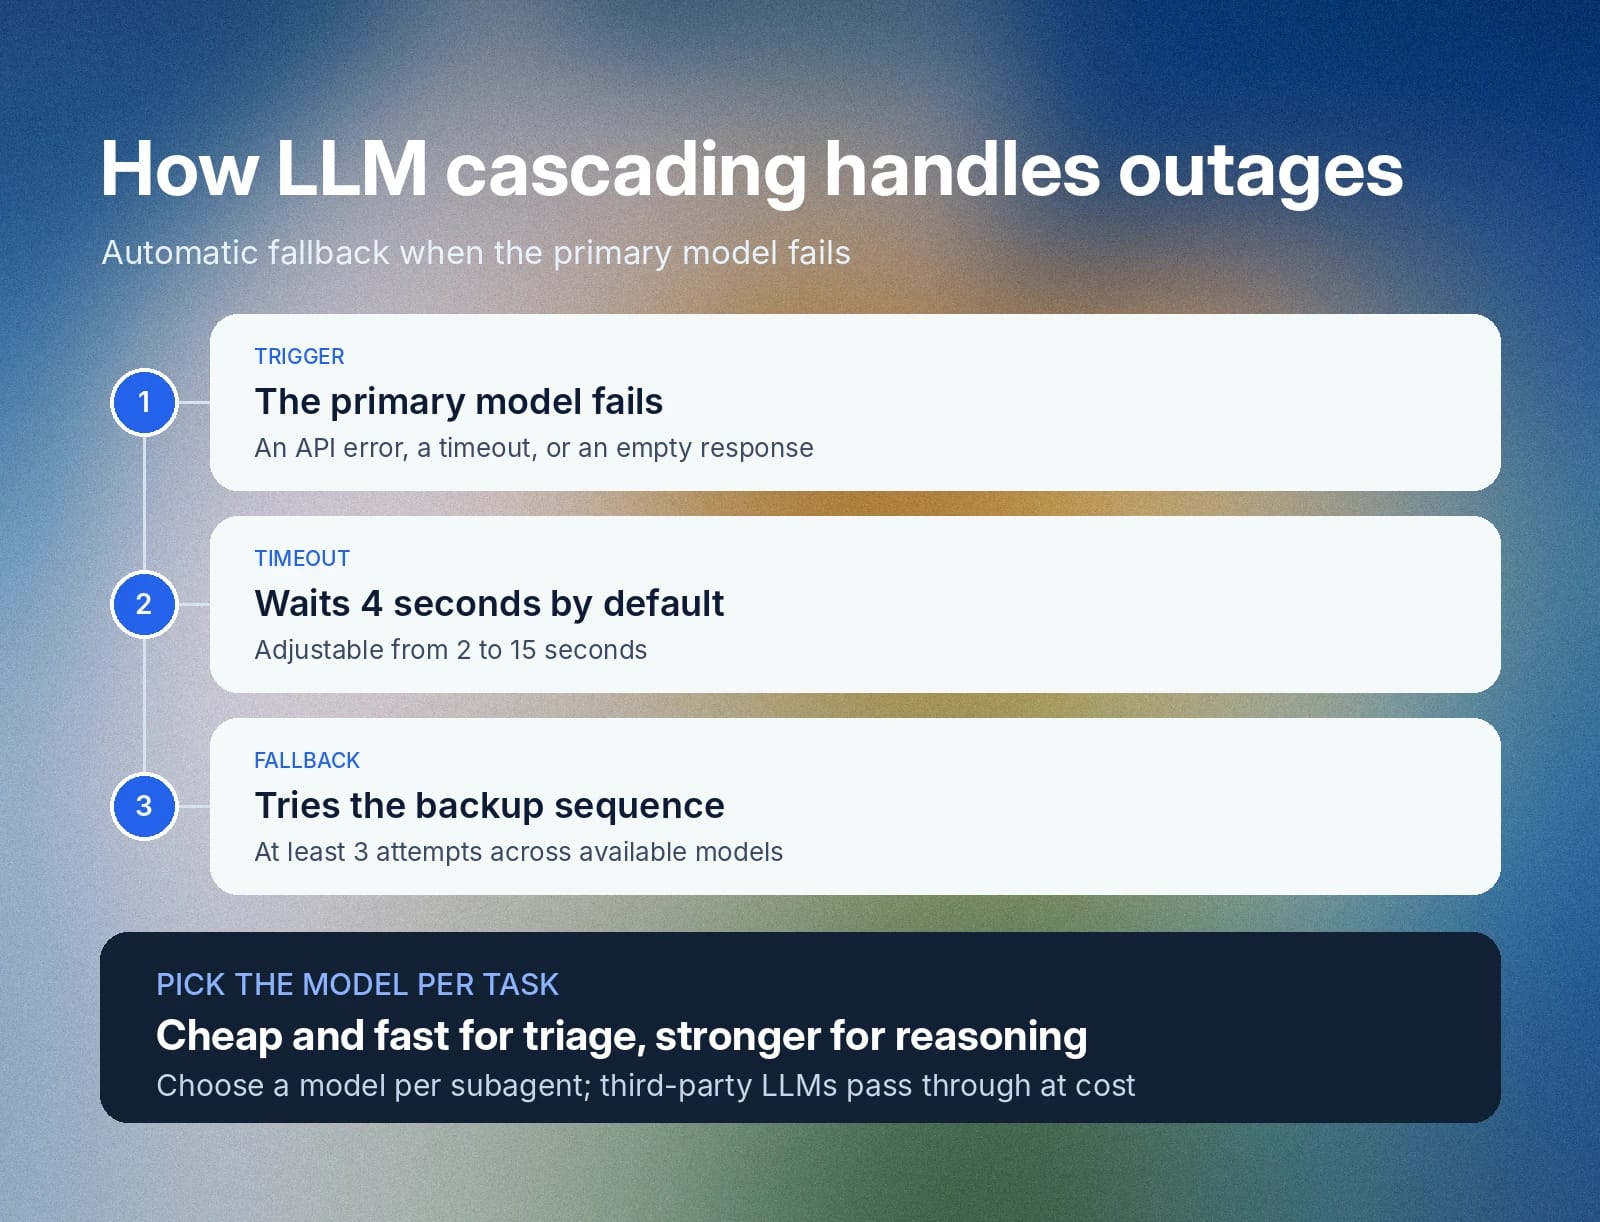
Providers kunnen storingen hebben. LLM-cascadering handelt die af: als het primaire model een API-fout retourneert, een time-out bereikt of een leeg antwoord stuurt, probeert ElevenAgents een back-upreeks. De standaardtime-out van primair naar back-up is 4 seconden, instelbaar van 2 tot 15 seconden, en het systeem doet minstens 3 pogingen over de beschikbare modellen.
Een aangepast LLM dat als primair model wordt gebruikt, probeert zichzelf minstens 3 keer opnieuw, tenzij je zelf een back-upvolgorde definieert. Het juiste model per taak houdt de agent snel én betaalbaar.
Orkestratie: werk routeren tussen agents en mensen
Agentorkestratie coördineert de prompts, subagents, tools en mensen die betrokken zijn bij het afronden van een taak. Op elk punt in het gesprek bepaalt het wat er hierna gebeurt.
Wat het doet
Eén agent met één lange prompt wordt lastig te beheren naarmate verantwoordelijkheden zich opstapelen. Orkestratie verdeelt het werk in fasen, elk met eigen instructies, model en tools, en verplaatst de beller daartussen.
Waarom dit belangrijk is
Kleinere prompts zijn makkelijker te testen en goedkoper uit te voeren, omdat elke interactie minder tekst laadt. Door een flow op te delen kan een goedkoop model triage en veelgestelde vragen afhandelen, en alleen overdragen aan een sterker model wanneer een verzoek dat vereist.
Hoe ElevenAgents dit doet
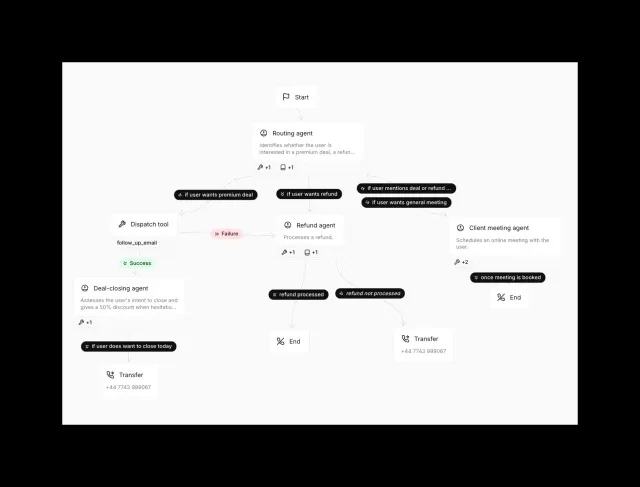
Workflows in ElevenAgents zijn een visuele builder voor vertakkende gespreksgrafen.
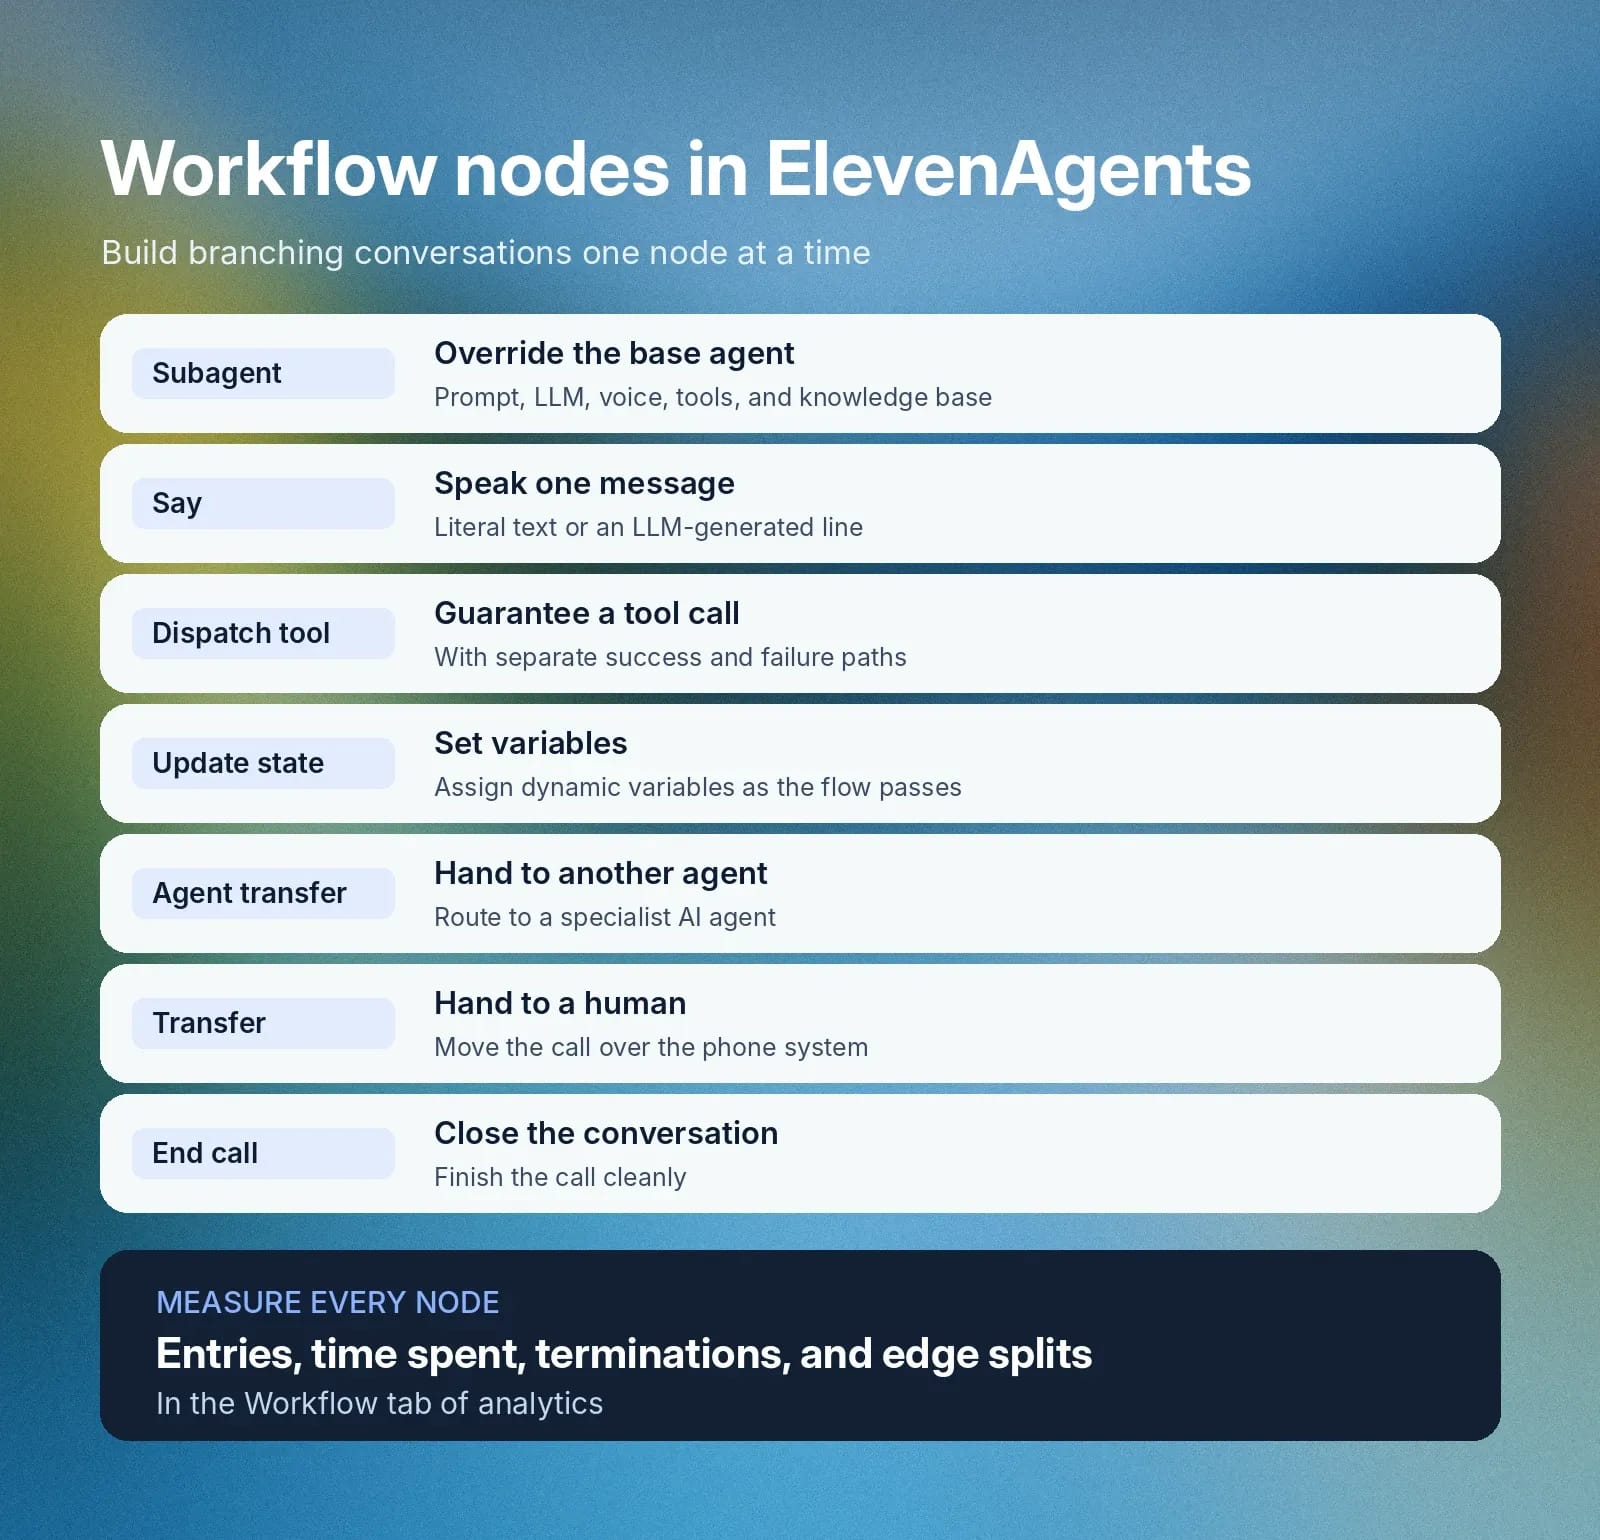
De nodes zijn:
- Subagent: Wijzigt of overschrijft de basisagent, inclusief de prompt, LLM, stem, tools en kennisbank.
- Say: Spreekt één bericht uit, als letterlijke tekst of als door een LLM gegenereerde zin.
- Dispatch tool: Een speciale stap die een tool call garandeert, met afzonderlijke paden voor succes en mislukking.
- Update state: Wijst dynamische variabelen toe terwijl de flow erdoorheen gaat.
- Agent transfer: Draagt het gesprek over aan een andere agent.
- Doorverbinden naar nummer: Verplaatst het gesprek via het telefoonsysteem van de AI-agent naar een persoon.
- End call: Beëindigt het gesprek.
Verbindingen tussen nodes bevatten voorwaarden in natuurlijke taal die het LLM realtime beoordeelt. Een supportflow kan beginnen met een routerende subagent op een snel model, factureringsvragen naar een factureringssubagent op een sterker model sturen en eindigen met een transfer-to-number-node wanneer de beller om een persoon vraagt. Na de lancering toont het tabblad Workflow in analytics per node de instroom, gemiddelde bestede tijd, beëindigingen en verdeling over verbindingen.
Orkestratie verandert één agent in een systeem dat je node voor node kunt ontwerpen, meten en verbeteren.
Tools en MCP: de agent laten handelen
Function calling, ook wel tool calling genoemd, laat een agent acties aanvragen bij externe software die je aan je tech stack hebt gekoppeld.
Het verandert een interface voor vraag en antwoord in een agentic AI-systeem dat werk kan afronden en namens jou met andere tools kan werken.
Wat het doet
Neem een beller die de afspraak van morgen naar vrijdag wil verplaatsen. De agent haalt de boeking op, controleert de beschikbaarheid op vrijdag, werkt het planningssysteem bij en bevestigt de wijziging. Elke stap is een tool call die actie onderneemt.
Waarom dit belangrijk is
Tools zijn waar gesprekken resultaten opleveren. Elke tool heeft duidelijke invoer en uitvoer nodig, en de agent moet weten of een call is geslaagd voordat die dit aan de beller vertelt.
Hoe ElevenAgents dit doet
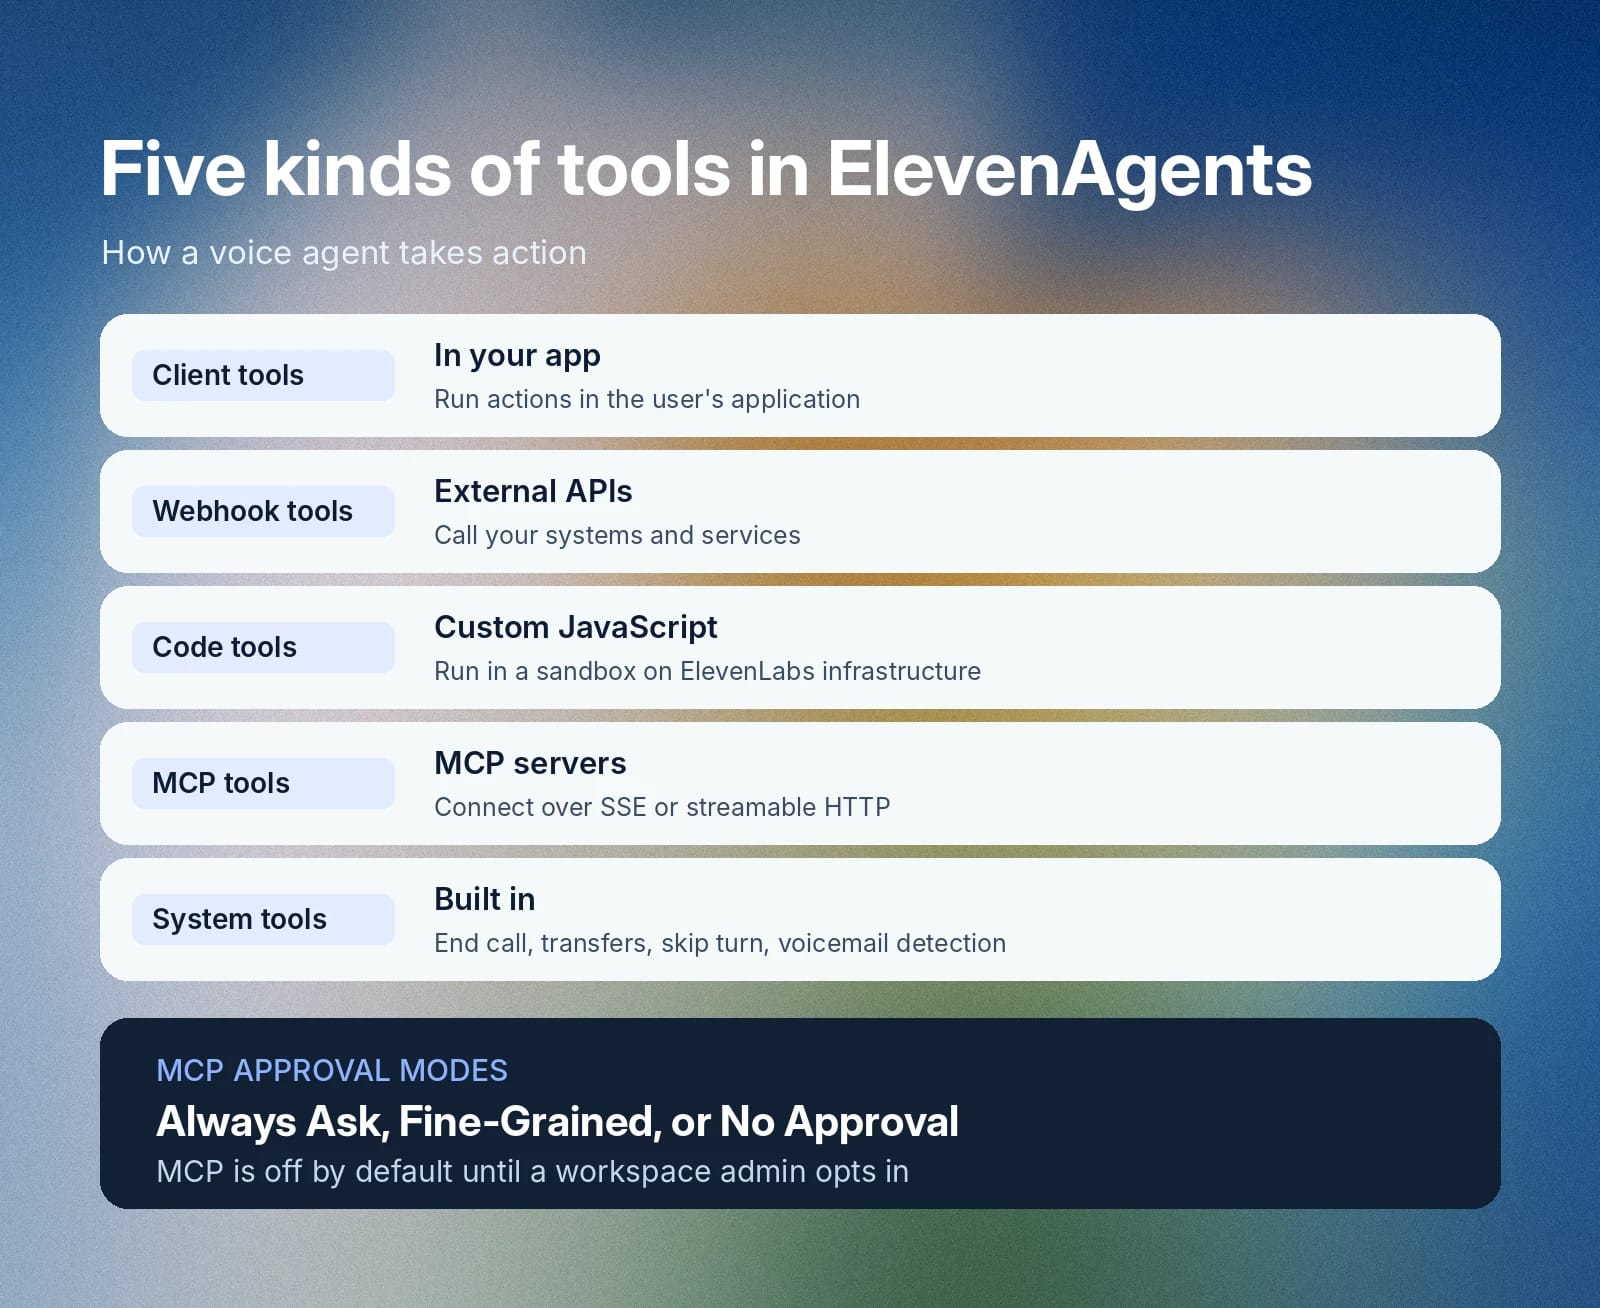
ElevenAgents ondersteunt client tools die in de applicatie van de gebruiker draaien, webhook tools die externe API's aanroepen, codetools die aangepaste JavaScript uitvoeren in een sandbox op de infrastructuur van ElevenLabs, MCP tools en ingebouwde systeemtools.
De systeemtools zijn onder meer gesprek beëindigen, taaldetectie, agent transfer, transfer to number, beurt overslaan, toetstoon afspelen en voicemaildetectie. Je kunt omgevingsaudio toevoegen terwijl een tool draait en bepalen of bellers de uitvoering mogen onderbreken.
Het Model Context Protocol (MCP) is een open standaard voor de manier waarop applicaties context en tools aan taalmodellen geven. ElevenAgents maakt via SSE en streamable HTTP verbinding met MCP-servers. Workspacebeheerders moeten zich eerst aanmelden, omdat MCP standaard voor elke workspace is uitgeschakeld. Vervolgens kies je voor elke server een goedkeuringsmodus: Always Ask, Fine-Grained Tool Approval of No Approval.
Clientevents zoals client_tool_call en mcp_tool_call rapporteren toolactiviteit, en de MCP-eventrapporten kennen vier statussen: loading, awaiting approval, success en failure. Betrouwbare tools geven de agent bereik in de echte wereld, en duidelijke goedkeuringsregels houden dat bereik onder controle.
Kennis en geheugen: feiten en context over de beller
Retrieval-augmented generation (RAG) geeft de agent feiten uit je eigen content, zoals een interne feitendatabase of een uitgebreider klantgeschiedenislogboek. Geheugen en personalisatie geven de agent context over de beller, zodat je agent de personalisatie en het nut voor je bedrijf kan verbeteren.
Wat het doet
Een taalmodel heeft een trainingsgrens en geen toegang tot je documentatie of gegevens. RAG doorzoekt voor elke query een kennisbank, haalt de meest relevante passages op en levert die aan het model voor de extra context die nodig is voor een bruikbaar antwoord.
Personalisatiegegevens vertellen de agent wie belt en wat voor die persoon relevant is.
Waarom dit belangrijk is
Antwoorden baseren op goedgekeurde content houdt ze nauwkeurig. Ook de snelheid van kennisophaling is belangrijk: elke toegevoegde milliseconde is er een waarop je klanten wachten. Personalisatiefuncties voorkomen ook dat bellers informatie in verschillende gesprekken moeten herhalen, omdat je agents de CRM-records bij de hand hebben aan het begin van elke nieuwe sessie.
Hoe ElevenAgents dit doet
Je voegt documenten toe aan de kennisbank als bestanden (PDF, DOCX, TXT, MD, HTML of EPUB, elk maximaal 20 MB), URL's of geplakte tekst. Een document gebruikt volledige context wanneer de geëxtraheerde tekst in de prompt past, tot ongeveer 300.000 tekens. Grotere documenten gebruiken RAG. Ophalen kan bij elke beurt of op aanvraag, en de standaardgebruiksmodus is Auto, die RAG gebruikt wanneer het is ingeschakeld en het document is geïndexeerd.
ElevenLabs werkt rechtstreeks aan de snelheid van kennisophaling. Het engineeringartikel How we reduced RAG latency beschrijft een daling van de mediane RAG-latency van 326 ms naar 155 ms met modellen die zelf worden gehost op infrastructuur die ElevenLabs al gebruikt.
Voor context over de beller gebruikt ElevenAgents dynamische variabelen, geschreven als {{ var_name }}, die berichten, systeemprompts en tools invullen. Voor inkomende gesprekken via Twilio, SIP trunk, WhatsApp en sms kan ElevenAgents initiatiegegevens van je server ophalen voordat het gesprek begint. Je server zoekt de beller op via caller_id en retourneert de variabelen, bijvoorbeeld vanuit je CRM, met een response van maximaal 256 KB. Na het gesprek leveren webhooks na het gesprek evaluatieresultaten en geëxtraheerde gegevens aan je externe systemen.
Samen geven kennisophaling en personalisatie de agent zowel de juiste feiten als de juiste beller.
Spraaksynthese: de agent een stem geven
Text to Speech (TTS) zet het antwoord van het taalmodel om in gesproken audio. Dit is de laag die de beller daadwerkelijk hoort.
Wat het doet
Het model zet tekst om in audio met natuurlijk tempo en emotionele voordracht. In een live gesprek streamt het audio in delen, zodat het afspelen begint voordat het volledige antwoord is gegenereerd.
Waarom dit belangrijk is
Latency en voordracht bepalen beide hoe bellers het gesprek beoordelen. Twee getallen zijn belangrijk voor realtime werk: de tijd om audio te genereren en de tijd totdat de beller het eerste geluid hoort. Namen, medicijnnamen en technische termen moeten ook correct worden uitgesproken, anders verliezen bellers vertrouwen in de agent.
Hoe Eleven v4 de stemlaag aandrijft
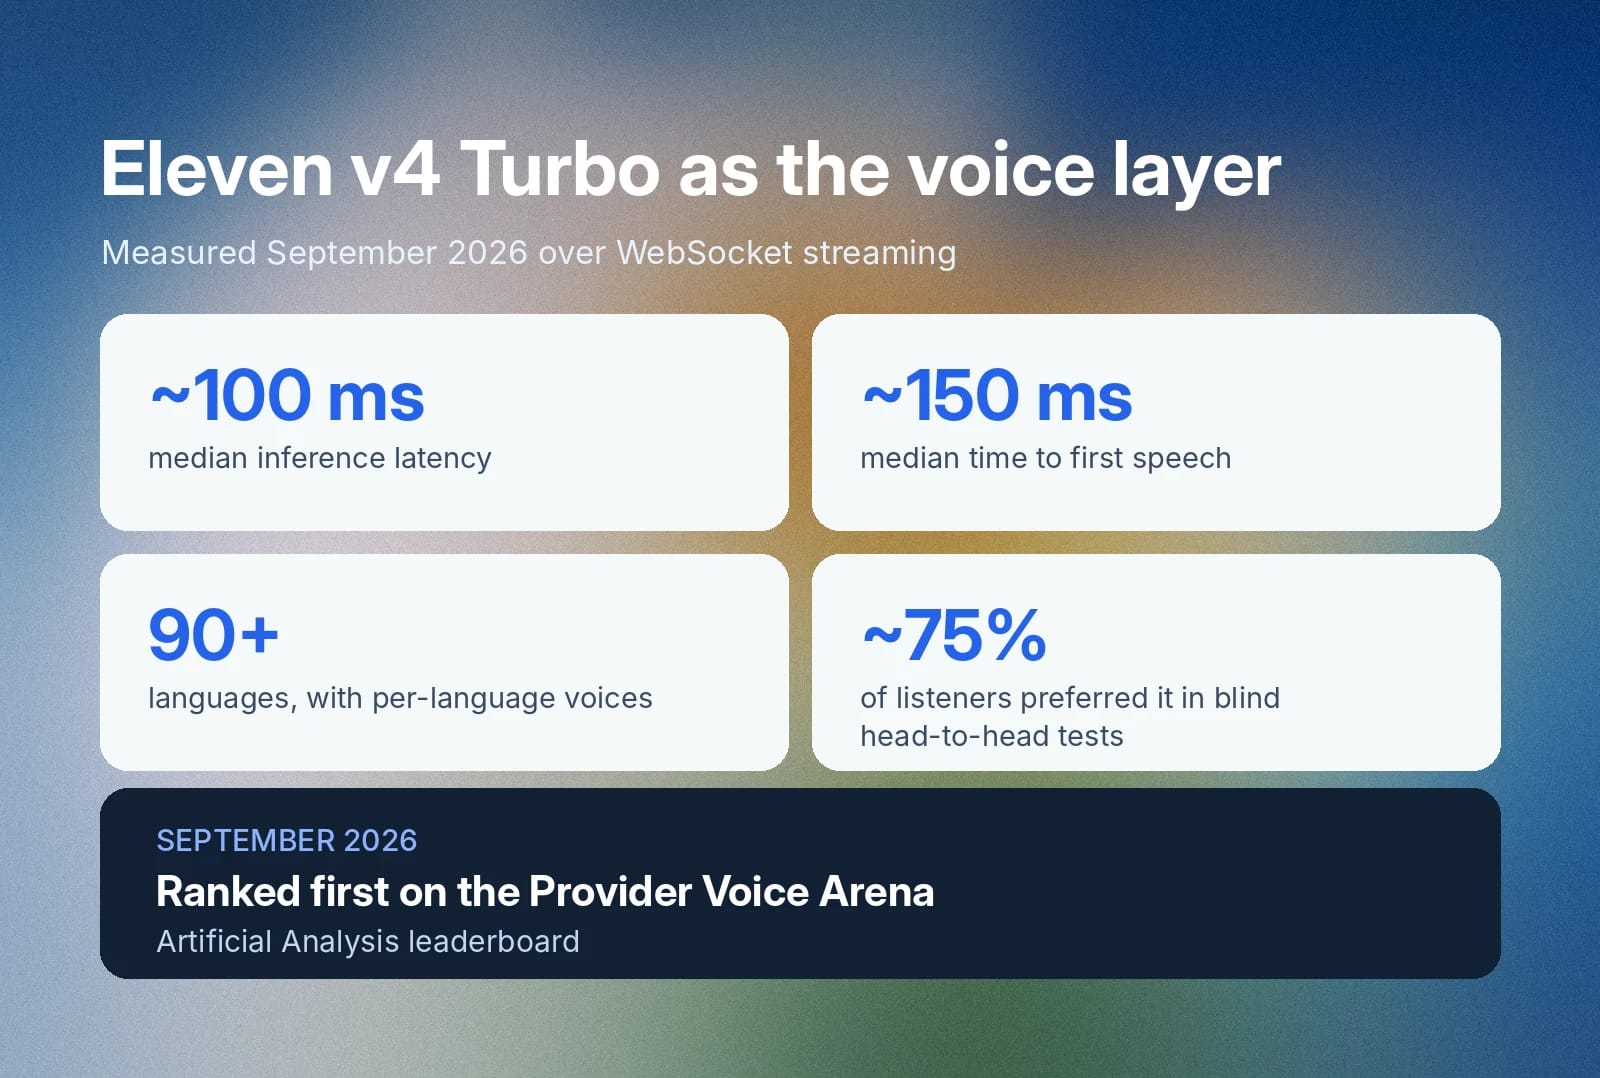
Eleven v4 is het meest emotieve Text to Speech-model van ElevenLabs tot nu toe, gebouwd op een volledig nieuwe architectuur. Eleven v4 Turbo is de variant met lage latency voor realtime gebruik, zoals agents, en samen met ElevenAgents als één systeem geoptimaliseerd.
Eleven v4 Turbo
Waarde
Mediane inferentielatency
Ongeveer 100 ms
Mediane tijd tot eerste spraak
Ongeveer 150 ms
Talen
90+
ElevenLabs heeft de latencycijfers in september 2026 gemeten via WebSocket-streaming, zonder netwerklatency. Eleven v4 stond in september 2026* op de eerste plaats van de Artificial Analysis Provider Voice Arena Leaderboard en ongeveer 75% van de luisteraars gaf er in blinde tests de voorkeur aan**.
* Artificial Analysis, Provider Voice Arena Leaderboard, sept. 2026
** Gebaseerd op rechtstreekse gebruikerstests voor voorkeur tegenover Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS en Google Gemini 3.8 Flash TTS.
Eleven v4 ondersteunt inline audiotags zoals [laughs] voor voordracht en IPA-ondersteuning voor fonemen voor uitspraak. In zorgagents omvat die uitspraakcontrole medische termen. ElevenAgents voegt daar controles op agentniveau aan toe. Met ondersteuning voor meerdere stemmen kan één agent wisselen tussen stemmen voor gesprekken met meerdere personages. De snelheid varieert van 0,7x tot 1,2x. Elke extra taal kan een eigen stem gebruiken. Uitspraakwoordenboeken gebruiken IPA- of CMU-notatie voor specifieke woorden.
Een snel eerste geluid en een nauwkeurige, expressieve stem laten de agent voelen als een gesprekspartner.
Telefonie en transport: de agent met bellers verbinden
De transportlaag vervoert audio tussen de beller en de agent. Welke integraties je hier opneemt in je voice AI-infrastructuur, hangt af van het telefoniekanaal dat je gebruikt.
Wat het doet
Telefoongesprekken verlopen via een telefoonnetwerk en SIP, terwijl gesprekken in browsers en apps via WebRTC of WebSocket verlopen. Een websitewidget verpakt de browserverbinding in een kant-en-klare interface.
Waarom dit belangrijk is
Elk kanaal heeft andere installatievereisten en audiobeperkingen, dus bepaal je kanalen vroeg. Een implementatie die op telefonie is gericht, heeft trunking en nummerbeheer nodig. Een productimplementatie heeft een SDK nodig.
Hoe ElevenAgents dit doet
- SIP trunking: Verbindt je telefoonsysteem rechtstreeks met ElevenLabs, voor inkomende en uitgaande gesprekken. Het werkt met Twilio, Vonage, Sinch, Infobip, Telnyx en andere standaardproviders. Signaling werkt via TCP op poort 5060 of TLS 1.2 of hoger op poort 5061, en audio gebruikt G.711 of G.722. Reken op minimaal 100 Kbps per gesprek. Limieten voor gelijktijdige gesprekken volgen je abonnementsniveau, en bellers wachten wanneer wachtrijvorming voor gesprekken is ingeschakeld.
- Native Twilio-integratie: Importeer een gekocht Twilio-nummer voor inkomende en uitgaande gesprekken. Geverifieerde beller-ID's werken alleen voor uitgaande gesprekken.
- Batchgesprekken: Upload een lijst met ontvangers in CSV- of XLS-formaat; elke extra kolom wordt een dynamische variabele. Je kunt direct starten of een start inplannen. Batches gebruiken de laagste waarde van 50% van de gelijktijdigheidslimiet van je workspace of 70% van de gelijktijdigheidslimiet van je agent, zodat capaciteit overblijft voor inkomende gesprekken.
- WebRTC en WebSocket: De SDK's gebruiken standaard WebRTC voor spraak en WebSocket voor gesprekken met alleen tekst. Privéagents authenticeren met een ondertekende URL of een conversation token dat op je server is gemaakt. Het WebSocket-endpoint is wss://api.elevenlabs.io/v1/convai/conversation.
- SDK's: Python, JavaScript, React, React Native, Swift, Kotlin en Unity.
- Widget: Voeg het element <elevenlabs-convai> toe aan een pagina. Het ondersteunt alleen spraak, spraak plus tekst en chatmodi, en de agent kan snelle antwoorden en carrousels tonen.
Eén agent kan telefoon, web, WhatsApp, sms en e-mail bedienen, zodat teams één keer kunnen bouwen en via meerdere kanalen kunnen implementeren.
Guardrails: de agent bij zijn taak houden
Guardrails zijn controles die het gedrag van een agent binnen vastgestelde grenzen houden. Ze werken naast grounding: een guardrail beperkt wat een agent zegt, zonder de feiten erachter correct te maken. Guardrails draaien parallel aan agentgesprekken en helpen je AI-agentgesprekken compliant en nauwkeurig te houden.
Wat het doet
ElevenAgents past guardrails toe op drie niveaus. De systeemprompt bepaalt toegestaan en niet-toegestaan gedrag, idealiter onder een kop # Guardrails. Validatie van gebruikersinvoer screent berichten op prompt injection. Antwoordvalidatie controleert elk antwoord voor aflevering.
Waarom dit belangrijk is
Een agent die afdwaalt van het onderwerp of een beleid verzint, ondermijnt snel vertrouwen. Een klantenserviceagent moet het restitutiebeleid uit een goedgekeurde bron ophalen voordat die antwoordt, en een guardrail handhaaft die grens.
Hoe ElevenAgents dit doet
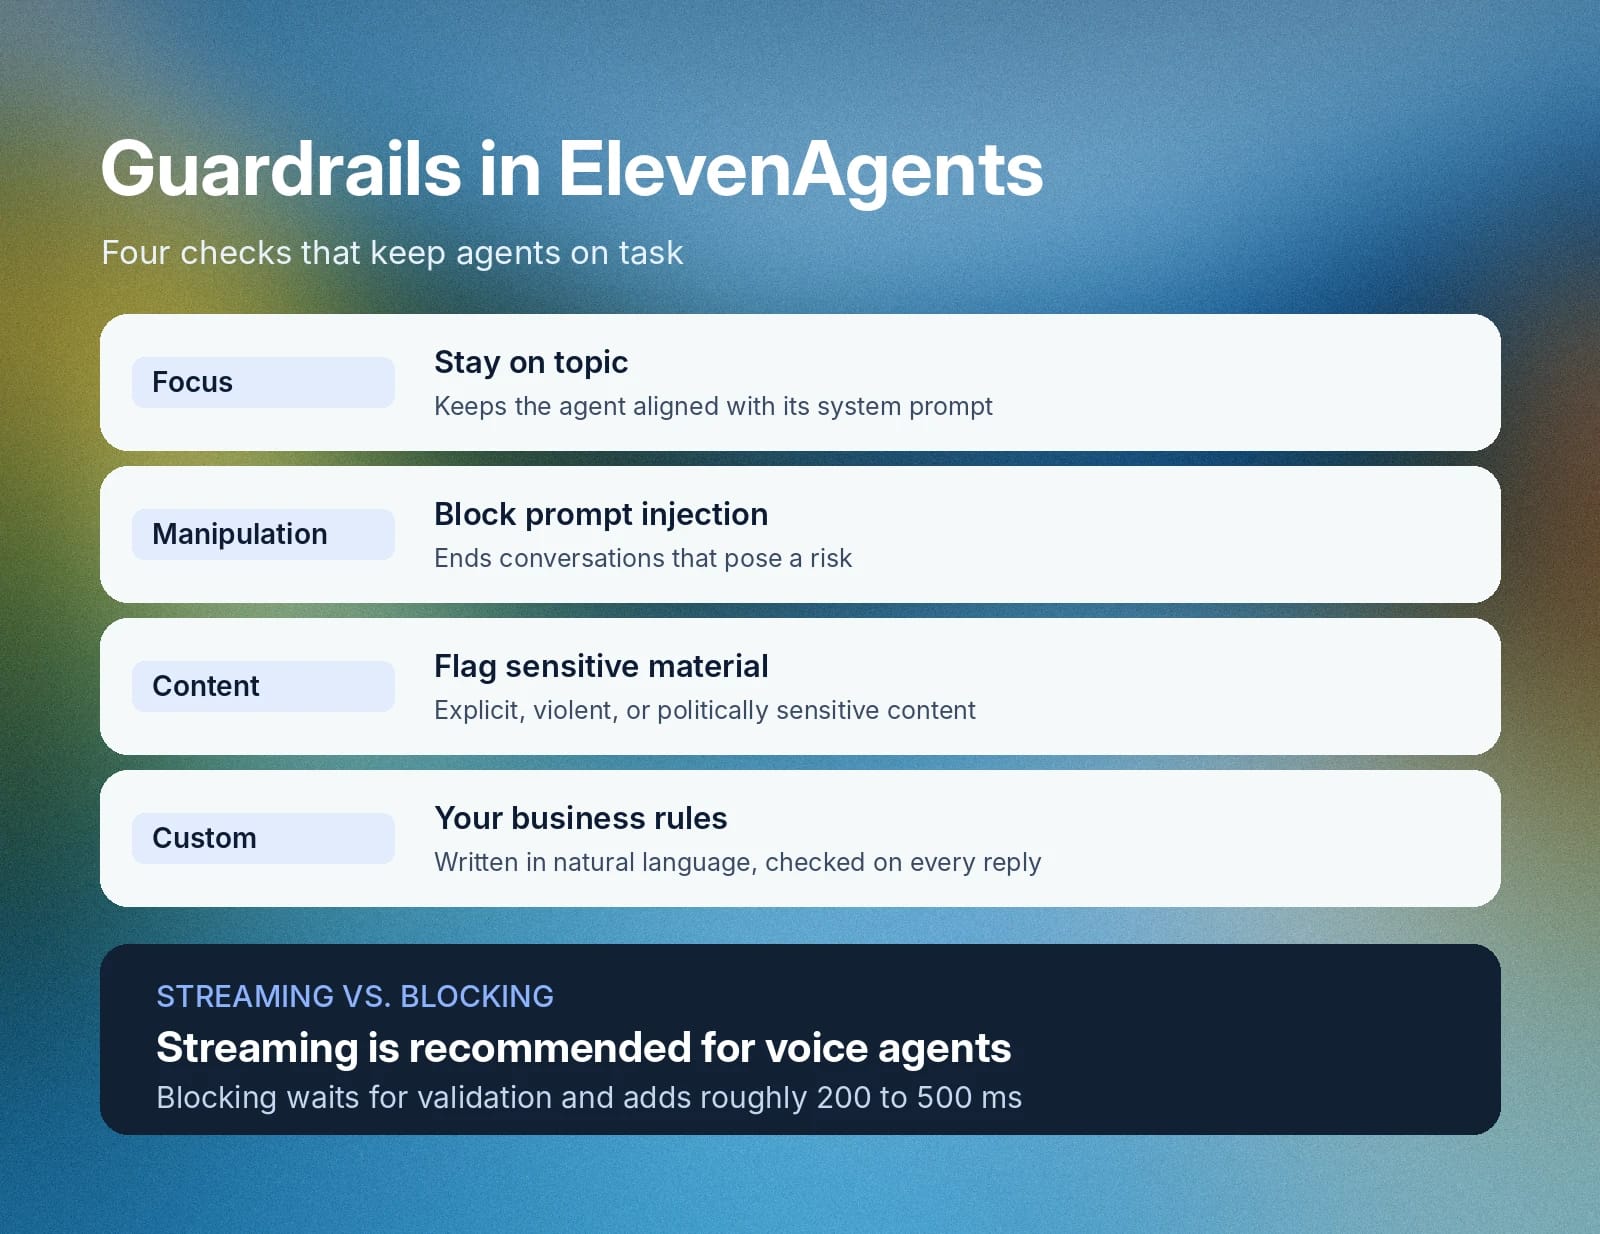
ElevenAgents introduceerde Guardrails 2.0 in september 2026. Dit nieuwe systeem biedt onder meer de volgende configuraties waarmee guardrails effectief werken:
- Focus: Houdt de agent bij het onderwerp en afgestemd op de systeemprompt.
- Manipulation: Detecteert prompt injection en beëindigt gesprekken die een risico vormen.
- Content: Markeert categorieën zoals seksueel expliciet, gewelddadig of politiek gevoelig materiaal.
- Custom: Bedrijfsregels die je in natuurlijke taal schrijft en bij elk antwoord worden beoordeeld.
Uitvoeringsmodus bepaalt de afweging rond latency. In streamingmodus kan het antwoord beginnen voordat de controle is voltooid, waardoor minder dan 500 ms audio kan afspelen voordat een blokkering het gesprek beëindigt; ElevenLabs raadt dit aan voor voice agents. De blokkerende modus wacht op validatie en voegt ongeveer 200 tot 500 ms toe.
Wanneer een aangepaste guardrail wordt geactiveerd, beëindigt de triggeractie het gesprek of probeert die het antwoord maximaal drie keer opnieuw met feedback die je schrijft. Je client kan luisteren naar het event guardrail_triggered.
Gelaagde guardrails met een gekozen latencyprofiel houden gedrag voorspelbaar zonder elk antwoord te vertragen.
Testen en experimenten: bewijzen dat de agent werkt
Testen controleert een agent vóór de lancering. Experimenten controleren wijzigingen tegen live verkeer na de lancering.
Wat het doet
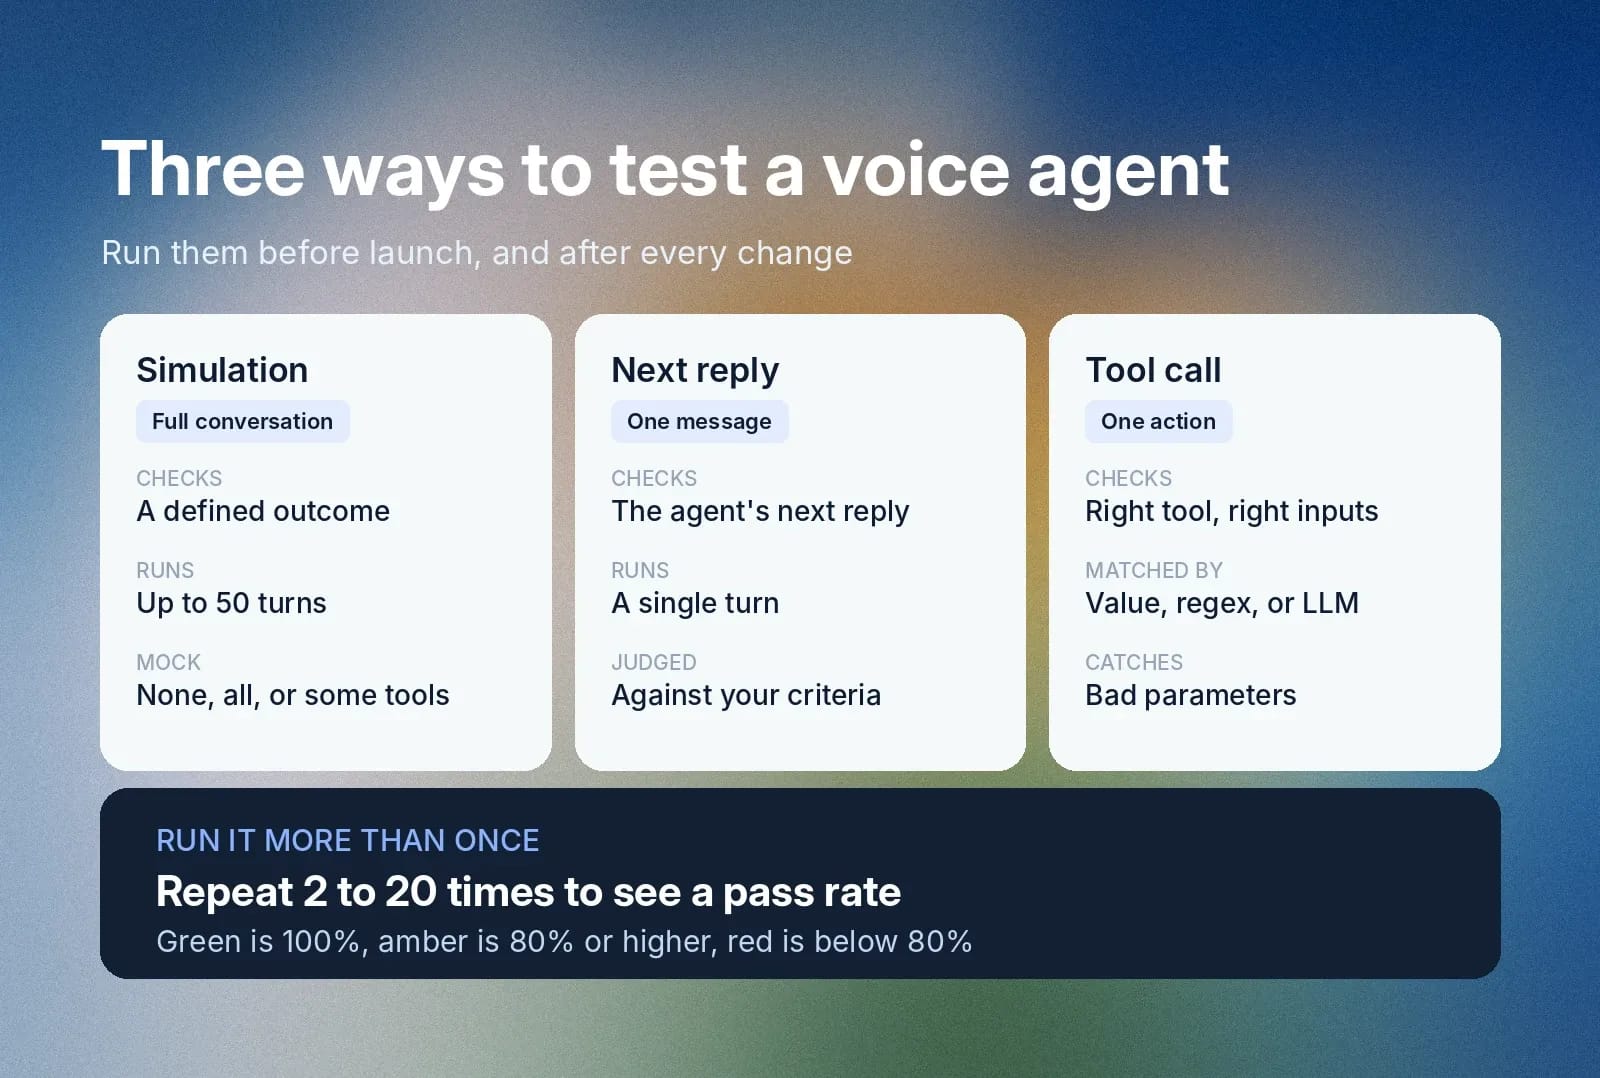
ElevenAgents heeft drie typen agenttests. Simulation voert een volledig gesprek met een gesimuleerde gebruiker en controleert of dit een gedefinieerde uitkomst bereikt, met maximaal 50 beurten (standaard 5). Next Reply-tests beoordelen alleen het volgende bericht van de agent aan de hand van je criteria. Tool Call-tests controleren of de agent de juiste tool met de juiste parameters gebruikt, gematcht op exacte waarde, regex of LLM-evaluatie. In simulaties kun je geen tools, alle tools of geselecteerde tools mocken.
Waarom dit belangrijk is
Eén geslaagde uitvoering laat zien dat een agent kan slagen. Tests herhaald uitvoeren toont hoe vaak dat gebeurt. De API accepteert repeat_count van 2 tot 20 en de resultaten tonen een slagingspercentage. Groen betekent 100%, amber 80% of hoger en rood lager dan 80%. Mislukkingen worden gegroepeerd op reden. Prompts, modellen, workflows en integraties veranderen allemaal gedrag, dus testen gaat door na de lancering.
Hoe experimenten werken
Experimenten zijn A/B-tests die zijn gebouwd op agentversies. Je vertakt je configuratie, wijzigt één variabele zoals de systeemprompt, workflow, stem, tools, kennisbank of LLM-instellingen en routeert een deel van het live verkeer naar de variant. ElevenLabs raadt aan te beginnen met 5 tot 10%.
Routing is deterministisch per gespreks-ID, dus een bepaalde gebruiker blijft op dezelfde tak en percentages moeten samen 100% zijn. CARS24, een klant van ElevenLabs, verhoogde verkeer via 5%, 10%, 20%, 50% en 100%, met bij elke stap een pauze van twee dagen, zoals beschreven in het rapport.
Tests vóór de lancering en live experimenten maken samen van wijzigingen meetbare verbeteringen.
Observability: meten wat er in productie gebeurt
Observability is het vermogen om te zien wat de agent deed, hoe deze presteerde en, indien van toepassing, waar deze faalde. Een agent die werkt in een test kan zich anders gedragen met echte bellers, waardoor volledige observability en controleerbare verslaglegging noodzakelijk zijn.
Wat het doet
Gespreksanalyse beoordeelt elk gesprek. Succesbeoordeling past criteria toe die je definieert voor doelbereik en kwaliteit, en gegevensverzameling extraheert gestructureerde velden zoals contactgegevens en type probleem. Het analytics-dashboard voegt gespreksvolume, duur, kosten, foutpercentages en latency toe. Actieve gesprekken worden realtime bijgewerkt en waarschuwingen gaan af wanneer foutpercentages pieken.
Waarom dit belangrijk is
Zonder monitoring is een slecht gesprek een anekdote. Met monitoring kun je zien welke node, tool of welk model het probleem veroorzaakte.
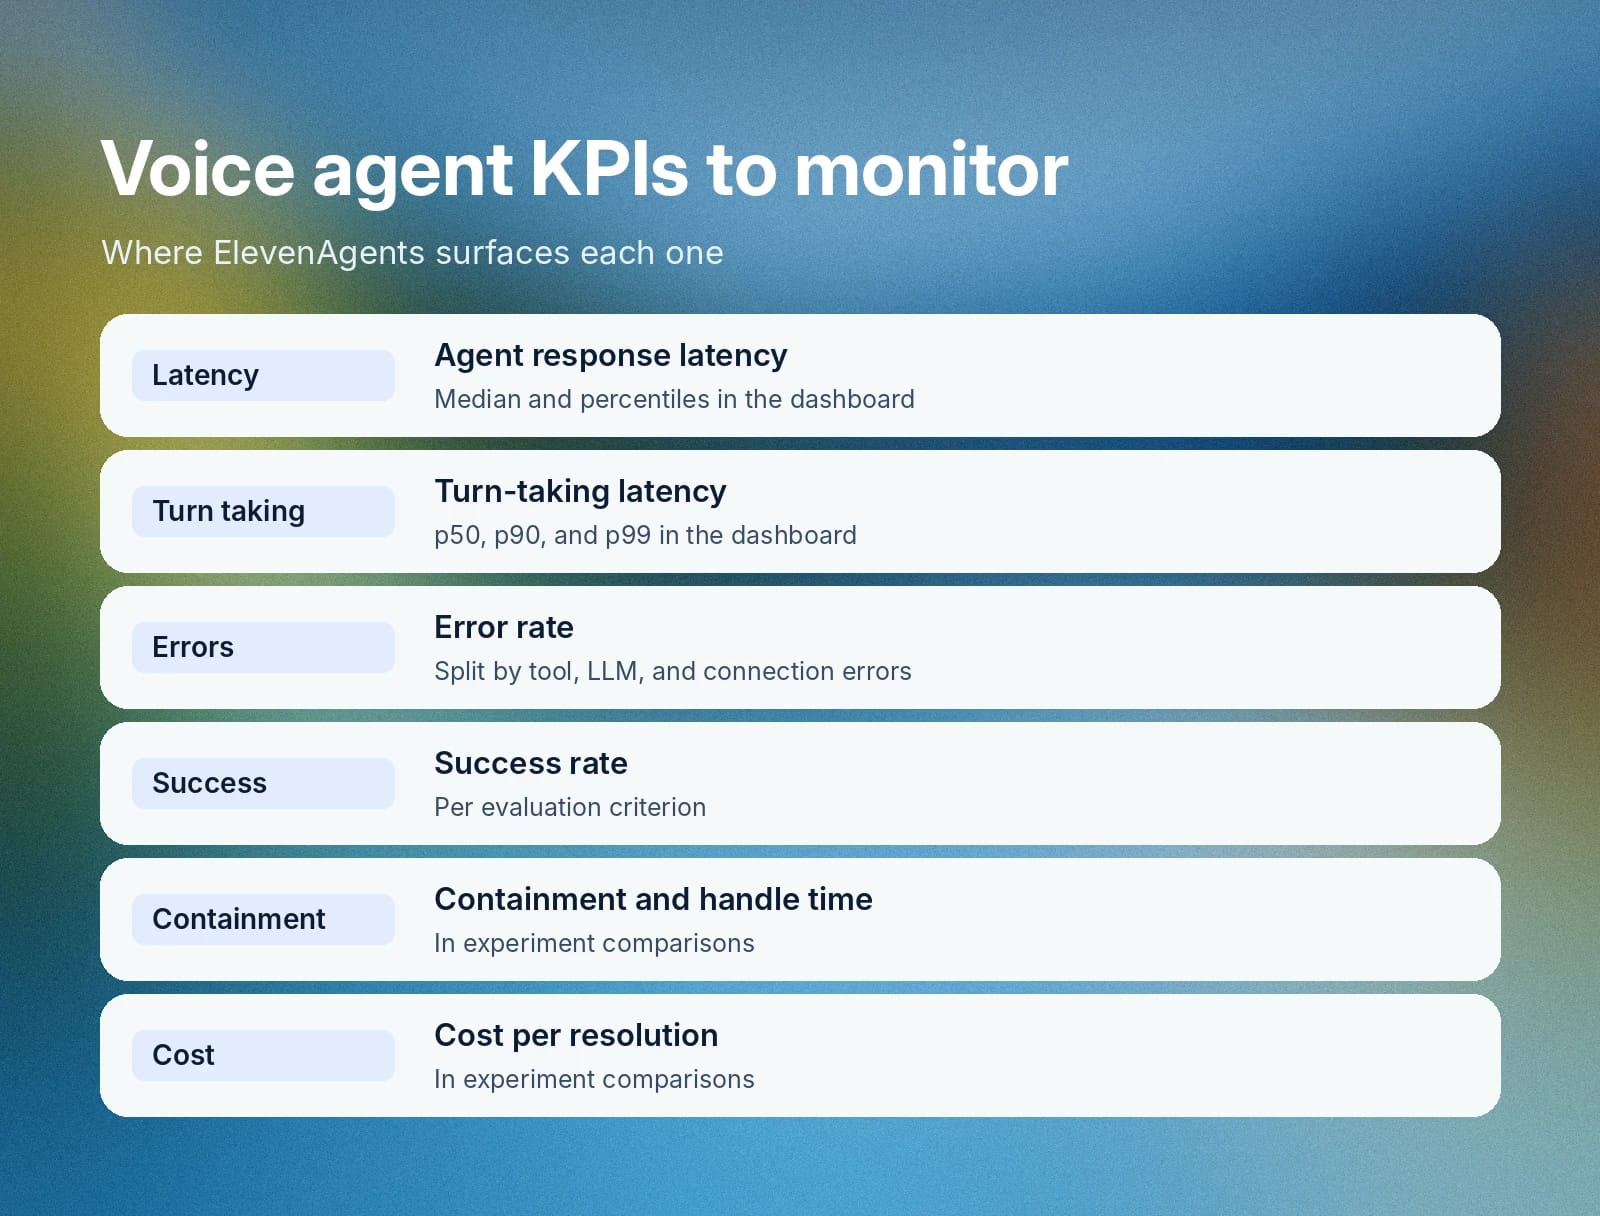
KPI
Wat het je vertelt
Waar ElevenAgents dit toont
Reactielatency van de agent
Hoe lang bellers op een antwoord wachten
Analytics-dashboard, mediaan en percentielen
Latency van beurtwisseling
Hoe snel de agent zijn beurt neemt
Analytics-dashboard, p50, p90 en p99
Foutpercentage
Aandeel gesprekken met fouten
Dashboard, uitgesplitst naar fouten in tools, LLM's en verbindingen
Succespercentage
Doelbereik per criterium
Evaluatiecriteria, met percentages voor succes, mislukking en onbekend
Afhandelingspercentage en afhandeltijd
Gesprekken opgelost zonder mens en gespreksduur
Experimentvergelijkingen
Kosten per oplossing
Wat elk opgelost gesprek kost
Experimentvergelijkingen
Kies de metrics die het nuttigst zijn voor de specifieke taak die je voor ogen hebt. Een supportagent richt zich op oplossing en escalatie, terwijl een outbound agent zich vooral richt op verbinding en voltooiing.
Schaal, betrouwbaarheid en overdracht aan mensen
Voice AI-infrastructuur moet kunnen leveren, of je nu met 5 klanten of 500.000 klanten spreekt. Ook bij grote volumes moeten deze onderdelen bestand zijn tegen belasting en indien nodig kunnen escaleren naar mensen.
Wat het doet
Schaal betekent veel gelijktijdige gesprekken ondersteunen binnen spraakherkenning, LLM-inferentie, spraaksynthese, integraties en telefonie. Betrouwbaarheid betekent dat elk van die afhankelijkheden een gedefinieerd pad bij fouten heeft. Overdracht betekent een duidelijke route naar een mens.
Hoewel ze strikt genomen geen onderdeel zijn van voice AI-infrastructuur, zijn ze in de praktijk allemaal essentieel voor een goed systeem.
Waarom dit belangrijk is
Een systeem dat tien testgesprekken afhandelt, kan zich anders gedragen bij tienduizend gesprekken. Een boekingstool die een time-out krijgt, mag de agent niet laten bevestigen dat een boeking is gemaakt terwijl dat niet zo is. Een beller die om een persoon vraagt, moet die bereiken met behoud van context, meestal via warme overdracht.
Hoe ElevenAgents dit doet
Gelijktijdigheidslimieten volgen het abonnementsniveau en wachtrijvorming voor gesprekken houdt bellers vast wanneer een limiet is bereikt. LLM-cascadering dekt modelstoringen af. Transfer-to-number-nodes, de systeemtool transfer to number en agent transfer verzorgen overdracht, en evaluatiecriteria kunnen bepalen wanneer er moet worden geëscaleerd. Stille periodes worden gefactureerd tegen 5% van het gebruikelijke tarief per minuut.
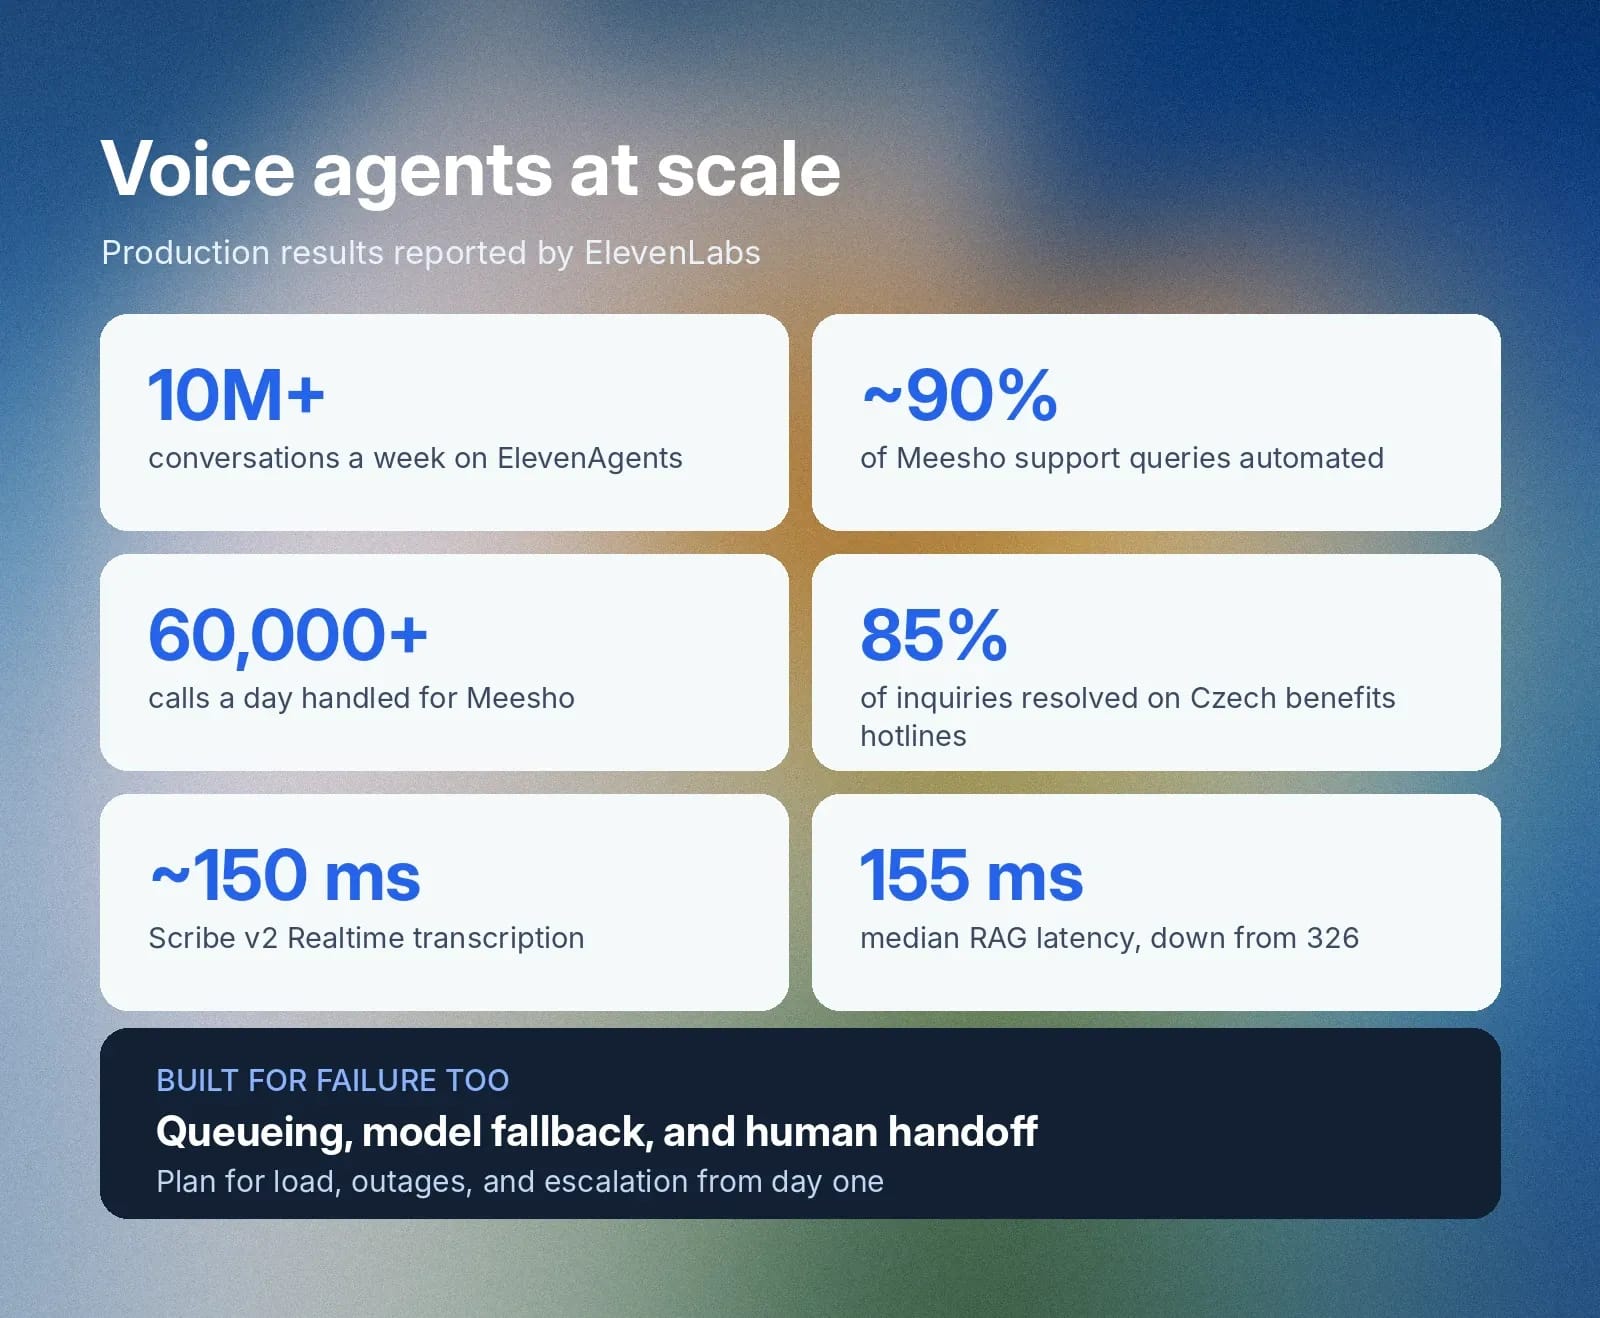
ElevenLabs rapporteert productieresultaten op schaal. ElevenAgents verwerkt meer dan 10 miljoen gesprekken per week. Meesho automatiseert volgens het rapport Building Enterprise-grade Voice Agents ongeveer 90% van de supportvragen over meer dan 60.000 gesprekken per dag. In de Tsjechische Republiek verwerken agents op basis van ElevenLabs volgens het rapport State of Conversational Agents in Government ongeveer 5.000 gesprekken per dag voor nationale hulplijnen voor uitkeringen en lossen ze 85% van de vragen zelfstandig op.
Vanaf het begin plannen voor belasting, fouten en overdracht onderscheidt een demo van een implementatie.
Waar je in 2026 op moet letten bij voice AI-infrastructuur die klaar is voor productie
Gebruik deze checklist om elk voice AI-platform te beoordelen aan de hand van je vereisten.
- Spraakherkenning: nauwkeurige transcripties voor je talen, accenten en audiokwaliteit, inclusief namen en identificatoren.
- Beurtwisseling: configureerbaar gedrag aan het einde van een beurt, barge-in en een gemeten reactietijd bij onderbrekingen.
- Modelkeuze: een selecteerbaar LLM per agent of subagent, een optie voor een aangepast LLM en automatische fallback.
- Orkestratie: workflows met meerdere stappen en routing tussen gespecialiseerde agents.
- Tools: webhooks, client tools, MCP-ondersteuning en goedkeuringscontroles.
- Kennis: je eigen documenten, met latency voor kennisophaling die je kunt meten.
- Personalisatie: gegevens over de beller beschikbaar voordat het eerste woord is uitgesproken.
- Stem: korte tijd tot eerste spraak en controle over uitspraak en expressie.
- Kanalen: telefoon, web, mobiel en berichten, met SDK's en een API.
- Guardrails: configureerbare gedragslimieten met bekende latencykosten.
- Testen: gesimuleerde gesprekken, controles van tool calls en herhaalde uitvoeringen.
- Experimenten en analytics: A/B-tests, latencypercentielen en foutuitsplitsingen.
- Schaal en overdracht: gedocumenteerde gelijktijdigheid, wachtrijvorming en escalatie naar mensen.
Toonaangevende systemen voor AI voice agents, zoals ElevenAgents, bieden al deze onderdelen op één platform.
Ga vandaag aan de slag door contact op te nemen met het team, of bouw je eigen AI-agentsystemen door je te registreren voor een account.
Veelgestelde vragen over voice AI-infrastructuur

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


