
Wat is voice activity detection en hoe werkt het?
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
Voice activity detection classificeert of korte audioframes van milliseconden menselijke spraak bevatten. Het wordt gebruikt in veel toepassingen voor digitale audioverwerking, waaronder transcriptie, telefonie en voice agents.
In dit artikel bespreken we wat voice activity detection doet, wat het niet doet en hoe het past binnen belangrijke toepassingen voor enterprises.
Samenvatting
- Voice activity detection (VAD) is een fundamenteel onderdeel van moderne audioworkflows. Het analyseert continu een audiostream en geeft voor elk audioframe van milliseconden aan met ja of nee of er menselijke spraak aanwezig is.
- VAD vertelt downstream audiotools wanneer ze moeten werken en wanneer ze stand-by moeten staan. Het wordt gebruikt door LLM's, transcriptieservices en als onderdeel van andere audio-pipelines voor enterprises.
- Algoritmen voor voice activity detection draaien in een continue cyclus van vijf stappen: audio vastleggen, in frames verdelen, stemkenmerken extraheren, de waarschijnlijkheid op spraak beoordelen en een beslissing doorgeven aan downstream services.
- VAD vertrouwde oorspronkelijk op puur wiskundige signaalverwerking om met ja of nee de aanwezigheid van spraak vast te stellen. Moderne AI-gebaseerde systemen gebruiken neurale netwerken voor dezelfde functie, maar met beter contextueel begrip van achtergrondgeluid en semantische signalen.
- VAD-systemen classificeren alleen of een audioframe spraak bevat. Ze vertellen je niet wanneer iemand is uitgesproken. Endpointsystemen gebruiken VAD en andere heuristische analysetools om te bepalen of een spreker zijn gedachte heeft afgerond.
- In enterpriseomgevingen helpt VAD voice agents natuurlijk met klanten te communiceren zonder hen te onderbreken, optimaliseert het gebruik van VoIP-bandbreedte, houdt het de kosten voor AI-transcriptie met speech to text (STT) laag en kent het andere toepassingen.
- Test VAD-systemen onder realistische omstandigheden. Onberispelijke studio-opnames zijn geen effectieve manier om hun mogelijkheden vast te stellen.
Wat is voice activity detection (VAD)?
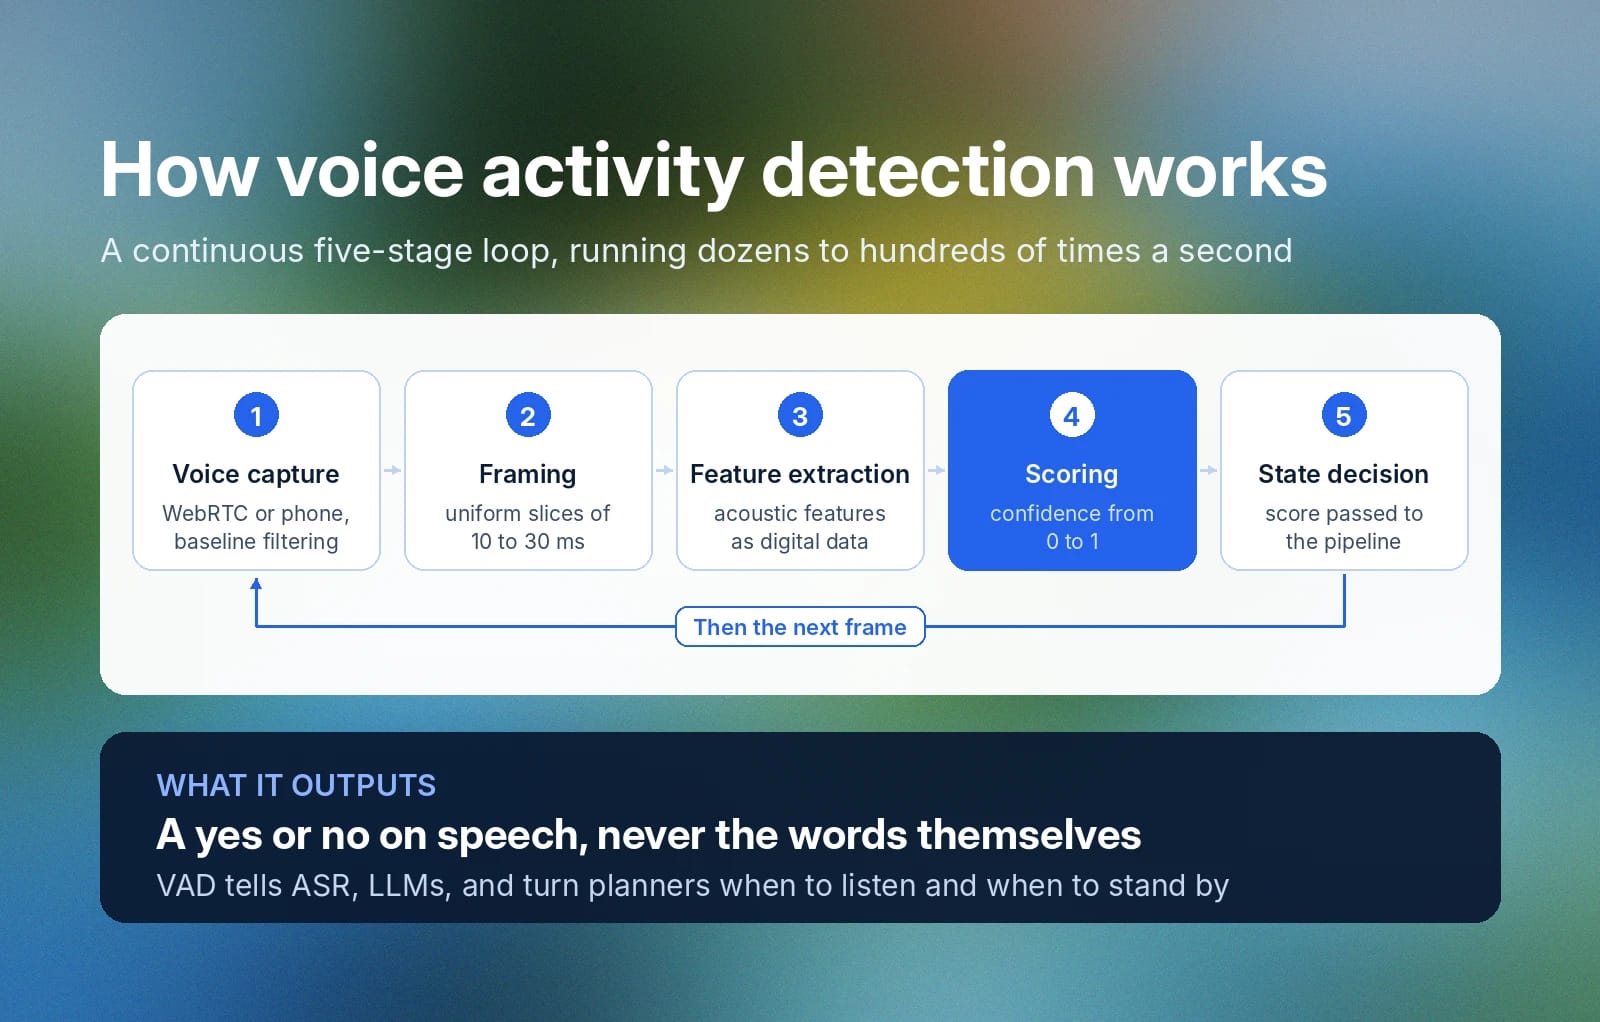
Voice activity detection (VAD) is een softwareproces dat classificeert of kleine stukjes audio, frames genoemd, spraak bevatten. VAD-algoritmen draaien tientallen tot honderden keren per seconde op een audiostream en geven als binaire reactie “ja” of “nee” terug op de vraag of ze spraak detecteren.
Ze worden gebruikt in bredere digitale audio-pipelines, zoals telecommunicatie of spraaktranscriptie. Ze vertellen andere downstream systemen, zoals ASR/STT, LLM's en turn planners, of ze actief naar de audiostream moeten luisteren of stand-by moeten staan.
VAD is niet hetzelfde als Automatic Speech Recognition (ASR). Een VAD-systeem geeft alleen een probabilistisch ja-of-nee-antwoord op de vraag of het spraak detecteert. Het geeft geen daadwerkelijke woorden weer. De primaire functie is downstream systemen vertellen of ze een bepaald audioframe moeten verwerken.
Hoe werken algoritmen voor voice activity detection?
Een VAD-algoritme werkt op een audiostream en neemt een ja-of-nee-beslissing over de vraag of een bepaald audioframe, meestal 10-30 milliseconden, spraak bevat.
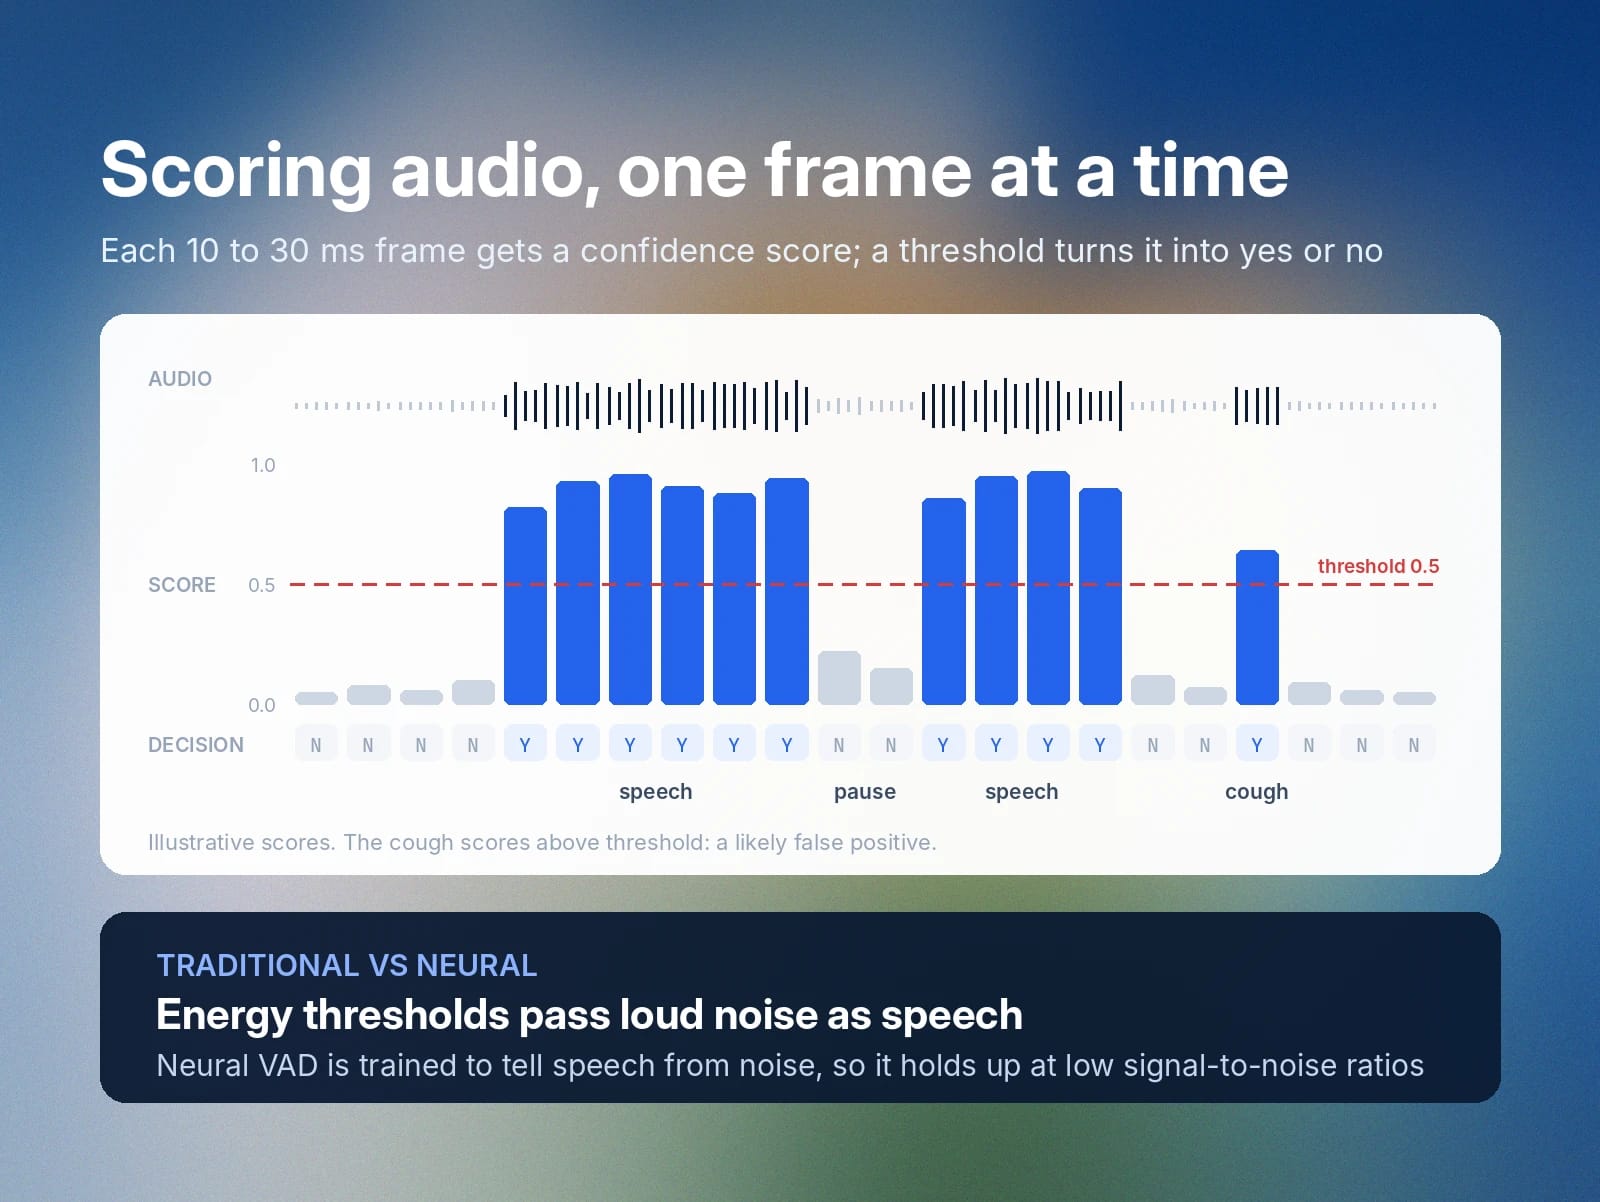
Ze werken continu in een cyclus van vijf stappen:
- Audio vastleggen: Het systeem waarop VAD draait, ontvangt een audiostream via WebRTC of telefonie en past standaard ruisfiltering toe op de gegevens.
- Framing: Het algoritme verdeelt de ruwe audiostream in uniforme frames.
- Kenmerken extraheren: Het algoritme extraheert akoestische kenmerken uit de stream die het wiskundig als digitale gegevens kan weergeven.
- Beoordeling: Het systeem voert de geëxtraheerde kenmerken binnen een frame door het eigenlijke VAD-algoritme om een betrouwbaarheidsscore tussen 0 en 1 te genereren voor de vraag of het spraak bevat (0 = ”geen spraak” en 1 = ”spraak”).
- Statusbeslissing: Het VAD-systeem geeft de betrouwbaarheidsscore door aan de audio-pipeline waarin het draait, zodat die pipeline kan beslissen hoe ermee om te gaan.
Traditionele versus AI-gebaseerde voice activity detection
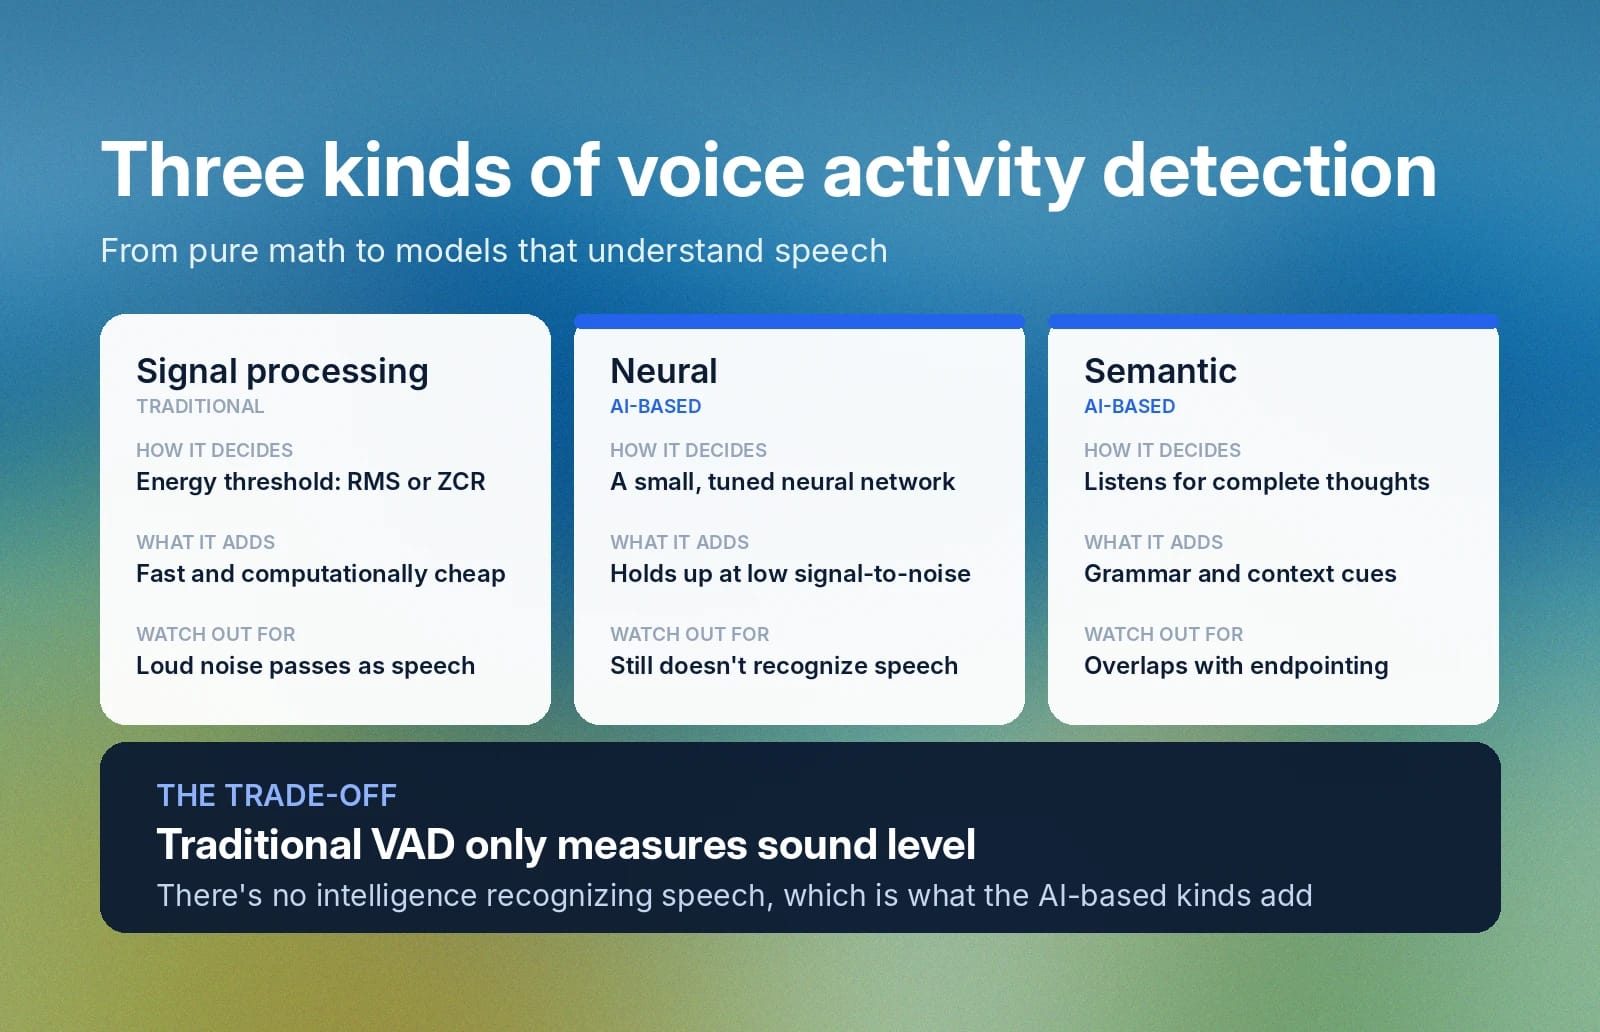
VAD valt in twee brede categorieën: signaalverwerking en AI.
Binnen AI-gebaseerde VAD bestaan twee afzonderlijke benaderingen, waardoor er in totaal drie soorten voice activity detection zijn.
Laten we deze uitgebreider bekijken.
Traditionele VAD (signaalverwerking)
Traditionele VAD-technologie meet het energieniveau van een audiostream en bevestigt dat er spraak aanwezig was als dit een bepaalde drempel overschreed. Dit is puur wiskundig, vaak een root-mean-square-berekening (RMS) of zero-crossing rate-berekening (ZCR). Als een frame boven de drempel uitkomt, wordt het als spraak doorgegeven. Onder de drempel niet.
Traditionele VAD is snel en rekenkundig goedkoop, maar meet alleen het geluidsniveau in audio. Hard achtergrondgeluid kan false positives veroorzaken. Er is geen intelligentie die daadwerkelijk spraak herkent.
AI-gebaseerde VAD
Er zijn twee soorten nieuwere AI-gebaseerde VAD: neuraal en semantisch. In plaats van een puur wiskundige drempel te gebruiken, gebruikt neurale VAD een klein, sterk geoptimaliseerd neuraal netwerk om te bepalen of een audioframe spraak of stilte bevat. Dankzij hun training begrijpen ze het verschil tussen spraak en ruis, waardoor ze beter presteren dan traditionele VAD wanneer een audiostream een lage signaal-ruisverhouding (SNR) heeft, dus wanneer er veel achtergrondgeluid is.
Het nadeel van neurale VAD is dat deze nog steeds niet de spraak zelf herkent. Semantische AI-VAD is een andere variant die dat wel doet. Deze overlapt met endpointing doordat hij naar een audiofeed luistert om vast te stellen of uitgesproken gedachten volledig zijn. Hij kan grammaticaal en contextueel begrijpen of er mogelijk nog meer spraak volgt.
VAD versus endpointing
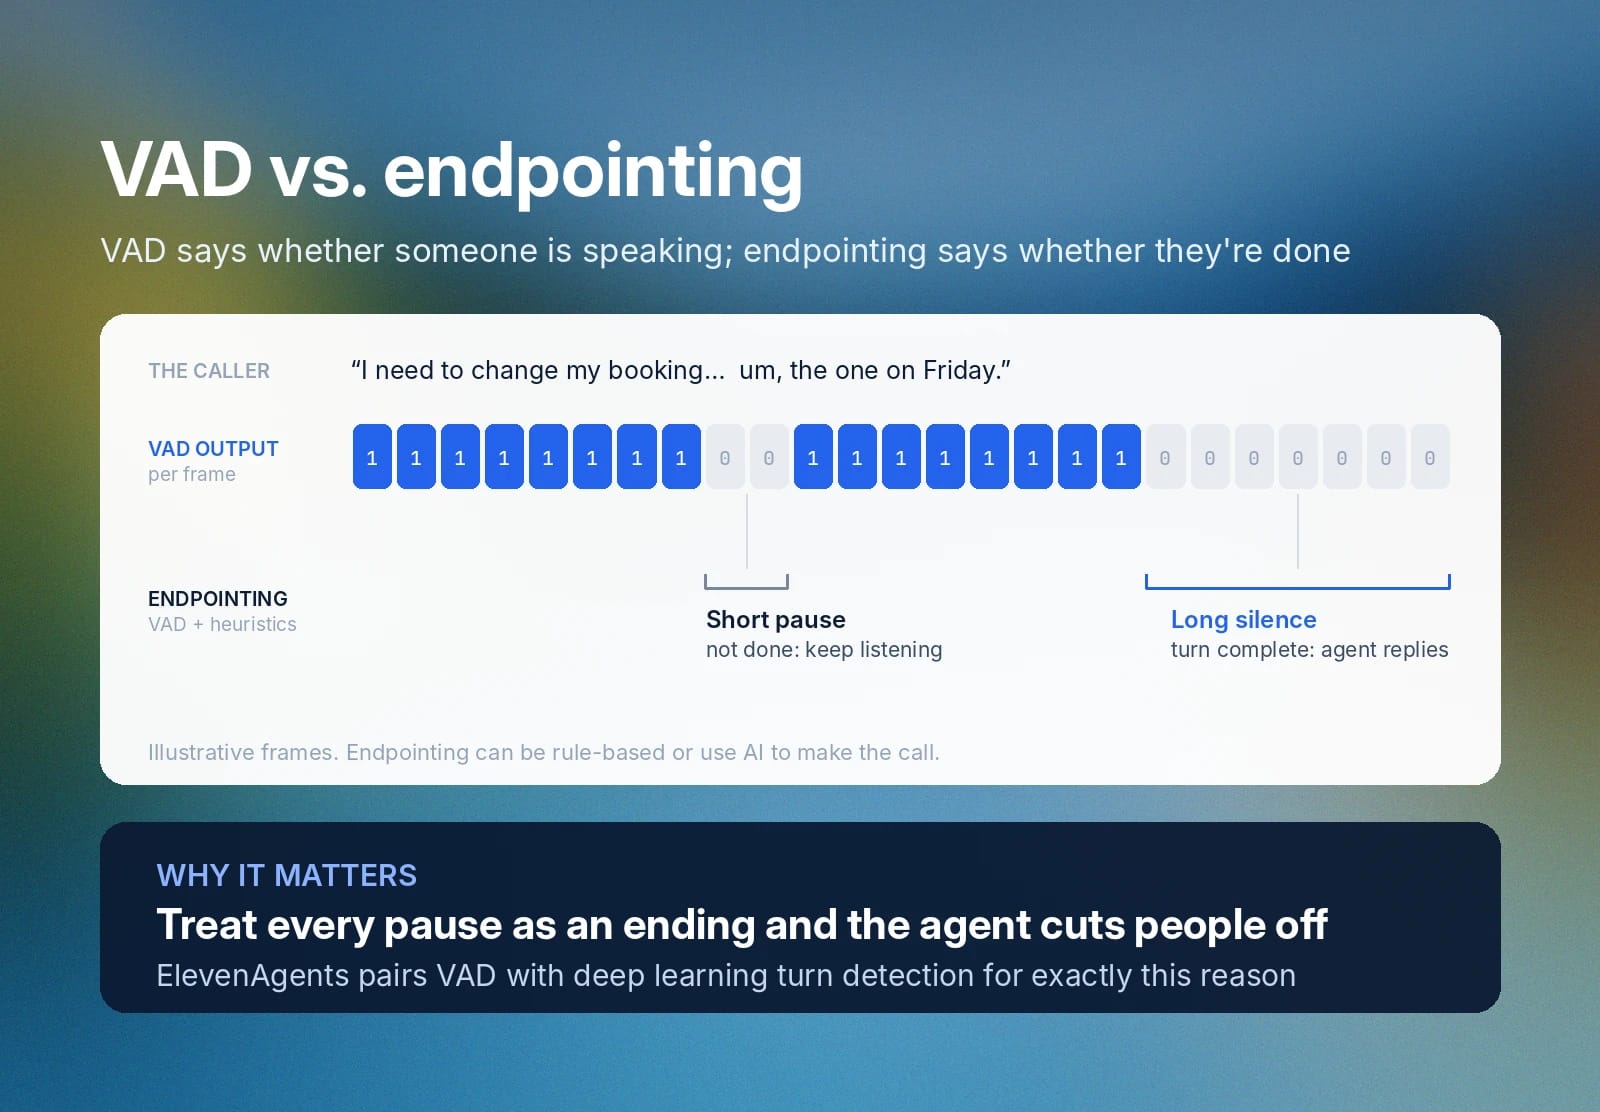
VAD en endpointing zijn complementaire technologieën. Een voice activity detection-systeem bepaalt simpelweg of iemand spreekt in elk audioframe dat het verwerkt. Het neemt een binaire ja-of-nee-beslissing en geeft die door aan de rest van de audioverwerkingspipeline.
Een endpointing-systeem gebruikt VAD-uitvoer, gecombineerd met heuristische analyse, om te bepalen of een spreker zijn gedachte heeft afgerond. Het kan hiervoor op regels gebaseerde signaalverwerking of AI gebruiken.
Toepassingen van voice activity detection in realtime AI
Voice activity detection is belangrijk voor diverse toepassingen.
Autonome voice agents en callcenters
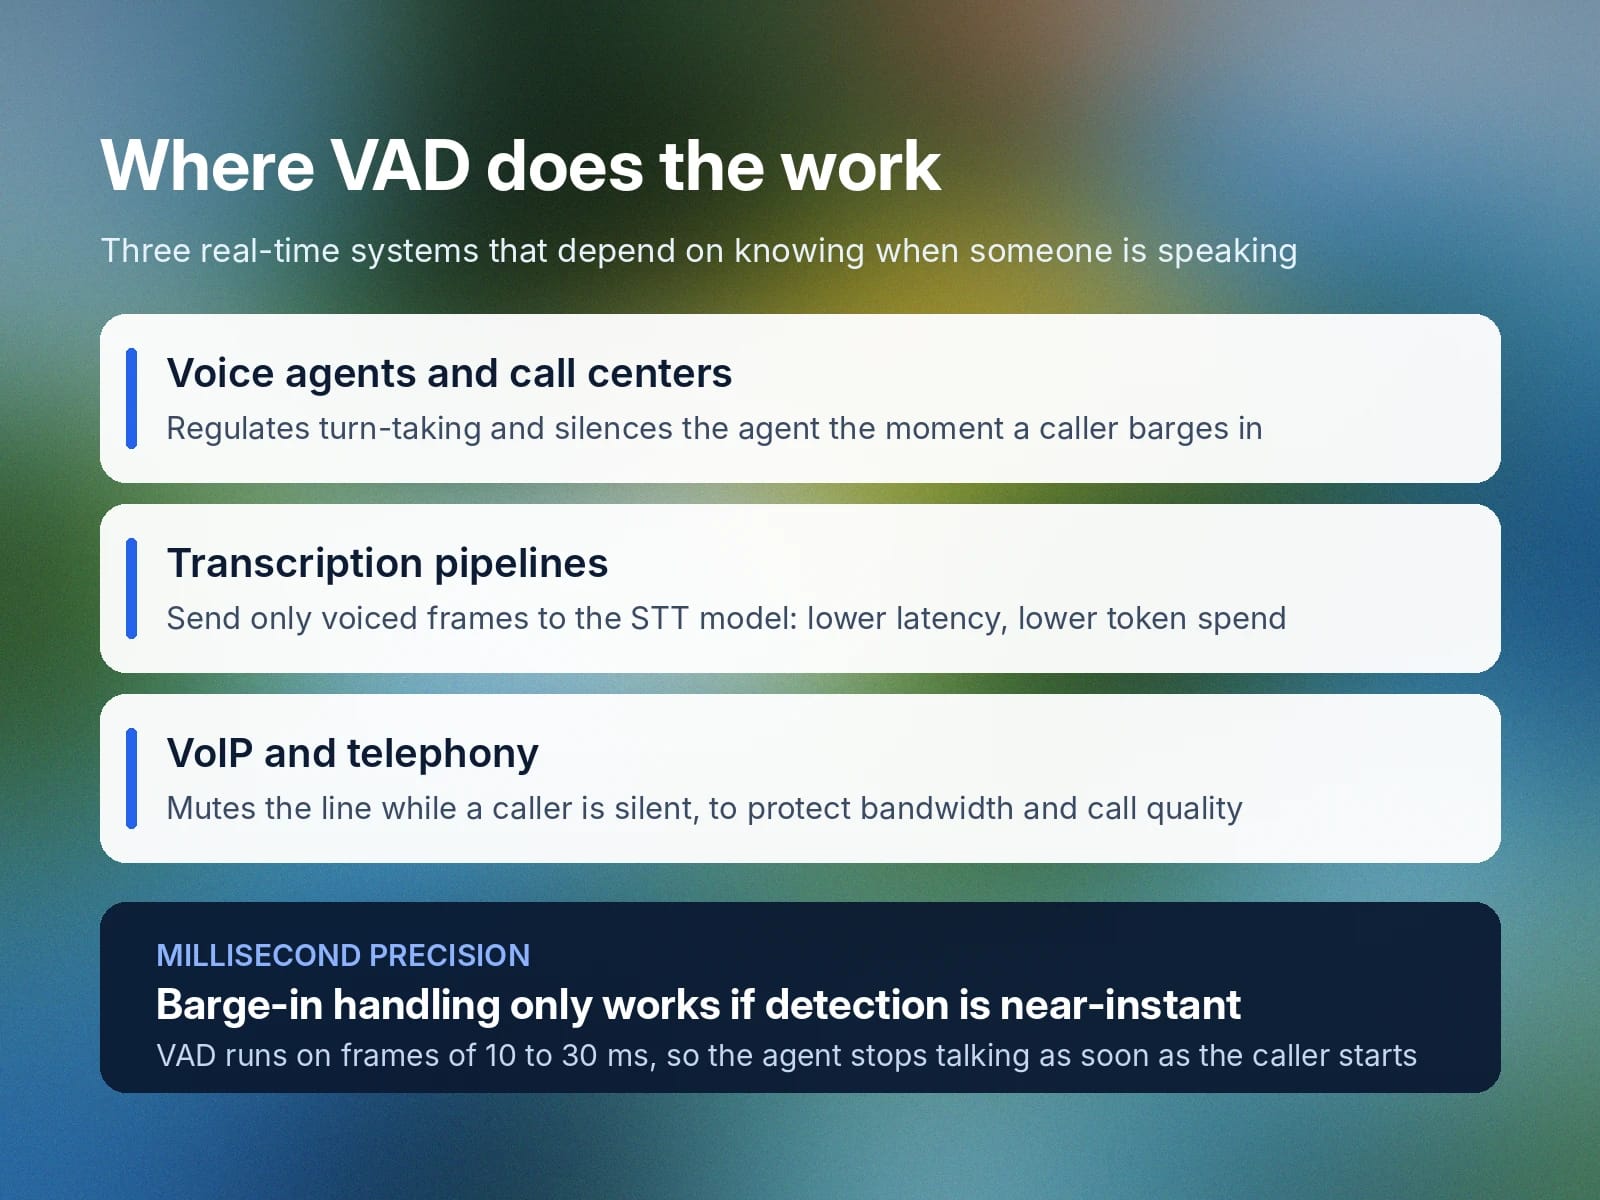
Een autonome agent die klantgesprekken screent, moet weten wanneer het passend is om te reageren. Je wilt niet dat de agent een klant midden in een zin onderbreekt of over een klant heen blijft praten wanneer die eerder antwoordt. VAD helpt beurtwisseling in gesprekken te reguleren en een natuurlijke flow in de interactie te behouden. Doordat het tot op de milliseconde werkt, is het ook zeer effectief in het beheren van “barge-in” door klanten: de agent wordt stilgezet wanneer de klant hem onderbreekt.
Transcriptiepijplijnen
Als je een Speech to Text-transcriptie-API-service gebruikt, zoals ElevenAPI, kun je de audio die je ernaartoe stuurt met voice activity detection filteren, zodat het model alleen frames met spraak verwerkt. Dat vermindert netwerklatentie en, nog belangrijker, verlaagt je tokenverbruik voor het transcriptiemodel. Zo verspil je geen AI-budget aan achtergrondgeluid.
Optimalisatie van VoIP en telefonie
Latentie kan ook de gesprekskwaliteit op VoIP-netwerken voor enterprises beïnvloeden. Om de prestaties te optimaliseren, dempen deze digitale audiosystemen met VAD tijdelijk een lijn wanneer een beller niet spreekt.
Wat maakt voice activity detection uitdagend?
Traditionele voice activity detection gebruikt wiskundige algoritmen om te bepalen of er spraak aanwezig is. Menselijke spraakpatronen zijn echter rommelig. Gesprekken zijn vaak onregelmatig, met onderbrekingen, en vinden plaats in praktijksituaties met achtergrondgeluid en zelfs nevenconversaties. De kernuitdaging van VAD is betekenisvolle stilte herkennen in audio met ruis.
Dit leidt tot enkele specifieke uitdagingen.
Pauzes midden in een zin
Mensen praten niet in een vast tempo gedurende een heel gesprek. Ze pauzeren, verzamelen hun gedachten, heroverwegen dingen terwijl ze praten en raken de draad kwijt. Geen van deze pauzes betekent dat een spreker klaar is met praten. Menselijke luisteraars begrijpen dat meestal gemakkelijk, maar voor software kan het lastig zijn, zelfs voor nieuwere AI-modellen.
Wanneer VAD-systemen deze pauzes aanzien voor afgeronde spraak, kan dat leiden tot afbrekingen midden in een zin tijdens een transactie of ertoe leiden dat een voice agent een menselijke spreker onderbreekt.
Stemgeluiden
Zachte spraak, wegstervende eindmedeklinkers (gebruikelijk aan het einde van een zin) en eigenschappen zoals vocal fry kunnen ervoor zorgen dat VAD-systemen legitieme spraak missen.
Onvoorspelbare akoestiek
Continue witte achtergrondruis, zoals een ventilator of stromend water, kunnen VAD-systemen relatief eenvoudig wegfilteren. Sporadische geluiden, zoals een blaffende hond, kunnen mogelijk worden aangemerkt als spookspraak.
Zware audiocompressie haalt dynamisch bereik weg en kan het voor VAD moeilijker maken om stille frames en spraakframes te onderscheiden.
Hoe je VAD-prestaties evalueert
Menselijke spraak is rommelig, vooral wanneer deze wordt opgenomen in dynamische praktijksituaties. Onberispelijke audio-opnames zijn geen goede manier om VAD-prestaties te testen. Pure nauwkeurigheid van speech to text meet ook niet rechtstreeks de effectiviteit van een VAD-systeem, aangezien dat volgt op wat VAD detecteert.
False positives versus false negatives
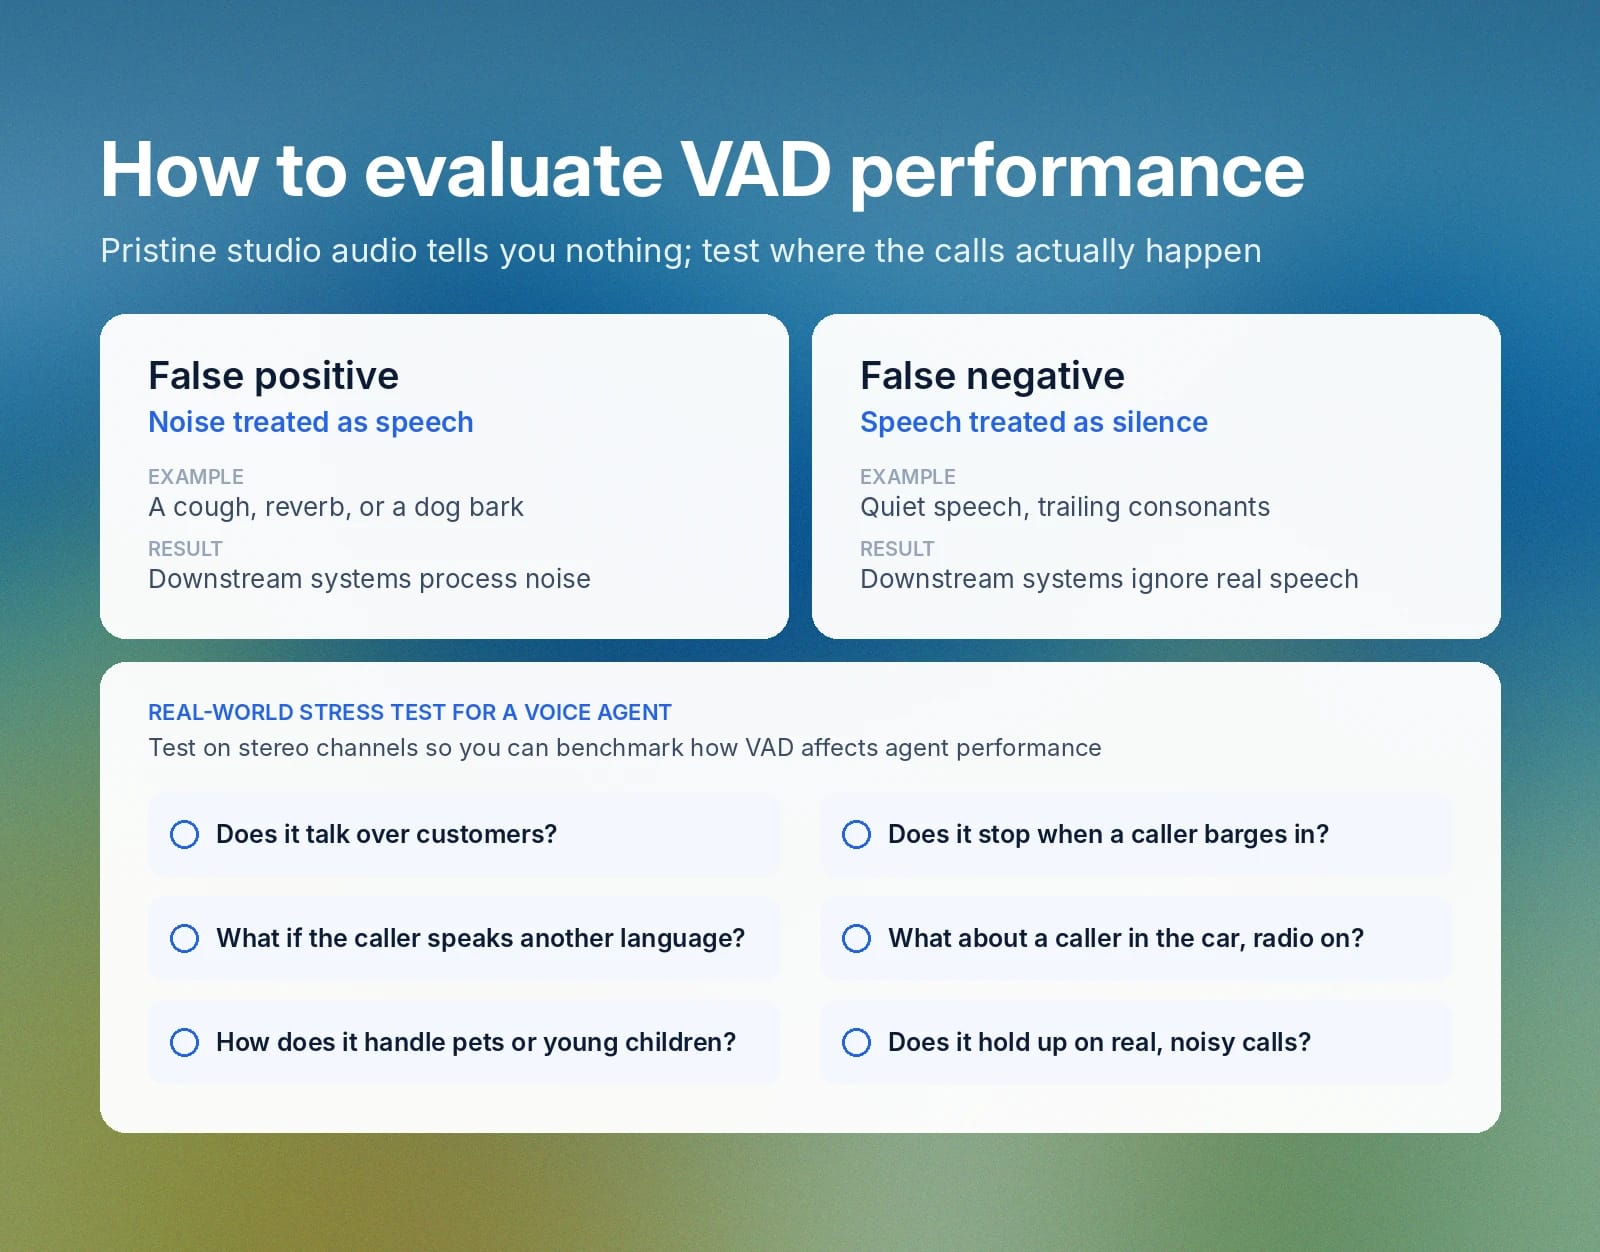
VAD-false positives zijn ruis die als spraak wordt behandeld. Een hoest, galm, blaffende hond en elk ander plotseling achtergrondgeluid kunnen er een veroorzaken en onbedoeld als spraakframes worden doorgegeven.
False negatives zijn spraak die als stilte wordt behandeld. VAD vertelt downstream services dan per ongeluk audioframes te negeren.
Stresstests in praktijksituaties
Om een VAD-service te evalueren, moet je zien hoe deze presteert in omgevingen waar audio wordt opgenomen en onder realistische omstandigheden.
Als je VAD bijvoorbeeld voor een voice agent gaat gebruiken, test dan met stereokanalen zodat je kunt benchmarken hoe dit de prestaties van de agent beïnvloedt. Vragen zoals de volgende kunnen opkomen:
- Zijn er false negatives waardoor de agent over klanten heen praat?
- Zorgt het ervoor dat de agent stopt met praten wanneer een gebruiker hem onderbreekt?
- Wat gebeurt er als de beller een vreemde taal spreekt?
- Hoe werkt het bij het luisteren naar sprekers die bellen vanuit praktijksituaties?
- Wat gebeurt er wanneer een klant vanuit de auto belt maar de radio niet zachter zet?
- Hoe goed werkt het met achtergrondgeluid van huisdieren of jonge kinderen?
Al deze omstandigheden komen waarschijnlijk voor bij klantgesprekken. VAD moet ze aankunnen en onder druk goed presteren.
Ga aan de slag met ElevenAgents voor klantenservice
ElevenAgents gebruikt een hybride VAD- en deep learning-systeem voor turn detection om gesprekken met agents natuurlijk en vloeiend te houden.
Begin vandaag met het bouwen van een nieuwe klantenserviceagent met ElevenAgents. Registreer om aan de slag te gaan.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.



