
Interactiemodellen: natuurlijke dialoog tussen mens en AI
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Iedereen die ooit heeft geprobeerd een AI-stemagent midden in een zin te onderbreken, weet hoe het voelt wanneer een systeem niet is gebouwd voor menselijke gesprekken. Het ritme klopt niet, de stem staat los van de inhoud en zelfs als de informatie correct is, voelt de interactie vreemd: niet alsof je met een deskundig persoon praat, maar alsof je door software navigeert die toevallig woorden gebruikt.
De oorzaak van dit onnatuurlijke gevoel is structureel: veel voice AI-systemen zijn gebouwd om beurten af te handelen, niet om gesprekken te voeren. Ze luisteren, verwerken en reageren steeds op één uitwisseling tegelijk. Dat werkt voor eenvoudige demo's, maar valt uiteen zodra een gesprek emotioneel en onvoorspelbaar wordt.
Interactiemodellen zijn AI-systemen die zijn ontworpen om in realtime via audio en tekst te communiceren. Ze nemen niet alleen waar wat er wordt gezegd, maar ook wanneer het wordt gezegd en wat voor emotionele reactie het moment vraagt. Dit artikel legt uit wat een interactiemodel anders maakt, waarom dat belangrijk is voor bedrijven die voice AI inzetten en hoe ElevenLabs hiernaartoe werkt.
Samenvatting
- De meeste voice AI werkt niet goed in echte gesprekken omdat het niet overweg kan met onderbrekingen, stiltes of context die tussen beurten behouden blijft.
- De interactiestack van ElevenLabs is ontworpen om onderbrekingen, pauzes en overlappende spraak af te handelen zonder context te verliezen of de gespreksstroom te verstoren.
- ElevenLabs werkt aan echte interactiemodellen met een geavanceerde cascaded architectuur, eigen Speech to Text (STT) en Text to Speech (TTS), en een stack die is geoptimaliseerd voor lage latentie en natuurlijke gesprekken die heen en weer gaan.
Waarom de meeste menselijke voice AI-communicatie niet natuurlijk voelt
De meeste voice AI behandelt een gesprek als een reeks afzonderlijke inputs en outputs: het systeem wacht op een blok spraak, zet dat om in tekst, verwerkt die tekst en antwoordt. Dit werkt voor interacties op basis van opdrachten en antwoorden, maar een echt gesprek is geen nette reeks tekstuitwisselingen. Het is een voortdurende wisselwerking vol pauzes en tussenwerpsels.
Door de stroom tussen beurten en de context die daarin doorloopt weg te nemen, ontstaan drie specifieke problemen:
- Het onderbreekt je of laat je wachten: Het systeem kan een denkpauze niet onderscheiden van een afgeronde beurt, waardoor het óf begint terwijl je nog praat óf stil blijft nadat je bent gestopt. Verzamel je midden in een zin je gedachten, dan word je onderbroken; rond je je punt af, dan wacht je door een moment van stilte heen.
- Het kan niet reageren zodra het begint te praten: Zodra het systeem begint te antwoorden, stopt het met luisteren. Als je onderbreekt om bij te sturen, blijft het antwoord geven op een vraag waar je al van bent afgestapt, omdat het niet kan registreren dat er iets is veranderd.
- Het vergeet gaandeweg: Elke beurt wordt afzonderlijk verwerkt, waardoor context van vijf uitwisselingen geleden niet behouden blijft. Je moet jezelf dan herhalen, of het systeem reageert alsof het gesprek net is begonnen.
Het resultaat is een gesprek dat functioneel correct kan zijn, maar toch verkeerd voelt.
Wat interactiemodellen kunnen wat traditionele voice AI niet kan
Waar traditionele voice AI één beurt tegelijk afhandelt, beheert een interactiemodel het volledige gesprek en houdt het tegelijk rekening met wat er wordt gezegd en wat er vervolgens moet gebeuren. Het functionele verschil is dat een interactiemodel reageert op de werkelijke toestand van de uitwisseling, niet alleen op de meest recente input.
Interactiemodellen hebben:
- Realtime reacties: Het systeem is ontworpen om op gesprekssnelheid te reageren, met een end-to-endcyclus die, afhankelijk van de configuratie, in minder dan een seconde kan verlopen.
- Natuurlijke omgang met onderbrekingen, stiltes en overlap: Het maakt onderscheid tussen een denkpauze en een afgeronde beurt, zodat het mensen niet onderbreekt en geen dode stiltes laat vallen. En wanneer de klant erdoorheen praat om bij te sturen, beheert het de overlap zonder context te verliezen of het gesprek te laten vastlopen.
- Continuïteit in de volledige uitwisseling: In plaats van de context bij elke beurt opnieuw in te stellen, neemt het systeem de gespreksgeschiedenis mee, zodat wat het bij beurt 10 zegt alles weerspiegelt wat er sinds beurt één is gebeurd.
- Adaptieve spreekstijl: De stem kan worden geprogrammeerd om van stijl te veranderen (rustiger, directer, meer geruststellend), afhankelijk van het soort taak dat hij uitvoert.
- Parallelle taakuitvoering: Het systeem haalt informatie op, voert tool calls uit en blijft tegelijk praten, in plaats van stil te vallen terwijl het iets opzoekt.
De test voor een interactiemodel is een gesprek dat slecht verloopt. In de opname hieronder belt een klant over een geannuleerde vlucht. De klant is gespannen en heeft snel een oplossing voor het probleem nodig.
De agent herkent onmiddellijk aan de woorden van de klant de urgentie en frustratie. Hij past zijn toon aan, handelt de onderbreking af zonder de draad kwijt te raken en gebruikt de gekoppelde tools om echte oplossingen voor de geannuleerde vlucht te bieden. Uiteindelijk krijgt de klant een oplossing zonder dat er een menselijke agent nodig is.
Vergelijk dit met de typische turn-based agents die vandaag worden gebruikt. Deze systemen wachten bij elke pauze, antwoorden vanuit een neutrale basis en missen de frustratie van de klant volledig. Na een paar uitwisselingen die niet ingaan op wat de beller werkelijk voelt, zou het gesprek waarschijnlijk moeten worden doorgezet naar een mens, waardoor de klant gefrustreerder achterblijft dan bij het begin.
Hoe ElevenLabs werkt aan interactiemodellen
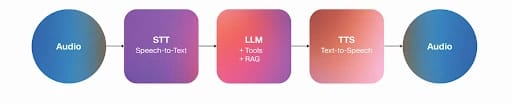
Onze gesprekspipeline gebruikt een geavanceerde cascaded architectuur in plaats van een fused architectuur. In plaats van dat één model alles afhandelt, is elke fase een eigen gespecialiseerd component.
Het voordeel van deze aanpak is dat we elke fase van de pipeline onafhankelijk kunnen optimaliseren en voor elk component een beter model kunnen inzetten zonder het hele systeem opnieuw te bouwen. En omdat we die componenten zelf bouwen, zijn ze gezamenlijk geoptimaliseerd om rijke context aan elkaar door te geven, niet alleen data. Daardoor gedraagt de pipeline zich nog steeds als één samenhangend gesprek, in plaats van als een keten van afzonderlijke tools.
Structuur van het cascaded model
Structuur van het fused model
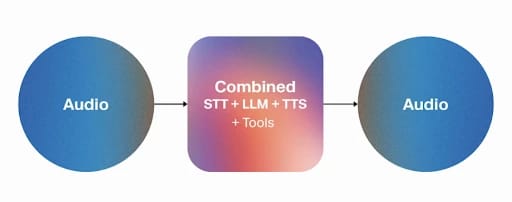
Afbeeldingen: cascaded versus fused modellen
Dit is de technologie waaruit de pipeline momenteel bestaat:
- Scribe v2 Realtime: Ons eigen STT-model transcribeert spraak in ongeveer 150 ms in meer dan 90 talen en blijft goed werken bij achtergrondgeluid, accenten, onderbrekingen en non-verbale gebeurtenissen zoals lachen en pauzes. Het is ook gebouwd voor domeinspecifieke woordenschat, van medische termen tot financieel jargon.
- Speculatieve beurtwisseling: Dit systeem bepaalt wanneer het moet spreken, pauzeren of wachten door de gespreksstroom te lezen, in plaats van te vertrouwen op een harde drempel voor stilte. Verbeteringen aan ons voice activity detection-model helpen achtergrondspraak en korte reacties beter te filteren, waardoor beurtwisseling natuurlijker aanvoelt.
- Eleven v3 Conversational: Een van onze meest expressieve TTS-modellen, gebouwd voor live dialogen die heen en weer gaan. Het neemt de emotionele lading van het gesprek mee tussen beurten, zodat de spreekstijl van de agent bij beurt 10 alles weerspiegelt wat eraan voorafging, niet alleen de meest recente reactie.
- Expressive Mode: Gebouwd op Eleven v3 Conversational en het beurtwisselingssysteem, Expressive Mode bepaalt hoe de agent op dat moment klinkt. De agent de-escaleert wanneer klanten gefrustreerd zijn, stelt gerust wanneer ze in de war zijn en is direct wanneer duidelijkheid nodig is. Ook leest het expressieve tags, zodat het model signalen zoals [laughs], [whispers] of [sighs] kan gebruiken om specifieke momenten in de spreekstijl vorm te geven.
- Flash v2.5: Ons TTS-model met lage latentie ondersteunt 32 talen en genereert spraak in minder dan 75 ms. Wanneer latentie prioriteit heeft, houdt het de reactietijd binnen het bereik van een natuurlijk menselijk ritme.
- Speech Engine: De verbindende laag die de stack samenbrengt en je server via WebSocket koppelt aan onze ElevenAPI, met één verbinding per gesprek. Wij verzorgen STT en TTS terwijl je server de LLM uitvoert, zodat technische teams hun eigen model kunnen gebruiken en de gesprekslogica op hun eigen infrastructuur kunnen houden.
Deze modellen worden voortdurend verbeterd en nieuwe versies verschijnen regelmatig. Elke nieuwe release verkleint de kloof tussen met software praten en met een persoon praten, met snellere reacties, scherpere emotieherkenning, meer talen en vloeiendere spreekstijl.
Praten terwijl je nadenkt
Niet elk onderdeel van een interactiemodel hoeft in een strikte volgorde te werken. ElevenAgents kan op de achtergrond blijven werken terwijl het gesprek doorgaat, in plaats van standaard stil te blijven tussen een vraag en een antwoord.
Een aantal kernsystemen werkt samen om tegelijk te kunnen praten en nadenken:
- Parallelle tool calls: De agent kan een database raadplegen, een tool uitvoeren of de bestelstatus controleren terwijl hij nog spreekt, zodat het ophalen van informatie nooit voelt als een dode pauze in het gesprek.
- Soft timeout: Als een LLM langer dan verwacht nodig heeft om een antwoord te genereren, zegt de agent een korte opvulzin zoals “Even nadenken” of “hmmm”, in plaats van een ongemakkelijke stilte te laten vallen. Soft timeout helpt een natuurlijke gespreksstroom te behouden en verkleint de kans op onderbrekingen.
- Termen die onderbrekingen negeren:In plaats van een vaste stiltedrempel te gebruiken, probeert het systeem de betekenis van wat er wordt gezegd te interpreteren om aan te voelen wanneer een beurt echt is afgelopen. Ook kunnen korte bevestigingen zoals “oké” of “mm-hmm” zo worden ingesteld dat ze worden doorgelaten zonder een volledige onderbreking te activeren, zodat de agent niet telkens de draad kwijtraakt wanneer de beller iets tussendoor zegt.
Samen zorgen deze systemen ervoor dat de agent niet voelt alsof hij aan het bufferen is of een antwoord aan het laden is. Ze vormen een gestroomlijnde gespreksengine die de tussenruimte op natuurlijke wijze opvult, zoals een persoon dat zou doen, terwijl informatie tegelijk wordt verwerkt en gedachten op de achtergrond worden geordend.
Hoe een gesprek met ElevenLabs in de praktijk werkt
De bovenstaande componenten werken niet netjes één voor één. Ze overlappen. Zo zou een agent van ElevenLabs omgaan met een beller die halverwege een supportgesprek vraagt: "Is mijn bestelling al verzonden, of wordt die nog verwerkt?"
- De beller spreekt: Audio streamt via de WebSocket-verbinding naar ElevenLabs en Scribe begint in realtime te transcriberen, ongeveer 150 ms achter de stem.
- Het systeem leest de stroom:Terwijl Scribe nog transcribeert, beoordeelt speculatieve beurtwisseling al of de beller klaar is of nog midden in een gedachte zit. Het afsluitende "of wordt die nog verwerkt?" wordt opgevat als een overdracht in plaats van een pauze, waardoor de volgende stap wordt gestart in plaats van in stilte te wachten.
- De LLM stelt context samen en reageert:De getranscribeerde vraag gaat naar de LLM, samen met de gespreksgeschiedenis, de bestelgegevens die via RAG uit de eigen systemen van het bedrijf zijn opgehaald, tooloutputs van eerder in het gesprek en de systeemprompt. De LLM redeneert over al deze informatie en genereert een antwoord dat is gebaseerd op de werkelijke bestelling van de beller, niet op een algemene statusmelding.
- Het TTS-model synthetiseert het antwoord:De tekst wordt natuurlijk klinkende audio. Als Expressive Mode actief is, bevat het antwoord spreekaanwijzingen die bij het moment passen, zodat een routinematige update ontspannen en zonder haast klinkt in plaats van vlak. Wanneer latentie prioriteit heeft, verzorgt Flash de synthese in minder dan 75 ms.
- Het antwoord streamt terug:Audio begint af te spelen voordat de synthese is voltooid, zodat de beller het begin van het antwoord hoort terwijl de rest nog wordt gegenereerd.
- De cyclus herhaalt zich: Elke nieuwe beurt neemt de toon, context en geschiedenis van het gesprek mee.
Tijdens dit snelle proces voelt het gesprek natuurlijk. De beller past zich niet langer aan de machine aan: die praat niet langzamer, articuleert niet overdreven en wacht niet op een pieptoon. Die praat gewoon, zoals met een persoon.
Zet natuurlijk klinkende stemagenten in binnen je hele bedrijf
Alles wat hier wordt beschreven, is vandaag in productie, niet slechts een roadmap. Van de cascaded architectuur tot de sub-secondepipeline, bedrijven over de hele wereld gebruiken al ElevenAgents om echte klantgesprekken op schaal af te handelen.
Dat geldt ook voor gereguleerde omgevingen met veel op het spel, omdat onze agentarchitectuur guardrails, auditlogs en compliancecontroles ondersteunt. ElevenLabs is gecertificeerd voor SOC 2 Type II, ISO 27001, HIPAA en PCI DSS Level 1, met Zero Retention Mode en regionale dataresidency voor teams die data binnen een specifieke grens moeten houden.
Klaar om een agent aan het werk te zetten? Je kunt een agent maken en beginnen met bouwen in de console, of met ons salesteam praten over een implementatie die is afgestemd op je omgeving.
Veelgestelde vragen over interactiemodellen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.



