Cascaded versus Fused Models: hoe architectuur bepaalt of je voice agent klaar is voor ondernemingen
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
De meeste mensen denken dat spraakagenten worden gebouwd met een cascaded of fused architectuur. In de praktijk worden agenten ontworpen op een spectrum tussen beide, waarbij doorgaans vijf architecturen worden gebruikt, afhankelijk van de toepassing.
De architectuur van de agent bepaalt of deze zich betrouwbaar gedraagt in productie, zich kan aanpassen aan specifieke bedrijfsvereisten en natuurlijk klinkt in gesprekken. Een fusion-based architectuur zoals het Realtime-model van OpenAI kan in korte gesprekken indrukwekkend levensecht klinken. Maar wanneer teams complianceguardrails moeten afdwingen, een mislukte reactie moeten debuggen of een sterkere LLM willen inzetten zodra er volgende maand een beschikbaar komt, biedt één fused netwerk weinig mogelijkheden.
Bij ElevenLabs gebruiken we een geavanceerde cascade-based architectuur. We zetten gespecialiseerde componenten in voor spraakherkenning, redeneren en spraakgeneratie, voor een hoog niveau van intelligentie en betrouwbaarheid. We voegen contextuele prosodie, low-latency-optimalisatie en intelligente beurtwisseling toe, zodat gesprekken natuurlijk verlopen. We hebben dit zo gebouwd omdat de bedrijven en overheden waarmee we werken agenten nodig hebben die zowel realistisch klinken als betrouwbaar kunnen worden ingezet voor complexe taken in productie.
In dit artikel bespreken we de vijf belangrijkste architecturen, waar ze goed in zijn, waar hun beperkingen liggen en hoe wij kijken naar de basis voor agenten die in kritieke workflows worden ingezet.
Wat teams beoordelen bij het kiezen van een architectuur
De vragen die teams stellen, vallen doorgaans in drie categorieën.
Kan het complexe taken uitvoeren?
- Redeneren en modelflexibiliteit: Kun je de beste modellen voor je use case kiezen, waaronder de krachtigste beschikbare LLM's, en upgraden zodra er betere opties beschikbaar zijn?
- Agentlogica: Kun je de gespreksflows, beslisregels en escalatiepaden definiëren en beheren die je agent volgt?
- Toolgebruik: Kan de architectuur tool calling in meerdere stappen en integraties met externe systemen ondersteunen?
Klinkt en voelt het menselijk?
- Prosodie: Geeft de agent een natuurlijk ritme, natuurlijke intonatie en emotionele toon weer?
- Latency: Zijn reacties snel genoeg om als een gesprek te voelen?
- Beurtwisseling: Weet de agent wanneer hij moet spreken, pauzeren of het woord moet geven?
Kan ik erop vertrouwen in productie?
- Betrouwbaarheid: Gedraagt de agent zich voorspelbaar en consistent, of wijkt hij na verloop van tijd af?
- Guardrails: Kan de architectuur bescherming bieden tegen ongewenste reacties of kwaadwillende gebruikers?
- Transparantie: Produceert de architectuur tussenresultaten, of is het een black box?
De afwegingen tussen cascaded en fused architecturen
Cascade-based architecturen worden gebouwd door gespecialiseerde componenten aan elkaar te koppelen: Speech to Text (STT), een Large Language Model en Text to Speech (TTS). Elke fase kan onafhankelijk worden geoptimaliseerd, getest en geüpgraded.
Cascaded architectuur
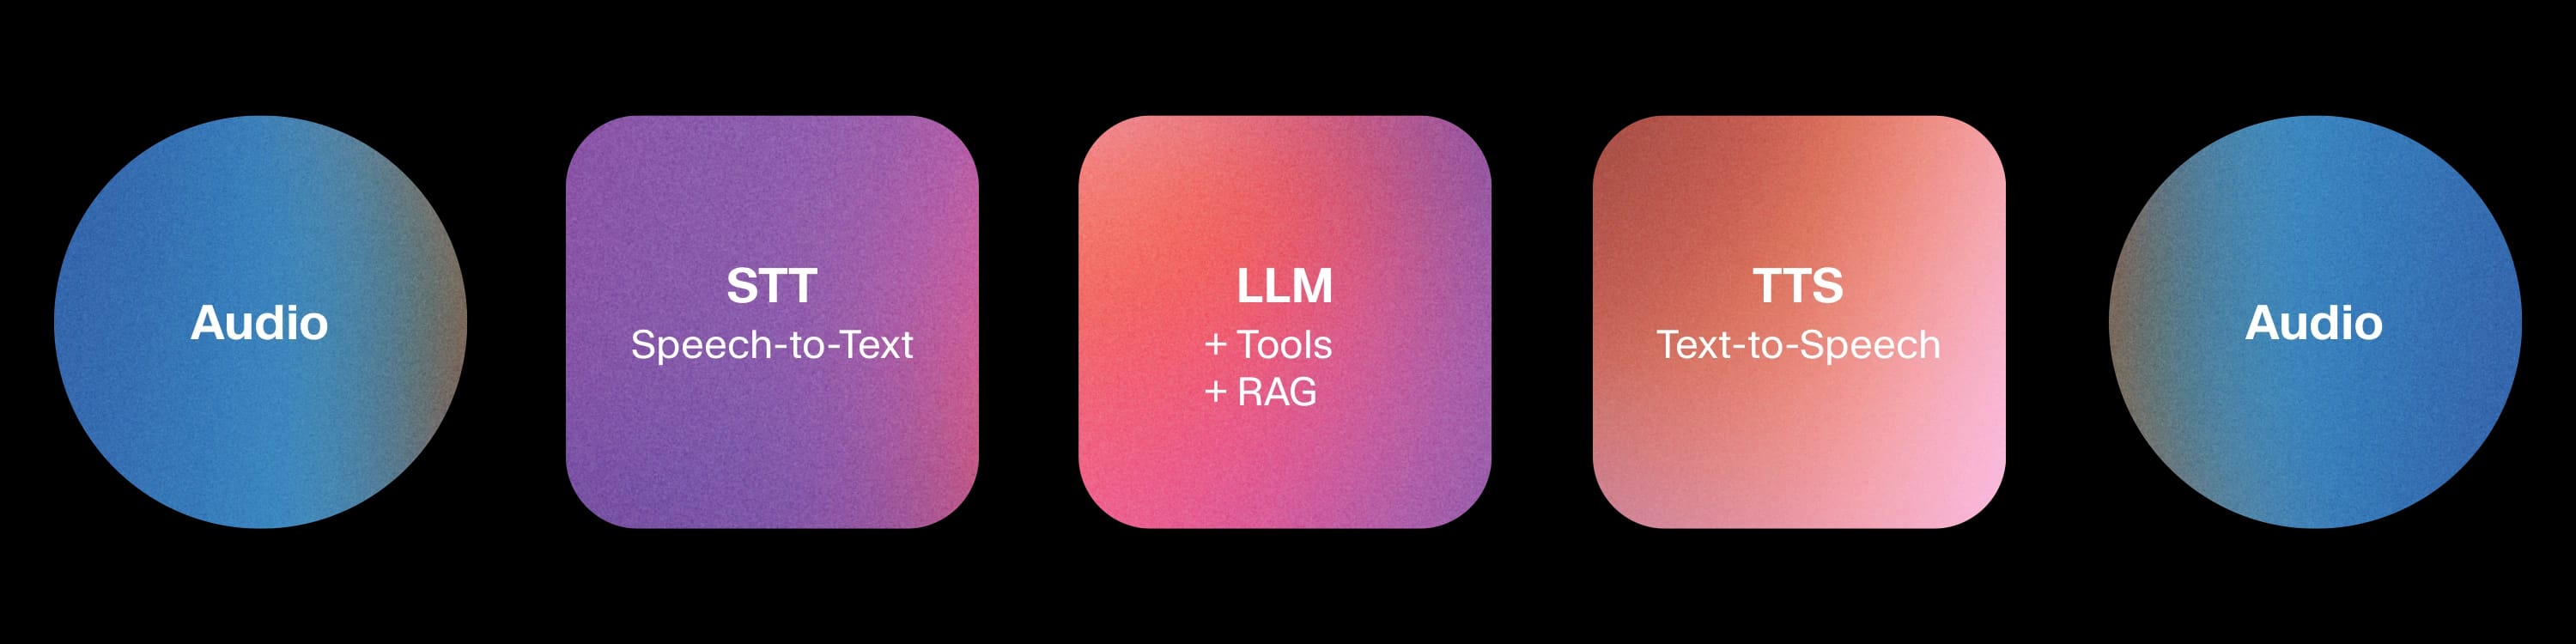
Die modulariteit maakt cascaded architecturen tot de basis van de meeste agents op enterpriseniveau. Elke fase produceert controleerbare output: leesbare tekst tussen STT en de LLM, en tussen de LLM en TTS. Guardrails kunnen worden afgedwongen op de tekstlaag, de nieuwste frontier LLM kan worden geïntegreerd zonder de spraakmodellen aan te passen en wanneer iets mislukt, is de oorzaak doorgaans te achterhalen.
De al lang bestaande kritiek op cascaded architecturen is dat ze prosodische signalen verliezen. Spraak wordt teruggebracht tot tekst, en intonatie, ritme en emotie moeten aan de uitvoerkant worden gereconstrueerd. Deze signalen kunnen gedeeltelijk worden hersteld door expliciete modellering, maar worden niet zo natuurlijk vastgelegd als bij fused benaderingen. Andere dimensies, zoals latency en beurtwisseling, kunnen in beide benaderingen doorgaans worden geoptimaliseerd tot vergelijkbare prestatieniveaus.
Fused model
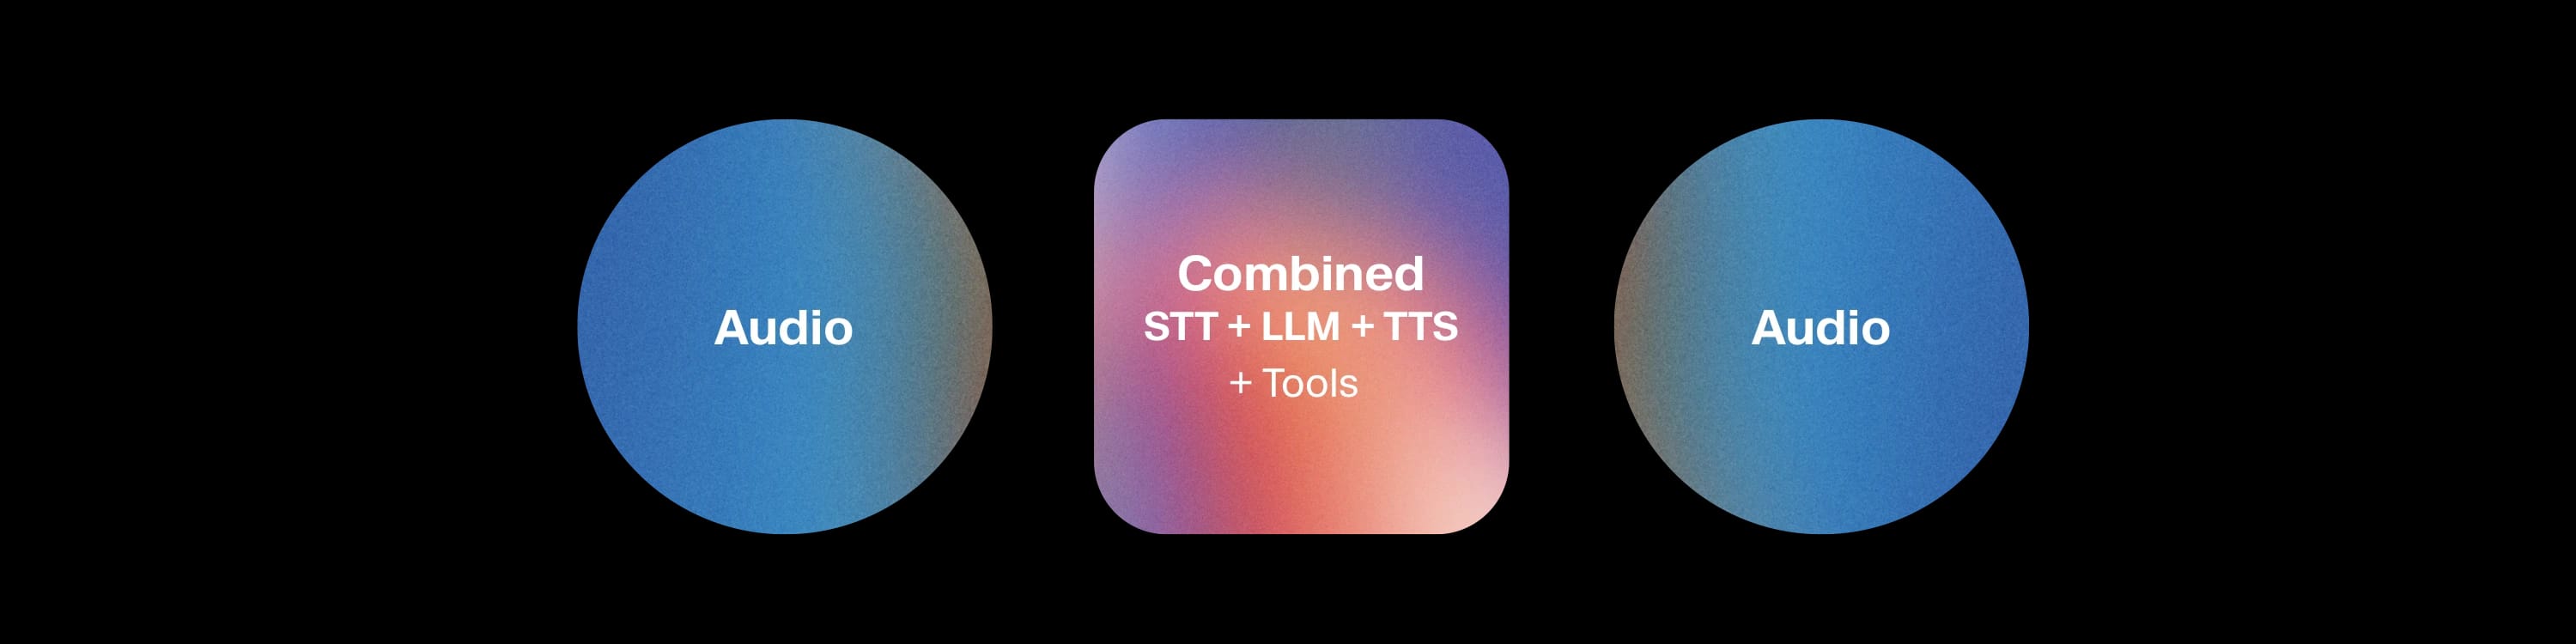
Fused architecturen hanteren een fundamenteel andere aanpak. Herkenning, redeneren en generatie vinden allemaal plaats binnen één multimodaal netwerk. Audio gaat erin en audio komt eruit, zonder controleerbare laag ertussen.
Dit gebrek aan tussenliggende fasen is zowel de aantrekkingskracht als de beperking. Een fused architectuur kan prosodische signalen natuurlijk behouden, omdat spraak nooit wordt opgesplitst in tekst. De mogelijkheden om guardrails af te dwingen, afzonderlijke componenten te vervangen of tussenresultaten voor debugging te inspecteren, zijn echter beperkt. Er zijn ook beperkingen bij het finetunen van STT voor branchespecifieke terminologie of het integreren van een andere LLM voor sterker redeneren en tool calling. Het systeem is één netwerk en teams zijn beperkt tot de redeneercapaciteiten waarmee het wordt geleverd. Dat betekent vandaag de dag lichtere kernen die niet kunnen tippen aan frontier LLM's bij complexe taken.
De vijf architecturen
1. Basic Cascaded
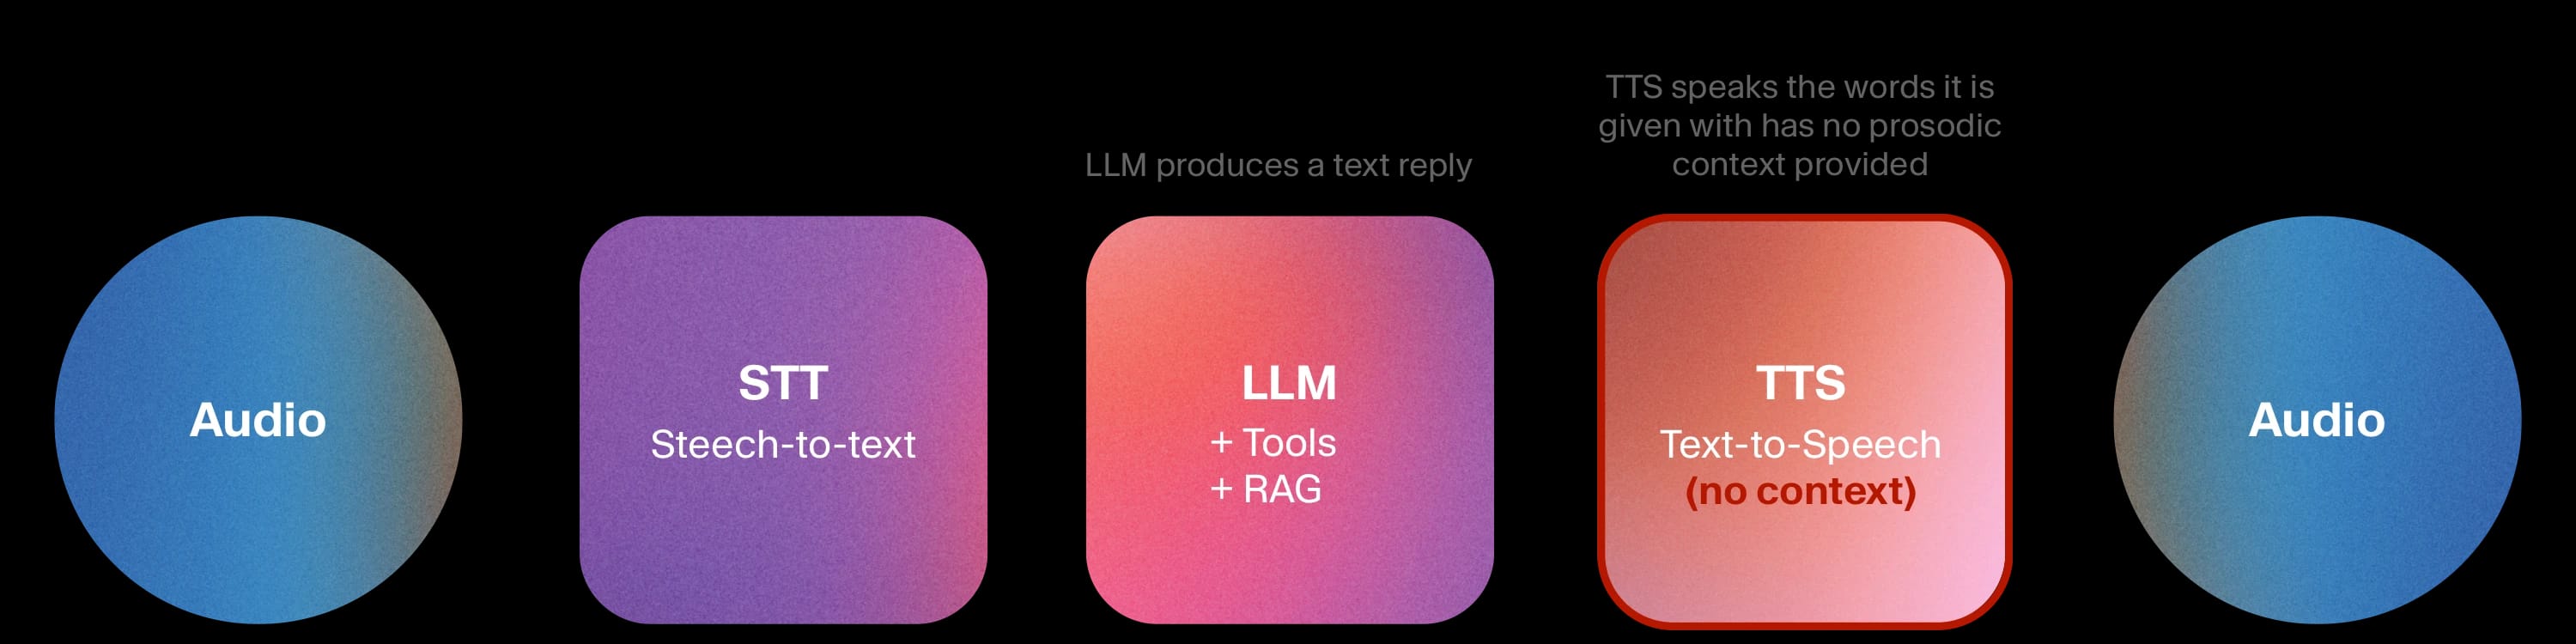
Audio wordt getranscribeerd, de LLM genereert een tekstantwoord en TTS spreekt dit uit. Elke fase werkt met platte tekst, zodat je alles kunt bekijken, testen en beheren.
De voordelen voor vertrouwen zijn duidelijk: guardrails op de tekstlaag, deterministische gespreksflows en volledige audittrails. Omdat de LLM een zelfstandige component is, kun je de agent koppelen aan het frontier model met de sterkste capaciteiten voor redeneren of tool calling, en upgraden zodra er een beter model beschikbaar is. Het zwakke punt is de gesprekskwaliteit: zonder contextuele TTS klinkt de agent functioneel maar vlak. Er is geen emotionele aanpassing of prosodische variatie, wat acceptabel is bij het voorlezen van rekeningsaldi, maar onvoldoende voor het helpen van een gefrustreerde klant.
Voorbeelden van use cases:
- IVR-vervangers in telecom en nutsvoorzieningen
- FAQ-afhandeling voor SaaS-onboarding
- Uitgaande meldingen, zoals afspraakbevestigingen, herinneringen aan recepten en bezorgmeldingen, waarbij consistentie belangrijker is dan warmte
2. Advanced Cascaded
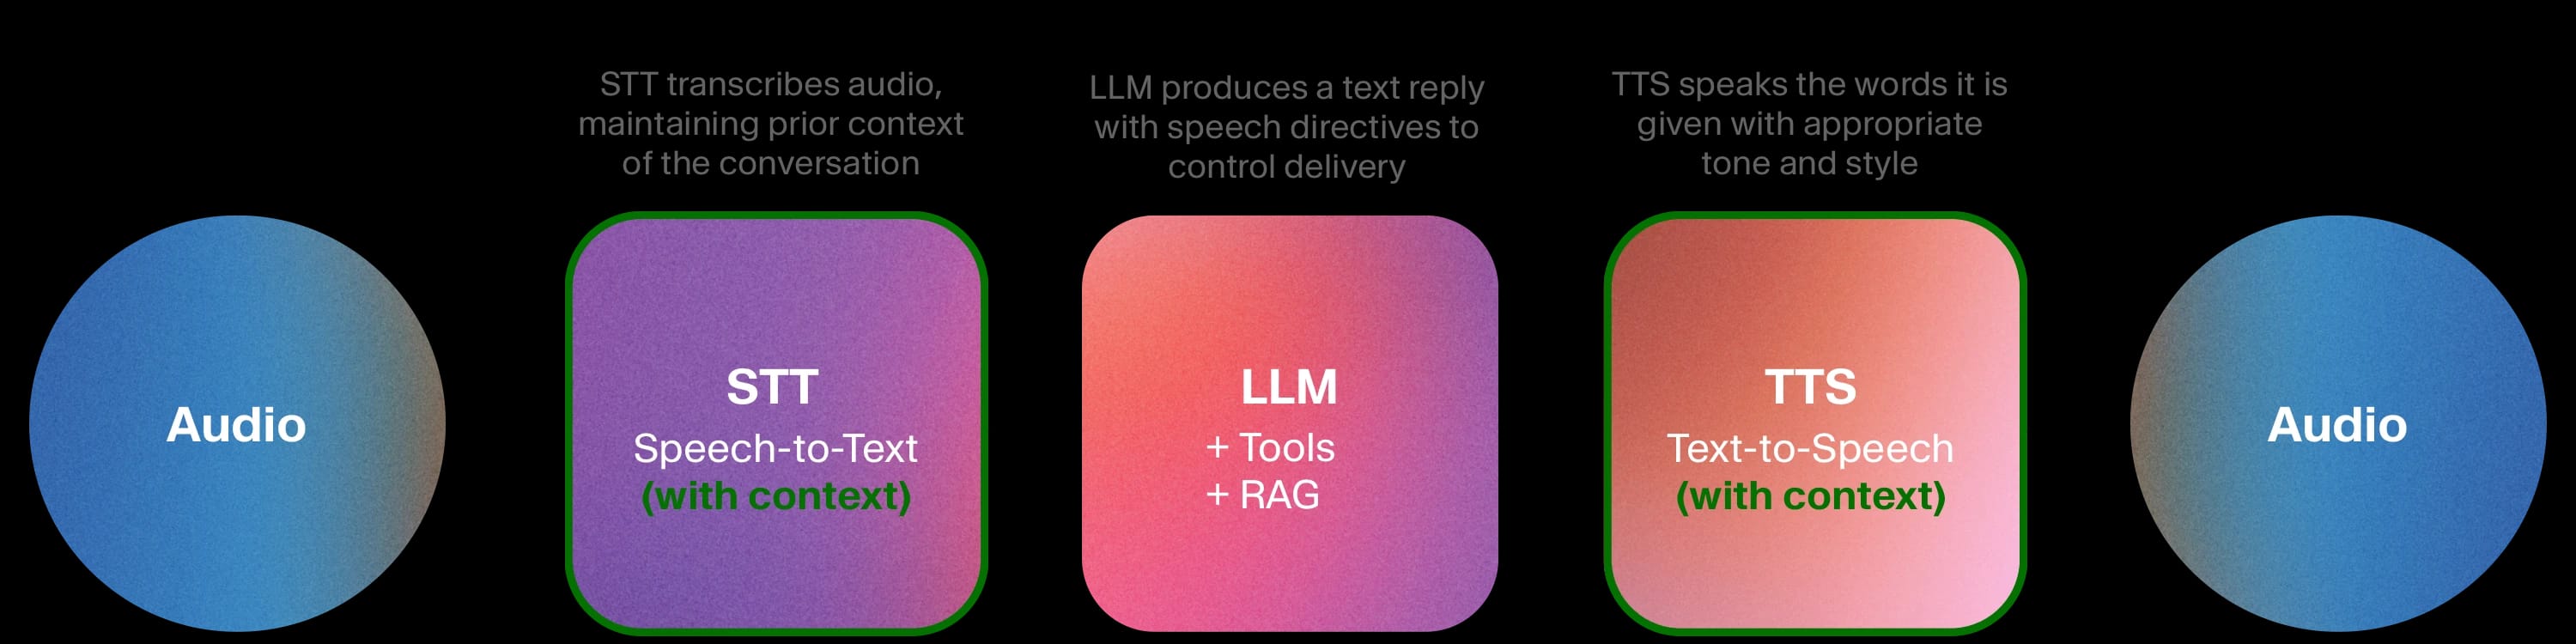
Dezelfde modulaire architectuur, maar nu werken meerdere componenten met rijkere context. Dit hebben we gebouwd met Expressive Mode in ElevenAgents.
Het Scribe v2 Realtime STT-model levert snelle, nauwkeurige transcriptie op basis van de eerdere context van het gesprek. Op basis van de tekst instrueert de LLM de TTS hoe de spraak moet worden uitgesproken – niet alleen wat er moet worden gezegd – bijvoorbeeld „geruststellend”, „met nadruk” of „met urgentie”, waarbij de toon dynamisch wordt aangepast gedurende het gesprek. Het systeem voor beurtwisseling gebruikt dezelfde signalen, zodat de agent kan bepalen wanneer hij moet reageren en wanneer hij het woord moet geven. Spraakmodellen zijn samengebracht in één stack zonder netwerkhops tussen componenten, waardoor de latency laag blijft.
De architectuur behoudt alles van Basic Cascaded: volledige transparantie, guardrails op de tekstlaag, verwisselbare componenten, domeinfinetuning en toegang tot de krachtigste beschikbare modellen voor tool calling en redeneren. Het voegt aanzienlijk betere prosodie, latency en beurtwisseling toe. Teams kunnen een nieuwe frontier LLM integreren in de week waarin die wordt uitgebracht, of STT voor de zorg finetunen op vaktaal, zonder een andere component opnieuw te hoeven bouwen.
Voorbeelden van use cases:
- Klantenservice voor financiële dienstverlening, waar een empathische benadering bij een gesprek over een betwiste afschrijving samengaat met strikte complianceguardrails en volledige interactielogging
- Receptionisten in de zorg die patiëntgesprekken triëren met passende urgentie, HIPAA-conforme flows en op het domein afgestemde spraakherkenning voor medische terminologie
- Salesassistenten die een warme, overtuigende toon aanhouden terwijl ze een gestructureerd draaiboek volgen en updates naar het CRM sturen
3. Hybride Cascaded en Fused
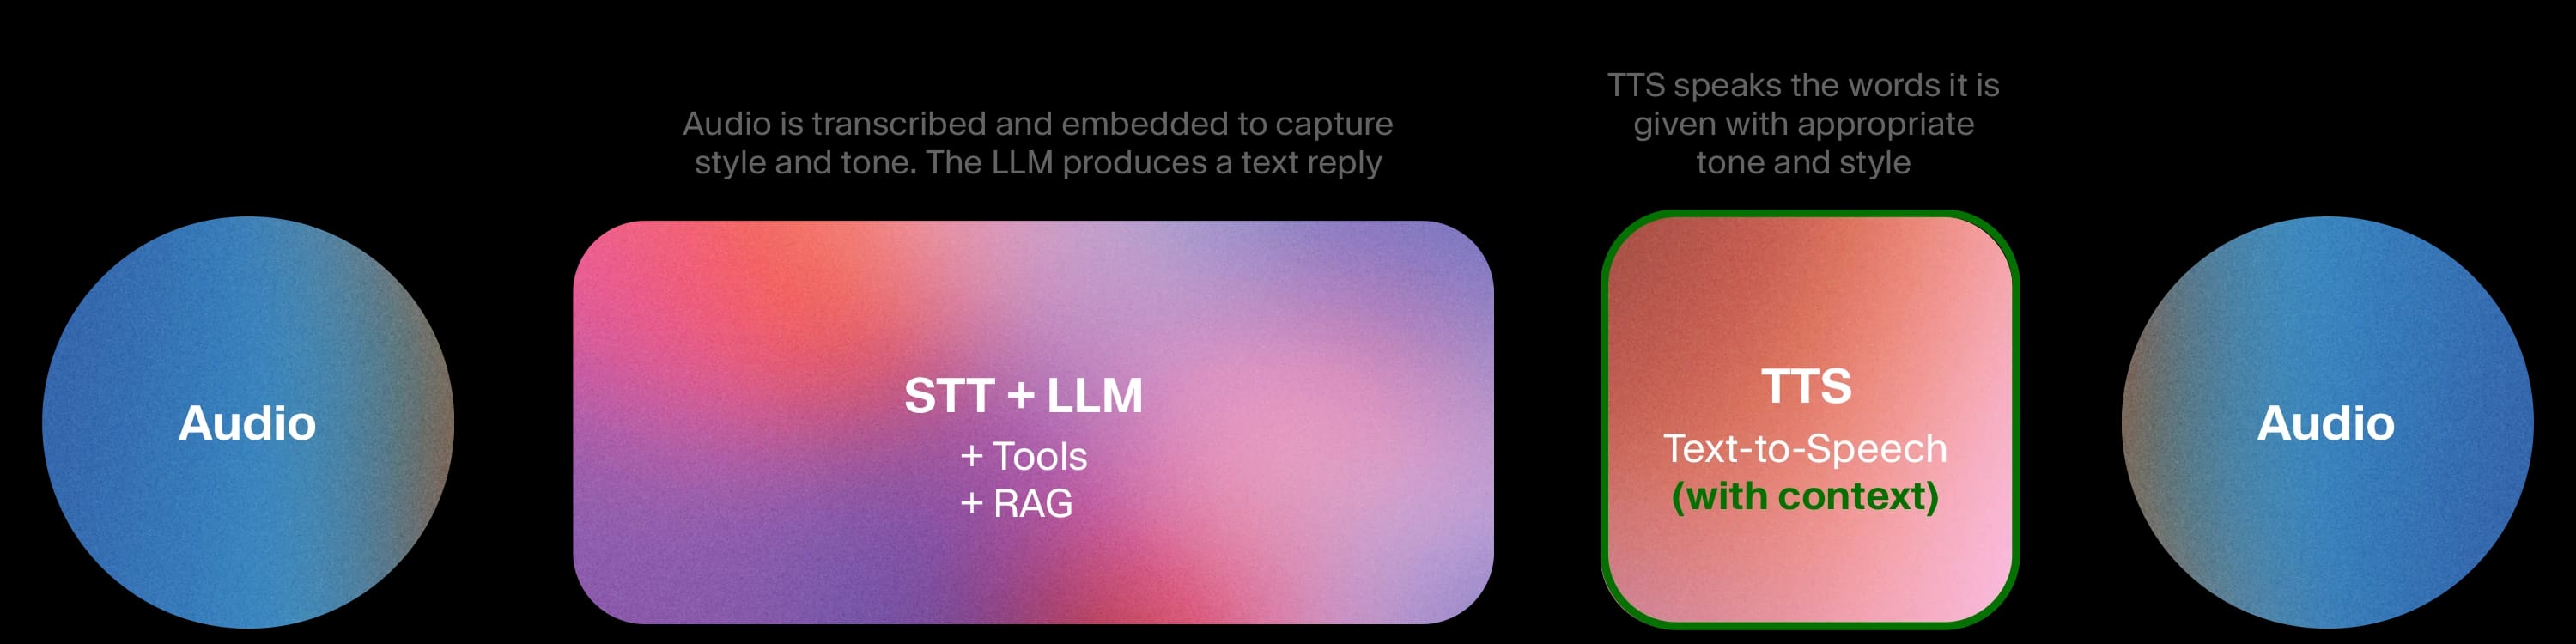
Sommige architecturen voeren akoestische kenmerken (uitspraak, emotie, toon) uit de invoerspraak rechtstreeks als embeddings aan de LLM, in plaats van deze eerst om te zetten in tekst. TTS blijft modulair.
Dit geeft de LLM rijkere input over hoe iets is gezegd, niet alleen wat er is gezegd, wat waardevol is voor specifieke toepassingen. Het fused ASR+LLM-blok is lastiger te auditen dan een duidelijke tekstoverdracht, omdat de tussenliggende representatie een embedding is en niet iets wat een mens kan lezen. De LLM is ook niet langer eenvoudig te vervangen, waardoor je mogelijkheden voor redeneren en tool calling beperkt zijn tot het model waarop het fused blok is gebaseerd.
Voorbeelden van use cases:
- Taalonderwijs en uitspraakcoaching, waarbij horen hoe een leerling spreekt even belangrijk is als wat diegene zegt
- Support waarbij toongevoeligheid belangrijk is en de complexiteit laag is, en het detecteren van frustratie dus van belang is, maar de taak zelf eenvoudig.
4. Sequential Fused
Eén multimodaal model verzorgt herkenning, redeneren en generatie in één doorgang, beurt voor beurt.
De prosodie kan sterk zijn. Omdat spraak nooit wordt opgesplitst in tekst, behoudt het model tempo, intonatie en emotionele signalen op een natuurlijke manier. Korte gesprekken kunnen opmerkelijk vloeiend klinken.
Maar zonder tekstlaag zijn de mogelijkheden om guardrails af te dwingen beperkt, zijn er weinig tussenresultaten beschikbaar voor debugging en is de flexibiliteit beperkt om een betere LLM in te zetten of de STT voor je domein te finetunen. De redeneerkernen zijn meestal lichter dan frontier LLM's, waardoor complexe tool calling en taken in meerdere stappen minder goed presteren. Wanneer een taak het oplossen van een complex probleem vereist, is prosodie alleen niet voldoende.
Voorbeelden van use cases:
- Persoonlijke metgezellen, entertainmentchatbots en toepassingen waarbij expressiviteit de betrokkenheid stimuleert en de compliancevereisten minimaal zijn.
5. Duplex Fused
Invoer en uitvoer worden gelijktijdig verwerkt, waarbij het model tegelijk luistert en spreekt. Dit kan korte uitwisselingen opvallend natuurlijk laten aanvoelen, met echte overlappende spraak en vloeiende beurtovergangen.
Dit is ook de moeilijkst te beheren architectuur, guardrails zijn zeer moeilijk af te dwingen en crosstalk leidt tot onvoorspelbare fouten. Inspecteren, loggen of debuggen is bijzonder moeilijk en het systeem is grotendeels gesloten, met minimale mogelijkheden om componenten te vervangen, domeinen te finetunen of aan te passen. Redeneren en toolgebruik zijn nog beperkter dan bij sequential fused modellen, omdat de gelijktijdige verwerking minder capaciteit overlaat voor complexe logica. En diezelfde gelijktijdige verwerking die korte uitwisselingen natuurlijk laat klinken, maakt langere gesprekken instabiel.
Voorbeelden van use cases:
- Experimentele companion apps, sociale spraakplatforms en onderzoeksdemo's waarin onvoorspelbaar gedrag acceptabel is.
De juiste architectuur kiezen voor je use case
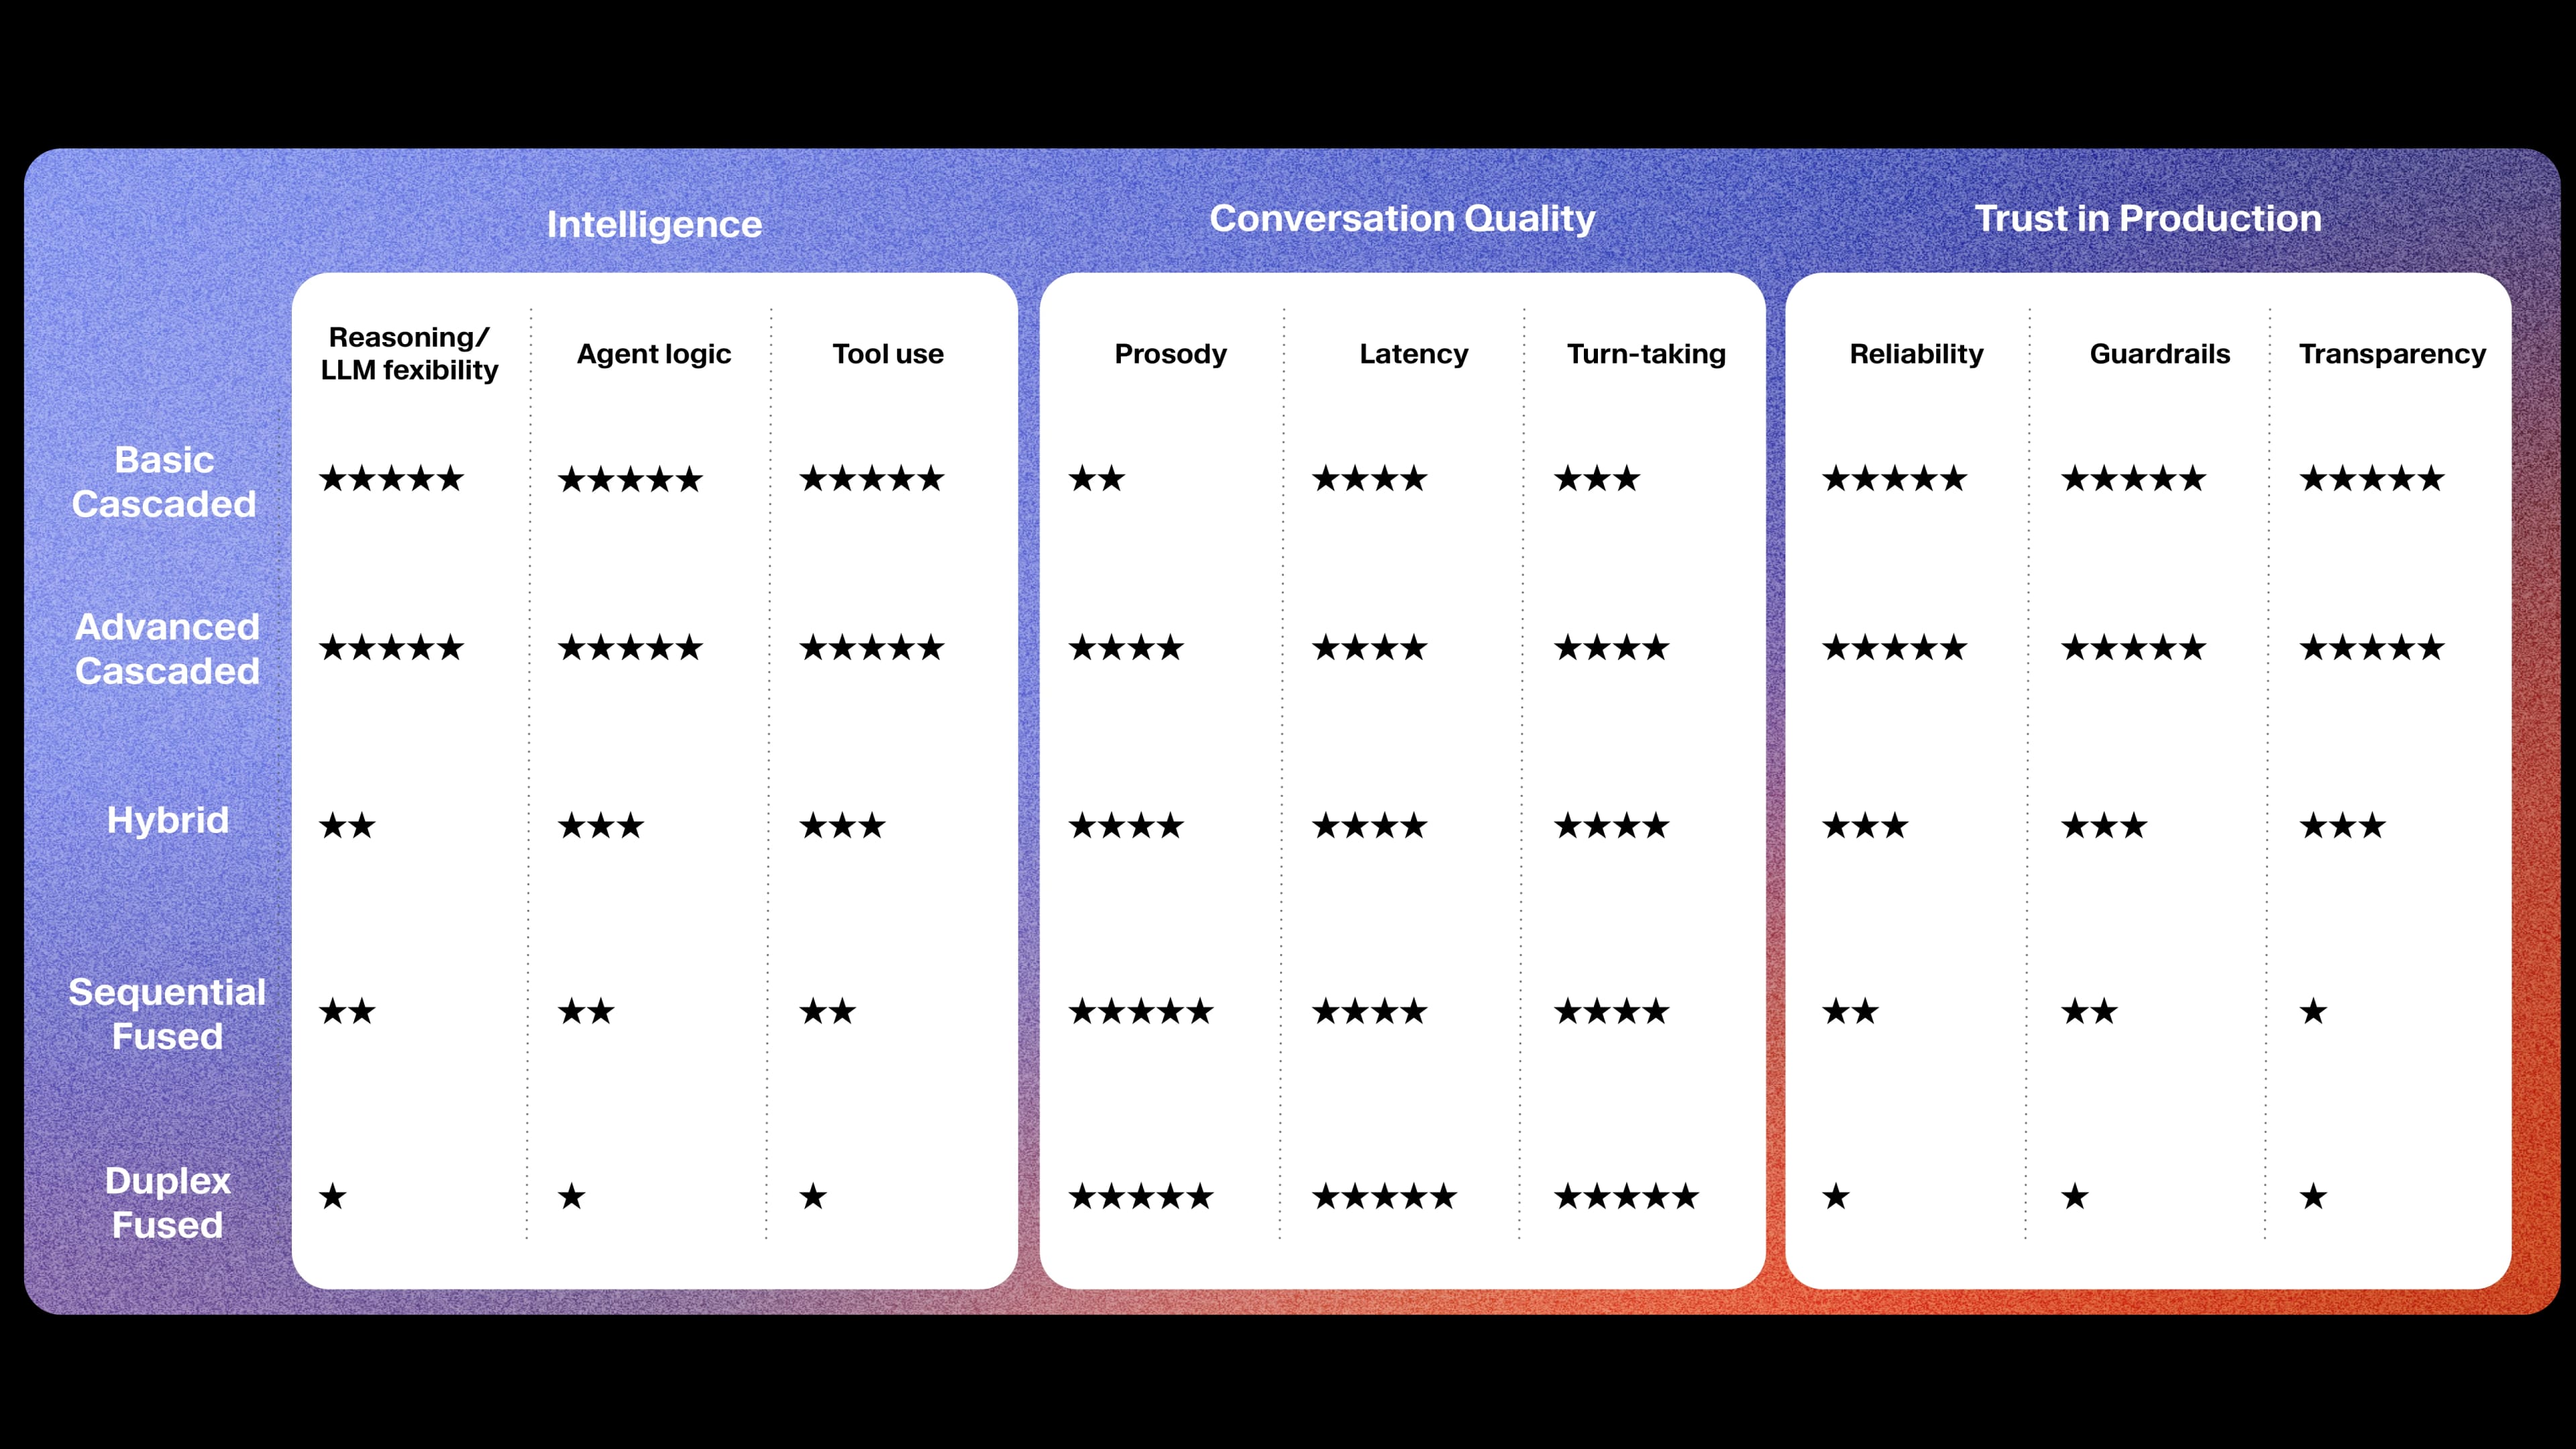
De juiste architectuur hangt af van wat een bepaalde toepassing nodig heeft. Als je een ervaring bouwt waarin natuurlijk klinkende spraak de belangrijkste functie is, bieden fused architecturen echte voordelen als je bereid bent concessies te doen aan frontier redeneren, guardrails en transparantie. Hoewel fused modellen vooroplopen op het gebied van prosodie, komen geavanceerde cascaded systemen elk kwartaal dichterbij. Fused modellen hebben door beperkingen op architectuurniveau daarentegen geen betekenisvolle vooruitgang geboekt op het gebied van complex redeneren of vertrouwen.
Voor de meeste bedrijven en overheden is de beste architectuur er een die zowel goed klinkt als capabel, aanpasbaar, betrouwbaar en klaar voor grootschalige implementatie is. Daarom hebben we ervoor gekozen om ElevenAgents te bouwen met een geavanceerde cascaded architectuur, met investeringen in Expressive Mode en toonaangevende, gezamenlijk geoptimaliseerde modellen voor Speech to Text en Text to Speech. Zo kunnen teams agenten bouwen met een hoog niveau van intelligentie, betrouwbaarheid en controle, gecombineerd met natuurlijke, mensachtige spraak.
Naarmate AI-agenten zich verder verspreiden binnen klantenservice, onderwijs, persoonlijke assistenten en meer, zullen de succesvolle agenten worden gebouwd op architecturen die zijn afgestemd op hun specifieke toepassingen.