
Wat is Automatic Speech Recognition (ASR)?
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
In 1952 kon het meest geavanceerde spraakherkenningssysteem ter wereld precies 9 woorden begrijpen.
Zo'n 75 jaar later transcribeert automatische spraakherkenning (ASR) tientallen talen in realtime, van de stemassistenten op je telefoon tot de ondertiteling die verschijnt in livevideo's.
In deze gids verkennen we de technologie die de kloof tussen de versie uit 1952 en de moderne versie heeft overbrugd: wat ASR is, hoe het spraak omzet in tekst en hoe ASR zich ook vandaag nog ontwikkelt.
Samenvatting:
- ASR staat voor automatische spraakherkenning, de technologie die gesproken audio omzet in geschreven tekst.
- De vroegste vorm van ASR ontstond in 1952; eind jaren 2010 evenaarden deep-learning-systemen menselijke benchmarks.
- Moderne ASR gebruikt end-to-end neurale netwerken die zijn getraind op miljoenen uren audio.
- Word error rate (WER) is de standaardmaatstaf voor nauwkeurigheid, maar ook latency, diarizationkwaliteit en contextueel begrip spelen een rol bij ASR voor productieomgevingen.
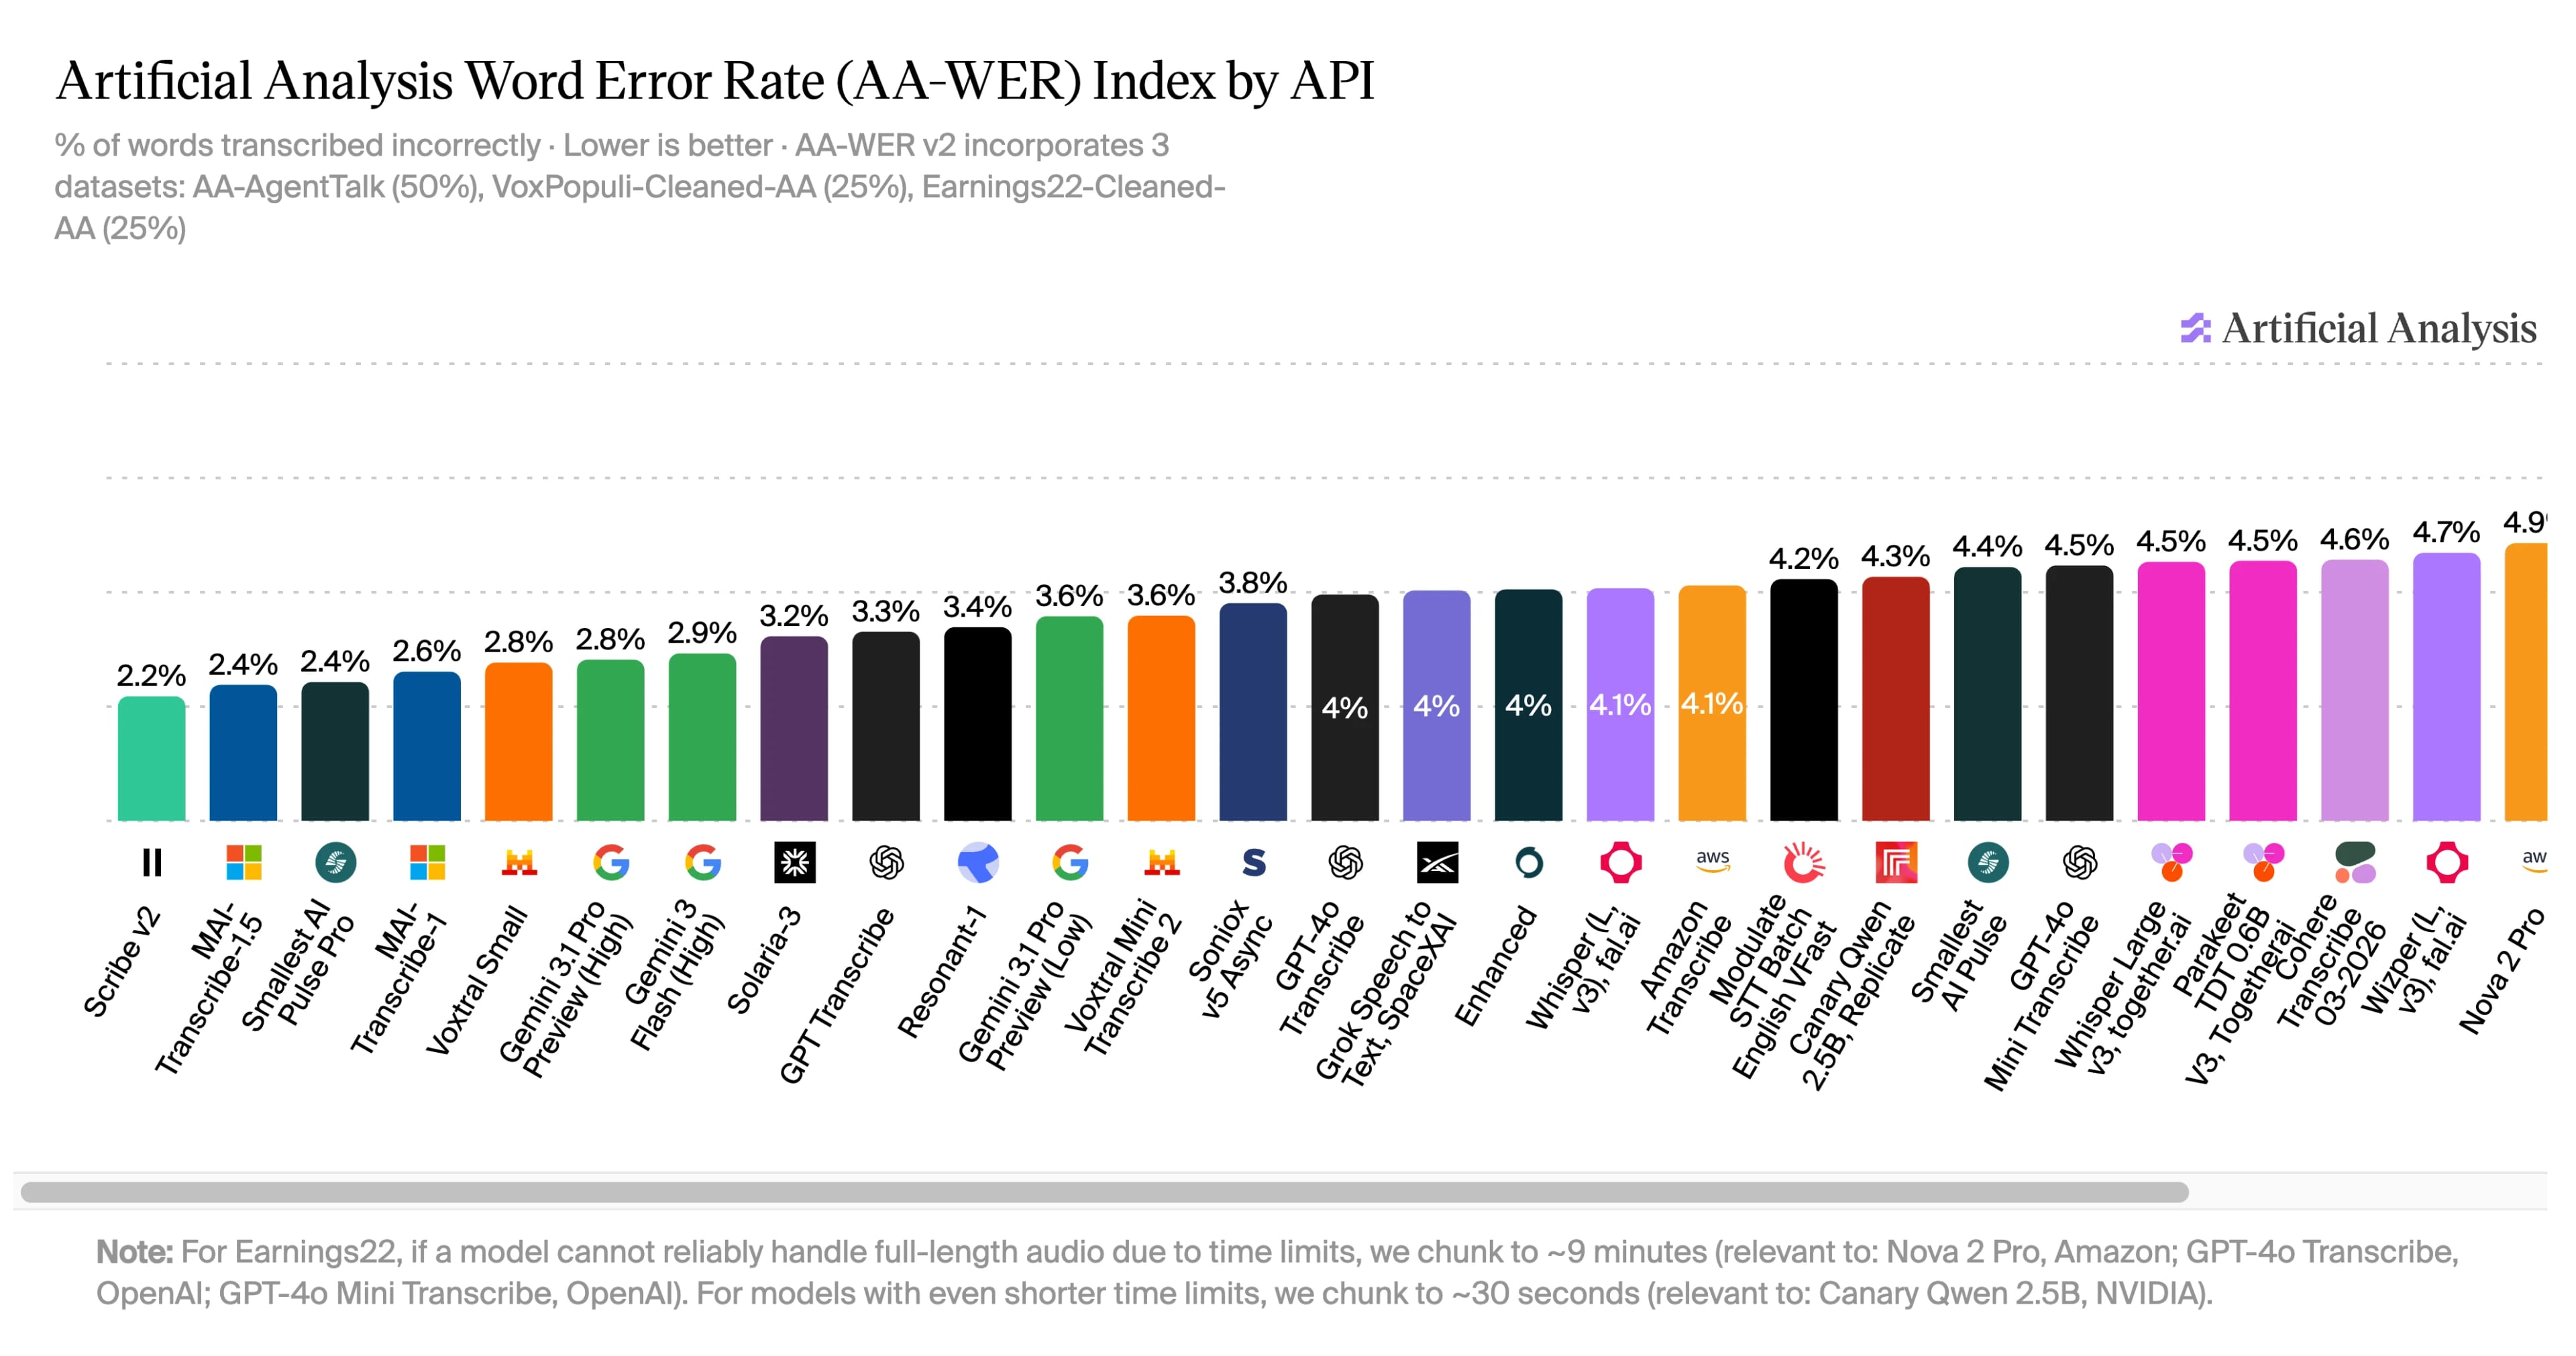
- ElevenAPI biedt ontwikkelaars ASR voor productieomgevingen, onafhankelijk gebenchmarkt door Artificial Analysis met een word error rate van 2,2%, de laagste in de index (juli 2026).
Wat is automatische spraakherkenning (ASR)?
Automatische spraakherkenning, vaak alleen aangeduid met het acroniem ASR, is software die naar menselijke spraak luistert en deze omzet in nauwkeurige, machineleesbare tekst. Het wordt ook vaak speech to text en spraakherkenning genoemd, en soms zelfs computer-spraakherkenning.
ASR is zo alomtegenwoordig geworden dat je er elke dag mee kunt werken zonder het te beseffen. Elke keer dat je een bericht dicteert, een stemassistent een vraag stelt, ondertiteling leest tijdens een livevideo of navigeert door een interactief telefoniesysteem met gesproken menu's, maak je gebruik van ASR.
Hoewel speech to text en ASR vaak als synoniemen worden gebruikt (en nauw met elkaar verbonden zijn), zijn ze niet precies hetzelfde. ASR is de technologie die vaststelt wat er wordt gezegd, terwijl STT de toepassing van die technologie als tool is. Spraakherkenningssoftware bouwt voort op ASR en identificeert wie een bepaald woord heeft gezegd. Dat vormt de basis voor speaker diarization-mogelijkheden.
Dit zijn kleine verschillen, maar het is nuttig ze te begrijpen als je ASR-/STT-/spraakherkenningssystemen wilt integreren in je apps of website.
Een korte geschiedenis van automatische spraakherkenning
Technologie voor automatische spraakherkenning is veel ouder dan de meeste mensen denken; de eerste versies stammen uit de jaren 50. In de ruim 70 jaar sinds het ontstaan heeft ASR verschillende belangrijke stadia doorlopen, die grotendeels de basis vormden voor de historische vooruitgang.
Dit zijn de belangrijkste tijdperken die ASR-technologie heeft doorlopen:
- 1952 en de eerste ASR: In 1952 werd de Automatic Digit Recognizer, bekend als AUDREY, gebouwd door Bell Laboratories om de cijfers een tot en met negen te begrijpen. De tool was slechts ongeveer 90% nauwkeurig en werkte alleen wanneer de uitvinder hem gebruikte, waardoor hij uiterst beperkt was. Vergeleken met wat we nu als moderne mogelijkheden kennen, was dit nog een wereld van verschil, maar zelfs alleen 1-9 kunnen herkennen was indrukwekkend.
- Jaren 60 en 70 en de groeiende ASR-woordenschat: In de decennia daarna konden laboratoria over de hele wereld, waaronder IBM, University College London en NEC in Japan, in verschillende contexten vergelijkbare modellen als AUDREY ontwikkelen. Raj Reddy, een Indiase promovendus aan Stanford, bouwde voor zijn PhD-project een klinkerherkenner. Daarmee legde hij de basis voor continue spraakherkenning zonder tussen elk woord te hoeven pauzeren. DARPA (Defense Advanced Research Projects Agency) financierde in deze periode onderzoek dat leidde tot Beam Search, een methode voor zinsconstructie en decodering die essentieel was om in 1976 meer dan 1.000 woorden te herkennen.
- Jaren 80 tot begin jaren 2010 met statistische vooruitgang: In 1987 combineerde een student van Raj Reddy (die toen professor was) Hidden Markov Models met Beam Search. Daardoor waren ASR-systemen mogelijk die niet op één specifieke spreker hoefden te worden getraind. Deze doorbraak verkortte de trainingstijd voor spraakherkenningssystemen drastisch. Dragon Systems bracht in 1997 de eerste commercieel beschikbare ASR uit, onder de naam NaturallySpeaking Preferred. Deze kon 100 woorden per minuut herkennen en verkocht goed.
- Het moderne tijdperk en deep learning: In de jaren 2010 toonden onderzoekers aan dat één end-to-end neuraal netwerk, getraind op audio en transcripten, beter presteerde dan een volledig statistische pipeline. Met de komst van diepe neurale netwerken konden ASR-systemen bijna menselijke prestaties bereiken, met een foutpercentage tussen 5% en 10%. In deze periode kwamen stemgestuurde assistenten als Alexa en Siri op de markt.
Sindsdien is ASR alleen maar nauwkeuriger en breder toegepast geworden. In juli 2026 identificeerde onafhankelijk onderzoek van Artificial Analysis ElevenLabs Scribe v2 als marktleider met een word error rate (WER) van slechts 2,2%.
Hoe werkt ASR? De basis van speech to text-technologie
ASR werkt door een audiofragment vast te leggen, dit om te zetten in een numerieke representatie en vervolgens een getraind model te gebruiken om de waarschijnlijkste woordreeks te voorspellen die deze cijfers vertegenwoordigen. Moderne ASR voert dit systeem realtime uit en rondt het volledige end-to-endproces in minder dan een seconde af.
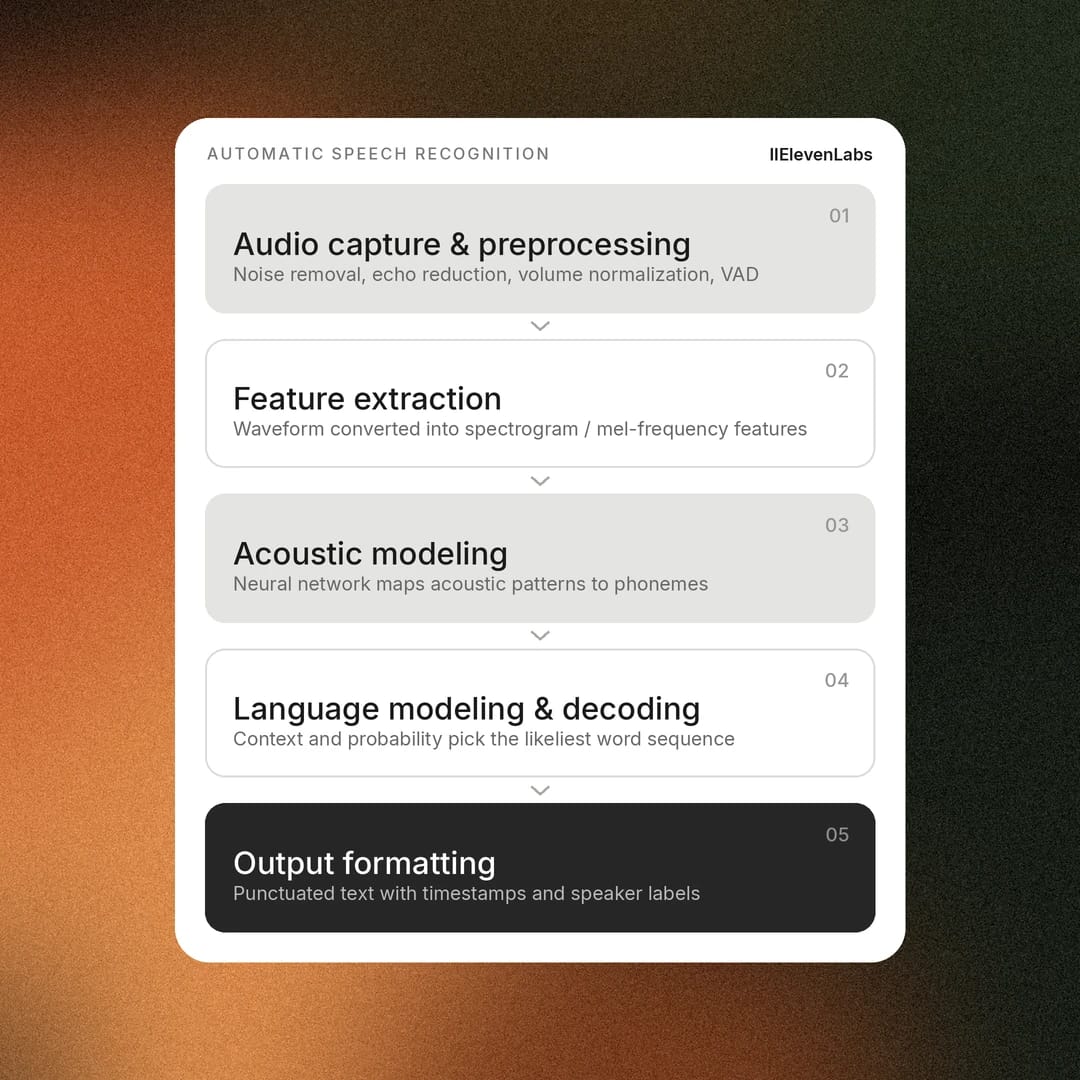
Een ASR-pipeline bestaat uit vijf hoofdstappen:
- Audio vastleggen en voorbewerken: Het systeem neemt het audiosignaal op, verwijdert achtergrondgeluid, vermindert echo en normaliseert volumeniveaus voor meer consistentie. Afhankelijk van het model kan het voice activity detection (VAD) gebruiken om spraak te onderscheiden van stilte of achtergrondgeluiden voordat de transcriptie begint.
- Kenmerkextractie: De audio wordt omgezet in een numerieke representatie, doorgaans een spectrogram of mel-frequentiekenmerken, die de frequenties en patronen in menselijke spraak nauwkeurig weergeven. Deze stap zet in feite een ruwe golfvorm om in data die een machinelearningmodel effectief kan verwerken.
- Akoestische modellering: Een neuraal netwerk analyseert de kenmerken uit de vorige stap en voorspelt fonemen of andere spraakeenheden. Het leert de relatie tussen akoestische patronen en gesproken taal. Moderne end-to-endmodellen voeren deze stap vaak gezamenlijk met taalbegrip uit, in plaats van als een volledig afzonderlijke fase.
- Taalmodellering en decodering: Het systeem weegt vervolgens af welke woordreeksen het waarschijnlijkst zijn op basis van regels zoals grammatica, context en wiskundige waarschijnlijkheid. De laatste twee zijn hierbij essentieel, want de IPA-transcriptie (International Phonetic Alphabet) van twee zinnen kan vergelijkbaar zijn, terwijl de context totaal verschilt. Zo kunnen “Recognize Speech” en “Wreck a nice peach” hetzelfde klinken, maar een heel andere betekenis hebben. De context helpt het systeem bepalen wat juist is wanneer de nauwkeurigheid geen uitsluitsel geeft.
- Opmaak van de uitvoer: Nadat is vastgesteld wat de spraak bevat, wordt de uiteindelijke tekst getranscribeerd, inclusief interpunctie en hoofdletters. Aanvullende metadata, zoals tijdstempels op woordniveau en sprekerlabels, zorgen voor gedetailleerdere transcripten.
In deze hoofdstappen zet het model binnenkomende audiodata om in een geschreven transcript.
Traditionele hybride systemen versus end-to-end deep-learning-ASR
Hoewel de bovenstaande pipeline beschrijft hoe ASR werkt, zijn er voor het middendeel van die pipeline in feite twee technologische routes mogelijk.
Oudere systemen koppelen verschillende componenten aan elkaar: een lexiconmodel dat vastlegt hoe woorden worden uitgesproken, een akoestisch model dat audio aan fonemen koppelt en een taalmodel dat waarschijnlijke woordreeksen voorspelt. Voor elk van deze componenten is menselijke expertise nodig: van taalkundigen die uitspraakwoordenboeken handmatig opstellen tot annotatoren die elk woord koppelen aan de exacte positie in de audio.
End-to-end deep learning brengt al deze componenten samen in één neuraal netwerk. Het netwerk koppelt audio rechtstreeks aan tekst en leert impliciet uitspraak, akoestiek en statistieken over taalwaarschijnlijkheid uit miljoenen uren gekoppelde audio en transcripten.
Laten we de verschillen tussen traditionele en moderne benaderingen van ASR-technologie bekijken.
Hoe ASR-nauwkeurigheid wordt gemeten: benchmarks voor word error rate (WER)
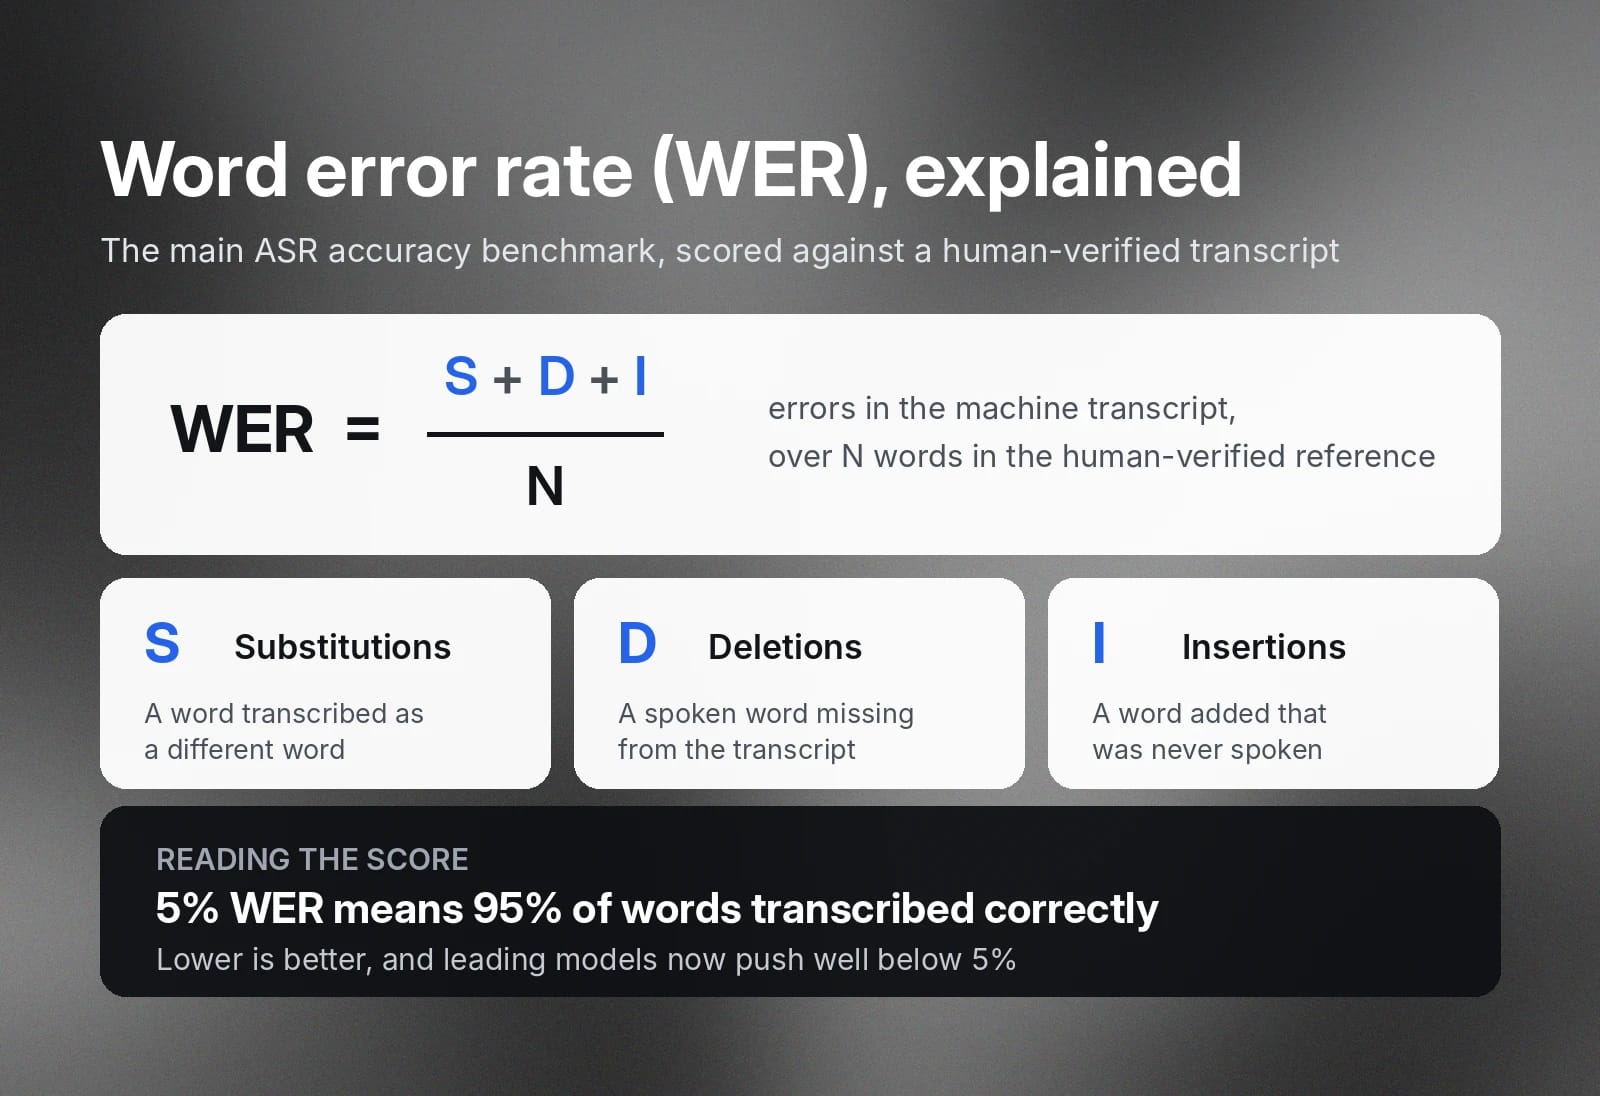
Voor alle speech to text- en ASR-workflows is word error rate (WER) de belangrijkste nauwkeurigheidsmaatstaf voor bedrijven. Deze vergelijkt een met ASR gegenereerd machinetranscript met een door mensen geverifieerde versie. Er zijn drie belangrijke typen fouten: vervangingen, weglatingen en toevoegingen.
De WER-formule deelt het totale aantal fouten door het aantal woorden in het referentietranscript. Een WER van 5% betekent dat het systeem 95% van de tekst nauwkeurig kon transcriberen. De meeste toonaangevende modellen komen inmiddels ruim onder de 5% en naderen perfectie.
WER is een nuttige benchmark, maar bij het bepalen van de effectiviteit van een ASR-tool zijn ook andere factoren belangrijk:
- Nauwkeurigheid van de opmaak: Kan het systeem niet-standaard tekenreeksen goed opmaken? Wordt een geldbedrag als $1,225 bijvoorbeeld zo weergegeven, of uitgeschreven als “duizend tweehonderdvijfentwintig dollar”?
- Latency: Nauwkeurigheid is belangrijk, maar als het enkele minuten duurt om een eenvoudig transcript te genereren, is een tool onbruikbaar. Zelfs als deze zeer nauwkeurig is, moet hij dat combineren met lage latency om bruikbaar te zijn.
- Robuustheid: Zelfs use cases zoals sterke accenten of luidruchtige achtergronden mogen de nauwkeurigheid van het model niet aanzienlijk verlagen.
- Diarizationkwaliteit: Use cases met meerdere sprekers vereisen dat elk woord correct aan de juiste spreker wordt toegeschreven. Verschillende sprekers kunnen identificeren en correct labelen draagt bij aan ASR, vooral in sectoren met veel sprekers, zoals rechtszalen.
Lees voor meer informatie onze uitgebreide gids over word error rate.
Belangrijke voordelen van ASR voor moderne bedrijven
De wereldwijde markt voor spraak- en stemherkenning groeit naar verwachting tot meer dan $23,11 miljard in 2030. De CAGR van 19,1% weerspiegelt hoe breed deze technologie in commerciële apparaten is toegepast. Elke moderne mobiele telefoon wordt geleverd met een dicteertoetsenbord en een stemassistent, de meeste nieuwe auto's reageren op spraakopdrachten en slimme speakers of assistenten staan inmiddels in huishoudens over de hele wereld.
Interactie met technologie via spraak is inmiddels een standaardoptie voor klanten. Voor bedrijven biedt ASR alles van transcriptie van klantgesprekken tot ondersteuning voor stemagents, en kan het processen integreren en productiviteit verhogen.
Dit zijn enkele belangrijke voordelen van ASR voor moderne bedrijven:
- Snellere invoer en documentatie: Meer dan 10 jaar geleden al publiceerde Stanford een onderzoek waaruit bleek dat spraakherkenningstechnologie bijna drie keer sneller was dan typen op een toetsenbord, met bovendien een lager foutpercentage. Voor de meeste mensen maakt ASR snellere documentatie mogelijk voor transcriptieworkflows en notities via spraak.
- Lagere operationele kosten: In veel use cases die vroeger uren handmatig noteren vereisten, verlaagt ASR-technologie de kosten van hoogwaardige transcriptie drastisch. Rechtszaken, contactcenters, zorgklinieken en zakelijke vergaderingen kunnen nu nauwkeurige ASR-systemen gebruiken die gedetailleerde notities en volledige, van sprekerlabels voorziene transcripten van gesprekken maken.
- Betere toegankelijkheid: De Wereldgezondheidsorganisatie voorspelt dat 2,5 miljard mensen in 2050 met een vorm van gehoorverlies zal leven. Realtime ondertiteling van geavanceerde ASR-tools kan digitale vergaderingen en media toegankelijk maken voor gebruikers.
- Doorzoekbare spraakdata: Wanneer je spraak automatisch transcribeert met ASR, wordt elke interactie tussen klant en bedrijf volledig vastgelegd. Elk verkoopgesprek, supportticket, gesprek met een potentiële klant of vergadering wordt tekst die doorzoekbaar en controleerbaar is. Vooral in het AI-tijdperk helpt het beschikbaar maken van context in een machineleesbaar formaat bij het opbouwen van uitgebreide kennisbanken. Dit houdt informatie zichtbaar, zowel voor functionaliteit als compliance.
- Altijd beschikbare klantervaringen: ASR biedt een van de basistechnologieën voor stemagents en ondersteunt geautomatiseerde support-use cases die klantgesprekken afhandelen 24/7/365.
Automatische spraakherkenning is zo prominent in technologie door de vele voordelen van integratie en de uitgebreide use cases die het ondersteunt. Of je nu in de medische sector werkt of klantgesprekken wilt transcriberen voor sentimentanalyse, ASR is een basistechnologie die je kunt integreren en gebruiken.
Populaire toepassingen van ASR in verschillende sectoren
Automatische spraakherkenning is een centrale technologie in talloze workflows en producten. Het is zo alomtegenwoordig dat gebruikers vaak niet eens nadenken over hoe het is ingebed in de technologie die ze gebruiken.
Hier volgt een kort overzicht van enkele populaire ASR-use cases wereldwijd.
Klantenservice en contactcenters
Contactcenters waren vroege gebruikers van ASR en gebruikten het om gesprekken te transcriberen voor kwaliteitsborging en compliance. Tegenwoordig kan ASR realtime werken om agents tijdens een gesprek suggesties te tonen en duizenden klantinteracties om te zetten in data die teams kunnen analyseren.
Media en entertainment
Omroepen en streamingplatforms kunnen ASR gebruiken om ondertiteling van menselijke gesprekken te genereren op een schaal die menselijke transcribenten nooit zouden kunnen evenaren. Het maakt realtime transcriptie mogelijk en maakt video- en audiobibliotheken volledig doorzoekbaar.
Zorg
Klinisch personeel besteedt een verrassend groot deel van de dag aan documentatie en verslaglegging. ASR helpt die tijd terug te winnen en biedt artsen een medisch STT-platform waaraan ze realtime notities kunnen dicteren.
Virtuele vergaderingen
Vergaderplatforms bieden vaak een vorm van digitale notities om gesprekken te transcriberen terwijl ze plaatsvinden, zodat niemand hoeft te kiezen tussen deelnemen en notities maken. Diensten als Google Meet sturen deze transcripten zelfs na elke vergadering, met actiepunten gemarkeerd, en helpen zo een doorzoekbare index van informatie te creëren.
Juridisch en compliance
In juridische omgevingen is het nauwkeurig vastleggen van wat er is gezegd en door wie een centrale vereiste in de rechtbank. Advocatenkantoren gebruiken ASR-platforms om vergaderingen, hoorzittingen, gesprekken met cliënten en rechtszittingen te transcriberen met nauwkeurige tijdstempels voor toekomstige raadpleging.
Onderwijs
Universiteitsdocenten kunnen een opgenomen transcript van hun colleges aanbieden, zodat studenten een overzicht kunnen opbouwen van de lessen die ze hebben gevolgd. Om informatie te begrijpen en onthouden, hebben studenten zo een uitgebreide bron als uitgangspunt.
De plaats van ASR in een pipeline voor stemagents
ASR is een standaardonderdeel van uiteenlopende technische implementaties. Bij technologie voor stemagents is het de eerste van drie bredere fasen die in een continue lus draaien.
- Luisteren (ASR): De agent legt binnenkomende audiostreams vast en zet spraak realtime om in tekst. Moderne ASR verwerkt audio continu zodra deze binnenkomt, filtert achtergrondgeluid weg, verwerkt onderbrekingen, produceert gedeeltelijke transcripten en identificeert wanneer iedereen spreekt.
- Denken (taalmodel): Een groot taalmodel interpreteert het transcript, begrijpt de intentie van de gebruiker, haalt informatie op uit gekoppelde tools en kennisbanken, behoudt de gesprekscontext en bepaalt de meest passende reactie of actie.
- Spreken (text to speech): Een text to speech-model zet het gegenereerde LLM-antwoord om in natuurlijke, expressieve audio. Moderne TTS-systemen kunnen tempo, intonatie, emotie en nadruk aanpassen wanneer ze audio terugstreamen naar de beller terwijl deze wordt gegenereerd, zonder op het volledige antwoord te wachten.
Conversationele latency stapelt zich op in elk van deze fasen. Streaming ASR begint woorden uit te sturen zodra ze zijn uitgesproken, in plaats van te wachten tot een uiting is afgerond, om latency te verminderen. ElevenAgents hanteert dit als standaard voor realtime stemagents en helpt zo een efficiënte agentervaring te creëren.
Uitdagingen bij ASR en de ontwikkeling van technologie
Hoewel ASR-technologie sinds de oorsprong in 1952 grote vooruitgang heeft geboekt, blijven er verschillende uitdagingen die de nauwkeurigheid kunnen verlagen.
Hieronder staan enkele problemen waar ASR-tools vandaag de dag nog steeds tegenaan lopen:
- Accenten en dialecten: Beschikbare trainingsdata concentreert zich doorgaans op een beperkt aantal talen en accenten. Daardoor zijn minder gebruikelijke accenten of talen die door minder mensen worden gesproken uitdagender voor ASR-tools. Rijke en diverse trainingsdatasets bieden hiervoor een oplossing.
- Achtergrondgeluid en overlappende sprekers: Omgevingen met wisselende volumeniveaus of luid achtergrondgeluid maken afzonderlijke woorden in een opname lastiger te onderscheiden. Overlappende sprekers kunnen hetzelfde effect hebben en de nauwkeurigheid van een ASR-transcriptie verminderen.
- Domeinspecifieke woordenschat: Vakgebieden met specifiek jargon of afkortingen hebben woordenboeken en referenties op domeinniveau nodig om de nauwkeurigheid te verbeteren. Geneeskunde en recht zijn twee gebieden waarin ASR-tools extra ondersteuning of gespecialiseerde training nodig hebben.
- Privacy en beveiliging: In veel rechtsgebieden gelden stemgegevens als persoonsgegevens. Ondernemingen hebben duidelijke bewaarbeleidsregels en waarborgen nodig om de verwerking van stemgegevens te beschermen en naleving van bredere regelgeving te waarborgen.
Een bredere afweging bij ASR-technologie is die tussen latency en nauwkeurigheid. Sommige use cases vereisen een balans tussen beide, terwijl domeinen zoals de geneeskunde waarschijnlijk nauwkeurigheid boven alles stellen.
Ga aan de slag met ElevenAPI voor ASR-integratie voor productieomgevingen
ElevenAPI brengt automatische spraakherkenning voor productieomgevingen naar je product via Scribe v2, het ElevenLabs Speech to Text-model. Scribe v2 biedt tijdstempels op woordniveau, speaker diarization, tagging van audio-events en de nauwkeurigheid en betrouwbaarheid die realtime toepassingen nodig hebben.
Bekijk de pagina ElevenLabs Speech to Text voor meer informatie of maak een gratis account om binnen enkele minuten een API werkend te krijgen.
Veelgestelde vragen over ASR

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.




