Wat is conversational AI-latentie en wat beïnvloedt deze?
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Voor conversationele AI is latency wat goede applicaties van geweldige onderscheidt.
Conversationele AI is van nature ambitieus. Het probeert hetzelfde gevoel na te bootsen als een gesprek met een mens, met hetzelfde emotionele bereik, dezelfde toonhoogte en cadans. Tel daarbij op wat als een ‘natuurlijke’ vertraging voelt tussen het moment waarop je stopt met praten en een AI-agent begint te reageren, en je hebt een latencystreefwaarde die gebaseerd is op hoe mensen daadwerkelijk communiceren.
Bedrijven die conversationele AI-agents op grote schaal willen inzetten, moeten die latency zo veel mogelijk verminderen om die natuurlijke illusie te bereiken. Dit artikel behandelt wat latency in conversationele AI is, wat vertragingen in de hele pipeline veroorzaakt en geeft een overzicht van hoe je die vermindert.
Samenvatting
- Latency in conversationele AI is de totale end-to-endvertraging vanaf het moment dat een gebruiker stopt met praten tot deze het eerste woord van de agent hoort.
- Agents met meer dan 700 ms kunnen onnatuurlijk aanvoelen; bij meer dan 1.200 ms zijn de afhaakpercentages hoog.
- Latency stapelt zich op in elke fase van de pipeline voor conversationele AI.
- ElevenAgents verwerkt de volledige pipeline in één uniforme architectuur, waardoor conversationele AI met lage latency toegankelijk wordt voor je bedrijf.
Wat is latency in conversationele AI?
Latency in conversationele AI verwijst naar de totale tijd die een systeem nodig heeft om te reageren nadat je hebt gesproken. Bij moderne AI-modellen wordt latency gemeten in ms. Achter de schermen bestaat de totale latency eigenlijk uit verschillende afzonderlijke processen, die elk een deel van de end-to-endpipeline vormen.
Een typische pipeline voor conversationele AI ziet er als volgt uit:
- Een gebruiker spreekt
- De audio wordt getranscribeerd door een Speech to Text-model
- Het transcript wordt doorgegeven aan een LLM-model, dat een reactie genereert
- De tekst van het LLM wordt vervolgens met een Text to Speech-model omgezet in audio
- De audio wordt vervolgens voor de gebruiker afgespeeld
Elk van deze fasen voegt latency toe aan een conversationeel AI-systeem. Daarom zijn er bij het bespreken van latency enkele verschillende afkortingen om te verduidelijken.
Modelinference-latency
Modelinference-latency is de tijd die een model besteedt aan het genereren van output, intern gemeten en zonder externe factoren. Het is de modelspecifieke maatstaf voor hoe snel je engine presteert bij typische inputs. Flash v2.5 heeft bijvoorbeeld een modelinference-latency van ongeveer 75 ms. Daarmee kun je vergelijken hoe snel modellen bij verschillende aanbieders zijn.
Houd er wel rekening mee dat dit niet de latency is die een gebruiker daadwerkelijk ervaart. Deze heeft uitsluitend betrekking op de totale tijd die een model besteedt aan het genereren van output.
LLM time-to-first-token
De time-to-first-token (TTFT) van een large language model (LLM) is de totale tijd die een large language model nodig heeft om een prompt te verwerken en de eerste bruikbare outputtoken te genereren.
TTS-generatie begint zodra de eerste token van je LLM arriveert. Dit meet dus hoe lang het LLM nodig heeft om je TTS-model aan te sturen. Bij de meeste end-to-end-systemen voor conversationele AI vormt LLM TTFT een aanzienlijk deel van de totale latency.
TTS time-to-first-audio (TTFA)
TTS time-to-first-audio (TTFA) meet de tijd vanaf de eerste TTS-request tot het moment waarop het eerste audiochunk het model daadwerkelijk verlaat. Het beschrijft modelinference-latency, maar dan specifiek voor TTS-engines.
End-to-end time-to-first-audio (TTFA)
De end-to-end-TTFA is de totale latency van conversationele AI. Het is de som van alle onderdelen van de pipeline, van spraakherkenning, LLM TTFT, TTS en TTFA tot alle netwerkoverdrachten tussen de stappen. Wanneer we latency in conversationele AI als geheel bespreken, is dit de metriek die de gebruiker ervaart.
Wanneer iemand spreekt, wacht diegene op de end-to-end-TTFA voordat er iets van je agent te horen is. Het is een holistische maatstaf, wat betekent dat verbetering van elk onderdeel van de pipeline deze verbetert.
Waarom latency in conversationele AI belangrijk is
Wanneer een gebruiker met je AI-agent praat, wordt latency een centrale factor in hoe deze de ervaring beoordeelt. Lage latency verkort de wachttijd op een reactie, waardoor het gesprek natuurlijk aanvoelt en je agent bekwaam overkomt.
Agents met hoge latency voelen kunstmatig en minder competent aan, zelfs als de kwaliteit van hun reacties hetzelfde is. Voor bedrijven kan zelfs een verschil van enkele honderden ms als een eeuwigheid voelen, waardoor je klantenserviceagent log en ineffectief aanvoelt.
Hier zijn enkele scenario's die laten zien waarom latency in conversationele AI in de praktijk belangrijk is:
- Onder 500 ms: Een conversationele agent voelt responsief en gestroomlijnd. Gebruikers merken de vertraging tussen het moment waarop ze stoppen met praten en hun eerste reactie mogelijk niet, waardoor het gesprek vloeiend verloopt.
- 500 ms tot 1000 ms: De vertraging tussen het moment waarop een gebruiker stopt met praten en een reactie krijgt, kan merkbaar worden. Die is net iets te lang, waardoor gebruikers misschien vooraf proberen bij te sturen door zichzelf te herhalen of te pauzeren om te zien of de agent hen echt heeft begrepen.
- Boven 1000 ms: Vertragingen beginnen traag te voelen, met stiltes waardoor sommige gebruikers het idee krijgen dat de AI-agent het gesprek niet volledig bijhoudt. Transcripten kunnen af en toe onderbrekingen of verzoeken om met een menselijke agent te spreken tonen. In sommige gevallen haken gebruikers af tijdens het gesprek.
Elk van deze drempelwaarden vertaalt zich in concrete bedrijfsresultaten.
Aan de lage kant van het latencyspectrum heb je een klantenserviceagent die binnenkomende vragen op natuurlijke wijze kan beantwoorden en gebruikers zonder extra hulp kan helpen hun vragen op te lossen. Dat ontlast je menselijke agents en houdt de klanttevredenheid hoog. Aan de hoge kant van het latencyspectrum frustreer je je klanten met een agent die veel te lang lijkt te aarzelen.
In een ander artikel hebben we de benchmarks voor het latencybudget van voice agents gedefinieerd om te laten zien hoe goede latency eruitziet bij zowel P50- als P95-waarden.
Wat veroorzaakt latency in conversationele AI?
Latency in conversationele AI is een term die verschillende processen samenvat, waarbij elk segment bijdraagt aan het geheel. Het knelpunt voor lage latency is daarom eerder een probleem op systeemniveau dan iets wat je oplost door simpelweg een beter model te kiezen. Er werken immers meerdere modellen samen in de pipeline.
Voor ontwikkelaars hebben we een uitgebreide technische gids geschreven over latencyoptimalisatie voor voice agents die je kunt gebruiken om elke fase van de end-to-end time-to-first-audio (TTFA) te verbeteren.
Naast de kernpipeline voegen ook andere factoren, zoals telefonie en function calling, latency toe, ook al maken ze geen deel uit van de modelinfrastructuur.
Hier vind je een overzicht van alle factoren die bijdragen aan latency in conversationele AI.
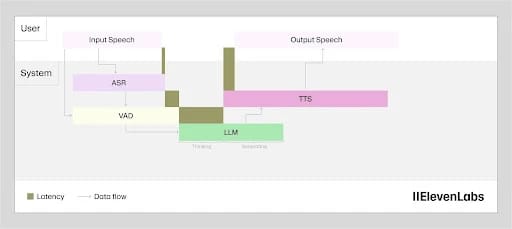
Automatische spraakherkenning
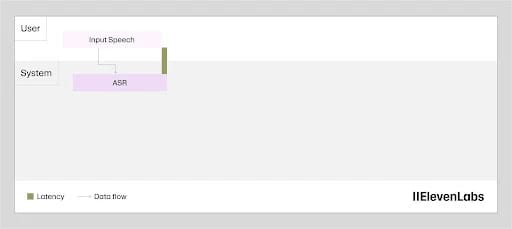
De latency van spraakherkenning is niet de tijd die nodig is om een transcript te genereren. Het transcriptieproces draait op de achtergrond terwijl de gebruiker spreekt, waardoor de tekst grotendeels klaar is wanneer de spraak eindigt.
De latency is hier eigenlijk de tijd tussen het einde van de spraak en het moment waarop het transcript wordt afgerond en doorgegeven aan de volgende fase. Scribe v2 Realtime verkleint deze kloof tot ongeveer 150 ms en streamt continu, zodat de output klaar is zodra de beurt eindigt.
Beurtwisseling en endpointing
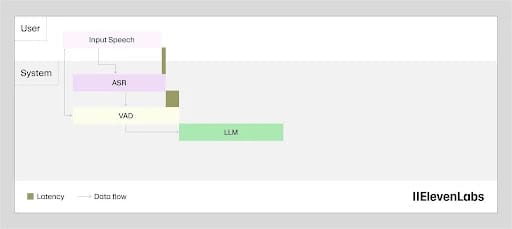
Een Voice Activity Detector (VAD) bevindt zich tussen de spraakherkenning en het taalmodel. Deze bepaalt wanneer de gebruiker daadwerkelijk is uitgesproken.
Om fouten te voorkomen wacht de VAD op een drempel van aanhoudende stilte voordat hij de beurt als beëindigd beschouwt. Die wachttijd voegt latency toe voordat het taalmodel een woord verwerkt. Die kleine extra latency kost weliswaar tijd, maar voorkomt ook dat het systeem reageert terwijl de gebruiker nog spreekt.
Technisch gezien zou de latency die wordt toegeschreven aan beurtwisseling positief zijn als alle andere onderdelen van conversationele AI geen latency hadden. Mensen nemen even de tijd voordat ze op spraak reageren. Als een machine een vergelijkbare pauze neemt, maakt dat de interactie realistischer. Omdat andere onderdelen van conversationele AI echter al latency veroorzaken, is minimale latency ideaal.
Verwerking door het taalmodel
Zodra het transcript klaar is uit de Speech to Text-engine (STT), genereert het taalmodel een antwoord. Latency is hier de tijd die nodig is om tokens te beginnen genereren, niet om de volledige reactie te genereren. Die tokens worden rechtstreeks naar de TTS-fase gestreamd zodra ze binnenkomen, dus TTFT is het belangrijkst.
Naast de modelkeuze zijn zowel de promptlengte als de omvang van de kennisbank van invloed op deze fase. Hoe meer context het LLM moet meenemen, hoe langer het duurt. Bij het ontwerpen van deze systemen op schaal is het belangrijk om de juiste balans te vinden tussen een nuttige kennisbank en een beknopte prompt om alles snel te houden.
Spraaksynthese
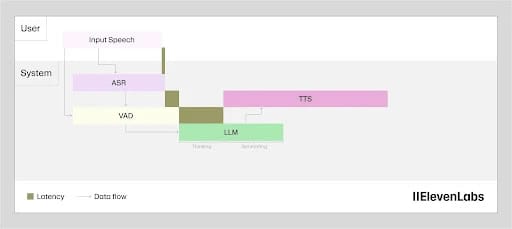
TTS-latency is de tijd tussen het ontvangen van de eerste tokens van het taalmodel en het begin van de audio. Omdat tokens sneller binnenkomen dan menselijke spraak wordt afgespeeld, wacht het synthesemodel nooit op de volledige reactie. TTS-latency is uitsluitend de tijd tot het eerste audiochunk.
Deze fase was vroeger de grootste afzonderlijke bijdrage aan latency in conversationele AI: oudere modellen hadden 2-3 seconden nodig voordat ze spraak begonnen te genereren. Flash v2.5 van ElevenLabs pakt dit direct aan met spraaksynthese met een latency van ~75 ms, waardoor dat knelpunt van seconden wordt teruggebracht tot een fractie van een seconde.
Netwerklatency
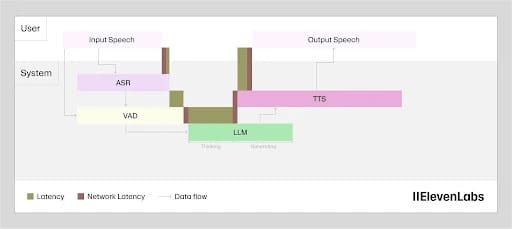
Het verzenden van data van de ene locatie naar de andere voegt altijd latency toe, waarbij geografische afstand de netwerklatency voor een round trip alleen maar vergroot.
Omdat meerdere onderdelen samenwerken voor een end-to-endreactie, kan aanzienlijke latency zich opstapelen door meerdere reeksen netwerkhops.
Function calling
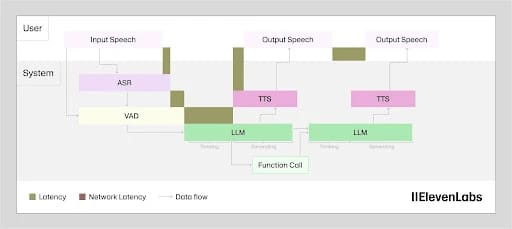
Function calls voegen API-round trips toe in de LLM-fase. Een snelle interne opzoeking voegt tientallen milliseconden toe, terwijl een betalingsverwerker of voorraadsysteem seconden kan toevoegen. De hoeveelheid latency hangt volledig af van de aangeroepen service, waardoor dit de moeilijkste fase is om direct te optimaliseren.
Het meest effectieve patroon is het LLM laten reageren voordat de tool call is voltooid. Een zin als "Ik zoek dat even voor je uit" houdt de gebruiker betrokken terwijl de externe call wordt afgehandeld, in plaats van stilte te laten vallen. De gesproken reactie begint terwijl de tool parallel draait.
Latency in conversationele AI verminderen
Om latency in conversationele AI te verminderen, moet je elke fase van de pipeline aanpakken in volgorde van impact. Afzonderlijke verbeteringen die je doorvoert hebben wel invloed op latency, maar voor de grootste verandering moet je de hele pipeline holistisch aanpakken.
Hier zijn enkele principes die je op hoofdlijnen kunnen helpen de latency in conversationele AI te verminderen:
- TTS-modelkeuze: TTS-modellen die zijn geoptimaliseerd voor snelheid, zoals Flash v2.5, gebruiken andere architecturen dan modellen die zijn geoptimaliseerd voor kwaliteit, zoals Eleven v3 en Eleven v4. Voor realtime voice agents is de juiste keuze het model met de hoogste kwaliteit dat aan je latencystreefwaarde voldoet. Dat is vrijwel altijd een model dat is geoptimaliseerd voor snelheid.
- LLM-modelkeuze: Kleinere, snellere LLM's leveren doorgaans een lagere time-to-first-token dan grotere modellen. Het is net zo belangrijk om het snelste LLM te kiezen dat nog steeds aan je kwaliteitsnorm voor de taak voldoet als om het juiste TTS-model te kiezen.
- Streaming: Met streaming TTS wordt audio in chunks teruggestuurd tijdens de synthese, zodat de gebruiker het eerste woord hoort terwijl het model de rest nog genereert. Dit concept geldt ook voor de LLM-output: door de TTS-synthese bij de eerste zin te starten terwijl het taalmodel volgende zinnen genereert, kun je latency uit de pipeline terugwinnen.
- System prompt-ontwerp: Gebruikers kunnen system prompts stroomlijnen door instructies in procedures of workflows onder te brengen, in plaats van ze onderdeel te maken van elke beslissingsstap. Daardoor hoeft het model bij elke beurt minder context te verwerken.
- Guardrails: Door guardrails in het streamingmodel uit te voeren, kan de output beginnen af te spelen voordat de guardrailcontrole is voltooid, in plaats van het afspelen te blokkeren tot de controle klaar is.
- Modellen op dezelfde locatie: Door waar mogelijk modellen op dezelfde locatie te gebruiken, zoals in de ElevenLabs Agents-stack, blijven onderdelen dicht bij elkaar en komt er geen latency bij door hops tussen afzonderlijk gehoste modellen.
- Geografie: Een kleine afstand tussen je servers en je gebruikers kan latency aanzienlijk verminderen, omdat dit de netwerkbijdrage aan de end-to-end-TTFA direct verlaagt.
Naast deze factoren kun je deze technische gids voor het optimaliseren van latency gebruiken voor meer informatie.
Ga aan de slag met conversationele AI met lage latency op ElevenAgents
Latency in conversationele AI is een belangrijke overweging bij het bouwen en inzetten van agents. Met ElevenAgents is latencyoptimalisatie ingebouwd in het proces. Van overlaptechnieken om tijd terug te winnen tot lage modelinference-latency voor afzonderlijke onderdelen: ElevenAgents bouwt conversationele AI-stacks met lage latency voor je bedrijf.
Uiteindelijk is het doel om realisme te creëren. Een gebruiker moet het gemak van een gesprek met een mens ervaren en tegelijk profiteren van een computerprogramma. Door de subprocessen te optimaliseren, is dat nu mogelijk.
Ontdek meer informatie over ElevenAgents of neem contact op met sales om vandaag nog aan de slag te gaan.
Veelgestelde vragen over latency in conversationele AI

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.