
Tutorial Python-spraakherkenning: van audiobestand naar transcript
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Spraakherkenning toevoegen aan een Python-app was vroeger omslachtig. Python-ontwikkelaars moesten zelf code schrijven voor het transcriptieproces, waaronder audiovoorbewerking, feature-extractie en modelintegratie. Bovendien worstelen engineeringteams met audioverwerking op laag niveau, matige transcriptiekwaliteit en vertragingen tussen gesproken woorden en live ondertiteling.
Vooruitgang in audiomodellen en SDK's voor spraakherkenning verandert dat.
In deze tutorial over spraakherkenning met Python leer je hoe je de audiomodellen van ElevenLabs Speech to Text in je Python-project integreert om transcriptie-apps voor commercieel gebruik te maken.
Samenvatting
- Commerciële Speech to Text-modellen bieden functies zoals sprekerdiarisatie, timestamps op woordniveau en keyterm prompting, die basale spraakherkenningsmodellen niet hebben.
- ElevenAPI voegt met Scribe v2 en Scribe v2 Realtime spraakherkenning toe aan je Python-code.
- Ontwikkelaars kunnen ElevenLabs-skills installeren op een AI-codeerplatform om nauwkeurige Python-code te genereren op basis van officiële API-documentatie.
- Je kunt de ElevenLabs API gratis proberen voordat je een betaald abonnement voor commerciële ontwikkeling neemt.
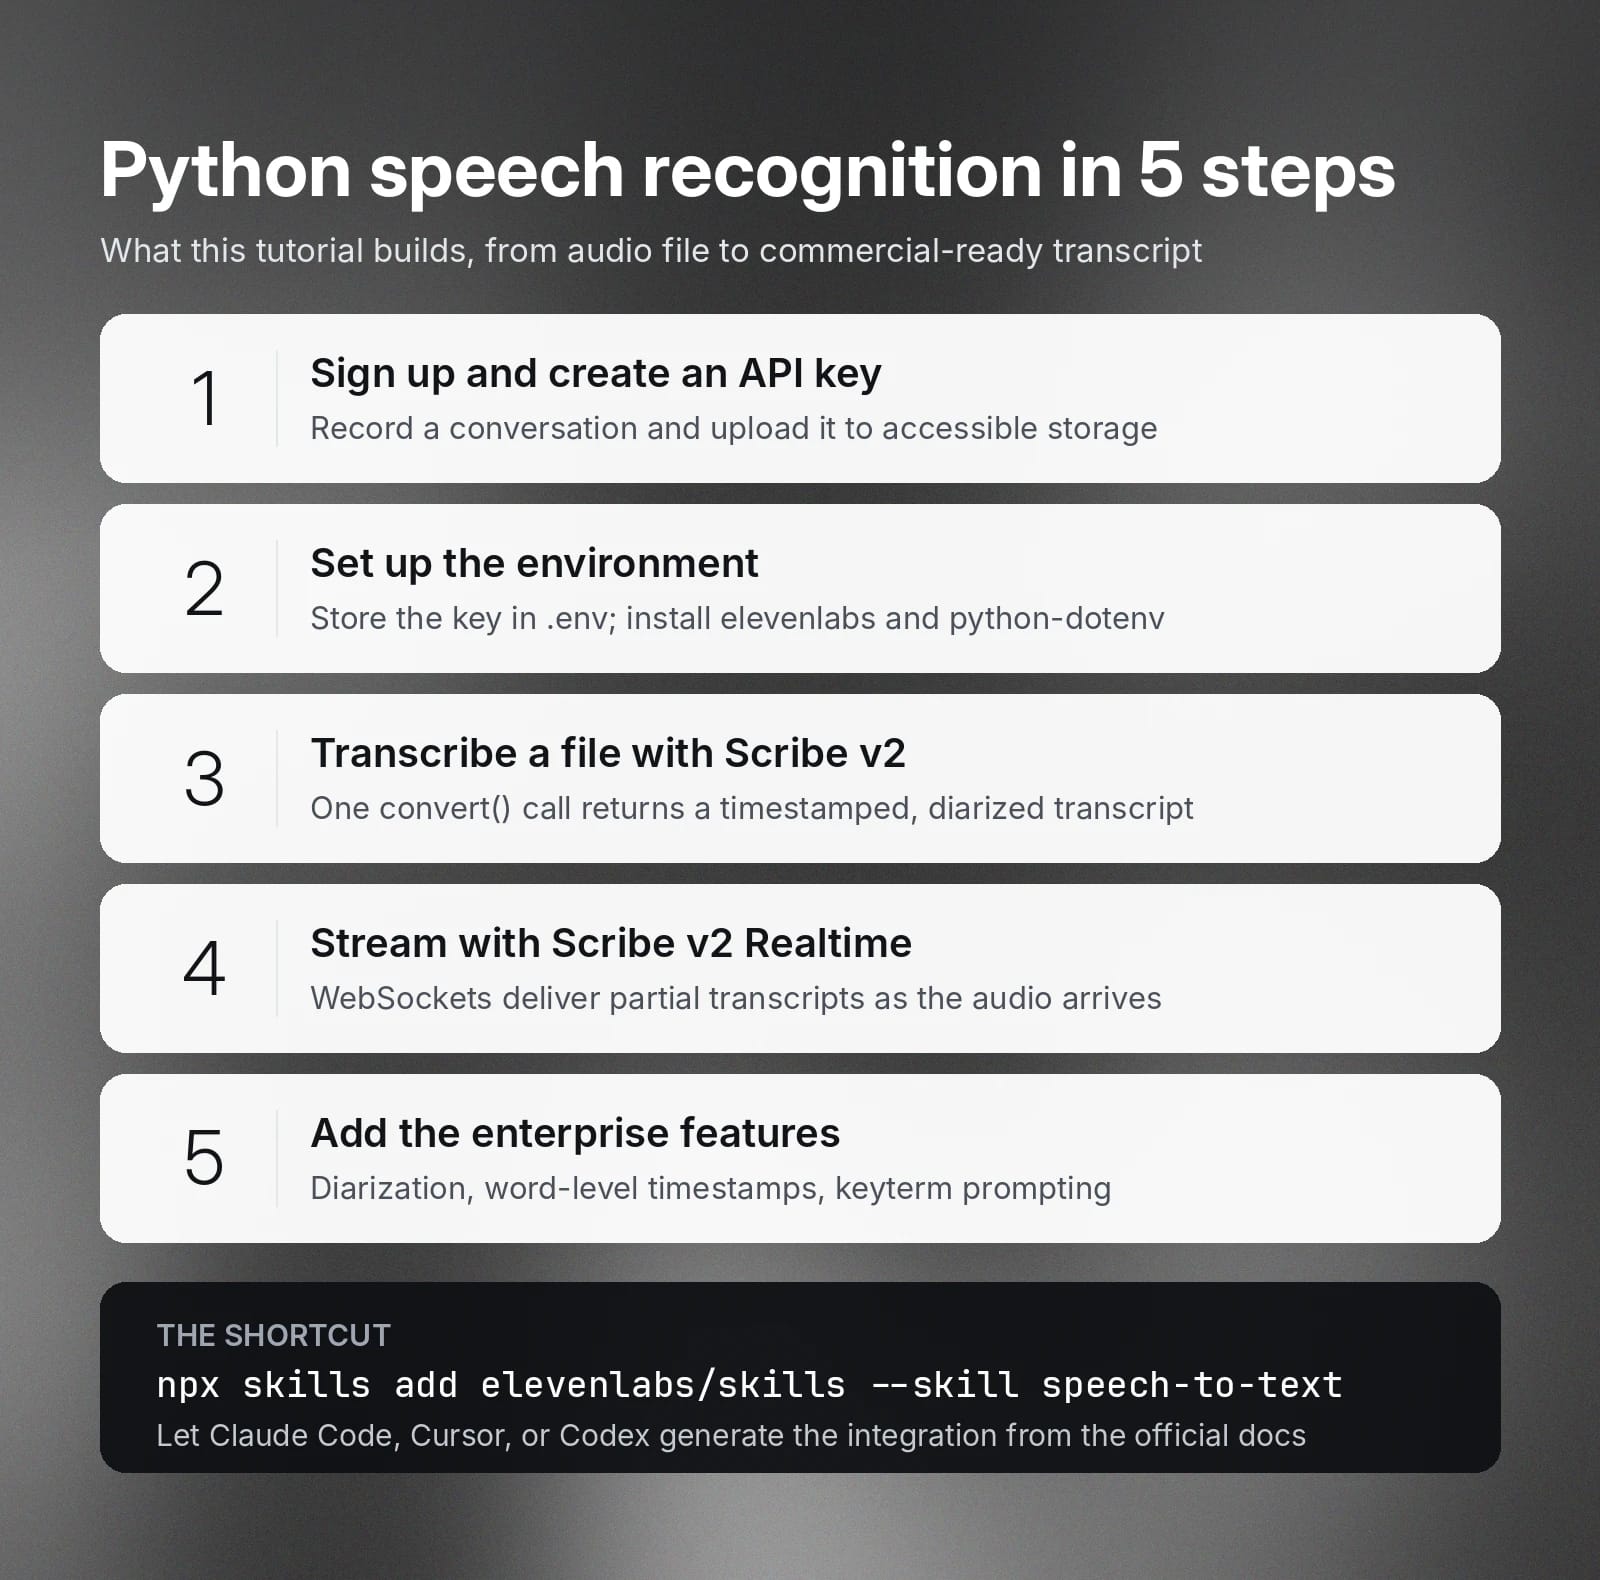
Wat deze tutorial over spraakherkenning met Python behandelt
Deze tutorial behandelt vereisten, API-integratie en geavanceerde transcriptiefuncties waarmee je een Python-app voor spraakherkenning kunt bouwen voor zakelijke toepassingen.
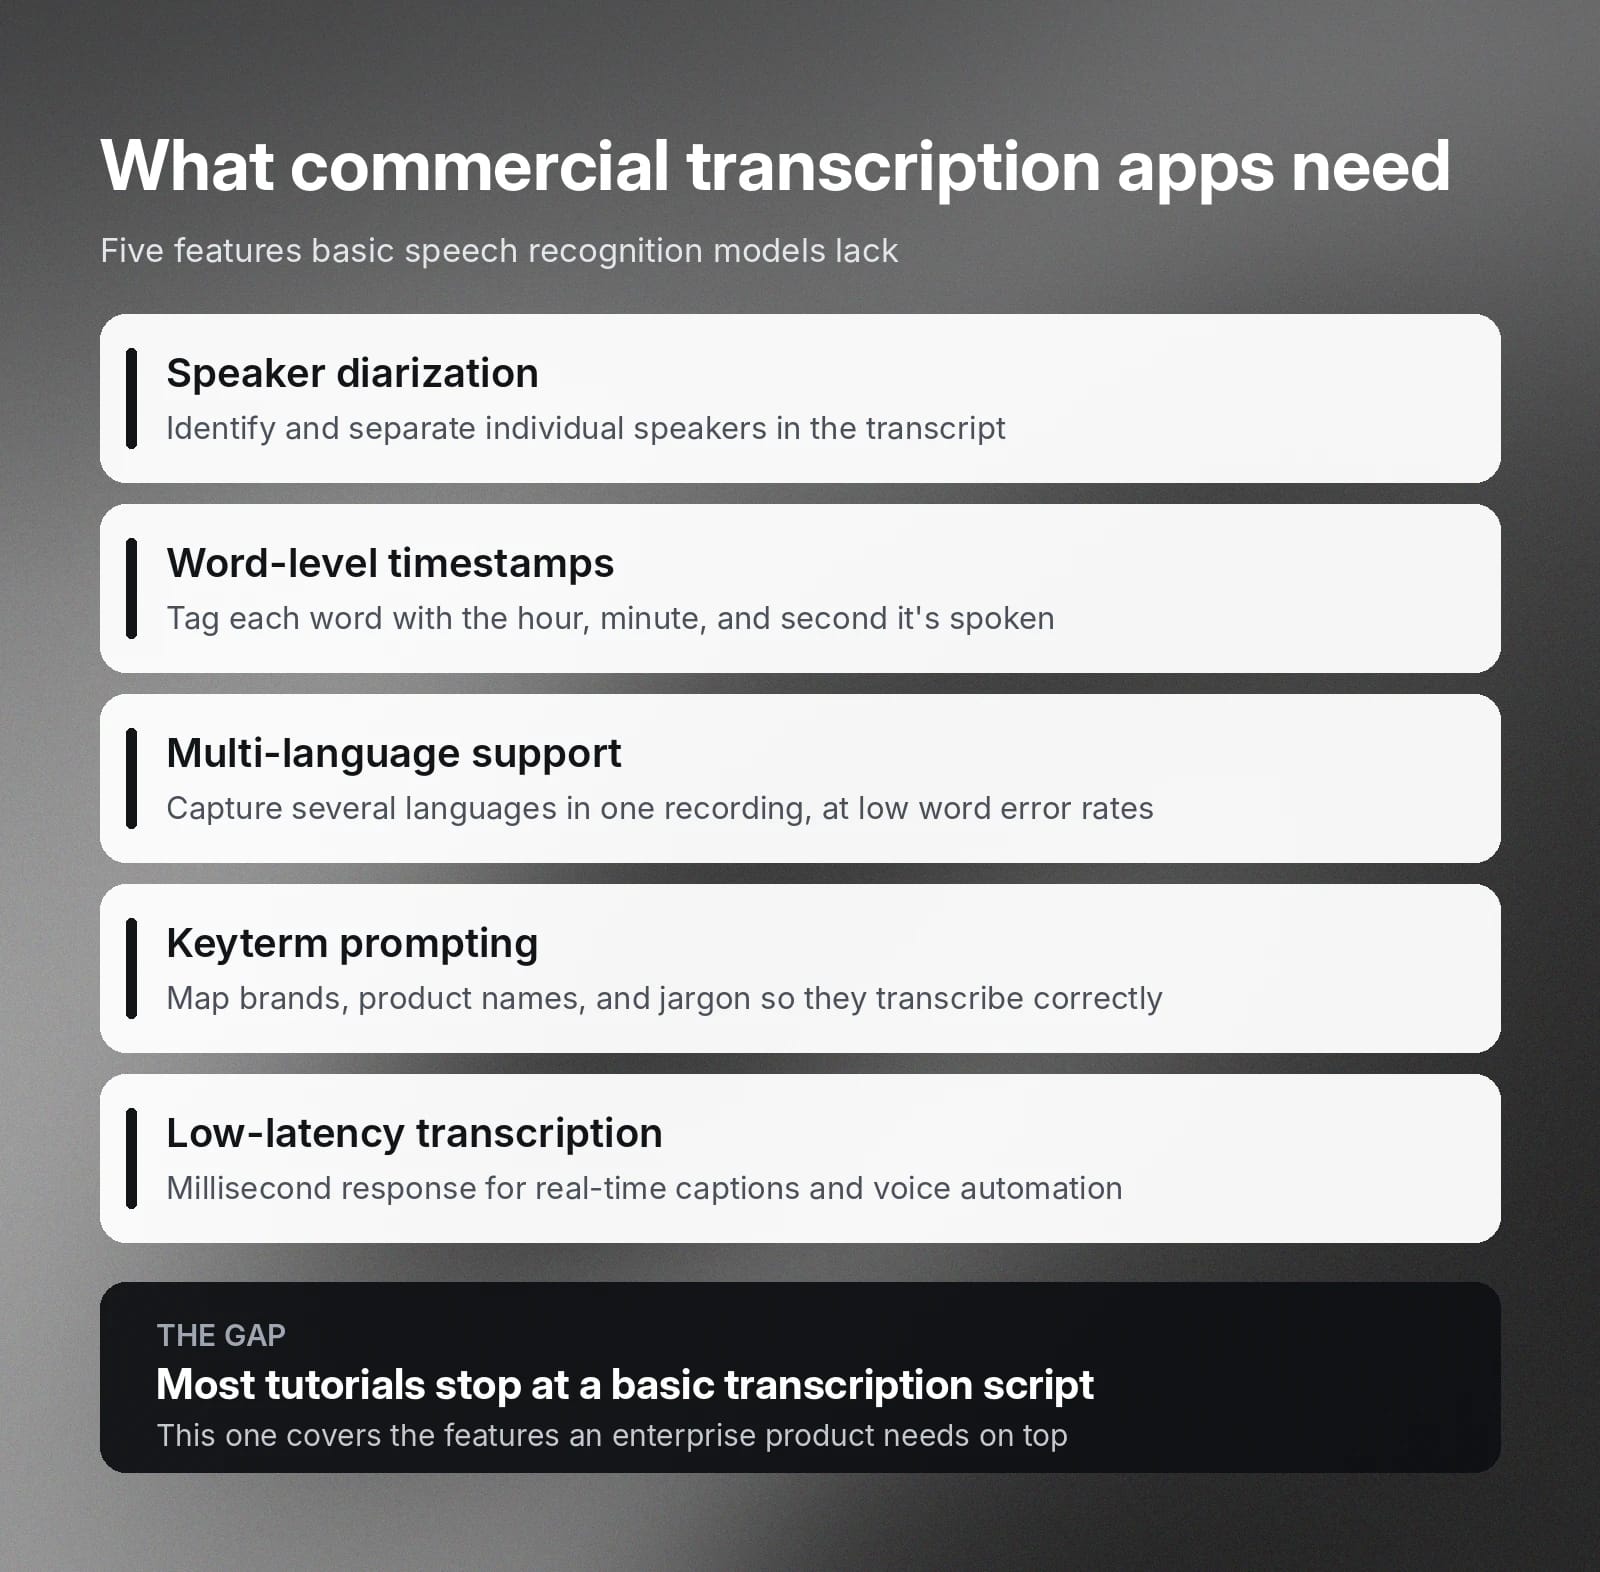
Spraakherkenning is de afgelopen jaren sterk ontwikkeld, vooral doordat large language models en neurale netwerken voor deep learning hebben veranderd hoe Python-ontwikkelaars transcriptie-SDK's gebruiken. Veel tutorials laten zien hoe je basale transcriptie-apps bouwt, maar slechts enkele behandelen de functies die een product voor commercieel gebruik nodig heeft.
We schreven deze tutorial om dat gat te dichten.
Veel transcriptieoplossingen voor bedrijven vereisen bijvoorbeeld deze functies:
- Sprekerdiarisatie: De mogelijkheid om individuele sprekers in het transcript te identificeren en van elkaar te onderscheiden.
- Timestamp: Elk woord nauwkeurig voorzien van de relatieve uren, minuten en seconden waarop het wordt uitgesproken.
- Ondersteuning voor meerdere talen: Legt spraak in verschillende talen binnen één opname of livestream vast met lage woordfoutpercentages.
- Keyterm prompting: Speciale woorden, zoals merken, productnamen en technische termen, toewijzen om verkeerd gespelde transcripties te voorkomen.
- Transcriptie met lage latentie: Een milliseconden snelle speech-to-text-reactie die realtime-transcriptie-apps mogelijk maakt.
Opmerking: Deze tutorial gaat verder dan het maken van eenvoudige persoonlijke scripts voor hobby- of persoonlijke projecten. Hij behandelt geen applicatielogica die is gebouwd boven op de integratie van de Speech to Text API, omdat die per bedrijf verschilt.
Vereisten voor integratie van spraakherkenning met Python
We baseren deze tutorial op ElevenAPI, een productieklare API van ElevenLabs die de interactie met stemmodellen in je code vereenvoudigt. Met ElevenAPI krijg je toegang tot Scribe v2 en Scribe v2 Realtime, onze toonaangevende stemmodellen voor batch- en live transcriptie.
In plaats van rechtstreeks ElevenLabs Speech to Text-modellen te gebruiken, verstuur je audio-opnamen, livestreams en argumenten via API-calls. Het audiomodel zet de audiogegevens vervolgens om in tekst. Na voltooiing ontvang je de transcripties in de code of via een webhook.
Volg deze voorbereidende stappen om aan de slag te gaan.
- Registreer je voor ElevenLabs.
- Maak je API-sleutel.
- Neem een gesprek op en upload het naar openbaar toegankelijke opslag.
Ga naar het volgende gedeelte zodra je klaar bent.
Je omgeving instellen
Stel je Python-omgeving in voordat je ElevenLabs-modellen integreert, zodat je ElevenLabs API-sleutel veilig is. Zoals voor alle API-sleutels raden we aan deze als omgevingsvariabele (een beheerd geheim) op te slaan in het .env-bestand.
Wanneer je een API-call doet, geef je de omgevingsvariabele door. Zo voorkom je dat je de API-sleutel per ongeluk blootstelt wanneer je API-requests via een openbaar netwerk doet.
Voer vervolgens een Bash-commando uit om elevenlabs, de ElevenLabs SDK, in je Python-omgeving te installeren. Met de SDK krijg je toegang tot verschillende stemmodellen. In dit geval kies je tussen Scribe v2 en Scribe v2 Realtime.
Je moet ook python-dotenv installeren, zodat je Python-code toegang krijgt tot omgevingsvariabelen die zijn opgeslagen in het .env-bestand.
Je eerste transcriptiescript schrijven
Zodra je de Python-omgeving hebt ingesteld, kun je het audiobestand transcriberen met ElevenLabs Scribe v2.
ElevenLabs Scribe v2 is een toonaangevend model voor spraakherkenning waarmee je audiobestanden op grote schaal kunt transcriberen. Het detecteert fonemen zeer nauwkeurig, zelfs wanneer de audio-opname veel achtergrondgeluid bevat. Om audio te transcriberen, stuur je de opname via de ElevenLabs API naar het model en haal je het voltooide transcript op.
Hieronder staat een Python-codefragment dat een audiobestand omzet in een transcript met timestamps en sprekerdiarisatie.
De code laadt de benodigde bibliotheken met de functies die de code nodig heeft. Ook worden de omgevingsvariabelen die je hebt gedeclareerd, in de programmaomgeving geladen.
Vervolgens maakt de code een ElevenLabs-client met de API-sleutel die is opgeslagen in de omgevingsvariabele. Daarna downloadt de code het audiobestand en zet dit om in binaire gegevens.
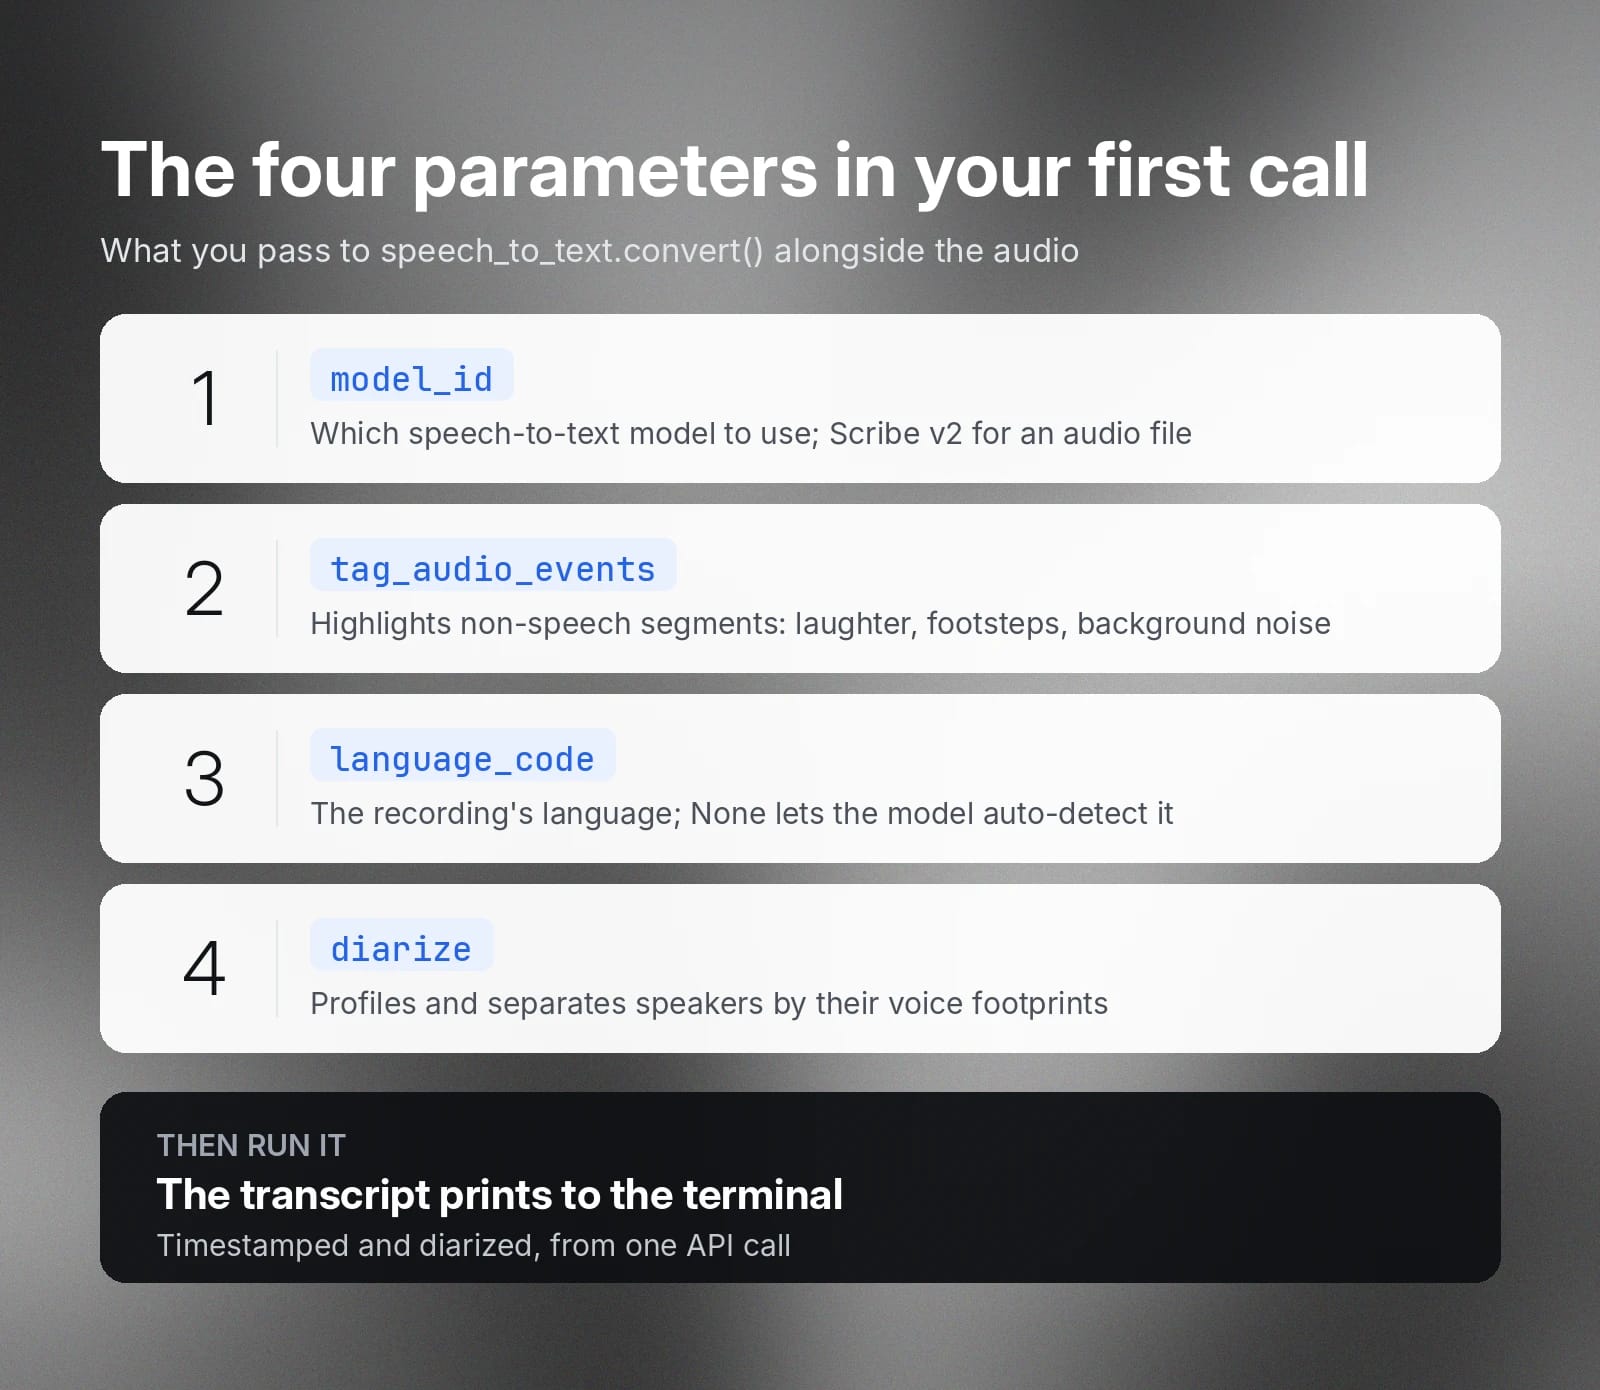
Zodra je de onbewerkte audiogegevens hebt, stuur je deze samen met verschillende parameters naar de ElevenLabs API.
- model_id geeft aan welk speech-to-text-model je wilt gebruiken. Omdat je een audiobestand doorgeeft, is Scribe v2 de beste optie.
- tag_audio_events laat je niet-spraaksegmenten markeren, zoals gelach, voetstappen en ander achtergrondgeluid.
- language_code staat voor de taal van de gesprekken in het opnamebestand. Wanneer deze is ingesteld op None, detecteert het model de taal automatisch.
- diarize geeft aan of je wilt dat het model verschillende sprekers profileert en onderscheidt op basis van hun stemkenmerken.
Voer ten slotte de code uit; je ziet de getranscribeerde audio dan in de terminal.
Streaming spraakherkenning in Python
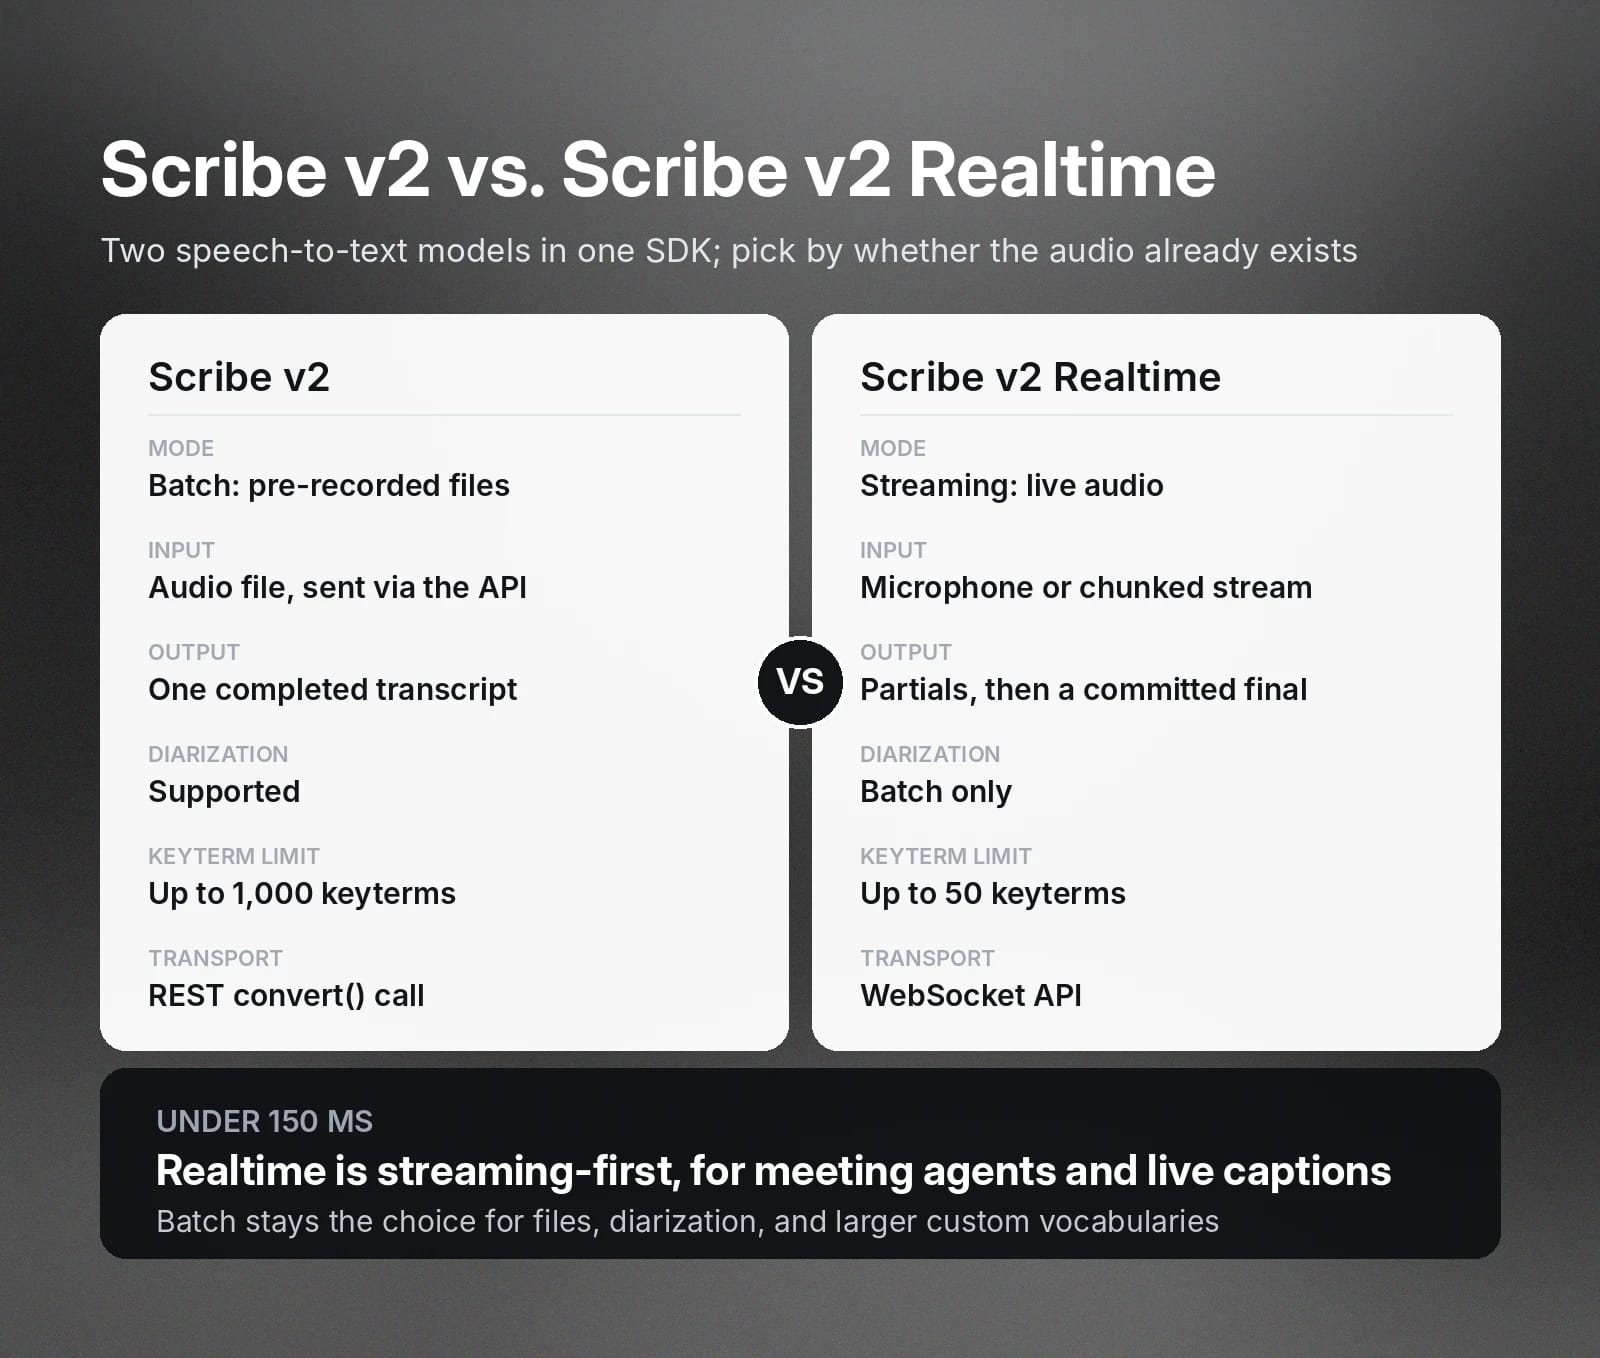
Het bovenstaande voorbeeld behandelt batchtranscriptie, wat geschikt is voor vooraf opgenomen bestanden. ElevenLabs biedt echter ook API's waarmee je streaming spraakherkenning kunt bouwen. In tegenstelling tot batchverwerking voert deze modus spraakherkenning realtime uit om transcripties te genereren terwijl het gesprek plaatsvindt.
Hiervoor verbind je je Python-code met het Scribe v2 Realtime-model via de WebSocket API.
Scribe v2 Realtime biedt een streaming-first-architectuur met een transcriptielatentie van minder dan 150 ms. Je gebruikt Scribe v2 Realtime om applicaties te bouwen zoals vergader-agents, toegankelijkheidstools en spraakgestuurde automatisering. Het model retourneert een gedeeltelijk transcript terwijl het de audiostream verwerkt. Het retourneert het definitieve transcript pas wanneer de code een audiosegment commit, automatisch of handmatig.
Afhankelijk van je audiobron en het type applicatie integreer je spraakherkenning met de ElevenLabs API aan de server- of clientzijde.
- Streaming aan de clientzijde laat je rechtstreeks vanaf de microfoon streamen of via handmatig opgedeelde audiostreams.
- Streaming aan de serverzijde stuurt audiogegevens van een URL of audiobron naar het stemmodel.
Met zowel streaming aan de clientzijde als aan de serverzijde kun je een asynchrone workflow gebruiken. Gebruik WebSockets om de resultaten te verwerken in plaats van de API voortdurend te pollen. In je code moet je handlers maken die gedeeltelijke en definitieve transcripties ontvangen.
Verdergaan: diarisatie, timestamps en aangepaste woordenschat
Naast automatische spraakherkenning ondersteunen ElevenLabs Speech to Text-modellen diarisatie, timestamps en aangepaste woordenschat.
- Diarisatie: Alleen batchtranscriptie ondersteunt sprekerdiarisatie. Je schakelt diarisatie in door het argument diarize in te stellen. Transcriptie met meerdere kanalen, een modus binnen batchtranscriptie, ondersteunt echter geen diarisatie.
- Timestamps: Bij batchtranscriptie kun je kiezen tussen timestamps op woord- of tekenniveau. Stel hiervoor de parameter timestamps_granularity in wanneer je de methode convert gebruikt.
- Aangepaste woordenschat: Zowel realtime- als batchtranscriptie ondersteunen keyterm prompting. Deze functie stuurt het model in de richting van het transcriberen van specifieke keyterms die je in een lijst opneemt. Scribe v2 Realtime ondersteunt maximaal 50 keyterms, terwijl Scribe v2 1.000 keyterms ondersteunt.
De ElevenLabs-skill gebruiken in AI-codeerassistenten
AI-codeerassistenten versnellen de ontwikkeling. Als je tools zoals Claude Code, Cursor, Codex of vergelijkbare AI-codeertools gebruikt, kun je ElevenLabs-skills aan de codeeromgeving toevoegen.
Je hoeft alleen deze opdracht uit te voeren in de terminal van je platform:
De AI-codeeragent downloadt de speech-to-text-skill uit de GitHub-repo van ElevenLabs en installeert deze in de lokale skilldirectory. Zo kun je automatisch Python-code voor spraakherkenning genereren op basis van de officiële documentatie van ElevenLabs, in plaats van de volledige API-integratie vanaf nul te schrijven.
Na installatie kun je Python-code voor spraakherkenning genereren door in gewone taal te beschrijven wat die moet doen. Op basis van de beschrijving genereert de codeerassistent automatisch code met de speech-to-text-skill, het juiste model en de juiste parameters.
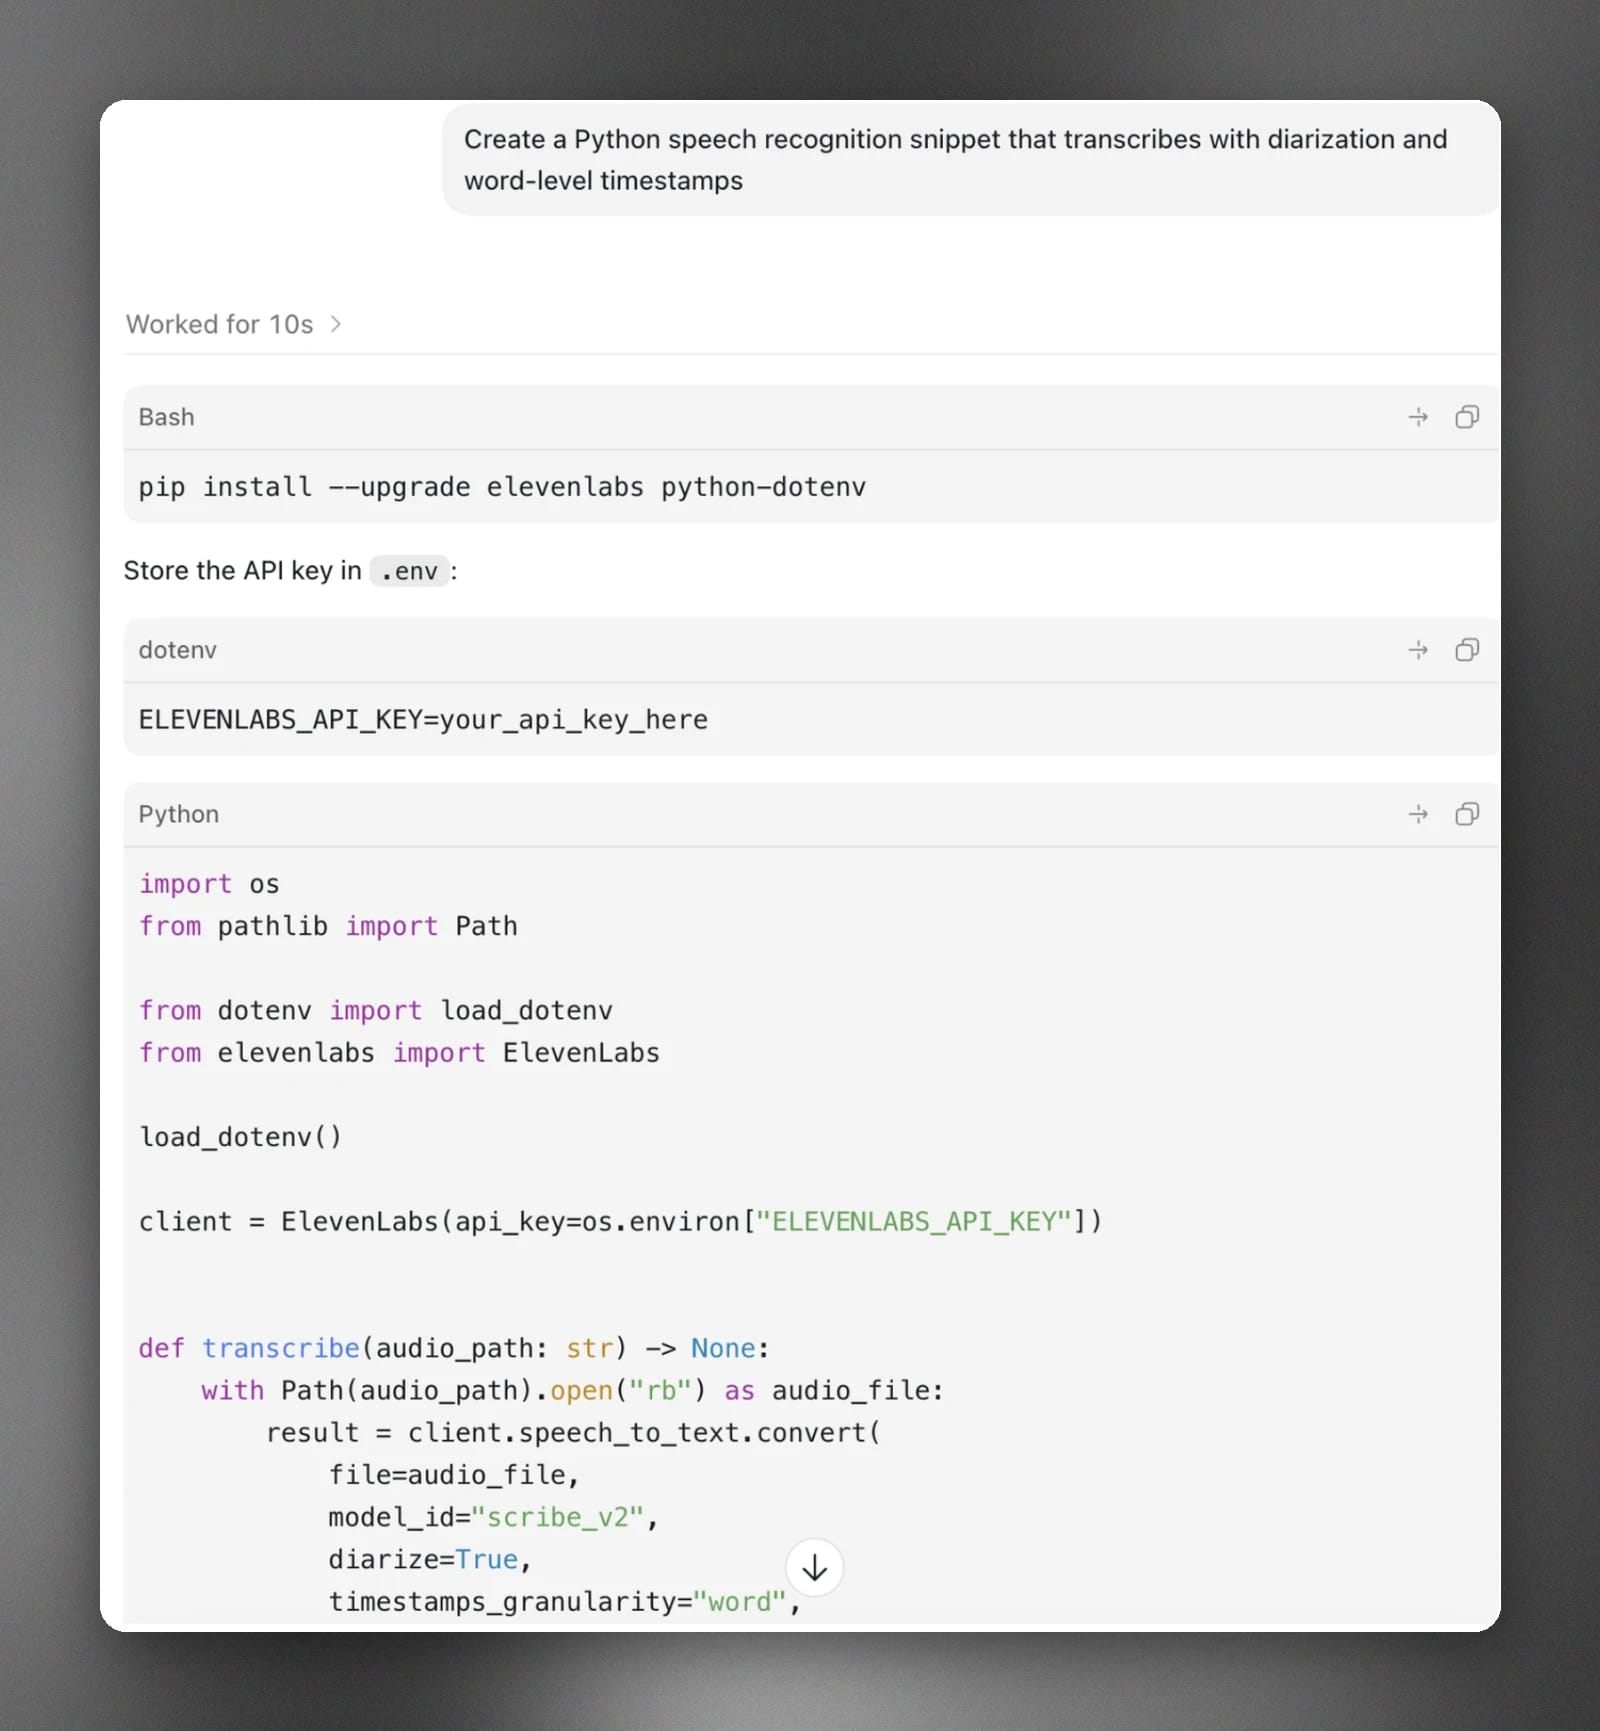
Als je bijvoorbeeld “Maak een Python-codefragment voor spraakherkenning dat transcribeert met diarisatie en timestamps op woordniveau” typt in Codex, krijg je een vergelijkbaar fragment als hieronder.
Aan de slag met ElevenAPI voor spraakherkenning
ElevenAPI geeft je toegang tot geavanceerde Speech to Text-modellen om spraakherkenningsapps in Python te bouwen.
Met ElevenAPI voorkom je dat je integratiecode vanaf nul moet schrijven, wat productinnovatie vertraagt. In plaats daarvan gebruik je SDK's die Speech to Text-services beschikbaar maken die voldoen aan commerciële vereisten, zoals keyterm prompting, diarisatie en timestamps.
Haal nu je ElevenLabs API-sleutel op en bekijk onze officiële documentatie om te leren hoe de API werkt.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


