
Hoe werkt audiotranscriptie met tijdstempels en eventtags?
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Een native transcriptiemodel op woordniveau gebruikt een audio-opname of realtime stream als input en geeft een gestructureerde array van getagde tokenobjecten met tijdstempels als output, die spraak en niet-spraakgeluiden vertegenwoordigen. Elk token is een van drie typen: word, spacing of audio_event. Audiogebeurtenissen kunnen gelach, applaus of andere achtergrondgeluiden zijn.
In dit artikel bekijken we hoe audiotranscriptie met tijdstempels werkt en waarom dit een flexibelere en krachtigere vorm van transcriptie is dan conventionele transcriptie die afhankelijk is van forced alignment.
Samenvatting
- Transcriptie op woordniveau geeft rechtstreeks gestructureerde arrays met tijdstempels van spraakgegevens en non-verbale audiogebeurtenissen als output.
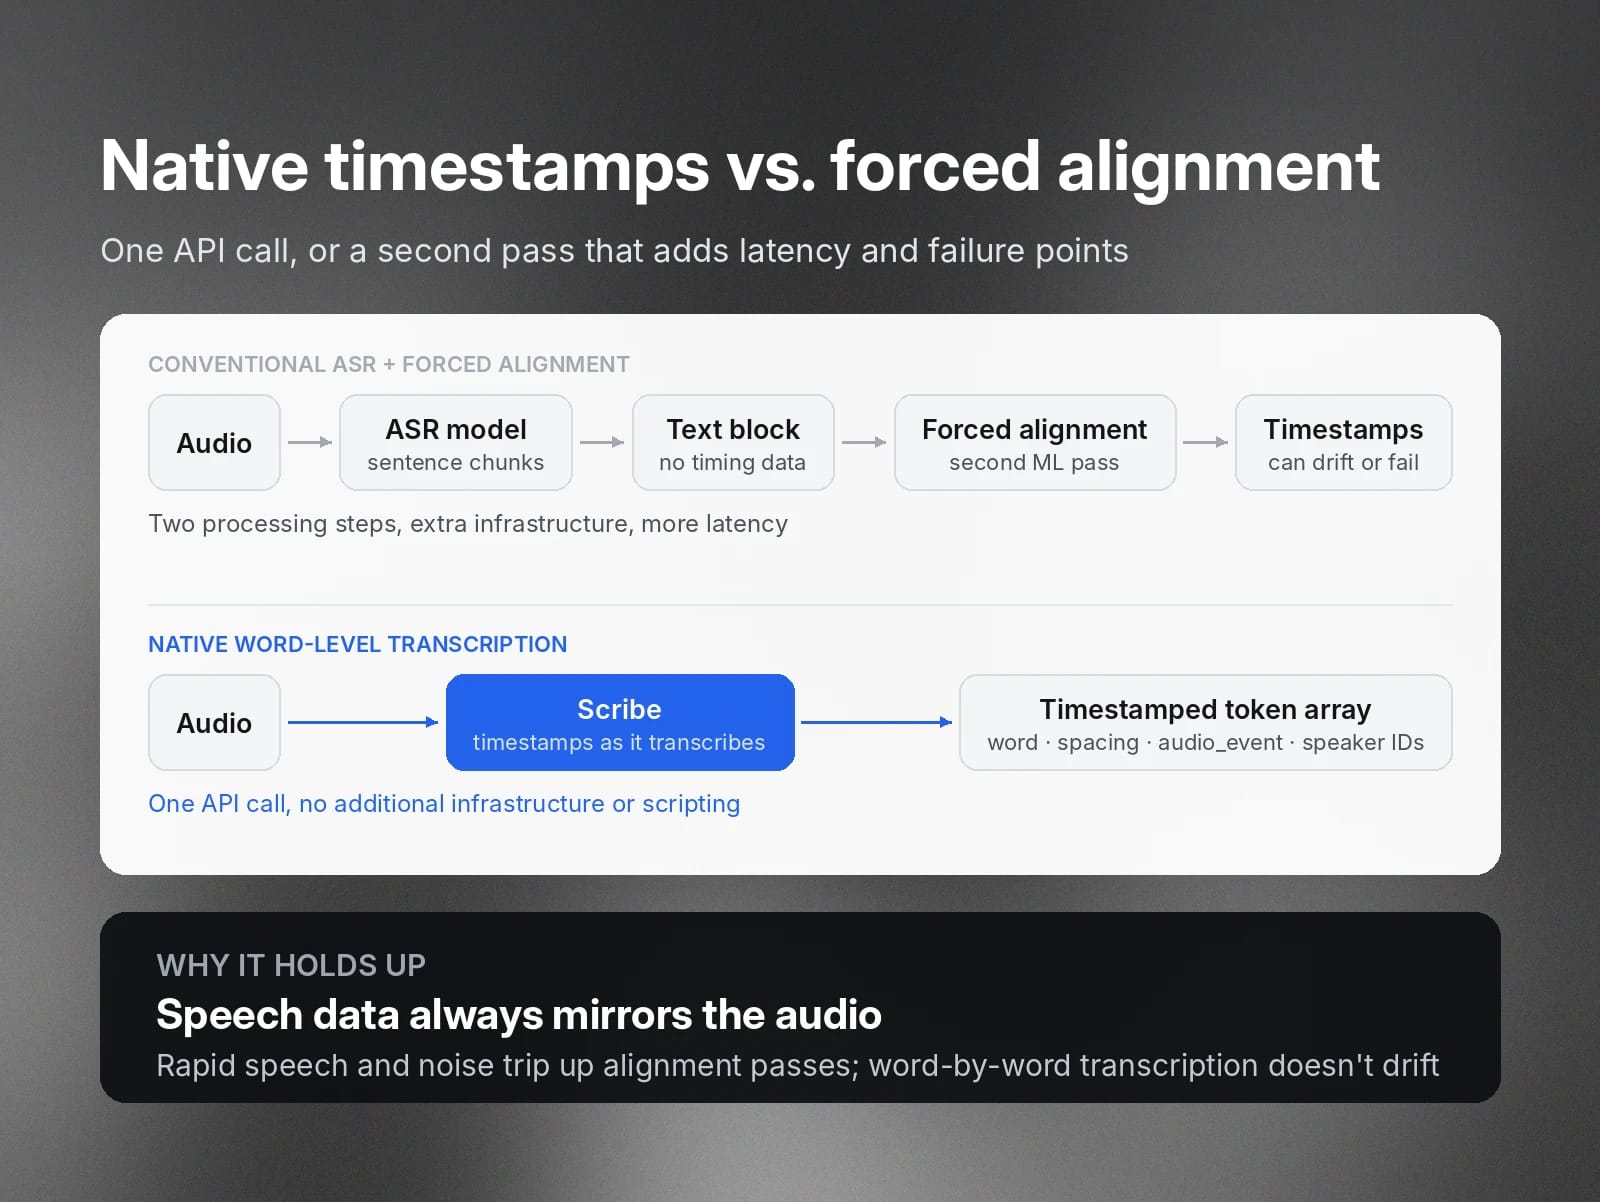
- Dit staat tegenover conventionele modellen voor automatische spraakherkenning, die volledige tekstblokken als output geven. Om daar tijdstempels aan de ruwe audio toe te voegen, moet je een tweede forced-alignmentproces uitvoeren. Dat duurt langer en voegt extra rekenbelasting toe.
- Met event tags leg je non-verbale content vast, zoals gelach of applaus. Omdat deze gegevens doorzoekbaar zijn, kun je ze gebruiken om op basis van reacties van het publiek hoogtepunten of virale momenten te identificeren.
- Je kunt de gestructureerde uitvoergegevens doorgeven aan applicaties voor uiteenlopende toepassingen, waaronder zeer nauwkeurige ondertiteling, doorzoekbare audioarchieven en geautomatiseerd knippen voor social media.
- De transcriptie op woordniveau van Scribe ondersteunt maximaal 5 kanalen, die elk onafhankelijk worden getranscribeerd.
Wat is audiotranscriptie met tijdstempels en event tags?
Transcriptie met tijdstempels is een vorm van automatische spraakherkenning (ASR) die tijdens het transcriberen de precieze begin- en eindpunten van woorden en andere audiogebeurtenissen, zoals applaus, bijhoudt. De output bestaat uit volledig gestructureerde, navigeerbare gegevens.
Conventionele ASR-transcriptie analyseert audio in grote blokken leesbare tekst. Je krijgt ondertiteling en een transcript voor menselijke lezers, maar als gegevens zijn ze niet erg bruikbaar.
Als je deze met tijdstempels wilt structureren, moet je de tekst opnieuw via een secundaire machinelearningservice verwerken om deze aan de audio te koppelen. Uiteindelijk kun je vergelijkbare output genereren, maar dat vereist meerdere verwerkingsstappen in plaats van dat deze native uit de API komt. Daardoor ontstaat enige latency en extra rekenbelasting.
Navigatie aan audio toevoegen
Het belangrijkste voordeel van transcriptie met tijdstempels en event tags is dat deze zowel voor mensen als machines leesbaar is. Dat heeft enkele belangrijke zakelijke toepassingen:
- Compliance-audits: Je kunt een transcript op trefwoorden doorzoeken en exacte tijdstempels krijgen voor elke vermelding van gevoelige gegevens.
- Videoproductie en -bewerking: Videoproductiesoftware kan ondertiteling tot op de milliseconde synchroniseren met wat er op het scherm wordt gezegd. De software kan ook reacties van het publiek passend labelen.
- Doorzoekbare archieven: Teams voor public relations, sales en training kunnen onder meer grote hoeveelheden klantinterviews, toespraken op beurzen, webinars of gemeentelijke bijeenkomsten transcriberen naar uitgebreide, doorzoekbare archieven.
- Marketinganalyses en klantensentiment: Met event tagging kun je reacties van het publiek labelen die in een eenvoudige teksttranscriptie verloren kunnen gaan.
Wat zijn de voordelen van native tijdstempels op woordniveau?
Standaard speech to text-modellen verwerken spraak in delen, meestal volledige zinnen of alinea's. Als je voor elk woord een tijdstempel wilt, moet je een extra verwerkingslaag ontwikkelen die in een tweede stap forced alignment uitvoert. Dit voegt infrastructuur en latency toe en brengt bovendien meer mogelijke foutpunten met zich mee. Zo kunnen modellen afwijken of volledig falen bij het verwerken van snelle spraak of spraak die wordt overstemd door hard achtergrondgeluid.
Transcriptie met tijdstempels, zoals Scribe kan uitvoeren, omzeilt dit probleem door op een gedetailleerder niveau te transcriberen, woord voor woord. Dit gebeurt in één API-aanroep. Er is geen extra infrastructuur of scripting nodig. Het model berekent tijdstempels tijdens het transcriberen, zodat spraakgegevens altijd nauwkeurig overeenkomen met de audio.
Hoe werkt transcriptie met tijdstempels en event tags?
Laten we Scribe als voorbeeld nemen.
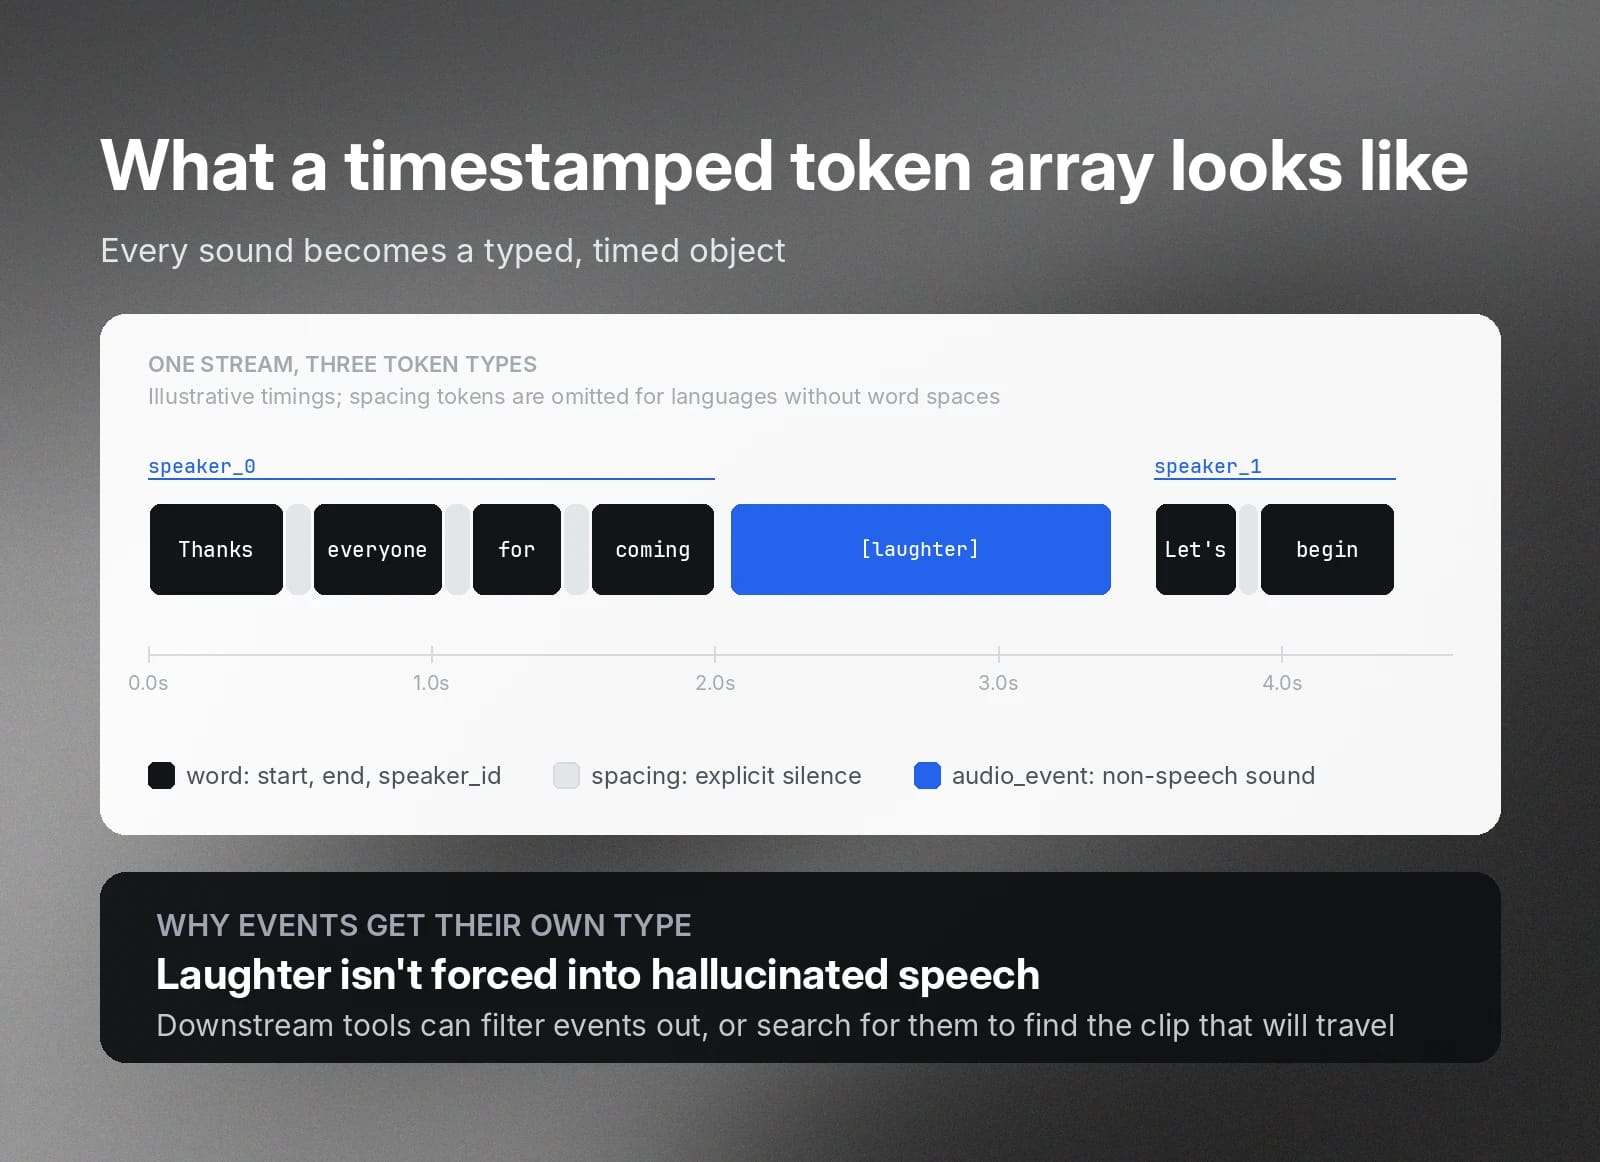
Een native transcriptiemodel op woordniveau zet de spraakgeluiden in een audiofeed om in een gestructureerde array van tokenobjecten. Het labelt elk token als een van drie typen: word, spacing of audio_event.
- word: Een herkend, afzonderlijk gesproken woord met geregistreerde begin- en eindtijden en een speaker_id-tag.
- spacing: Expliciet gelabelde stilte of pauzes tijdens spraak. Handig om ondertitelingsdiensten in het juiste tempo te laten werken. Niet gebruikt voor gedetecteerde talen die geen spaties tussen woorden gebruiken, zoals Japans, Mandarijn, Thai, Lao, Birmaans en Kantonees.
- audio_event: Betekenisvolle non-verbale audio, zoals gelach of applaus. Het model structureert deze als een afzonderlijk gebeurtenistype en dwingt de audio niet tot gehallucineerde spraak.
Parameters voor realtime streaming
Transcriptiemodellen op woordniveau kunnen ook speciale functies bevatten ter ondersteuning van live audiotranscriptie via WebSocket. Bijvoorbeeld:
- include_timestamps=true: Deze parameter zorgt ervoor dat de verbinding tijdstempels op woordniveau opneemt in de JSON-berichten committed_transcript_with_timestamps die aan het einde van elk afgerond audiosegment worden verzonden. Zo krijg je tijdstempels terwijl de stream nog actief is. Tags voor audiogebeurtenissen worden alleen opgenomen als tag_audio_events ook is ingeschakeld.
- include_language_detection=true: Deze parameter vertelt de verbinding om gedetecteerde gesproken talen te taggen, samen met de betrouwbaarheidsscore van het model voor de detectie. Hiermee kun je live meertalige ondertiteling uitvoeren.
Hoe tagt een Speech to Text-model niet-spraakgebeurtenissen?
Scribe tagt audiogebeurtenissen wanneer je de parameter tag_audio_events hebt ingeschakeld. In dat geval tagt het specifieke begin- en eindtijden en voegt het tijdstempels toe, net zoals bij woorden. Het kan verschillende reacties taggen, meestal gelach en applaus, maar ook andere omgevingsgeluiden die in de context betekenisvol kunnen zijn, waaronder voetstappen of achtergrondmuziek.
Dit verrijkt transcripts en ondertiteling direct met belangrijke context. Sarcasme kan voor een lezer lastiger te begrijpen zijn in eenvoudige, vlakke tekst. Een [laughter]-tag verrijkt het transcript en geeft het meer emotionele zeggingskracht.
Betere analyses
Event tagging maakt ook alle verdere analyses die je uitvoert overzichtelijker, omdat die tools niet één blok ongestructureerde tekst hoeven te parseren. Native transcriptie op woordniveau scheidt audiogebeurtenissen als gestructureerde gegevens, zodat je tools ze waar nodig gewoon kunnen wegfilteren en alleen verbale content kunnen verwerken.
Omdat spacing-tokens pauzes zichtbaar maken, kun je ze analyseren. Dit kan waardevol zijn voor sentimentanalyse en QA-toepassingen, bijvoorbeeld om te meten hoe lang een klantenservicemedewerker stil was tijdens een gesprek.
Eenvoudiger zoeken op tijdstempels
Of je kunt er gericht naar zoeken. Als je sentimentanalyse uitvoert op een interview voor producttests, kun je betekenisvolle emotionele reacties eruit halen. Of als je een socialmedia-account beheert, kun je snel zoeken naar gelach in een speech van een uur om de clips te vinden waarvan je denkt dat ze het meest waarschijnlijk viraal gaan.
Wat zijn praktische toepassingen van gestructureerde transcripts met tijdstempels?
Het native verkrijgen van gestructureerde gegevens in transcripts heeft verschillende belangrijke toepassingen.
Ondertiteling en captions genereren
Je kunt transcripts met tijdstempels rechtstreeks exporteren naar productieformaten voor ondertiteling, waaronder SRT en VTT, zonder tussenliggende verwerking. Je videobewerkingstool kan de woordtiming gebruiken om woorden in de ondertiteling te markeren terwijl ze worden uitgesproken.
Het transcriptiemodel kan snelle spraak eenvoudig analyseren, omdat het woord voor woord verwerkt. Waar een conventioneel model kan struikelen over zeer snelle spraak of overlappende stemmen, kan een model op woordniveau zoals Scribe een helder, gestructureerd transcript leveren.
Audio en video doorzoeken
Met conventionele transcriptie kun je trefwoorden in het tekstblok vergelijken, maar zonder forced alignment kun je niet naar het moment springen waarop een zin werd uitgesproken. Een zoekopdracht op trefwoorden in een transcript op woordniveau is volledig geïndexeerd en brengt je rechtstreeks naar de seconde waarop een zin in de audio werd uitgesproken. Zo verander je je audioarchief in feite in een volledig doorzoekbare referentiecatalogus. Deze mogelijkheid is vooral nuttig voor het beheren van grote mediabibliotheken, podcastnetwerken en bedrijfsarchieven.
Compliance- en risicoaudits
Vaak wil je audio met gevoelige informatie opnemen, bijvoorbeeld gesprekken met de klantenservice voor QA. Juist deze gesprekken bevatten waarschijnlijk gevoelige of gereguleerde persoonsgegevens.
Om aan de regels te blijven voldoen en toch audiogegevens voor analyses te hebben, heb je een manier nodig om gevoelige gegevens realtime uit transcripts te redigeren. Met native tijdstempels op woordniveau kun je gebruikmaken van functies zoals Entity Detection van ElevenLabs, die gevoelige entiteiten markeert, zoals creditcardnummers of namen, en de offsets en tijdstempels retourneert zodat je deze in je transcripts kunt verbergen terwijl ze binnenkomen.
Je kunt bijvoorbeeld een creditcardnummer, de meisjesnaam van de moeder, geboortedatum en klantnaam detecteren en redigeren terwijl deze worden uitgesproken in een gesprek waarin iemands identiteit wordt geverifieerd.
Geautomatiseerd knippen voor social media
Je kunt ook zoekopdrachten op trefwoorden programmatisch automatiseren om hoogtepunten te vinden in langere content. Je kunt bijvoorbeeld belangrijke momenten uit een campagnetoespraak of bedrijfsseminar uitlichten. Dit helpt je recente content om te zetten in professioneel bewerkte hoogtepunten voor YouTube, LinkedIn of TikTok.
Timing voor meerdere kanalen en sprekers
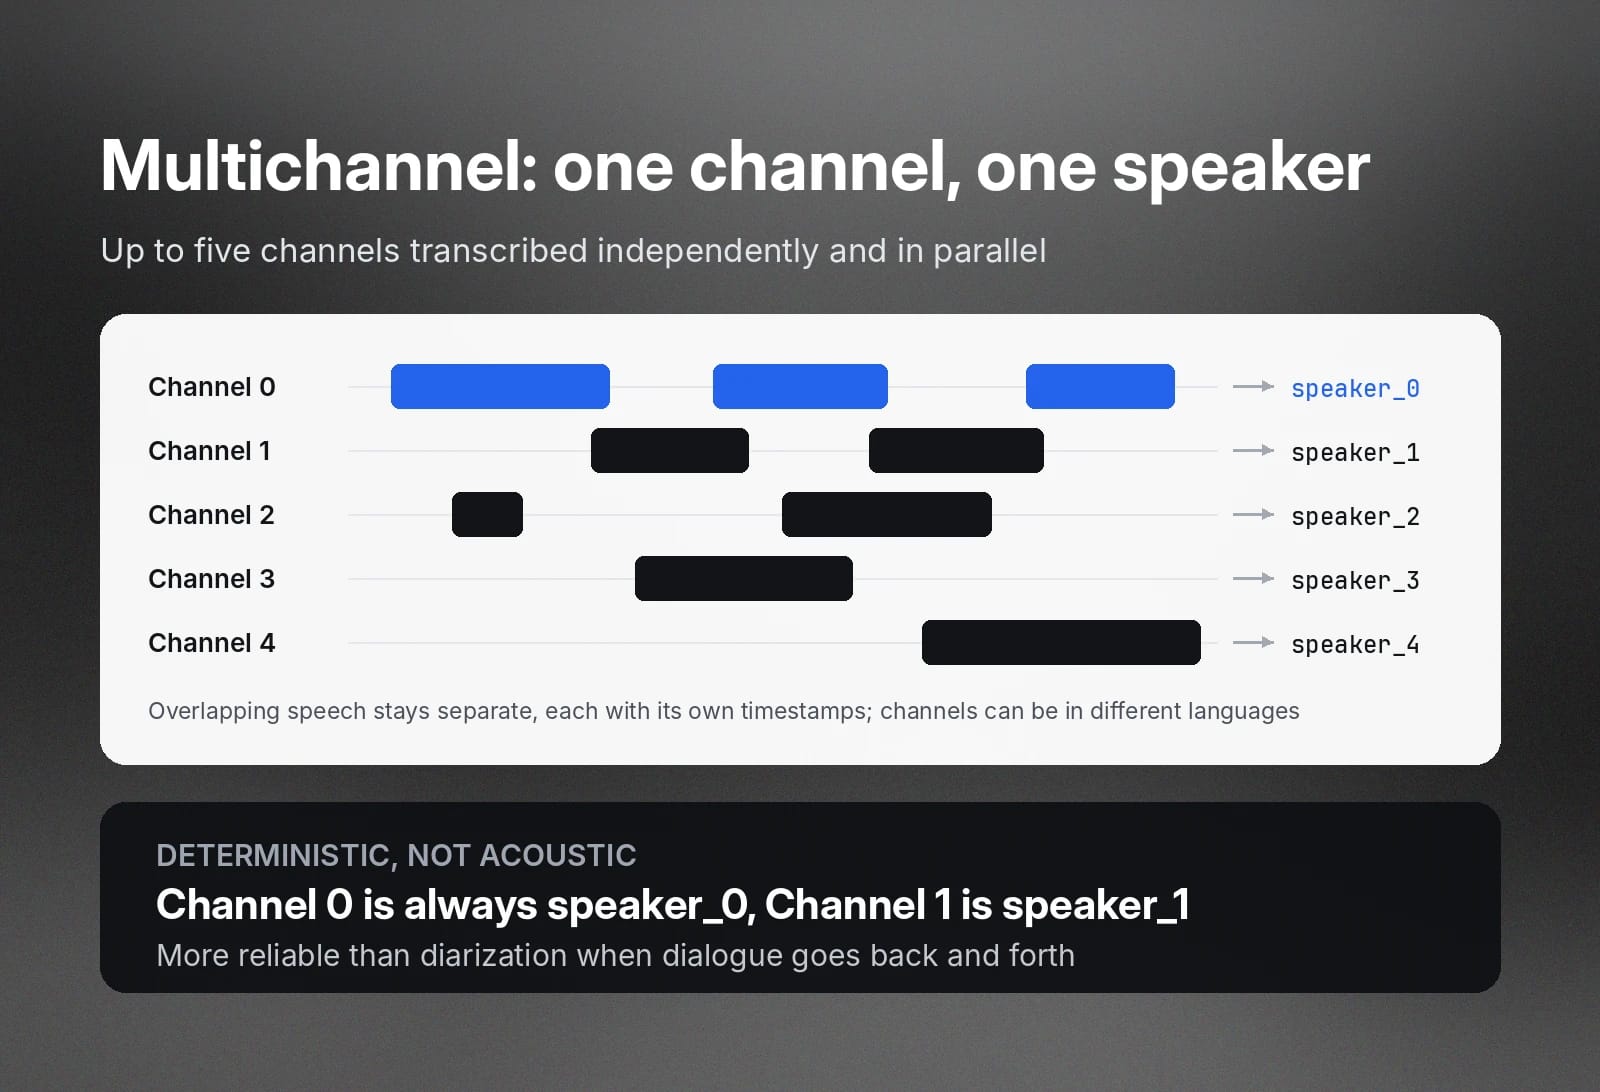
Scribe kan maximaal vijf kanalen onafhankelijk en parallel transcriberen. Elk kanaal krijgt een toegewezen speaker ID en tijdstempels. Dit is betrouwbaarder dan standaard akoestische sprekerdiarisatie, die vaak moeite heeft met dialogen waarin sprekers elkaar afwisselen. Bij opnamen met meerdere kanalen is de sprekerstoewijzing van Scribe volledig deterministisch. Dat betekent dat Channel 0 wordt toegewezen aan speaker_0, Channel 1 aan speaker_1, enzovoort.
Het kan sprekers herkennen die tegelijk proberen te praten en toch onafhankelijke tijdstempels voor hun spraak genereren. Ze kunnen ook verschillende talen spreken.
Gegevens met tijdstempels exporteren in het formaat dat je nodig hebt
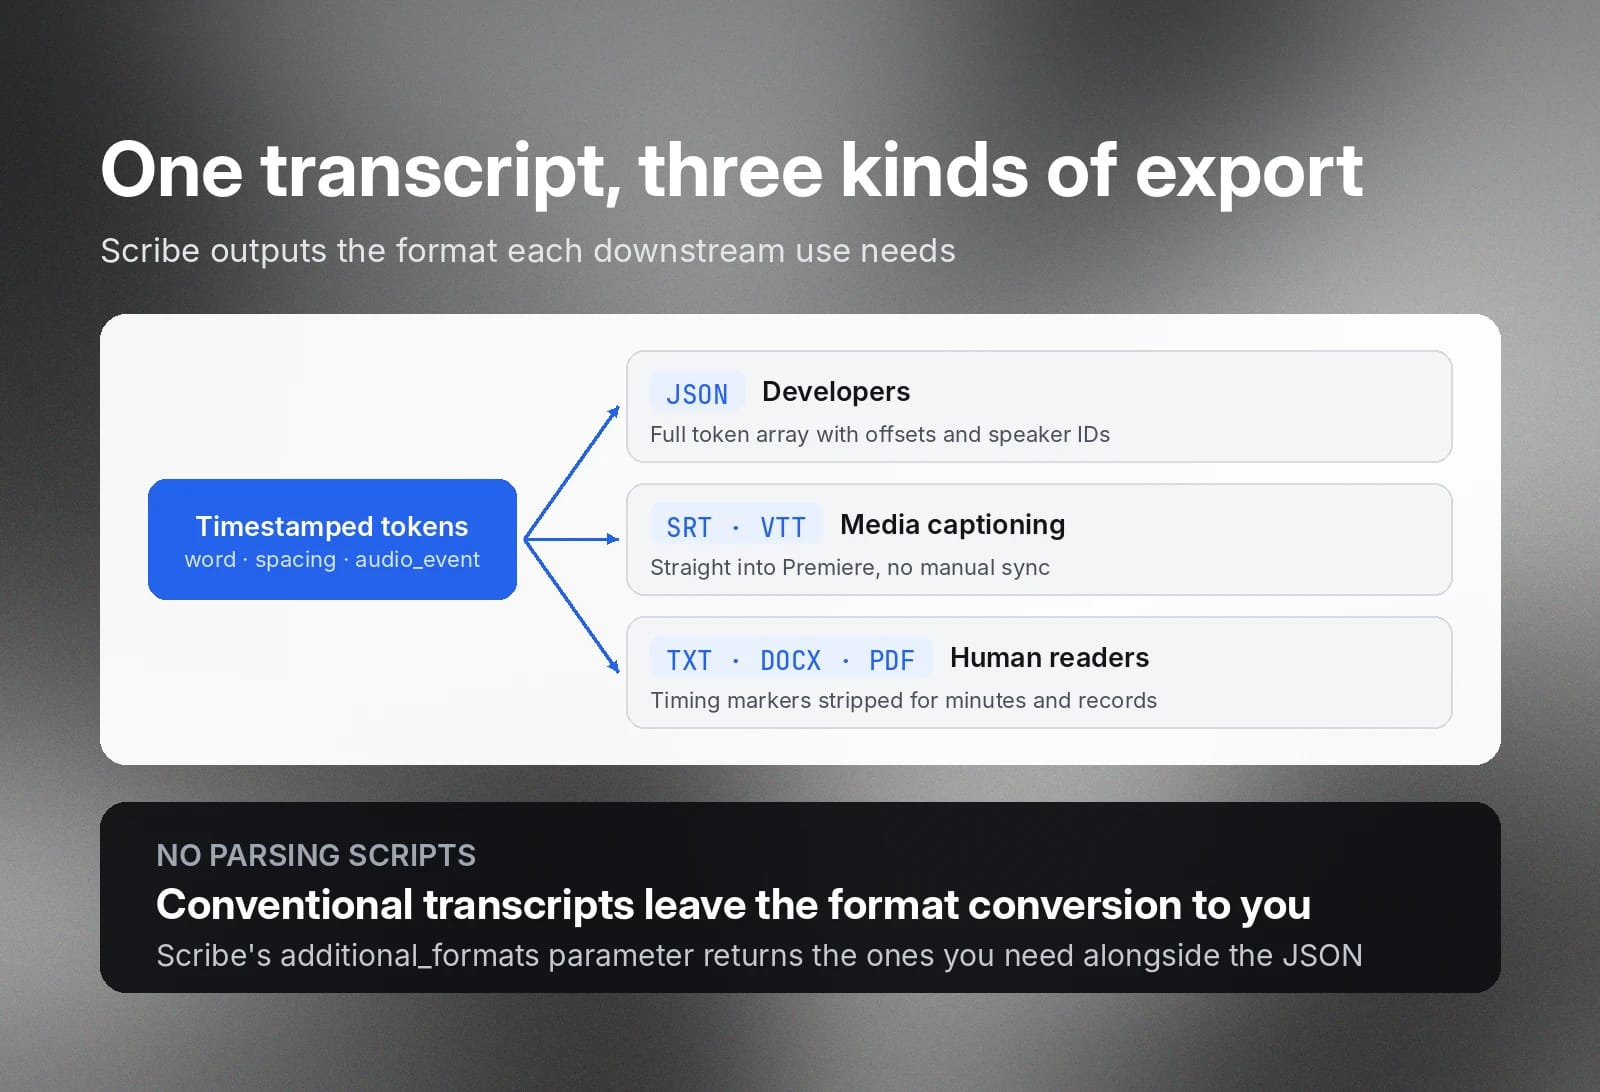
Als je conventionele transcripts in meerdere formaten wilt verspreiden, moet je de parsingscripts waarschijnlijk zelf schrijven. Scribe kan transcripts in verschillende formaten exporteren, afhankelijk van hoe je ze wilt gebruiken. Je vindt volledige schemadefinities in de ElevenLabs Create Transcript API Reference.
Gestructureerde gegevens voor ontwikkelaars: JSON
Scribe ondersteunt export naar JSON voor ontwikkelaars die gegevens willen in een schema dat ze aan verdere applicaties kunnen doorgeven. Ontwikkelaars kunnen deze JSON-gegevens bijvoorbeeld gebruiken om interactieve media of een semantische zoekdatabase voor je organisatie te bouwen. De volledige array van word-, spacing- en audio_event-tokens wordt uitgevoerd met begin- en eindoffsets en speaker ID's.
Ondertiteling voor media: SRT en VTT
Scribe kan SRT- en VTT-transcripts uitvoeren die je zonder handmatige synchronisatie rechtstreeks kunt invoeren in Adobe Premiere of andere productieapplicaties.
Leesbaar voor mensen: TXT, DOCX en PDF
Het kan transcripts ook uitvoeren in lezersvriendelijke formaten. In deze formaten verwijdert Scribe low-level tijdsmarkeringen om de tekst leesbaarder en geschikt voor juridische documentatie of auditdocumentatie te maken. Dit is bijvoorbeeld nuttig wanneer je notulen van bestuursvergaderingen direct na een sessie efficiënt moet verspreiden, podcasttranscripts voor SEO wilt publiceren of juridische documenten wilt archiveren.
Gebruik transcriptie van ElevenLabs met tijdstempels en event tags
Native transcriptie op woordniveau geeft je snel en efficiënt de gestructureerde gegevens die je voor je workflows nodig hebt.
Begin vandaag nog met het transcriberen van je audio met Scribe in ElevenAPI of lees meer over transcriptie op woordniveau.
Veelgestelde vragen over tijdstempels en transcriptie met event tags

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


