Text to Speech vs Speech to Text: wat is het verschil?
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Stel je dit eens voor: je rijdt naar je werk en je smartphone leest je ongelezen e-mails voor met tekst-naar-spraak-software (TTS). Nog beter: je verstuurt je antwoorden zonder je telefoon aan te raken of je ogen van de weg te halen — allemaal dankzij Speech to Text-software (STT).
Deze technologieën zijn niet alleen leuke, futuristische concepten. Ze worden snel een onmisbaar onderdeel van ons dagelijks leven, vereenvoudigen alledaagse taken en verbeteren de toegankelijkheid.
Duik met ons in de wereld van TTS en STT op basis van kunstmatige intelligentie. We bekijken wat ze zijn, waarin ze verschillen, hoe ze werken, waar je op moet letten bij TTS- en STT-providers en op welke manieren ze in verschillende sectoren worden toegepast.
De verschillen tussen TTS en Text from Speech
Er zijn verschillende belangrijke verschillen tussen TTS en Text from Speech-technologie. Dit zijn de belangrijkste.
Functionaliteit
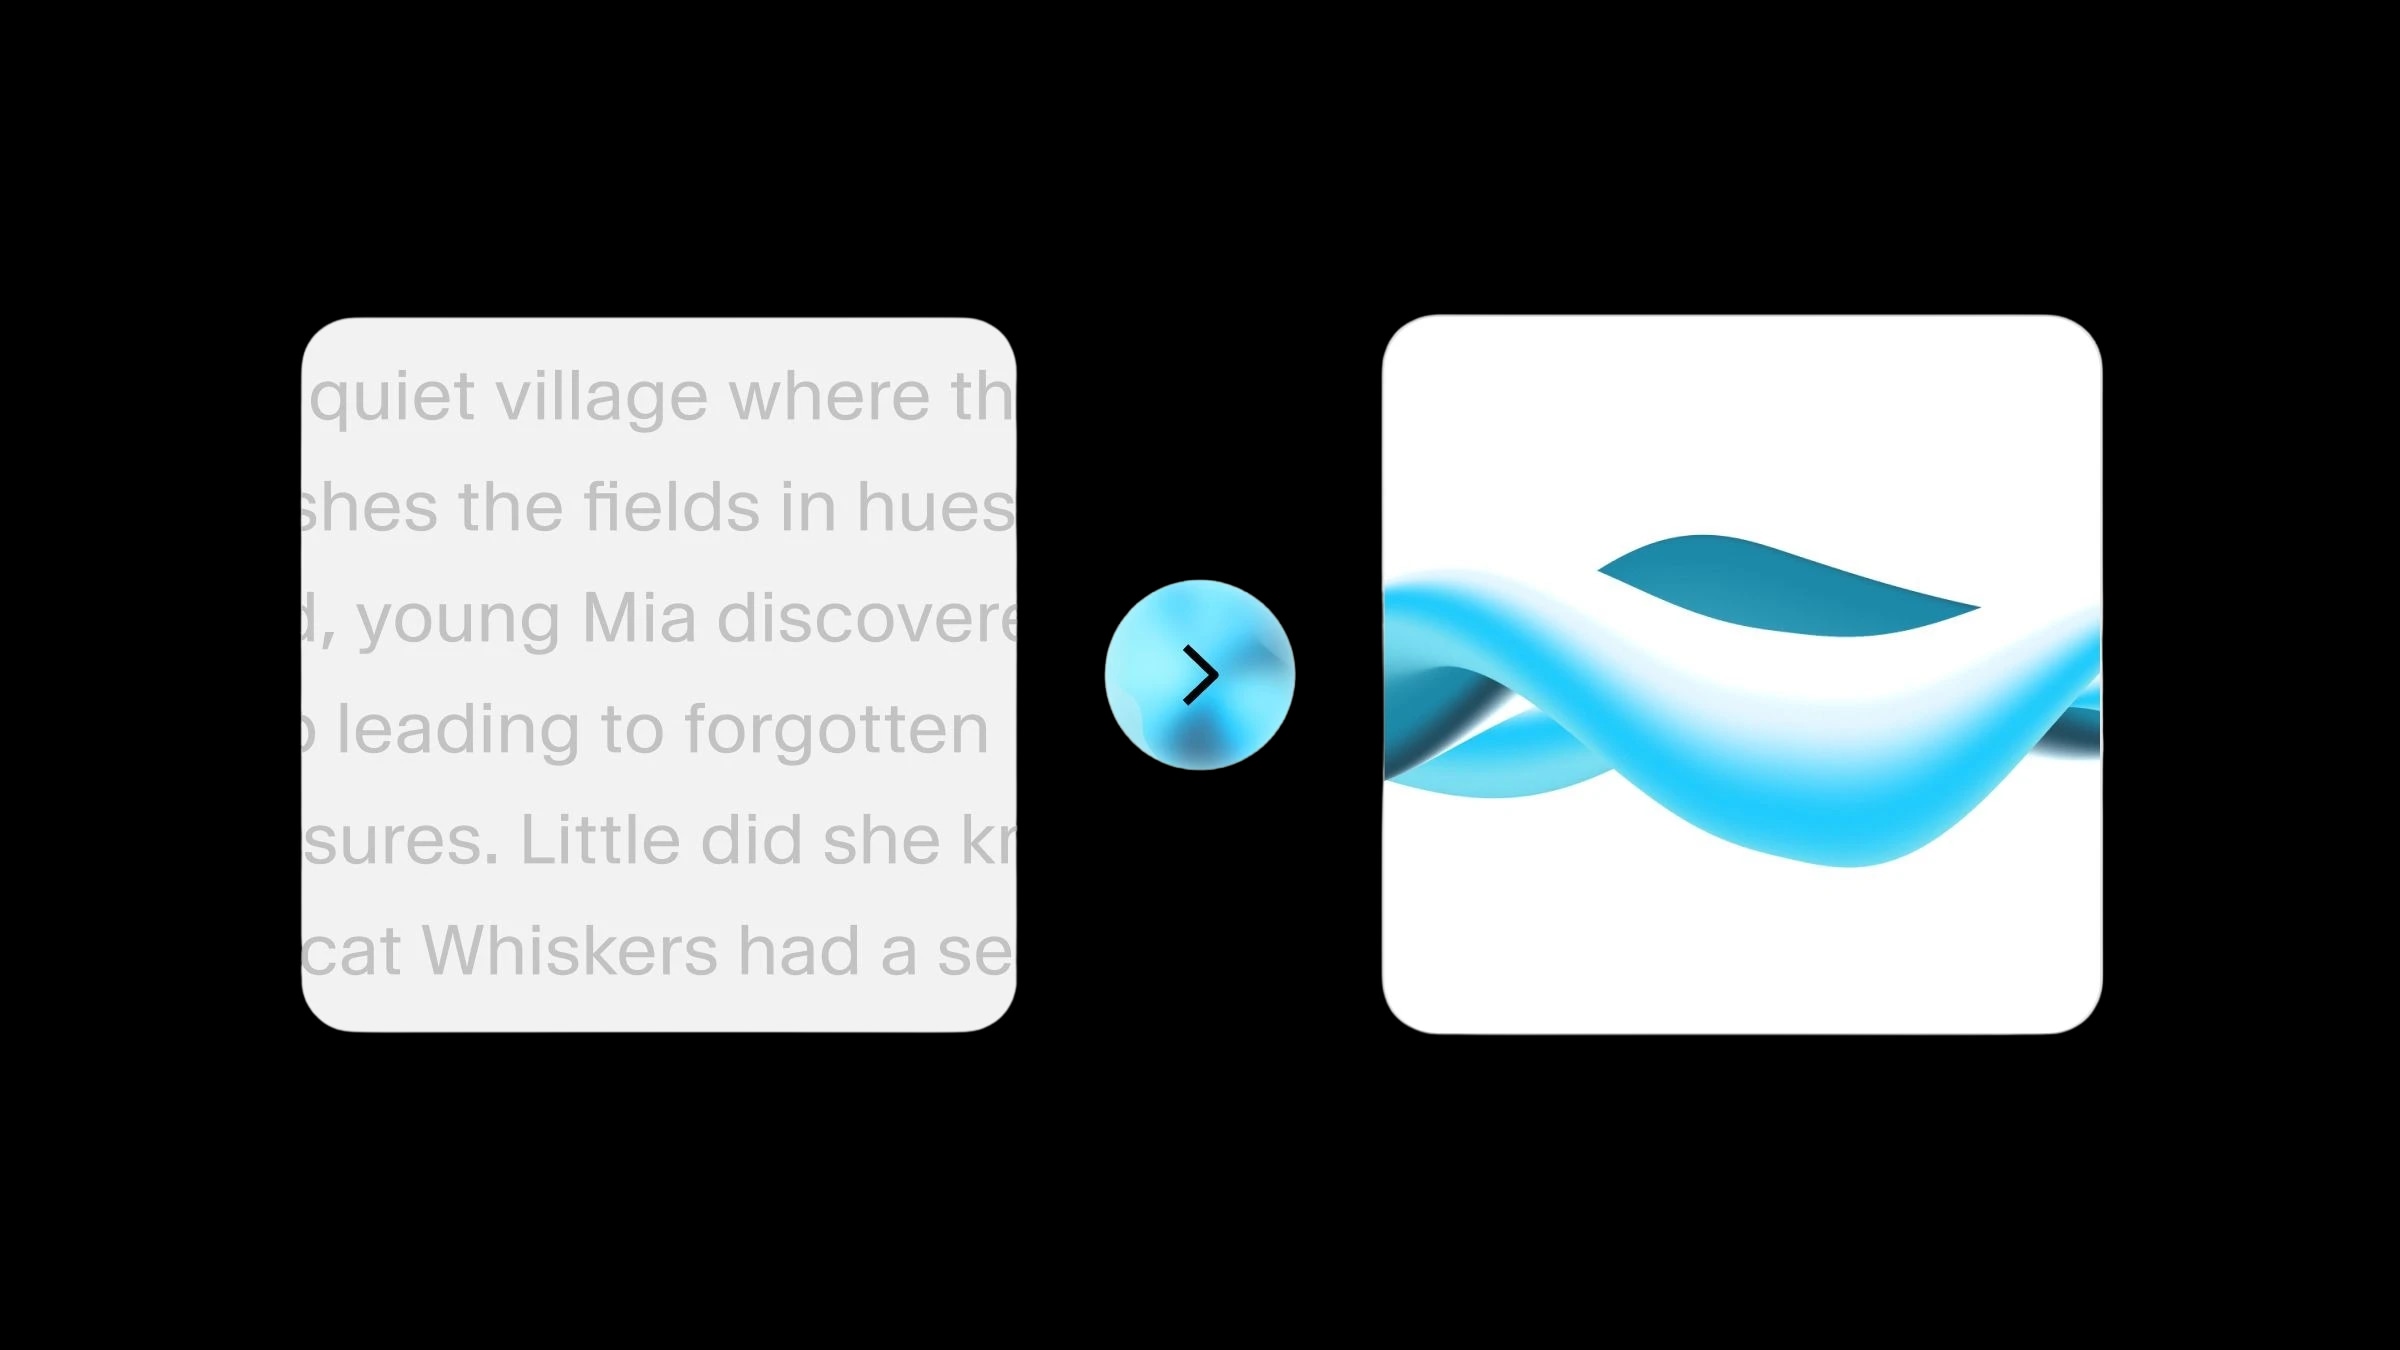
TTS (tekst-naar-spraak) zet geschreven tekst om in gesproken woorden, terwijl Speech to Text (STT) het tegenovergestelde doet en gesproken woorden naar tekst transcribeert. TTS wordt gebruikt om geschreven content hoorbaar te maken en fungeert als een spraakassistent voor mensen met een visuele beperking of leerproblemen. STT legt daarentegen gesproken taal vast en zet die om in een geschreven transcript, wat handig is voor dicteren en spraakopdrachten.
Toepassingscontext
TTS wordt vaak geïntegreerd in e-readers, omroepsystemen en virtuele assistenten om audio-uitvoer te bieden. STT wordt gebruikt in transcriptiediensten, spraakgestuurde applicaties en realtime ondertiteling voor mensen met een gehoorbeperking. TTS is vooral gericht op uitvoer, met de nadruk op het hoorbaar overbrengen van informatie. STT is daarentegen gericht op invoer, met de nadruk op het vastleggen en verwerken van gesproken taal.
Technologische aanpak
TTS-technologie omvat tekstanalyse, taalverwerking en spraaksynthese. De technologie moet de nuances van gesproken taal, waaronder intonatie en ritme, nauwkeurig overbrengen. STT vereist geavanceerde spraakherkenning om verschillende accenten, dialecten en spraakpatronen nauwkeurig te transcriberen, vaak in realtime.
Wat is TTS (tekst-naar-spraak)?
TTS (tekst-naar-spraak) is een technologie die geschreven tekst omzet in gesproken woorden. In de kern stelt TTS computers in staat om hardop voor te lezen en elke tekst om te zetten in een synthetische stem. Deze technologie wordt veel gebruikt, van virtuele assistenten tot toegankelijkheidstools voor mensen met leesproblemen.
Een opvallend voorbeeld van geavanceerde TTS-technologie zijn de TTS-mogelijkheden van ElevenLabs. De TTS van ElevenLabs onderscheidt zich door natuurlijk klinkende, mensachtige stemuitvoer te produceren. Dit wordt bereikt met geavanceerde AI-algoritmen die niet alleen het geluid van menselijke spraak nabootsen, maar ook de nuances en verbuigingen begrijpen en reproduceren die natuurlijke spraakpatronen kenmerken.
Dit realisme maakt de TTS van ElevenLabs ideaal voor het maken van boeiende audiocontent voor verschillende media, het verbeteren van gebruikersinterfaces met stemfeedback en het bieden van een toegankelijk leesalternatief voor gebruikers met een visuele beperking.
Wat is Text from Speech (Speech to Text, STT)?
Text from Speech, ook bekend als Speech to Text (STT), is het proces waarbij gesproken taal wordt omgezet in geschreven tekst. Deze spraakherkenningstechnologie is cruciaal voor het maken van transcripties van audio-opnamen, het mogelijk maken van spraakopdrachten en het faciliteren van realtime ondertiteling voor toegankelijkheid.
ElevenLabs heeft belangrijke vooruitgang geboekt in STT-technologie. Ons Scribe-model zet audio en video efficiënt om in tekst in 99 talen. Het biedt een gebruiksvriendelijke interface, waardoor het ideaal is om vergaderingen, colleges en interviews vanuit audio- en videobestanden schriftelijk vast te leggen.
Hoe werkt TTS?
TTS-technologie zet geschreven tekst om in hoorbare spraak, via een proces dat uit verschillende ingewikkelde stappen bestaat.
Eerst splitst het TTS-systeem de tekst op in fonemen: de kleinste klankeenheden in elke taal. Deze segmentatie is essentieel voor het vermogen van het systeem om verschillende woorden nauwkeurig uit te spreken.
Na deze fonemische segmentatie zet het systeem deze klanken om in digitale spraak. Hierbij speelt kunstmatige intelligentie (AI) een cruciale rol. Met AI-algoritmen die zijn getraind op uitgebreide datasets van gesproken taal kan het systeem spraak produceren met mensachtige tonen en ritmes. Deze gegenereerde spraak wordt vervolgens afgestemd op de geïdentificeerde fonemen, wat resulteert in natuurlijk klinkende uitvoer.
Dankzij vooruitgang in AI en machine learning zijn moderne TTS-technologieën sterk geëvolueerd. Ze kunnen nu contextuele nuances begrijpen, meerdere talen ondersteunen en emotionele verbuigingen tot op zekere hoogte nabootsen. Deze verbeteringen hebben de spraakuitvoer aanzienlijk menselijker gemaakt, wat leidt tot natuurlijkere en boeiendere interacties met digitale apparaten.
Wat zijn de beste TTS-providers?
The best TTS software solutions are ElevenLabs, Murf, and PlayHT. Here’s a brief rundown of their main features, pros, cons, and rating out of 5.
Hoe werkt Speech to Text?
Speech to Text-technologie (STT) zet gesproken taal om in geschreven tekst via een complex proces met meerdere stappen.
Eerst worden gesproken woorden vastgelegd, meestal via een microfoon. Deze audio-invoer wordt vervolgens omgezet in een digitaal formaat dat het systeem kan verwerken. De kern van STT ligt in het vermogen om deze digitale audio te analyseren. Het gebruikt geavanceerde algoritmen om de spraak op te delen in kleinere, herkenbare segmenten.
Deze segmenten zijn fonemen, de kleinste klankeenheden in spraak. Het STT-systeem vergelijkt deze fonemen met een vooraf gedefinieerd taalmodel om woorden en zinsdelen te identificeren. Deze stap is cruciaal om verschillende accenten, dialecten en variaties in spraak te begrijpen.
Vervolgens past het systeem technieken voor natuurlijke taalverwerking (NLP) toe. NLP helpt de context en syntaxis van gesproken taal te begrijpen, waardoor transcripties nauwkeuriger worden. Het stelt het systeem ook in staat om complexe zinsstructuren en sectorspecifiek jargon te verwerken.
Geavanceerde STT-systemen gebruiken algoritmen voor machine learning en deep learning, die verbeteren naarmate er meer data en gebruik is. Deze technologieën stellen het systeem in staat om in de loop van de tijd te leren van nieuwe spraakpatronen, accenten en zelfs talen, waardoor de nauwkeurigheid en efficiëntie verbeteren.
Kortom, STT-technologie omvat audio-opname, fonemische analyse, taalmodellering en NLP, allemaal ondersteund door machine learning, om spraak effectief om te zetten in tekst.
Wat zijn de beste Speech to Text-providers?
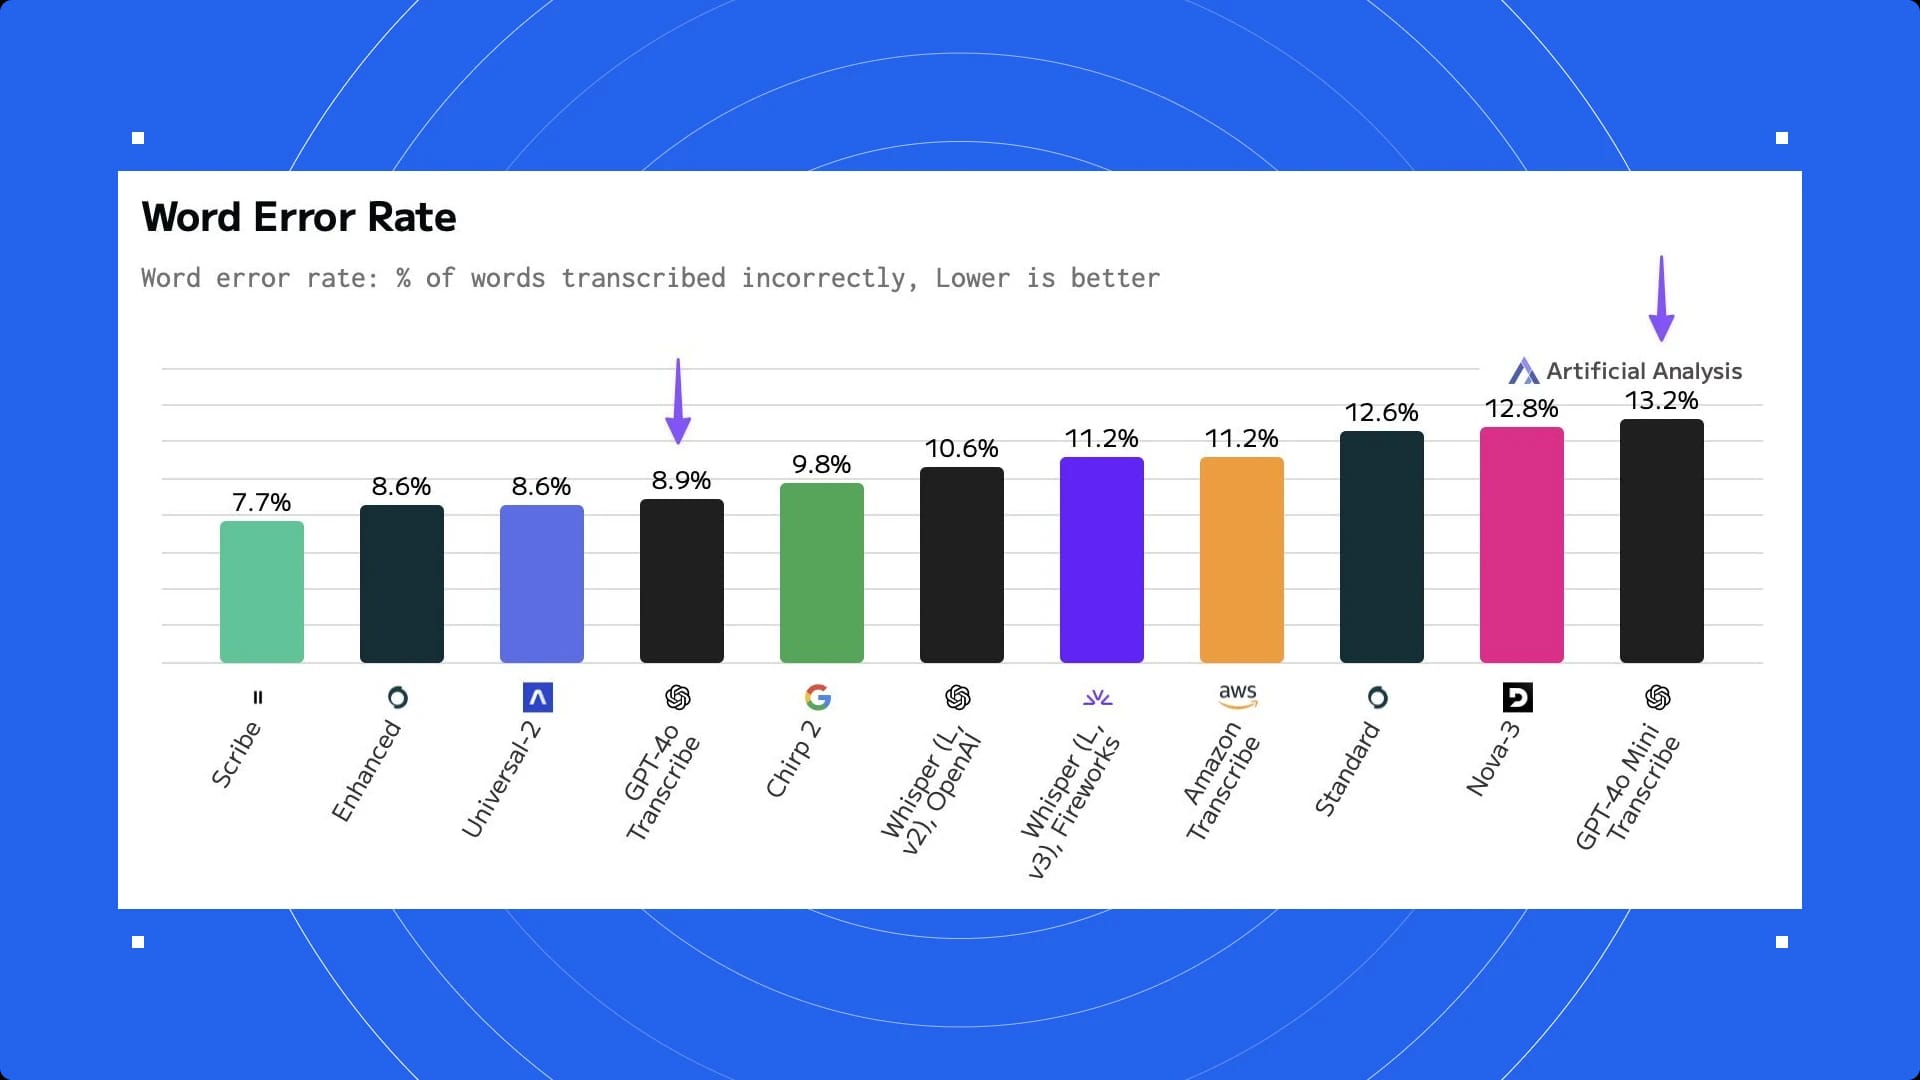
De beste Speech to Text-providers zijn Scribe van ElevenLabs, gevolgd door OpenAI en andere providers zoals Google.
TTS en STT: nauwkeurigheid en uitdagingen
TTS- en Speech to Text-technologieën streven naar mensachtige nauwkeurigheid. Hun nauwkeurigheid verbetert voortdurend, maar dat betekent niet dat ze perfect zijn. Dit kun je verwachten op het gebied van nauwkeurigheid en uitdagingen bij beide technologieën.
Nauwkeurigheid en uitdagingen van TTS
AI-stem-TTS-technologie heeft zich sterk ontwikkeld, maar kent nog uitdagingen. De voornaamste is het creëren van natuurlijk klinkende menselijke stemmen. Moderne TTS-systemen kunnen weliswaar heldere en begrijpelijke audio-uitvoer produceren, maar het toevoegen van mensachtige verbuigingen en emoties blijft lastig. Daarnaast heeft TTS moeite met contextinterpretatie, waardoor woorden soms verkeerd worden uitgesproken op basis van hun context. Een andere uitdaging is het aanpassen van stemmen aan uiteenlopende behoeften, zoals verschillende accenten en spraakpatronen, wat essentieel is voor wereldwijde toegankelijkheid.
Nauwkeurigheid en uitdagingen van Text from Speech/Speech to Text (STT)
STT-technologie heeft grote stappen gezet in nauwkeurigheid, vooral sinds de opkomst van deep learning. Toch ondervindt de technologie problemen in rumoerige omgevingen, waar achtergrondgeluiden de spraakherkenning kunnen verstoren. Ook het nauwkeurig vastleggen en transcriberen van uiteenlopende accenten en dialecten vormt een aanzienlijke uitdaging. Bovendien hebben STT-systemen vaak moeite met homofonen (woorden die hetzelfde klinken maar verschillende betekenissen hebben) en met het begrijpen van complexe syntaxis of straattaal, wat hun algehele effectiviteit in praktijksituaties beïnvloedt.
Toepassingen in verschillende sectoren
TTS- en Speech to Text-technologieën hebben innovatieve toepassingen gevonden in een groot aantal sectoren. Ze veranderen de manier waarop we met informatie omgaan en verbeteren de toegankelijkheid.
TTS-toepassingen in sectoren
TTS-technologie wordt in verschillende sectoren toegepast. In het onderwijs helpt het bij het maken van toegankelijke leermaterialen voor studenten met leesproblemen of een visuele beperking. Bijvoorbeeld door lesboeken om te zetten in luisterboeken.
In de auto-industrie levert TTS spraakreacties in navigatiesystemen. De klantenservicesector gebruikt TTS voor geautomatiseerde antwoorden in callcenters, wat de efficiëntie verhoogt. Daarnaast speelt TTS een belangrijke rol in de entertainmentindustrie, met name in games en virtuele assistenten, waar het interactieve gebruikerservaringen biedt.
STT-toepassingen in sectoren
STT-technologie heeft uiteenlopende toepassingen in meerdere sectoren. In de gezondheidszorg helpt het bij het transcriberen van gesprekken tussen arts en patiënt en het dicteren van klinische documentatie, waardoor de efficiëntie toeneemt. In de juridische sector wordt STT gebruikt om rechtszittingen en juridische documentatie te transcriberen. De technologie speelt ook een cruciale rol in de media, door te helpen bij realtime ondertiteling van uitzendingen voor mensen met een gehoorbeperking. In het bedrijfsleven faciliteert STT efficiënte transcripties van vergaderingen, waardoor verslaglegging en toegankelijkheid van informatie verbeteren.
Tot slot
TTS- (tekst-naar-spraak) en Speech to Text-technologieën (STT) lijken misschien op elkaar, maar hebben verschillende functies. TTS zet geschreven tekst om in gesproken woorden en brengt geschreven content tot leven met mensachtige stemmen. STT doet daarentegen het tegenovergestelde: het zet gesproken woorden om in geschreven tekst en legt de nuances van gesproken taal vast in tekstvorm.
Beide technologieën maken gebruik van geavanceerde AI, maar voorzien in verschillende behoeften: TTS voor het beluisteren van geschreven materiaal, en STT voor het maken van geschreven verslagen van gesproken content.
Klaar om aan de slag te gaan? Probeer Eleven v4, ons meest expressieve Text to Speech-model.
Wil je geavanceerde TTS-technologie ervaren? Registreer je voor ElevenLabs vandaag nog. Je zult niet teleurgesteld zijn.