
Speech to Text API
Transcribeer spraak met ElevenLabs Scribe v3
Ons nauwkeurigste Speech to Text-model. Transcribeer vergaderingen, gesprekken en interviews, met sprekerlabels en instellingen voor de woorden die ertoe doen.
- Lovable
- Veed model
- Synthesia
- Stripe
- Perplexity
- Twilio
De nauwkeurigste Speech to Text-API voor batchworkloads
Maak captions, ondertitels en bewerkbare transcripten voor podcasts, video's, interviews en andere opgenomen content – allemaal met toonaangevende nauwkeurigheid via de API.
Ongekende transcriptienauwkeurigheid
Scribe v3 maakt in 102 talen 27% minder woordfouten dan Scribe v2, en minder dan elk ander batchmodel dat we hebben getest.
Ontworpen voor elk scenario
Transcriptie die werkt in rumoerige omgevingen, met achtergrondmuziek, sterke accenten en audio van lage kwaliteit.
Gedetailleerde controle over timing, sprekers en niet-spraakgebeurtenissen.
De ElevenLabs Transcription API kan gelach, emotie en geluidseffecten detecteren. Gebruik keyterm prompting om transcriptie te sturen met domeinspecifieke termen.
Transcribeer audio en video
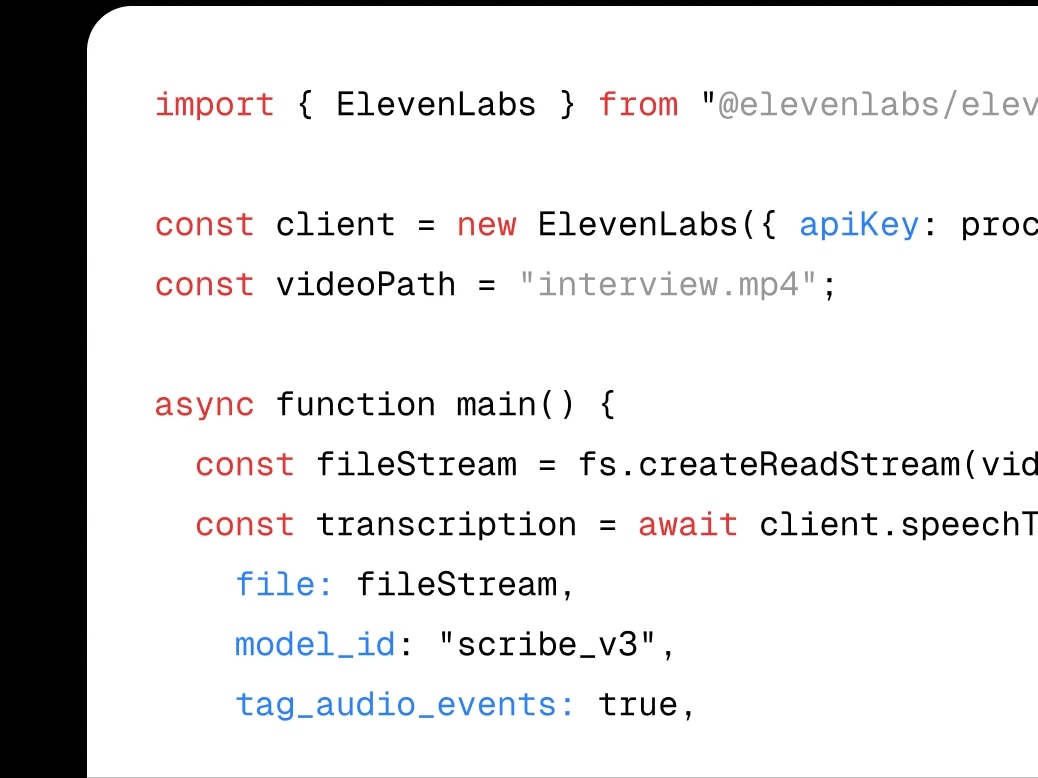
Schone, bewerkbare transcripten

Keytermprompting

Dynamische audiotagging
Leg niet-spraakgebeurtenissen vast, zoals gelach, applaus, muziek en achtergrondgeluid. Transcripten bevatten de volledige context van je audio, niet alleen de woorden.
Slimme sprekersdiarisatie
Identificeer en label automatisch maximaal 32 sprekers. Duidelijk inzicht in wie wat zei, overzichtelijk geordend in leesbare transcripties.
Entiteitsdetectie
Identificeer en tag automatisch 56 soorten entiteiten, waaronder namen, datums, locaties en organisaties, in je transcripten.
Transcribeer klinische audio met Scribe v2 Medical
Een Speech to Text-model dat is geoptimaliseerd voor medische transcriptie en klinische workflows, met verbeterde herkenning van medicijnnamen, anatomie en pathologietermen.
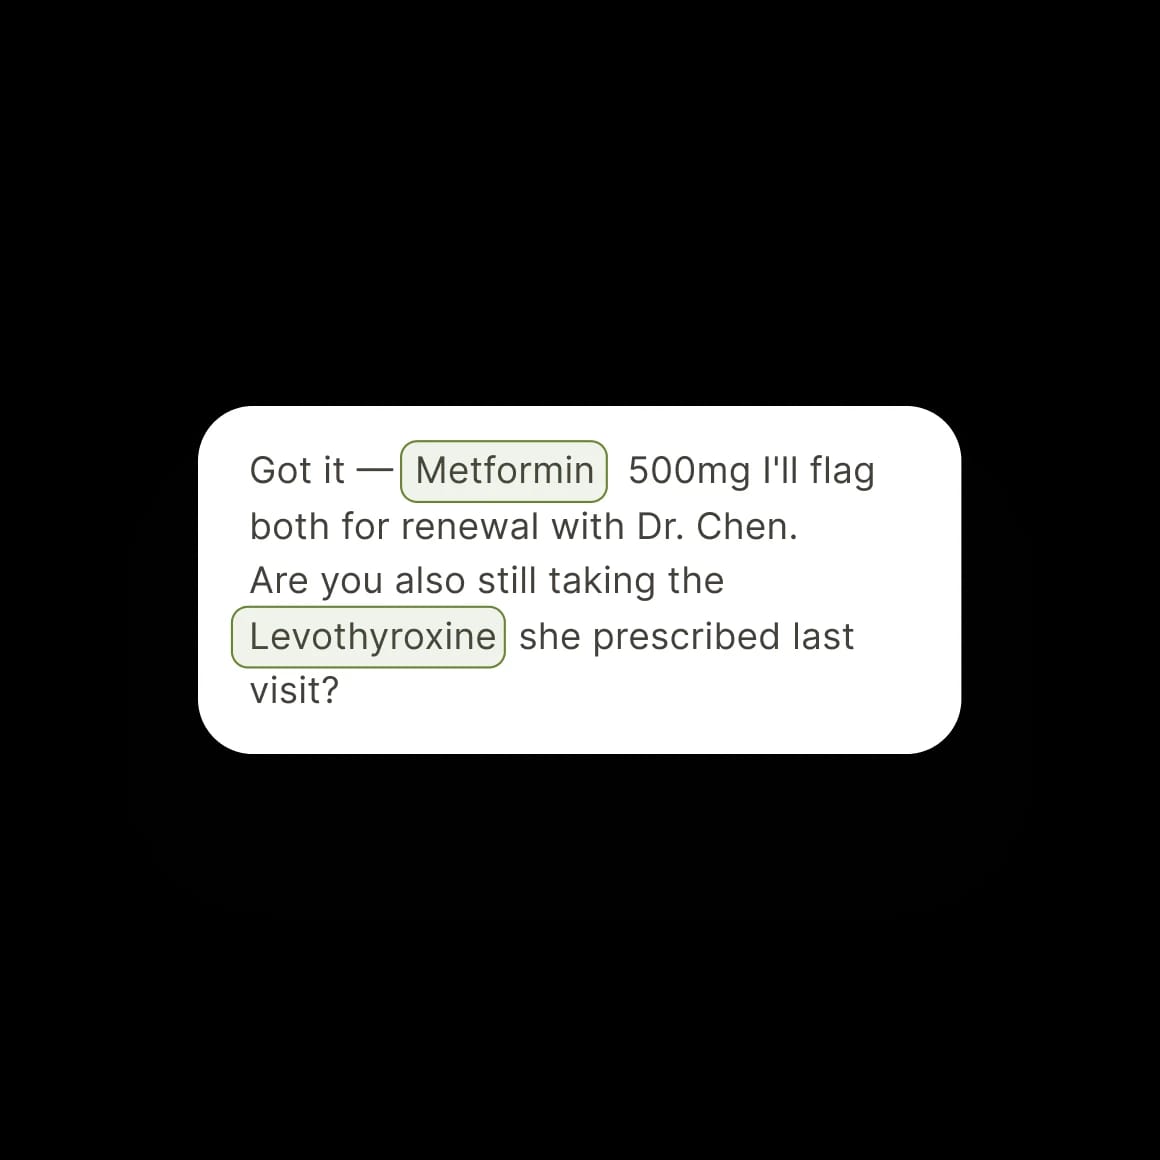
Transcribeer klinische spraak
Zet gesprekken tussen zorgverleners en patiënten, artsendictaten en patiëntintakes om in nauwkeurige tekst, klaar voor beoordeling door een zorgverlener en gebruik in notities, codering en verdere documentatieworkflows.
Minder fouten bij medische termen
Op term-WER maakt Scribe v2 Medical 15% minder fouten dan Scribe v2 op de Eka Medical ASR-testset, met verbeterde herkenning van medische spraak binnen klinische woordenschat.
Scribe v3
De hoogste nauwkeurigheid, ontworpen voor batchworkloads.
- 27% minder fouten dan Scribe v2
- Laagste diarization-foutpercentage dat we hebben getest
- Getalopmaak en taalhints
- Entiteitsdetectie en keyterm prompting
- Ondersteunt meer dan 90 talen
Scribe v3 Live
De laagste latentie, voor realtime workloads.
- Latentie onder 150 ms
- 43% minder fouten dan v2 Realtime
- Keytermbibliotheek en meertalige modus
- Verbeterde beurtwisselingdetectie
- Ondersteunt meer dan 90 talen
Scribe v2 Medical
Medische fine-tune, voor klinische transcriptie.
- Afstemming op medische woordenschat
- Transcriptie in 90+ talen
- Even nauwkeurig als Scribe v2 voor alledaagse spraak
- Verbeterde herkenning van medicijnnamen
- Geschikt voor HIPAA voor Enterprise-klanten
Transcribeer spraak in meer dan 90 talen en uiteenlopende accenten
Biedt uitzonderlijke nauwkeurigheid voor accenten, dialecten en opnameomstandigheden.
Wijzig de languageCode om talen te bekijken
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";
const elevenlabs = new ElevenLabsClient({
apiKey: "<your_api_key>"
});
const response = await fetch(
"https://storage.googleapis.com/eleven-public-cdn/audio/marketing/nicole.mp3"
);
const audioBlob = new Blob([await response.arrayBuffer()], { type: "audio/mp3" });
const transcription = await elevenlabs
.speechToText.convert({
file: audioBlob,
modelId: "scribe_v3",
tagAudioEvents: true,
languageCode: , // Taal instellen
diarize: true
});
console.log(transcription);


Ondersteunt 's werelds toonaangevende bedrijven en merken
“Van het nasynchroniseren van Reels in lokale talen tot het genereren van muziek en karakterstemmen in Horizon: het platform van ElevenLabs stelt creators, bedrijven en ondernemingen wereldwijd in staat om op schaal te werken met stem, muziek en geluid.”

“Dankzij de ongeëvenaarde nauwkeurigheid van Scribe in zoveel talen begrijpt Fieldy elk dagelijks gesprek en kan het eenvoudig opschalen over continenten heen. Sinds de overstap naar ElevenLabs Scribe heeft Fieldy de gebruikersretentie met 50% verhoogd.”

“ElevenLabs maakte het voor ons eenvoudig om krachtige text-to-speechmogelijkheden snel aan onze SDK toe te voegen, zodat Agents in realtime met expressieve stemmen kunnen reageren op vragen van gebruikers of feedback kunnen geven op wat ze zien.”
“Twilio heeft de generatieve AI-stemtechnologie van ElevenLabs geïntegreerd in zijn CPaaS, waarmee ConversationRelay wordt verbeterd. Dankzij deze integratie kunnen bedrijven en ontwikkelaars conversationele AI-steminteracties creëren die menselijk klinken, expressief aanvoelen en rechtstreeks vanaf het Twilio CPaaS-platform in realtime reageren. We zijn bij ElevenLabs enthousiast dat Twilio voor ElevenLabs heeft gekozen om ConversationRelay te verbeteren met de meest expressieve, menselijk klinkende stemmen die beschikbaar zijn. ”

API's gebouwd voor productie

Data wordt versleuteld tijdens verzending en opslag, met ondersteuning voor naleving van SOC 2, HIPAA en de AVG. Modi voor EU Data Residency en Zero Retention zijn beschikbaar voor strengere datacontrole.
Data wordt versleuteld tijdens verzending en opslag, met ondersteuning voor naleving van SOC 2, HIPAA en de AVG. Modi voor EU Data Residency en Zero Retention zijn beschikbaar voor strengere datacontrole.
Officiële Python- en TypeScript-SDK's met typeveiligheid, ondersteuning voor streaming en duidelijke voorbeelden.
Ons team zorgt voor een soepele lancering en houdt je processen betrouwbaar draaiende, met consistente prestaties en gemoedsrust.
