Hoe text to speech-technologie werkt: van tekst naar natuurlijke stem
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Text to speech-technologie (TTS) zet geschreven woorden om in gesproken audio. Het systeem bepaalt eerst wat de tekst zegt en hoe die moet klinken, waarna een AI-model de audio genereert.
Eerst normaliseert een TTS-engine de ingevoerde tekst en zet deze om in wiskundige tokens en vectorrepresentaties die een computersysteem kan verwerken. Vervolgens zet het model deze wiskundige constructies om in digitale geluidsrepresentaties en uiteindelijk in audio-output.
In dit artikel onderzoeken we hoe verschillende text to speech-tools werken en hoe de nieuwste generatie generatieve AI-neurale spraaksynthese de meest natuurlijke spraak tot nu toe biedt.
Samenvatting
- Text to speech-systemen zetten geschreven woorden in twee stappen om in audio. Ze zetten tekst om in tokens, oftewel wiskundige representaties van taal. Vervolgens zetten ze de tokens om in een akoestische representatie die als geluid wordt uitgevoerd.
- Nieuwere neurale TTS-engines gebruiken AI-modellen om natuurlijk klinkende spraak te produceren. Bedrijfsteams gebruiken ze voor contentcreatie, ondertiteling en klantenservice-agents.
- Uitspraakwoordenboeken en fonetische tags zijn twee manieren om TTS-output nauwkeurig af te stemmen, zodat die zo natuurlijk mogelijk klinkt en technisch jargon en namen correct worden uitgesproken.
- Met een Text to Speech API kun je bedrijfsapplicaties verbinden met hoogwaardige stemgeneratie.
Wat is TTS? Hoe text to speech-technologie werkt
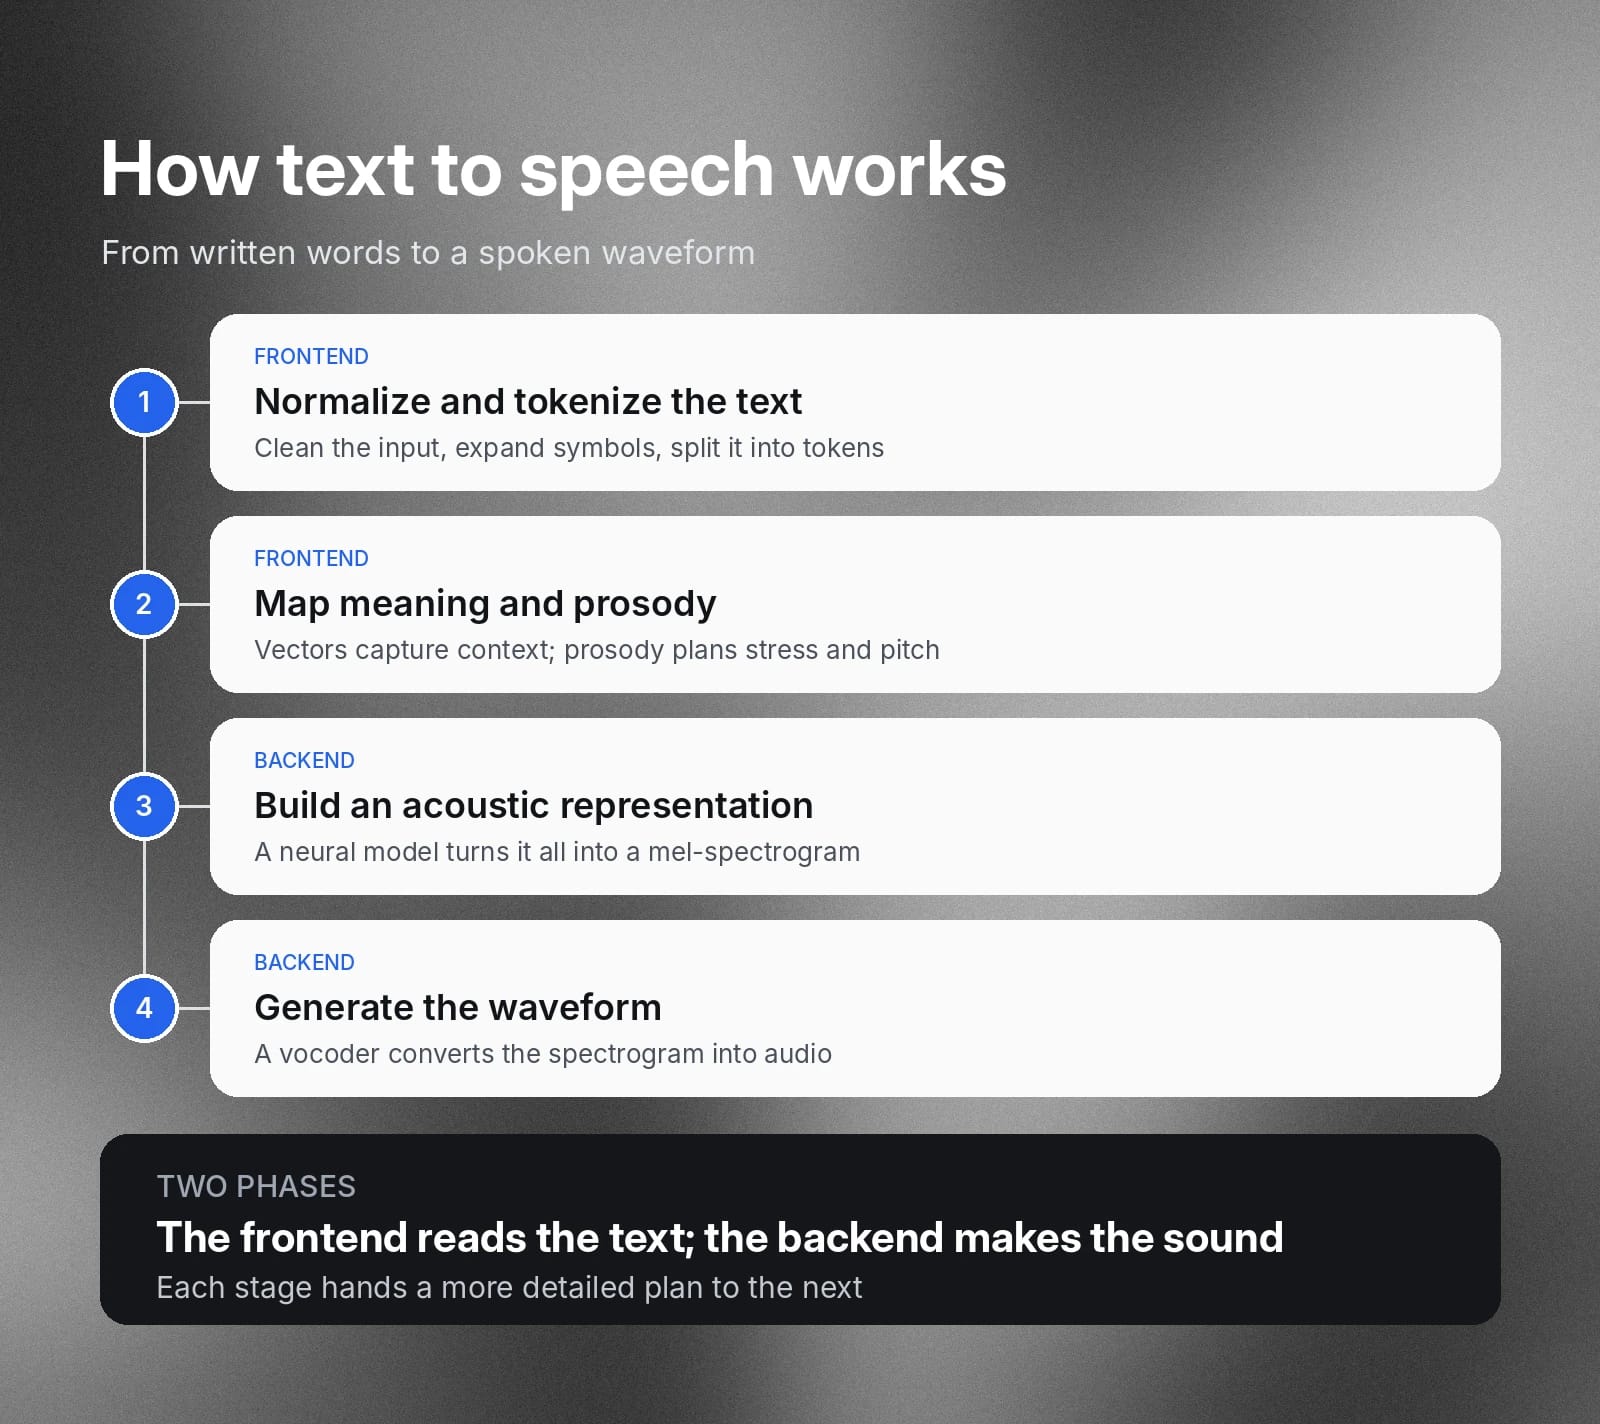
Text to speech werkt door geschreven tekst te analyseren, te bepalen hoe elk woord moet klinken en vervolgens zowel een neuraal model als een vocoder te gebruiken om de gesproken audio te genereren.
TTS bestaat grofweg uit twee fasen:
- Frontend: Het systeem zet tekst om in een wiskundige vorm waarmee de TTS-engine kan werken.
- Backend: Het systeem neemt de output van de eerste fase en zet die om in golfvormen die spraak modelleren.
Laten we de onderdelen van de TTS-werking nader bekijken.
Tekstnormalisatie en taalkundige analyse
De eerste stap in een TTS-proces is natural language processing (NLP): ruwe tekstinvoer opschonen, tokeniseren en ondubbelzinnig maken. Hierbij wordt tekst opgedeeld in tokens, afzonderlijke eenheden geschreven taal die een TTS-engine kan verwerken. Een token kan een volledig woord, een subwoordeeneheid of leesteken zijn.
Tekst bevat vaak andere symbolen dan volledige woorden, zoals afkortingen en cijfers. Een TTS-engine moet ook bepalen hoe deze worden uitgesproken. De TTS-engine leest bijvoorbeeld “$11” en zet die tekst om in de klanken voor “elf dollar”.
Semantische betekenis en prosodie
Prosodie is de toonhoogte en het ritme van spraak, waardoor TTS natuurlijk klinkt. Tijdens het verwerken van tekst genereert de engine ook een laag prosodische informatie die veranderingen in klemtoon en intonatie aan tekst koppelt, zodat deze natuurlijker klinkt.
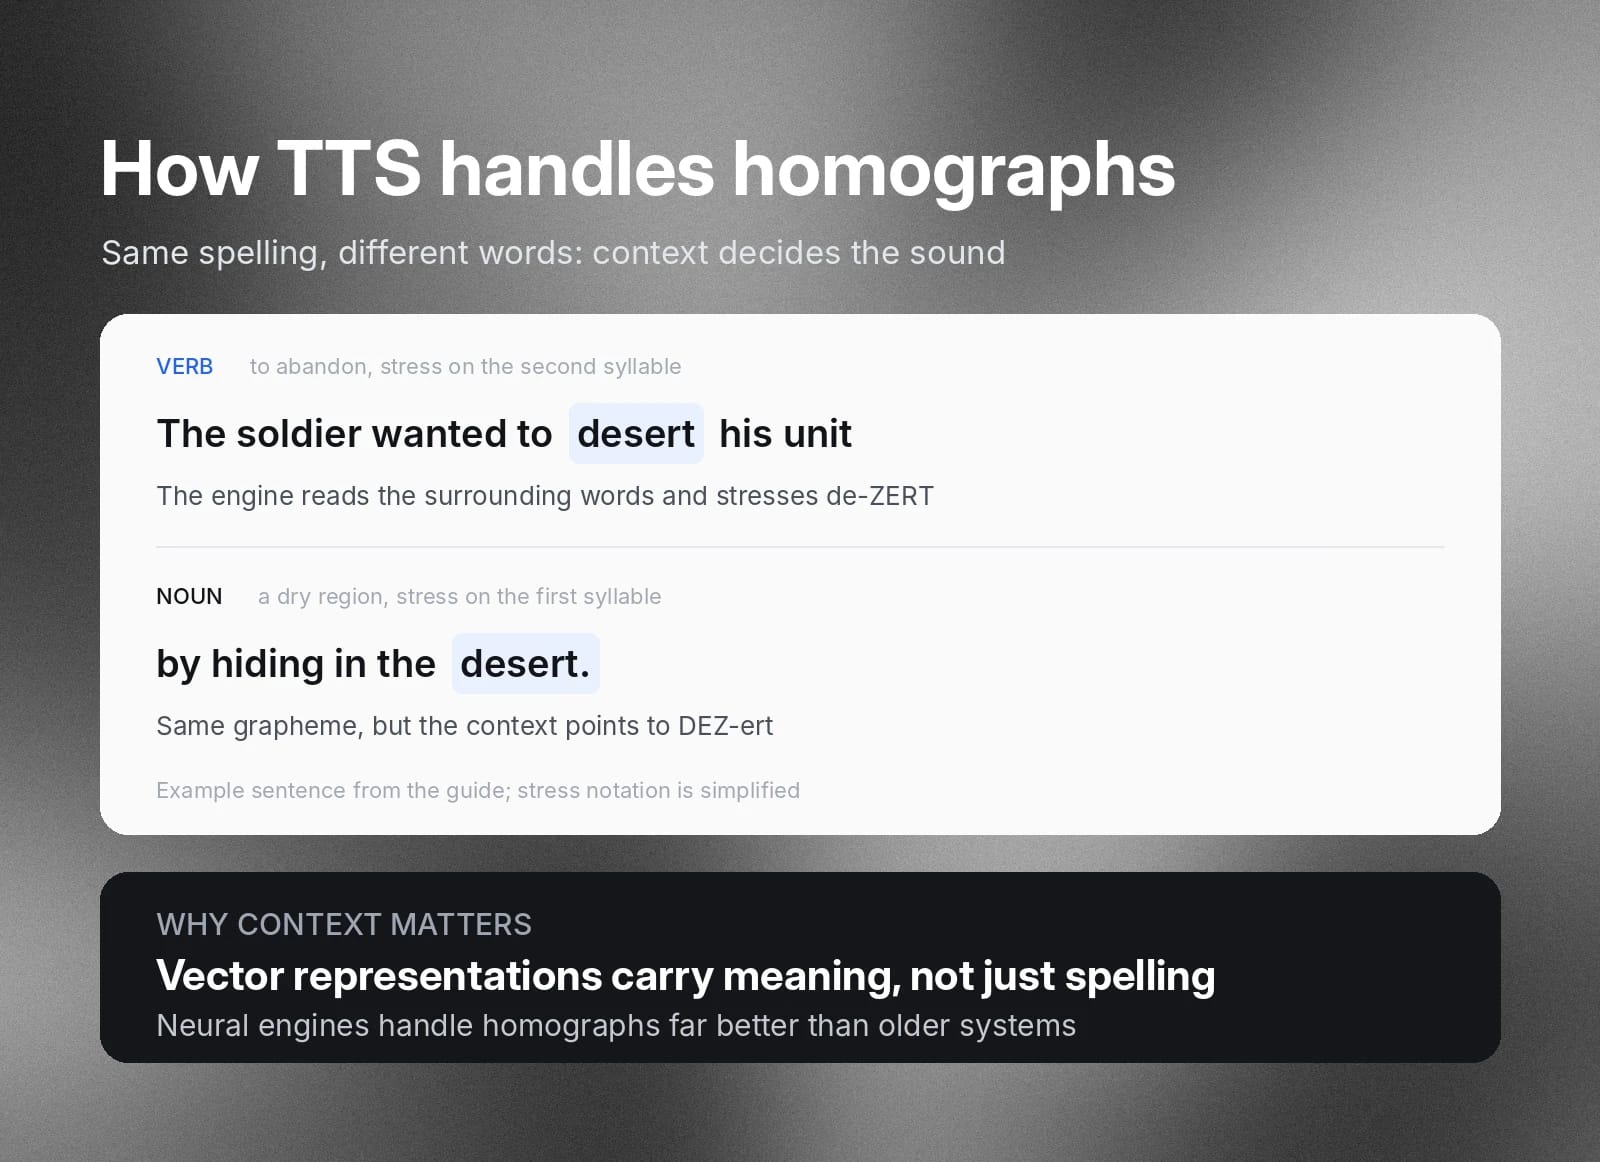
Een TTS-engine moet de uitspraak van text to speech ook aanpassen aan de context. Deze informatie wordt verzameld in de vorm van vectorrepresentaties: numerieke gegevens die de semantische overeenkomst tussen woorden en zinnen in kaart brengen. Zie het als een X-Y-grafiek waarin een lijn langs verschillende punten wordt uitgezet, maar dan in veel meer dan twee dimensies.
Een specifiek voorbeeld zijn homografen. Homografen, oftewel verschillende woorden met dezelfde spelling, moeten soms anders worden uitgesproken. De TTS-engine moet bepalen welke intonatie en klemtoon bij elk woord horen. Bijvoorbeeld hoe het grafeem “desert” wordt uitgesproken in de zin "The soldier wanted to desert his unit by hiding in the desert.”
Bekijk hoe Eleven v4 dit voorbeeld tot leven brengt.
Akoestische modellering en synthese van golfvormen (spraak)
De TTS-engine neemt de getokeniseerde informatie en contextuele vectoren, die nu allemaal numerieke gegevens zijn, en zet ze om in een akoestische representatie, zoals een mel-spectrogram. Dit omvat verschillende frequenties, energieniveaus en geluiden die de hersenen als emotie interpreteren. In het verleden zijn veel verschillende systemen gebruikt voor deze functie, maar neurale modellen behoren tegenwoordig tot de effectiefste.
In de laatste stap zet een vocoder deze spectrogrammen om in audio die menselijke luisteraars als spraak herkennen. Dit proces heet golfvormgeneratie.
TTS in de praktijk: een uitgewerkt voorbeeld
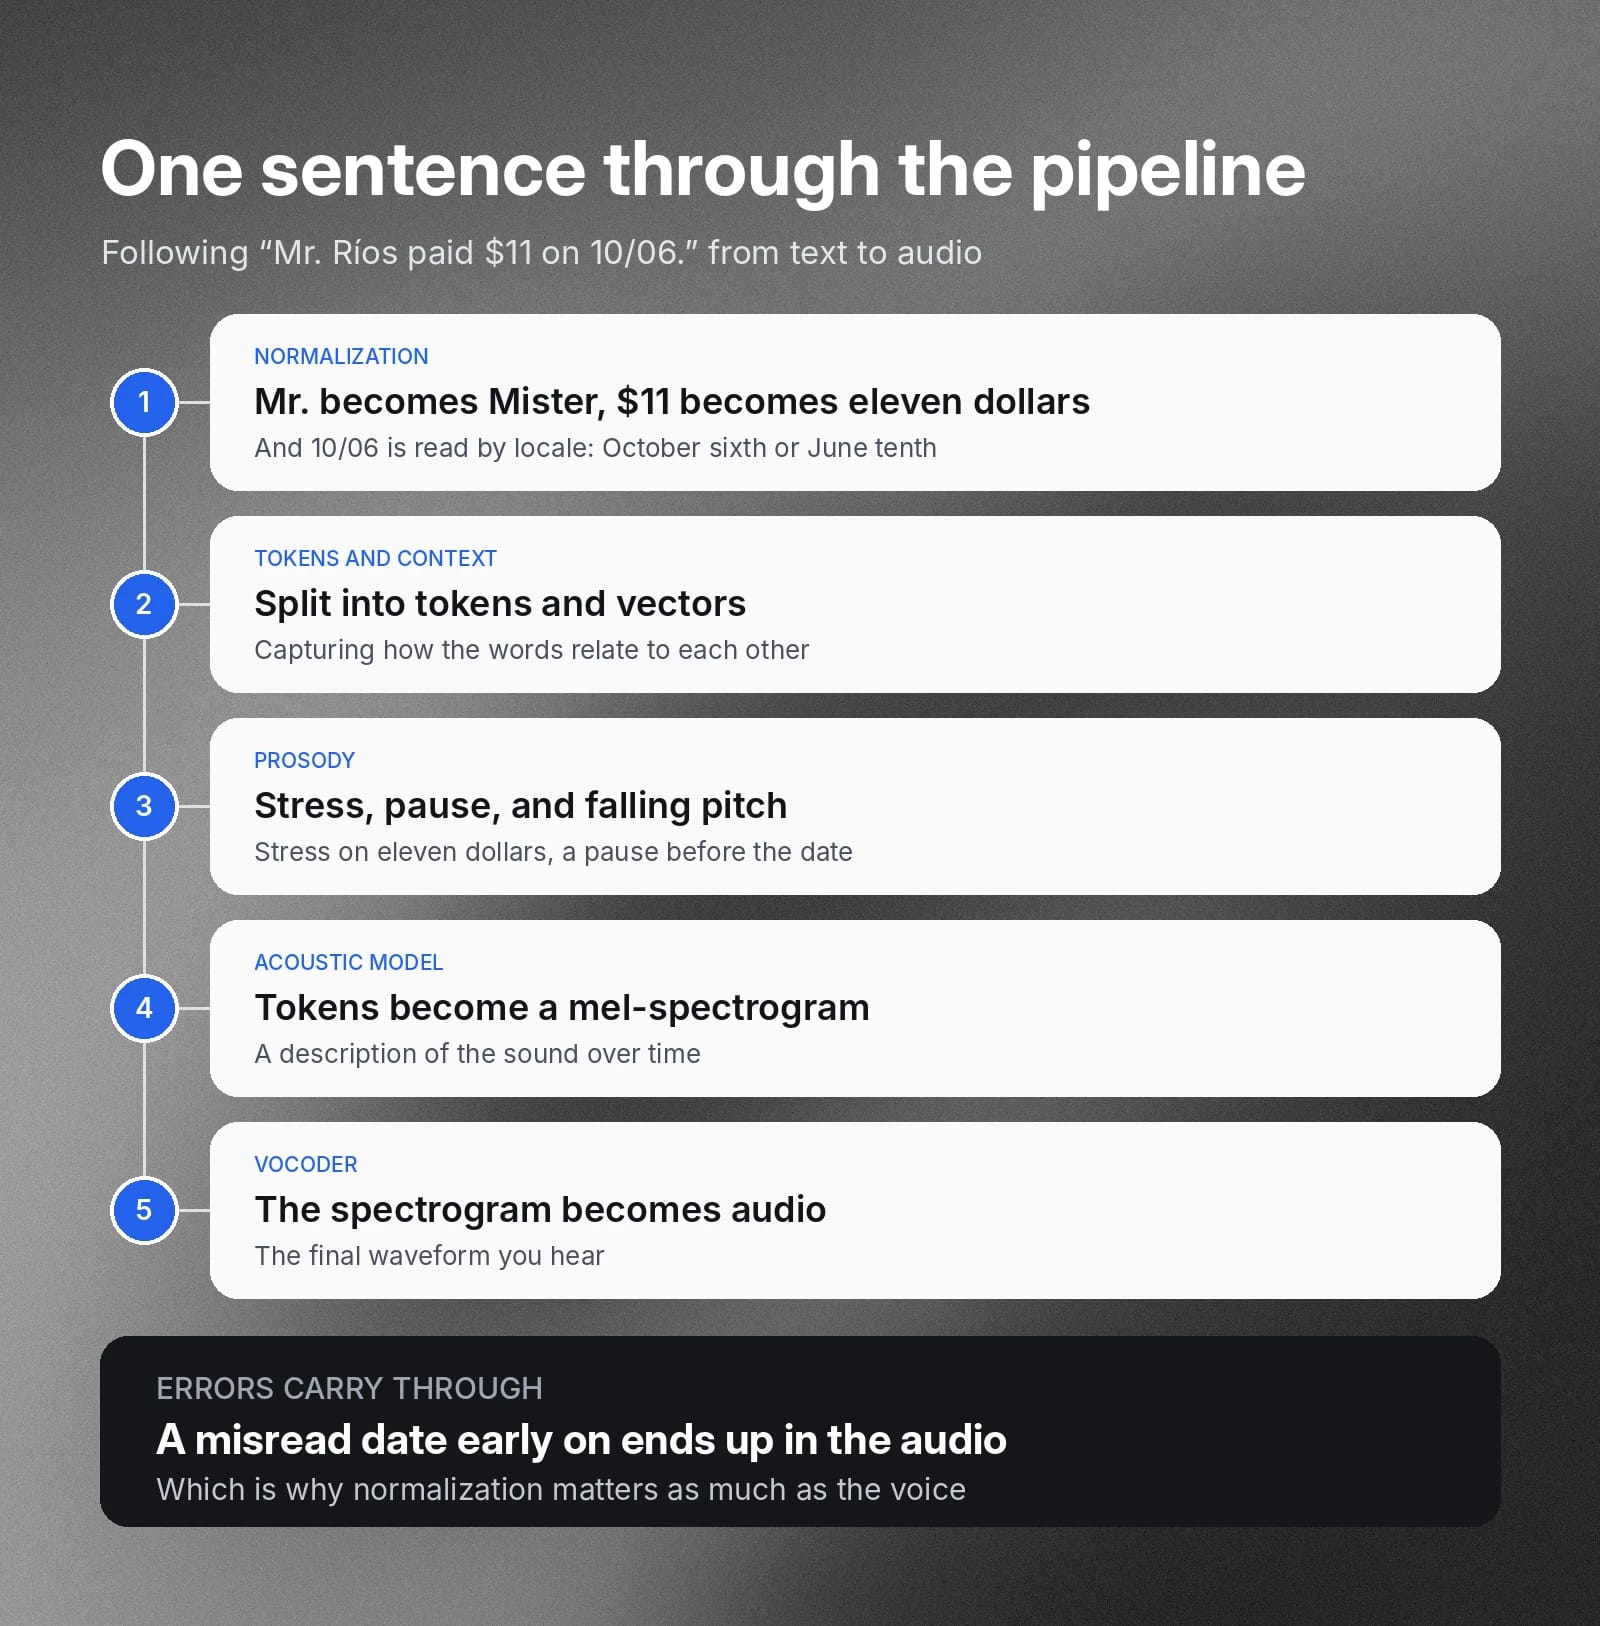
De eenvoudigste manier om te zien hoe de TTS-fasen samenwerken, is door één zin door de pipeline te volgen.
Neem de tekst “Mr. Ríos paid $11 on 10/06.”
- Normalisatie: De engine breidt “Mr.” uit tot “Mister”, leest “$11” als “elf dollar” en bepaalt of “10/06” “zes oktober” of “tien juni” is, afhankelijk van de landinstelling en context.
- Tokenisatie en context: De opgeschoonde tekst wordt opgesplitst in tokens en omgezet in vectoren die vastleggen hoe de woorden met elkaar samenhangen.
- Prosodie: De engine legt de klemtoon op “elf dollar”, voegt een korte pauze toe voor de datum en laat de toonhoogte dalen aan het einde van de zin.
- Akoestisch model: Het neurale model zet de tokens en het prosodieplan om in een mel-spectrogram dat het geluid in de tijd beschrijft.
- Vocoder: De vocoder zet het spectrogram om in de uiteindelijke audiogolfvorm die je hoort.
Elke fase geeft een gedetailleerder plan door aan de volgende. Daarom werken fouten vroeg in de pipeline, zoals een verkeerd gelezen datum, door in de uiteindelijke audio.
Waarom klinkt neurale text to speech menselijker?
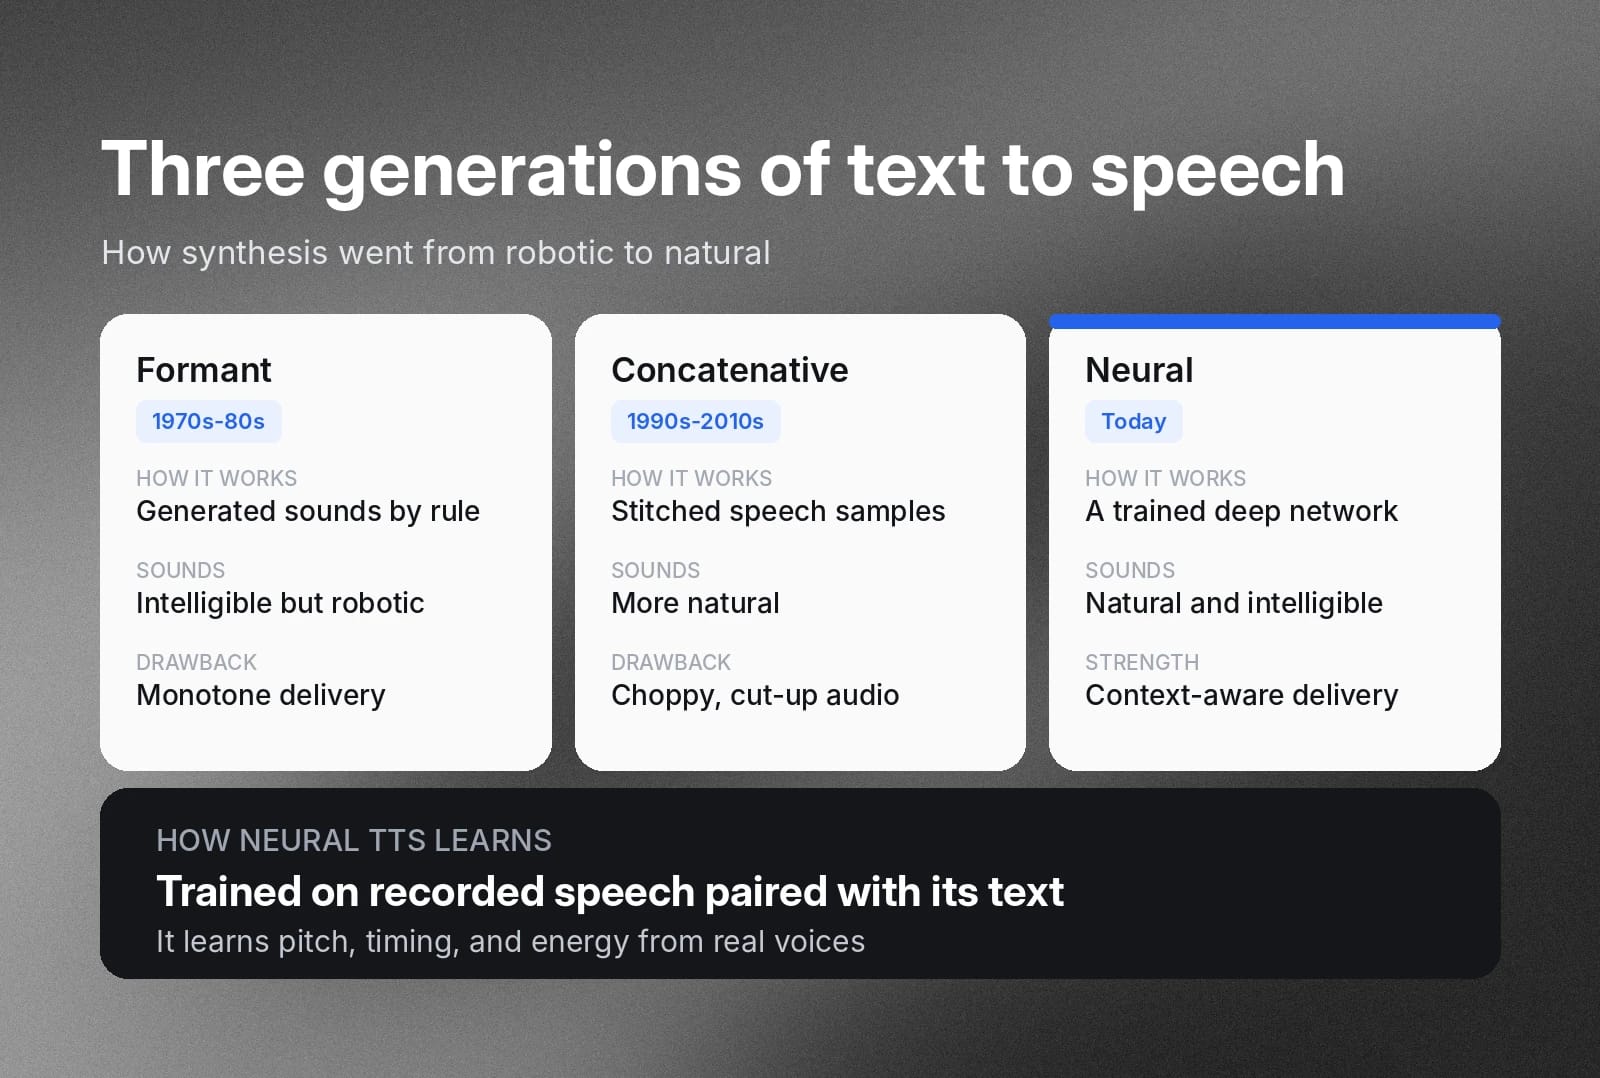
Neurale spraaksynthese blinkt uit in het produceren van natuurlijke, verstaanbare spraak, de twee kwaliteiten waarmee engineers TTS-engines beoordelen. Neurale TTS werkt door een deep neural network (DNN) te trainen om spraak te produceren op basis van tekstinvoer. Je traint het DNN met grote hoeveelheden opgenomen spraak en de bijbehorende tekst.
Neurale spraaksynthese-engines zijn slechts de nieuwste generatie TTS van enterprise-niveau. Daaraan gingen twee eerdere generaties commerciële synthesetechnologie vooraf.
Formantsynthese was de dominante methode in de jaren 70 en 80. In plaats van menselijke spraak te samplen voor runtime-output, genereerde deze synthetische geluiden die spraak modelleerden. De spraak was verstaanbaar, maar monotoon en klonk robotachtig.
Concatenatieve synthese domineerde van de jaren 90 tot de jaren 10 en klonk natuurlijker dan eerdere formantsystemen. In plaats van tonen te genereren op basis van wiskundige regels, voegden deze systemen kleine samples van menselijke spraak aan elkaar. Ze gebruikten taalkundige opzoektabellen om genormaliseerde tekst aan geluiden te koppelen en voerden vervolgens kleine eenheden aaneengeschakelde spraakaudio uit, afkomstig uit een enorme bibliotheek of corpus. Hoewel natuurlijker dan spraak van een formantengine, kan concatenatie spraak nog steeds hakkelig of opgeknipt laten klinken.
Wat is het verschil tussen een AI-stemgenerator en text to speech?
“AI-stemgenerator” is een term die in marketing vaak wordt gebruikt voor een breed scala aan stemtechnologieën, waaronder text to speech. Text to speech verwijst specifiek naar systemen die geschreven tekst als invoer nemen, de semantiek en prosodie modelleren en audiogolfvormen produceren.
AI-stemgeneratoren vormen een volledig ecosysteem van onderling verbonden stemtechnologieën, waaronder TTS en andere generatieve systemen voor Voice Design, Voice Cloning, en overdracht van stemstijl. Hoewel de term in marketing vaak uitwisselbaar met text to speech wordt gebruikt, kun je AI-stemgeneratoren beter zien als de bredere categorie generatieve stemtools waar TTS deel van uitmaakt.
Text to speech gebruiken voor content, toegankelijkheid en support
Text to Speech-modellen zijn wereldwijd een centraal onderdeel geworden van workflows, zowel persoonlijk als commercieel.
Dit zijn enkele belangrijke toepassingen van text to speech.
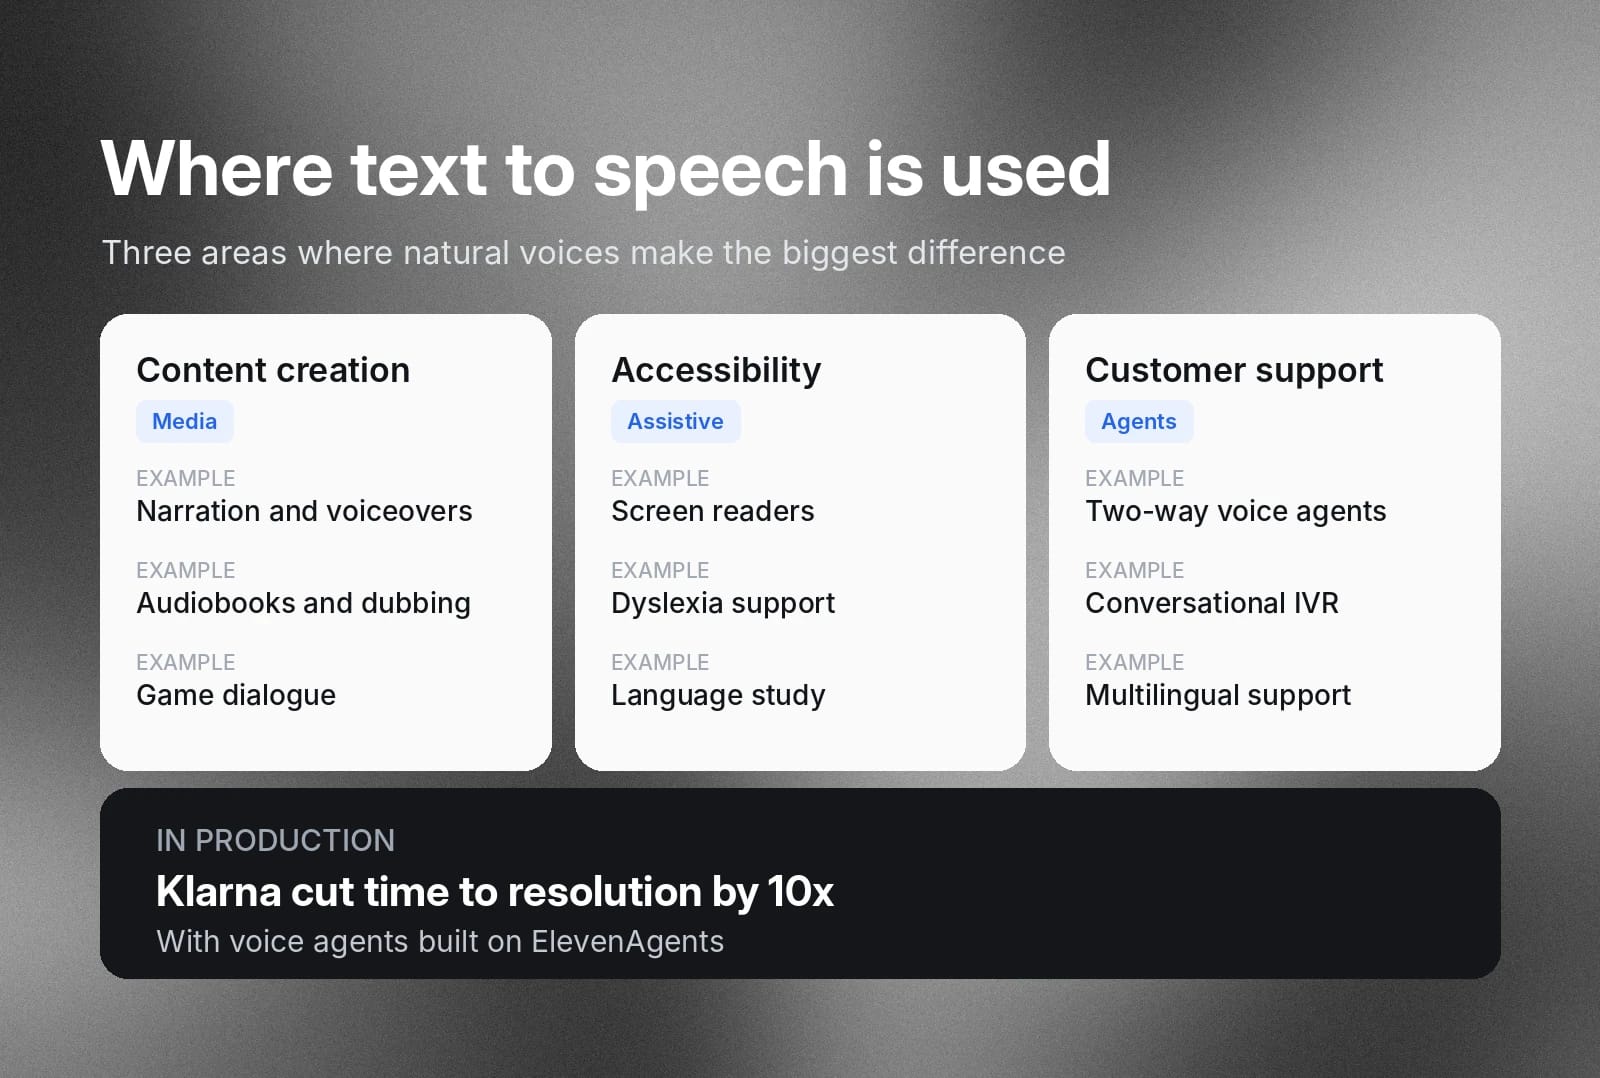
Contentcreatie
Text to speech-tools kunnen de kosten van grootschalige mediaproductie verlagen en minder studiotijd nodig maken voor narratie en aanvullende opnames in de postproductie.
Voorbeelden van toepassingen:
- Narratie
- Voice-overs
- Dubbing Studio
- Luisterboekproductie
- Gamedialogen
Zo heeft TAP ElevenLabs TTS gebruikt om educatieve content op te schalen voor scholen in heel India.
Toegankelijkheid
Text to speech is een van de meest gebruikte ondersteunende technologieën, omdat mensen geschreven content via luisteren kunnen opnemen. Natuurlijke spraak vergroot de betrokkenheid van luisteraars en vermindert mentale vermoeidheid bij lang materiaal.
Veelvoorkomende toepassingen voor TTS-toegankelijkheid zijn:
- Schermlezers: Lees volledige pagina's voor met een schermlezer en TTS.
- Ondersteuning bij dyslexie en geletterdheid: Verminder de leesbelasting door leessessies te begeleiden met een TTS-stem.
- Slechtziendheid en blindheid: Schermlezers spreken interface-elementen en pagina-inhoud voor, zodat mensen software en websites kunnen gebruiken zonder het scherm te zien.
- Cognitieve verschillen en aandachtsproblemen: Tekst horen kan het lezen van lange documenten minder inspannend maken en helpt om de aandacht erbij te houden.
- Leren en taalstudie: Studenten horen de juiste uitspraak van nieuwe woordenschat en kunnen tijdens het reizen of studeren naar studieboeken luisteren.
Schermlezers zijn uitgebreide toegankelijkheidstools die alles op een scherm beschrijven, waaronder knoppen en menu's. Voorleestools richten zich op het uitspreken van de content zelf, meestal met meeloopmarkering, en hebben baat bij natuurlijkere stemmen omdat mensen ze langdurig gebruiken.
Klantenservice
Neurale spraaksynthese kan een hoogwaardige klantervaring bieden in combinatie met een LLM die agentische interacties aankan. Platforms zoals ElevenAgents combineren de stemlaag met spraakherkenning, een LLM en gekoppelde tools waarmee een agent begrijpt wat een beller nodig heeft en met een natuurlijke stem kan reageren.
Agents die met ElevenAgents zijn gebouwd, werken via telefoon, web, WhatsApp, e-mail en sms, zodat klanten een gesprek via verschillende kanalen kunnen voortzetten zonder zichzelf te herhalen. Voorbeelden van toepassingen:
- Bidirectionele voice AI-agents: Voer live gesprekken door vragen uit een kennisbank te beantwoorden of klanten naar specifieke flows te leiden, zoals terugbetalingen of aankopen.
- Interactive voice response (IVR)-systemen: Vervang verouderde menustructuren zoals ‘Druk op 3 voor verkoop’ door gesprekken waarin je klanten natuurlijk kunnen spreken.
- Meertalige support: Help klanten in hun eigen taal vanuit één agentconfiguratie.
Klarna heeft bijvoorbeeld de oplossingstijd met ElevenAgents met een factor 10 verkort
Hoe regelen text to speech-engines de uitspraak?
Moderne neurale spraaksynthese-engines kunnen zeer natuurlijk klinkende spraak genereren, maar randgevallen zullen altijd bestaan in iets dat zo breed, diep en dynamisch is als menselijke taal. Misschien wil je accenten, slang of regionale uitspraken behouden in je gegenereerde spraak. Misschien produceer je audio voor een sector waarin technische termen uniek worden uitgesproken. Of misschien wil je gewoon dat je merknaam altijd op een heel specifieke manier wordt uitgesproken.
Uitspraakwoordenboeken en foneme-overschrijvingen
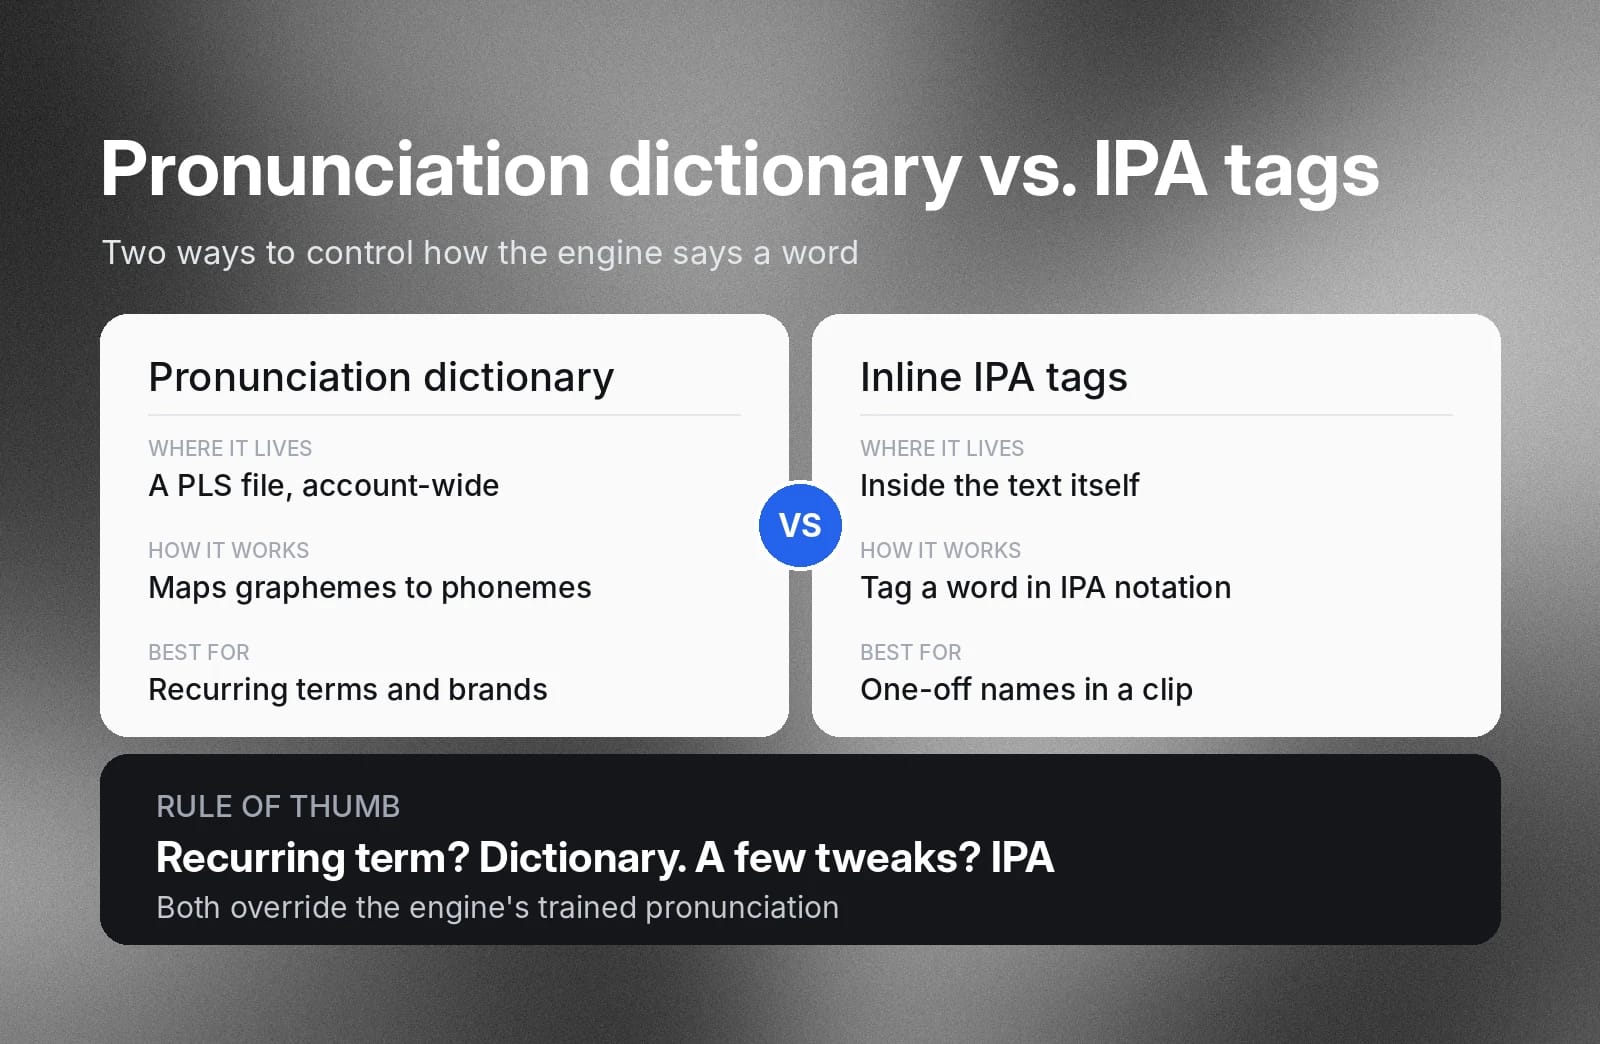
ElevenAPI van ElevenLabs bevat een uitspraakwoordenboek waarmee je kunt aanpassen hoe de engine spreekt. Je maakt een woordenboek in een W3C-standaardbestand voor de Pronunciation Lexicon Specification (PLS), dat grafemen (symbolen in tekst) koppelt aan fonemen (gesproken woorden opgesplitst in klanken). Wanneer de TTS-engine een van de vermelde grafemen tegenkomt, overschrijft deze de getrainde uitspraak en gebruikt hij de fonetische uitspraak uit het woordenboek.
In de documentatie Uitspraakwoordenboeken gebruiken lees je hoe je een uitspraakwoordenboek in ElevenAPI maakt.
Native IPA en fonetische prompting
Sommige TTS-modellen kunnen ook inline-uitspraaktags herkennen die rechtstreeks in de tekstinvoer zijn opgenomen. Wil je de uitspraak slechts in één of twee audioclips aanpassen, dan hoef je geen woordenboek voor je hele account te maken, maar kun je woorden in de tekst taggen met standaard IPA-notatie. Bijvoorbeeld als je een luisterboek opneemt en wilt dat de naam van een fictief personage op een specifieke manier wordt uitgesproken.
Veelvoorkomende uitdagingen bij text to speech en hoe je ze aanpakt
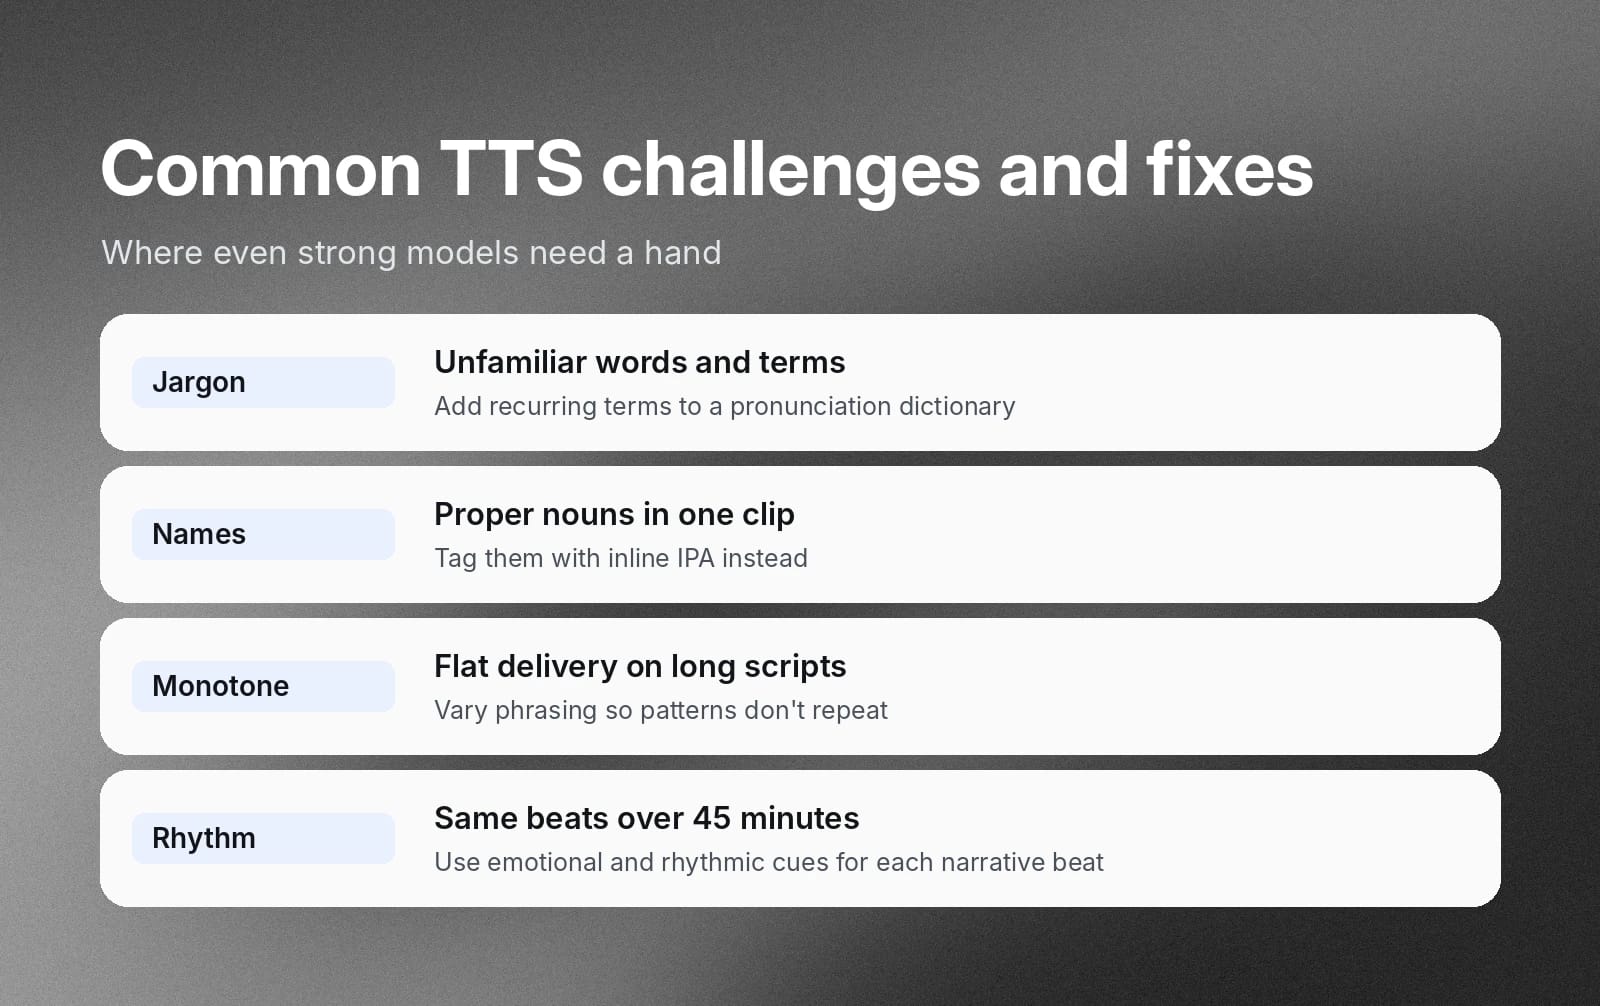
Zelfs de sterkste TTS-modellen kunnen moeite hebben met de nuances van menselijke taal. Twee van de meest voorkomende problemen zijn het verkeerd uitspreken van nieuwe woorden en monotone spraak. Zo pak je ze aan.
Verkeerde uitspraken van onbekende woorden, jargon en eigennamen
TTS-engines gebruiken algoritmen om te voorspellen hoe genormaliseerde tekst moet worden uitgesproken, op basis van hoe grafemen in hun trainingsdata aan fonemen zijn gekoppeld. Ze doen de best mogelijke voorspelling op basis van de tekst en context die ze hebben verwerkt. Maar zoals we in de vorige sectie bespraken, zijn er veel randgevallen waarin je iets op een zeer specifieke manier wilt laten uitspreken.
Uitspraakwoordenboeken of gerichte IPA-tags zijn je beste hulpmiddelen voor deze randgevallen. Heb je een veelvoorkomende term die je consistent wilt laten uitspreken, dan is een woordenboek de beste oplossing. Wil je slechts enkele termen gericht aanpassen, gebruik dan fonetische IPA-tags.
Monotone voordracht
Deze problemen komen het vaakst voor bij langere scripts waarin dezelfde woorden of zinnen steeds opnieuw worden uitgesproken. De gesynthetiseerde spraak van een engine kan uitstekend klinken in soundbites van 10 seconden, maar dezelfde routinematige uitspraak en ritmische patronen horen tijdens een lezing van 45 minuten wordt snel vermoeiend voor de luisteraar.
Varieer de formulering in je scripts en gebruik fonetische tags met mate om uitspraken periodiek te variëren. Gebruik emotionele en ritmische aanwijzingen om de spraakoutput dynamischer te maken, met stijgingen en dalingen die verschillende verhaalmomenten volgen.
Bouw natuurlijke stemervaringen met een Text to Speech API
Lichtgewicht webtools kunnen uitstekend zijn voor kleine audioclips, maar schalen niet goed mee met grotere bedrijfsbehoeften. Als je duizenden klantinteracties per minuut wilt beheren of hoogwaardige audiocontent in lange vorm wilt genereren, heb je robuustere TTS-tools nodig.
Met een Text to Speech API zoals ElevenAPI kun je je software rechtstreeks verbinden met neurale spraaksynthesemodellen. Je kunt REST-requests of persistente WebSockets gebruiken om op schaal on-demand audio te genereren voor agents of andere doeleinden.
Hoe een text to speech API-request werkt
Hoewel de modellen complex zijn, is de developerflow eenvoudig te begrijpen en kun je er snel mee aan de slag.
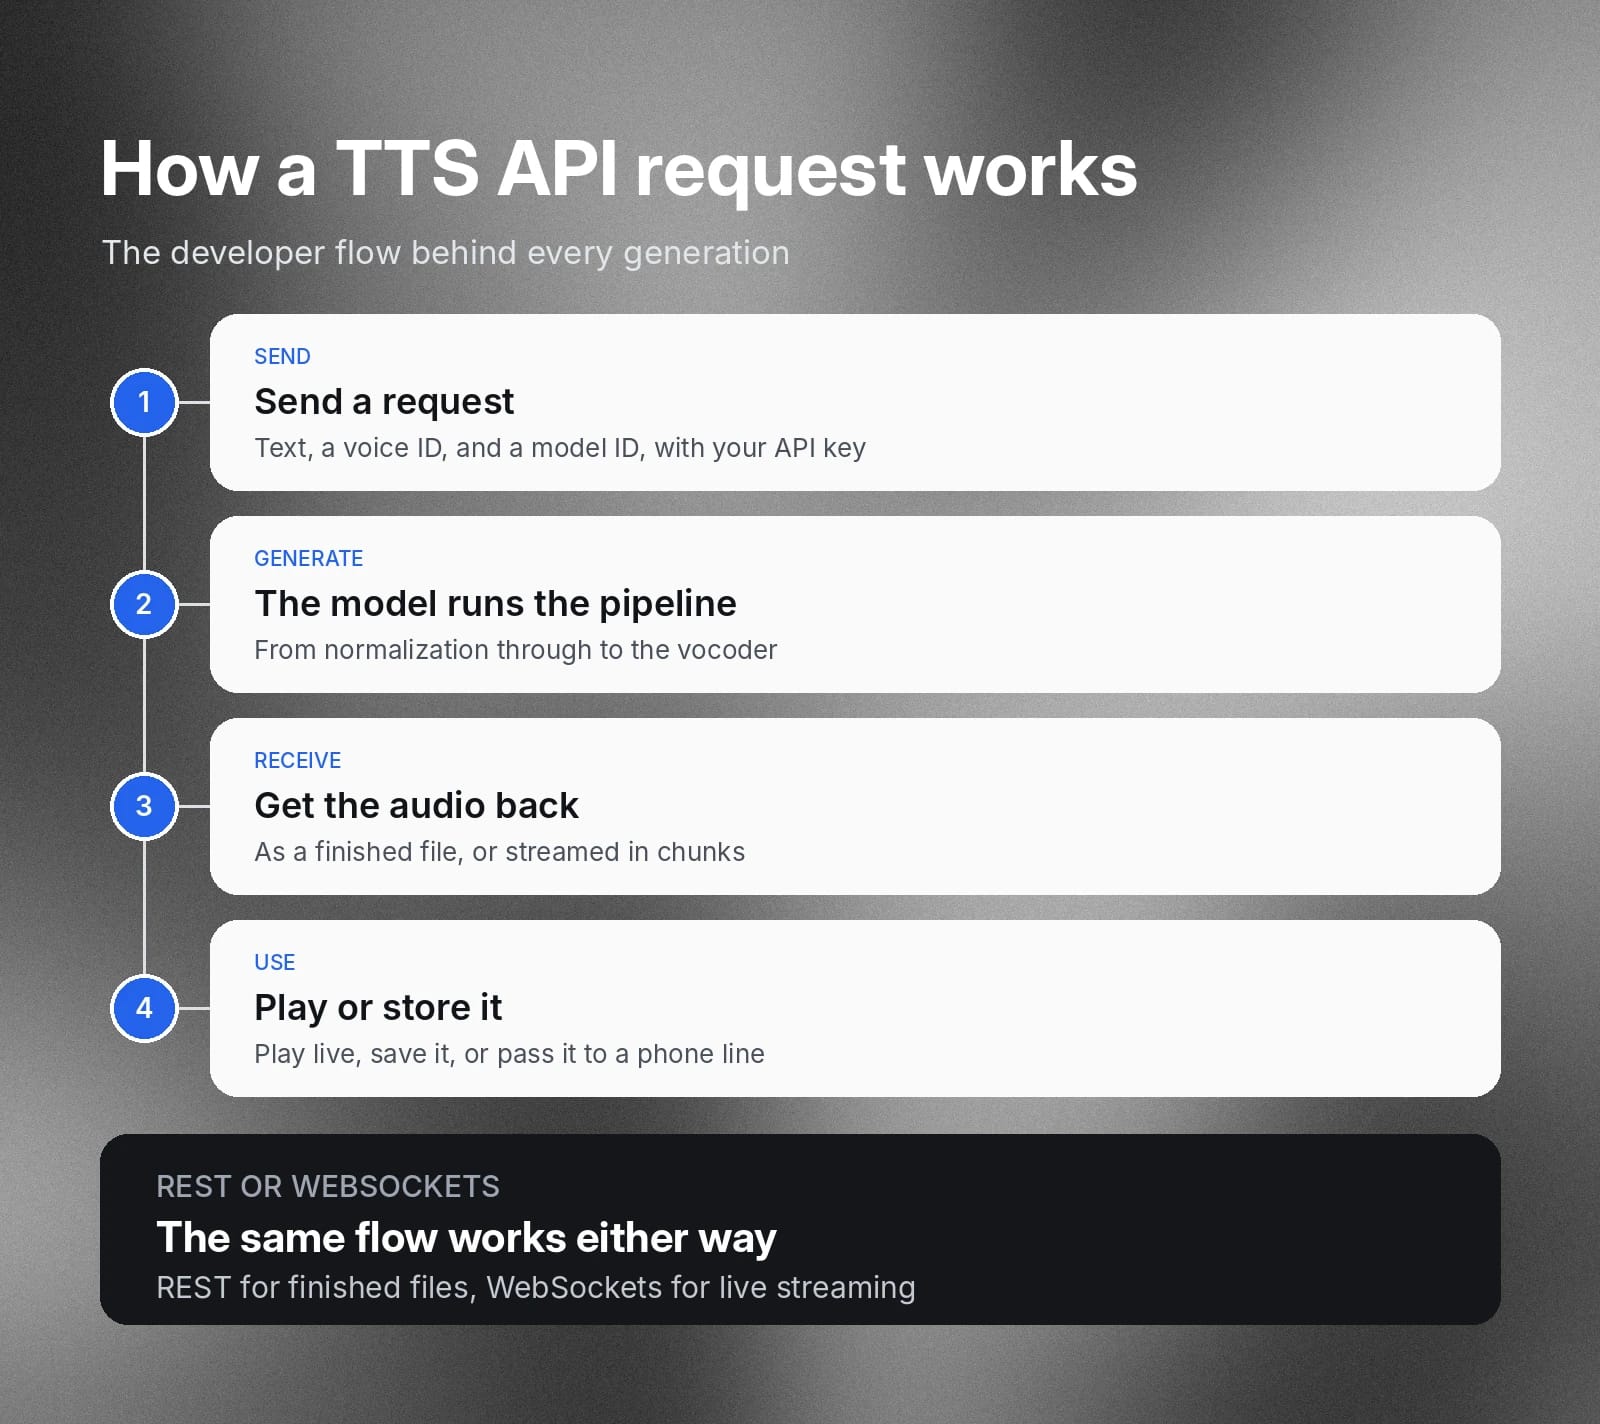
Met ElevenAPI kun je Text to Speech in je applicaties integreren in enkele minuten:
- Verstuur een request: Je applicatie stuurt de tekst, een stem-ID en een model-ID met je API-sleutel naar de API.
- Genereren: Het model doorloopt de hierboven beschreven pipeline, van normalisatie tot de vocoder.
- Audio ontvangen: De API retourneert het voltooide audiobestand of streamt het terug in chunks, zodat afspelen kan beginnen voordat de generatie is voltooid.
- Afspelen of opslaan: Je applicatie speelt de audio live af, slaat deze op of stuurt deze door naar een ander systeem, zoals een telefoonlijn.
Dezelfde flow geldt of je REST gebruikt voor voltooide bestanden of WebSockets voor live streaming, en de hieronder beschreven SDK's verpakken deze aanroepen voor je.
Architectuuroverwegingen voor ontwikkelaars
Afhankelijk van je use case moet je mogelijk afwegingen maken tussen verwerkingssnelheid, audiofideliteit, netwerklatentie en protocollen, en integratiemogelijkheden.
Latentie versus fideliteit
Om conversationele agents natuurlijk te laten klinken, kun je streven naar ongeveer 100 ms time-to-first-audio, wat betekent dat je de latentie in het netwerk en naar de TTS-engine minimaliseert. Hierbij gaat het om de kwaliteit van de audio-output die je binnen die beperking uit de architectuur van je agent kunt halen.
Bij audiocontent in lange vorm, zoals een podcast of lezing, is latentie daarentegen minder belangrijk. In plaats van latentie te minimaliseren, wil je output met hoge fideliteit maximaliseren.
Streamingprotocollen
De protocollen die je voor je API-verbinding gebruikt, kunnen ook van invloed zijn op latentie en prestaties. WebSockets maken echte bidirectionele audiostreaming mogelijk, wat betekent dat je tekst in chunks kunt verwerken in plaats van te wachten tot een hele feed is gerenderd. Het afspelen kan bij de eerste chunks beginnen terwijl de TTS-engine latere chunks nog verwerkt.
SDK's
Text to Speech API's van enterprise-niveau, zoals ElevenAPI, bieden volledige software development kits (SDK's) voor Python en TypeScript/JavaScript, evenals REST API's, om snel een nieuwe architectuur op te zetten. Gebruik ze om de integratie-overhead voor je devteam te verminderen.
Aan de slag met ElevenAPI voor Text to Speech
Natuurlijke TTS-synthese van een toonaangevend spraakmodel levert de hoogwaardige audio-output die je agents en audioproducties producties nodig hebben om luisteraars betrokken te houden. Of je nu op zoek bent naar een hoogwaardige conversationele agent voor klantworkflows of TTS in je applicatie wilt bouwen, ElevenLabs heeft een oplossing.
Ga vandaag aan de slag door je eigen audio met hoge fideliteit te produceren met ElevenAPI, of ontdek meer over ElevenAgents.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.