
Neural text to speech (TTS) uitgelegd: Zo werken AI-stemmen
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Neural text to speech (TTS) is de technologie achter de AI-stemmen die je overal hoort. De kleine knop op je nieuwssite die je artikel voorleest. Geautomatiseerde supportgesprekken. Videonarratie op sites zoals TikTok en YouTube. De lijst gaat door. Neural TTS heeft traditionele, robotachtige vormen van text to speech vervangen.
De TTS-markt groeide tot meer dan $4,8 miljard in 2026 en groeit met een samengesteld jaarlijks groeipercentage (CAGR) van 22,4%. De markt groeit elk jaar sterk doordat er meer toepassingen bijkomen en zowel creators als bedrijven deze technologie omarmen.
In deze gids lees je wat neural tekst-naar-spraak is en waarom het centraal staat in de snelle groei van deze sector. We bespreken hoe het verschilt van traditionele TTS en waar je op moet letten wanneer je een TTS API in je applicaties integreert.
Samenvatting
- Neural text to speech gebruikt deep learning om spraak vanaf nul te genereren.
- Neural stemmen leggen prosodie, intonatie, klemtoonpatronen en ritme vast om context op te bouwen voor hoe een menselijke stem klinkt.
- Traditionele concatenatieve en parametrische TTS bestaat nog in legacysystemen, maar neural synthese heeft die vervangen waar stemkwaliteit belangrijk is.
- Ontwikkelaars kunnen neural TTS via API's integreren; de streaminglatentie is nu laag genoeg voor realtime gesprekken.
Wat is neural text to speech?
Neural text to speech (neural TTS) is een vorm van spraaksynthese die deep neural networks gebruikt om menselijk klinkende spraak te produceren. Een neural network in AI bestaat uit lagen van onderling verbonden verwerkingseenheden en heet zo omdat het in grote lijnen lijkt op het neurale netwerk in menselijke hersenen.
Eerdere text to speech-modellen gebruikten handgeschreven regels en opgenomen audiofragmenten om taal in kaart te brengen en spraak uit tekstvoorbeelden te leren produceren. Een neural TTS-model leidt zelf regels af en leert uit context om lastigere aspecten van spraak aan te pakken, zoals waar het moet pauzeren of welk woord in een zin de klemtoon krijgt.
Aspecten zoals begrip van prosodie en emotie onderscheiden neural TTS van traditionele modellen.
Hoe neural TTS werkt: technisch overzicht
Op het eerste gezicht zet neural TTS tekst om in audio, met behoud van kenmerken die betekenis dragen: uitspraak, emotionele intentie, ritme, nadruk en toon. Onder de oppervlakte werkt een pipeline van modellen samen om tekst om te zetten in menselijk klinkende spraak.
De precieze architecturen verschillen per aanbieder, maar neural TTS heeft doorgaans de volgende kernfasen.
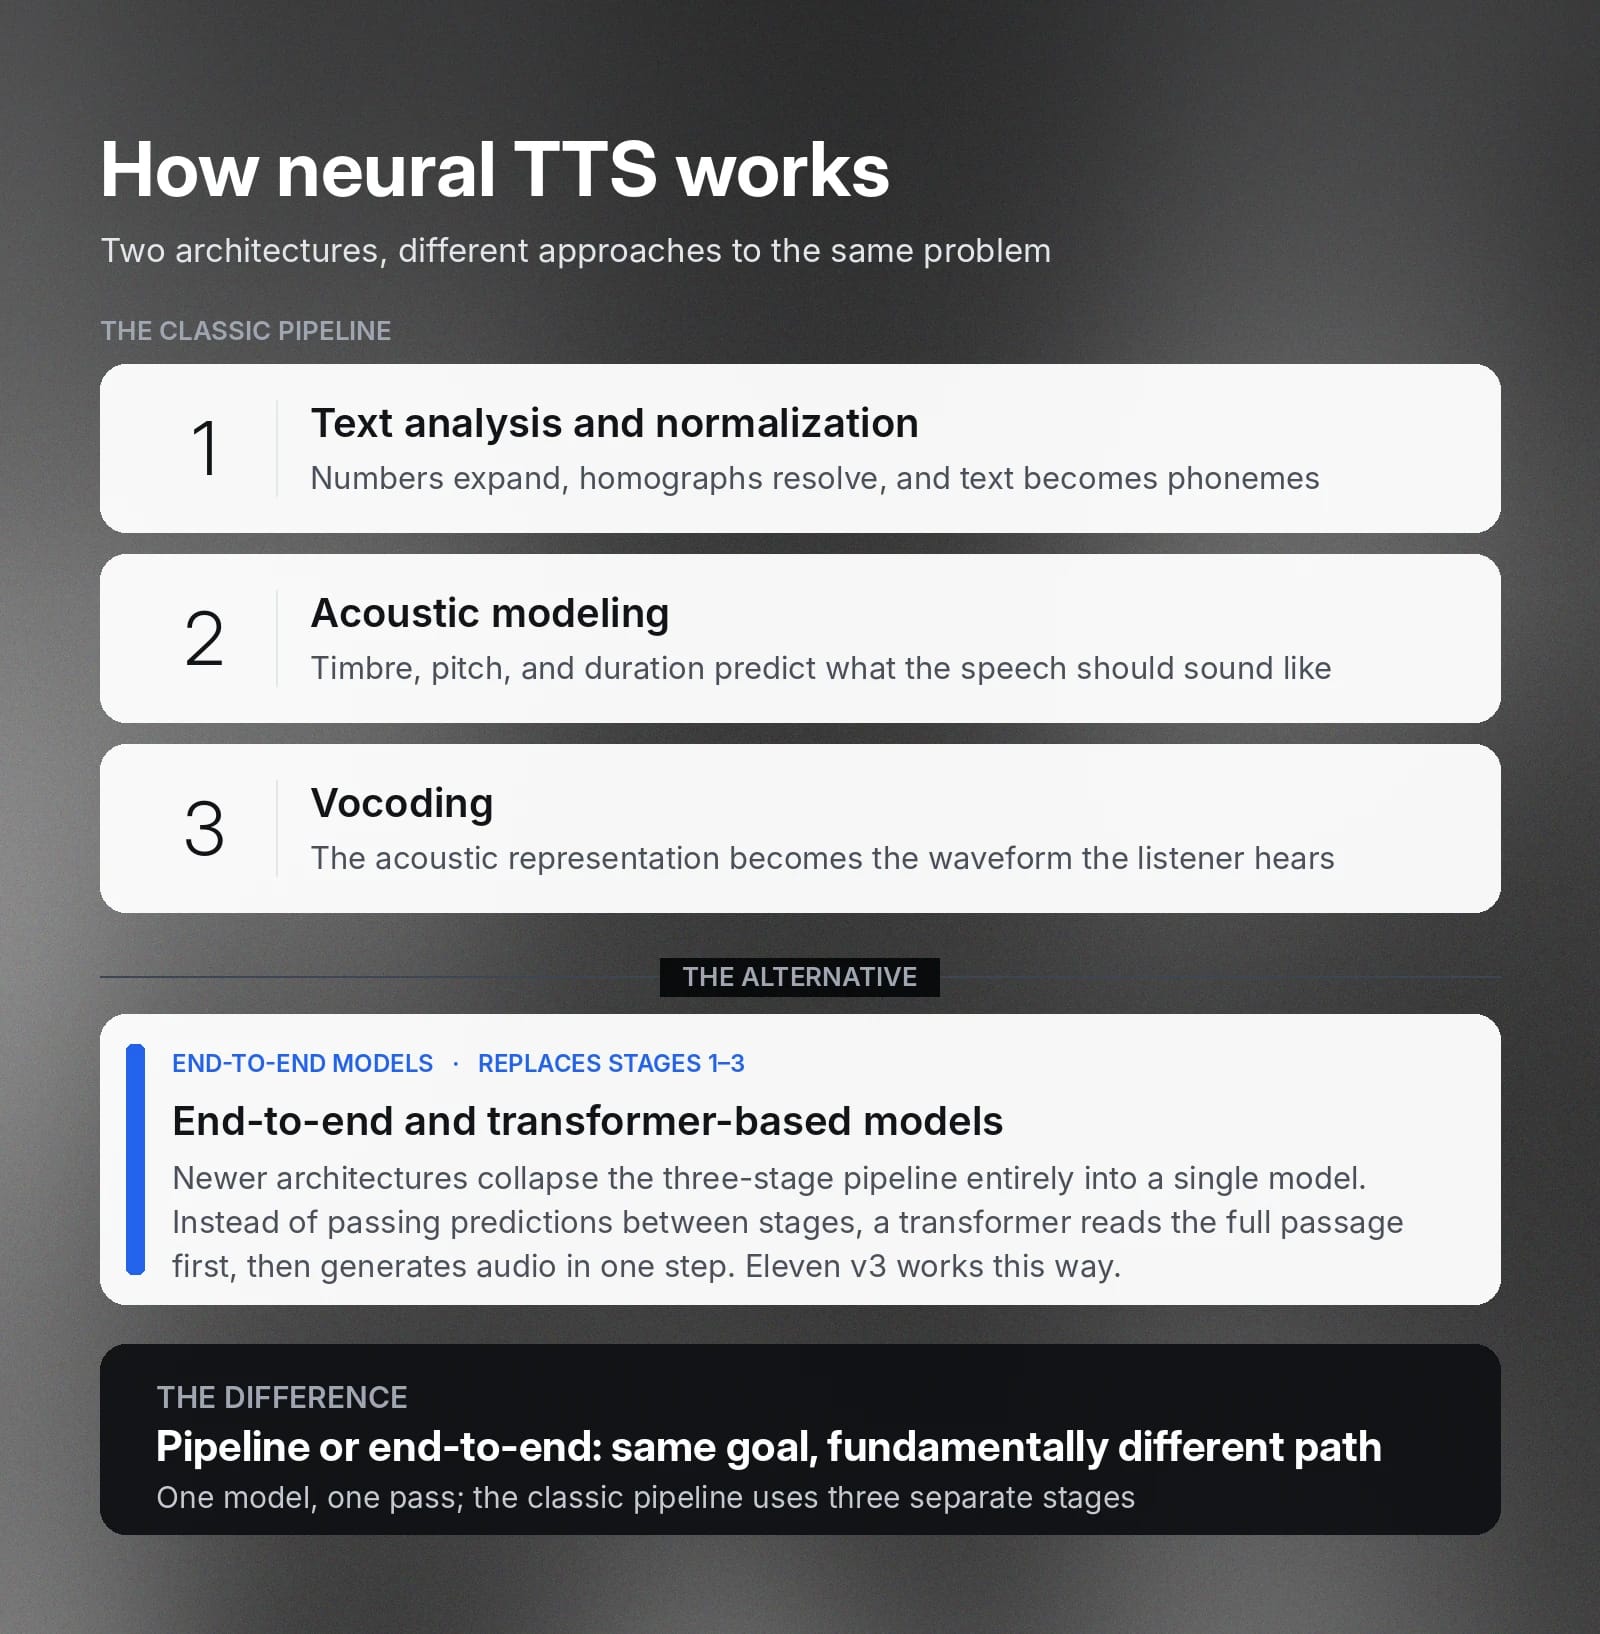
Tekstanalyse
Geschreven tekst zit vol dubbelzinnigheden. In het Engels is er een bekende voorbeeldzin waarin de betekenis verandert als je een ander woord benadrukt: “I didn't say he stole the money.” Benadruk "I," en je suggereert dat iemand anders het zei. Benadruk “he,” en je suggereert dat iemand anders het stal. Benadruk “money,” en ineens werd iets anders gestolen.
Tekstanalyse lost deze dubbelzinnigheid op voordat audio wordt gegenereerd. Afkortingen worden uitgeschreven en veelvoorkomende tekstelementen (datums, getallen, symbolen enzovoort) worden omgezet naar gesproken vormen. Homografen zoals “read,” “lead” en “bass” worden herkend en afhankelijk van de context van de hele zin correct uitgesproken. Ook voorspelt het prosodische markup en bepaalt het welke woorden het meeste gewicht dragen. Het akoestische model zet die markup in de volgende fase om.
Genormaliseerde tekst wordt vervolgens omgezet in afzonderlijke fonemen via een proces dat grafeem-naar-foneemconversie heet. Deze stap helpt ervoor te zorgen dat de uiteindelijke audio stabiel en correct is, zelfs in talen zoals Engels met notoir onbetrouwbare uitspraakregels.
We hebben een foneemgids geschreven die deze laag uitgebreider uitlegt.
Akoestische modellering
Het akoestische model is de neurale kern van het systeem: het neemt de foneemreeks en voorspelt hoe de spraak moet klinken.
De akoestische laag heeft drie hoofddimensies:
- Klankkleur: De klankkleur die een stem herkenbaar maakt als die van een specifieke spreker, soms de ‘stemafdruk’ van iemand genoemd.
- Toonhoogte: Het toonverloop in een zin, waaronder de intonatie van een zinsdeel en de stijging van een vraag of daling van een mededeling.
- Duur: Hoelang het model elk foneem aanhoudt. Dit bepaalt het tempo van een zin en voorkomt dat een woord als “jump” verandert in “jjjjump.”
Samen bepalen deze de prosodie van een zin. Neural TTS gebruikt ze voor een minder robotachtige voordracht. Door te trainen op uren echte spraak plaatst het model pauzes en nadruk op een manier die op menselijke spraak lijkt. Dit contextgebaseerde leren haalt patronen uit trainingsdata, in plaats van uit specifieke regels die ontwikkelaars hebben geïmplementeerd.
Architecturen zoals FastSpeech en Tacotron 2 zijn pijlers van deze fase en staan bekend om hun vermogen een foneemreeks om te zetten in een mel-spectrogram. Een mel-spectrogram is een kaart van de audiofrequenties in de tijd. Het beschrijft spraak, maar is geen afspeelbare audio: het is slechts een digitale representatie van de geluiden.
Vocoding
Een vocoder is het laatste netwerk in een klassieke pipeline. Het zet de hierboven besproken akoestische representatie om in een echte golfvorm, die de eindgebruiker hoort.
Een probleem bij het ontwikkelen en gebruiken van vocoders was dat ze doorgaans veel te traag waren voor echte productie-pipelines. Pas met iteraties zoals HiFi-GAN, die vroege vocoders zoals DeepMind's WaveNet verbeterden, werden de snelheden hoog genoeg voor echte productiescenario's.
Realtime neural TTS werd alleen mogelijk door innovaties in dit deel van de pipeline.
End-to-end- en transformer-gebaseerde modellen
Traditionele TTS-modellen doorlopen de drie bovenstaande fasen om audio uit tekst te produceren. Nieuwere generaties voegen deze pipeline volledig samen. Een transformer-gebaseerd model (met dezelfde architectuur als large language models) zet tekst in één end-to-endproces om in audio, in plaats van voorspellingen tussen afzonderlijke akoestische en vocodernetwerken door te geven.
Een pipelinemodel moet steeds één zin verwerken, terwijl een transformer de hele passage leest voordat die op basis van de bredere context bepaalt hoe een regel moet klinken. Dezelfde zin kan in een komedie heel anders worden uitgesproken dan in een drama.
ElevenLabs-modellen zoals Eleven v4 passen zich aan die nuance aan en accepteren inline audiotags zoals [whispers] of [nervous], zodat gebruikers meer controle hebben over hoe hun scripts klinken.
Neural text to speech versus traditionele TTS
Vóór de popularisering van neural networks kozen TTS-systemen voor een van twee hoofdbenaderingen. Beide kom je nog tegen in legacy IVR-menu's en schermlezers.
Dit zijn de twee traditionele TTS-typen:
- Concatenatieve TTS: Nam een stemacteur op die duizenden zinnen voorlas en knipte die in kleine fragmenten. Wanneer er spraak moest worden geproduceerd, werden die fragmenten aan elkaar geplakt. Individuele woorden konden menselijk klinken, maar de overgangen tussen fragmenten zorgden voor een schokkerig, robotachtig ritme dat mensen nog altijd associëren met een computerstem.
- Parametrische TTS: Genereerde audio op basis van een statistisch model van spraakparameters in plaats van opnames. Het was kleiner en flexibeler dan concatenatieve synthese, maar de audio klinkt gedempt en zoemend omdat het vereenvoudigde model de fijne details van echte spraak wegliet.
Neural TTS genereert daarentegen de volledige golfvorm uit een aangeleerd spraakmodel en elimineert beide problemen tegelijk.
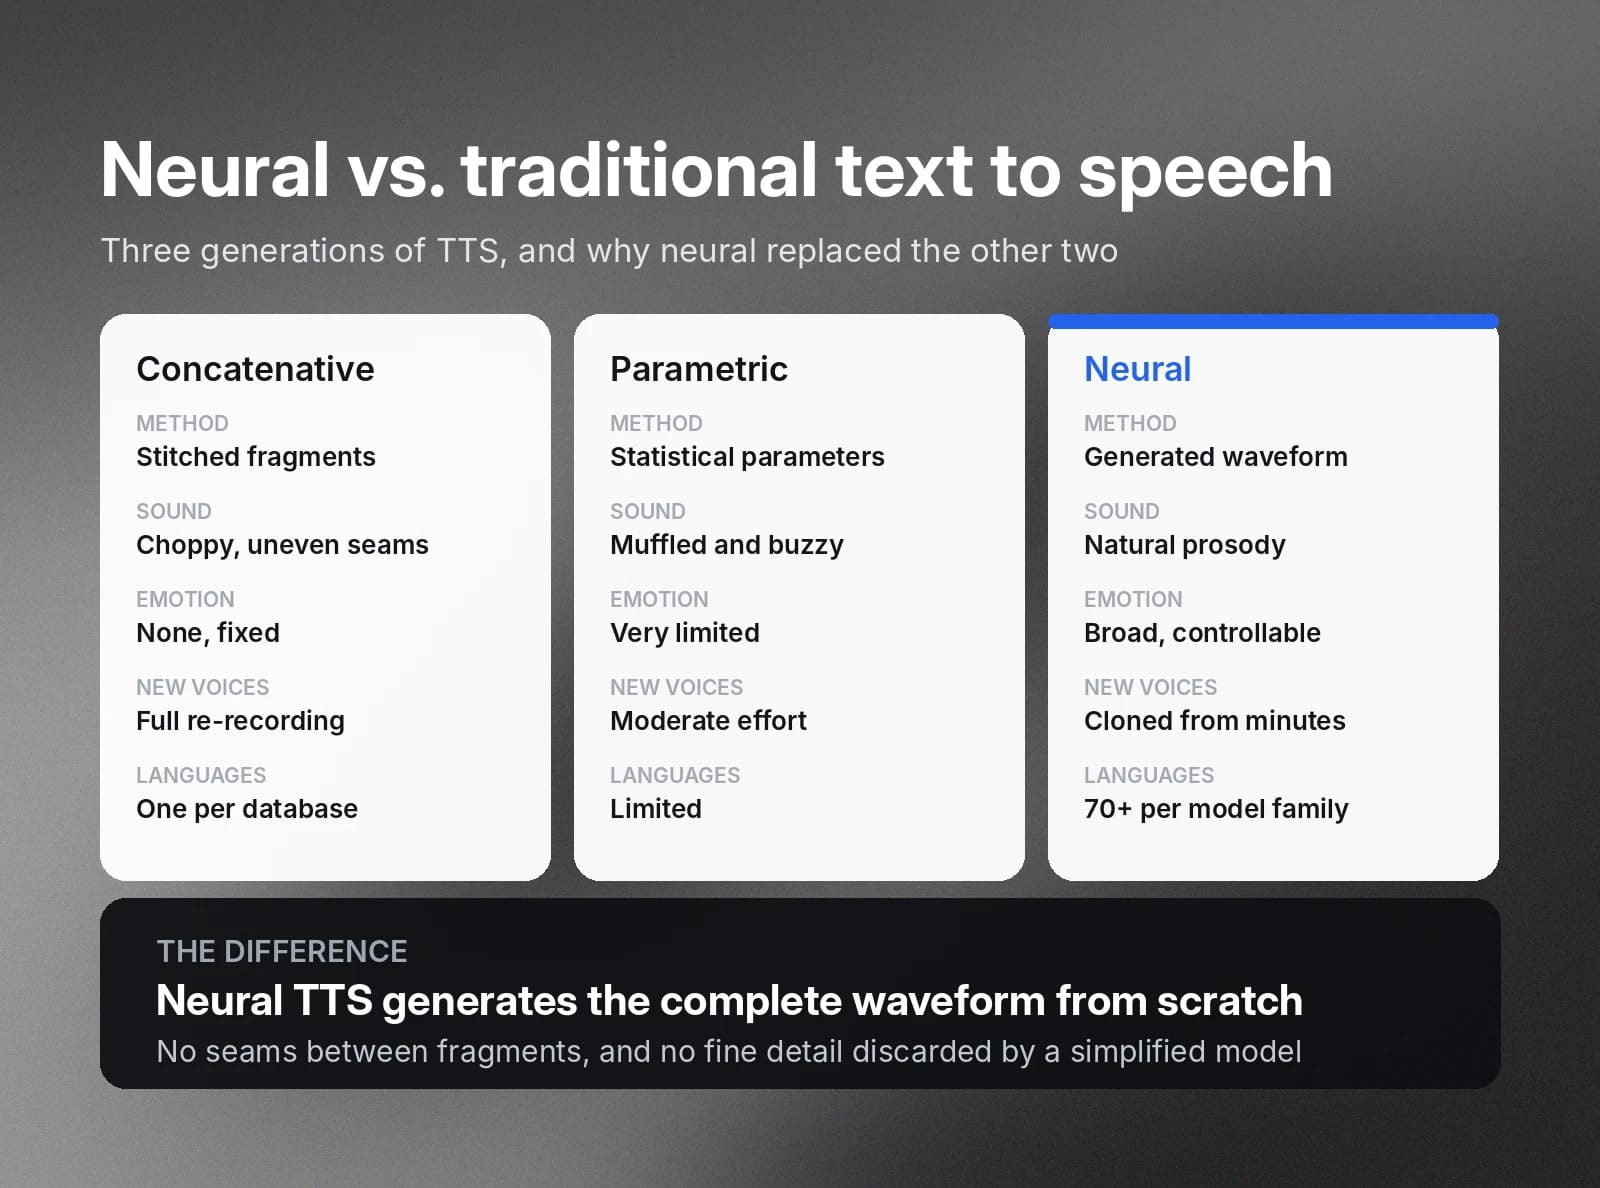
Zo vergelijkt neural text to speech zich over de hele linie met traditionele TTS.
Belangrijkste functies en voordelen van neural TTS
De vloeiende, menselijk klinkende audio van neural TTS maakt diverse toepassingen mogelijk, terwijl de grotere natuurlijkheid nieuwe mogelijkheden ontsluit die met traditionele TTS niet mogelijk waren.
Dit zijn enkele van de belangrijkste functies en voordelen van neural text to speech:
- Natuurlijke prosodie: Stemmen leggen nadruk, pauzes en intonatie zoals een menselijke spreker dat zou doen. Zo blijven luisteraars betrokken bij lange content, in plaats van gefrustreerd of vermoeid te raken.
- Emotionele expressie: Moderne modellen kunnen expressieve spraak leveren, of het nu gaat om dramatische monologen of rustige voordrachten. Met Eleven v4 sturen schrijvers dit aan via audiotags die je rechtstreeks in het script schrijft.
- Stemklonen: Een neuraal model leert het timbre en de stijl van een specifieke spreker uit een kort fragment. Je kunt Voice Cloning (Instant of Professional) gebruiken om een consistente stem te behouden in al je TTS-toepassingen.
- Meertaligheid: Een neuraal model kan tientallen talen spreken, waarbij een stemkloon zijn identiteit in elke taal behoudt. Een merk kan zo zorgen dat de gekozen stem in Londen hetzelfde klinkt als in Rome.
- Realtimesnelheid: Een neural text to speech-model kan spraak sneller synthetiseren dan die wordt afgespeeld, met streaminglatentie die laag genoeg is voor live gesprekken.
- Schaal: Na het trainen van neural TTS kan een stem moeiteloos miljoenen woorden inspreken, inclusief nieuwe productnamen en beschrijvingen, waardoor de kosten voor studio-opnames sterk dalen.
Neural text to speech verandert over de hele linie fundamenteel hoe TTS werkt. Die verschuiving biedt nieuwe kansen voor toegankelijkheid, bedrijven, bereik en emotionele expressie.
Belangrijkste toepassingen voor neural TTS-oplossingen
Doordat de fundamentele architectuur van een text to speech-model verandert, maken verbeteringen in snelheid en voordracht een reeks nieuwe toepassingen mogelijk.
Dit zijn enkele toepassingen waarin het vandaag de meeste waarde biedt.
Conversational AI en stemagents
Klantenservice-agents, virtuele receptionisten, telefonische assistenten en AI SDR's zijn allemaal afhankelijk van stemmen die betrouwbaar klinken en bijna direct reageren.
Conversational AI is de meest veeleisende toepassing voor neural TTS: de kwaliteitslat ligt er het hoogst en de latentievereisten zijn het strengst.
Luisterboeken en publiceren
Neurale narratie maakt het economisch haalbaar om audio-edities te produceren van titels uit de backcatalogus die normaal gesproken nooit de kosten van studio-opnames zouden rechtvaardigen. Je kunt een volledig luisterboek genereren in enkele uren met neural Text to Speech.
ElevenCreative maakt dat zo eenvoudig mogelijk; Character Casting vindt automatisch de beste stemmen voor een personage en vult hun regels in een volledig manuscript in.
Gaming en interactieve media
Dynamische dialogen, procedureel gegenereerde content en NPC-gesprekken zijn enorme projecten wanneer ze handmatig in een studio worden opgenomen. Neural TTS laat studio's ze op schaal inspreken en fouten herstellen door tekst te bewerken in plaats van extra studiouren te factureren.
Lokalisatie en nasynchronisatie
Neural TTS in combinatie met vertaling brengt video- en audiocontent naar nieuwe markten, terwijl de stemidentiteit van de oorspronkelijke spreker behouden blijft.
Het publiek van een creator in Medellín hoort dezelfde herkenbare stem als in Boston, maar dan Spaans sprekend.
Neural text to speech integreren in je applicatie
Voor ontwikkelaars is neural TTS slechts één API-call verwijderd.
Hier is een volledig voorbeeld dat tekst omzet in spraak met ElevenAPI via de Python SDK.
Hetzelfde endpoint is beschikbaar via REST of SDK's voor Python, JavaScript en andere talen. Er zijn drie integratiepatronen die de meeste applicaties dekken:
- Batchsynthese: Verstuur tekst en ontvang een volledig audiobestand. Dit past bij vooraf geproduceerde content zoals artikelen, IVR-prompts, luisterboeken en video's.
- HTTP-streaming: Audiochunks komen binnen zodra ze zijn gegenereerd, zodat het afspelen begint voordat de synthese klaar is. Gebruik dit om lange documenten voor te lezen of podcastachtige content op aanvraag te genereren.
- WebSocket-streaming: Voor conversational agents accepteert een permanente WebSocket-verbinding tekst stapsgewijs, zoals tokens die uit een LLM streamen, en retourneert audio met de laagst mogelijke latentie.
Productie-integraties hebben ook retry-logica, request timeouts en goede foutafhandeling nodig. Lees voor meer informatie onze gids over patronen voor Text to Speech API-integratie.
Een Text to Speech API kiezen: waar je op moet letten
Hoewel Text to Speech API's vergelijkbaar kunnen lijken, zijn er onder de oppervlakte enorm veel functies die de ene API geschikter kunnen maken dan de andere voor jouw specifieke toepassing.
Dit is geen volledige lijst, maar dit zijn punten om op te letten bij een TTS API:
- Audiokwaliteit: Als de audio van een neural TTS API niet goed klinkt, is die aanbieder niet geschikt voor je. Voer blinde luistertests uit, vooral met lange narratie; daar worden tekortkomingen het waarschijnlijkst hoorbaar.
- Latentie: Kijk bij conversationele AI-pipelines of -applicaties naar time to first byte. Ook regionale infrastructuur is belangrijk. We konden de wereldwijde API-latentie met maximaal 40% verlagen door verkeer via datacenters dichter bij gebruikers te routeren.
- Streamingondersteuning: Controleer of HTTP- en WebSocket-streaming allebei beschikbaar en gedocumenteerd zijn. API's die alleen batchverwerking bieden, sluiten realtime toepassingen volledig uit.
- Taal- en stemdekking: Zoek neural text to speech API's met brede taalondersteuning, vooral voor de talen die je regelmatig nodig hebt in je apps.
- Expressieve controle: Zoek tools waarmee je kunt sturen hoe neural TTS in de praktijk klinkt. ElevenLabs-audiotags bieden gedetailleerde controle over spraak.
- Overeenkomst met de spreker: Gebruik je stemklonen, controleer dan hoe goed het model de voordracht en prosodie van een gekloonde stem behoudt in een langere passage. Scripts met meer tekens kunnen na verloop van tijd achteruitgaan, waardoor de stem anders klinkt dan het oorspronkelijke fragment.
- Licenties en ethiek: Bevestig dat je commerciële rechten op de output krijgt en bekijk hoe de aanbieder omgaat met stemtoestemming, gegevensbewaring en het voorkomen van misbruik. Enterprise-kopers moeten vragen naar SOC 2-compliance en AI-veiligheidscertificering door derden, zoals AIUC-1 en ISO 42001.
- Documentatie en developer experience: Een uur zoeken in documentatie voor ontwikkelaars vertelt je alles wat je moet weten over hoe volledig een product is. Vertrouw op docs en advies van engineers, niet op verkooppraatjes.
- Prijsmodel: Veel API's rekenen per teken/credit. Bereken je maandelijkse volume en vergelijk abonnementen op basis van dat aantal, niet van de instapprijs.
Ga aan de slag met ElevenAPI voor hoogwaardige neural TTS
ElevenAPI geeft ontwikkelaars direct toegang tot de neurale Text to Speech-modellen achter ElevenLabs, met meer dan 90 talen en duizenden stemmen. We bieden HTTP-streaming en WebSocket-ondersteuning, en lage latency die is ontwikkeld voor realtime gesprekken.
Bekijk de productpagina van de Text to Speech API om de modellen te horen, of registreer je en maak een gratis API-sleutel om aan de slag te gaan.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.




