
Text to Speech API-integratie: streaming, batching, retries
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Een Text to Speech API integreren is eenvoudig… zodra je een paar concrete keuzes hebt gemaakt: welke overdrachtsmodus je gebruikt, hoe je een model en outputformat kiest, hoe je streamt, hoe je grote volumes verwerkt zonder je concurrencylimiet te overschrijden, hoe je cachet en opnieuw probeert zodat je nooit twee keer betaalt om dezelfde audio te genereren, en hoe je time-to-first-byte vergelijkt met een andere provider.
Om je te helpen bij de integratie van de Text to Speech API, hebben we al deze architecturale keuzes en de bijbehorende aanpak uiteengezet. Deze handleiding helpt je de ElevenLabs Text to Speech API te integreren en op te schalen, met codefragmenten die je direct in productie kunt plakken.
Bekijk voor uitgebreide achtergrondinformatie over de concepten die hier worden genoemd onze handleidingen over audiostreaming begrijpen, latency optimaliseren, en het overzicht van ElevenLabs-modellen.
Samenvatting
- Er is één ElevenLabs Text to Speech API-endpoint, dat je op drie manieren kunt gebruiken: batch convert, HTTP-stream en stream-input WebSocket.
- Via HTTP telt elke actieve request mee voor je concurrencylimiet, terwijl via WebSocket alleen actieve generatie meetelt.
- Beperk je parallellisme tot net onder je abonnementslimiet en cache een hash van elke parameter die de output beïnvloedt, zodat je nooit twee keer voor dezelfde tekst wordt gefactureerd.
- Probeer 429- en 5xx-fouten opnieuw met exponential backoff en full jitter, zodat je gas terugneemt voordat je de concurrencygrens bereikt.
Drie manieren om de Text to Speech API te integreren
Er is één Text to Speech-endpoint, maar de manier waarop je het integreert bepaalt je latency, complexiteit en kosten.
Dezelfde POST /v1/text-to-speech/{voice_id}-aanroep werkt in drie vormen, elk geschikt voor een iets andere toepassing. Hieronder vind je alle drie de manieren om de Text to Speech API te integreren:
- Batch (convert) is de eenvoudigste integratie: Je verstuurt één request en ontvangt één audiorespons. Dit is de optie met de minste complexiteit en de hoogste time-to-first-audio, omdat de volledige clip wordt gesynthetiseerd voordat er bytes terugkomen.
- HTTP-streaming (stream) behoudt dezelfde request maar verdeelt de respons in chunks: Je voegt /stream toe aan het pad, roept de stream-methode aan en de audio komt terug als een chunked response. De code is vrijwel identiek en de ervaren latency is veel lager.
- De WebSocket (stream-input) houdt een permanente verbinding open: Je verstuurt tekst incrementeel en ontvangt gaandeweg audiochunks terug. Deze optie is ontwikkeld voor interactieve agents en om de output van een LLM om te zetten in spraak terwijl tokens worden geproduceerd, nog voordat de zin af is.
Streaming zorgt er niet voor dat het model sneller audio genereert; de inferentietijd blijft gelijk. Streaming verandert wanneer je de eerste chunk ontvangt: die wordt verstuurd voordat de volledige clip klaar is, waardoor de gebruiker minder lang wacht, ook al blijft de totale hoeveelheid werk hetzelfde.
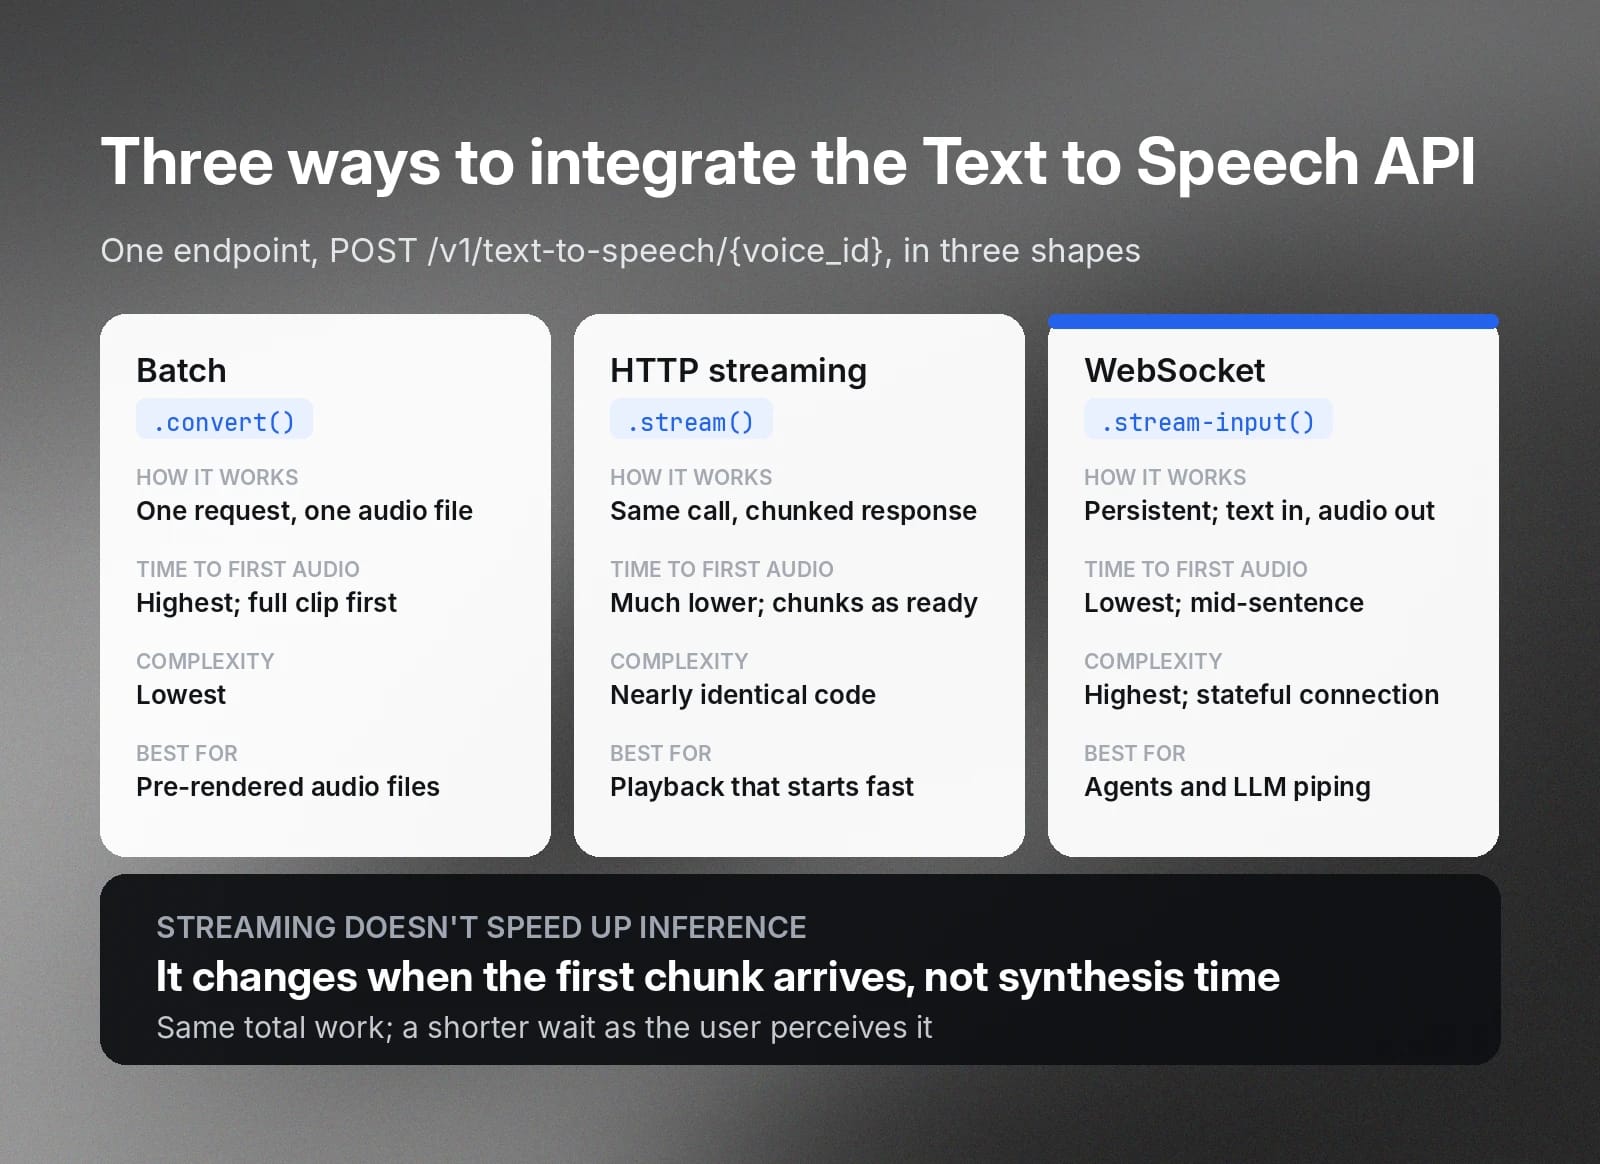
Beslistabel: batch vs. streaming vs. WebSocket
Bij de keuze tussen deze drie methoden moet je rekening houden met verschillende factoren.
Als snelle richtlijn: kies batch voor offline rendering, HTTP-streaming voor bekende tekst waarop een gebruiker wacht, en WebSocket voor agents en live LLM-naar-spraak.
De onderstaande tabel zet de afwegingen uiteen op de dimensies die op schaal belangrijk zijn.
Via HTTP telt elke actieve request, zowel batch als streaming, gedurende de volledige looptijd mee voor de concurrencylimiet van je abonnement. Via een WebSocket telt alleen de tijd mee waarin het model actief audio genereert; een open maar inactieve socket kost vrijwel niets.
Voor een cascaderende stemagent die gedurende een volledig gesprek een verbinding openhoudt maar alleen audio genereert tijdens de beurten van de agent, is dat verschil groot. Het is de belangrijkste reden om WebSockets te gebruiken bij het bouwen van agents. Het volledige protocol staat beschreven in de handleiding voor realtime Text to Speech WebSocket.
Een model en outputformat kiezen
Twee keuzes bepalen de audio die je terugkrijgt van je TTS API-integratie. Ten eerste het model, dat de kwaliteit en snelheid bepaalt. Ten tweede het outputformat, dat de container, bitrate en sample rate bepaalt.
Als je beide vanaf het begin goed kiest, vallen alle vervolgstappen, zoals latency en compatibiliteit met telefonie, op hun plek.
Modellen
We bieden verschillende Text to Speech-modellen. Ze zijn niet gerangschikt van best naar slechtst; elk maakt andere afwegingen.
Ter toelichting: de waarde van ~75 ms is modelinference onder representatieve omstandigheden, exclusief netwerk- en applicatielatency. Deze neemt toe bij langere invoer en onder belasting. Meet altijd vanuit je applicatie, niet op basis van een benchmarkgetal.
Flash-modellen zijn kleiner en gebruiken agressievere benaderingen om de inferentietijd te verkorten. Eleven v4 en Multilingual v2 zijn grotere modellen die meer tijd per teken besteden om rijkere output te produceren.
Gebruik voor een realtime- of agenttraject eleven_flash_v2_5; dat is de meertalige optie met de laagste latency. Gebruik voor narratie, luisterboeken, of marketing-voice-over, eleven_multilingual_v2 als je stabiele, hoge kwaliteit wilt, of eleven_v4 als je maximale expressiviteit en emotioneel bereik nodig hebt.
Wanneer uitspraak belangrijk is, bijvoorbeeld voor telefoonnummers, datums of valuta, normaliseer je de getallen zelf in je applicatie voordat de tekst de API bereikt. Schrijf de gesproken vorm uit die je wilt.
Door dit zelf te normaliseren blijft de uitspraak voorspelbaar tussen modellen en voorkom je dat je afhankelijk bent van modelspecifieke standaardwaarden die kunnen veranderen.
Outputformat
De parameter output_format bepaalt de container, sample rate en bitrate van de audio die je terugkrijgt. Dit zijn de waarden die je het vaakst gebruikt:
Steminstellingen
De volgende instellingen bepalen hoe de gegenereerde spraak wordt uitgesproken:
- Stabiliteit: Bepaalt de balans tussen consistentie en expressiviteit. Lagere waarden leveren meer gevarieerde, expressieve spraak op, terwijl hogere waarden zorgen voor een stabielere, voorspelbaardere uitspraak.
- SimilarityBoost: Bepaalt hoe nauw de output de referentiestem volgt.
- Stijl: Vergroot de natuurlijke spreekstijl van de stem wanneer deze wordt verhoogd.
- useSpeakerBoost: Vergroot de gelijkenis met de oorspronkelijke spreker tegen geringe extra latency.
- Snelheid: Past het spreektempo aan rond de standaardwaarde van 1.0.
Van deze instellingen heeft Stability doorgaans de grootste invloed op de ervaren kwaliteit. Lagere waarden zorgen voor expressievere maar minder consistente output, terwijl hogere waarden prioriteit geven aan consistentie en voorspelbaarheid.
Bij het kiezen van een stem is de combinatie met de laagste latency Flash met een Instant Voice Clone of een standaardstem; Professional Voice Clones klinken uitstekend, maar voegen overhead per generatie toe waarmee je rekening moet houden.
In deze handleiding is de voorbeeld-stem-id JBFqnCBsd6RMkjVDRZzb (George).
Streamingintegratie (HTTP en WebSocket)
In deze sectie behandelen we de praktische kern van de integratie van de Text to Speech API. We bespreken het installeren van de SDK, het openen van een stream en het verwerken van audio zodra deze binnenkomt. Het HTTP-traject dekt de meeste web- en app-weergave, terwijl het WebSocket-traject agents en live LLM-output dekt.
Beide trajecten gaan ervan uit dat je de onderstaande ElevenLabs-client hebt geïnitialiseerd.
Het streamingtraject opent een stream en verwerkt chunks zodra ze binnenkomen. voiceId is het eerste positionele argument, gevolgd door een options-object met camelCase-sleutels (modelId, outputFormat, voiceSettings):
Maak voor de WebSocket-variant verbinding met wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input, verstuur een eerste bericht met je steminstellingen en een spatie aan het begin, verstuur vervolgens tekstberichten zodra ze beschikbaar zijn en lees JSON-frames terug waarvan het audioveld base64-gecodeerde chunks bevat.
Batchverwerking en concurrencylimieten voor hoge throughput
Integratie met hoge throughput wordt bepaald door concurrency: het aantal requests dat op hetzelfde moment audio genereert. Elk abonnement heeft een limiet per modelfamilie.
Elk abonnement heeft een eigen concurrencylimiet:
- Free: 4 gelijktijdige Flash-requests.
- Starter: 6 gelijktijdige Flash-requests.
- Creator: 10 gelijktijdige Flash-requests.
- Pro: 20 gelijktijdige Flash-requests.
- Scale en Business: 30 gelijktijdige Flash-requests, met aangepaste Enterprise-limieten.
De limieten voor Multilingual v2 zijn ongeveer de helft hiervan.
Een begrensde pool beperkt dit door het aantal requests dat tegelijk wordt uitgevoerd te maximeren:
Stel MAX_CONCURRENCY iets lager in dan je abonnementslimiet, in plaats van precies op die limiet. Die marge vangt ander verkeer op dat dezelfde sleutel gebruikt en houdt je onder de drempel waarop een 429 wordt geretourneerd.
Tekenlimieten en lange tekst opsplitsen
Elk model beperkt het aantal tekens dat het in één request accepteert. Elke integratie voor lange content moet tekst opsplitsen en de audio weer samenvoegen.
Dit zijn de tekenlimieten per request voor elk model:
- Flash v2.5: Accepteert maximaal 40.000 tekens per request.
- Flash v2: Accepteert maximaal 30.000 tekens per request.
- Multilingual v2: Accepteert maximaal 10.000 tekens per request.
- Eleven v3: Accepteert maximaal 5.000 tekens per request.
- Eleven v4: Accepteert maximaal 10.000 tekens per request.
Alles wat langer is, moet je opsplitsen in meerdere requests. Probeer te splitsen op zinsgrenzen zodat de prosodie behouden blijft bij de overgang tussen chunks.
Genereer de chunks op volgorde en voeg de audio samen. Bij lange narratie waarbij elke chunk onafhankelijk is, sluiten de twee onderdelen rechtstreeks op elkaar aan: voer de output van splitText in de begrensde pool hierboven en laat die de rest afhandelen.
Caching en idempotentie
De output van Text to Speech is voldoende deterministisch dat dezelfde tekst opnieuw genereren met dezelfde stem, hetzelfde model en dezelfde instellingen verspilling is. Cache het resultaat met een hash van de invoer die de audio beïnvloedt als sleutel; dezelfde sleutel dient bij nieuwe pogingen ook als idempotentietoken.
Zo doe je beide.
De regel die dit laat werken, is dat elke parameter die de audio verandert in de sleutel moet staan, inclusief outputFormat en steminstellingen. Als je dit goed doet, fungeert dezelfde sleutel ook als idempotentietoken. Wanneer een client een request opnieuw probeert dat al is geslaagd, retourneer je de gecachte bytes in plaats van opnieuw te genereren.
Foutafhandeling en ratelimieten (429's)
Een productieclient heeft nieuwe pogingen met backoff en jitter nodig, plus afhandeling die per statuscode verschilt, omdat sommige fouten het waard zijn om opnieuw te proberen en andere niet.
De onderstaande tabel koppelt elke status aan de juiste actie. In deze sectie leggen we uit waarom een 429 een zachte limiet is en geen harde grens.
Een 429 is geen harde grens, en het helpt om het mechanisme te kennen. Wanneer je de concurrencylimiet overschrijdt, worden requests eerst op prioriteit in de wachtrij gezet, wat doorgaans ongeveer 50 ms toevoegt. Alleen als je daarna nog steeds boven de capaciteit zit, ontvang je een 429.
De respons bevat ook de headers current-concurrent-requests en maximum-concurrent-requests, die je actuele beschikbare ruimte tonen. Je kunt ze dus uitlezen en gas terugnemen voordat je de limiet bereikt.
Wanneer je meer ruimte nodig hebt in plaats van beter retrygedrag, upgrade je je abonnement. Enterprise-klanten kunnen via hun accountmanager hogere limieten aanvragen.
Latency en time-to-first-byte benchmarken
Latency hangt af van je regio, je invoer en de huidige belasting. Dat betekent dat het enige latencygetal waarop je kunt vertrouwen, een getal is dat je vanuit je eigen omgeving hebt gemeten.
Deze sectie geeft je time-to-first-byte (TTFB) voor het Flash-streamingendpoint en is zo opgebouwd dat je dezelfde testharnas op een andere provider kunt richten en ze onder identieke omstandigheden kunt vergelijken.
Beschouw dit als een methodologie, niet als een gepubliceerd resultaat. Eén enkele uitvoering biedt nergens garantie voor.
Hier zijn enkele belangrijke aandachtspunten bij het benchmarken van de latency van een Text to Speech API-integratie:
- Neem de netwerk-roundtrip mee: TTFB hangt af van je locatie en het dichtstbijzijnde cluster van de provider, dus voer de test uit vanaf de locatie waar je servers doorgaans draaien.
- Negeer een warm-uprun: De eerste request naar een koude verbinding is trager en kan je cijfers vertekenen.
- Houd de invoer constant: Invoerlengte, stem, model en belasting beïnvloeden allemaal het resultaat, dus houd ze identiek bij alle providers.
- Rapporteer een verdeling: Resultaten verschillen per run, dus publiceer de mediaan en p95 in plaats van één waarde.
Met deze aandachtspunten ben je klaar om te benchmarken.
Schrijf voor een vergelijking met een andere provider een functie met dezelfde vorm. Laat beide vervolgens draaien via een kleine runner die één warm-upcall weggooit, ongeveer 20 getimede samples neemt met tussenpozen zodat ze niet met elkaar botsen, en de mediaan en p95 in milliseconden rapporteert.
Een eerlijke vergelijking draait om het beheersen van de variabelen.
Voer beide providers uit vanaf dezelfde machine en hetzelfde netwerk, idealiter een server in de regio waar je daadwerkelijk implementeert in plaats van een laptop op een thuisverbinding. Gebruik dezelfde invoertekst en houd de audio kort, zodat modelinference het cijfer bepaalt in plaats van de generatielengte. Rapporteer de mediaan en p95 over veel runs, want één meting is ruis.
Houd er rekening mee dat TTFB via het openbare internet 20-200 ms netwerk-roundtrip bevat die niets met het model te maken heeft. We leveren vanuit clusters in Noord-Amerika, Europa en Zuidoost-Azië en routeren naar het dichtstbijzijnde cluster. Plaats je testclient dus overeenkomstig, anders benchmark je vooral de afstand tot het datacenter.
Belangrijkste punten voor je Text to Speech API-integratie
Een productieklare Text to Speech API-integratie draait om een aantal keuzes met grote impact.
Als je deze goed maakt, valt al het andere op zijn plek:
- Kies het model op basis van de taak: Gebruik Flash v2.5 voor alles wat interactief is en een model met hogere kwaliteit zoals Multilingual v2 of Eleven v4 voor offline rendering waarbij latency minder belangrijk is.
- Stream wanneer een gebruiker wacht: Gebruik HTTP-streaming voor bekende tekst en een WebSocket voor agenten, zodat inactieve tijd niet van je concurrencybudget afgaat.
- Beperk je parallellisme tot je abonnementslimiet: Beperk gelijktijdige requests tot net onder je abonnementslimiet en cache op basis van een hash van elke parameter die de output beïnvloedt, zodat dezelfde audio nooit twee keer wordt gefactureerd.
- Probeer 429- en 5xx-fouten opnieuw met exponential backoff en full jitter: Neem gas terug bij 429 en 5xx met full jitter, en houd de concurrencyheaders in de gaten om te zien hoe dicht je bij de limiet zit.
- Splits lange tekst op zinsgrenzen: Splits op zinsgrenzen binnen de tekenlimiet van elk model, zodat prosodie behouden blijft bij de overgang.
Als je nog dieper wilt gaan, bekijk dan de handleiding voor streaming, het concept audiostreaming, authenticatie, en tokens voor eenmalig gebruik aan de clientzijde.
Bouw je Text to Speech-integratie met ElevenAPI
Na het lezen van deze handleiding heb je alle patronen die je nodig hebt voor een productieklare Text to Speech API-integratie. Van streaming, batchverwerking en caching tot retries en zelfs benchmarken: je bent klaar om dit operationeel te maken.
Ga aan de slag door meer te leren over de Text to Speech API of registreer je om vandaag je eerste aanroep te doen met ElevenAPI.
Veelgestelde vragen over integratie van de Text to Speech API

Tadas Petra is Developer Relations Engineer en helpt ontwikkelaars bouwen met de productreeks van ElevenLabs. Hij is ook de oprichter van Hungrimind, een onderwijsplatform voor ontwikkelaars. Eerder was hij Lead Developer Advocate bij Agora en docent bij Zero To Mastery.



