

Genereer audio realtime
In deze handleiding lees je hoe je realtime audio genereert via een WebSocket-verbinding.
WebSocket-streaming is een methode om gegevens te verzenden en te ontvangen via één enkele, langdurige verbinding. Deze methode is handig voor realtime-applicaties waarbij je audiogegevens moet streamen zodra deze beschikbaar zijn.
Als je snel de latency (tijd tot de eerste byte) van een WebSocket-verbinding met de ElevenLabs Text to Speech-API wilt testen, kun je elevenlabs-latency installeren via npm en de instructies hier volgen.
WebSockets zijn beschikbaar voor Text to Speech en het Agents Platform. Deze handleiding behandelt de
Text to Speech-WebSocket (/v1/text-to-speech/{voice_id}/stream-input). Dat endpoint ondersteunt
de modellen eleven_v3 en eleven_v4 niet. Zie voor Eleven v3- of Eleven v4-dialoog via een
WebSocket Realtime Text to Dialogue
en Text to Speech- en Text to Dialogue-
WebSockets.
Vereisten
- Een ElevenLabs-account met een API-sleutel (zo vind je je API-sleutel).
- Python of Node.js (of een andere JavaScript-runtime) geïnstalleerd op je apparaat
Instellen
Installeer de vereiste afhankelijkheden:
Maak vervolgens een .env-bestand in je projectmap en voeg je API-sleutel toe:
De WebSocket-verbinding starten
Kies een stem uit de Voice Library en het Text to Speech-model dat je wilt gebruiken. Start vervolgens een WebSocket-verbinding met de Text to Speech-API.
De invoertekst versturen
Stel eerst de steminstellingen in zodra de WebSocket-verbinding is geopend. Stuur daarna het tekstbericht naar de API.
De audio opslaan in een bestand
Lees het binnenkomende bericht van de WebSocket-verbinding en schrijf de audiochunks naar een lokaal bestand.
Het script uitvoeren
Voer het script uit met de volgende opdracht in je terminal. Een mp3-audiobestand wordt opgeslagen in de map output.
Geavanceerde configuratie
WebSockets bieden enkele geavanceerde instellingen waarmee je je realtime-audiogeneratie nauwkeurig kunt afstemmen.
Buffering
Bij het genereren van realtime-audio moet je rekening houden met twee belangrijke begrippen: Time To First Byte (TTFB) en buffering. Om audio van hoge kwaliteit te produceren en context af te leiden, heeft het model een bepaalde hoeveelheid invoertekst nodig. Hoe meer tekst er via een WebSocket-verbinding wordt verzonden, hoe beter de audiokwaliteit. Als deze drempel niet wordt bereikt, voegt het model de tekst toe aan een buffer en genereert het audio zodra de buffer vol is.
Wat latency betreft, is TTFB de tijd die nodig is om de eerste audiobyte naar de client te sturen. Dit is belangrijk omdat het de waargenomen latency van de audio beïnvloedt. Daarom wil je mogelijk de buffergrootte bepalen om een balans te vinden tussen kwaliteit en latency.
Hiervoor kun je de parameter chunk_length_schedule gebruiken wanneer je de WebSocket-verbinding initialiseert of tekst verstuurt. Deze parameter is een array met gehele getallen die het aantal tekens aangeven dat naar het model wordt gestuurd voordat audio wordt gegenereerd. Als je chunk_length_schedule bijvoorbeeld instelt op [120, 160, 250, 290], genereert het model audio nadat respectievelijk 120, 160, 250 en 290 tekens zijn verzonden.
Hier zie je hoe dit werkt met de standaardinstellingen voor chunk_length_schedule:
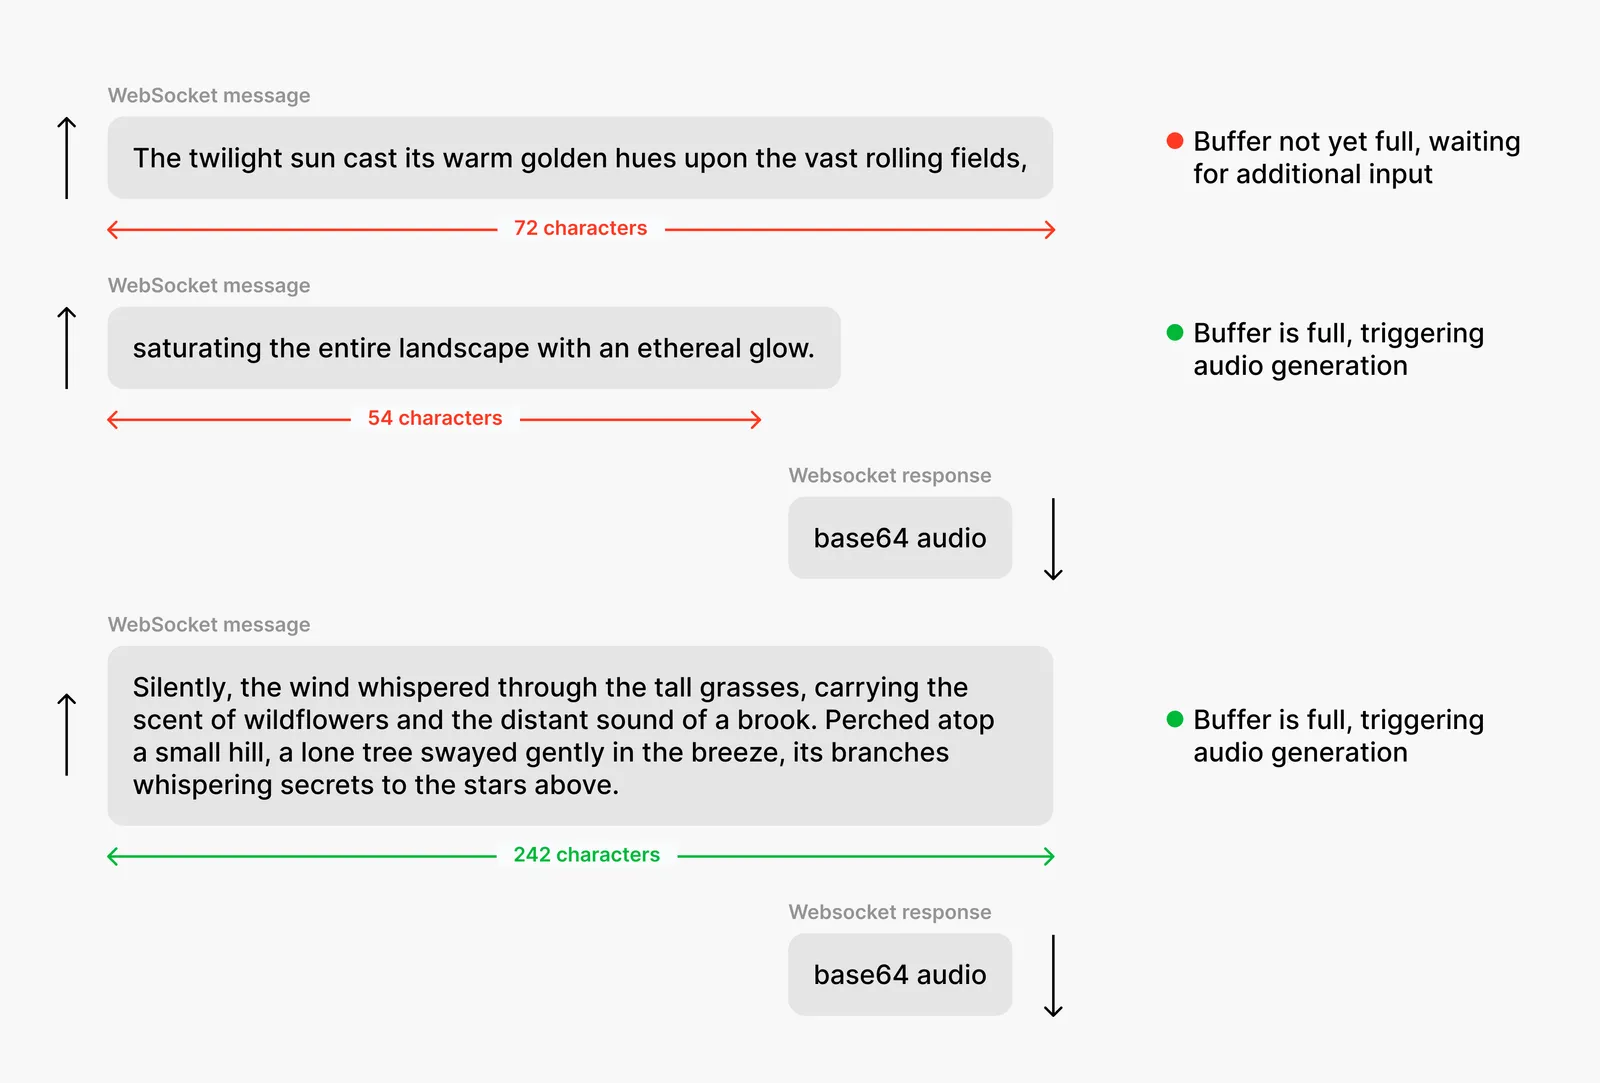
In het bovenstaande diagram wordt audio pas gegenereerd nadat het tweede bericht naar de server is gestuurd. Dit komt doordat het eerste bericht onder de drempel van 120 tekens blijft, terwijl het tweede bericht het totale aantal tekens boven die drempel brengt. Het derde bericht komt boven de drempel van 160 tekens, dus de audio wordt meteen gegenereerd en naar de client teruggestuurd.
Je kunt een aangepaste waarde voor chunk_length_schedule opgeven wanneer je de WebSocket-verbinding initialiseert of tekst verstuurt.
Als je audio onmiddellijk wilt laten terugsturen, kun je flush: true gebruiken om de buffer te wissen en alle gebufferde tekst te laten genereren. Dit kan bijvoorbeeld handig zijn wanneer je het einde van een document hebt bereikt en audio wilt genereren voor het laatste gedeelte.
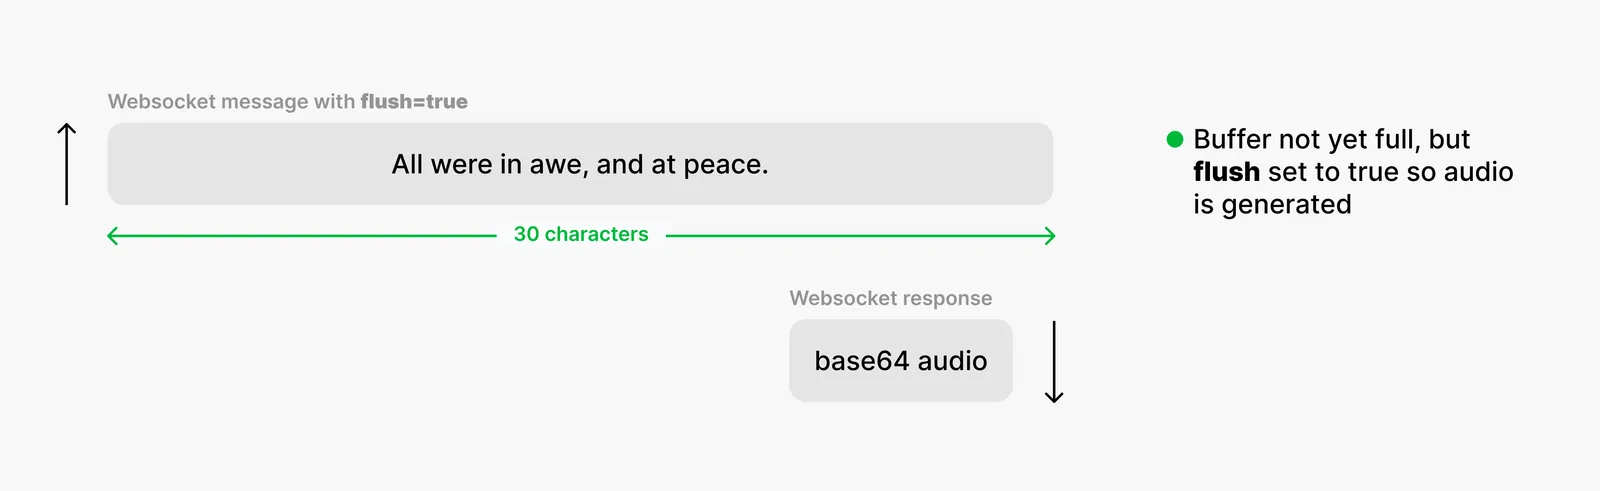
Je kunt dit per bericht instellen door flush: true in het bericht op te nemen.
Daarnaast zorgt het sluiten van de WebSocket er automatisch voor dat alle gebufferde tekst wordt gegenereerd.
Steminstellingen
Wanneer je de WebSocket-verbinding initialiseert, kun je de steminstellingen voor de volgende generaties opgeven. Hiermee bepaal je de snelheid, stabiliteit en andere stemkenmerken van de gegenereerde audio.
Je kunt dit per bericht overschrijven door andere voice_settings in het bericht op te geven.
Uitspraakwoordenboeken
Je kunt uitspraakwoordenboeken gebruiken om de uitspraak van specifieke woorden of zinnen te bepalen. Dit kan handig zijn om ervoor te zorgen dat bepaalde woorden correct worden uitgesproken of om nadruk op bepaalde woorden of zinnen te leggen.
In tegenstelling tot voice_settings en generation_config moet je uitspraakwoordenboeken opgeven in het bericht “Initialize Connection”. Zie de API-referentie voor meer informatie.
Wanneer je fonemen gebaseerde uitspraakwoordenboeken met WebSockets gebruikt, moet je enable_ssml_parsing=true als queryparameter aan de WebSocket-URI toevoegen. Bijvoorbeeld:
Best practice
- We raden aan de standaardinstelling voor
chunk_length_scheduleingeneration_configte gebruiken. - Bij het ontwikkelen van een realtime-applicatie voor een conversationele agent raden we aan
flush: truesamen met de tekst aan het einde van een gespreksbeurt te gebruiken, zodat audio tijdig wordt gegenereerd. - Als de standaardinstelling geen optimale latency biedt voor je use case, kun je
chunk_length_scheduleaanpassen. Houd er wel rekening mee dat het verminderen van latency met deze aanpassing ten koste kan gaan van de kwaliteit.
Tips
- De WebSocket-verbinding wordt na 20 seconden inactiviteit automatisch gesloten. Om de verbinding open te houden, kun je één spatieteken
" "versturen. Deze string moet een spatie bevatten, want een volledig lege string,"", sluit de WebSocket. - Stuur een lege string om de WebSocket-verbinding te sluiten nadat je het laatste tekstbericht hebt verstuurd.
- Je kunt
alignmentgebruiken om tijdstempels op woordniveau voor elk woord in de tekst op te halen. Dit kan handig zijn om de audio met de tekst in een video uit te lijnen of voor andere toepassingen die nauwkeurige timing vereisen. Zie de API-referentie voor meer informatie.