Wat zijn Audio Tags? De complete gids voor emotionele TTS
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
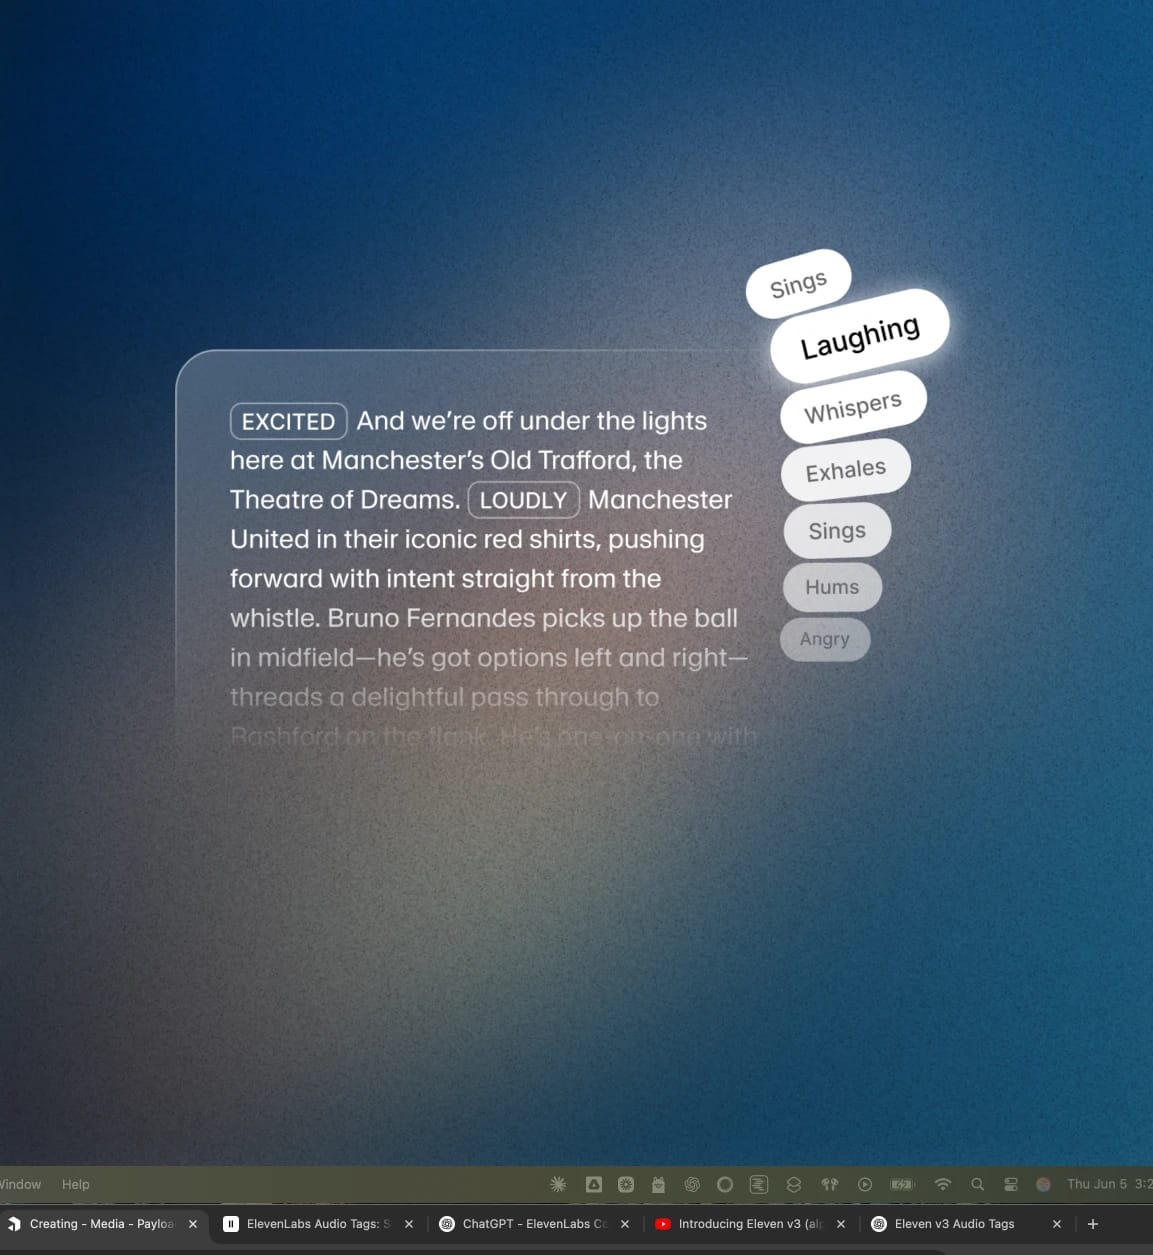
Audio Tags zijn aanwijzingen in vierkante haken, zoals [laughs], [gasps], [excited] en [worried], die Eleven v3 en Eleven v4 lezen als regieaanwijzingen in plaats van woorden om uit te spreken. Wanneer je een script schrijft voor een Text to Speech-model, geven deze Audio Tags je nauwkeurige controle over de emotionele voordracht van je tekst.
Eleven v3 werd in maart 2026 publiek beschikbaar. Vóór v3 betekende een specifieke emotionele voordracht uit een Text to Speech-model krijgen: content opnieuw genereren en hopen op het beste. Audio Tags nemen dat giswerk weg en geven je volledige controle over een emotionele Text to Speech-voordracht. Eleven v4 gaat nog verder en geeft je nauwkeurige emotionele controle.
Deze gids behandelt wat Audio Tags zijn, hoe ze werken, welke tagcategorieën er beschikbaar zijn en hoe ze zich verhouden tot SSML (Speech Synthesis Markup Language). We bespreken ook veelvoorkomende toepassingen, elk met een link naar een eigen uitgebreide gids.
Samenvatting
- Audio Tags zijn aanwijzingen in vierkante haken, zoals [shouts] of [excited], die emotie, tempo, voordracht en toon binnen TTS in Eleven v3 en Eleven v4 sturen.
- Eleven v3 en Eleven v4 ondersteunen geen SSML, maar vervangen het door Audio Tags voor een natuurlijkere schrijfervaring.
- Tags omvatten verschillende categorieën, zoals emoties, voordracht en tempo, menselijke reacties, accenten en geluidseffecten.
- Met interpunctie en hoofdletters in je tekst kun je het tempo van een AI-stemvoordracht bepalen.
- Je kunt Audio Tags in ElevenLabs gebruiken via de UI of de API.
Hoe werken Audio Tags?
Audio Tags staan inline in je transcript en worden tussen vierkante haken geplaatst. Wanneer je wilt dat de voordracht verandert, bijvoorbeeld van normaal naar [worried], hoef je alleen een audiotag toe te voegen.
Je kunt ook meer dan één tag in een enkele zin gebruiken en tags combineren voor een gelaagdere voordracht, zoals [tired] Het was een lange dag… [upset] Hoeveel dagen houd ik dit nog vol?
Dankzij de architectuur achter Eleven v4 kan het model context op een dieper niveau lezen dan eerdere modellen. Daardoor kan het emotionele aanwijzingen, toonveranderingen, sprekerwisselingen en contextuele signalen volgen zonder dat je een aparte parameter of instelling nodig hebt. Vertel het model gewoon wat het moment vraagt, en het brengt de zin precies zoals je hebt gepland.
Eleven v4 kan ook dialogen met meerdere sprekers verwerken die spontaan aanvoelen, met onderbrekingen, stemmingswisselingen en het natuurlijke heen-en-weer van echte gesprekken, allemaal op basis van alleen tags en scriptstructuur.
Audio Tags versus SSML
Als je met andere TTS-systemen hebt gewerkt, ben je waarschijnlijk Speech Synthesis Markup Language tegengekomen. Platforms zoals Amazon Polly en Microsoft Azure Speech gebruiken SSML-tags zoals <break> of <emphasis> om een TTS-script extra context te geven.
Eleven v4 ondersteunt geen SSML-breaktags of de rest van de SSML-tagset. In plaats daarvan nemen Audio Tags, interpunctie en de structuur van een tekst zelf die rol over, terwijl ze nauwkeurige controle over de voordracht bieden.
Gebruik de onderstaande tabel om veelvoorkomende SSML-tags te koppelen aan het equivalent in Eleven v4.
Voor een schrijver kost [whispers] aan een zin toevoegen veel minder moeite dan een prosody-snelheid configureren.
De categorieën Audio Tags in v3: regie voeren met Audio Tags
Je kunt Audio Tags overal in je script plaatsen om de voordracht realtime vorm te geven. Je kunt ook combinaties van tags binnen een script of zelfs binnen één zin gebruiken.
Tags vallen in de volgende hoofdcategorieën.
Emoties
Met deze tags kun je de emotionele toon van de stem bepalen, of die nu somber, intens of opgewekt is. Je kunt bijvoorbeeld één of een combinatie van [sad], [angry], [happily] en [sorrowful] gebruiken.
Voordracht en tempo
Deze gaan meer over toon en voordracht. Je kunt deze tags gebruiken om het volume en de energie aan te passen voor scènes die terughoudendheid of kracht nodig hebben. Voorbeelden zijn tags zoals [whispers], [shouts] en [softly].
Menselijke reacties
Echt natuurlijke spraak bevat reacties. Je kunt deze bijvoorbeeld gebruiken om meer realisme toe te voegen door natuurlijke, ongeschreven momenten in spraak te verwerken. Tags zoals [laughs], [clears throat] en [sighs] helpen allemaal om een TTS-model menselijke emotie te laten uiten.
Andere voorbeelden van audiotagcategorieën zijn:
- Accenten en karakterstemmen: Accenttags laten de stem overgaan naar een specifieke regio of persona zonder van model te wisselen, zoals [French accent], [British accent] of [pirate voice]. Gebruik ze om van één stem een flexibele cast te maken in plaats van één vaste voordracht.
- Geluidseffecten: Tags voor geluidseffecten voegen niet-spraakaudio rechtstreeks toe aan de generatie, zoals [gunshot], [explosion] en [clapping]. Ze werken goed voor meeslepende audio, games en gedramatiseerde vertellingen waarin de scène meer dan een stem nodig heeft. Je kunt ook de ElevenCreative AI-geluidseffectgenerator gebruiken.
Hoewel tags je veel controle geven, kun je ook interpunctie gebruiken om ritme en nadruk vorm te geven. Voeg bijvoorbeeld een ellips toe voor een natuurlijke pauze of gebruik komma's om natuurlijke ademhalingspatronen te creëren. Schrijf een woord volledig in hoofdletters om nadruk toe te voegen: “Ik wil het NU meteen.”
Wat kun je doen met Audio Tags?
Audio Tags ontsluiten de emotionele complexiteit van scripts op een intuïtieve manier. Schrijf natuurlijk en voeg tags toe terwijl je bezig bent.
Hier zie je in het kort enkele toepassingen van emotionele TTS met Audio Tags.
Situationeel bewustzijn in AI-audio
Tags zoals [whisper] of [shouting] laten Eleven v4 reageren op het moment. Van een waarschuwing verzachten tot een langgerekte pauze aanhouden voor spanning: je kunt dynamisch situationeel bewustzijn in je script opnemen.
Bekijk onze gids over situationeel bewustzijn in AI-audio voor een volledig overzicht.
Regie voeren over karaktervertolking in spraak
Bij het opbouwen van een script met meerdere personages wil je duidelijk laten zien waarin elke stem verschilt. Van spelen met hun persoonlijkheid met [sarcastically] tot bepalen hoe ze spreken met [British accent]: met onze TTS-engine kun je een volledig scala aan emoties vastleggen.
Lees meer over regie voeren over karaktervertolking in AI-spraak.
Emotionele context uitdrukken in spraak
Met Audio Tags kun je de emotionele voordracht van een zin vormgeven naarmate die vordert. Je kunt emoties gedurende een speech opbouwen en een hoogtepunt bereiken op het moment waarop je je personage op zijn of haar best voor je ziet. Tags zoals [awe], [booming] en [big laugh] helpen je een volledig emotioneel bereik in je AI-stemvoordracht op te bouwen.
Lees meer over het gebruik van emotionele context in AI-spraak.
Dialogen met meerdere personages tot leven brengen
Wanneer je dialogen met meerdere personages opbouwt, kun je elke zin met een audiotag beginnen om rijke gesprekken tussen personages te creëren.
Neem bijvoorbeeld het volgende: Tom: [coughing] [beginning to speak] sorry, ik ben vandaag een beetje ziek— Emma: [interrupting] —Ziek? Je weet toch hoe erg ik hoesten haat, Tom! Tom: [surprised] Het is maar een kuchje, niets ernstigs. Hoe zou jij je voelen als— Emma: [overlapping] [annoyed] —Ik denk dat je naar huis moet gaan.
Ontdek wat je nog meer kunt doen met dialogen met meerdere personages in Eleven v3.
Nauwkeurige controle over de voordracht van AI-spraak
Met Eleven v3 en Eleven v4 kun je het tempo van spraak regelen met Audio Tags of via interpunctie. Tags zoals [pause], [rushed] of [drawn out] laten je de zin actief en nauwkeurig vormgeven. Je kunt ook ellipsen, punten en uitroeptekens toevoegen om emotie op een natuurlijke manier in je TTS-voordracht op te bouwen.
We hebben een uitgebreide gids geschreven over nauwkeurige controle over de voordracht in Eleven v3.
Emotionele TTS is beschikbaar via de API
Audio Tags werken via de Text to Speech API op dezelfde manier als binnen de ElevenLabs-UI. Schrijf de tag inline bij de scripttekst en de API retourneert de getagde voordracht in de gegenereerde audio, van luisterboekworkflows tot voice-overs voor advertenties.
Lees meer over Eleven v4 of neem contact op met sales om vandaag aan de slag te gaan.
Veelgestelde vragen over Audio Tags en emotionele TTS

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.