
SSML-tags uitgelegd: pauzes, uitspraak en tempo regelen in Text to Speech
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
Speech Synthesis Markup Language (SSML) is een XML-gebaseerde markuptaal die tekst in tags plaatst om een Text to Speech-model te vertellen hoe het die moet uitspreken, waaronder waar het moet pauzeren, hoe het een woord moet uitspreken en welke zin het moet benadrukken.
Deze bedieningslaag zit achter veel van de AI-spraak die je al hoort. Zowel een interactive voice response-systeem (IVR) dat een bevestigingsnummer voorleest als een AI-luisterboek-verteller die aan het eind van een hoofdstuk pauzeert, maken er in een bepaalde vorm gebruik van. Als je AI-gegenereerde spraak hebt aangepast, ben je SSML waarschijnlijk al tegengekomen.
SSML maakt al meer dan twee decennia deel uit van TTS-technologie en is nog steeds een belangrijk onderdeel van de manier waarop veel aanbieders TTS leveren. Deze gids legt uit wat SSML is en precies waar het binnen de modellen van ElevenLabs van toepassing is, samen met het verbeterde Audio Tag-systeem dat Eleven v3 en Eleven v4 gebruiken voor toonaangevende, natuurlijk klinkende Text to Speech.
Bekijk Eleven v4 in actie met Audio Tags
Ontdek Eleven v4Samenvatting
- SSML is een op W3C gebaseerde markuptaal waarmee je vocale pauzes, nadruk, uitspraak en tempo in gesynthetiseerde spraak regelt.
- ElevenLabs-modellen ondersteunen, behalve Eleven v3 en Eleven v4, de SSML-tag <break> voor pauzes tot 3 seconden.
- Eleven Flash v2 en Eleven Turbo v2 ondersteunen de tag <phoneme> voor aangepaste Engelse uitspraak.
- Eleven v3 en Eleven v4 ondersteunen SSML helemaal niet. In plaats daarvan gebruiken ze Audio Tags voor instructies in natuurlijke taal tussen haakjes, zoals [whispering] en [sighs], om de stroom van gesynthetiseerde spraak te regelen.
- De WebSocket API regelt het parsen van SSML via de parameter enable_ssml_parsing en verstuurt SSML-tags als volledige berichten om extra latentie te voorkomen.
- Tags zoals <prosody>, <say-as>, <sub>, <lang>, <voice> en <audio> worden niet ondersteund door ElevenLabs-modellen, maar hebben allemaal een alternatief: steminstellingen, tekstnormalisatie, uitspraakwoordenboeken, meertalige modellen, afzonderlijke stemmen en geluidseffecten.
Wat is SSML?
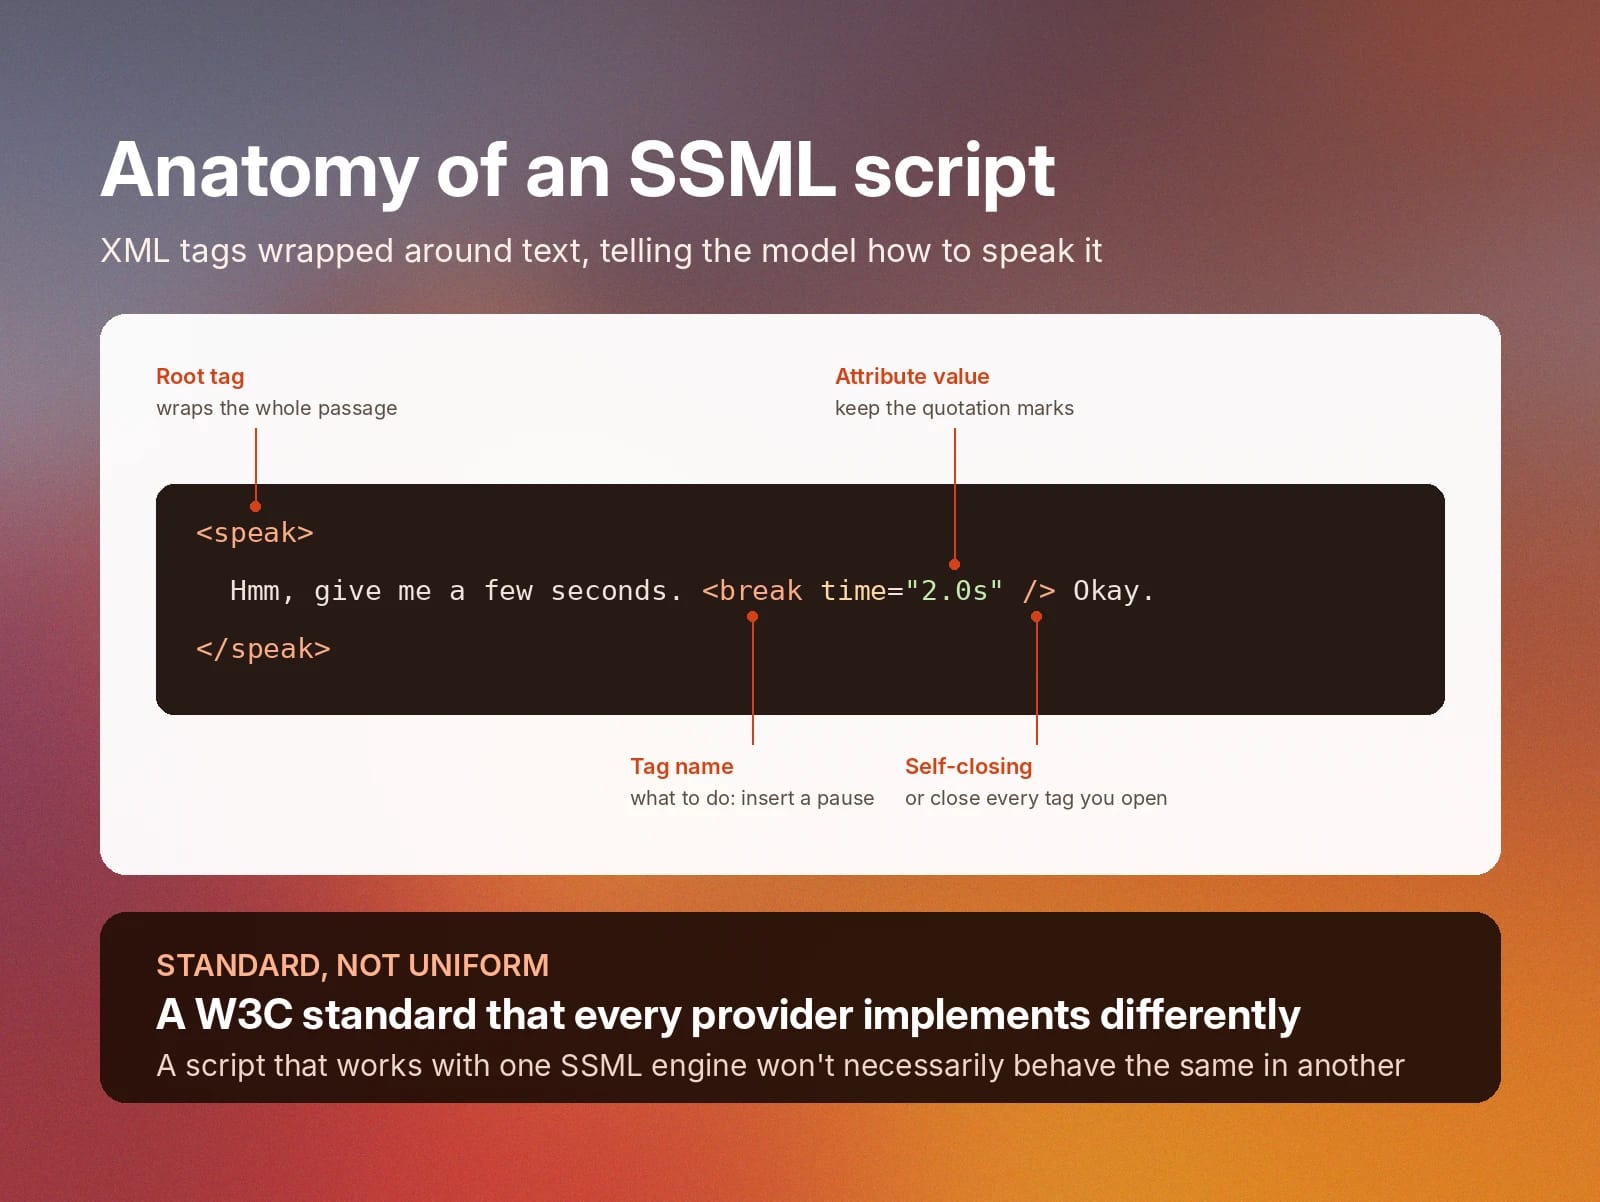
SSML is een markuptaal waarmee je geschreven tekst kunt annoteren met instructies voor hoe een synthesemachine die moet uitspreken. Het World Wide Web Consortium (W3C) ontwikkelde het als standaard om verder te gaan dan gewone Text to Speech-modellen. SSML biedt expliciete, machineleesbare aanwijzingen voor de uitspraak van een passage, in plaats van te vertrouwen op interpretatiemodellen voor platte tekst.
SSML is geen unieke markup die is voorbehouden aan één aanbieder. Amazon Polly en Microsoft Azure Speech gebruiken beide SSML-tags, zoals <break> en <emphasis>, als hun belangrijkste bedieningsmechanisme. De meeste cloudplatforms voor Text to Speech accepteren een versie van de standaard. SSML was al de standaardmethode om spraak te annoteren lang voordat generatieve stemmodellen bestonden.
SSML blijft een fundamentele standaard, terwijl nieuwere, modelspecifieke bedieningselementen zich naast moderne generatieve stemtechnologieën ontwikkelen. Dankzij deze leverancierneutrale specificatie achter SSML kunnen aanbieders algemene basistags implementeren. Aanbieders kunnen daar vervolgens hun eigen uitbreidingen en beperkingen aan toevoegen.
Veelgebruikte SSML-tags voor betere intonatie en wat ze doen
SSML-implementaties delen een kernset tags waar de meeste mensen naar zoeken wanneer ze gesynthetiseerde spraak willen regelen.
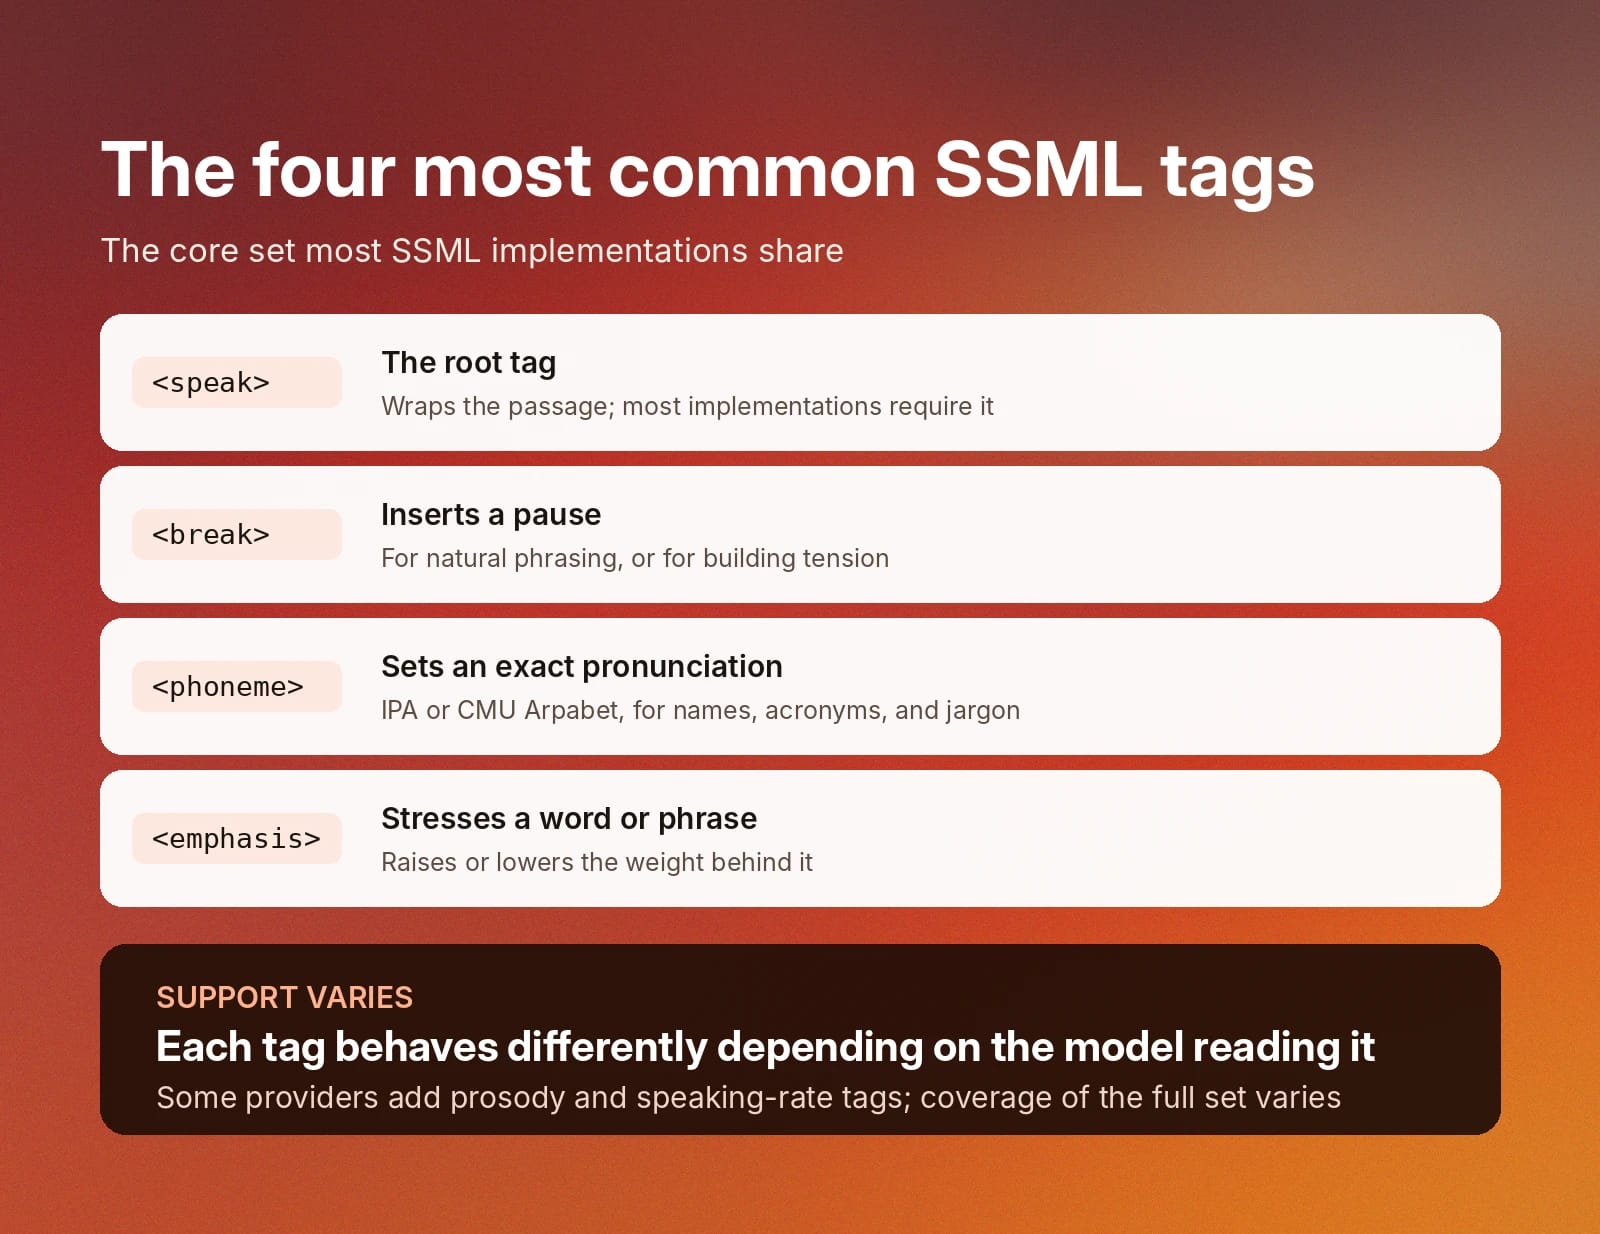
Deze veelgebruikte SSML-tags zijn:
- <speak>: Dit is de hoofdtag die de volledige passage omvat. De meeste implementaties vereisen deze om de ingesloten content als SSML te herkennen.
- <break>: Voegt een pauze van een opgegeven duur toe. Dit is handig voor natuurlijke frasering tussen bijzinnen of zinnen, of om spanning op te bouwen in een tekst.
- <phoneme>: Specificeert de exacte uitspraak van een woord met een fonetisch alfabet zoals IPA of CMU Arpabet. Dit is handig voor afkortingen, namen of technische termen.
- <emphasis>: Benadrukt een woord of zin, zoals een spreker de betekenis ervan van nature meer of minder gewicht zou geven.
Elk van deze vier tags gedraagt zich anders, afhankelijk van het TTS-model dat de tag leest. Sommige aanbieders ondersteunen extra tags voor prosodie of spreeksnelheid. Een script dat voor één TTS-aanbieder is geschreven, gedraagt zich niet hetzelfde bij een andere, zelfs als beide SSML-ondersteuning claimen, omdat de dekking van de volledige tagset verschilt.
Wat het meest verschilt, is welke tags een bepaald Text to Speech-model daadwerkelijk verwerkt. Daarin wordt de implementatie van ElevenLabs specifiek.
SSML gebruiken met ElevenLabs
De SSML-ondersteuning van ElevenLabs is niet volledig uniform. Het hangt af van welk model je selecteert om audio te genereren. De tag <break> is het breedst ondersteunde element, en <phoneme> is beschikbaar voor een beperktere set modellen.
Oudere TTS-modellen van ElevenLabs, zoals Multilingual v2, ondersteunen de tag <break> voor pauzes tot drie seconden. Zo kan een AI-agent zeggen: "Wacht even, laat me nadenken," en vervolgens <break time="2.0s" /> gebruiken om een hoorbare pauze te creëren voordat die doorgaat met: "Goed, ik weet hoe ik kan helpen." Het is de meest gebruikte tag in veel workflows, omdat deze een natuurlijkere gespreksstijl helpt simuleren.
Bij het gebruik van SSML-tags kun je het beste slechts een klein aantal tegelijk gebruiken. Veel tags in één zin of alinea kunnen ervoor zorgen dat een model onverwacht van snelheid verandert of verschillende audioartefacten produceert. Verschillende stemmen gaan ook anders om met pauzes, vooral stemmen die zijn getraind op samples met stopwoordjes zoals "uh" of "um."
SSML in de praktijk met ElevenLabs
De ElevenLabs-modellen Flash v2 en Turbo v2 gaan nog een stap verder en ondersteunen ook de tag <phoneme> voor aangepaste uitspraken, uitsluitend in het Engels. Daardoor is de phoneme-tag nuttig om te corrigeren hoe een model een naam, afkorting, technische term of andere zakelijke formulering uitspreekt. Dit geldt zolang het script op een van die twee modellen draait.
Eleven v3 en Eleven v4 wijken daarentegen volledig van dit patroon af. Ze gebruiken Audio Tags voor controle over de voordracht. Daarnaast introduceert Eleven v4 native inline-ondersteuning voor IPA, waarmee IPA-symbolen tussen schuine strepen rechtstreeks in je tekst kunnen worden gelezen. Hieronder behandelen we wat de break-tag en bedieningselementen voor voordracht vervangt.
Bekijk voor het volledige overzicht van de bedieningselementen voor Text to Speech van ElevenLabs, waaronder uitspraakwoordenboeken en tekstnormalisatie, de gids met best practices.
SSML-codevoorbeelden met ElevenLabs
De onderstaande voorbeelden tonen SSML in een script en in een API-aanroep. Onthoud dat <break> werkt op elk model behalve Eleven v4 en Eleven v3, en dat <phoneme> alleen werkt op Flash v2 en Turbo v2 (alleen Engels).
SSML implementeren voor stembediening om een pauze toe te voegen
Plaats de tekst en de tag in een <speak>-blok en behoud de aanhalingstekens rond de attribuutwaarde:
Vind meer informatie over pauzes en SSML-phoneme-tags via ElevenAPI.
Corrigeer een uitspraak met <phoneme>
Gebruik IPA of CMU Arpabet om precies aan te geven hoe een woord moet klinken. Hier wordt de naam "Siobhan" met IPA aangestuurd, terwijl "Madison" met CMU Arpabet wordt uitgeschreven:
Spraak genereren met SSML in Python
Deze aanroep stuurt een script met een break-tag naar een model dat deze ondersteunt:
Spraak genereren met SSML in JavaScript
Hieronder staat een vergelijkbaar voorbeeld voor het genereren van spraak met SSML, maar dan geschreven in JavaScript.
SSML en de WebSocket API: SSML gebruiken met TTS-API's
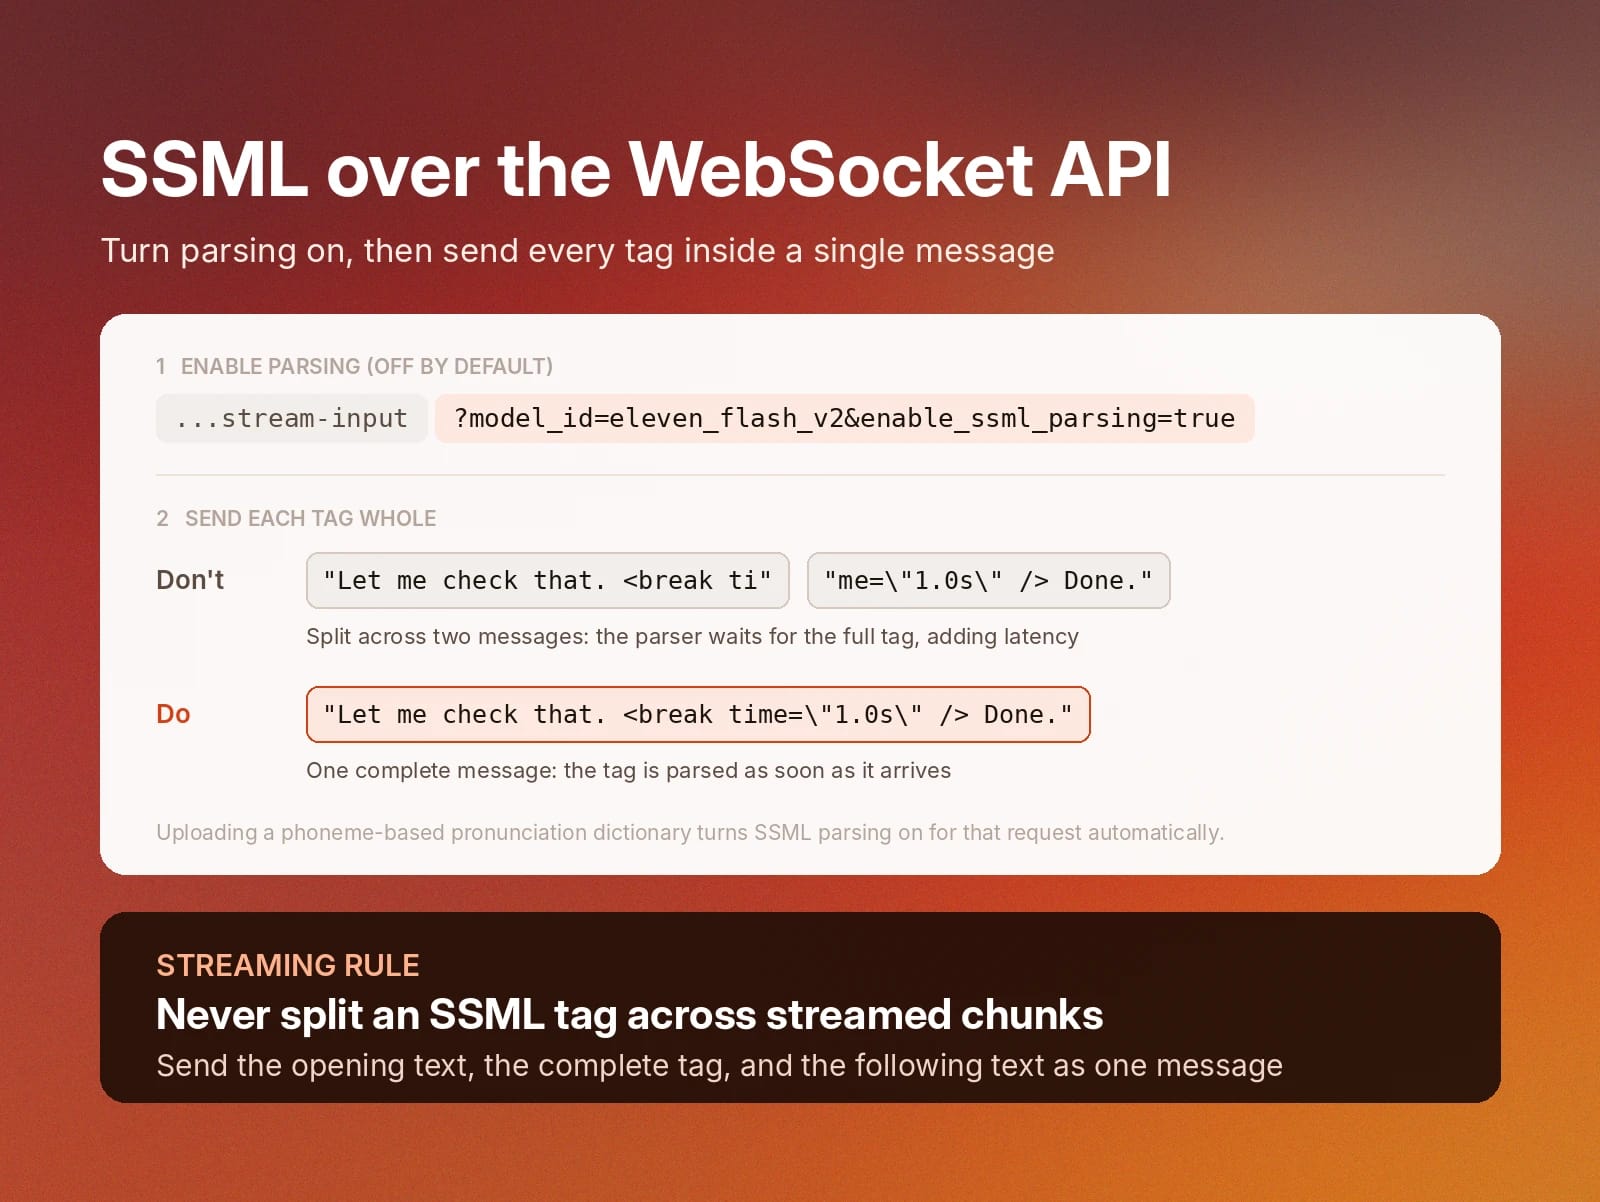
Voor audio streamen via de WebSocket API van ElevenLabs in plaats van een standaard HTTP-request moet je SSML-parsing expliciet inschakelen. Dit staat standaard uit en kun je regelen met de parameter enable_ssml_parsing.
Voor het beste resultaat raden we aan elke SSML-tag als volledig zelfstandig bericht te verzenden in plaats van deze over meerdere gestreamde chunks te verdelen. Een tag halverwege een bericht splitsen voegt latentie toe, omdat de parser de volledige tag nodig heeft voordat deze ernaar kan handelen.
Een op phonemen gebaseerd uitspraakwoordenboek uploaden schakelt SSML-parsing automatisch in voor de request, zelfs als de parameter enable_ssml_parsing niet specifiek is ingesteld. Bekijk voor alle parameterdetails en berichtopmaak voor de WebSocket API deze documentatiegids over audio genereren in realtime.
In het onderstaande voorbeeld wordt SSML-parsing ingeschakeld in de verbindings-URL en wordt de volledige break-tag in één bericht verzonden:
SSML-tags die ElevenLabs niet ondersteunt en wat je in plaats daarvan gebruikt
Door over te stappen op het Audio Tag-systeem geven de Text to Speech-modellen van ElevenLabs gebruikers meer flexibiliteit en gedetailleerde controle over hun audio-output. Audio Tags worden bovendien volledig in natuurlijke taal geschreven, waardoor je ze heel eenvoudig in je scripts kunt opnemen.
Als je met een eerder ElevenLabs-model werkt, kan het nuttig zijn om te weten welke SSML-tags worden ondersteund. Door het grote aantal voorkeursalternatieven verwerken vroege ElevenLabs-modellen nu alleen <break> en <phoneme>; de overige SSML-tags worden op andere manieren afgedekt.
Andere SSML-tags die je misschien kent uit de W3C-specificatie, worden niet als markup gelezen en vereisen daarom elk een andere aanpak. Dit kun je bij ElevenLabs gebruiken in plaats van andere SSML-tags:
SSML-tag
Wat deze doet
Gebruik in plaats daarvan
<prosody>
Stelt toonhoogte, spreeksnelheid en volume in
De steminstellingen voor snelheid en stabiliteit. Op Eleven v3 en Eleven v4: Audio Tags voor voordracht, zoals [slowly] of [rushed]
<emphasis>
Benadrukt een woord of zin
Hoofdletters of interpunctie voor nadruk. Op Eleven v3 en Eleven v4: tags zoals [shouts]
<say-as>
Regelt hoe getallen, datums en afkortingen worden gelezen
Tekstnormalisatie, de waarde voluit schrijven of een regel in een uitspraakwoordenboek
<sub>
Vervangt de gesproken vorm van een geschreven woord
Een aliasregel in een uitspraakwoordenboek
<lang>
Wisselt de taal voor een zin
Een meertalig model, met de zin geschreven in de doeltaal
<voice>
Wisselt halverwege het script van spreker
Een afzonderlijke generatie per stem, of een dialoog met meerdere sprekers op Eleven v3 en Eleven v4
<audio>
Voegt een opgenomen audiobestand of geluid in
Audio Tags voor geluidseffecten op Eleven v3 en v4, de tool voor geluidseffecten van ElevenLabs, of audio mixen na generatie
Prosodie: toonhoogte, spreeksnelheid en volume met SSML
De tag <prosody> van SSML past de toonhoogte, spreeksnelheid en het volume aan voor een stuk tekst. Op eerdere ElevenLabs-modellen regel je het tempo via de steminstelling voor snelheid en de expressiviteit via de instelling voor stabiliteit. Beide gelden voor de hele generatie en niet voor één enkele zin.
Om het tempo binnen een script te veranderen, splits je de tekst op in afzonderlijke generaties of voeg je <break>-tags toe tussen zinnen. Gebruik op Eleven v3 en v4 de Audio Tags uit de bovenstaande tabel, zoals [slowly], [rushed] en [whispers], rechtstreeks in de regel.
Uitspraak: <phoneme>, <say-as> en <sub> met SSML
ElevenLabs biedt je drie manieren om de uitspraak in je TTS-output te regelen.
Dit zijn de belangrijkste methoden:
- Gebruik <phoneme> voor een eenmalige correctie op Flash v2 of Turbo v2, zoals in het bovenstaande voorbeeld.
- Gebruik een uitspraakwoordenboek voor termen die in veel scripts terugkomen. Een woordenboek kan phoneme-regels en aliasregels bevatten die zich gedragen als <sub>, bijvoorbeeld door "UN" toe te wijzen aan "United Nations".
- Gebruik voor wat <say-as> afhandelt, zoals getallen, datums, valuta en telefoonnummers, tekstnormalisatie. Die zet geschreven waarden om in gesproken woorden. Wanneer een waarde op precies één manier moet worden gelezen, zoals een bevestigingsnummer, schrijf je deze voluit of zet je spaties tussen de cijfers in het script.
Taal en landinstelling
De tag <lang> van SSML markeert een zin als behorend tot een andere taal. De TTS-modellen van ElevenLabs lezen deze tag niet. Kies in plaats daarvan een meertalig model en schrijf de zin in de taal waarin deze moet worden uitgesproken.
Flash v2 en Turbo v2 zijn alleen Engels, dus scripts waarin talen worden gemengd hebben een meertalig model nodig, zoals Multilingual v2, Flash v2.5, Eleven v3 of Eleven v4. Eleven v4 en v3 ondersteunen ook accenttags zoals [French accent] en IPA-transcriptie in meer dan 70 talen.
Audio en geluidseffecten
De tag <audio> van SSML speelt een opgenomen clip af binnen een gesproken antwoord. Dit is een SSML-tag die ElevenLabs niet ondersteunt, omdat onze TTS-modellen nieuwe geluidseffecten kunnen genereren op basis van je prompts in natuurlijke taal.
Om geluid in de spraak zelf toe te voegen, schrijf je gewoon de tag voor het geluidseffect, zoals [applause] of [door slamming], en zie je hoe Eleven v4 en Eleven v3 dit tot leven brengen. Voor langer of gedetailleerder sounddesign kun je het geluidseffect genereren en dit afzonderlijk mixen met de stemtrack in je editor of productieworkflow.
SSML-best practices met ElevenLabs
Als je met een van de oudere TTS-modellen van ElevenLabs werkt, worden SSML-tags nog gedeeltelijk ondersteund. Onthoud dat je op elk moment kunt overstappen naar Eleven v4 om optimaal gebruik te maken van Audio Tags. Dan hoef je nooit meer de exacte formulering van een SSML-tag op te zoeken.
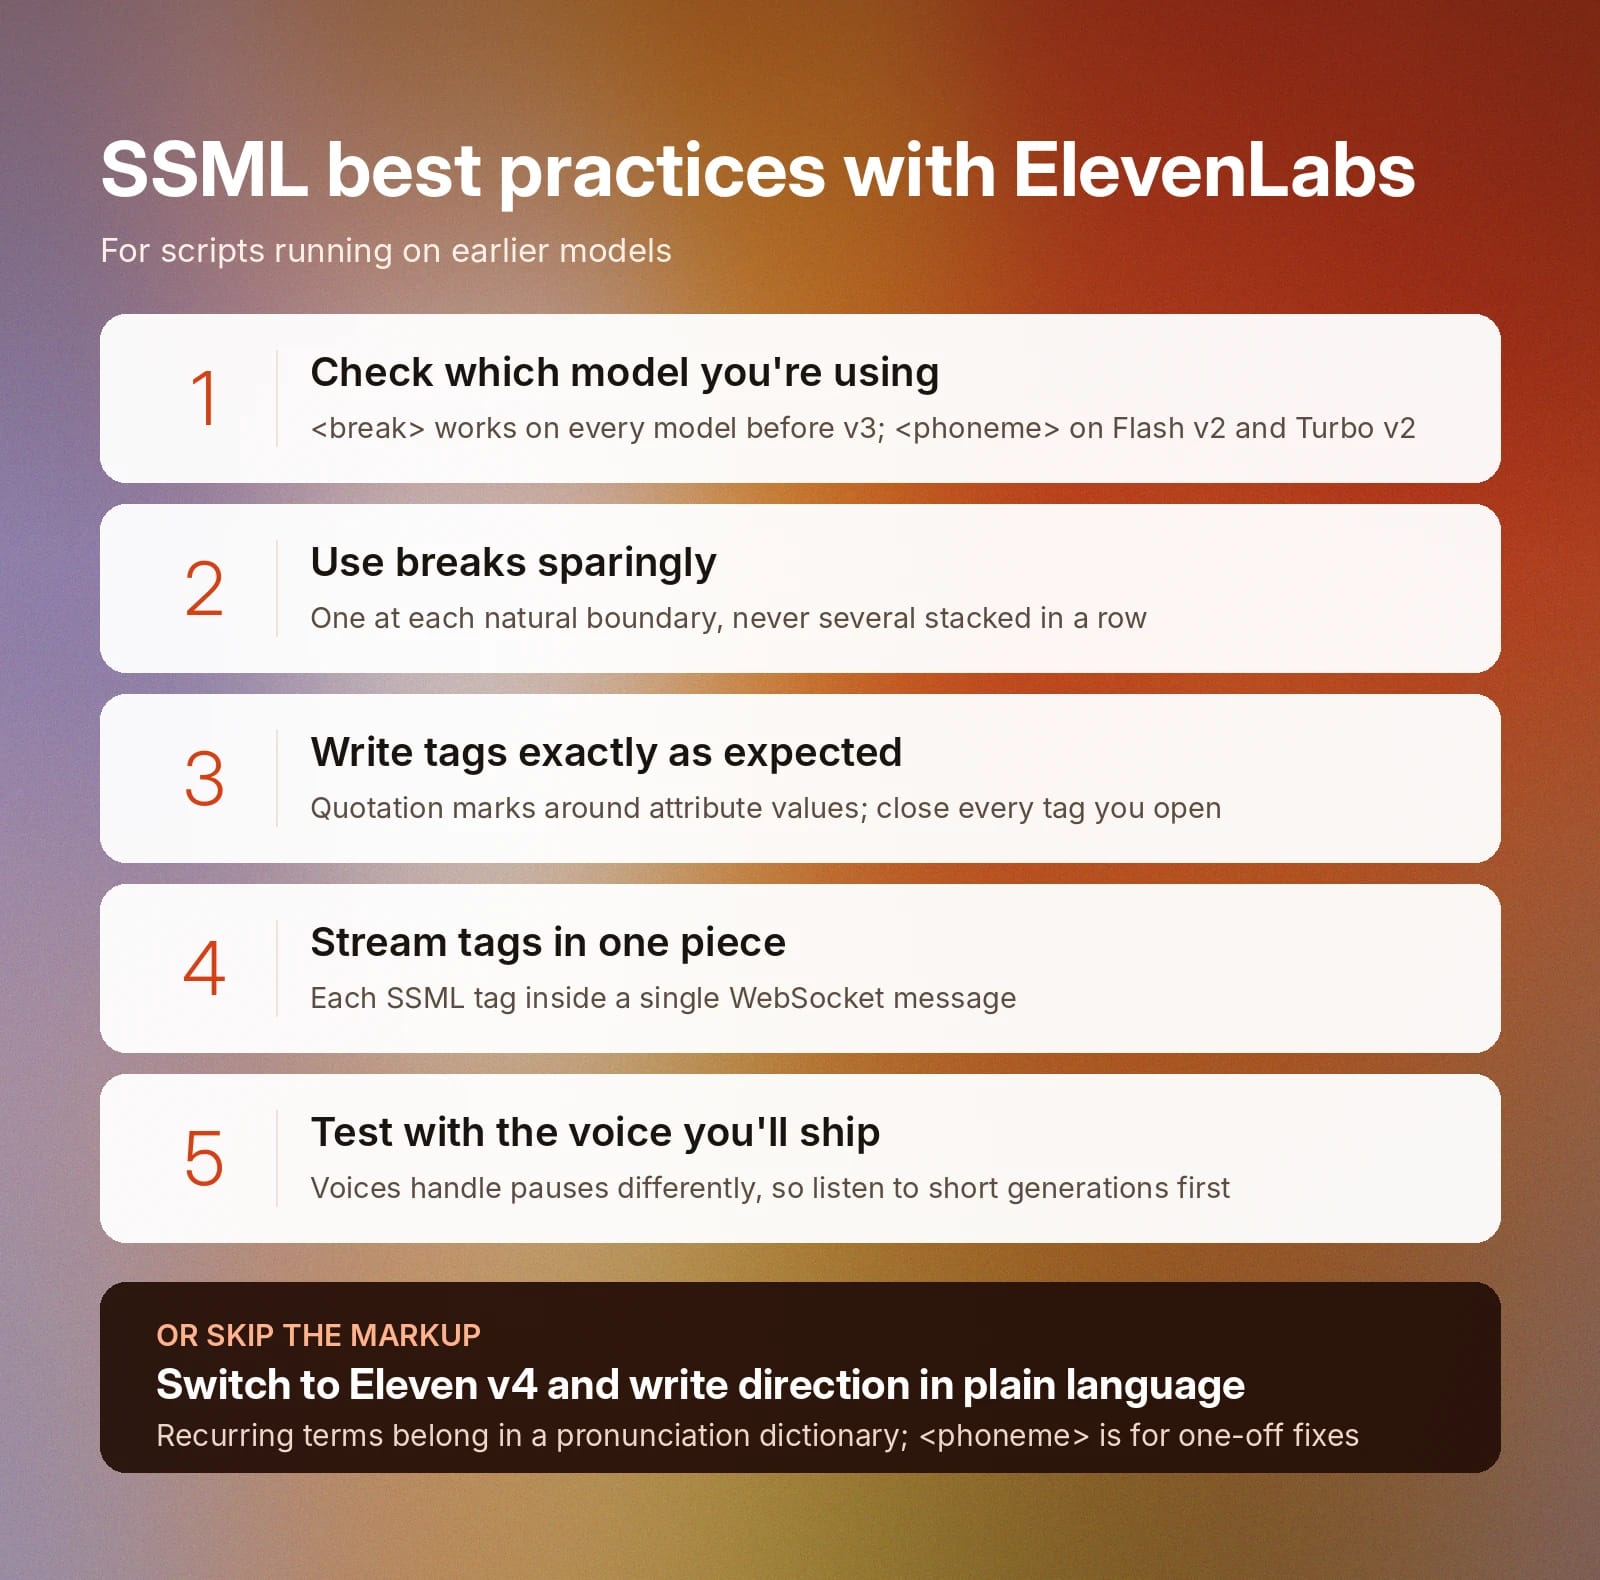
Wanneer je met SSML in ElevenLabs werkt, helpen deze tips je op weg:
- Controleer welk model je gebruikt: <break> werkt op elk model behalve Eleven v3, <phoneme> werkt alleen op Flash v2 en Turbo v2, en Audio Tags werken alleen op recentere modellen, zoals Eleven v4 en Eleven v3.
- Gebruik breaks spaarzaam: Plaats er één bij elke natuurlijke overgang, in plaats van er meerdere achter elkaar te plaatsen.
- Schrijf SSML-tags zoals verwacht: Behoud de aanhalingstekens rond attribuutwaarden, bijvoorbeeld <break time="2.0s" />, en sluit elke tag die je opent.
- Stream tags in één geheel: Verstuur elke SSML-tag in één WebSocket-bericht.
- Test met de stem die je gaat gebruiken: Stemmen gaan verschillend om met pauzes, dus luister naar korte generaties voordat je een volledig script uitvoert. ElevenLabs heeft meer dan 17.500 stemmen in onze Voice Library.
Naast deze best practices voor SSML is het verstandig om een uitspraakwoordenboek te gebruiken voor termen die vaak terugkomen. Voor eenmalige correcties is <phoneme> de beste optie.
Wat zijn de belangrijkste toepassingen van SSML?
Speech Synthesis Markup Language wordt vooral gebruikt om te regelen of te verfijnen hoe een TTS-engine een audioclip produceert. Het is een handig hulpmiddel om pauzes in te voegen, de uitspraak van een bepaald woord te verfijnen en een gevoel van prosodie toe te voegen aan AI-gegenereerde spraak.
Hier zijn enkele toepassingen waarin de SSML-standaard nuttig is:
- Interactive voice response-systemen (IVR): Handig wanneer een IVR-systeem wil pauzeren tussen een prompt en een menu, of getallen duidelijk wil voorlezen.
- Conversationele agenten: Een korte pauze toevoegen vóór een antwoord, zodat de uitwisseling natuurlijk klinkt.
- Luisterboeken en lange verhalen: Pauzeren aan het einde van hoofdstukken en tussen scènes om duidelijk te markeren waar een moment eindigt en een nieuw moment begint.
- E-learning en training: De uitspraak corrigeren van productnamen, technische termen, afkortingen en bedrijfsspecifieke termen.
- Meldingen en waarschuwingen: Regelen hoe datums, tijden en referentiecijfers worden voorgelezen.
Hoewel SSML verschillende toepassingen biedt, kun je dit allemaal bereiken met Audio Tags zonder vaak complexe SSML-tags te hoeven onthouden en in je scripts te voegen. Eleven v4 en Eleven v3 hebben het Audio Tag-systeem ontwikkeld om gebruikers volledige controle te geven over hun AI-gegenereerde spraakoutput, zonder het gedoe van SSML.
Waarom Eleven v4 Audio Tags gebruikt in plaats van SSML
Eleven v4 werkt met Audio Tags als een ander mechanisme voor het regelen van de voordracht en het verfijnen van de uitspraak. Het leest inline-instructies tussen haakjes die rechtstreeks uit gescripte tekst komen, zodat je in natuurlijke taal kunt schrijven om een bepaalde output te creëren. Deze Audio Tags omvatten een breed scala aan aanwijzingen, waaronder:
- Emoties of gevoelens, zoals [sad] of [excited]
- Voordracht en tempo, zoals [whispers] of [rushed]
- Menselijke reacties, zoals [sighs] of [laughs]
- Accenten en karakterstemmen, zoals [French accent]
- Geluidseffecten, waaronder [applause] of [door shutting]
De reden voor dit ontwerp ligt in de manier waarop dit model context in een gesprek leest. De architectuur van Eleven v4 leest context diepgaander dan eerdere modellen, waardoor het emotionele signalen, toonverschuivingen, sprekerwisselingen en contextuele aanwijzingen kan volgen zonder afzonderlijke parameters of instellingen.
SSML geeft specifieke instructies op een vast punt in de tekst, waardoor de voordracht star en houterig kan aanvoelen. SSML is een van de belangrijkste redenen waarom AI-tekst robotachtig klinkt, ondanks hoogwaardige onderliggende modellen.
Een aanwijzing zoals [whisper] geeft Eleven v4 een interpretatieve instructie die op de omringende regel wordt toegepast en wordt gevormd door de prosodie van alles eromheen.
De meeste SSML-elementen hebben een rechtstreeks v4-equivalent:
SSML-tag
Wat deze doet
Eleven v4-equivalenten
<break time="1s">
Voegt een pauze toe
[pause], een beletselteken of een regeleinde
<prosody rate="slow">
Vertraagt de spraak
[drawn out] of [slowly]
<prosody rate="fast">
Versnelt de spraak
[rushed]
<emphasis>
Benadrukt een specifiek woord
[shouts] of een woord in hoofdletters schrijven
<prosody pitch="high">
Verhoogt de toonhoogte
Emotionele tags zoals [excited]
<prosody pitch="low">
Verlaagt de toonhoogte
Emotionele tags zoals [sorrowful]
Uitspraak volgt hetzelfde vervangingspatroon. IPA is ingebouwd als native ondersteuning voor Eleven v4, met transcriptie in meer dan 90 talen. Hiermee kunnen teams de uitspraak regelen zonder de vereiste XML-tags, door transcriptie rechtstreeks tussen schuine strepen in de tekst toe te voegen.
Ga aan de slag met natuurlijk klinkende spraak op ElevenCreative
Audio Tags geven scripts de pauzes, emotie, het tempo en de stemstijl die een stemacteur rechtstreeks uit de tekst zou lezen. Eleven v4 brengt die expressiviteit naar een volledige productieworkflow, door de stemmodellen van ElevenLabs te combineren met beeld- en videomodellen, zodat een script in één workspace een voltooid audio- of videostuk wordt.
Bekijk hoe Audio Tags met Eleven v4 worden omgezet in voltooide audio, of maak een gratis account om vandaag SSML en Audio Tags met je eigen scripts te experimenteren.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.



