
- Inzichten
Wat is conversationele AI?
- Geschreven door
- Jack Limebear
LuisterenLuister naar dit artikel
Wat in 1950 begon als een gedachte-experiment, beantwoordt nu supportoproepen, kwalificeert leads, plant afspraken in en voert interviews voor bedrijven over de hele wereld.
Conversationele AI heeft een grens overschreden. Systemen die gebruikers ooit beperkten tot starre menu's en vooraf geschreven reacties, voeren nu natuurlijke gesprekken in realtime via stem en tekst, begrijpen intenties, onthouden context en voltooien taken van begin tot eind.
In deze gids behandelen we alles wat je moet weten over conversationele AI: waar het vandaan komt, hoe het onder de motorkap werkt, de onderdelen en typen die de categorie bepalen, en hoe bedrijven het vandaag in productie inzetten.
Samenvatting:
- Conversationele AI is technologie waarmee gebruikers via tekst of stem communiceren, en moderne systemen reageren in realtime met volledige context.
- Het bouwt voort op drie fundamentele disciplines: kunstmatige intelligentie, machine learning en natuurlijke taalverwerking. Moderne systemen voegen daar LLM's, spraakmodellen, retrieval en beurtwisseling aan toe.
- Het vakgebied ontwikkelde zich van ELIZA's patroonherkenning in 1966 via regelgebaseerde IVR, consumentenassistenten zoals Siri en Alexa, tot de Transformer-doorbraak die de LLM's van vandaag mogelijk maakte.
- Een moderne pipeline koppelt spraakherkenning, intentieherkenning, dialoogbeheer, reactiegeneratie en spraaksynthese tot een uitwisseling van minder dan een seconde, gecoördineerd door een model voor beurtwisseling.
- Bedrijven zetten conversationele AI in voor support, sales, incasso, planning en receptie. Platformen zoals ElevenAgents laten dezelfde agent vanuit één configuratie werken via stem en chat.
Wat is conversationele AI?
Conversationele AI is een categorie technologie waarmee gebruikers via tekst of stem kunnen communiceren om informatie te krijgen van een systeem met kunstmatige intelligentie. Traditionele manieren van communicatie tussen mens en computer waren beperkt tot vaste dialoogvertakkingen, waarbij gebruikers vooraf bepaalde opdrachten selecteerden. Een modern conversationeel AI-systeem kan menselijke spraak herkennen en categoriseren, en reageert in realtime en met volledige context op vragen.
Naarmate conversationele AI krachtiger is geworden, zijn bedrijven deze gaan toepassen in klantgerichte systemen. Met een AI-assistent is alles mogelijk: van het stroomlijnen van hotlines voor klantenservice tot het bouwen van volwaardige agents die automatisch klantgegevens invullen in een verzekeringsformulier.
Drie fundamentele disciplines vormen de basis van elk conversationeel AI-systeem:
- Kunstmatige intelligentie: Het bredere systeem dat software helpt cognitieve functies na te bootsen waarvoor normaal menselijke intelligentie of input nodig is. In een gesprek met AI omvat dit het coördineren van taken op basis van input, bepalen welke gegevens in een reactie moeten staan, het systeem naar specifieke onderdelen sturen of interne bronnen raadplegen.
- Machine learning: Met machine learning kunnen AI-systemen enorme datasets verwerken en patronen daarin herkennen. Door te leren van eerdere interacties kunnen ML-systemen voor conversationele AI zich aanpassen aan gebruikersgedrag en hun prestaties in de loop van de tijd verbeteren.
- Natuurlijke taalverwerking (NLP): Engines voor natuurlijke taalverwerking stellen computers in staat menselijke taal te begrijpen en te gebruiken. Het is een fundamentele pijler van conversationele AI omdat systemen hiermee gebruikersintentie uit input kunnen halen, een samenhangende reactie kunnen genereren, dialogen kunnen beheren en reacties in de loop van de tijd kunnen verfijnen voor betere prestaties en nauwkeurigheid.
Een modern productiesysteem bouwt veel verder op deze fundamenten. Grote taalmodellen verwerken redenering en het genereren van reacties, Speech to Text- en Text to Speech-modellen verzorgen de spraaklaag, retrievalsystemen baseren antwoorden op goedgekeurde kennis en modellen voor beurtwisseling beheren de realtime gespreksstroom, allemaal binnen guardrails. In de onderstaande secties over de werking en belangrijkste onderdelen van conversationele AI lichten we elk hiervan toe.
Het resultaat van deze drie kerntechnologieën is gestroomlijnde, samenhangende en volledig contextbewuste software voor conversationele AI waarmee gebruikers in natuurlijke taal kunnen praten. Veel systemen ondersteunen gesprekken in een groot aantal talen, waarbij ElevenAgents natuurlijk klinkende spraak beheert in meer dan 70 talen.
Geschiedenis en evolutie van conversationele AI
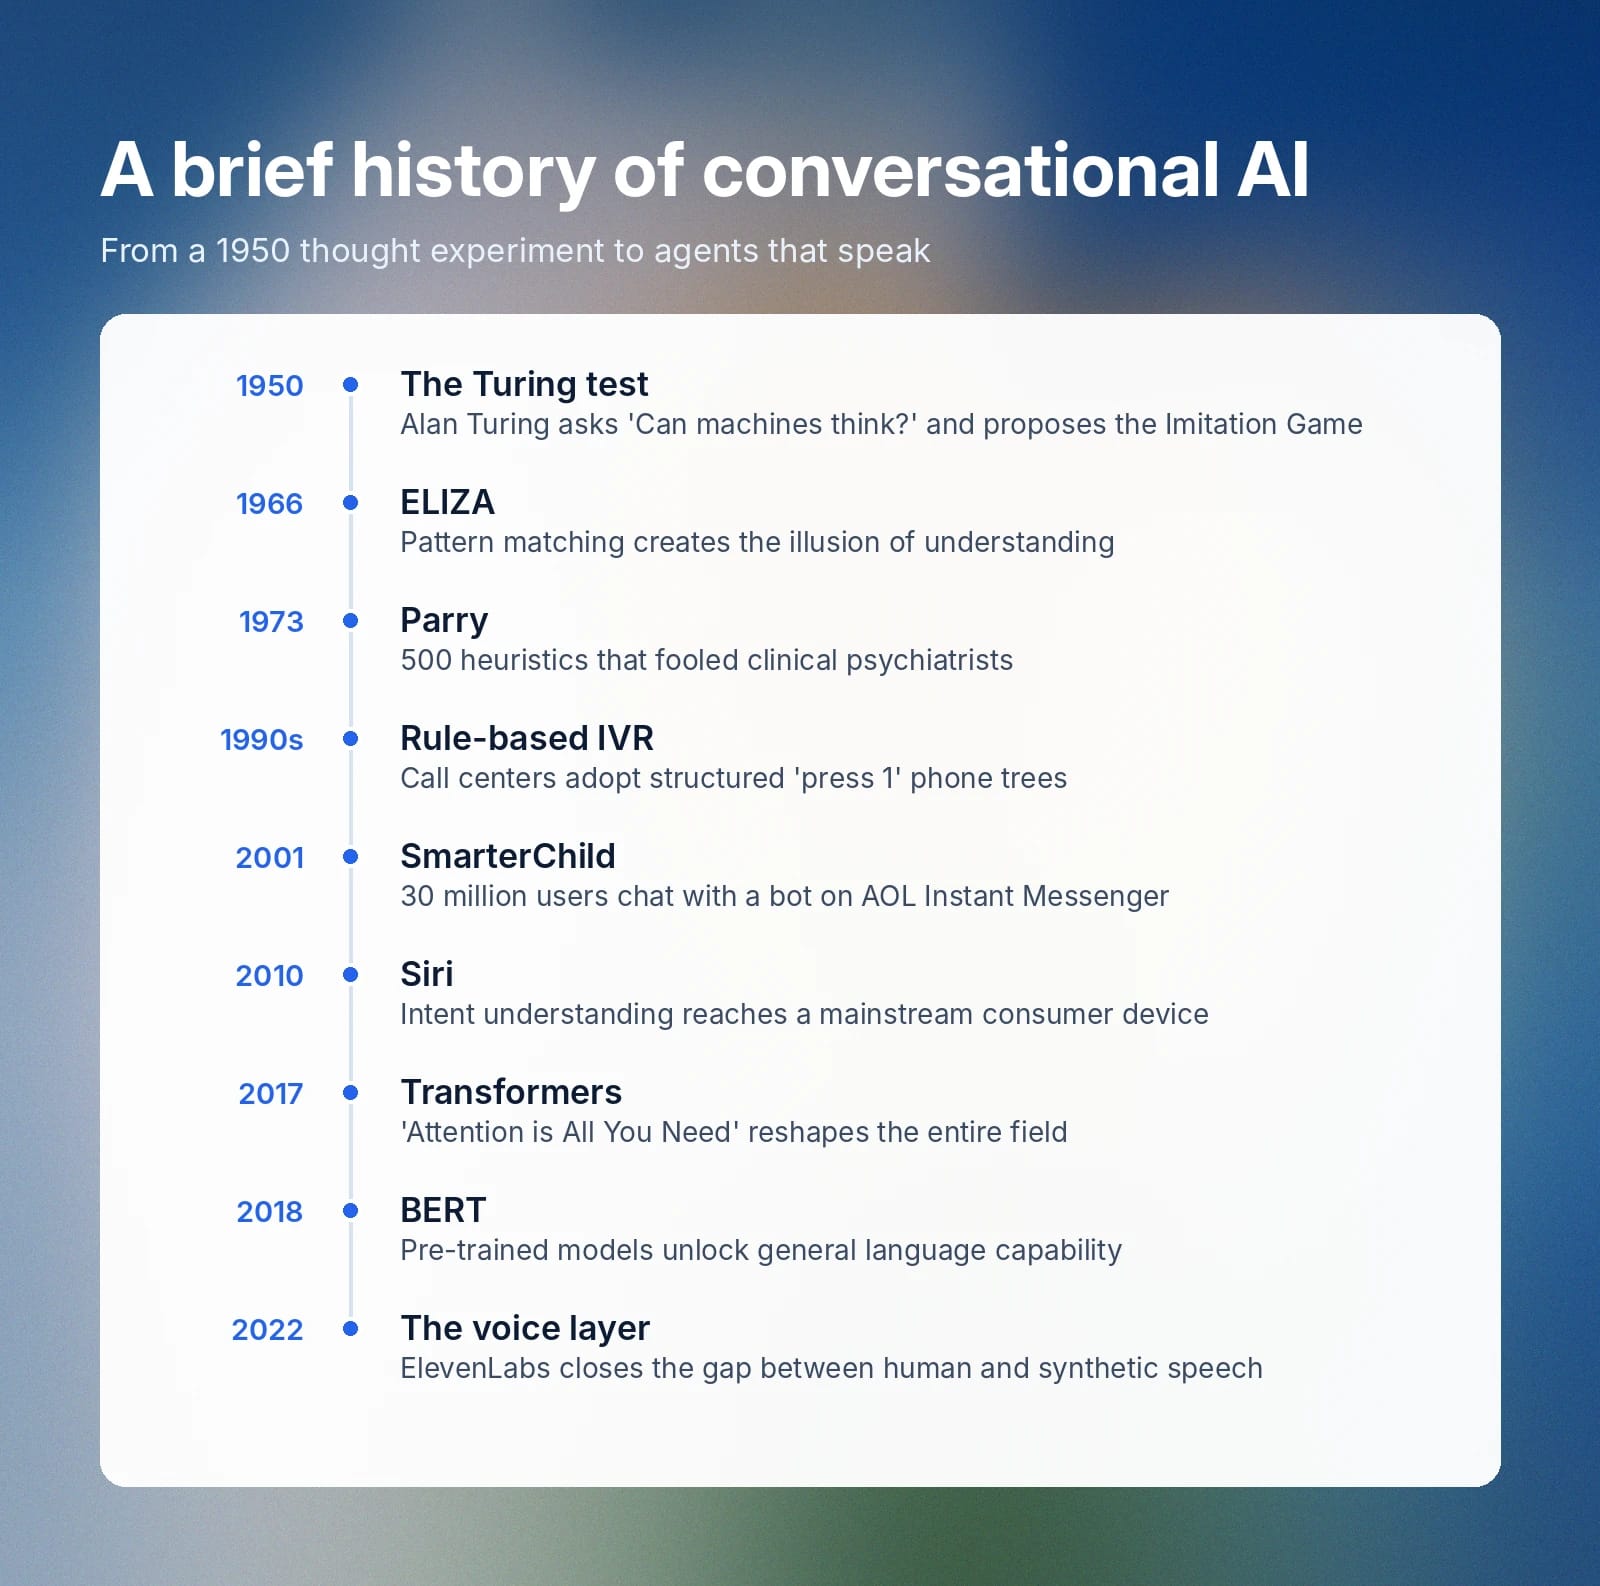
Conversationele AI begon met een filosofisch idee. In zijn artikel uit 1950, “Computing Machinery and Intelligence”, begon Alan Turing met de vraag: ‘Kunnen machines denken?’. Hij probeerde die vraag te beantwoorden met een gesimuleerde test: The Imitation Game.
The Imitation Game had drie deelnemers: een menselijke beoordelaar, een computer en een menselijke proefpersoon. De twee mensen zaten in verschillende kamers, terwijl de beoordelaar berichten stuurde naar en ontving van zowel de mens als het computerprogramma. Als de menselijke beoordelaar de menselijke en computerprogramma-chatters niet van elkaar kon onderscheiden, stelde Turing dat de software iets zou hebben aangetoond dat functioneel gelijkwaardig was aan intelligentie.
Meer dan 70 jaar later dient het kader van de Turingtest nog altijd als een fundamenteel filosofisch ijkpunt voor elk conversationeel systeem dat erop volgde. Maar naarmate de kunstmatige intelligentie achter deze agents geavanceerder is geworden, is de lat aanzienlijk hoger komen te liggen.
Laten we bekijken hoe wetenschappers en wiskundigen Turings kader in de loop der tijd hebben gebruikt en aangepast voor conversationele AI.
Vroege chatbots 1960 - 1990
In 1966 ontwikkelde Joseph Weizenbaum een van de eerste programma's voor natuurlijke taalverwerking. De software, bekend als ELIZA, gebruikte patroonherkenning om gebruikers de illusie te geven dat hun input werd begrepen en er passend op werd gereageerd. De broncode van ELIZA is nooit gevonden, maar dankzij Weizenbaums artikel uit 1966 in Computational Linguistics zijn er restanten bewaard gebleven.
Het bekendste ELIZA-script heet ‘DOCTOR’ en is bedoeld als een ‘nep-Rogeriaanse psychotherapeut’. Het gesprek begon met ‘Is something troubling you?’, waarna gebruikers werden uitgenodigd te reageren met wat hen bezighield. ELIZA nam elke invoer en herformuleerde die tot een gerelateerde vraag.
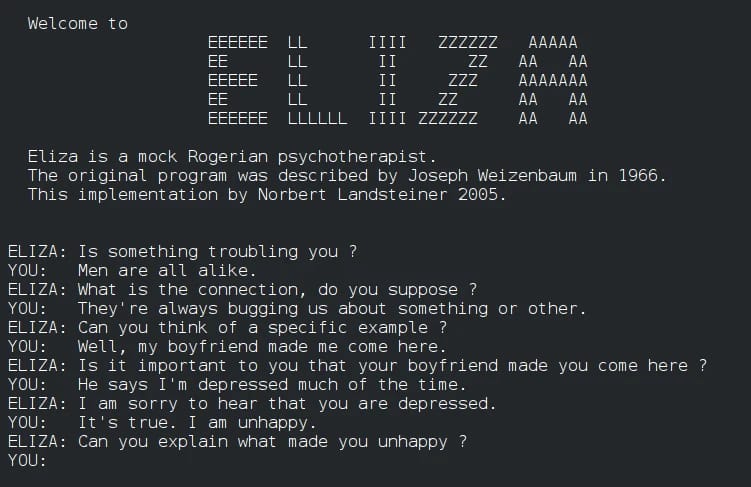
Als een gebruiker bijvoorbeeld ‘My work is extremely stressful’ invoerde, kon ELIZA reageren met ‘What about your work is extremely stressful?’, en het gesprek voortzetten met een nieuwe vraag. Weizenbaum koos de naam ELIZA als verwijzing naar Bernard Shaws ‘Pygmalion’, waarin Eliza Doolittle leert haar spraak in de loop van de tijd te verfijnen.
Enkele jaren later, in 1973, bracht Kenneth Colby Parry uit, een chatbot die de paranoia van een patiënt met een psychische aandoening moest weerspiegelen. Parry had meer dan 500 heuristieken die de reacties bepaalden, waardoor de antwoorden ogenschijnlijk flexibel en genuanceerd waren. Het doel was de emotionele complexiteit van een echt gesprek tussen psychiater en patiënt na te bootsen.
Na het verzamelen van een groot aantal transcripts tussen Parry en erkende klinisch psychiaters ontdekte Colby dat experts geen onderscheid konden maken tussen echte patiënttranscripts en die van Parry.
Regelgebaseerde systemen 1990-2000
Hoewel Interactive Voice Response-systemen (IVR) al in de jaren zeventig bestonden, werden ze als duur en te ingewikkeld beschouwd voor grootschalig gebruik. Pas eind jaren negentig investeerden bedrijven in computertelephony-integratie met IVR-systemen om klantgegevens te verzamelen in callcenters.
IVR biedt een gestructureerde aanpak voor interactie tussen computer en mens. Deze systemen verzamelen informatie van gebruikers en leiden gesprekken vervolgens door naar de juiste afdeling of dienst. Zelfs vroege IVR-toepassingen boden twee mogelijke interactiemethoden: IVR met stemherkenning en Dual-Tone Multi-Frequency, waarbij je cijfers invoert via een toetsenbord.
In de jaren 2000 werd IVR veel kosteneffectiever doordat de VoiceXML-standaard breed werd toegepast en CPU-capaciteit toegankelijker werd.
Hoewel regelgebaseerde IVR's een evolutie waren van vroege chatbots zoals ELIZA en Parry, lijken ze ironisch genoeg een stap terug. Ze bieden weliswaar meer interactiemogelijkheden, maar alleen binnen strikt afgebakende categorieën. Door deze inflexibiliteit verdwijnt de illusie dat je met een echt mens praat, die ELIZA en Parry juist wel konden overbrengen.
Elke input buiten de vooraf aangewezen IVR-paden leverde op zijn best geen antwoord op en liet op zijn slechtst het systeem vastlopen. Daarom pasten menselijke bellers hun taal aan om te spreken op een manier die de machine begreep. Denk aan: “zeg ‘Facturering’ om te worden doorverbonden met een financieel adviseur.”
De fundamentele pijlers van IVR-gebaseerde gespreksroutering vormden de basis voor veel conversationele AI-systemen die later zouden volgen.
Opkomst van chatbots in de jaren 2000
In 2001 lanceerde ActiveBuddy SmarterChild op AOL Instant Messenger. Het was een breed verspreide messengerbot die gebruikers weersupdates kon geven, recent nieuws kon leveren of sportuitslagen kon ophalen. Hoewel de functionaliteit vrij beperkt was, had SmarterChild gedurende zijn bestaan meer dan 30.000.000 individuele gebruikersinteracties.
Ondanks het grote nut genereerde SmarterChild geen omzet voor het merk. Stephen Klein, destijds COO en later CEO, behield de functie toch omdat die een glimp liet zien van de kracht van conversationeel computergebruik.
SmarterChild werd slechts enkele jaren gelanceerd nadat A.L.I.C.E (Artificial Linguistic Internet Computer Entity) voor het eerst de Loebner Prize won als de meest realistische pratende robot van 2000. A.L.I.C.E won de Loebner Prize drie keer tijdens zijn bestaan, maar slaagde er nooit in de Turingtest te doorstaan.
Tien jaar later verscheen de eerste gangbare AI-assistent die rechtstreeks in een consumentenapparaat was geïntegreerd. Siri was het resultaat van verschillende eerdere technologieën, waaronder automatische spraakherkenning (ASR), natuurlijke taalverwerking (NLP) en machine learning.
Siri werd gelanceerd in 2010 en was een van de eerste softwaresystemen die de intentie achter een vraag kon begrijpen en daar passend op kon reageren. Andere lanceringen, zoals Microsoft Cortana, Amazon Alexa en Google Now, volgden in de periode 2012-2014. Alexa is hier bijzonder relevant, omdat het altijd actieve element in huis van dat model een vroege vorm van conversationele AI was zonder scherm of aanraakinvoer.
Aan de klantgerichte kant werden chatbots een vast onderdeel van de meeste bedrijfswebsites. Chatbots konden bestellingen opzoeken, bronnen vinden, informatie volgen, wachtwoorden resetten of klanten informatieve updates over hun account geven. Hoewel ze minder flexibel waren dan diensten als Alexa of Siri, presteerden deze vroege chatbots goed bij specifieke, afgebakende taken.
Machine learning en NLP in de jaren 2010
Eerdere generaties conversationele AI-assistenten waren regelgedefinieerd en vertrouwden op zorgvuldig geplande beslisbomen en uitgebreide, samengestelde bibliotheken met reacties. In de jaren 2010 begon dit ontwikkelmodel te veranderen doordat machine learning en NLP modellen in staat stelden te trainen op grote corpora van menselijke reacties.
Een grote verschuiving in mogelijkheden kwam met de opkomst van recurrent neural networks (RNN's) en Long Short-Term Memory-modellen (LSTM). Deze systemen hadden grote invloed op de manier waarop machines sequentiële input verwerkten en woorden in een zin begrepen.
Google's NLP-techniek Word2Vec versnelde ook de ontwikkeling van LLM's door semantische relaties in een geometrische ruimte in kaart te brengen. Dankzij deze aanpak konden modellen de relatie tussen woorden inschatten, wat hielp bij het genereren van volgende woorden en het opbouwen van contextueel accurate reacties.
Deze ontwikkelingen culmineerden in het artikel uit 2017, ‘Attention is All You Need’, waarin Google de Transformer-architectuur introduceerde. Transformers gebruiken self-attention om elk woord in een invoer tegelijkertijd af te wegen tegen elk ander woord, waardoor training sneller gaat en de gegenereerde output veel rijker wordt.
In 2018 bracht Google BERT (Bidirectional Encoder Representations from Transformers) uit, een vroeg AI-model dat Transformer-architectuur gebruikt. Het was vooraf getraind op internettekst, waardoor het met relatief weinig aanvullende trainingsdata veel downstreamtaken kon uitvoeren.
Van vertalen en samenvatten tot het beantwoorden van vragen en zelfs het classificeren van het sentiment van input: aan het eind van de jaren 2010 begonnen modellen de algemene mogelijkheden van conversationele AI te tonen die we vandaag gebruiken.
De ontbrekende spraaklaag
In al deze fasen van vooruitgang ontbrak een fundamenteel element van de interactie tussen mens en machine. In de jaren 2020 kon conversationele AI input lezen, redeneren en uitgebreide reacties produceren, maar nog niet echt met een gebruiker spreken. Tot de afgelopen jaren was de spraaklaag altijd het ontbrekende element van volwaardige conversationele AI.
ElevenLabs werd in 2022 gelanceerd om de kloof tussen menselijke en synthetische spraak te dichten, door generatieve modellen te trainen met een rijker begrip van hoe stemmen werken. Deze modellen gingen verder dan alleen fonetische deconstructies en reconstructies: ze moesten ook de emotionele context van taal begrijpen.
Wil je het in actie zien? Lees meer over Eleven v3, het meest expressieve model van ElevenLabs tot nu toe, dat een volledig scala aan menselijke emoties kan overbrengen
Hoe conversationele AI werkt
Een modern conversationeel AI-systeem werkt samen met gebruikers, voert uiteenlopende taken uit, doorzoekt opgeslagen informatie en raadpleegt externe platformen voor gegevens die kunnen helpen bij een reactie. Hoewel een reactie in minder dan een seconde kan verschijnen, koppelen de processen in die momenten een reeks tools en systemen aan elkaar.
Zo werkt een interactie van begin tot eind:
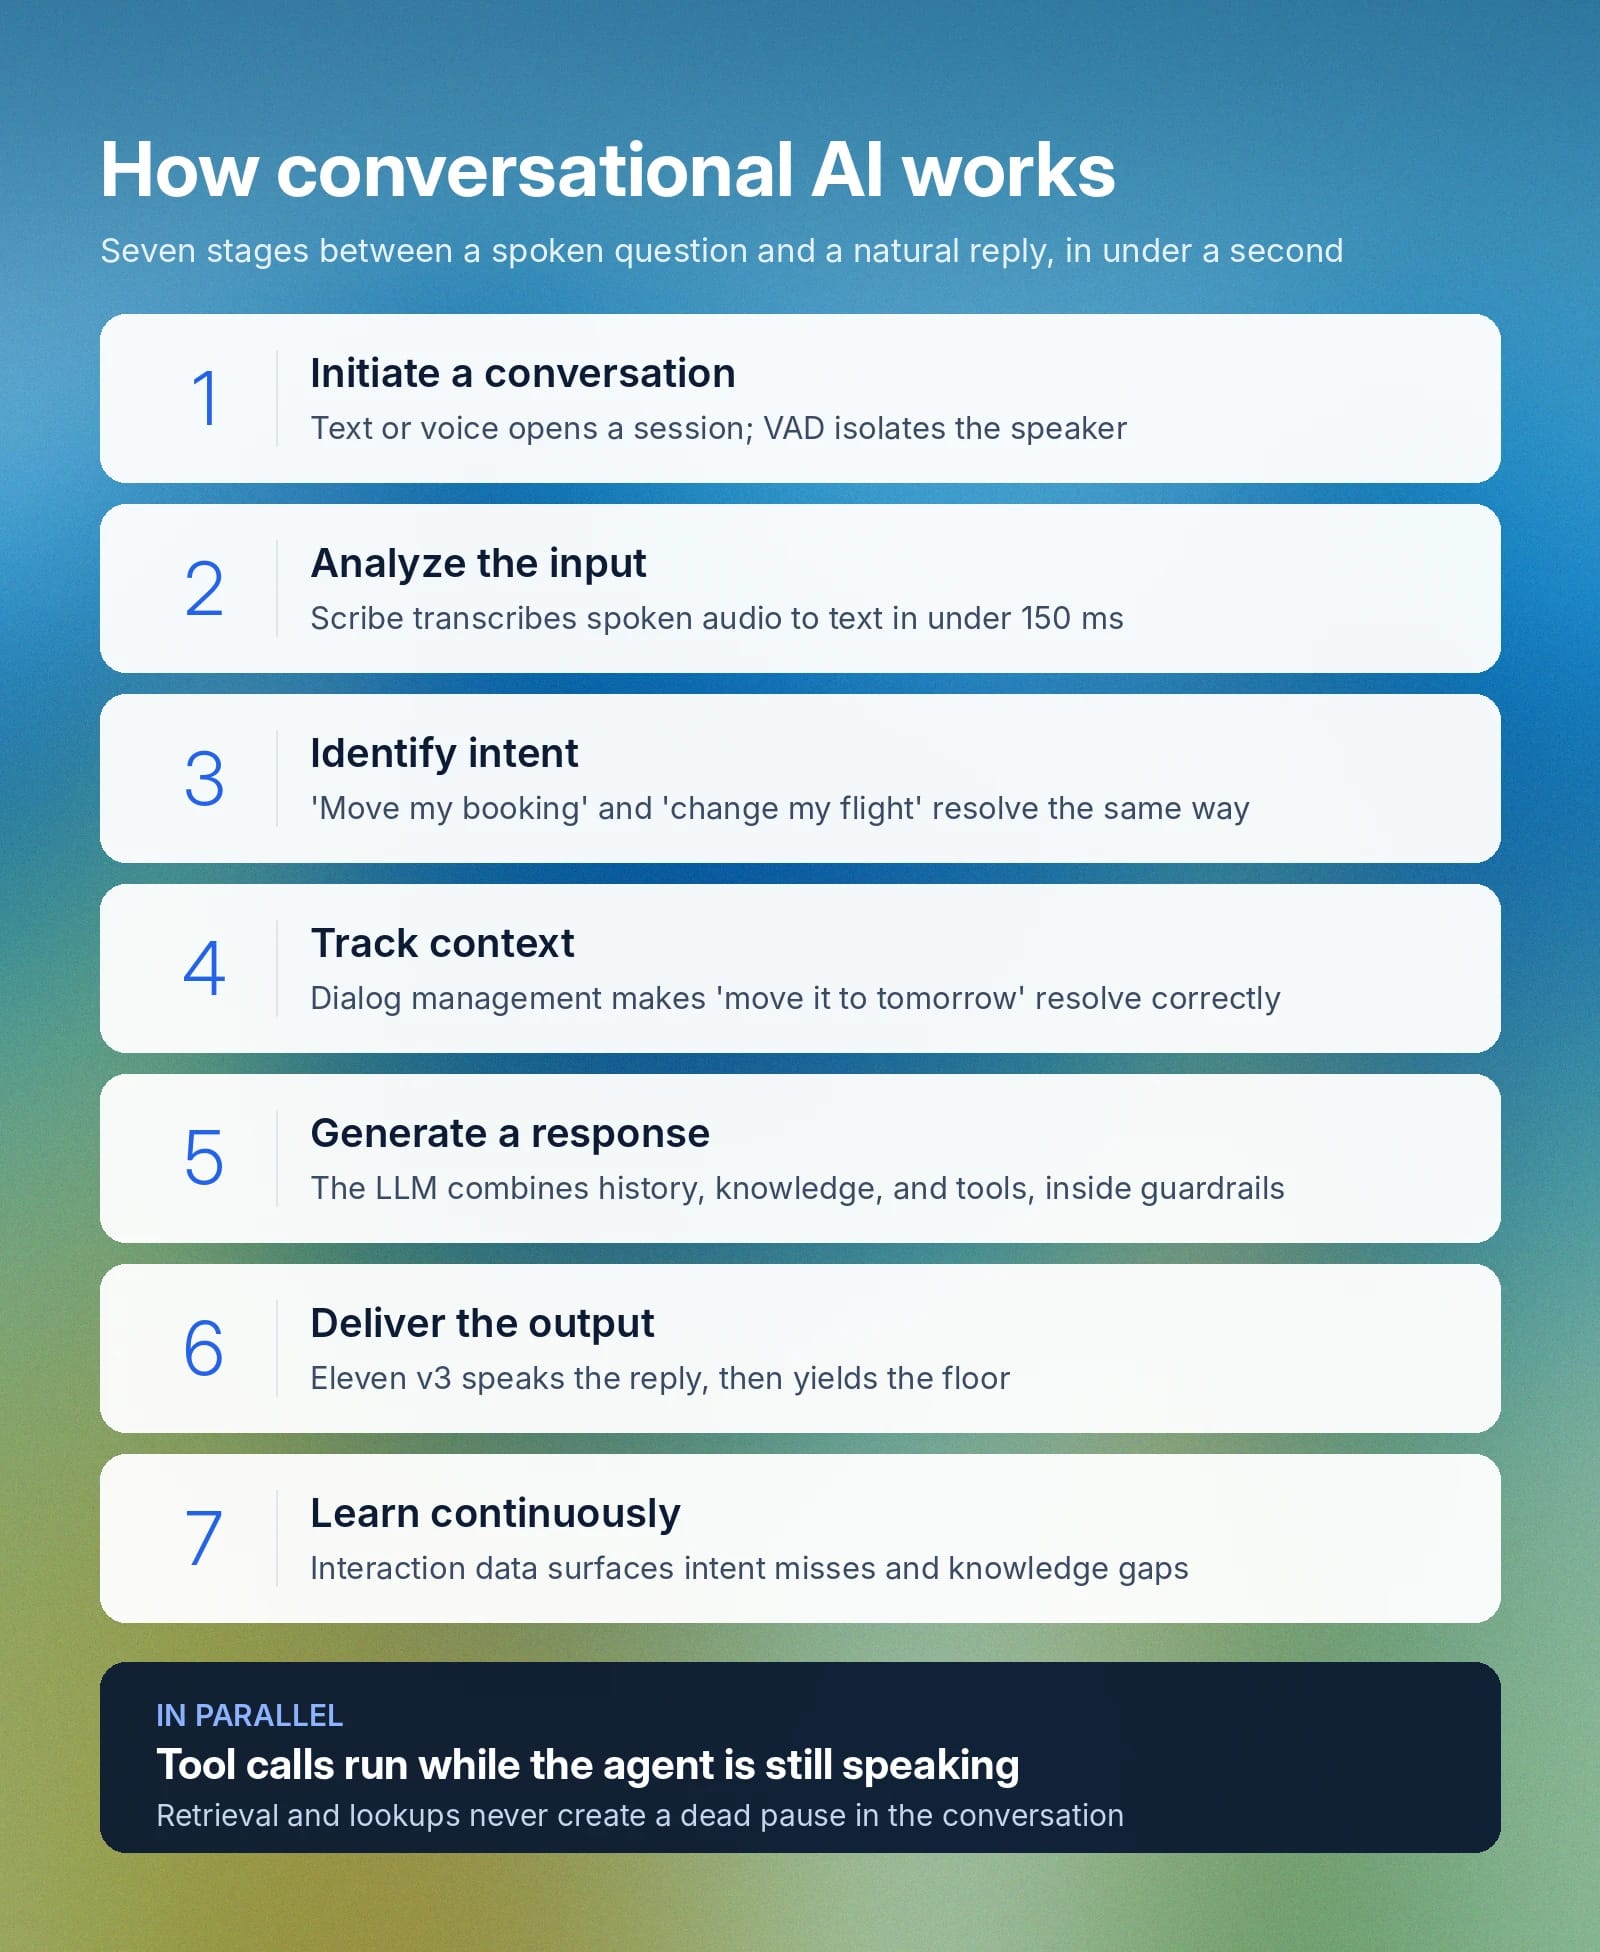
- Een gesprek starten: Een gebruiker geeft input via tekst of stem en start daarmee een sessie met de agent. In systemen op basis van spraak activeert de agent een luisterstatus en isoleert Voice Activity Detection (VAD) de audio van de spreker van achtergrondgeluid.
- De input analyseren: Het systeem zet ruwe tekst of audio om in een gestructureerde representatie die het intern kan gebruiken. Voor tekst betekent dit de input omzetten in tokens en de structuur ervan parseren. Voor stem zet een Speech to Text-model (STT) gesproken audio om in tekst; ElevenLabs gebruikt hiervoor Scribe, zijn eigen STT-model, dat audio in minder dan 150 ms transcribeert.
- De intentie herkennen: In deze fase wordt precies bepaald wat een gebruiker met de interactie wil bereiken. Verschillende uitingen leiden vaak tot dezelfde uitkomst, zoals wanneer twee gebruikers vragen om "mijn boeking te verplaatsen" of "mijn vlucht te wijzigen". Intentieherkenning haalt ook specifieke informatie uit de input, zoals een vluchtnummer of datum.
- Context bijhouden via dialoogbeheer: Dialoogbeheer houdt een overzicht bij van kerninformatie: wat al is vastgesteld, wat de gebruiker heeft gezegd en wat nog moet worden opgelost. Deze laag geeft het systeem persistent geheugen, zodat een zin als "verplaats het naar morgen" via contextuele aanwijzingen wordt opgevat als "verplaats de vlucht naar morgen".
- Een reactie genereren: Het grote taalmodel (LLM) brengt de gespreksgeschiedenis, relevante documenten uit de kennisbank, beschikbare tooloutput en de systeemprompt samen en genereert vervolgens een contextueel passende reactie. Die output wordt vóór verzending gecontroleerd aan de hand van guardrails, zodat deze binnen een geaccepteerd onderwerpbereik blijft.
- De output leveren: De gebruiker ontvangt een reactie als tekst op het scherm, als gesynthetiseerde spraak of als beide. Voor stem gaat de reactie door een Text to Speech-model; ElevenLabs gebruikt Eleven v3 om reacties natuurlijk in plaats van robotachtig te laten klinken. De agent geeft vervolgens het woord terug en luistert naar de volgende beurt van de gebruiker.
- Continu leren en verbeteren: Systemen op productieschaal genereren enorme hoeveelheden interactiedata. Analyse op schaal brengt verkeerd herkende intenties, reacties van lage kwaliteit en kennishiaten aan het licht, zodat precies duidelijk wordt waar de agent zich in de loop van de tijd moet verbeteren.
Voor tekstgebaseerde interacties werkt het proces grotendeels hetzelfde, alleen zonder de STT- en TTS-lagen. Het bericht gaat rechtstreeks naar het LLM voor verwerking en de reactie komt terug als tekst, gebaseerd op dezelfde onderliggende intelligentie.
De onderliggende systemen die samenwerken
De bovenstaande stappen weerspiegelen een eenvoudige uitwisseling, maar echte gesprekken verlopen zelden rechtlijnig. Gebruikers onderbreken, veranderen halverwege een zin van onderwerp en wisselen van taal. Om met die nuance om te gaan, vertrouwt conversationele AI op een reeks onderliggende systemen die parallel werken:
- LLM's: Verwerken wat de gebruiker heeft gezegd, bepalen hoe ze moeten reageren en stellen vast of tools of acties moeten worden geactiveerd.
- RAG (Retrieval-Augmented Generation): Haalt relevante documenten uit je eigen kennisbank op om antwoorden te baseren op de content van je bedrijf.
- STT (Speech to Text): Zet gesproken audio om in tekst zodat het LLM deze kan verwerken.
- TTS (Text to Speech): Zet de reactie van het LLM terug om in gesproken audio met een vooraf geselecteerde stem.
- Model voor beurtwisseling: Detecteert wanneer een gebruiker is uitgesproken, zodat de agent weet wanneer deze moet reageren en het gesprek natuurlijk heen en weer gaat.
- Guardrails: Houden de agent bij het script, compliant en binnen de grenzen die je stelt, ongeacht hoe het gesprek verloopt.
- VAD (Voice Activity Detection): Scheidt de audio van de hoofdspreker van achtergrondgeluid, waardoor transcripties nauwkeuriger worden en geluiden die geen deel van het gesprek zijn worden weggefilterd.
- Voicemaildetectie: Herkent wanneer een oproep voicemail heeft bereikt in plaats van een persoon, zodat de agent passend reageert.
Ook draait niet elk onderdeel van de pipeline in een strikte volgorde. Een agent kan via parallelle tool calls een database raadplegen of de bestelstatus controleren terwijl deze nog spreekt, zodat retrieval nooit een ongemakkelijke stilte in het gesprek veroorzaakt.
Beurtwisseling: conversationele AI menselijker laten aanvoelen
Beurtwisseling verdient extra aandacht, omdat deze laag een natuurlijk aanvoelende agent het meest onderscheidt van een starre agent.
Moderne systemen voor beurtwisseling beheren die stroom met verschillende mechanismen:
- Speculatieve beurtwisseling: In plaats van een vaste hoeveelheid stilte af te wachten, gebruikt het systeem de betekenis van wat een gebruiker heeft gezegd om aan te voelen wanneer een beurt echt voorbij is. Zo voorkomt het dat de agent inspringt tijdens een natuurlijke pauze midden in een zin.
- Onderbrekingen afhandelen: Wanneer een gebruiker begint te spreken tijdens een reactie, stopt de agent, wist deze de reactie waaraan nog werd gewerkt en genereert een nieuwe op basis van de nieuwe input, in plaats van door de beller heen te praten.
- Termen om onderbrekingen te negeren: Korte luistersignalen zoals "mm-hmm" of "oké" kunnen zo worden ingesteld dat ze worden doorgelaten zonder een volledige onderbreking te veroorzaken. Zo verliest de agent niet telkens de draad wanneer een beller aangeeft te luisteren.
- Zachte timeout: Als het LLM langer dan verwacht nodig heeft om een reactie te genereren, spreekt de agent een korte opvulzin uit, zoals "Even denken…", in plaats van een ongemakkelijke stilte te laten vallen. Zo blijft het gesprek natuurlijk verlopen.
Bij dit alles blijft het doel hetzelfde: snelle, natuurlijk klinkende en behulpzame reacties, zodat de klant nooit het gevoel heeft met een machine te praten.
Belangrijkste onderdelen van conversationele AI
Conversationele AI is een stack van verschillende technologieën en systemen die samenwerken om de eindgebruiker te helpen. Elk onderdeel heeft een iets andere verantwoordelijkheid en draagt bij aan het eindproduct.
Dit zijn de belangrijkste onderdelen van een conversationeel AI-systeem en wat ze toevoegen.
Grote taalmodellen (LLM's)
Grote taalmodellen vormen de kern voor redenering in een modern conversationeel AI-systeem. Een LLM interpreteert wat de gebruiker heeft gezegd, brengt de gespreksgeschiedenis, opgehaalde documenten en tooloutput samen, bepaalt welke actie nodig is en genereert de reactie. Daarmee neemt het veel over van wat eerder afzonderlijke engines voor intentieherkenning, dialoogbeheer en NLG vereiste.
Speech to Text en Text to Speech
Bij spraakinteracties vormen twee spraakmodellen de uiteinden van de pipeline. Een Speech to Text-model transcribeert de gesproken audio van de gebruiker naar tekst die het LLM kan verwerken, terwijl een Text to Speech-model de reactie terug omzet in gesproken audio. De expressiviteit van het Text to Speech-model bepaalt grotendeels of een agent menselijk of robotachtig klinkt. Daarom combineert ElevenAgents Scribe voor transcriptie met Eleven v3 voor de weergave.
Model voor beurtwisseling
Het model voor beurtwisseling beheert het ritme van een gesprek in realtime: wanneer het moet luisteren, reageren en het woord moet geven. Het beoordeelt aan de hand van de betekenis van iemands spraak of de beurt van de gebruiker daadwerkelijk is afgelopen, handelt onderbrekingen af en laat luistersignalen passeren zonder de reactie te verstoren. Zonder dit model komt zelfs een perfect beredeneerd antwoord op het verkeerde moment.
Natuurlijke taalverwerking
Natuurlijke taalverwerking is een onderdeel van kunstmatige intelligentie waarmee computers menselijke taal kunnen verwerken en begrijpen. Het omvat verschillende subprocessen, waaronder tokenisatie, parsing, semantische analyse en named entity recognition, die ruwe invoertekst omzetten in iets waarmee computers kunnen werken.
Intentieherkenning
Intentieherkenning is een NLP-techniek die menselijke taal probeert te ontcijferen en de betekenis achter verschillende semantische keuzes begrijpt. Onderzoekers trainen engines voor intentieherkenning doorgaans op een enorme hoeveelheid gelabelde voorbeelden. Daarmee leren modellen input aan intentiecategorieën te koppelen, zelfs wanneer één bericht meer dan één vereiste bevat.
Dialoogbeheer
Dialoogbeheer is een systeem dat de stroom van een gesprek in de loop van de tijd organiseert en plant. Het begrijpt wat er is gezegd en welke informatie het systeem nog nodig heeft om een verzoek af te ronden, en beheert vertakkende gesprekslogica om te bepalen wanneer een gesprek ‘voltooid’ is. Dit onderdeel helpt ook bij het beheren van de systeemreactie wanneer de gebruiker iets onverwachts zegt.
Natuurlijke-taalgeneratie (NLG)
Natural language generation is een onderdeel van conversationele AI dat de linguïstische formulering afhandelt. Het zet modeloutput om in menselijk leesbare taal, vaak met templategebaseerde systemen met een variabele interne structuur. De kwaliteit van dit onderdeel kan sterk verschillen: geavanceerdere systemen genereren reacties volledig vanaf nul.
Machine learning
Machine learning biedt conversationele AI-systemen de mogelijkheid om zich in de loop van de tijd te verbeteren, in plaats van alleen op een basisniveau te functioneren. ML-modellen leren van eerdere voorbeelden en passen hun interne parameters aan om beter met gebruikersinput om te gaan.
Schaal is hierbij cruciaal, omdat de iteratieve verbeteringen van ML machines in staat stellen de complexiteit van menselijke taal te ondersteunen op een niveau dat een regelgebaseerd systeem nooit zou kunnen bereiken.
Actief leren
Active learning is een onderdeel van machine learning dat specifieke voorbeelden selecteert waar een systeem het minst zeker over is en ze markeert voor menselijke beoordeling. Door mensen de labeling van edge cases te laten beoordelen, stellen ML-modellen een onderzoeker in staat impactvolle feedback te geven op de modelprestaties.
Active learning versnelt de modelprestaties aanzienlijk, omdat een model minder tijd besteedt aan gelijkmatige verbetering en meer tijd aan de eigen probleemgebieden.
Documentcognitie
Elk AI-systeem is gebaseerd op een brede verzameling contextuele informatie. Van interne kennisbanken tot beleidsdocumenten en trainingshandleidingen: er is een schat aan content om uit te putten. Door actuele informatiearchieven aan een model te koppelen, kan het deze documenten raadplegen om gebruikers realtime antwoord te geven, in plaats van te vertrouwen op feiten die het tijdens het trainingsproces heeft geleerd.
Documentcognitie is een belangrijk element voor elk conversationeel AI-systeem dat gebruikers of medewerkers met specifieke vragen raadplegen.
Typen conversationele AI-technologie
Als breed onderwerp omvat conversationele AI verschillende technologische toepassingen. Vooral als je een enterprise bent die een eigen agent wil implementeren, helpt inzicht in de verschillen tussen de typen om productontwikkeling veel eenvoudiger te maken.
Laten we enkele van de belangrijkste typen conversationele AI-technologie doornemen.
AI-chatbots
AI-chatbots werken voornamelijk op websites en in mobiele apps en stellen gebruikers in staat via interactie informatie te vinden. Sommige AI-chatbots zijn diep geïntegreerd met interne FAQ's en documenten, waardoor ze complexe interacties met meerdere beurten kunnen afhandelen.
Kwaliteitsverschillen bij een AI-chatbot hangen vooral samen met het vermogen om complexere gebruikersvragen af te handelen. Vooral wanneer gebruikers zelf niet zeker weten hoe ze een verzoek moeten voltooien, moet een model input kunnen verwerken, die opsplitsen in de onderliggende vereisten en relevante documenten vinden om het probleem op te lossen.
Spraakassistenten
Spraakassistenten voegen systemen voor spraakherkenning en spraaksynthese toe, zodat gebruikers via audio met hen kunnen communiceren. In sommige situaties waarin typen lastig is, is een spraakassistent een veel handiger gespreksoptie.
De kwaliteit van spraakassistenten verschilt enorm: van mensachtige stemmen tot robotachtige, statische audiofragmenten, die bepalen hoe een gebruiker de ervaring beleeft. Zelfs als de onderliggende reactie doeltreffend is, kan een mechanische weergave gebruikers afschrikken en ertoe leiden dat ze afhaken.
Interactive Voice Response
Zoals eerder genoemd, is IVR een vroeg handmatig navigatiesysteem waarmee gebruikers uit een vooraf gedefinieerde hiërarchie van opties kunnen kiezen. Door AI aangedreven versies van IVR laten gebruikers in natuurlijke taal uitleggen wat ze nodig hebben, waarna het systeem die input aan een gesprekspad koppelt.
Waar vroege IVR eruitzag als ‘druk op 3 voor facturering’, ziet AI-gebaseerde IVR eruit als ‘leg uit waarom je belt.’
AI-agents
AI-agents zijn de meest geavanceerde vorm van conversationele AI-technologie. Ze kunnen processen met meerdere stappen uitvoeren, verbonden tools automatisch gebruiken, beslissingen nemen zelfs wanneer er ambiguïteit is en end-to-end workflows uitvoeren.
Waar veel andere vormen van deze technologie door mensen werden aangestuurd, kunnen AI-agents een eenvoudige menselijke reactie nemen en als antwoord hele systemen plannen. Ze nemen opnieuw contact op met een gebruiker wanneer er een beslissing nodig is waarvoor menselijke input vereist is.
De flexibiliteit en kracht van AI-agents zijn twee van de belangrijkste redenen waarom bedrijven over de hele wereld ze in hun workflows integreren.
Welke praktische toepassingen heeft conversationele AI?
Bedrijven kunnen conversationele AI nu gebruiken voor gesprekken die verder gaan dan eenvoudige antwoorden op FAQ's. Met platformen zoals ElevenAgents kunnen stem- en chatagents goedgekeurde kennis gebruiken, een gedefinieerde workflow volgen en verbinding maken met bestaande tools zoals CRM-, ticketing-, betaal- en telefoniesystemen om het gesprek naar een oplossing te leiden.
De onderstaande lijst is niet volledig, maar geeft je een idee van enkele manieren waarop conversationele AI kan worden gebruikt.
Deze lijst is slechts een startpunt. Naast deze veelvoorkomende toepassingen gebruiken bedrijven conversationele AI ook voor bijvoorbeeld medewerkerstraining, interne helpdesks en onboarding. Er ontstaan steeds nieuwe toepassingen, terwijl teams stem- en chatagents in meer delen van hun bedrijfsvoering testen.
Welke voordelen zien bedrijven door conversationele AI te gebruiken?
De voordelen van conversationele AI zijn het best te begrijpen aan de hand van wat het in de praktijk mogelijk maakt. In alle sectoren gebruiken bedrijven conversationele AI voor werk dat voorheen te tijdrovend, te repetitief of te duur was om op te schalen. Hieronder zie je hoe dat uitwerkt in praktijksituaties.
Lost vragen aan de klantenservice sneller op
Supportwachtrijen met grote volumes passen goed bij conversationele AI, omdat veel klantvragen snelle en accurate antwoorden vereisen. Agents voor conversationele AI kunnen het probleem van de klant herkennen, antwoorden met goedgekeurde kennisbronnen en het gesprek doorgeven aan een menselijke medewerker wanneer complexe of gevoelige gevallen worden gedetecteerd.
Klarna laat zien hoe dit eruitziet in klantenservice. Het gebruikt voice AI als eerstelijnstelefonische support voor 35 miljoen klanten in de VS en lost vragen tot tien keer sneller op dan met traditionele methoden.
Versnelt salesopvolging en leadkwalificatie
Sales- en businessdevelopmentteams gebruiken conversationele AI om sneller te reageren op inkomende leads en opvolging van uitgaande leads consistent te houden. Agents kunnen inkomende leads kwalificeren, selectievragen stellen, accountgegevens verzamelen en afspraken inplannen. Voor uitgaande workflows kunnen agents prospects bellen en uitkomsten registreren zonder de gespreksgeschiedenis te verliezen.
Bij hypotheekverstrekking zet Better een AI-spraakassistent in voor repetitieve kwalificatiegesprekken, realtime controles van geschiktheid en het telefonisch vastleggen van rentetarieven. Daarmee heeft het de conversieratio van lead naar vastgelegde rente verdubbeld.
Automatiseert uitgaande gesprekken met grote volumes
Uitgaande gesprekken met grote volumes vereisen consistentie, duidelijke registraties en een betrouwbare manier om uitkomsten vast te leggen. Dit omvat incassogesprekken, betalingsherinneringen en heractivering van accounts. Agents kunnen worden gebruikt om bellers veilig te verifiëren, openstaande bedragen toe te lichten, directe betaallinks te verstrekken en gestructureerde uitkomsten in interne boekhoudsystemen te registreren.
Razorpay gebruikt uitgaande spraakagents om slapende accounts opnieuw te activeren en te achterhalen waarom ze geen transacties meer uitvoeren. Door deze terugwin-gesprekken te automatiseren, hebben ze contactpercentages bereikt die vergelijkbaar zijn met de prestaties van hun menselijke callcenters.
Stroomlijnt het plannen van afspraken en intake
Het plannen van afspraken en intake omvat vaak herhaald contact, geschiktheidscontroles en boekingsstappen. Agents kunnen proactief contact opnemen met leden, de geschiktheid controleren en afspraken rechtstreeks telefonisch of via chat inplannen.
Everlywell gebruikt meertalige spraakagents voor contact rond gezondheidsscreenings, wat resulteert in 3,5 keer hogere conversieratio's onder Spaanstalige leden dan bij traditionele geautomatiseerde telefoonsystemen.
Vermindert gemiste oproepen en verbetert receptiedekking
Bedrijven die telefonische receptiediensten nodig hebben, gebruiken conversationele AI om routinematige inkomende oproepen te beantwoorden en gemiste vragen te verminderen. Hieronder vallen klinieken, lokale dienstverleners, overheidsinstanties en andere organisaties waar bellers snelle doorverwijzing of basisinformatie verwachten. Agents beantwoorden inkomende lijnen, verwijzen bellers door naar de juiste afdeling, nemen nauwkeurige berichten aan en behandelen afspraken buiten openingstijden, zodat klanten sneller antwoord krijgen.
De City of Midland, Texas, gebruikt een AI-"civiele conciërge" om overloopgesprekken af te handelen en inwoners 24/7 directe, meertalige ondersteuning te bieden.
Waar je op moet letten bij een platform voor conversationele AI
Beoordeel een platform voor conversationele AI op geschiktheid voor productie, niet alleen op de kwaliteit van een demo. Een kort testgesprek kan indrukwekkend klinken, maar echte implementaties moeten variatie bij klanten, systeemintegraties, compliancevereisten en updates in de loop van de tijd aankunnen.
Let bij het beoordelen van platformen op deze mogelijkheden:
- Stemkwaliteit en latentie: Klinkt natuurlijk en reageert snel genoeg om een live gesprek gaande te houden. Een robotachtige stem of vertraagde reactie kan ervoor zorgen dat klanten vroeg in de interactie hun vertrouwen verliezen.
- Taalondersteuning: Detecteert talen en schakelt tijdens een gesprek tussen talen, met behoud van natuurlijke stemkwaliteit en accurate reacties.
- Diepgang van integraties: Leest gegevens uit en schrijft ze terug naar systemen zoals je CRM, ticketingplatform, telefoniestack, planningstools en betaalsystemen.
- Veiligheid en compliance: Ondersteunt de certificeringen, privacycontroles en implementatievereisten die je branche nodig heeft, zoals SOC 2, HIPAA, AVG, PCI DSS of regionale dataresidentie.
- Implementatie- en iteratiegemak: Stelt niet-technische teams in staat kennis bij te werken, reacties aan te passen en wijzigingen te testen zonder voor elke wijziging op engineering te moeten wachten.
- Supportmodel: Biedt responsieve support tijdens de installatie en na de lancering, vooral bij het oplossen van problemen in productie, opschalen naar een nieuwe markt of toevoegen van een nieuwe toepassing.
- Guardrails en testen: Laat teams bepalen wat de agent mag zeggen, welke acties deze kan uitvoeren, wanneer deze moet escaleren en hoe gesprekken vóór de lancering worden getest.
- Controles voor de kennisbank: Baseert antwoorden op goedgekeurde bedrijfscontent en maakt die content eenvoudig bij te werken in de loop van de tijd.
Voor technische teams is de orchestratie-engine ook het beoordelen waard, omdat deze bepaalt hoe modellen, tools, workflows en bedrijfsregels tijdens een gesprek samenwerken.
Maak je eerste conversationele AI met ElevenLabs
Een conversationele AI-agent bouwen met ElevenAgents begint op het webplatform of met de API. De meeste agents kunnen binnen een uur draaien, terwijl complexere implementaties – met diepgaande integraties, goedkeuringsworkflows of aangepaste vereisten – enkele dagen kunnen duren.
Of je nu klaar bent om te bouwen of nog zoekt naar de juiste aanpak, je kunt op verschillende manieren aan de slag. Neem contact op met ons salesteam als je een veeleisendere implementatie plant en hulp wilt bij het afbakenen ervan, of ga vandaag aan de slag op het platform en laat binnen enkele minuten een agent draaien. Wil je het proces zien voordat je begint? Deze videowalkthrough laat stap voor stap zien hoe je je eerste agent bouwt.
