
De orkestratie-engine van ElevenAgent uitgelegd
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
ElevenAgents worden aangedreven door een low-latency orkestratie-engine die speciaal is ontwikkeld voor realtime gesprekken en minder dan 100 ms overhead toevoegt. Deze architectuur combineert het beste van het onderzoek van ElevenLabs met geavanceerde LLM's van toonaangevende aanbieders zoals OpenAI, Google en Anthropic, naast een selectie open-sourcemodellen die door ElevenLabs worden gehost. Door meerdere modellen in verschillende fasen van de antwoordpipeline te gebruiken, zorgt de agent ervoor dat gesprekken zowel zeer responsief als contextbewust zijn. Door de sterke punten van elk model dynamisch in samenhang te benutten, bereiken we betrouwbare, schaalbare prestaties voor uiteenlopende bedrijfstaken en gespreksscenario's, terwijl we de balans tussen intelligentie, snelheid en kosten optimaliseren.
In dit artikel leggen we uit hoe deze modellen samenwerken om de kernmogelijkheden te bieden die agents nodig hebben om in complexe omgevingen te werken, en meer specifiek welk model welke tokens ziet en wanneer. Centraal staat het beheer van de gespreksgeschiedenis op verschillende momenten in de interactie. We bespreken opnieuw hoe en waar de gespreksgeschiedenis wordt gedeeld, om de rol ervan in de orkestratie voor zowel zelfstandige als multi-agentworkflows te verduidelijken.
Zelfstandige agent
We beginnen met de zelfstandige agent en de kerncomponenten daarvan. Je kunt ervan uitgaan dat een minimaal waardevolle agent een system prompt heeft, toegang tot een aantal tools en een kennisbank. Klanten doen er goed aan zelfstandige agents te verkiezen boven workflows wanneer hun use case maar beperkt vereist dat een strikte reeks stappen wordt geverifieerd, of wanneer het belangrijk is kennissilo's binnen de agents te voorkomen. Kennissilo's ontstaan wanneer bepaalde tools, documenten of historische context toegankelijk zijn voor sommige subagents, maar niet voor andere. Deze zijn inherent aan multi-agentworkflows en brengen een afweging tussen flexibiliteit en determinisme met zich mee.
Voor zelfstandige agents in ElevenLabs is het belangrijk te begrijpen hoe ze:
- effectieve generation requests opbouwen
- relevante documenten ophalen en verwerken
- tool calls genereren en uitvoeren om agentreacties te onderbouwen
- resultaten opleveren voor evaluatie en gegevensverzameling
Gesprekscontext opbouwen
Een gesprek tussen een klant en een ElevenLabs-agent bestaat uit een reeks beurten, waarbij elke beurt uit een uitwisseling van berichten tussen beide partijen bestaat. Deze afwisselende lijst van agent- en gebruikersberichten vormt het uitgangspunt voor het opbouwen van onze gesprekscontext. Tijdens elke beurt ontvangt het onderliggende LLM generation requests met een reeks afwisselende agent- en gebruikersberichten die één bericht langer is dan in de vorige beurt. Deze berichtenreeks begint vanzelfsprekend met één systeembericht dat de system prompt van de agent vertegenwoordigt.
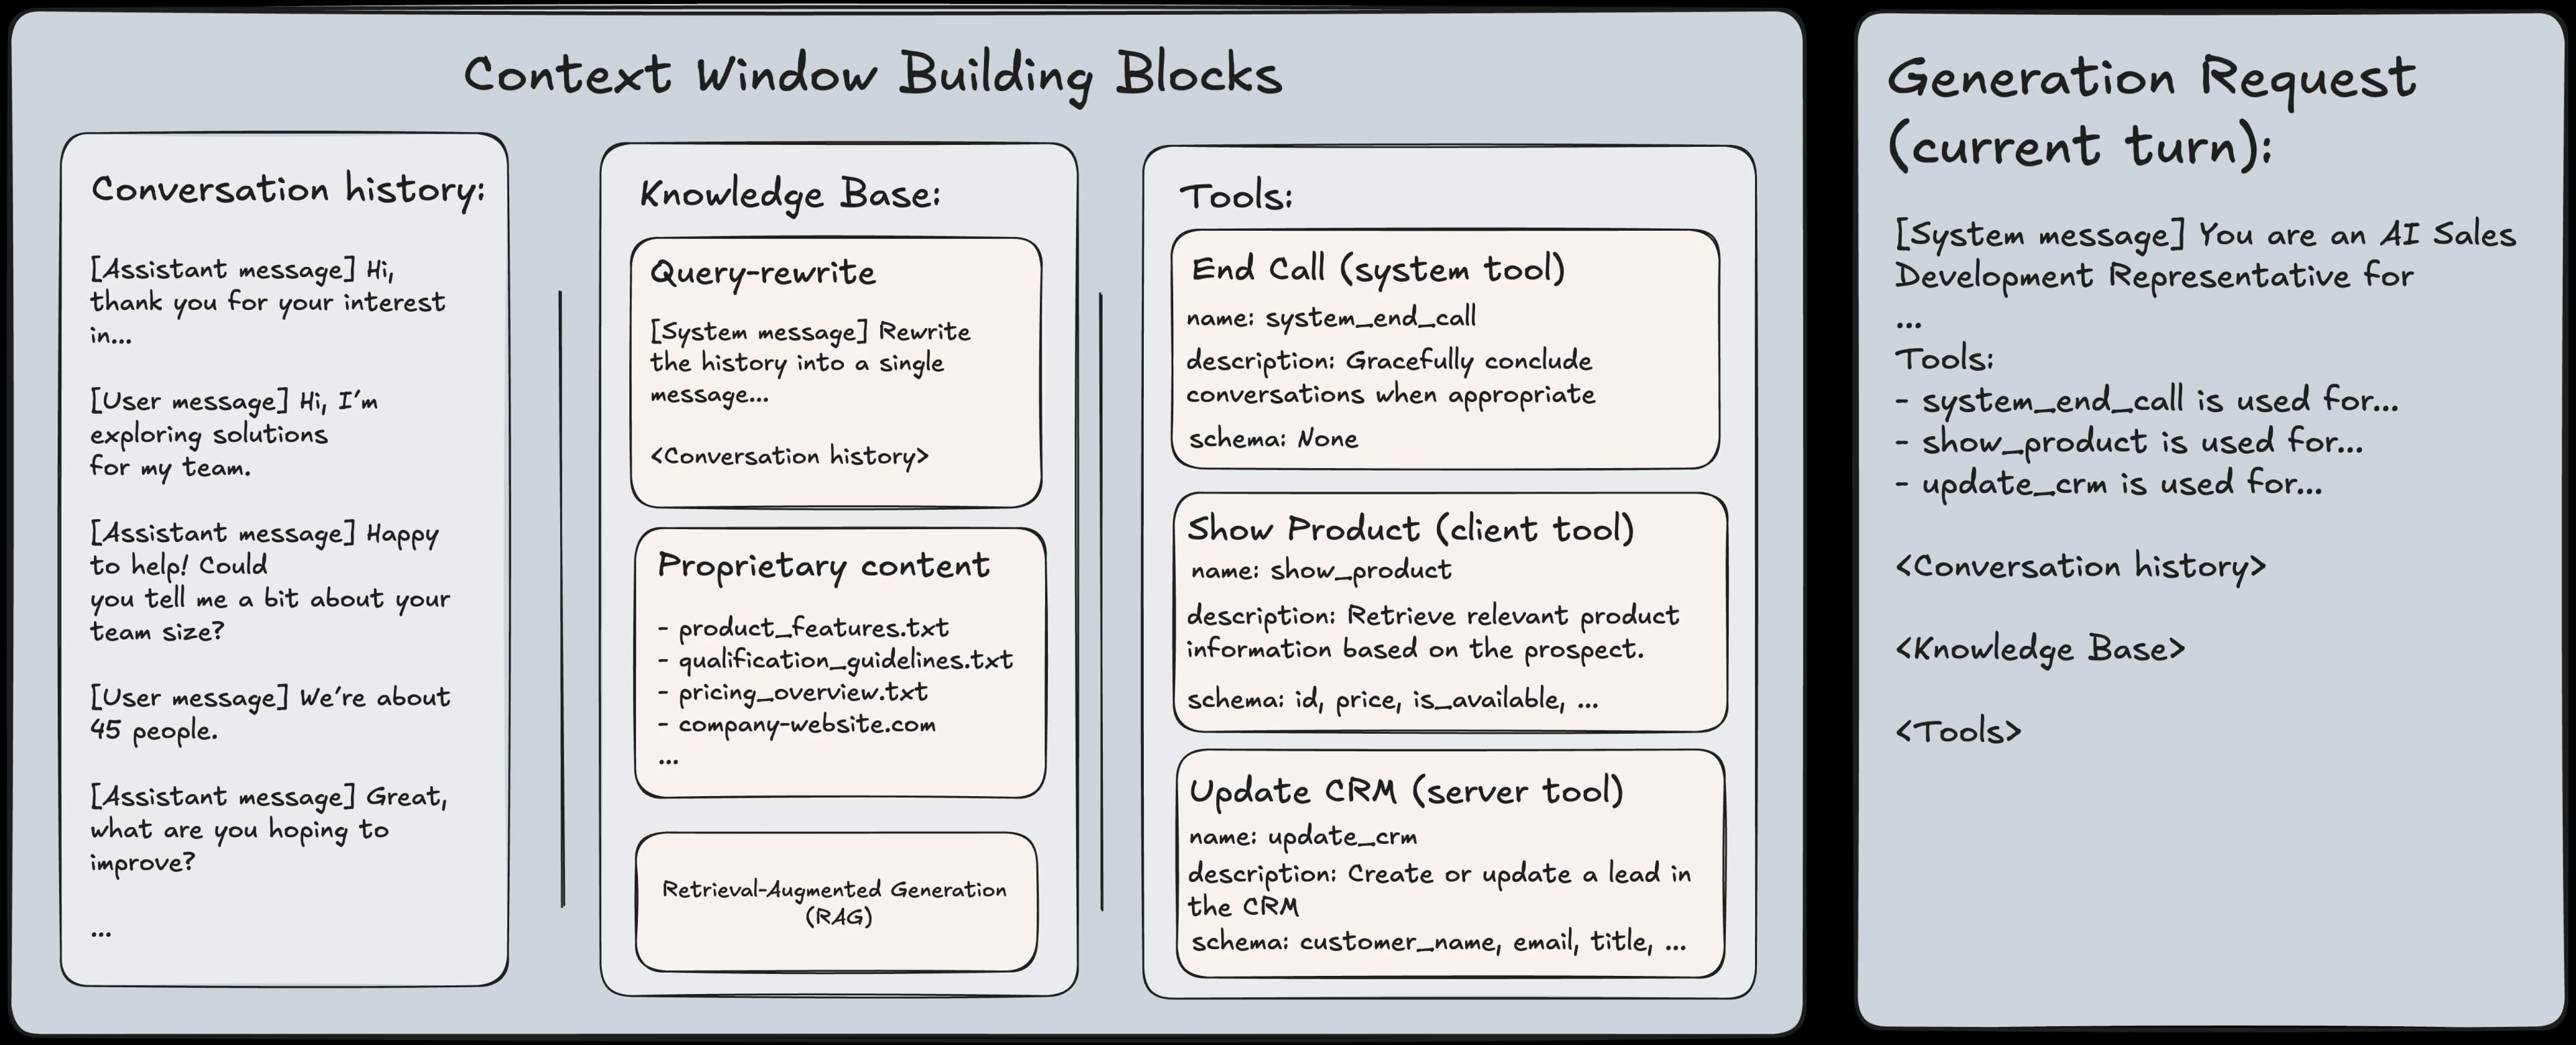
De ElevenLabs-orkestrator verkleint de ervaren LLM-latency door te voorspellen wanneer een gebruiker is uitgesproken. In sommige gevallen kan dit binnen één beurt leiden tot meerdere LLM-generation requests met dezelfde gesprekscontext. Hoewel orkestratie optimaliseert hoe snel agents reageren, hangt de kwaliteit van reacties net zo sterk af van hoe kennis wordt geraadpleegd. Naarmate klanten verder komen, baseren ze de reacties van hun agents doorgaans op een combinatie van eigen documentatie en openbare content. Retrieval-augmented generation (RAG) is hiervoor al enkele jaren de standaardaanpak. ElevenAgents Knowledge Bases bouwen voort op RAG met een geoptimaliseerde architectuur met meerdere modellen, die we in een eerder artikel hebben beschreven. Hierdoor kunnen documenten betrouwbaar worden opgehaald, ook wanneer de meest recente gebruikersinvoer een vervolgvraag, een bevestiging van een verduidelijking is of anderszins geen expliciete vraag bevat.
Retrieval is echter slechts één manier waarop agents met externe systemen communiceren.
Acties uitvoeren en informatie ophalen met tools
ElevenLabs-agents kunnen via een flexibel toolsysteem tijdens een gesprek acties in de praktijk uitvoeren en live informatie ophalen. Die mogelijkheden brengen een belangrijke ontwerpafweging met zich mee: elke ingeschakelde tool vergroot de omvang van de geserialiseerde prompt, omdat de naam, beschrijving en het parameterschema naast de system prompt en gespreksgeschiedenis worden opgenomen. Naarmate er meer tools worden toegevoegd, neemt ook de redeneerlast voor het model toe om de juiste reeks tools aan te roepen. In de Agent Builder beschrijft de toolbeschrijving wat de tool doet en welke velden deze retourneert. Dit is de informatie die het taalmodel gebruikt om de context van het gebruik te begrijpen. Zodra dat is gedefinieerd, horen de specifieke voorwaarden voor het aanroepen van de tool in de system prompt van de agent. Bijvoorbeeld:
- Toolbeschrijving voor lookup_order: “Haalt de bestelgegevens van een klant op aan de hand van de bestel-ID. Retourneert bestelstatus, gekochte artikelen, verzendadres en trackingnummer.”
- Instructie in de system prompt: “Roep na het verifiëren van de identiteit van de klant de tool lookup_order aan om de bestelgegevens op te halen.”
Deze scheiding van verantwoordelijkheden houdt tooldefinities herbruikbaar voor verschillende agents, terwijl de system prompt van elke agent bepaalt op welk exact moment een tool wordt aangeroepen. Om klanten te helpen deze system prompts effectief te ontwerpen, bieden we uitgebreidere richtlijnen in onze Prompting Guide. Binnen dit framework kunnen voornamelijk de volgende soorten tools worden gedefinieerd:
- Webhooktools die externe API's aanroepen.
- Clienttools die tool requests als events versturen via de websocket van het gesprek.
- Systeemtools voor ingebouwde acties, zoals gesprekken doorverbinden.
- MCP-tools die verbinding maken met Model Context Protocol-servers.
Wanneer een agent besluit een tool te gebruiken, haalt deze de benodigde gegevens uit het gesprek en stuurt een request om de tool uit te voeren. Zodra de tool een resultaat retourneert, wordt dat resultaat aan het gesprek toegevoegd zodat het model er in de volgende reactie op natuurlijke wijze naar kan verwijzen. Indien nodig kan de uitvoer van de tool ook de opgeslagen informatie van de agent bijwerken als een dynamische variabele. Deze opgeslagen informatie wordt bewaard als eenvoudige sleutel-waardeparen, die met vooraf gedefinieerde mappings uit de reactie van de tool worden gehaald. Zodra deze zijn ingesteld, kunnen de variabelen terugvloeien naar de agent via de system prompt, toekomstige toolparameters en workflowvoorwaarden. Deze feedbacklus geeft agents een vorm van werkgeheugen die zich tijdens interacties ontwikkelt.
Dit beschrijft hoe tools worden geïntegreerd in het redeneerproces van de agent, maar je kunt ook instellen wanneer ze worden uitgevoerd. Tools kunnen in drie uitvoeringsmodi draaien, elk geschikt voor een andere gespreksbehoefte. In Immediate Mode wordt de tool uitgevoerd zodra deze door het LLM wordt aangevraagd. Dit is de standaard voor snelle lookups waarbij gebruikers een vrijwel directe reactie verwachten, zoals het controleren van een bestelstatus. In combinatie met pre-tool speech genereert de agent eerst een korte bevestiging, zoals “Ik kijk dat even voor je na”, en stuurt deze naar de gebruiker terwijl de tool parallel draait, zodat er zo min mogelijk stilte valt. Voor tragere tools verlengt het platform deze opvulberichten automatisch om ze af te stemmen op de verwachte wachttijd. Post-Tool Speech Mode stelt de uitvoering daarentegen uit totdat de agent is uitgesproken. Dit is essentieel voor acties met gevolgen in de praktijk, zoals een gesprek doorverbinden, een sessie beëindigen of een betaling indienen. De gebruiker hoort de volledige context, bijvoorbeeld “Ik verbind je nu door met de factureringsafdeling”, en kan onderbreken voordat de actie wordt uitgevoerd. Async Mode voert de tool volledig op de achtergrond uit zonder het gesprek te onderbreken. Deze modus is het meest geschikt voor fire-and-forgetbewerkingen, zoals een e-mail versturen, een externe workflow activeren of gegevens loggen, waarbij de agent in zijn antwoord niet naar het resultaat hoeft te verwijzen.
Nu uitvoering en orkestratie zijn ingericht, is de volgende stap begrijpen hoe je prestaties meet.
Prestaties meten
Na afloop van een gesprek met een Agent willen klanten mogelijk bepaalde informatie uit het gesprek halen voor verdere analyse en opslag, of bepalen of een gesprek geslaagd was. Dan komen Data Collection en Evaluation Criteria in beeld. Met Data Collection kun je gestructureerde informatie uit een gesprekstranscript halen voor vervolgonderzoek en aggregatie. Klanten exporteren deze uitvoer vaak naar hun data lakehouse voor rapportage- of verrijkingsworkflows. Een Sales Development Agent kan bijvoorbeeld automatisch gegevens van potentiële klanten uit een gesprek halen om een lead te maken of bij te werken in het Customer Relationship Management (CRM)-systeem. Evaluation Criteria bepalen daarentegen of een gesprek als geslaagd wordt beschouwd. Als aan alle geconfigureerde criteria wordt voldaan, wordt het gesprek als geslaagd gemarkeerd; anders wordt het als mislukt aangemerkt. Zo voldoen gesprekken consequent aan vastgestelde standaarden voor kwaliteit en integriteit en krijg je snel feedback. Zodra een gesprek eindigt en de post-call webhook wordt geactiveerd, verwerkt de agent het definitieve transcript, inclusief eventuele tooluitvoering en metadata, via een LLM samen met alle geconfigureerde gegevensverzamelingspunten en evaluatiecriteria. Het model gebruikt deze gecombineerde prompt om te bepalen of aan elk evaluatiecriterium is voldaan en om de opgegeven datapunten voor vervolgonderzoek te extraheren. Omdat het LLM deze configuraties rechtstreeks als onderdeel van de invoerprompt interpreteert, is het belangrijk ze duidelijk en consistent op te maken, zodat het model ze nauwkeurig kan begrijpen en toepassen. Daarom raden we de volgende best practices aan voor het schrijven van beschrijvingen voor Evaluation Criteria en Data Collection.
Evaluatiecriteria
- Eén duidelijk doel per criterium: één zin of kort opsommingsteken is beter dan meerdere doelen in één criterium.
- Observeerbaar en gebaseerd op het transcript: formuleer het doel zo dat op basis van het transcript kan worden bepaald of iets geslaagd of mislukt is (wat er is gezegd, wat de agent heeft gedaan, wat de gebruiker heeft gevraagd). Vermijd doelen die externe context vereisen waarover het LLM niet beschikt.
- Expliciete uitkomsten voor geslaagd/mislukt/onbekend: het LLM heeft al de context dat het doel moet zijn behaald om iets als geslaagd te markeren, niet behaald moet zijn om het als mislukt te markeren, en dat het op basis van het transcript niet kan bepalen hoe het moet worden gemarkeerd als het onbekend is. Het doel moet daarom zo zijn geschreven dat “behaald” tegenover “niet behaald” duidelijk is gedefinieerd. Als het ambigu is, kan het model neigen naar onbekende of onjuiste classificaties
- Houd het beknopt: soms worden veel evaluatiecriteria tegelijk verstuurd. Lange evaluatiecriteria kunnen daarom ruis toevoegen en mogelijk hallucinaties veroorzaken
- Taal is belangrijk: elke toelichting van het LLM over het al dan niet behalen van een evaluatiecriterium wordt gegeven in dezelfde taal als de criteriumbeschrijving, dus het is belangrijk hier rekening mee te houden
Gegevensverzameling
- Beschrijf precies wat je wilt extraheren: de beschrijving is het belangrijkste signaal voor het LLM. Geef aan wat het veld betekent, in welke situatie het moet worden ingesteld en wat er moet gebeuren als het onduidelijk is (bijvoorbeeld: “Laat null staan als de klant nooit een voorkeursdatum heeft genoemd”).
- Laat het overeenkomen met het verwachte type: de waarde die het LLM geeft, komt altijd overeen met het datatype dat aan het gegevensverzamelingspunt is toegewezen (bijvoorbeeld boolean, string, integer enzovoort). De beschrijving moet daar dus op aansluiten. Je kunt bijvoorbeeld “Extraheer het aantal aangevraagde artikelen” gebruiken voor integer en “Ja/nee, of de klant met het aanbod instemde” voor boolean.
- Gebruik enums waar mogelijk: gebruik voor het stringtype enum in het schema als de set waarden vastligt; dit begrenst het model en vermindert ongeldige uitvoer.
- Eén extractiedoel per item: zet niet meerdere ongerelateerde feiten in de beschrijving van één item; splits ze op in afzonderlijke items, zodat elke aanroep één duidelijk extractiedoel heeft.
- Houd beschrijvingen kort: beschrijvingen mogen uit enkele zinnen bestaan; lange alinea's zijn niet nodig. Het transcript staat al in het gebruikersbericht, dus het schema met een korte beschrijving is voldoende.
Momenteel is het LLM dat voor deze evaluatie- en extractiestap wordt gebruikt vast ingesteld op een low-latencymodel voor snelle verwerking. In de nabije toekomst verwachten we opties te introduceren die klanten meer flexibiliteit bieden.
Vervolgens richten we ons op use cases die gestructureerde orkestratie, determinisme of specialisatie voor meerdere gespreksrollen vereisen en waarvoor klanten in plaats daarvan Workflows kunnen gebruiken.
Workflows
Workflows bieden een visuele interface voor het ontwerpen van complexe gespreksflows. Uiteindelijk levert dit het logische object op dat de orkestrator gebruikt om meerdere subagents, tools en doorverbindingen onder een zelfstandige agent-ID te beheren. Workflows voegen naast de onderdelen die al voor zelfstandige agents zijn beschreven aanvullende componenten toe om rekening mee te houden, waaronder de manier waarop:
- system prompts en gespreksdoelen van subagents met elkaar interageren.
- de route langs verschillende transitiepunten in de grafiek wordt bepaald.
Gespecialiseerde gespreksdoelen
Workflows hergebruiken functionaliteit van zelfstandige agents om gedrag af te dwingen dat gedurende een interactie consistent blijft. Hieronder vallen gedeelde elementen zoals de basissystemprompt, kerntools en globale kennisbanken die altijd beschikbaar moeten zijn, ongeacht welk deel van de workflow actief is. De overkoepelende system prompt definieert doorgaans de globale gesprekscontext, de verwachte toon, veiligheidsbeperkingen en eventuele merk- of productbrede instructies.
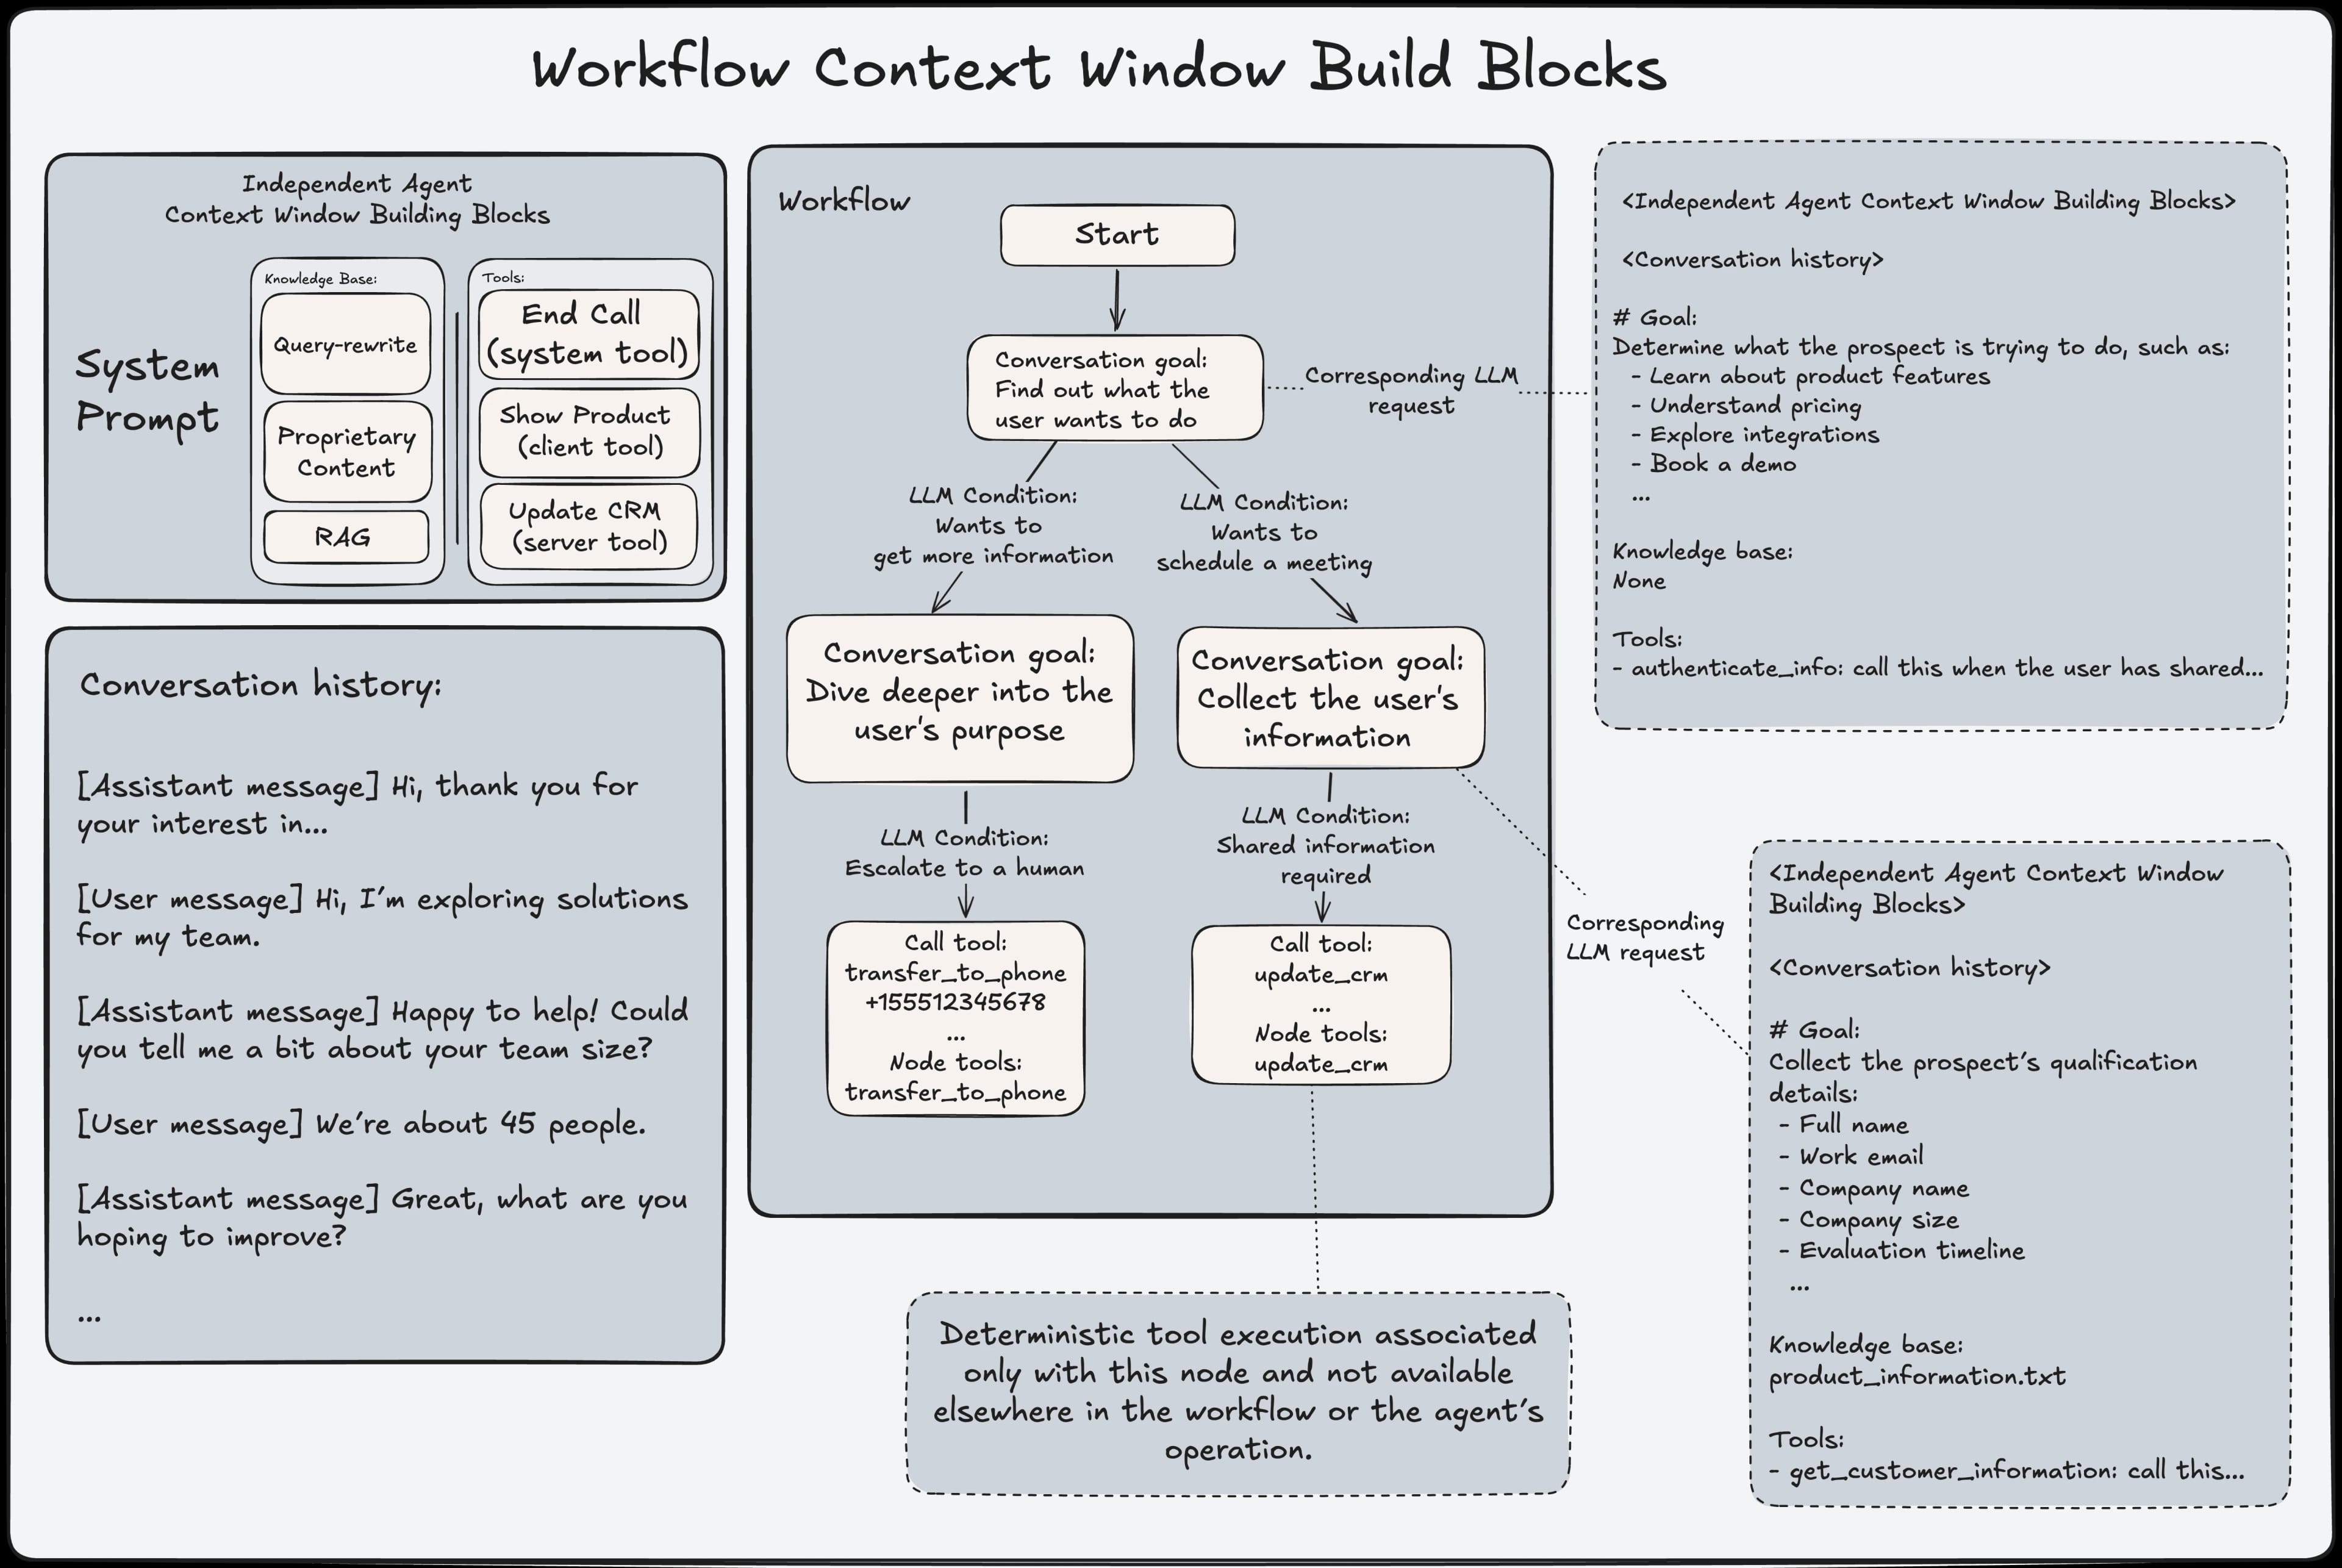
Boven op deze gedeelde basis introduceren Workflows gespecialiseerde subagents die binnen een gerichte grafiek werken. Elke subagent krijgt een nauw afgebakend doel en vult de basisconfiguratie aan met aanvullende promptinstructies, tools en kennisbronnen die alleen relevant zijn voor zijn rol. In plaats van de volledige gespreksopzet opnieuw te definiëren, voegen subagents hun intentie toe aan de basisagent via promptcompositie en selectieve contextuitbreiding. Hoewel de gespreksgeschiedenis behouden blijft bij overgangen tussen subagents om continuïteit te waarborgen, werkt elke subagent met een bewust beperkte weergave van het systeem. Kennisbanken en tools worden selectief beschikbaar gesteld, waardoor duidelijke silo's ontstaan die voorkomen dat informatie tussen verantwoordelijkheden lekt. Om deze isolatie te versterken, wordt het orkestratorobject bij elke overgang opnieuw opgebouwd alsof het een zelfstandige agent betreft. Dit zorgt ervoor dat de promptstatus, configuratie en beschikbare mogelijkheden van de actieve subagent volledig deterministisch blijven. Dankzij dit ontwerp kunnen Workflows globale consistentie behouden en tegelijkertijd lokale specialisatie ondersteunen, wat leidt tot voorspelbaar gedrag, een duidelijke scheiding van verantwoordelijkheden en nauwkeurige controle over de toepassing van context, kennis en acties in elke fase van een interactie.
Een van de belangrijkste mechanismen die deze controle mogelijk maken, is de manier waarop overgangen tussen subagents worden aangestuurd.
Workflowovergangen aansturen met LLM-voorwaarden
Workflows gaan vooruit door een gerichte grafiek van subagents te doorlopen, waarbij overgangen tussen knooppunten worden aangestuurd door expliciete voorwaarden. Deze voorwaarden bepalen wanneer de controle van de ene subagent naar de andere moet gaan en stellen workflows in staat te reageren op gebruikersinvoer, toolresultaten en dynamische variabelen. Grafiekvoorwaarden kunnen deterministisch zijn of door een LLM worden geëvalueerd. Deterministische voorwaarden, zoals onvoorwaardelijke overgangen, controles op basis van expressies voor dynamische variabelen of voorwaarden op toolresultaten, bieden sterke garanties voor de control flow en zijn zeer geschikt om strikte voortgang door een workflow af te dwingen. Op LLM's gebaseerde voorwaarden maken daarentegen semantische beoordeling van criteria in natuurlijke taal mogelijk, zoals het detecteren van gebruikersintentie of herkennen dat specifieke informatie is verstrekt.
Belangrijk is dat LLM-voorwaarden buiten de system prompt van de actieve agent worden geëvalueerd en geen invloed hebben op het generatiegedrag van de agent. Ze worden in plaats daarvan parallel door de orkestrator beoordeeld aan de hand van de huidige gespreksstatus. Deze scheiding zorgt ervoor dat transitielogica de prompt van de agent niet verontreinigt of beïnvloedt hoe reacties worden gegenereerd, terwijl workflows LLM-redenering kunnen blijven inzetten voor flexibele navigatie door de grafiek. Door deterministische en door LLM's geëvalueerde voorwaarden te combineren, kunnen workflows zowel voorspelbaarheid als aanpasbaarheid bereiken: deterministische overgangen wanneer correctheid cruciaal is en LLM-gebaseerde overgangen wanneer semantische interpretatie nodig is.
Wanneer een gesprek naar een nieuwe fase gaat, activeert het systeem een versie van de agent die specifiek op die stap is afgestemd. Elke fase werkt met eigen gerichte instructies en heeft alleen toegang tot de kennis en tools die relevant zijn voor de bijbehorende verantwoordelijkheid. Zo kan een fase voor het afhandelen van terugbetalingen verwijzen naar terugbetalingsbeleid zonder niet-gerelateerde context van onboarding of triage over te nemen. De overgang tussen fasen wordt aangestuurd door expliciete transitievoorwaarden. Deze voorwaarden bepalen wanneer verantwoordelijkheden moeten verschuiven en zorgen dat routeringsbeslissingen op natuurlijke wijze kunnen plaatsvinden naarmate het gesprek zich ontwikkelt. Om continuïteit te behouden, blijft de gebruikerservaring naadloos bij overgangen, waarbij elke fase de relevante gesprekscontext overneemt zonder de werking van de overdracht bloot te leggen. Beveiligingen bewaken ook overgangen om niet-productieve routeringscycli te voorkomen, zodat de workflow stabiel en doelgericht blijft.
Veiligheid en beveiliging
Voor situaties die meer veiligheids- en beveiligingsmaatregelen vereisen, kunnen klanten gebruikmaken van aanvullende onderdelen van de orkestrator.
Guardrails
ElevenLabs Agents implementeren veiligheids-guardrails via een configureerbaar moderatie- en afstemmingssysteem dat gebruikers- en agentberichten realtime evalueert. Binnenkomende content wordt geclassificeerd in meerdere risicocategorieën, waaronder seksuele content, geweld, intimidatie, haat en zelfbeschadiging, elk met afzonderlijk configureerbare drempelwaarden. Wanneer een guardrail wordt geactiveerd, wordt het gesprek onmiddellijk beëindigd en krijgt de client een duidelijke reden voor de mislukking. Dit zorgt ervoor dat onveilige interacties vroeg en consequent worden geblokkeerd, zonder alleen op mitigaties via prompts te vertrouwen. Guardrails werken buiten de promptlogica van de agent en vormen een betrouwbare handhavingslaag die niet kan worden omzeild door modelgedrag of gebruikersinvoer. Met deze aanpak kunnen klanten de veiligheidsgevoeligheid afstemmen op hun domein, terwijl de handhaving tijdens runtime deterministisch blijft.
Conform gegevensbeheer
Sprekers kunnen soms gevoelige informatie delen met een agent waarvoor strikte vereisten voor opslag en verwerking gelden, bijvoorbeeld medische gegevens die HIPAA-conform moeten worden verwerkt. Om deze use cases te ondersteunen, bieden we Zero Retention Mode (ZRM) op Agent- of Workspace-niveau. Als dit is ingeschakeld, worden alle gespreksgegevens uitsluitend in het geheugen verwerkt en nooit naar permanente opslag geschreven. Zodra het gesprek en de verwerking zijn afgerond, bewaart ElevenLabs geen informatie. Daardoor zijn transcripts, audio-opnamen en analyseresultaten niet beschikbaar in het Agents Dashboard. Dit beleid geldt voor zowel systemen voor klanten als interne logs. Hoewel gegevens niet worden bewaard, worden ze tijdens het gesprek wel verwerkt. Alle geconfigureerde post-call webhooks ontvangen de uitvoer, zodat klanten indien nodig transcripts of analyseresultaten in hun eigen systemen kunnen opslaan.
Wanneer ZRM actief is, zorgen we er ook voor dat subverwerkers geen gegevens bewaren door de beschikbare LLM's te beperken tot aanbieders met contractuele toezeggingen die training op of bewaring van klantgegevens verbieden. Momenteel gaat het hierbij om modellen van Google Gemini en Anthropic Claude. Klanten die onder ZRM een ander LLM willen gebruiken, kunnen dat doen door een eigen overeenkomst met die aanbieder te sluiten en het als custom LLM te configureren met API-sleutels die onder die overeenkomst vallen. Omdat hierdoor gegevens buiten onze standaardvertrouwensgrens worden verwerkt, moet ons Safety-team de use case handmatig beoordelen en goedkeuren voordat we deze kunnen inschakelen. Hoewel ZRM ervoor zorgt dat ElevenLabs en zijn subverwerkers geen gespreksgegevens bewaren, blijven klanten ervoor verantwoordelijk dat externe tools of webhooks die hun Agent gebruikt, voldoen aan de toepasselijke vereisten voor gegevensbewaring en regelgeving.
Vooruitblik
In dit artikel hebben we onderzocht hoe ElevenLabs Agents gesprekscontext, tools, evaluatie en gestructureerde workflows beheren om op schaal betrouwbare realtime ervaringen te bieden. Naarmate klanten agents in steeds complexere omgevingen inzetten, blijven we de flexibiliteit van onze orkestratie-engine uitbreiden: van configureerbare evaluatiemodellen en uitgebreidere transitiecontroles tot beter inzicht in promptcompositie en tokengebruik in verschillende fasen.
Ons Forward Deployed Engineering-team werkt nauw samen met klanten om ervoor te zorgen dat deze mogelijkheden zich in hetzelfde tempo ontwikkelen als implementaties in de praktijk. De volgende generatie Agents biedt nog meer transparantie, determinisme en aanpasbaarheid, zonder afbreuk te doen aan de low-latencyprestaties die realtime gesprekken mogelijk maken.
Nicolas works on the Forward Deployed Engineering team at ElevenLabs partnering with customers to bring their agents to production. He previously spent four years at AWS focusing on regulated industries and the public sector.



