
Wat is RAG? Hoe Retrieval-Augmented Generation werkt
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
AI-modellen genereren antwoorden op basis van wat ze tijdens hun training hebben geleerd. Daardoor kennen ze niet automatisch het beleid, de producten of andere informatie van een bedrijf die na die training is gemaakt. RAG (Retrieval-Augmented Generation) lost dit op door relevante externe informatie op te halen en aan het model te geven voordat het antwoordt.
RAG baseert de antwoorden van AI op de daadwerkelijke documenten van een bedrijf. Een klantenserviceagent die RAG gebruikt, kan het actuele retourbeleid of de productspecificatie ophalen voordat die antwoordt. Dit verkleint het risico op hallucinaties.
In deze gids leggen we uit wat RAG in AI betekent, hoe retrieval en generatie samenwerken en waarin RAG verschilt van een zelfstandig LLM. Ook bespreken we de beperkingen van RAG, waar het goed werkt in generatieve AI-toepassingen en hoe RAG het ophalen van kennis ondersteunt in AI-agents.
Samenvatting
- RAG koppelt een retrievalsysteem aan een generatief model, zodat het model informatie buiten zijn trainingsdata kan gebruiken.
- De kennis die RAG ophaalt, bevindt zich buiten het model en kan dus worden bijgewerkt zonder iets opnieuw te trainen.
- ElevenAgents gebruikt RAG automatisch wanneer een kennisbank te groot is om rechtstreeks in de context van het model te passen. Daardoor blijven antwoorden snel zonder dat de nauwkeurigheid bij grote, complexe kennisbanken afneemt.
Wat is RAG in AI?
RAG is een systeemarchitectuur rond een LLM die het externe informatie biedt, zoals merkrichtlijnen, producthandleidingen, artikelen uit de kennisbank of interne databases. Hierdoor kan AI werken met bedrijfsspecifieke informatie, zodat antwoorden het actuele beleid, private kennis en bedrijfsgegevens kunnen weerspiegelen waarop een model nooit is getraind.
Een LLM kan bovendien maar een beperkte hoeveelheid informatie tegelijk verwerken, de zogeheten context window. Een grote organisatorische kennisbank kan die limiet snel overschrijden. RAG houdt de informatie daarom buiten het LLM en haalt alleen de passages op die nodig zijn voor de huidige vraag.
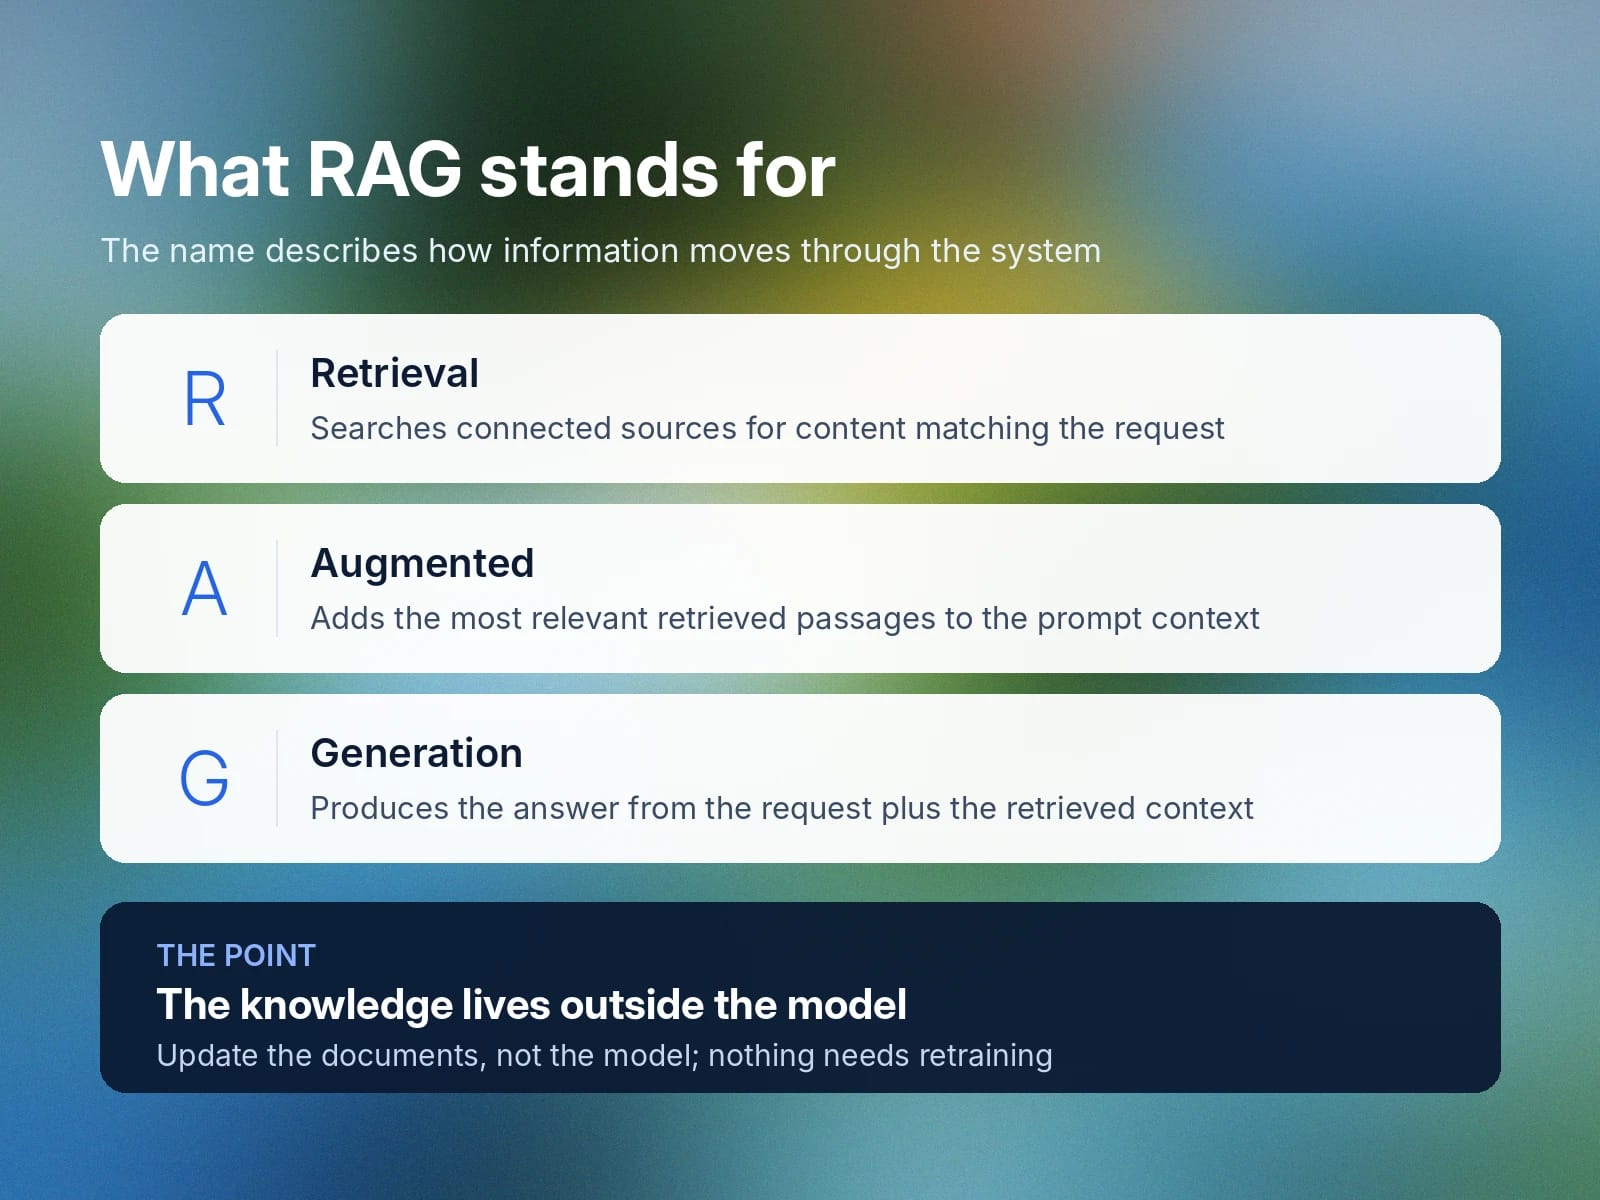
De naam beschrijft hoe informatie door het systeem stroomt:
- Retrieval: Zoekt in gekoppelde bronnen, zoals beleidsdocumenten, helpdesklogs of voorraadbestanden, naar inhoud die overeenkomt met het verzoek van de gebruiker.
- Augmented: Voegt de meest relevante opgehaalde passages toe aan de promptcontext.
- Generation: Gebruikt het verzoek van de gebruiker en de opgehaalde context om het antwoord te produceren.
RAG ondersteunt ook grounding, de praktijk waarbij een AI-antwoord wordt gekoppeld aan specifieke broninformatie, door het LLM relevant materiaal te geven dat het kan gebruiken bij het genereren van een antwoord. Als een klant bijvoorbeeld naar een garantiebeleid vraagt, haalt het RAG-systeem de relevante voorwaarden uit de bedrijfsdocumentatie op en geeft die aan het LLM om het antwoord op te baseren.
Hoe werkt Retrieval-Augmented Generation?
Een RAG-systeem bereidt externe kennis voor om te doorzoeken, haalt de informatie op die het meest relevant is voor de vraag van een gebruiker en geeft die informatie als context aan het LLM voordat het een antwoord genereert.
RAG-implementaties verschillen in complexiteit. Basis-RAG gebruikt een eenvoudig proces van ophalen en genereren, terwijl geavanceerdere methoden query rewriting, filtering, reranking of andere retrievaltechnieken kunnen toevoegen.
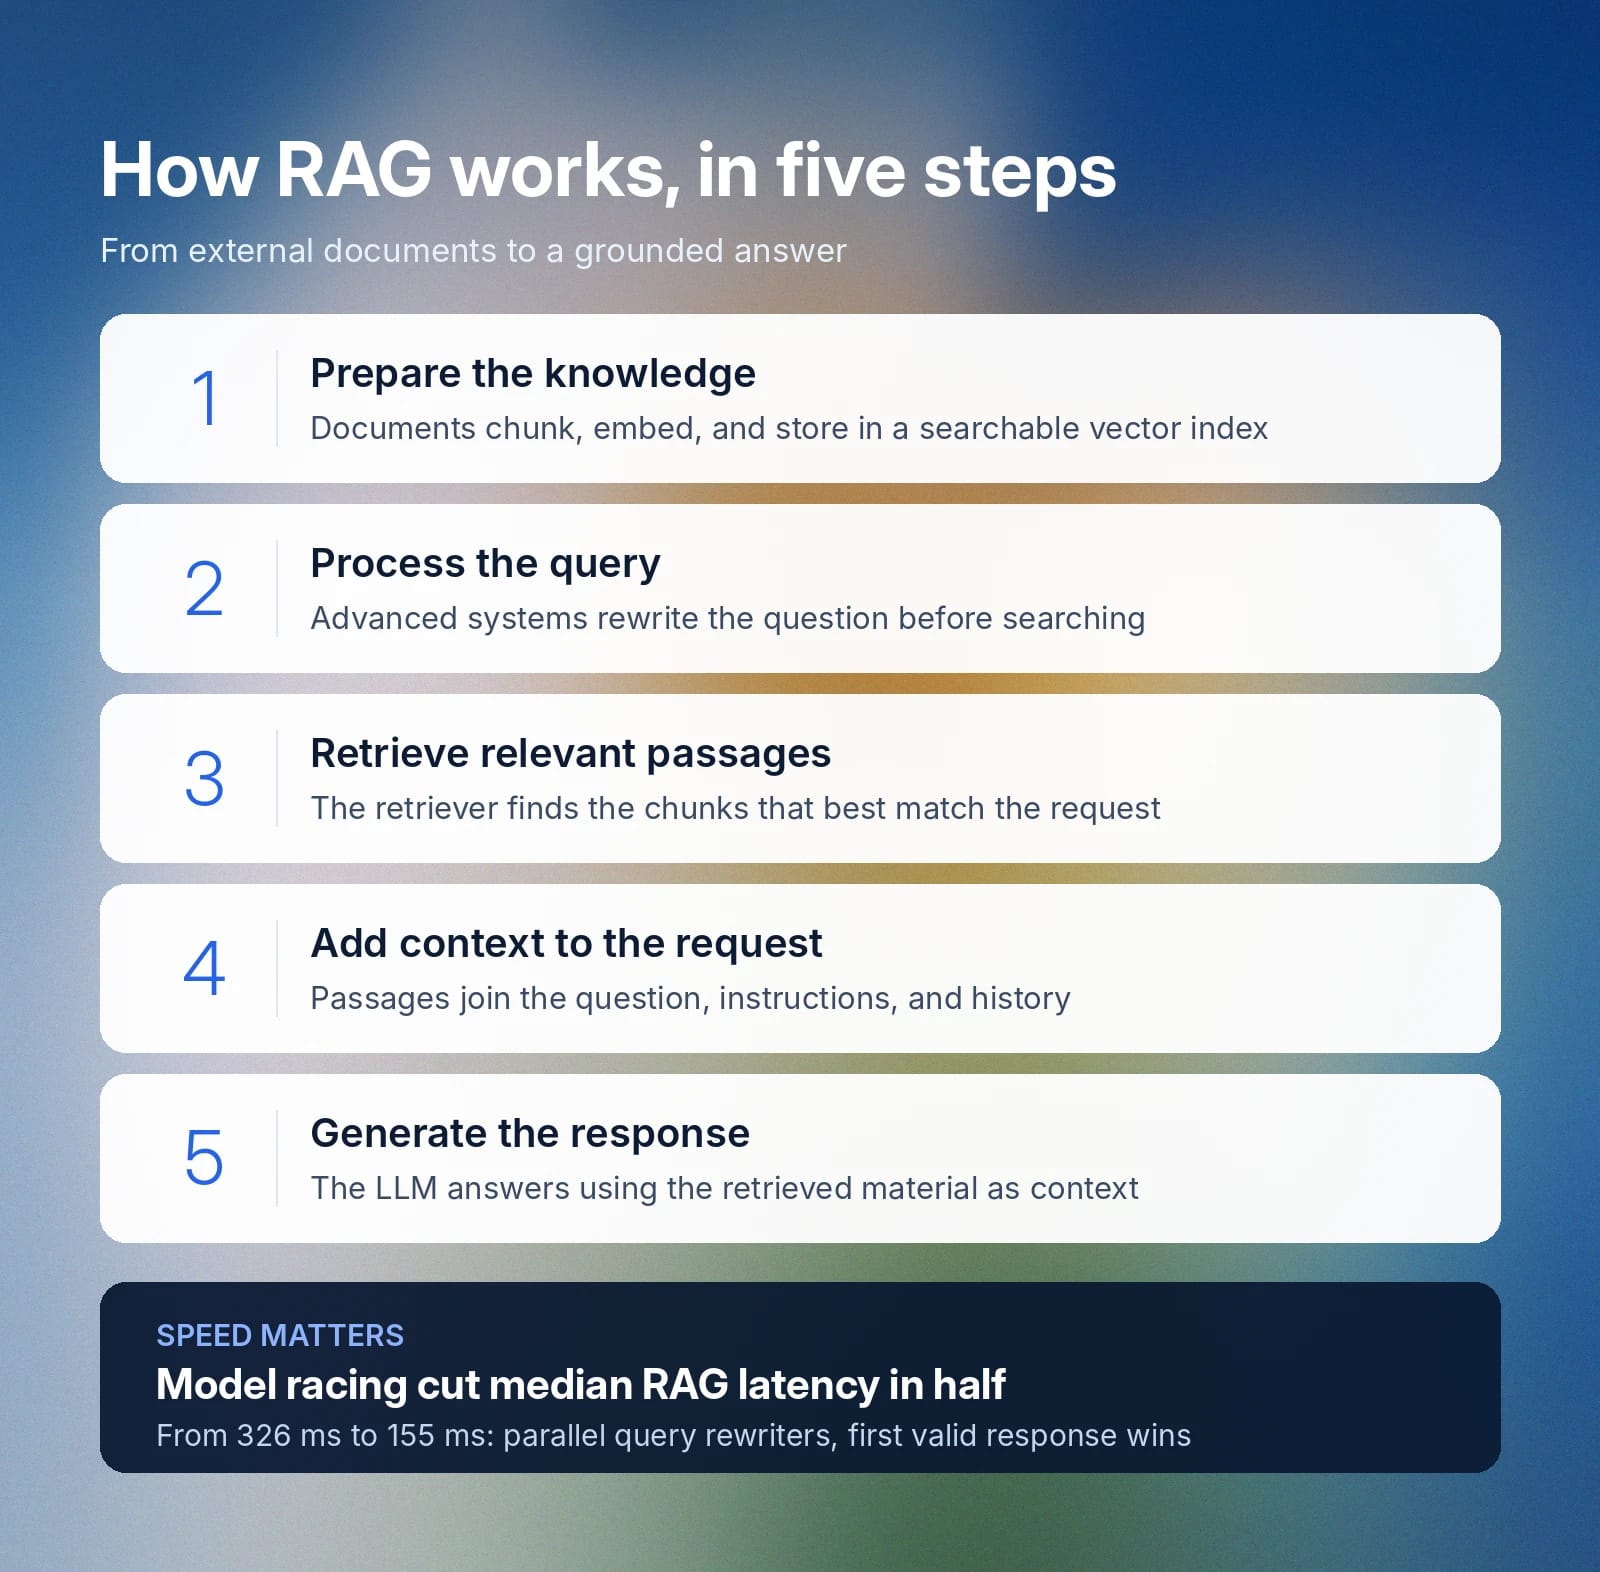
Het RAG-proces volgt meestal vijf stappen:
- De kennis voorbereiden: Documenten worden opgedeeld in kleinere passages (een proces dat ‘chunking’ heet), omgezet in wiskundige representaties die embeddings worden genoemd en opgeslagen in een doorzoekbare index of vectordatabase.
- De query verwerken: Het systeem interpreteert de vraag van de gebruiker en herschrijft of verfijnt die in geavanceerdere RAG-systemen voordat het zoekt.
- Relevante passages ophalen: De retriever doorzoekt de geïndexeerde kennisbank naar de tekstchunks die het beste aansluiten bij het verzoek.
- Context aan het modelverzoek toevoegen: De geselecteerde passages worden samen met de vraag van de gebruiker, relevante instructies en de gespreksgeschiedenis naar het LLM gestuurd.
- Het antwoord genereren: Het LLM produceert een antwoord met het opgehaalde materiaal als onderdeel van zijn context.
Veel RAG-systemen activeren retrieval selectief als externe tool. Met ElevenAgents kunnen teams RAG voor een kennisbank rechtstreeks inschakelen in de agentinstellingen. Het systeem gebruikt query rewriting om eerdere dialoog en vage verwijzingen tijdens vervolgvragen in een nauwkeurige, zelfstandige zoekquery om te zetten.
Om tijdige antwoorden te garanderen, ontwikkelde ElevenLabs ook een model-racingarchitectuur die elke query parallel naar meerdere rewritingmodellen stuurt en de eerste geldige reactie gebruikt. Deze aanpak halveerde de mediane RAG-latency, van 326 ms naar 155 ms, waardoor retrieval snel genoeg blijft om een natuurlijke gespreksstroom te behouden, zelfs wanneer een grote kennisbank dit activeert.
Wat is het verschil tussen LLM's en RAG-modellen?
Een LLM is een model dat taal begrijpt en genereert. RAG is een architectuur rond het LLM die externe informatie ophaalt wanneer de toepassing die nodig heeft.
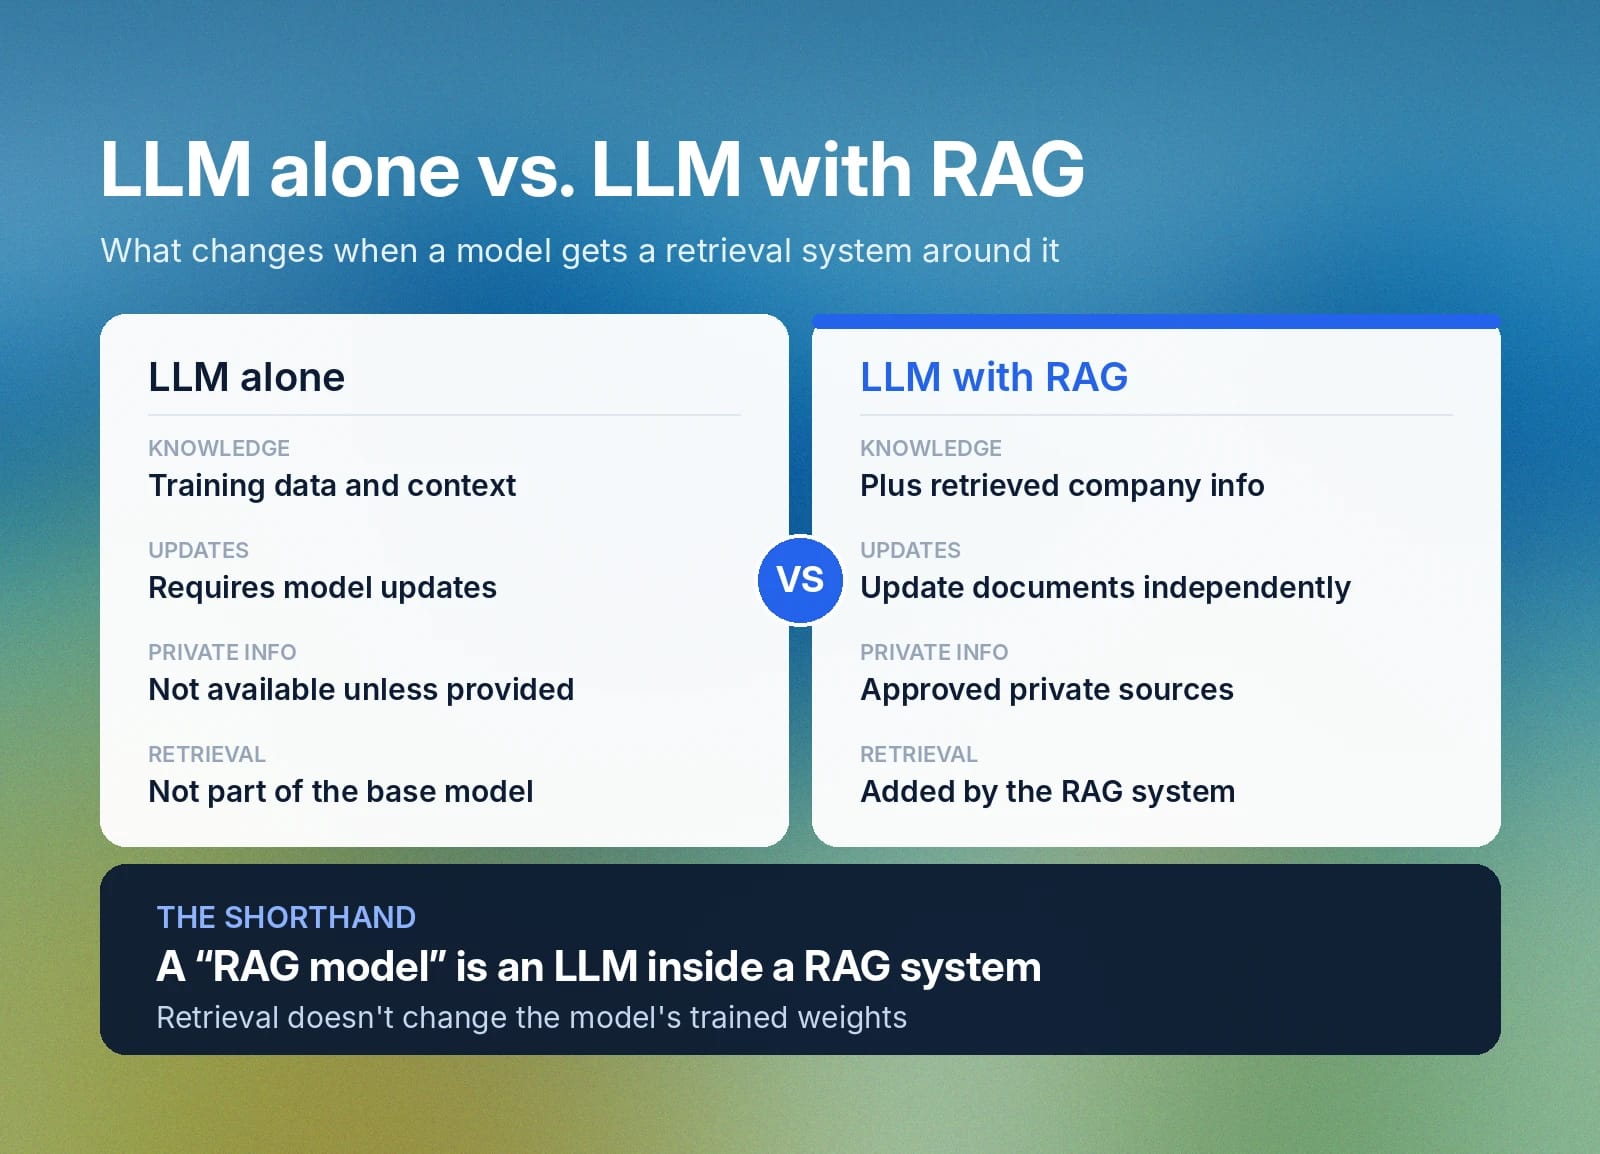
Dit verandert er wanneer een LLM met RAG wordt gecombineerd:
Kenmerk
Alleen LLM
LLM met RAG
Kennis
Trainingsdata en huidige context
Trainingsdata, huidige context en opgehaalde bedrijfsinformatie, zoals beleid, productdocumentatie of inhoud uit de kennisbank
Updates
Nieuwe informatie moet in de context of via modelupdates worden aangeleverd
Externe kennis kan los van het model worden bijgewerkt
Private informatie
Niet beschikbaar tenzij deze wordt aangeleverd
Kan ophalen uit goedgekeurde private bronnen
Retrieval
Geen onderdeel van het basismodel
Toegevoegd door het omringende RAG-systeem
‘RAG-model’ wordt soms gebruikt als afkorting voor een LLM dat binnen een RAG-systeem wordt gebruikt. Een bedrijf kan bijvoorbeeld zeggen dat het een ‘RAG-model’ gebruikt voor klantenservice terwijl de werkelijke opzet een LLM is dat relevante inhoud uit het helpcentrum of over beleid ophaalt voordat het een antwoord genereert.
Beperkingen van RAG-modellen in praktische toepassingen
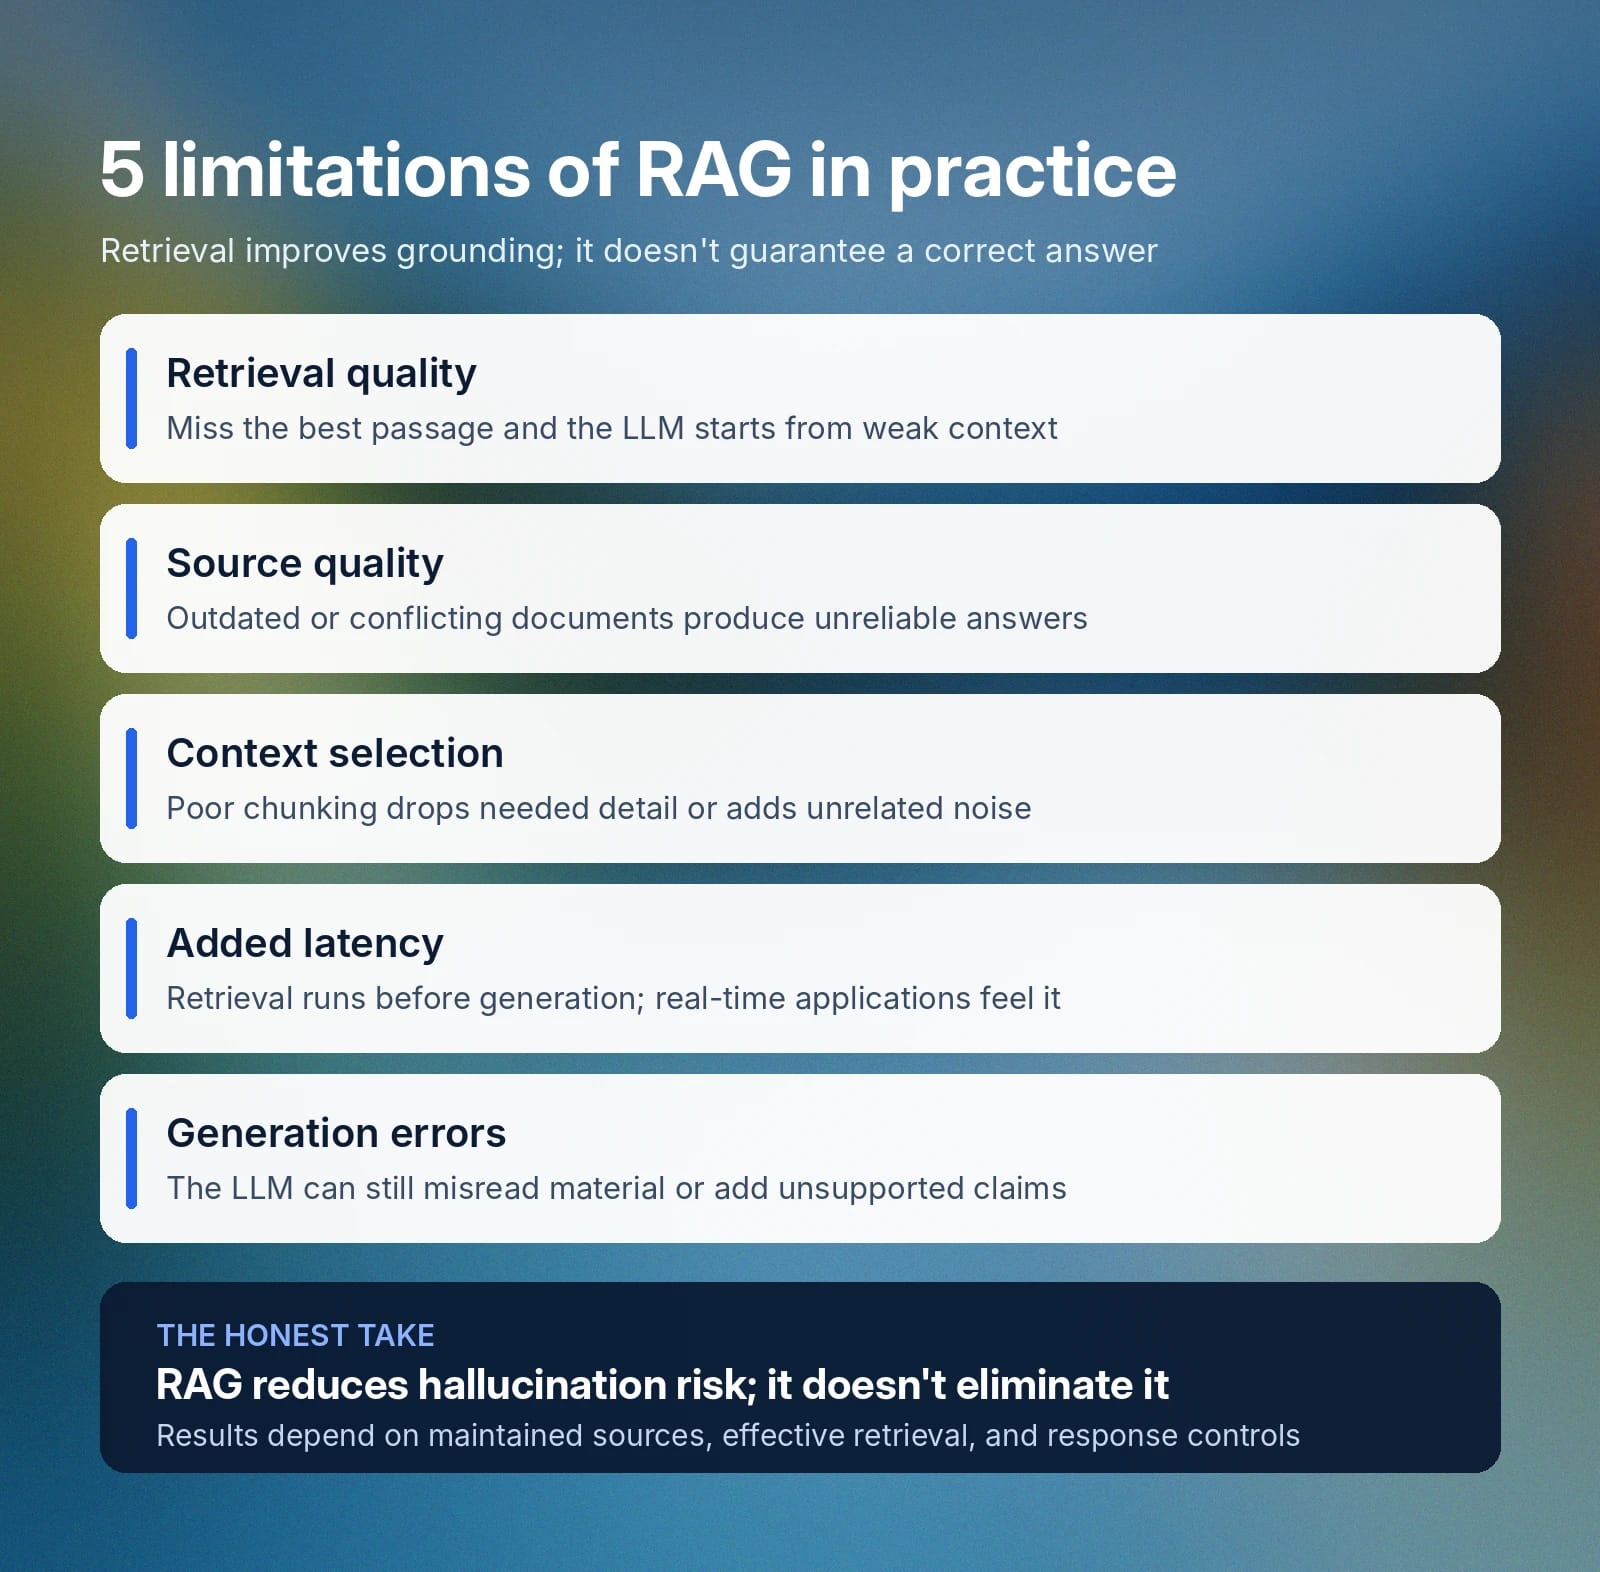
RAG verbetert de toegang tot relevante bedrijfskennis die buiten het LLM is opgeslagen, maar retrieval heeft ook eigen beperkingen en garandeert geen juist antwoord. De belangrijkste beperkingen zitten in wat het systeem ophaalt, wat het naar het model stuurt en hoe het model reageert:
- Kwaliteit van retrieval: Als het systeem de meest relevante passage mist, begint het LLM met onvolledige of zwakke context. Slecht geformuleerde query's, zwakke semantische overeenkomsten of dubbelzinnige formuleringen kunnen retrieval allemaal de verkeerde kant op sturen.
- Kwaliteit van bronnen: Verouderde, tegenstrijdige of onvolledige documenten kunnen tot onbetrouwbare antwoorden leiden.
- Selectie van context: Slechte keuzes bij chunking of retrieval kunnen benodigde details weglaten of irrelevante informatie toevoegen.
- Extra latency: Retrieval en queryverwerking vinden plaats vóór het genereren, waardoor antwoorden in realtime toepassingen trager kunnen worden.
- Generatiefouten: Het LLM kan opgehaalde informatie nog steeds verkeerd interpreteren of ongefundeerde beweringen toevoegen.
Hoewel RAG het risico op hallucinaties kan verkleinen, neemt het dit niet volledig weg. Nauwkeurige resultaten hangen nog steeds af van goed onderhouden bronnen, effectieve retrieval en controles rond het uiteindelijke antwoord.
RAG in generatieve AI: praktische toepassingen en voordelen
RAG is het nuttigst wanneer een AI-toepassing informatie nodig heeft die vaak verandert, eigendom is van de organisatie of te groot is om in elk modelverzoek op te nemen.
Hier maakt RAG het grootste verschil:
Bijblijven met vaak bijgewerkte informatie
RAG helpt teams AI-antwoorden af te stemmen op actuele productgegevens, prijzen, beleid en voorraad. Teams kunnen de broninformatie onafhankelijk bijwerken en RAG haalt de relevante versie op wanneer er een vraag wordt gesteld. Een agent voor leadkwalificatie kan bijvoorbeeld de nieuwste prijs- of abonnementsgegevens ophalen bij het kwalificeren van een inkomende beller.
Private of gespecialiseerde kennis gebruiken
Sommige kennis is privaat of gespecialiseerd in plaats van openbaar, zoals intern beleid, technische documentatie of supportcontent voor een specifiek team. Met RAG kan een agent rechtstreeks uit deze bronnen ophalen, in plaats van alleen te vertrouwen op wat openbaar beschikbaar is of in het model is ingebouwd.
Een interne IT- of HR-helpdeskagent kan bijvoorbeeld gegevens ophalen uit een HR-specifieke kennisbank om vragen over werknemersvoordelen te beantwoorden, in plaats van openbare documentatie te doorzoeken die deze informatie niet bevat.
Grote kennisbanken doorzoeken
RAG helpt wanneer een bedrijf veel meer documentatie heeft dan een LLM in één verzoek kan verwerken. Het haalt alleen de passages op die relevant zijn voor de huidige vraag, in plaats van de volledige verzameling naar het model te sturen. In een verkoopomgeving kan een technische assistent tijdens een gesprek producthandleidingen doorzoeken om relevante vereisten te vinden.
Ga aan de slag met ElevenAgents voor geavanceerde RAG-oplossingen
Met ElevenAgents kunnen teams AI-stem- en chatagents bouwen die RAG met gekoppelde kennisbronnen gebruiken, via het no-code webplatform of de API voor teams die agents rechtstreeks in hun eigen producten willen integreren.
Voor agents met RAG kunnen teams documenten, URL's of tekst toevoegen aan een kennisbank en alleen de informatie ophalen die relevant is voor elke query.
ElevenLabs heeft retrieval ook geoptimaliseerd voor realtime gesprekken en de mediane RAG-latency in de ElevenAgents-architectuur teruggebracht van 326 ms naar 155 ms. Teams die met ElevenAgents bouwen, krijgen deze retrievalmogelijkheden standaard, of ze nu een agent configureren via het dashboard of erop voortbouwen via de API.
Begin met bouwen met ElevenAgents of neem contact op met ons team om de juiste opzet voor je toepassing te bespreken.
Veelgestelde vragen over RAG

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.



