Hoe we RAG 50% sneller hebben gemaakt
- Geschreven door
- Michal Korbela
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
RAG verbetert de nauwkeurigheid van AI-agents door LLM-antwoorden te baseren op grote kennisbanken. In plaats van de volledige kennisbank naar het LLM te sturen, embedt RAG de query, haalt het de meest relevante informatie op en geeft die als context door aan het model. In ons systeem voegen we eerst een stap voor het herschrijven van queries toe, waarbij de dialooggeschiedenis vóór het ophalen wordt samengevat in een nauwkeurige, op zichzelf staande query.
Voor zeer kleine kennisbanken kan het eenvoudiger zijn om alles rechtstreeks in de prompt mee te geven. Maar zodra de kennisbank groter wordt, RAG essentieel om antwoorden nauwkeurig te houden zonder het model te overbelasten.
Veel systemen behandelen RAG als een externe tool, maar wij hebben het rechtstreeks in de requestpipeline gebouwd, zodat het bij elke query wordt uitgevoerd. Dit zorgt voor consistente nauwkeurigheid, maar brengt ook een latentierisico met zich mee.
Waarom het herschrijven van queries ons vertraagde
De meeste gebruikersverzoeken verwijzen naar eerdere beurten, dus het systeem moet de dialooggeschiedenis samenvatten in een nauwkeurige, op zichzelf staande query.
Bijvoorbeeld:
- Als de gebruiker vraagt: “Kunnen we die limieten aanpassen op basis van onze piekverkeerspatronen?"
- Herschrijft het systeem dit naar: “Kunnen API-ratelimieten voor het Enterprise-abonnement worden aangepast aan specifieke verkeerspatronen?”
Door het herschrijven worden vage verwijzingen zoals “die limieten” omgezet in op zichzelf staande queries die ophaalsystemen kunnen gebruiken. Dit verbetert de context en nauwkeurigheid van het uiteindelijke antwoord. Maar doordat we afhankelijk waren van één extern gehost LLM, ontstond er een sterke afhankelijkheid van de snelheid en beschikbaarheid ervan. Deze stap alleen was verantwoordelijk voor meer dan 80% van de RAG-latentie.
Hoe we dit met model racing hebben opgelost
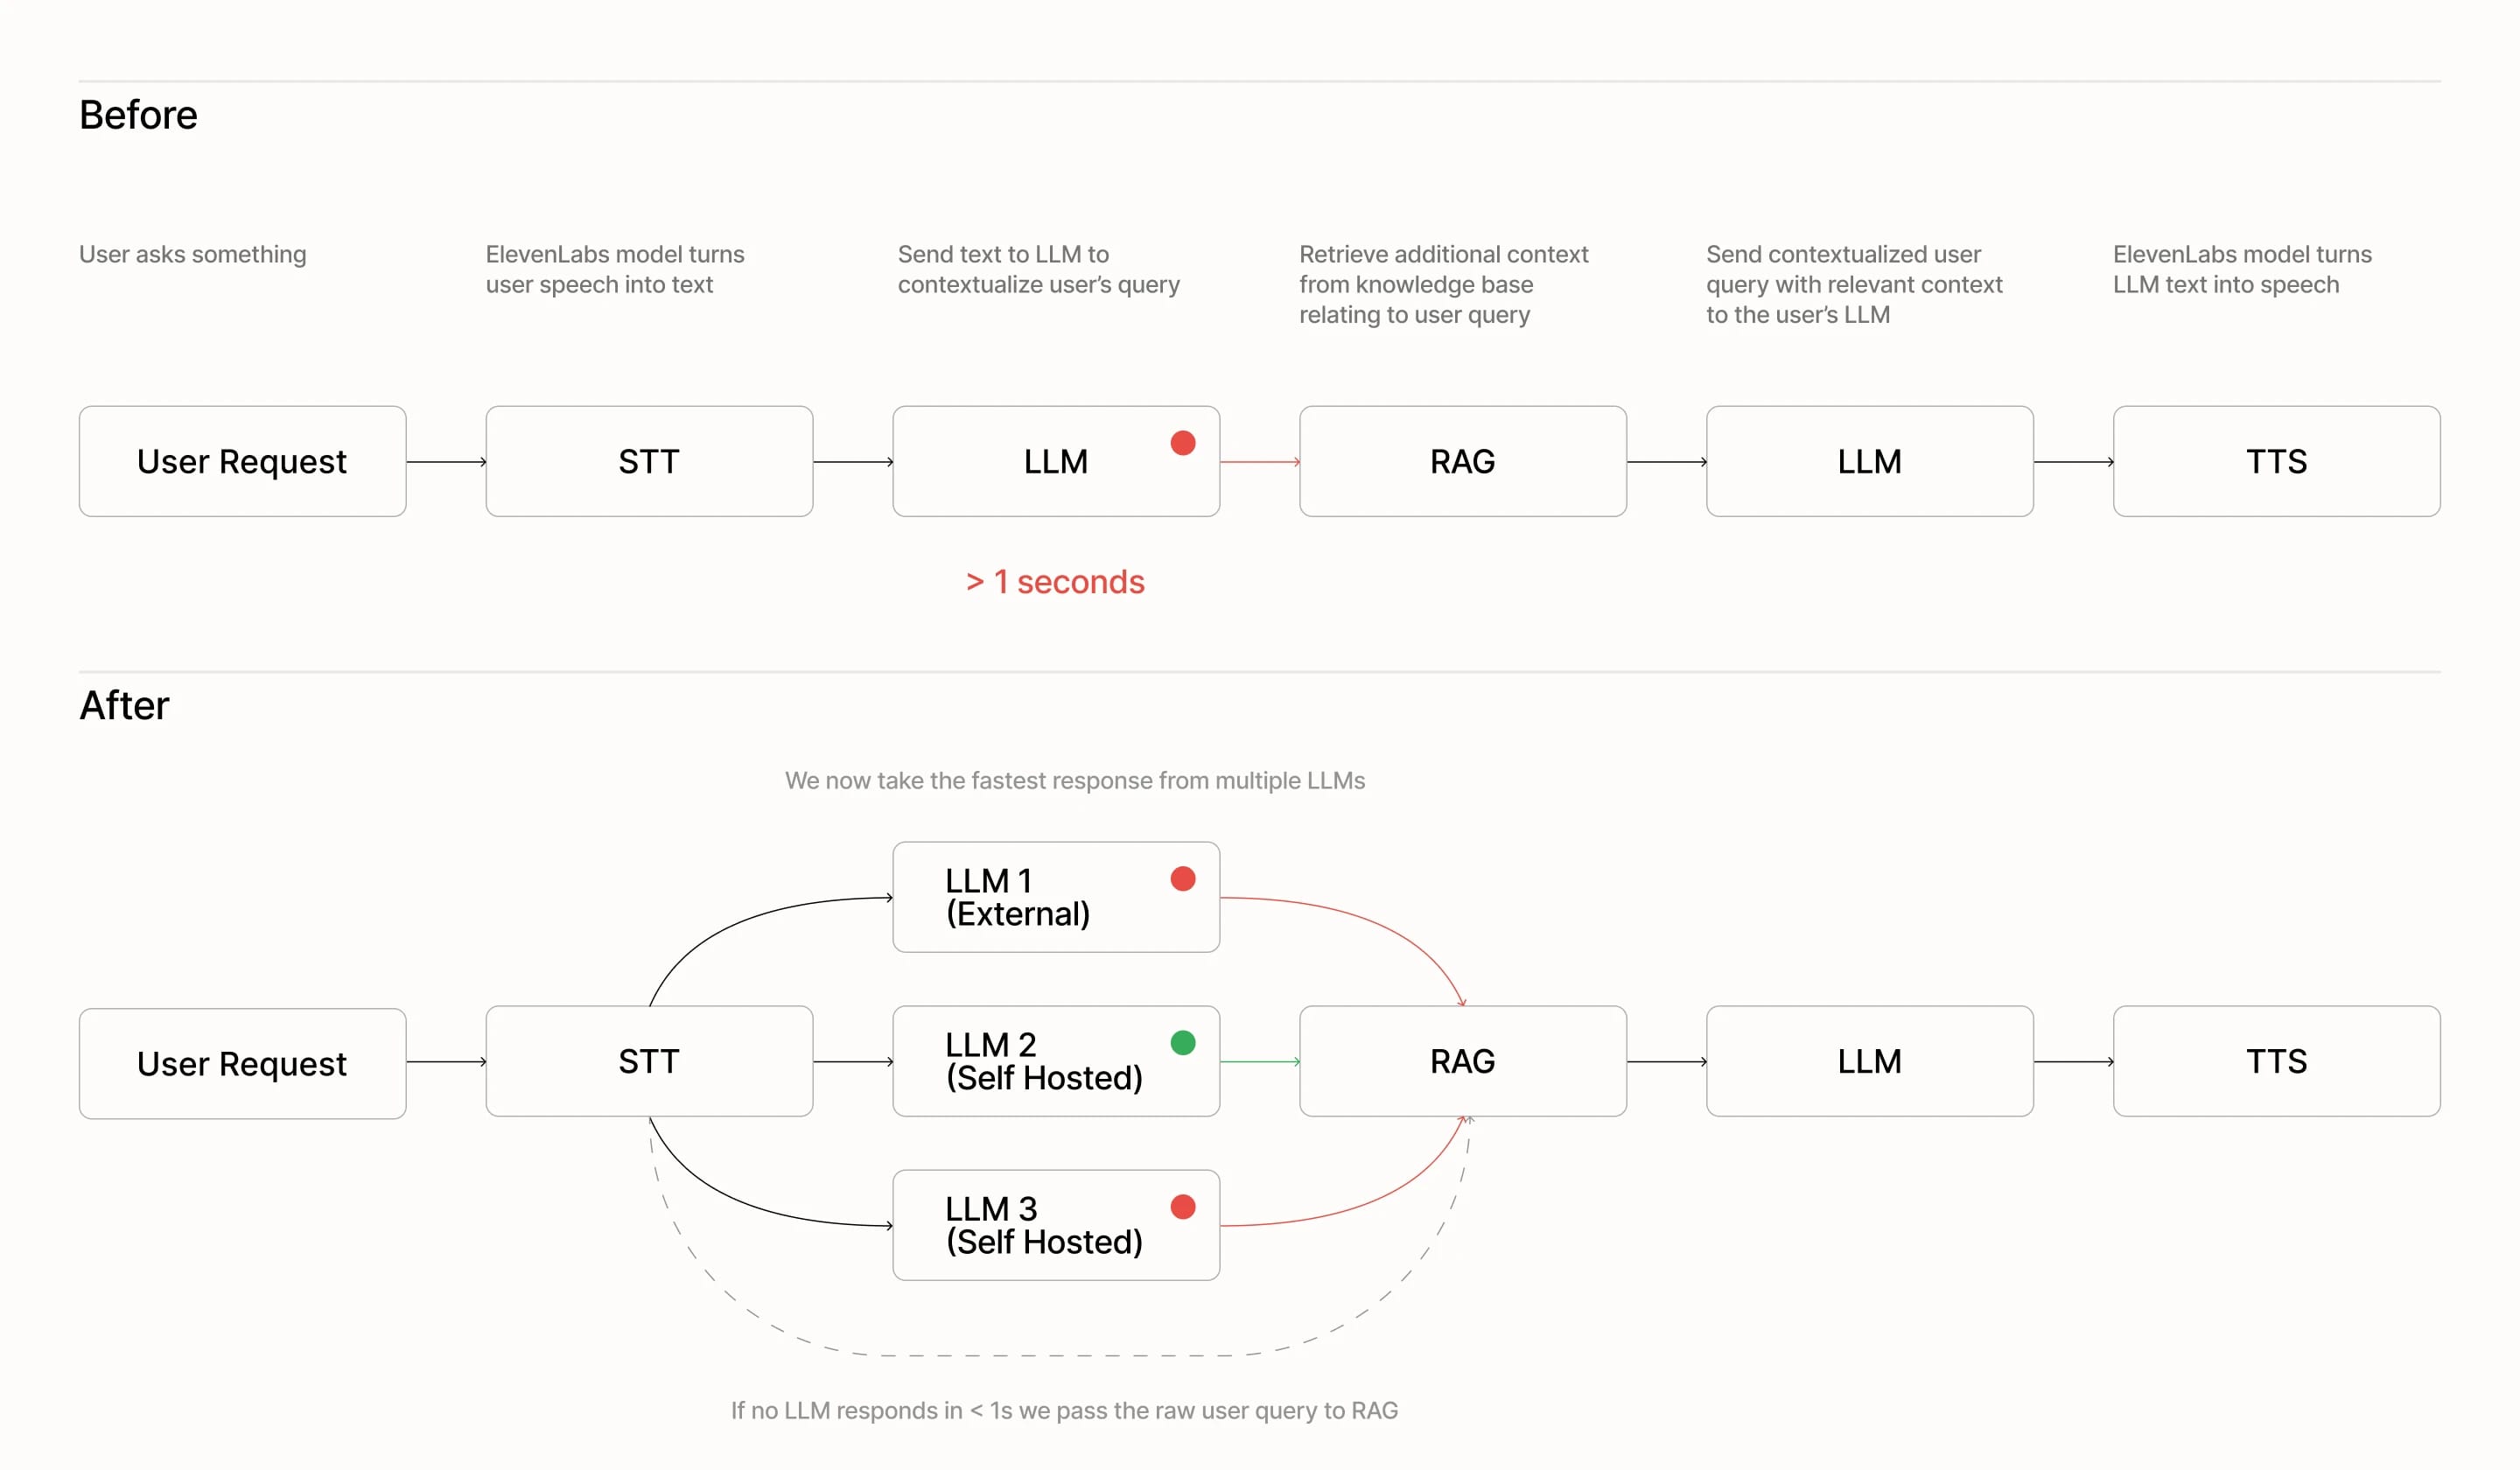
We hebben het herschrijven van queries opnieuw ontworpen als een race:
- Meerdere modellen parallel. Elke query wordt tegelijk naar meerdere modellen gestuurd, waaronder onze zelfgehoste Qwen 3-4B- en 3-30B-A3B-modellen. Het eerste geldige antwoord wint.
- Fallbacks die gesprekken gaande houden. Als geen model binnen één seconde reageert, vallen we terug op het oorspronkelijke bericht van de gebruiker. Dat is mogelijk minder nauwkeurig, maar voorkomt vertragingen en waarborgt de continuïteit.
De impact op prestaties
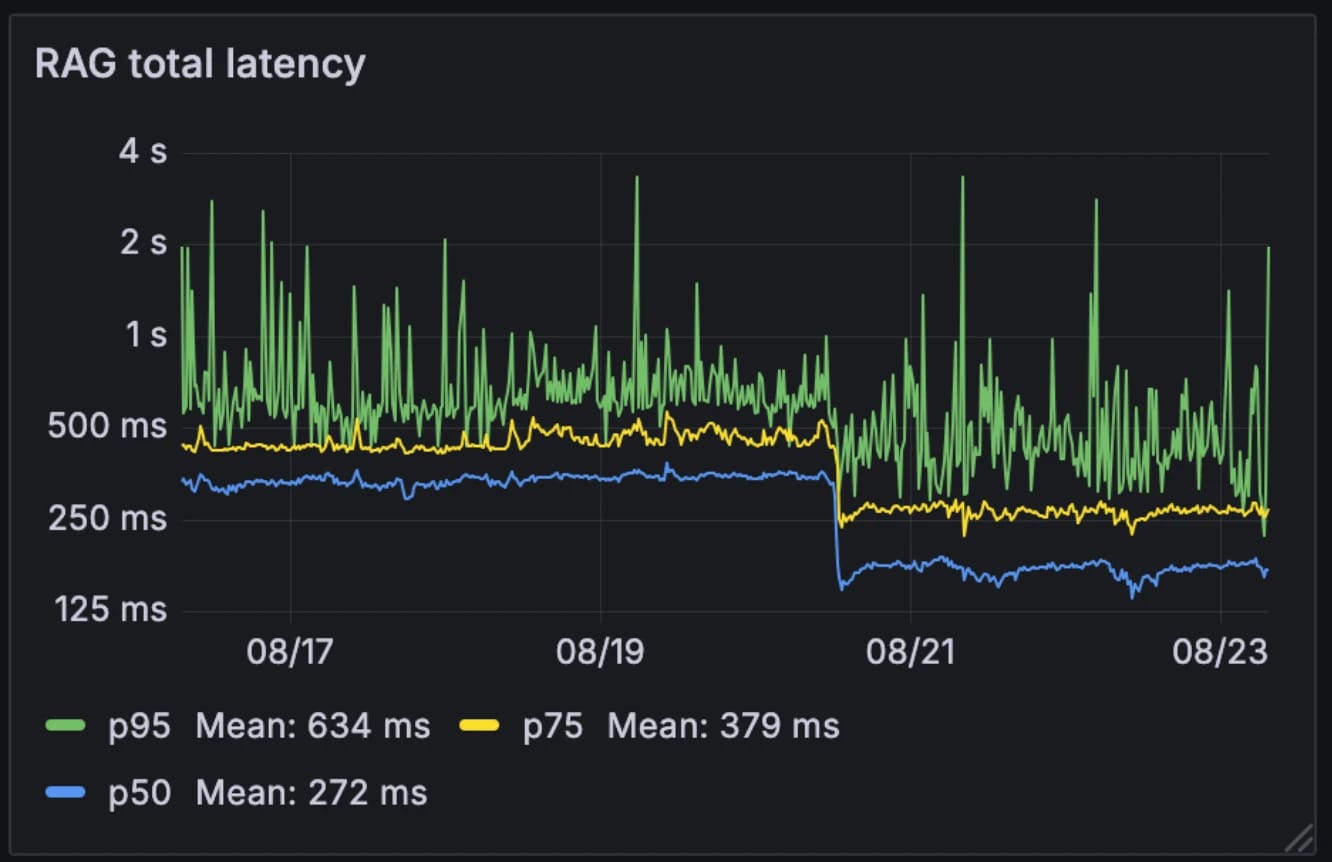
Deze nieuwe architectuur halveerde de mediane RAG-latentie, van 326 ms naar 155 ms. Anders dan veel systemen die RAG selectief als externe tool activeren, voeren wij het bij elke query uit. Nu de mediane latentie is gedaald naar 155 ms, is de overhead hiervan verwaarloosbaar.
Latentie voor en na:
- Mediaan: 326 ms → 155 ms
- p75: 436 ms → 250 ms
- p95: 629 ms → 426 ms
De architectuur maakte het systeem ook robuuster voor verschillen tussen modellen. Extern gehoste modellen kunnen tijdens uren met een piekvraag vertragen, terwijl onze interne modellen relatief consistent blijven. Door de modellen tegen elkaar te laten racen, vlakken we deze variatie af en zetten we onvoorspelbare prestaties van individuele modellen om in stabieler systeemgedrag.
Toen een van onze LLM-providers vorige maand bijvoorbeeld een storing had, liepen gesprekken naadloos door op onze zelfgehoste modellen. Omdat we deze infrastructuur al voor andere diensten gebruiken, zijn de extra compute-kosten verwaarloosbaar.
Waarom dit belangrijk is
RAG-queryherschrijving onder 200 ms neemt een belangrijk knelpunt voor conversationele agents weg. Het resultaat is een systeem dat zowel contextbewust als realtime blijft, zelfs bij grote kennisbanken voor ondernemingen. Nu de overhead voor het ophalen van informatie vrijwel verwaarloosbaar is, kunnen conversationele agents schalen zonder concessies te doen aan de prestaties.
Michal is a backend engineer on the ElevenLabs Agents Platform