
Wat is een LLM? Een praktische gids voor taalmodellen
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
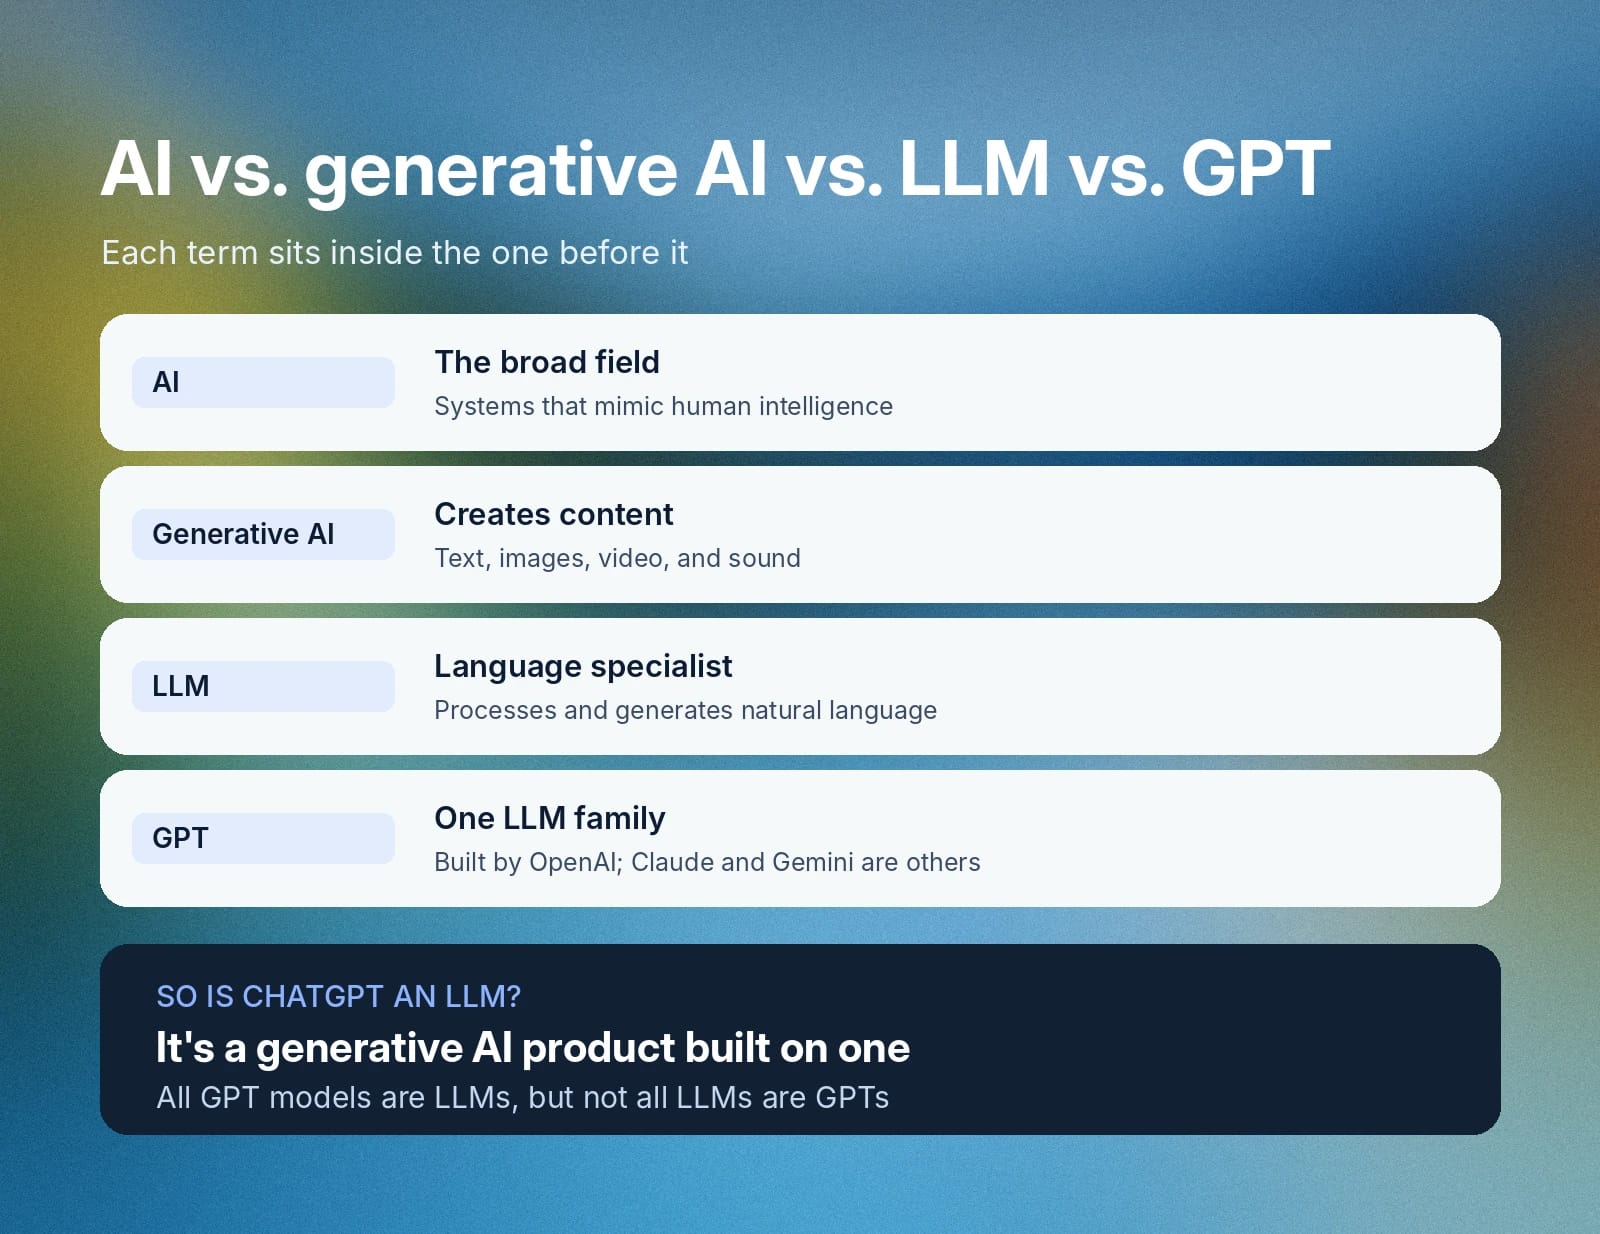
Een groot taalmodel (LLM) is een systeem voor kunstmatige intelligentie dat op een enorme dataset is getraind om natuurlijke taal te analyseren, voorspellen en genereren. Bekende LLM's zijn de GPT-modellen van OpenAI, Claude van Anthropic en Gemini van Google, die vaak worden gebruikt voor bijvoorbeeld schrijven, redigeren en programmeren.
Aanvankelijk bevatten LLM-datasets vooral tekst uit bronnen zoals boeken, blogs en zelfs onlineforums. Moderne LLM's gebruiken nu multimodale data om meer toepassingen mogelijk te maken, zoals het aandrijven van conversatiegerichte stemagents of het maken van muziek.
Voordat organisaties deze technologie implementeren, hebben ze vaak antwoorden nodig op vragen als: wat is een LLM, hoe werkt een LLM en welke architecturen moet het team gebruiken? Deze gids behandelt die vragen en laat ook toepassingen van de technologie in de praktijk en de concrete voordelen ervan zien.
Samenvatting
- Een groot taalmodel (LLM) is een AI-model dat is getraind op enorme datasets met tekst en multimodale data, met als doel output te analyseren, voorspellen en genereren.
- Het belangrijkste verschil tussen GPT's en LLM's is dat GPT (Generative Pre-trained Transformer) een specifieke familie van LLM's is die door OpenAI is ontwikkeld, terwijl LLM de overkoepelende term is voor modellen zoals Claude en Gemini.
- Generatieve AI is de brede categorie voor modellen die op basis van trainingsdata allerlei soorten content creëren, terwijl LLM's een gespecialiseerde subcategorie van generatieve AI zijn die zich richt op natuurlijke-taalverwerking.
- LLM's gebruiken transformer-neurale netwerken om tekst op te delen in kleinere eenheden die tokens worden genoemd, en voorspellen vervolgens het volgende token op basis van contextuele informatie uit de prompt en de bestaande chatgeschiedenis.
- Praktische voorbeelden van grote taalmodellen zijn chatbots voor klantenservice, geautomatiseerde schrijftools, codegeneratoren en lagen voor natuurlijke-taalverwerking in stemtoepassingen.
Wat is een LLM? De definitie van een groot taalmodel
Een groot taalmodel is een AI-programma dat is gebouwd op neurale netwerken voor deep learning om natuurlijke taal te analyseren, voorspellen en genereren. Ontwikkelaars hebben deze modellen getraind op datasets met miljarden werken uit boeken, wetenschappelijke artikelen, websites en blogs. De term 'groot' verwijst zowel naar de enorme hoeveelheid data die wordt gebruikt om deze modellen te trainen als naar de miljarden interne parameters die hun gedrag bepalen.
Grote taalmodellen vormen een grote verandering ten opzichte van hoe eerdere software werkte: traditionele software was afhankelijk van expliciete syntaxiscommando's, maar LLM's niet. In plaats van elk woord afzonderlijk te verwerken, gebruiken LLM's contextuele verbanden om complexe taalpatronen en grammatica te herkennen. Ze interpreteren ongestructureerde menselijke taal en blijven reageren op open prompts van gebruikers, waarbij ze zich aanpassen aan contextwijzigingen midden in een gesprek.
Deze ontwikkelingen in natuurlijke-taalverwerking voorzien ElevenAgents van de mogelijkheden om complexe klantintenties te begrijpen en geautomatiseerde workflows uit te voeren.
Hoe werken grote taalmodellen?
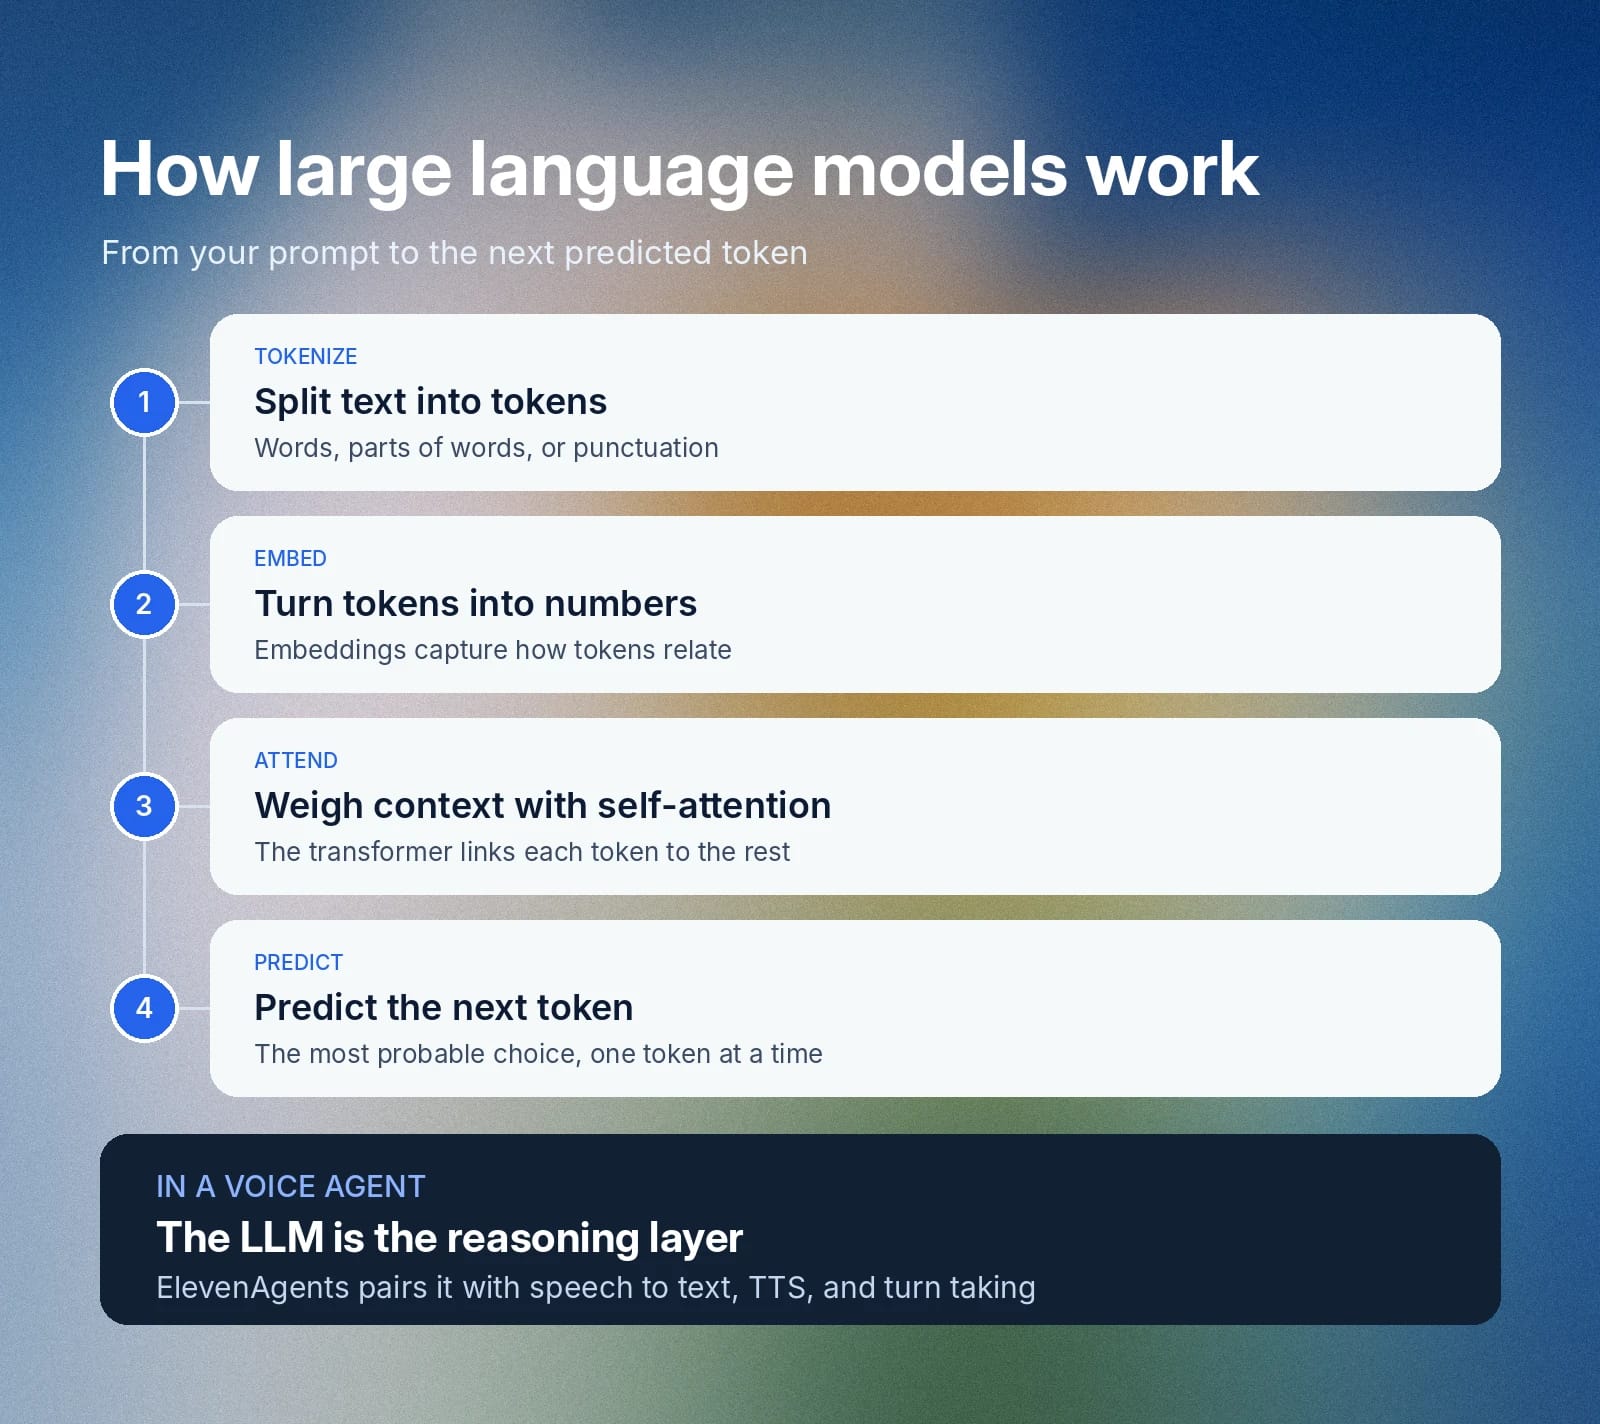
Grote taalmodellen verwerken tekst via kunstmatige neurale netwerken om invoer in natuurlijke taal te analyseren en relevante content te genereren. Het proces begint met tokenisatie, waarbij het model invoertekst opdeelt in kleinere eenheden die tokens worden genoemd. Vervolgens zet het model deze tokens om in numerieke representaties (embeddings genoemd) om wiskundige of statistische relaties tussen tokens te beoordelen.
De meeste moderne LLM-systemen zijn gebaseerd op de architectuur van transformer-neurale netwerken. Transformers gebruiken zelfattentiemechanismen, die de contextuele relaties tussen tokens beoordelen. Het model voorspelt het statistisch meest waarschijnlijke token om een reeks te voltooien door aangeleerde patronen te gebruiken om waarschijnlijkheidsverdelingen te berekenen.
Zelfattentie stelt modellen voor natuurlijke-taalverwerking in staat om context over lange afstanden te behouden en zich aan te passen aan veranderingen midden in een gesprek. Platformintegraties met ElevenAgents bouwen voort op deze mogelijkheden om relevante reacties met lage latentie te leveren die natuurlijke menselijke gesprekken nabootsen.
Wat is temperatuur in een LLM?
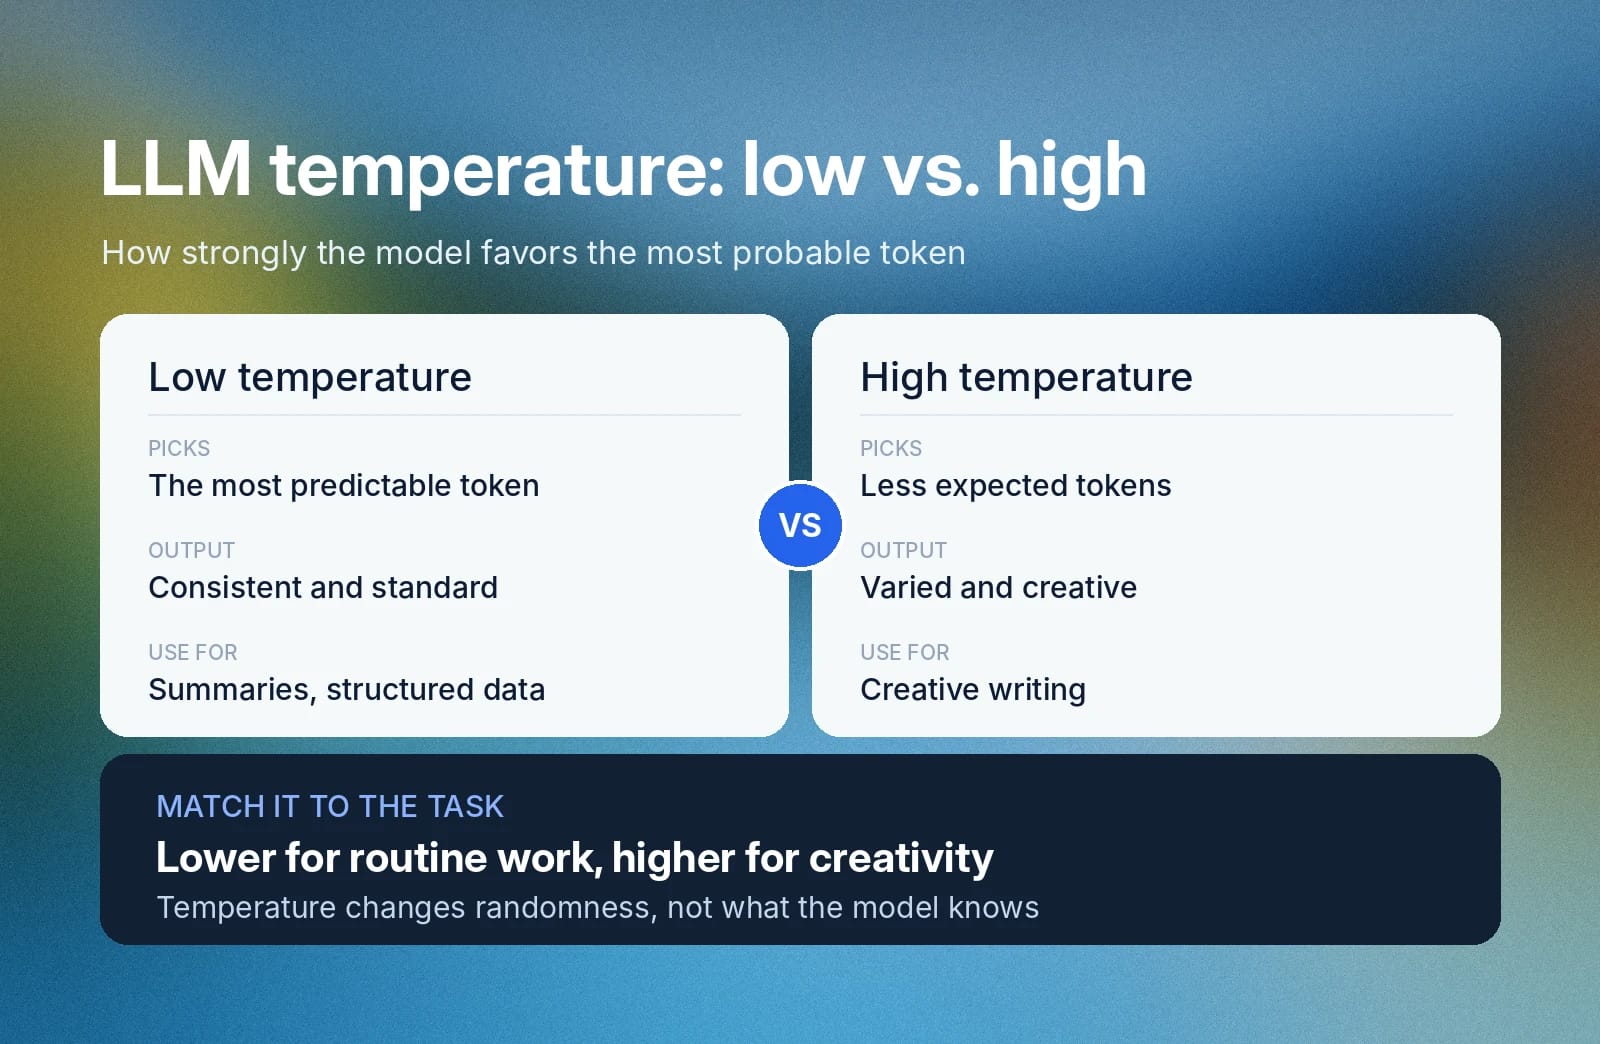
De LLM-temperatuur is een variabele instelling die ontwikkelaars kunnen configureren om te bepalen hoe willekeurig de output van een LLM wordt. LLM's genereren het volgende token in een reeks woorden door de meest voorkomende optie te kiezen. Bij elke keuze die een LLM maakt, kunnen er echter meerdere alternatieven zijn met een vergelijkbare weging.
Door de LLM-temperatuur aan te passen, verander je hoe sterk een LLM de voorkeur geeft aan de meest waarschijnlijke optie. Een lage temperatuurinstelling levert standaard en consistente output op, omdat het model dan meestal het meest voorspelbare volgende token in een reeks kiest. Een hoge temperatuur wijkt daarentegen vaker af van de verwachte keuze en levert creatievere en gevarieerdere output op.
Pas de temperatuurwaarde van je LLM aan op de taak die je wilt uitvoeren. Alles waarbij creativiteit nodig is, vraagt om hogere temperaturen, terwijl routinetaken of gestructureerde output, zoals gegevenssamenvattingen, beter met lagere temperaturen werken.
Hoe worden LLM's getraind en gefinetuned?
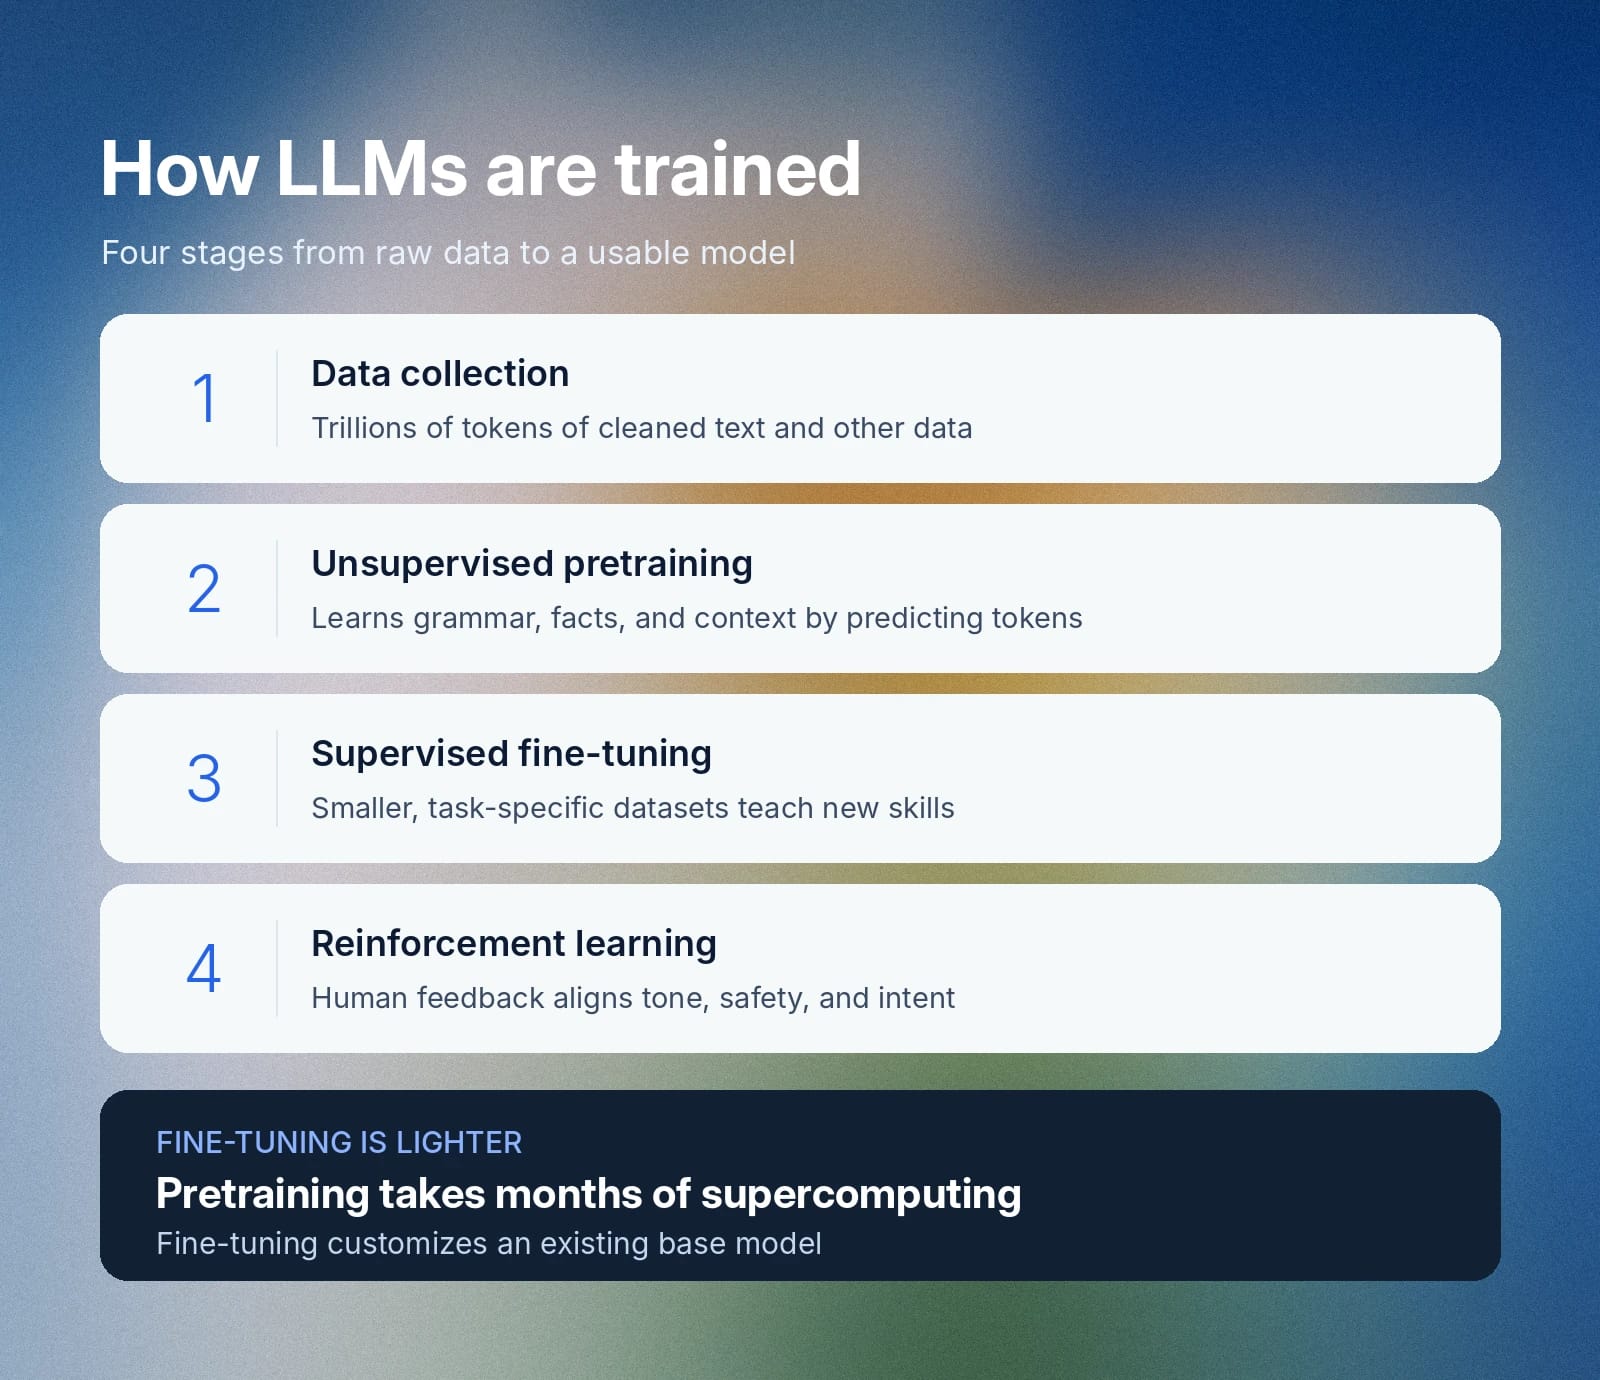
Het trainen van LLM's vereist een meerfasig proces om ruwe tekst en multimodale data om te zetten in functionele taalsystemen. Bedrijven hebben geavanceerde supercomputercapaciteit nodig die meerdere maanden draait, terwijl fine-tuning een lichter proces is waarmee het bestaande basismodel wordt aangepast.
Toonaangevende AI-bedrijven behandelen hun precieze trainingsproces doorgaans als bedrijfsinformatie en de meeste maken broncode of gewichten niet openbaar. Toch verloopt training doorgaans volgens dit proces:
- Dataverzameling en voorbewerking: Ontwikkelaars bouwen datasets uit meerdere bronnen met pretrainingscorpora die biljoenen tokens uit terabytes aan opgeschoonde tekst bevatten. Tekst scrapen of minen uit internetbronnen is een van de belangrijkste manieren waarop bedrijven deze datasets opbouwen.
- Onbegeleide pretraining: Het grote taalmodel leest biljoenen tokens om grammaticaregels, feitelijke verbanden en taalkundige context te leren. Het traint zichzelf in wezen vooraf via autoregressieve taalmodellering, aangedreven door zelfattentiemechanismen die het statistisch waarschijnlijke volgende token in een reeks berekenen.
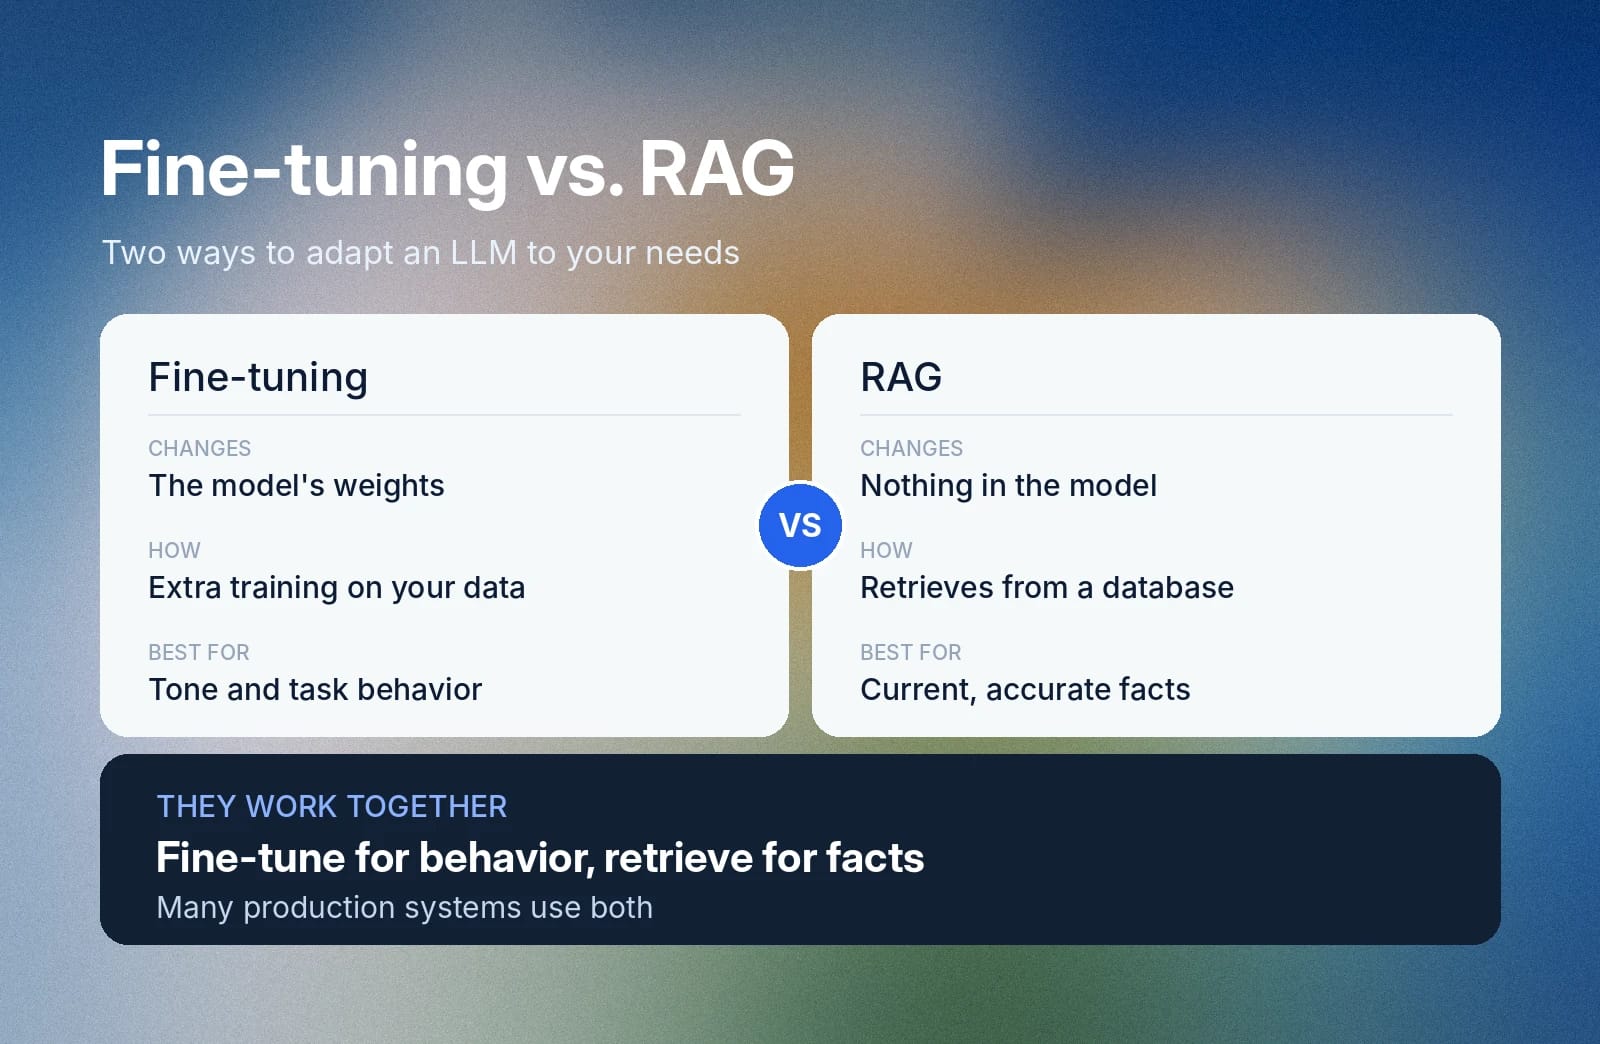
- Begeleide fine-tuning: Engineers gebruiken kleinere, taakspecifiekere datasets om het vooraf getrainde model aan te passen. Deze stap leert het model specifieke vaardigheden, van het beantwoorden van algemene vragen tot het genereren van logo's of het uitvoeren van laboratoriumonderzoek.
- Reinforcement learning en afstemming: Ontwikkelaars verfijnen het gedrag van het model met feedback van menselijke beoordelaars en beloningsmodellen. In deze fase worden modeloutputs afgestemd op veiligheidsrichtlijnen, vereisten voor de toon en menselijke intentie.
Typen LLM-architecturen: encoders, decoders en hybride modellen
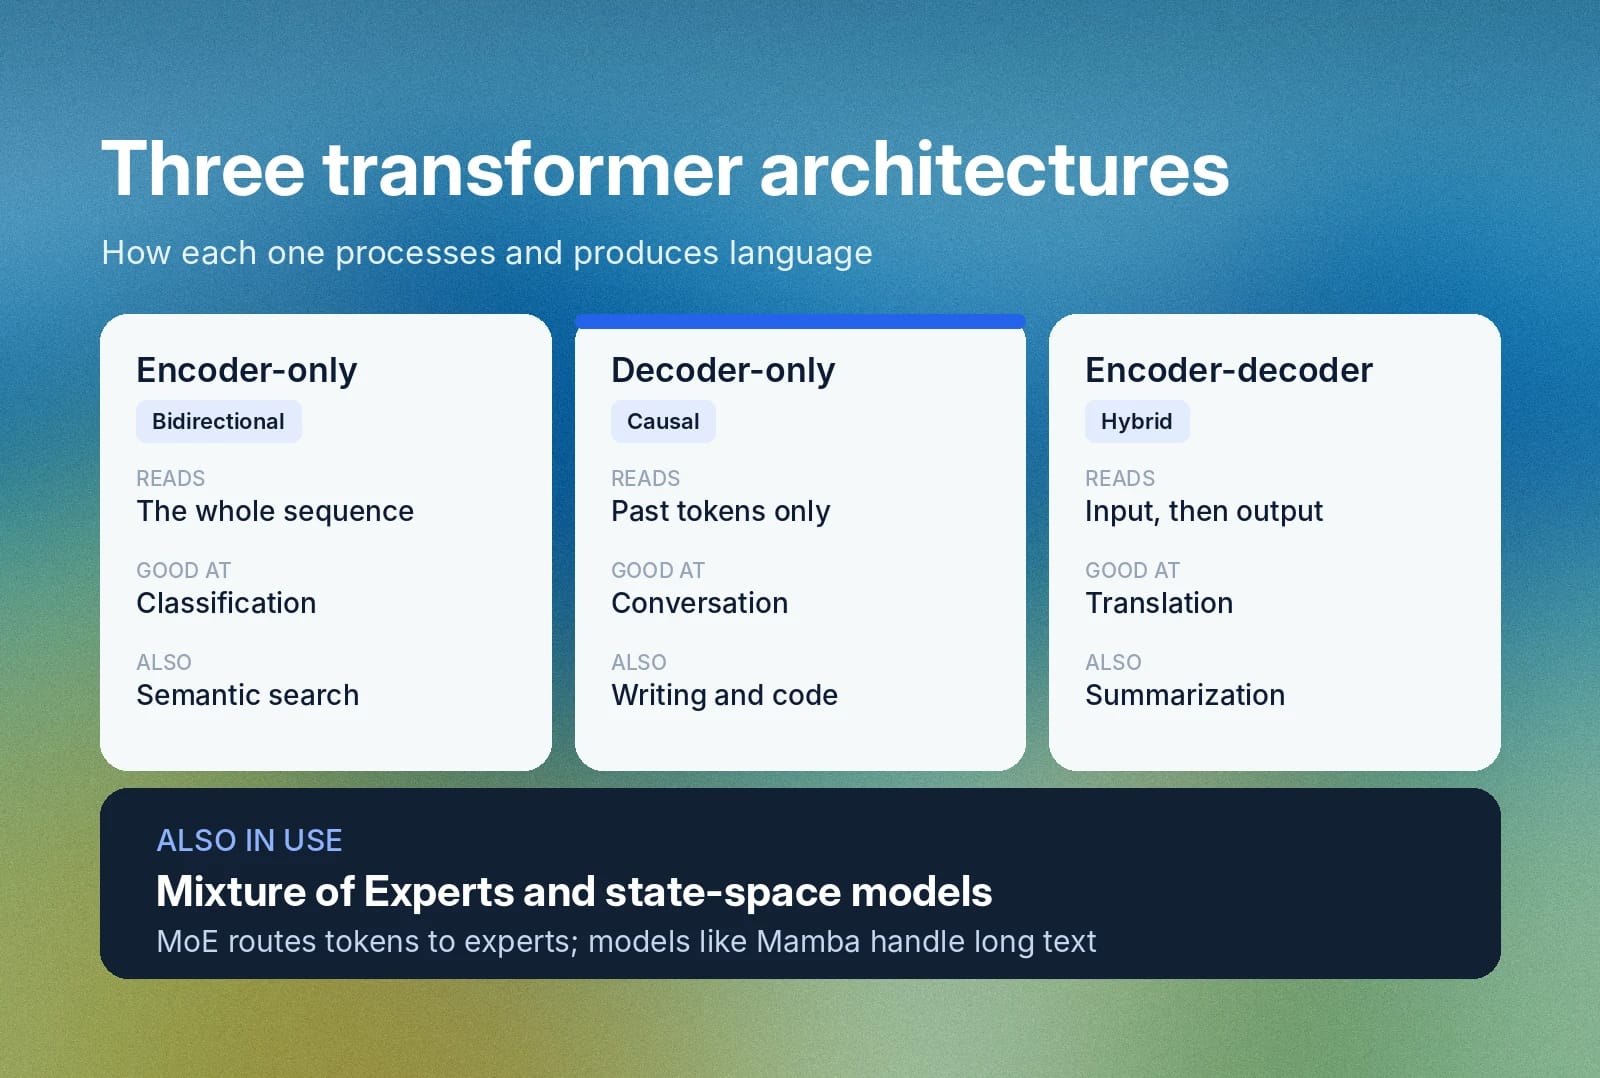
Transformerarchitecturen organiseren lagen van neurale netwerken op verschillende manieren om invoer te verwerken en content te produceren. Klassieke transformers vallen in drie hoofdcategorieën: alleen-encoder-, alleen-decoder- en encoder-decoder- (hybride) modellen. Moderne systemen gebruiken echter ook efficiënte architecturen om prestaties op te schalen.
Modellen met alleen een encoder
Architecturen met alleen een encoder verwerken volledige reeksen tegelijk met bidirectionele zelfattentie. Hierdoor kan de machine de relatie van elk token met andere eerdere en toekomstige tokens afwegen. In de praktijk optimaliseert dit modellen voor taken zoals:
- Tekstclassificatie
- Sentimentanalyse
- Informatieterugwinning
- Semantisch zoeken
Dit soort taken komt ook voor in spraakworkflows. Het Scribe-model voor speech to text van ElevenLabs transcribeert spraak in meer dan 90 talen, en de functie voor entiteitsdetectie markeert gevoelige details en aanstootgevende taal in transcripties.
Modellen met alleen een decoder
Architecturen met alleen een decoder gebruiken causale aandacht om tokens te verwerken en voorspellen elk woord op basis van eerdere tokens. Deze modellen genereren vloeiende gesprekken en vormen de hoofdarchitectuur achter moderne conversatiegerichte chatbots, open schrijftools en tools voor codegeneratie.
In ElevenAgents genereert de LLM die je kiest, meestal een model met alleen een decoder, de reacties van de agent, terwijl een eigen turn-taking-model de timing van het gesprek afhandelt.
Encoder-decoder- (hybride) modellen
Encoder-decoder-modellen gebruiken een encoder om invoer te verwerken en een decoder om output te genereren. Dankzij deze duale structuur zijn hybride modellen beter geschikt voor taken die strikt contextbehoud vereisen, zoals documentsamenvatting, taalvertaling en het herformatteren van data.
Vertaling is een klassieke encoder-decoder-taak en ElevenLabs Dubbing ondersteunt meer dan 90 talen.
Mixture of Experts (MoE) en state-space-modellen
In plaats van voor elk woord elke parameter van het neurale netwerk te activeren, leidt Mixture of Experts (MoE) afzonderlijke tokens naar kleinere teams van gespecialiseerde 'expert'-subnetwerken. Dit biedt een redeneerdiepte die vergelijkbaar is met enorme modellen, maar met hogere snelheden en lagere rekenkosten. State-space-modellen, zoals Mamba, verwerken ondertussen zeer lange teksten efficiënt.
ElevenAgents bevat open-source LLM's die ElevenLabs in onze eigen infrastructuur host.
Voorbeelden van grote taalmodellen en dagelijkse toepassingen
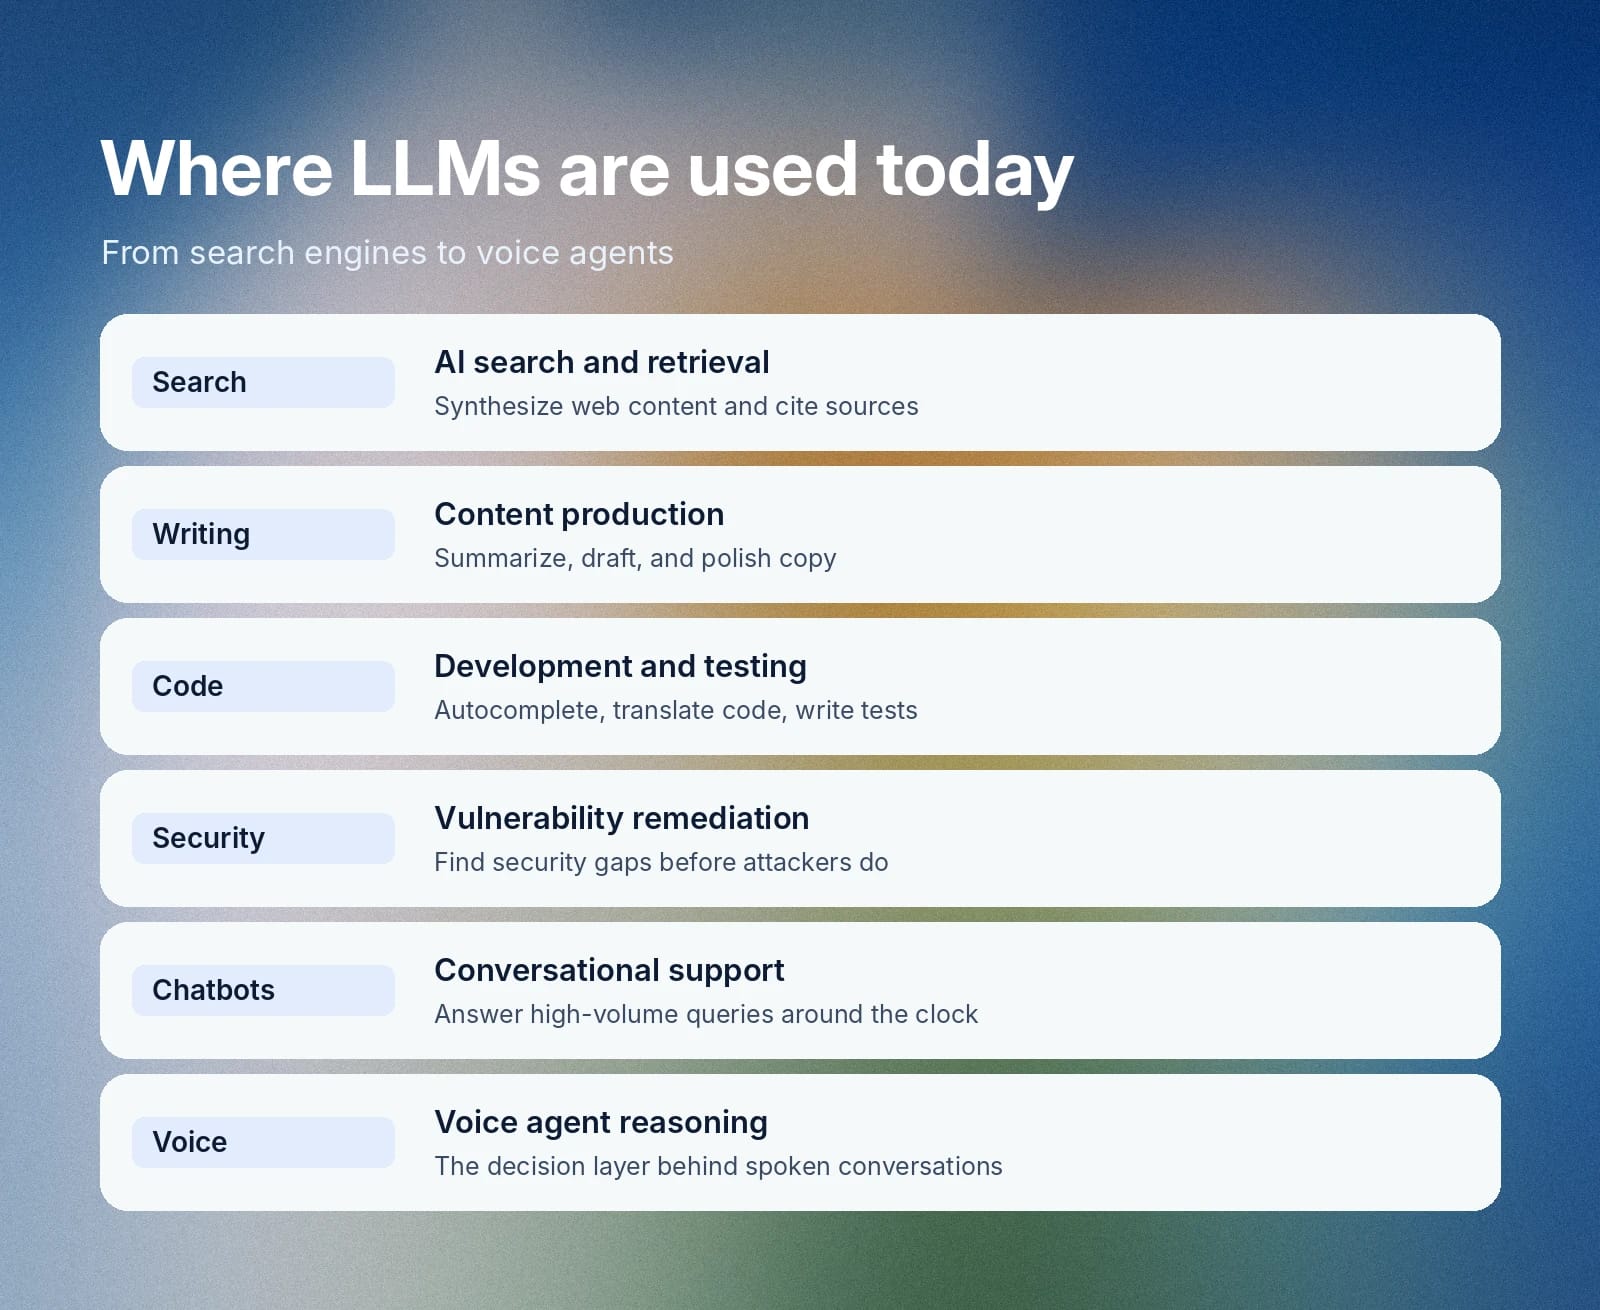
Organisaties hebben een breed scala aan toepassingen voor grote taalmodellen gevonden. Deze toepassingen laten zien hoe AI zich heeft ontwikkeld van experimenteel onderzoek tot een standaardfunctie op het web, in softwaretoepassingen en op alledaagse apparaten. Terwijl AI-wetenschappers de onderliggende architectuur blijven onderzoeken en optimaliseren, laten LLM-voorbeelden uit de praktijk zien hoe teams ze tot nu toe hebben geïmplementeerd:
- AI-zoeken en informatieterugwinning: Conversatiegerichte zoekmachines zoals Bing, Google AI Overviews en Perplexity gebruiken LLM's om webcontent in realtime te analyseren. De modellen synthetiseren informatie, vermelden bronnen rechtstreeks en laten gebruikers vervolgvragen stellen.
- Schrijven, redigeren en contentproductie: LLM's en andere AI-tools maken het eenvoudig om materiaal voor intern en extern gebruik te schrijven en redigeren. NotebookLM vat bijvoorbeeld lange rapporten samen, Jasper AI schrijft advertenties en Grammarly verbetert teksten.
- Codegeneratie, ontwikkeling en testen: AI ondersteunt programmeertools zoals GitHub Copilot bij het automatisch aanvullen van functies en het vertalen van code van de ene programmeertaal naar de andere. Teams kunnen AI ook gebruiken om geautomatiseerde testsuites te genereren, zodat ze bugs eenvoudig kunnen identificeren en oplossen vóór de implementatie.
- Cybersecurity en het oplossen van kwetsbaarheden: Toonaangevende AI-bedrijven hebben gespecialiseerde modellen uitgebracht voor het detecteren van beveiligingslekken. Daarmee kunnen organisaties oplossingen implementeren voordat aanvallers deze kunnen vinden en misbruiken.
- Chatbots en conversatieassistenten: Organisaties zetten conversatie-interfaces in om 24/7 klantenservice te bieden. Door platforms zoals ElevenAgents te integreren, kunnen bedrijven grote hoeveelheden vragen automatiseren met conversatieoplossingen in plaats van op veelgestelde vragen te vertrouwen.
- Redeneerengine voor stemagents: LLM's fungeren ook als de centrale redeneerlaag voor AI-stemsystemen. ElevenAgents koppelt je gekozen LLM aan Speech to Text, Text to Speech met lage latentie en een eigen turn-taking-model om natuurlijke gesprekken in realtime te voeren.
Wat zijn de beperkingen van grote taalmodellen?
Als ruggengraat van de meeste AI-producten waarmee consumenten werken, zijn LLM's een krachtige architectuurcomponent die in veel workflows en toepassingen helpt. Maar als je met LLM's wilt bouwen of je eigen model wilt trainen, moet je rekening houden met hun belangrijkste beperkingen:
- Hallucinaties: Er is geen garantie dat wat een LLM genereert juist is. Een antwoord kan gemakkelijk verzonnen of simpelweg onjuiste informatie bevatten.
- Statische kennis: Zonder RAG is een LLM beperkt tot de vooraf vastgelegde kennisomvang die het tijdens het trainingsproces heeft meegekregen.
- Vooringenomenheid: Als je trainingsdata vooringenomenheid bevat, zal je model die vooringenomenheid weerspiegelen. Dit is vooral belangrijk als je een LLM gebruikt om data te classificeren of beslissingen over informatie te nemen, omdat bepaalde impliciete vooringenomenheid in je data de output ongemerkt negatief kan beïnvloeden.
- Beperkt contextvenster: LLM's werken doorgaans slechts met een vaste hoeveelheid tekst, waardoor langere gesprekken details kunnen verliezen en na verloop van tijd minder effectief worden.
- Kosten en latentie: Hoe groter de LLM, hoe meer rekenkracht nodig is om hem uit te voeren. Kies je voor krachtigere modellen, dan betaal je waarschijnlijk extra voor die betere service.
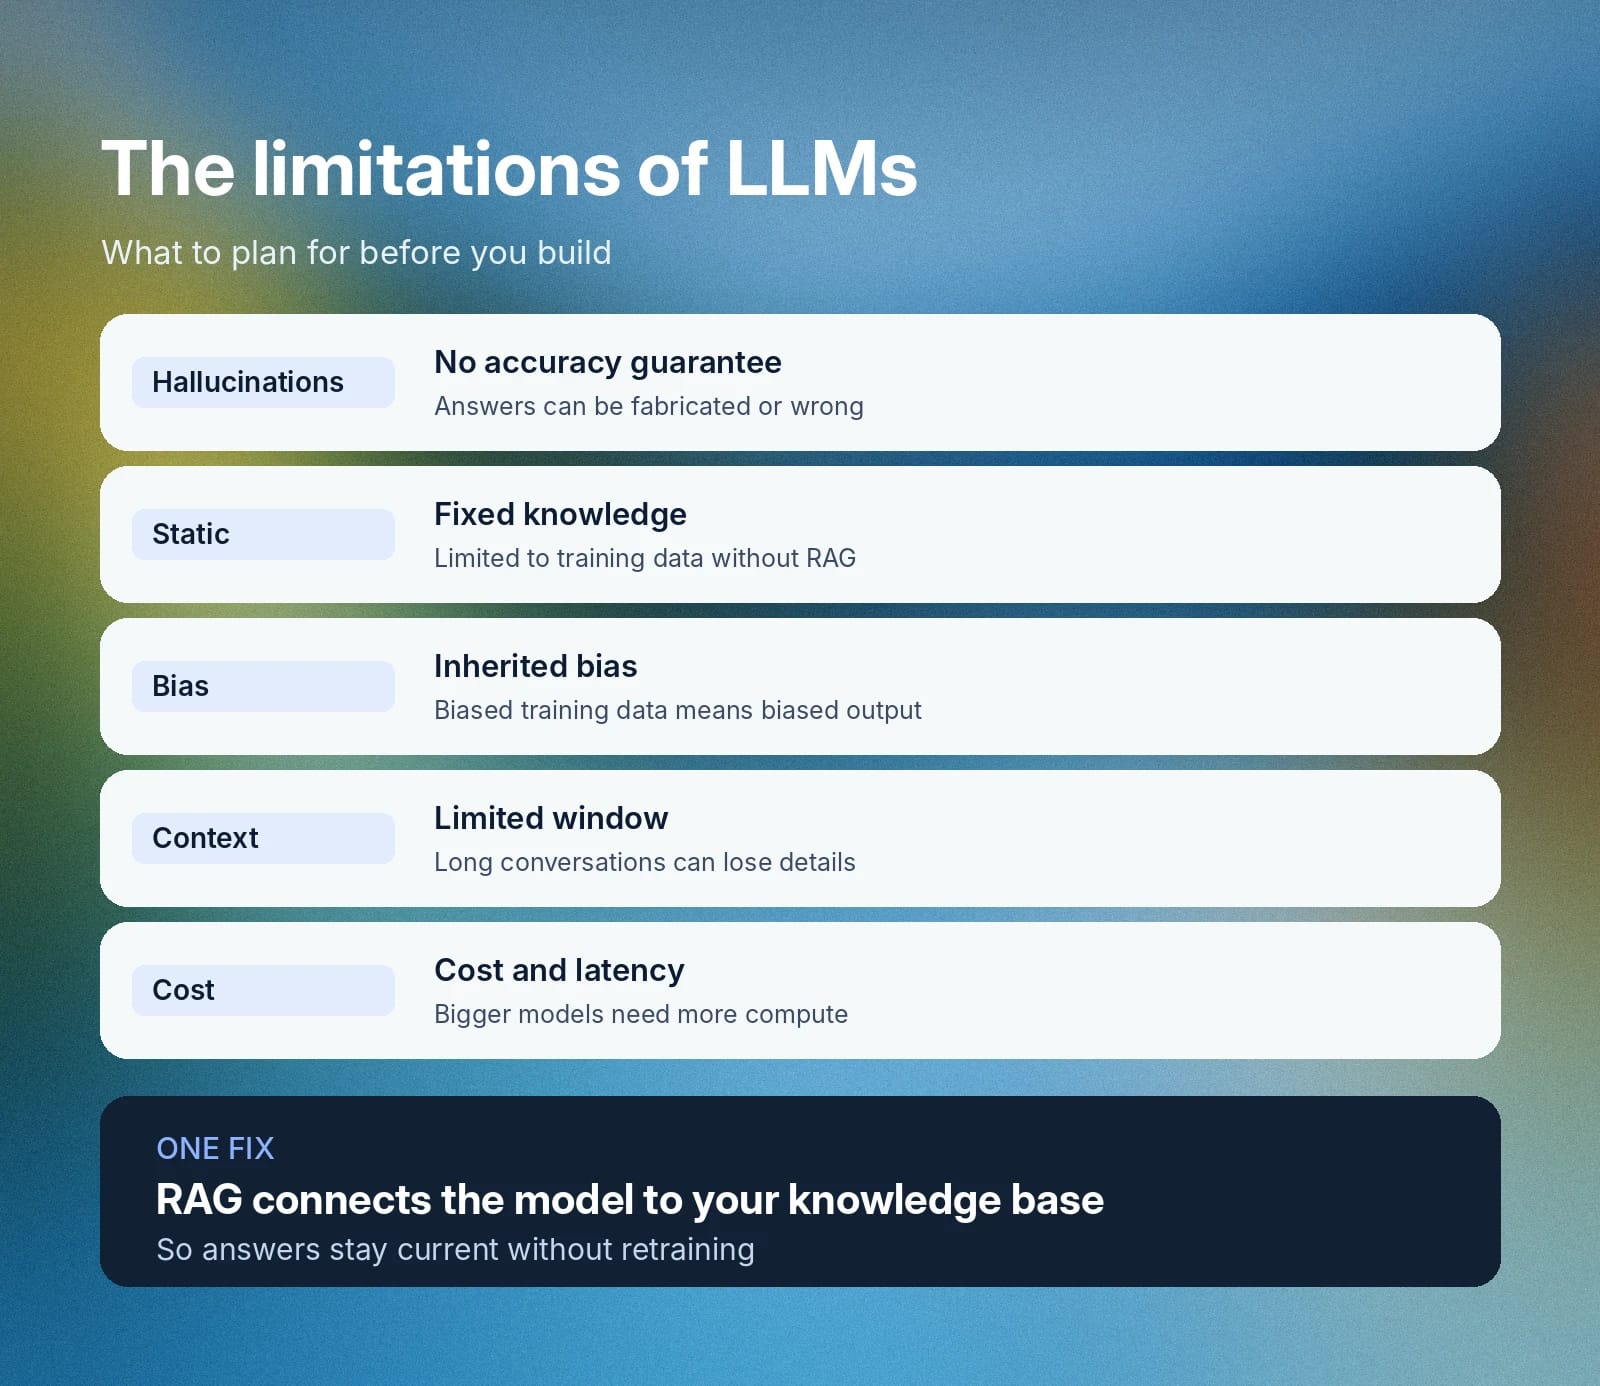
Er zijn verschillende strategieën die je kunt overwegen of implementaties die je kunt toepassen om de impact van deze beperkingen te beperken. Door bijvoorbeeld RAG in een LLM in te schakelen en er een steeds groeiende kennisbank aan te koppelen, kun je het probleem van statische kennis oplossen.
Bouw LLM-ervaringen met spraakondersteuning met ElevenAgents
De keuze voor een groot taalmodel voor je toepassing is een cruciale beslissing die je mogelijk moet aanpassen wanneer je bedrijfsbehoeften en zelfs regelgeving veranderen. Door vendor lock-in te voorkomen, behoud je bedrijfsflexibiliteit en wendbaarheid bij het bouwen van conversatiegerichte stem-AI-oplossingen.
Met ElevenAgents kun je kiezen uit ondersteunde LLM's van aanbieders zoals OpenAI, Anthropic en Google, of via een OpenAI-compatibel endpoint je eigen aangepaste model koppelen. Zo kun je eenvoudig de optimale balans kiezen tussen snelheid, redeneervermogen en kosten voor je specifieke behoeften.
Bekijk ElevenAgents om te zien hoe gehoste LLM's stemworkflows stroomlijnen, of neem contact op met sales om vandaag nog te beginnen met het bouwen van je stemagents met lage latentie.
Veelgestelde vragen over LLM's

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


