Maak kennis met Scribe
- Gepubliceerd
LuisterenLuister naar dit artikel
Scribe, ons eerste Speech to Text-model, is 's werelds nauwkeurigste transcriptiemodel. Scribe is ontwikkeld om de onvoorspelbaarheid van audio uit de praktijk aan te kunnen en transcribeert spraak in 99 talen, met tijdstempels op woordniveau, speaker diarization en tags voor audio-events — allemaal geleverd in een gestructureerde response voor naadloze integratie.
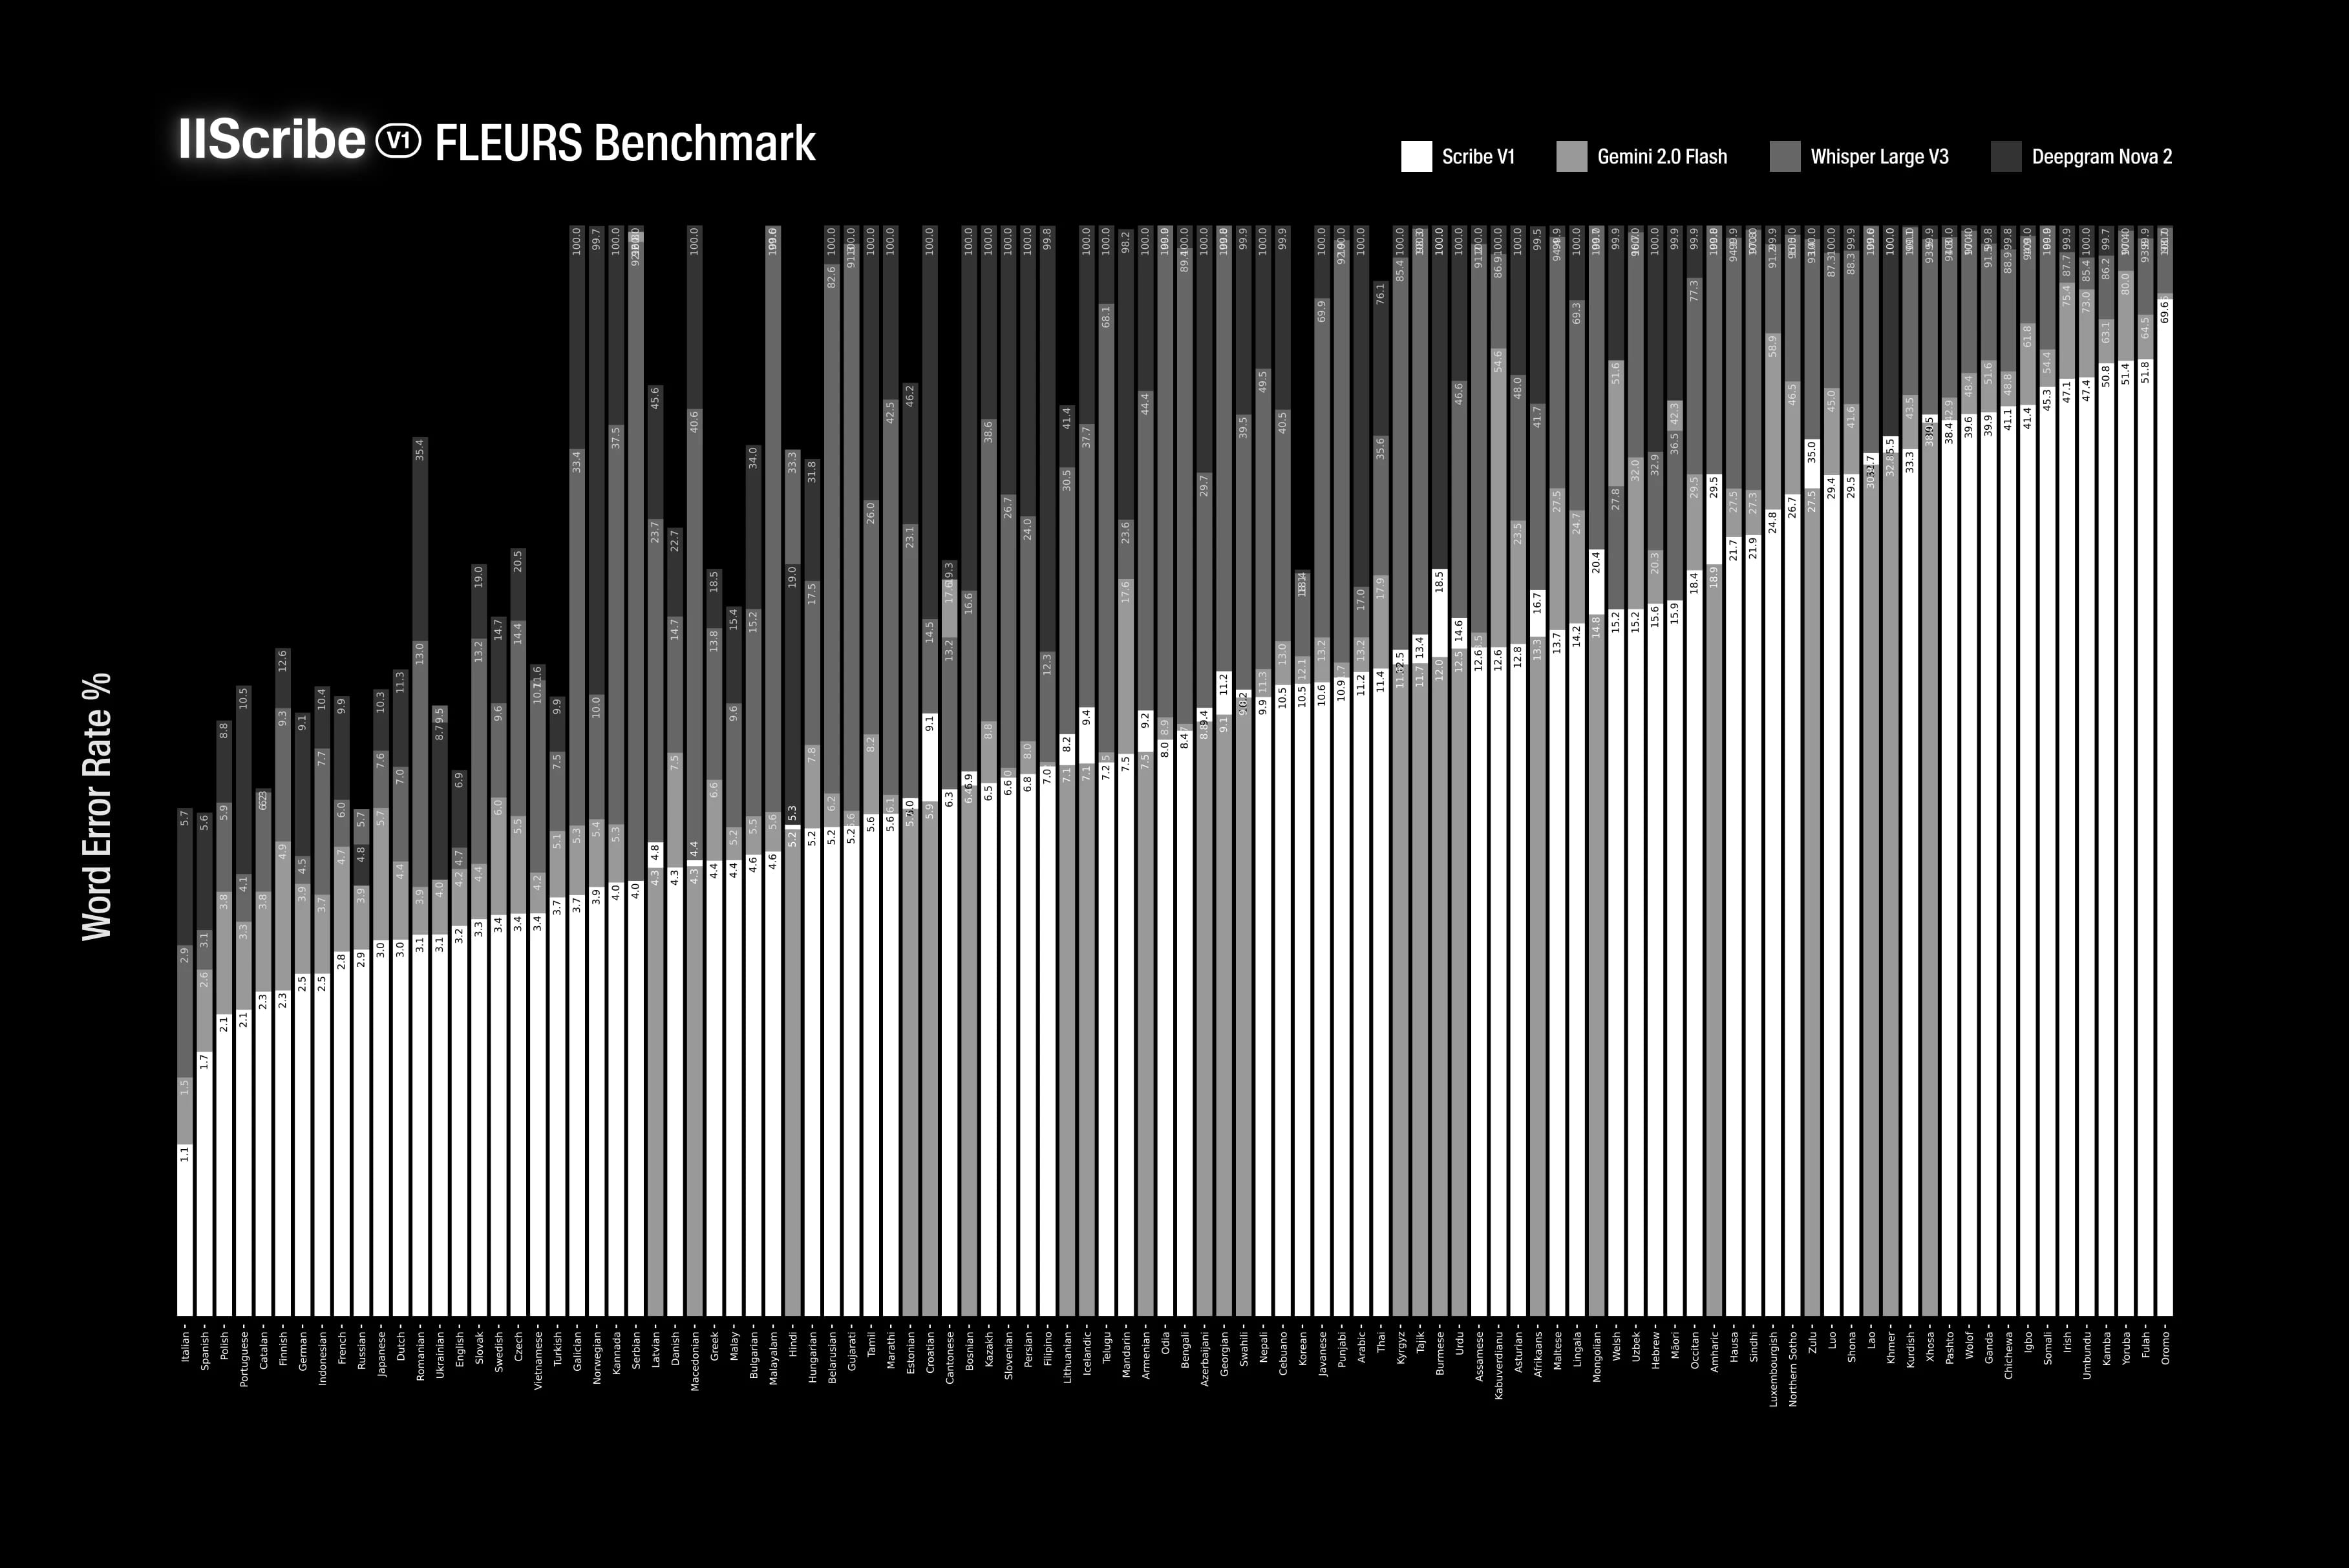
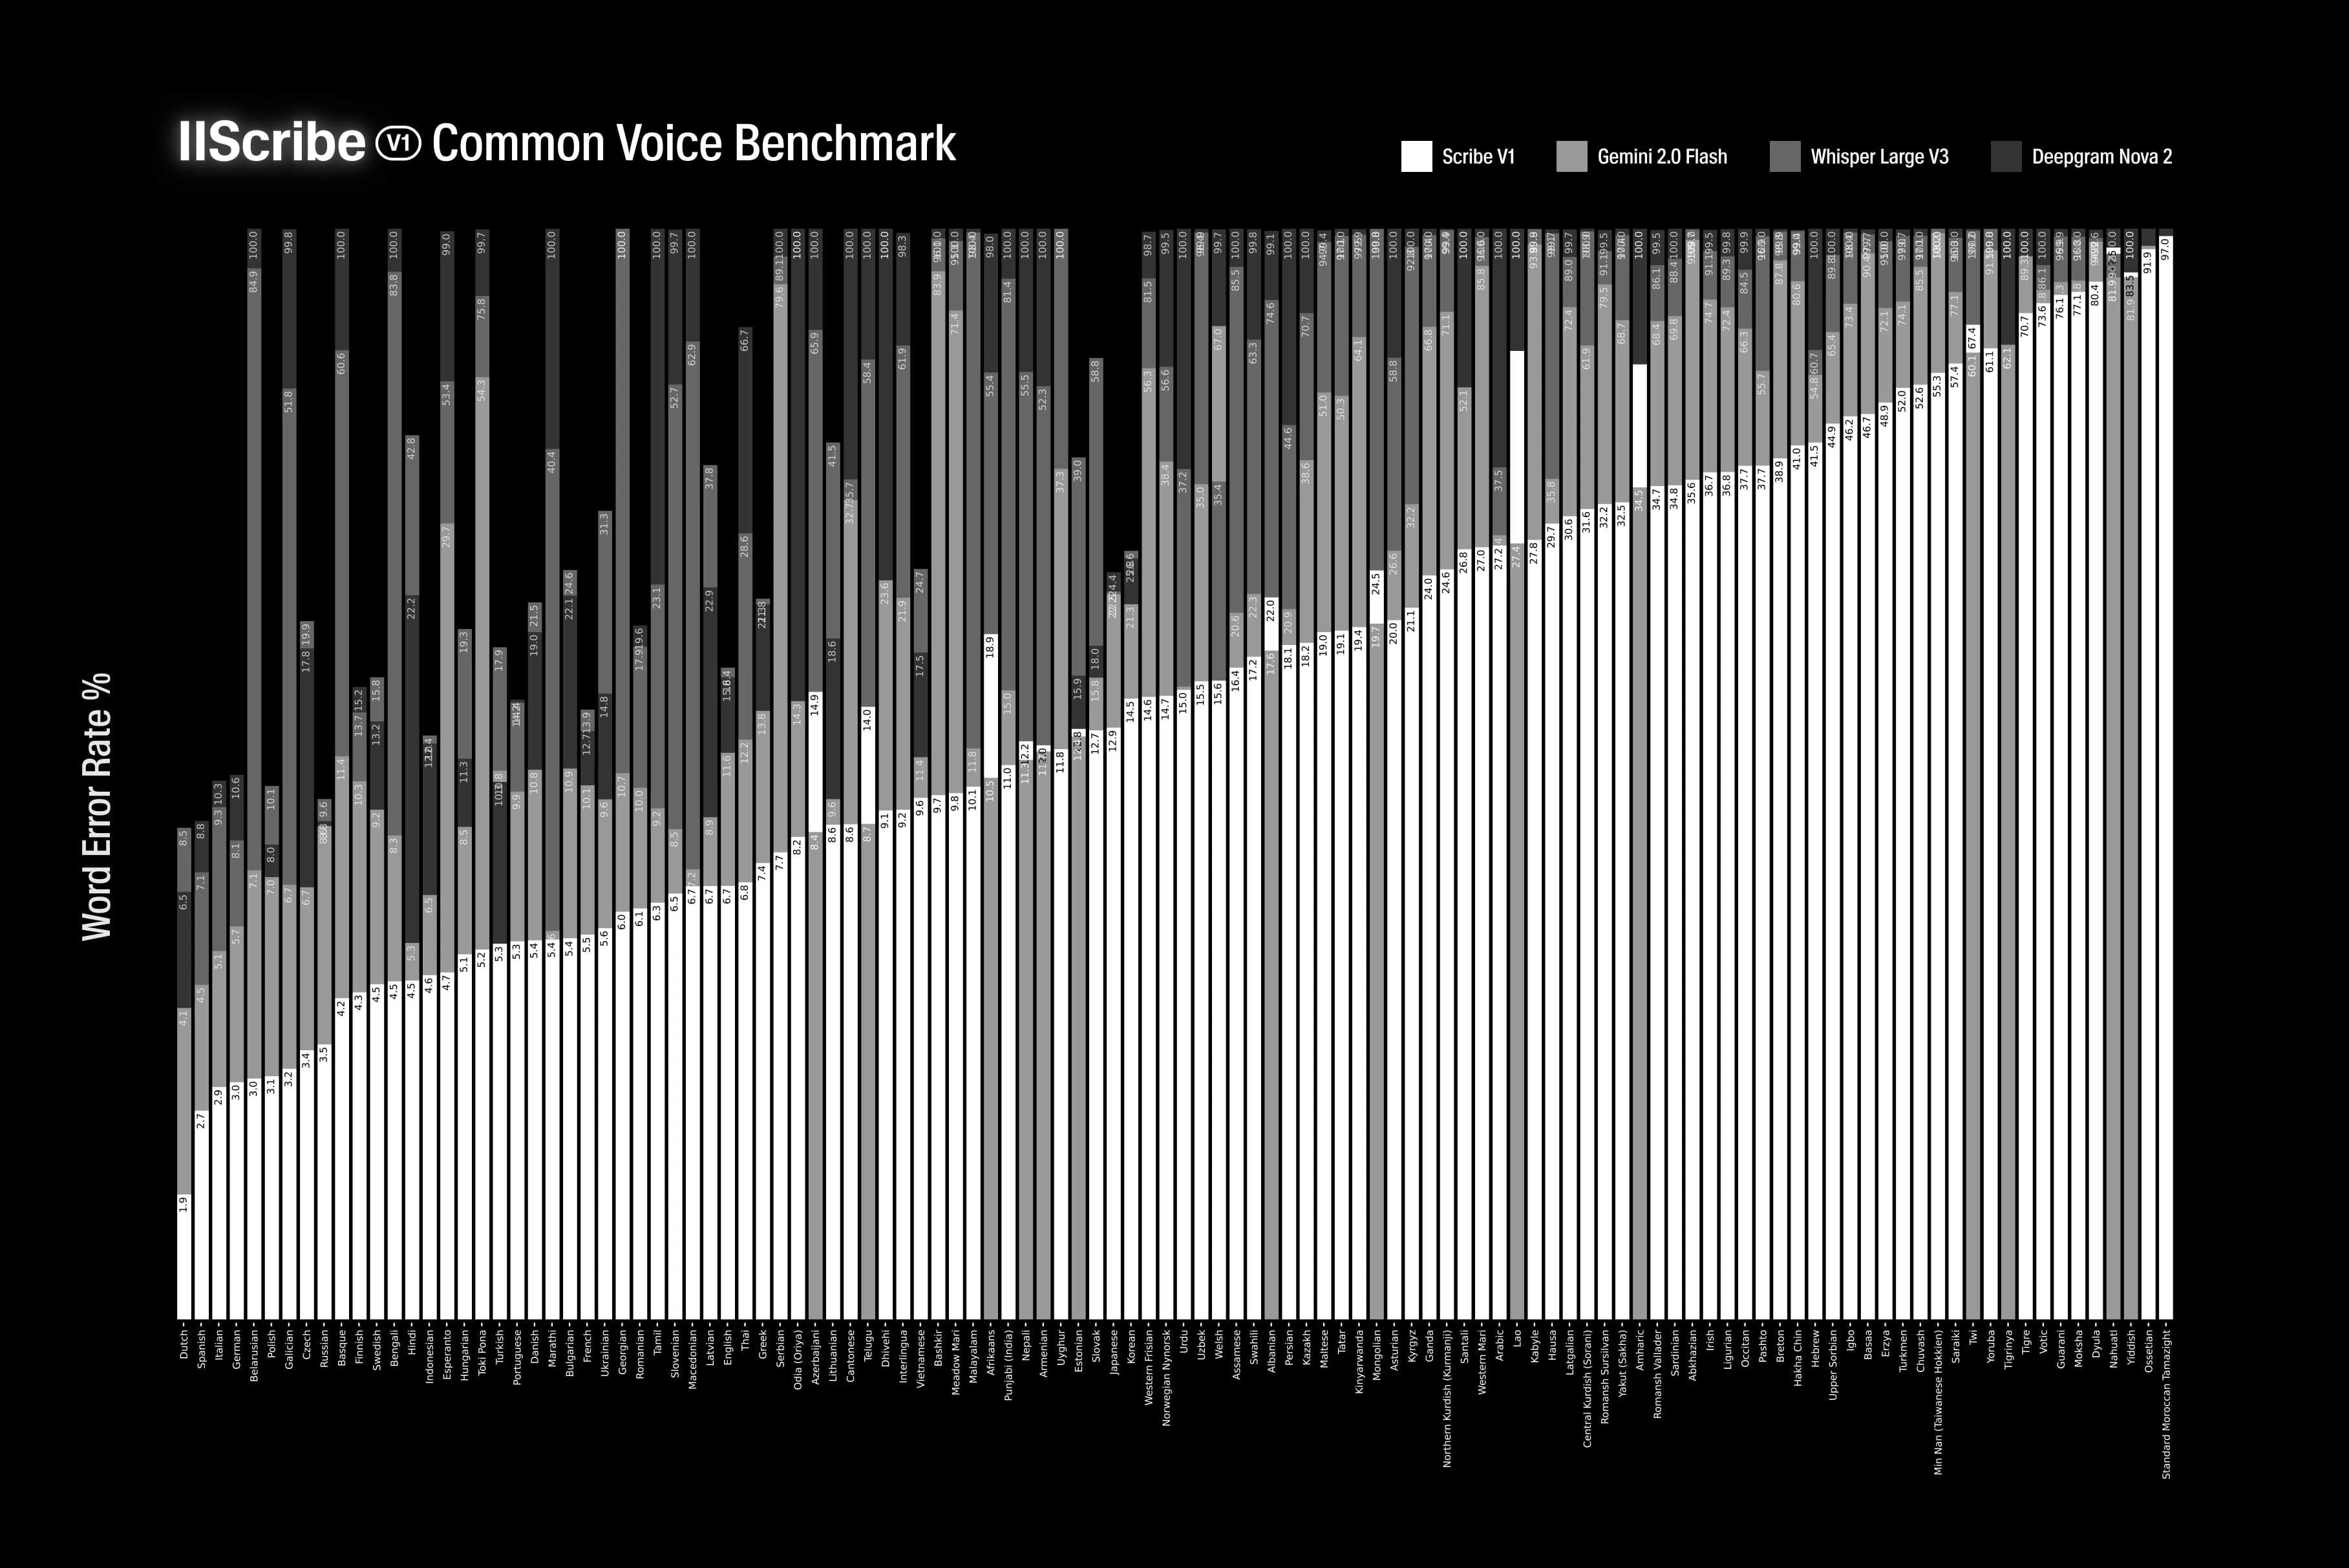
Scribe is ontwikkeld voor precisie. In benchmarktests van FLEURS en Common Voice voor 99 talen presteert het consequent beter dan toonaangevende modellen zoals Gemini 2.0 Flash, Whisper Large V3 en Deepgram Nova-3. Of het nu gaat om samenvattingen van vergaderingen, filmondertiteling of zelfs songteksten, Scribe levert het laagste automatische woordfoutpercentage bij transcriptie in het Italiaans (98,7%), Engels (96,7%) en 97 andere talen.
Scribe maakt ASR universeel toegankelijk en vermindert fouten aanzienlijk in talen die traditioneel minder goed worden ondersteund, zoals Servisch, Kantonees en Malayalam, waar concurrerende modellen vaak woordfoutpercentages van meer dan 40% hebben.
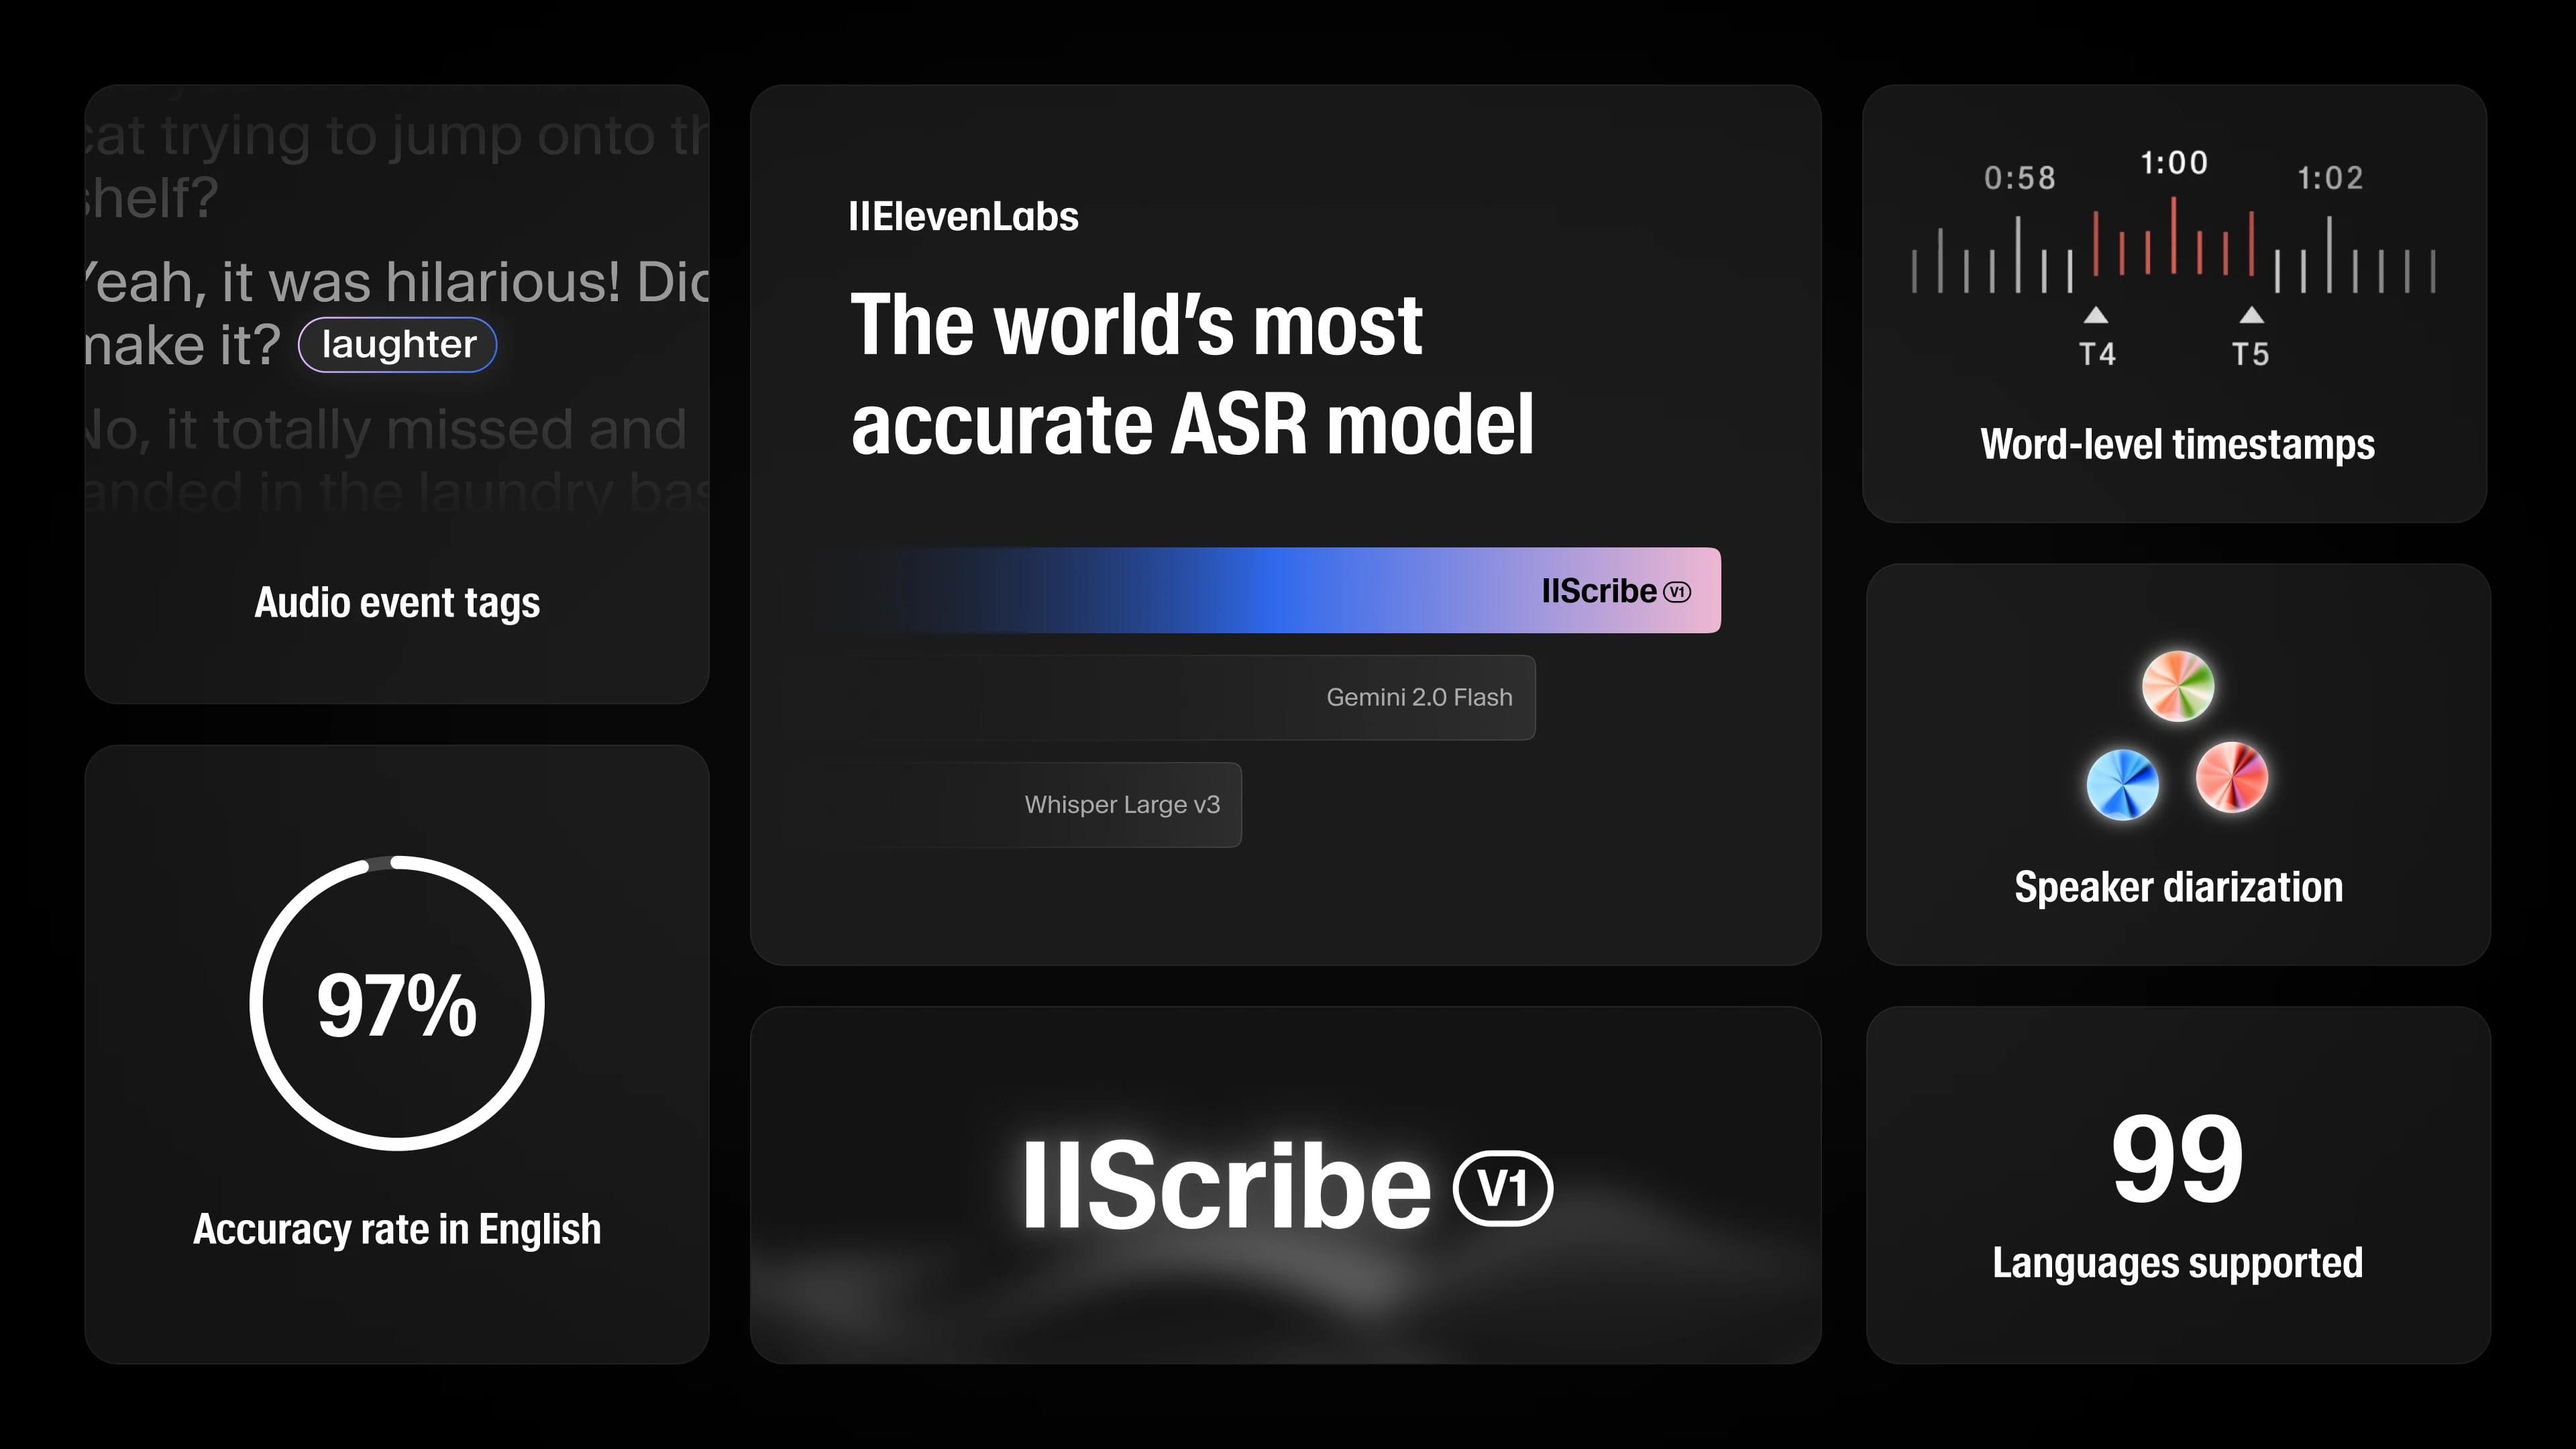
Ontwikkelaars kunnen Scribe vandaag nog integreren via onze Speech to Text API om gestructureerde JSON-transcripten te ontvangen met sprekerdiarisatie en tijdstempels op woordniveau en markeringen voor niet-spraakgebeurtenissen (bijv. lachen). Een versie met lage latency voor realtime applicaties wordt binnenkort uitgebracht.
Creators en bedrijven kunnen Scribe rechtstreeks gebruiken via het ElevenLabs-dashboard om audio- of videobestanden te uploaden en opgemaakte transcripten te genereren.
Begin met bouwen met Scribe:
API-documentatie | Probeer het in het ElevenLabs-dashboard
Benchmarks
FLEURS - woordfoutpercentage % - 102 talen
Common Voice - woordfoutpercentage % - 102 talen
Bijdragen
Onderzoeksleider, training, architectuur
Flavio Schneider
Projectleider, pre-trainingdata, fine-tuningdata
Tim von Känel
Inferentie, optimalisaties
Maximiliano Levi
Bijdragers aan onderzoek
Johan Nordberg, Piotr Dabkowski
Frontend
Austin Malerba
Backend
Hristo Stoychev
Data-acquisitie
Alex George
Tim is on our research team and focuses on ASR and Music.