Maak kennis met Eleven v4, ons meest expressieve model
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Een tekstregel kan sterk veranderen, afhankelijk van hoe die wordt uitgesproken. "Ik wil dat je rustig blijft" moet anders klinken, afhankelijk van wie het zegt: een arts die het zachtjes tegen een bange patiënt zegt, of een personage in een game dat het naar zijn team roept voordat ze de strijd ingaan.
Vandaag lanceren we Eleven v4, ons meest expressieve text-to-speechmodel tot nu toe, en de variant met lage latency: Eleven v4 Turbo.
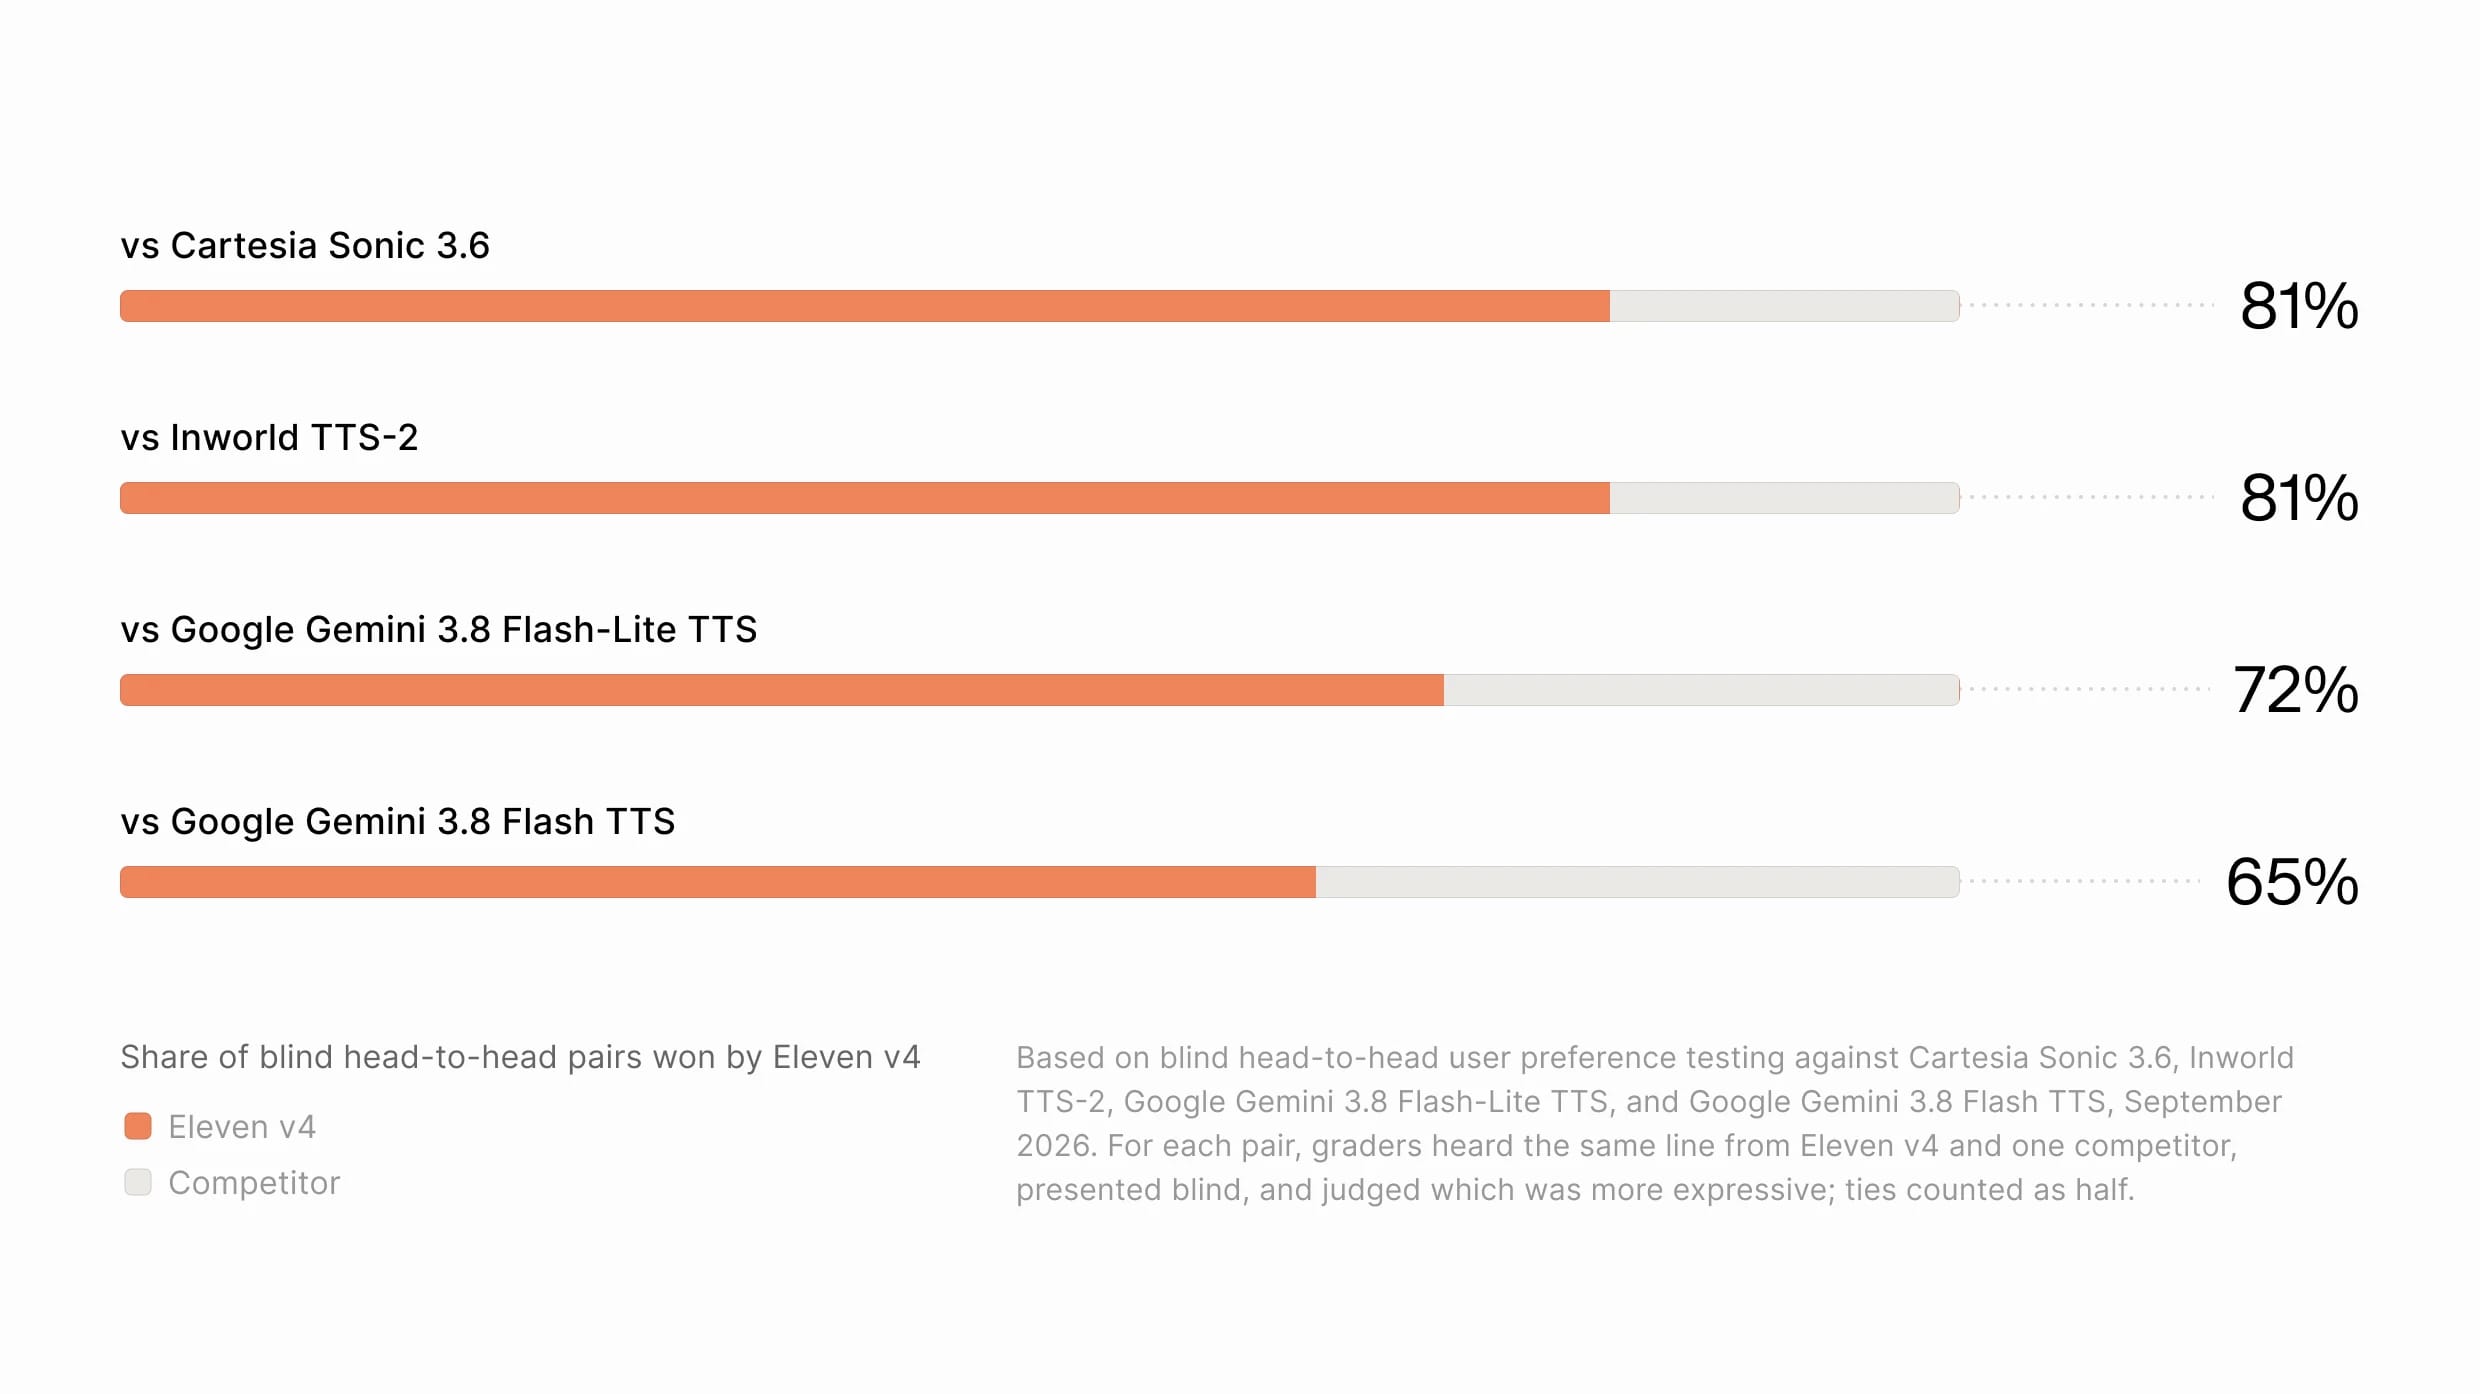
Door Artificial Analysis op nummer 1 gezet1, en in blinde rechtstreekse tests door ~75% van de luisteraars verkozen boven concurrerende modellen2, is Eleven v4 ontworpen om toon, tempo, emotie, karakter en context te interpreteren. Het genereert spraak die dramatisch, teder, urgent, komisch of conversationeel kan klinken, met behoud van de identiteit van de spreker. Natuurlijkere dynamiek tussen meerdere sprekers zorgt ervoor dat gesprekken responsief aanvoelen, in plaats van als losse regels die aan elkaar zijn gezet. Sprekers reageren op de context van het gesprek, wat natuurlijkere dialogen en interacties tussen personages oplevert.
Een nieuwe architectuur, gebouwd voor prestaties
Eleven v4 is gebouwd op een volledig nieuwe architectuur en is ons meest expressieve Text to Speech-model, door Artificial Analysis op nummer 1 gezet1. Eleven v4 Turbo brengt dezelfde technologie naar toepassingen met lage latency, zoals agents. Met een mediane inferencelatency van ~100 ms kan het sneller reageren dan de gemiddelde pauze tussen twee mensen die met elkaar praten.
Beide modellen kunnen spraak genereren die expressief in plaats van mechanisch aanvoelt. Ook de onderliggende audiokwaliteit is over de hele linie hoger, met schonere, natuurlijker klinkende output.
Eerdere generaties text-to-speechmodellen kunnen tekst hardop voorlezen, maar Eleven v4 geeft spraak een emotionele diepgang die veel natuurlijker aanvoelt. Het model kan de bedoelde toon, het gewenste spreektempo, het karakter van de tekst en de context ervan interpreteren om emotioneel aansprekende spraak te leveren.
Gebruikers hebben ook gedetailleerde controle over de output en kunnen in natuurlijke taal beschrijven hoe een regel moet worden uitgesproken. Ze kunnen ook specifieke instructies toevoegen voor de uitspraak van bepaalde zinnen, de emotie die ze moeten overbrengen en zelfs geluidseffecten, met inline tags zoals [laughs], [said angrily in French accent], [light rain] of [phone buzzing]. Eleven v4 volgt deze audiotags en aanwijzingen nauwkeuriger dan eerdere modellen, zodat je de voordracht krijgt die je beschrijft. Zo kun je vertelling gemakkelijker regisseren, personages of hun dialogen meer uitwerken en andere situaties aanpakken waarin de voordracht belangrijk is.
De ontwikkelaarsdocumentatie van ElevenLabs behandelt de volledige tagsyntaxis en hoe je deze tags via de API toepast. De ondersteuning voor fonemen van het International Phonetic Alphabet (IPA) is ook aanzienlijk verbeterd, waardoor aangepaste uitspraken betrouwbaarder werken.
Eleven v4 verbetert ook de consistentie en dynamische gesprekken tussen meerdere sprekers. Met een nieuwe methode om de identiteit van sprekers vast te leggen, behoudt Eleven v4 de unieke kenmerken van elke stem. Het kan spraak consistent houden in gesprekken met agents, luisterboeken of advertenties. Omdat het model de context van een hele scène begrijpt, genereert het natuurlijke dialogen waarin sprekers reageren op wat er net is gezegd, in plaats van losse regels aan elkaar te plakken.
Een Turbo-model voor toepassingen met lage latency
Hoogwaardige stemmodellen waren doorgaans langzamer in het genereren van spraak, waardoor gebruikers moesten kiezen tussen snelle of expressieve spraakagents. Velen kozen voor bekwame maar monotone agents, die robotachtig kunnen overkomen op een gestreste klant die gewoon zijn probleem wil oplossen.
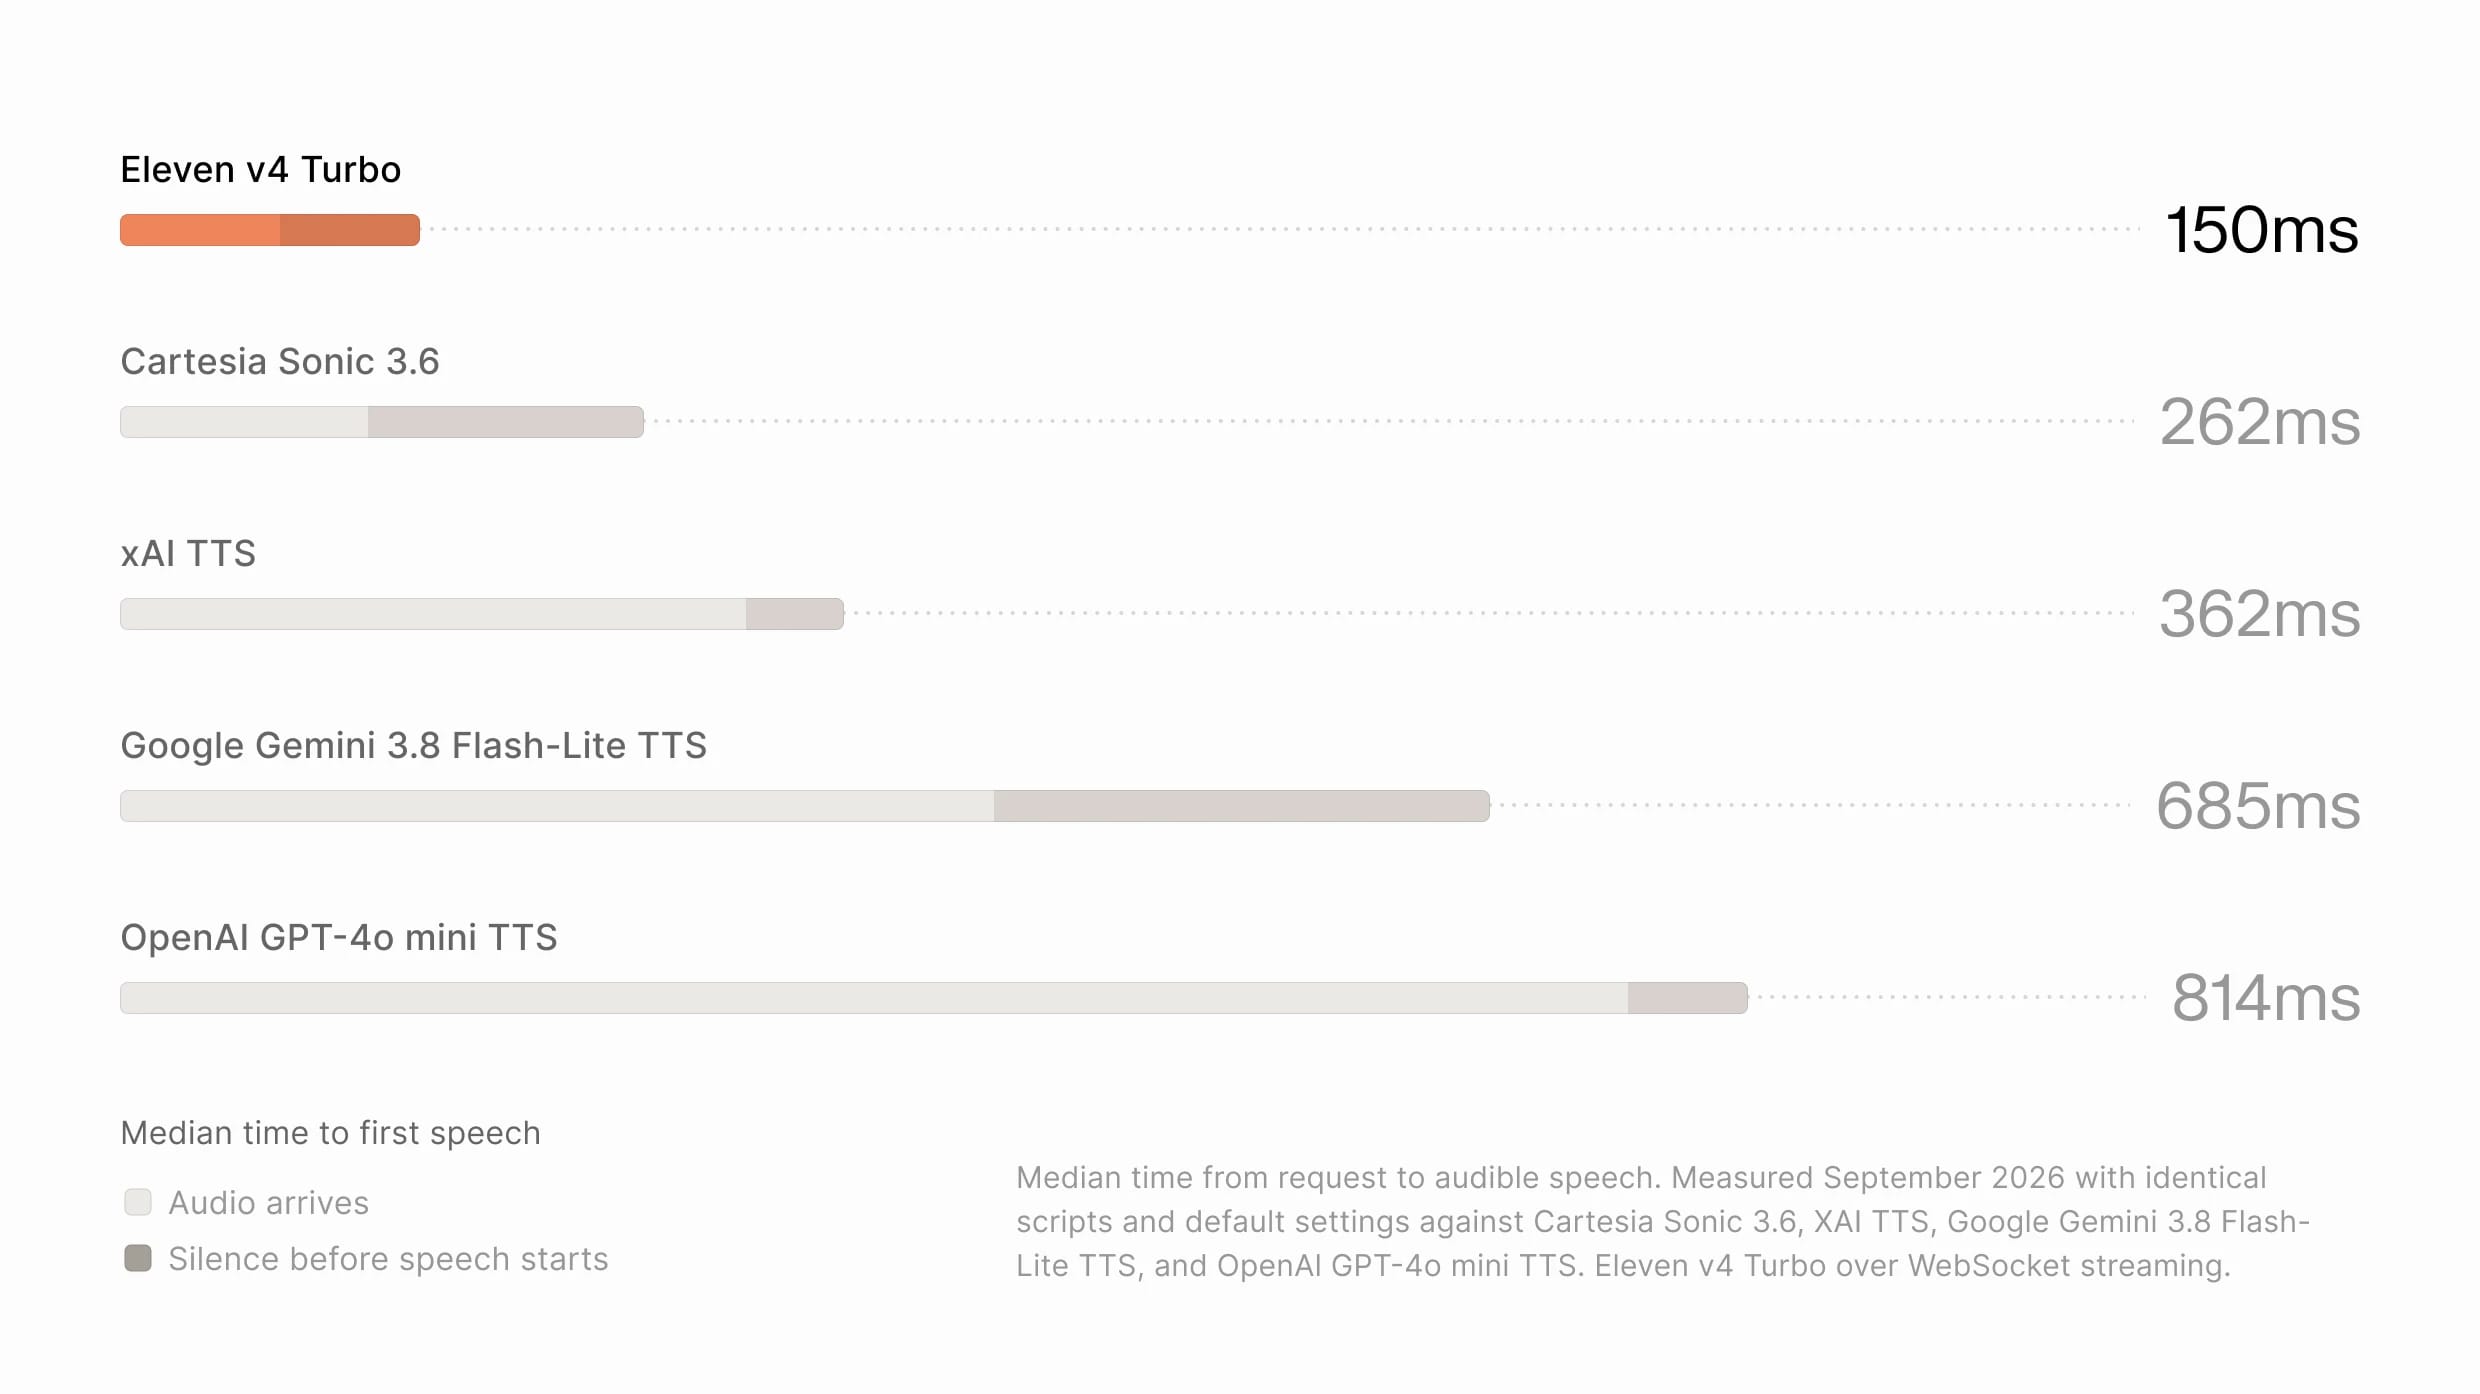
Eleven v4 Turbo combineert snelheid en emotie met een mediane tijd tot de eerste spraak van ~150 ms3, waardoor je krachtige agents kunt inzetten in talloze sectoren: van warme, geruststellende agents die medische termen nauwkeurig kunnen uitspreken in de zorg, tot snel pratende agents die slang gebruiken om spelers in games te vermaken.
Het Eleven v4 Turbo-model is gemaakt om samen te werken met het platform voor conversationele agents van ElevenLabs, ElevenAgents. Andere bouwers van agents voegen modellen en software van verschillende leveranciers samen, waardoor gebruikers geen manier hebben om de modeloutput voor hun eigen toepassingen te verfijnen of te verbeteren. De onderzoeks- en engineeringteams van ElevenLabs hebben Eleven v4 Turbo en ElevenAgents samen als één systeem geoptimaliseerd, voor expressievere, betrouwbaardere agents met lage latency.
Eén stem, talloze talen
De manier waarop we communiceren verschilt per context, locatie en zelfs moment van de dag. Expressieve spraak ontwikkelen die dat weerspiegelt, in verschillende talen, blijft een van de moeilijkste uitdagingen binnen audio-AI.
Eleven v4 is op al deze gebieden een stap vooruit en de verbeteringen gaan verder dan alleen de manier waarop het model zinnen uitspreekt. Eleven v4 vangt ritme, emotie en voordracht beter in verschillende talen, zodat creators spraak kunnen produceren die natuurlijk aanvoelt voor de taal en context. De manier waarop je bijvoorbeeld tegen een oudere onbekende in Japan spreekt, verschilt behoorlijk van hoe je die persoon in Italië zou aanspreken.
Zowel Eleven v4 als Eleven v4 Turbo ondersteunen meer dan 90 talen. Een stem die in één taal is opgenomen, spreekt nu ook elke andere taal vloeiend, met het accent van een moedertaalspreker en behoud van de identiteit van het origineel. Die accentgetrouwheid is merkbaar sterker dan voorheen, zodat de stem tijdens een generatie niet meer terugvalt naar het oorspronkelijke accent.
Catalaans
Spaans
Voor nasynchronisatie en lokalisatie betekent dit dat de stem van het merk waarvoor je hebt gekozen — of dat nu een bekende acteur is met wie je samenwerkt of een toon die het beste bij de stijl van je bedrijf past — uitstekend klinkt in elke taal die Eleven v4 ondersteunt.
Authentieker, consistenter stemklonen
Stemklonen is authentieker, krachtiger en consistenter met Eleven v4 en Eleven v4 Turbo, met een aanzienlijk betere overeenkomst tussen de spreker en de oorspronkelijke bronstem. Instant Voice Clones kunnen nu stemmen met hoge kwaliteit vastleggen met slechts 10 seconden audio.
Echte stem
Eleven v4
Eleven v4 behoudt de identiteit van de spreker ook betrouwbaarder in generaties, dialogen, vertellingen en opnieuw gegenereerde regels. Dit betekent dat personages, vertellers en gekloonde stemmen bij langlopende projecten consistent blijven gedurende een hele productie. Eleven v4 voegt ook ondersteuning toe voor Professional Voice Clones (PVC), voor toepassingen die de hoogste kloonkwaliteit vereisen.
Request stitching — generaties aan elkaar koppelen voor langere content — is in Eleven v4 ook aanzienlijk betrouwbaarder, wat het werken in ElevenLabs Studio en de ElevenLabs Reader App verbetert.
Hoor zelf het verschil
Eleven v4 en Eleven v4 Turbo vormen het resultaat van ons nieuwste onderzoek naar expressieve spraakgeneratie. Ze zijn gemaakt voor content waarin de voordracht net zo belangrijk is als de woorden zelf, zoals luisterboeken, karaktervertolkingen, voice-overs, nasynchronisatie of het lokaliseren van conversationele agents.
Beide modellen zijn nu beschikbaar in ElevenAgents, ElevenCreative en via ElevenAPI. Maak een gratis account om vandaag nog te beginnen met genereren met Eleven v4 of Eleven v4 Turbo.
- Artificial Analysis, Provider Voice Arena Leaderboard, sep. 2026
- Gebaseerd op blinde rechtstreekse gebruikerstests tegen Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS en Google Gemini 3.8 Flash TTS, september 2026. Bij elk paar hoorden beoordelaars dezelfde regel van Eleven v4 en één concurrent, blind gepresenteerd, en beoordeelden ze welke expressiever was en welke natuurlijker klonk; een gelijkspel telde als een half punt.
- Mediane tijd van request tot hoorbare spraak. Gemeten in september 2026 met identieke scripts en standaardinstellingen tegen Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS en OpenAI GPT-4o mini TTS; de netwerklatency is voor alle systemen gemeten en verwijderd. Eleven v4 Turbo via WebSocket-streaming.
Mati is the cofounder of ElevenLabs, where he leads teams building AI that can communicate at human level. Before ElevenLabs, Mati worked at Palantir where he embedded with enterprises and governments to help them deploy new technology. He grew up in Poland, before moving to the UK to study Mathematics at Imperial College London.