Hoe je transcript weet waar elk woord wordt uitgesproken
- Geschreven door
- Mike Murphy
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Als je weleens een film op tv hebt gekeken waarbij er iets misgaat met de uitzending en de dialogen van de acteurs totaal niet synchroon lopen met de ondertiteling, weet je hoe afleidend dat kan zijn en hoe het je uit het verhaal kan halen. Video's en software die stemmodellen gebruiken, hebben hetzelfde probleem: een ondertitel die een seconde te laat verschijnt of een transcript dat het verkeerde woord markeert, kan net zo defect aanvoelen.
“Mensen zijn best goed in het synchroniseren van media, ten minste op woordniveau”, zegt Danila Kozlov, onderzoeker bij ElevenLabs die werkt aan alignment. “We voelen vaak intuïtief aan waar een woord begint, maar op tekenniveau en met precisie tot op minder dan een milliseconde is dat veel lastiger.”
Vandaag deelt ElevenLabs meer over Cue, een forced alignment-model dat elk teken in een audiobestand op een nauwkeurige tijdlijn plaatst. Cue vormt de basis voor de Scribe-modelfamilie van ElevenLabs en is bij opnamen uit de praktijk nauwkeuriger dan elke aligner die ElevenLabs heeft getest, in alle 29 talen van de benchmark. Het verwerkt ook opnamen van elke lengte in één keer en synchroniseert een uur audio in minder dan een seconde.
Wat is forced alignment?
Stel je voor dat iemand je een video en een transcript geeft en je vraagt elk woord te koppelen aan het moment waarop het wordt uitgesproken. Dat is forced alignment. Wanneer je in een ElevenLabs-transcript op een woord klikt en de player naar precies die plek springt, doet een aligner het werk.
Forced alignment verschilt echter van het vagere concept AI alignment. Dat gaat over het ontwerpen van AI-systemen zodat hun gedrag aansluit bij de waarden en zakelijke voorkeuren van mensen. Bij forced alignment hebben we het alleen over het op elkaar afstemmen van tekst en geluid.
Cue is de laatste stap in de speech-to-text-pipeline. Scribe, het Speech to Text-model van ElevenLabs, transcribeert de audio en de aligner bepaalt de timing. Elk Scribe-request gaat erdoorheen. Datzelfde model vormt ook de basis voor ondertiteling, nasynchronisatie en de timing van songteksten voor muziek, en is afzonderlijk beschikbaar via de Forced Alignment API.
Omdat zo veel producten ervan afhankelijk zijn, moet een aligner nauwkeurig zijn in elke ondersteunde taal, extreem snel werken en veel requests tegelijk kunnen verwerken.
Waar traditionele aligners tekortschieten
Vóór het nieuwe model bouwde het team het alignermodel dat tot dan toe in elk ElevenLabs-product was gebruikt. Hoewel het krachtig was, wisten ze dat ze een nieuwe versie nog beter konden maken. Toen Kozlov erbij kwam, begonnen hij en het team met het interviewen van klanten en interne gebruikers bij ElevenLabs over wat hen frustreerde bij het werken met de vorige aligner. Hun klachten kwamen overeen met de beperkingen van de open-sourcetools die het team testte.
Lengte is het eerste grote probleem. Veel aligners werken tegenwoordig goed voor clips van ongeveer 30 seconden, maar langere bestanden moeten in stukken worden geknipt. Elk nieuw stuk kan een kleine timingfout toevoegen, en het aan elkaar zetten van die stukken kan er nog meer veroorzaken. Bij volledige opnamen bedraagt de gemiddelde timingfout van Cue slechts 179 milliseconden, terwijl de open-sourcetools varieerden van 283 ms tot meer dan 6.000 ms.
Audio die in de praktijk is opgenomen, is een nog grotere uitdaging. Achtergrondgeluid, overlappende spraak en omgevingsmuziek zorgen ervoor dat veel tools hun plaats verliezen bij het koppelen van tekst aan audio. Maar dit zijn juist de bestanden die veel mensen getranscribeerd willen hebben, omdat we allemaal vaak op plekken leven die niet perfect stil zijn. Bij Engelse opnamen met problemen in de achtergrond bedraagt de gemiddelde fout van Cue 57 ms, tegenover 65 ms tot 920 ms voor de andere tools.
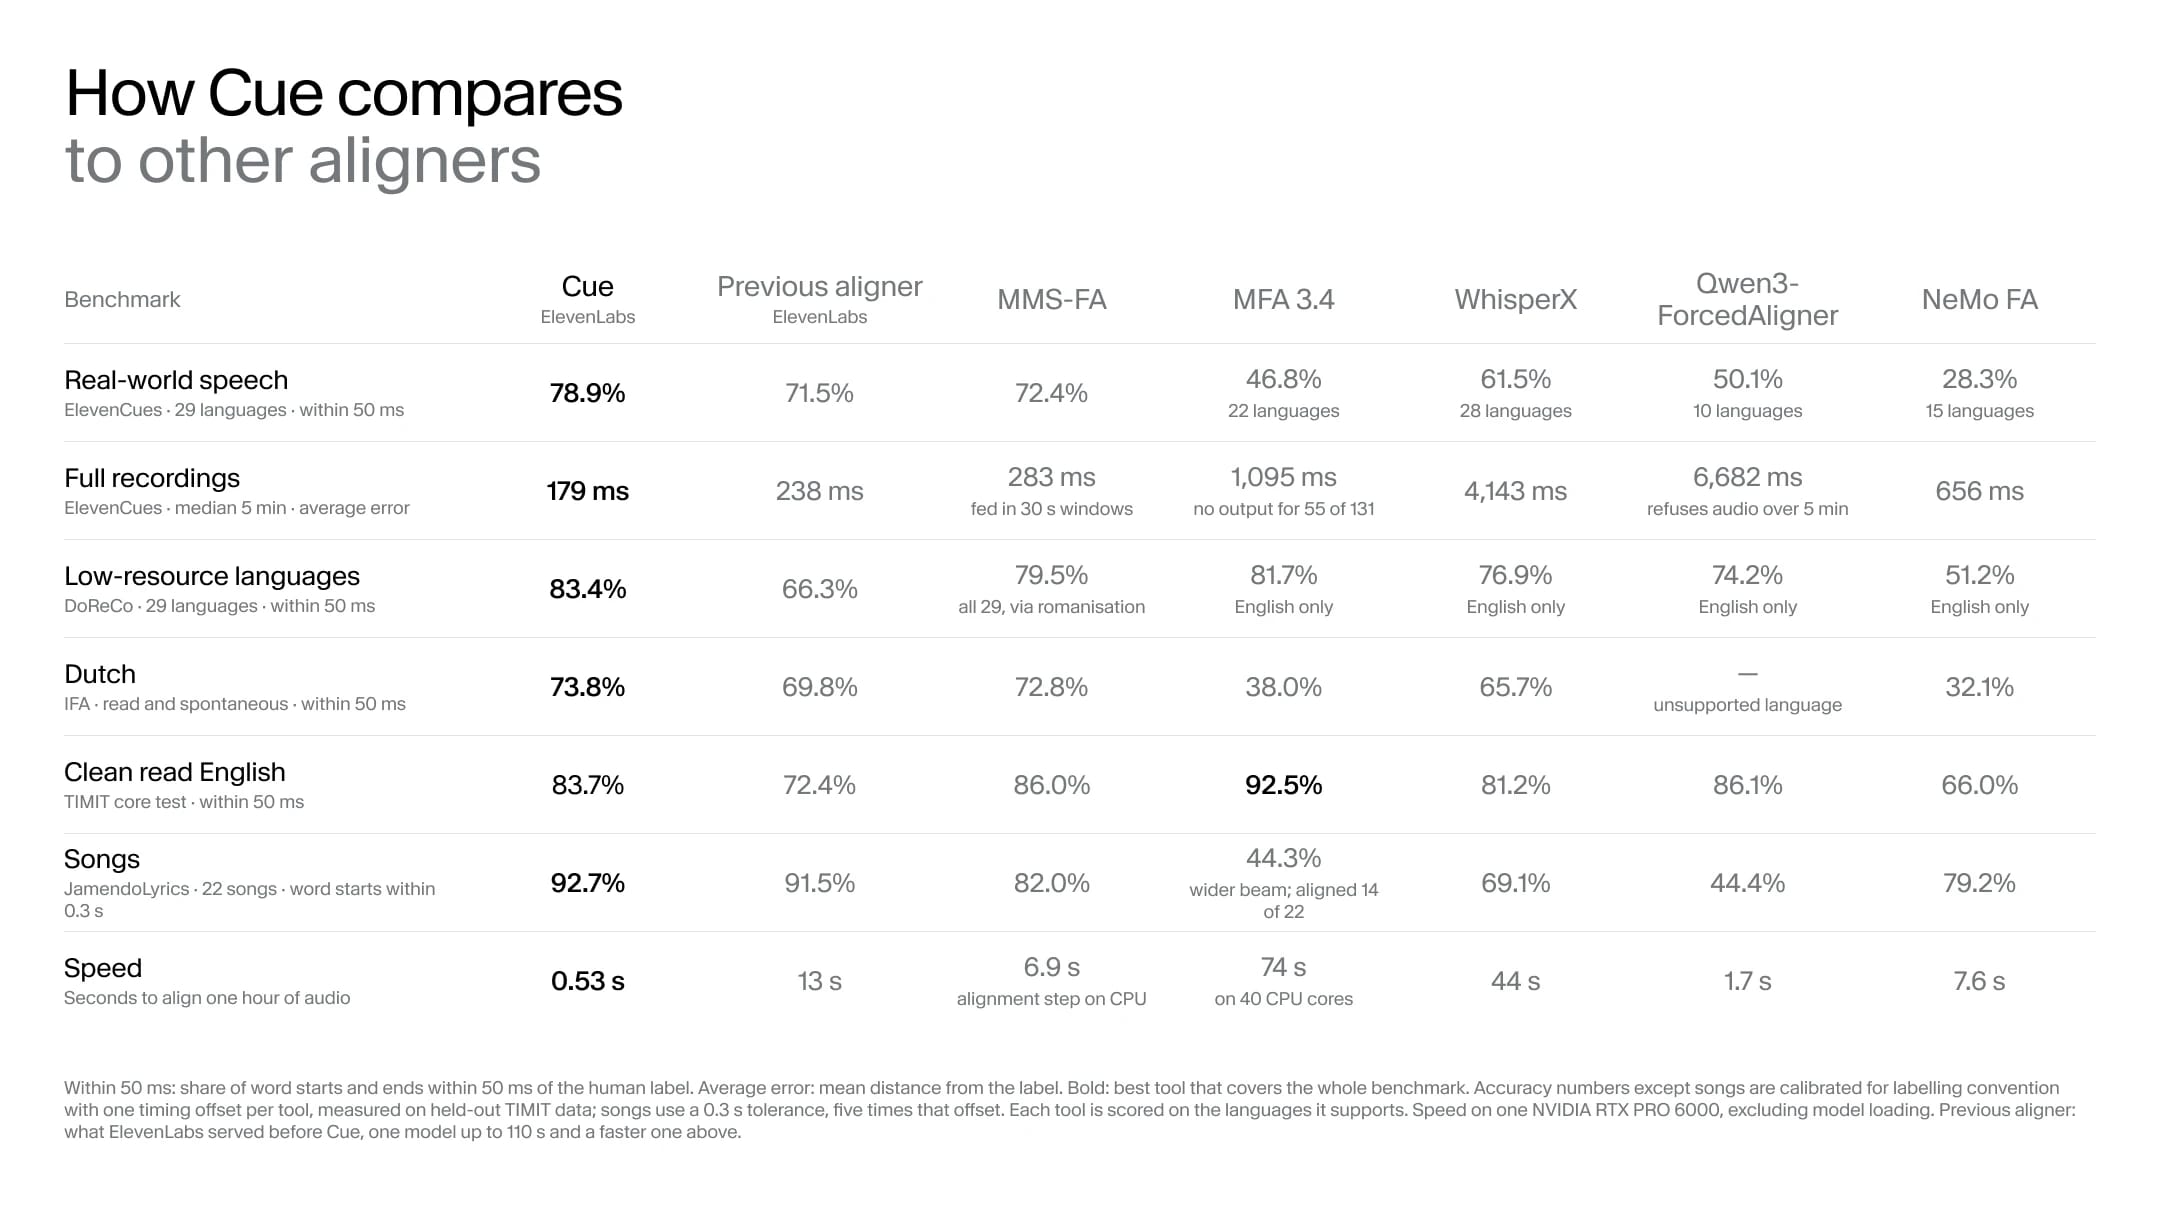
Taalondersteuning is een andere beperking. De meeste open-sourcealigners hebben een apart model nodig voor elke taal die ze ondersteunen. Daardoor presteren talen met minder trainingsdata vaak minder goed, of worden ze helemaal niet ondersteund. MMS-FA is de enige andere tool die alle 29 benchmarktalen ondersteunt, en Cue was over het algemeen sneller in het bepalen van de grenzen tussen woorden.
Snelheid is ook een probleem voor deze modellen, omdat het synchroniseren van grote hoeveelheden audio snel duur kan worden. Cue kan één uur audio in ongeveer een halve seconde synchroniseren op onze productie-GPU. De op een na snelste tool, Qwen3-ForcedAligner, heeft bijna 2 seconden nodig, en de langzaamste geteste tool ruim meer dan een minuut.
Hoe Cue verschilt
Cue is één model dat meer dan 90 benchmarktalen omvat, anders dan de meeste concurrenten. Het kan ook opnamen van elke lengte in één keer verwerken, waardoor het opdelen wordt vermeden dat timingfouten in lange bestanden doet oplopen.
Knijp of scroll met Control om in of uit te zoomen. Veeg horizontaal of scroll met Shift om te pannen. Als een woord focus heeft, gebruik je plus en min om in of uit te zoomen, of Shift met de pijl naar links of rechts om te pannen.
Selecteer een woord om de tekens te bekijken
Hoewel de meeste modellen groter zijn geworden naarmate ze beter presteren, is Cue kleiner dan de vorige aligner van ElevenLabs, aldus Kozlov. Het draait nog steeds op een GPU, maar synchroniseert een uur audio in ongeveer een halve seconde.
Het team bouwde Cue rond de soorten audio die mensen daadwerkelijk uploaden. Ze gebruikten de vorige aligner als uitgangspunt, maakten een benchmark op basis van requests uit de praktijk en beoordeelden elke tool op dezelfde manier, waarbij elk woord dat een tool niet kon plaatsen als fout werd geteld. Cue werkt op tekenniveau, wat fijnmaziger is dan de labels op woordniveau die de meeste benchmarks gebruiken, dus die scores onderschatten waarschijnlijk de nauwkeurigheid ervan.
“Op een gegeven moment bereik je het niveau van menselijke vaardigheden”, zei Kozlov over alignermodellen. “Onze huidige aligner gaat dat niveau voorbij, waardoor het veel lastiger wordt om te controleren of je volledig correct bent of hoe nauwkeurig je precies bent, omdat er geen gouden benchmark voor bestaat. We moesten benchmarks op woordniveau gebruiken om een systeem op tekenniveau te benchmarken, wat niet per se het volledige potentieel van Cue laat zien.”
De kwaliteit van Cue weerspiegelt ook hoe snel ElevenLabs kan handelen op basis van gebruikersfeedback. Kort nadat Cue was uitgerold, meldde een klant aan het team dat Georgisch en enkele andere talen met minder beschikbare middelen slechter presteerden dan verwacht. ElevenLabs houdt onderzoek dicht bij de teams en klanten die de producten gebruiken. Daardoor konden we het probleem snel signaleren, onderzoek doen naar mogelijke modelverbeteringen, een nieuwe versie van het model trainen en uitbrengen — allemaal binnen minder dan 24 uur nadat de klant het probleem voor het eerst had gemeld.
Nummers synchroniseren
Muziek is lastig omdat zang woorden uitrekt en vervaagt, en weinig modellen dat goed aankunnen. Het team verwachtte niet dat Cue dit zo goed zou verwerken. Cue kon een subset van nummers uit de onder een Creative Commons-licentie beschikbare JamendoLyrics MultiLang-dataset synchroniseren. Dat lukte in het Engels, Frans, Spaans en Duits — in één keer — met verrassende nauwkeurigheid. Het plaatste 92,7% van de woorden binnen 0,3 seconde van het label, tegenover 82,0% voor de op een na beste tool.
De gemiddelde fout bij de starttijd van Cue was 0,82 seconde, ongeveer de helft van die van de dichtstbijzijnde concurrent. Bij minstens 19 van de 22 nummers was het nauwkeuriger dan elke andere tool. Het potentieel om je favoriete nieuwe nummers bij karaoke te zingen op de dag dat ze uitkomen, is enorm.
Probeer Cue vandaag
Cue zit al achter elke Speech to Text-transcriptie op ElevenLabs. Probeer de Forced Alignment API.
Dankwoord
Het werk aan de alignermodellen van ElevenLabs was niet mogelijk geweest zonder veel mensen binnen het bedrijf. Het team wil iedereen bedanken die aan de vorige en de nieuwe versie van het model heeft gewerkt, waaronder medeoprichter en CTO Piotr Dąbkowski, onderzoekers Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel en Angelos Perivolaropoulos; daarnaast Ani Janelidze van Data Operations, onze teams voor Forward Deployed Engineering en Support; en Lorenzo Dossi voor zijn werk aan de visualisatie in deze blog.
Mike Murphy is hoofdredacteur en schrijver voor de ElevenLabs-blog, waar hij complexe onderzoeken en technologie omzet in heldere, pakkende verhalen. Voordat hij bij ElevenLabs kwam, werkte hij jarenlang als technologiereporter, onder meer bij Quartz, en leidde hij de content bij IBM Research. Hij heeft een masterdiploma in journalistiek van Northwestern.