
Een interview transcriberen: nauwkeurige transcripties met sprekerlabels
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
Een interview handmatig transcriberen kost uren werk. Als je een artikeldeadline hebt of aan een tijdgevoelig onderzoek werkt, heb je die extra uren misschien niet in je planning. AI-tools voor speech to text transcriberen interviews in enkele minuten, zodat je meer tijd overhoudt voor redigeren en analyseren.
In deze gids leggen we uit hoe je een interview nauwkeurig met AI transcribeert. We bespreken ook tools, stijlen en opmaak om van elk audio-interview een bruikbaar geschreven transcript te maken.
Samenvatting
- Interviewtranscripten moeten voor journalistiek of academisch onderzoek vaak aan strenge nauwkeurigheidsnormen voldoen.
- Transcriberen in de verbatimmodus legt alles vast wat in het interview wordt gezegd, inclusief herhalingen en stopwoorden.
- Gebruik multichannel-transcriptie met een aparte microfoon voor elke spreker om fouten in sprekerlabels te voorkomen. Deze functie transcribeert de audio van elke spreker afzonderlijk, zodat ze ook bij door elkaar praten correct worden gelabeld.
- Audio-events zoals lachen, zuchten of applaudisseren geven context aan een interviewopname. ElevenCreative STT tagt deze standaard, maar je kunt de instelling ‘audio-events taggen’ uitschakelen als je ze niet nodig hebt.
- Bevat je interview persoonsnamen, bedrijfsnamen of vakjargon, gebruik dan keyterm prompting om de spelling te verduidelijken voordat de transcriptie begint.
Wat interviewtranscriptie anders maakt dan transcripten van vergaderingen of gesprekken
Interviewers hebben, zowel voor journalistiek als academisch onderzoek, directe citaten uit hun transcripten nodig. Wanneer interviews een uur of langer duren, is handmatig transcriberen niet haalbaar, zeker niet als je een hoge nauwkeurigheid nodig hebt.
Die citaten komen terecht in gepubliceerde artikelen, rapporten en verwijzingen. Het transcript moet alles vastleggen wat wordt gezegd, zonder woorden te wijzigen of iets weg te laten.
Zakelijke vergaderingen zijn anders. Ze duren meestal korter en de meeste teams hebben alleen de belangrijkste punten nodig. Veel teams gebruiken tools die de vergadering samenvatten in plaats van een woordelijk verslag te maken.
Als je software voor interviewtranscriptie kiest, moet nauwkeurigheid vooropstaan, maar het mag niet het enige punt op je checklist zijn. Dit zijn de functies die het belangrijkst zijn.
Verbatim of schoon: de stijl van je transcript kiezen
Bij het transcriberen van je interviews kun je uit twee stijlen kiezen: verbatim of schoon.
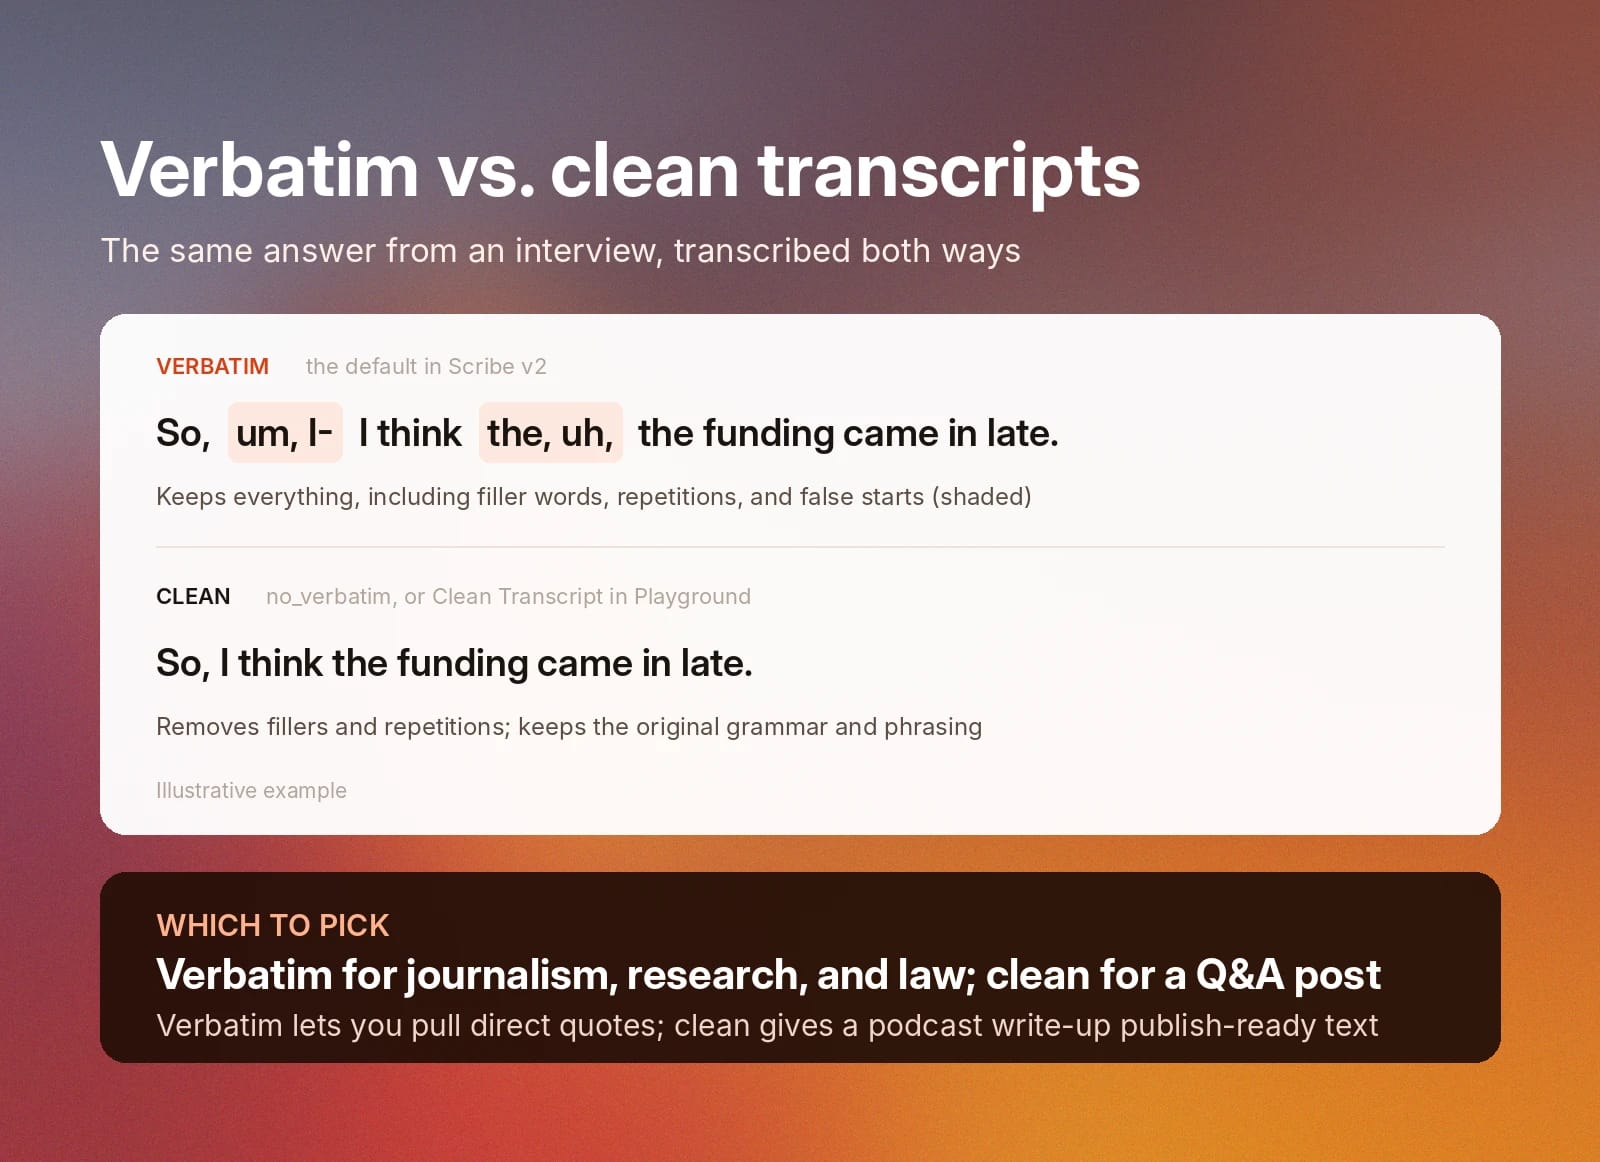
Een verbatimtranscript legt elk woord en elke uiting uit je gesprek vast, zonder iets te wijzigen of te verwijderen. Dit omvat herhalingen, valse starts en stopwoorden zoals ‘eh’ of ‘uh’.
Een schoon transcript verwijdert stopwoorden en herhalingen, maar behoudt de oorspronkelijke grammatica en formulering. Schone transcripten zijn beter leesbaar en behouden tegelijkertijd de oorspronkelijke bedoeling van het gesprek.
Voor de meeste interviews zijn verbatimtranscripten het meest geschikt. Omdat ze het hele gesprek behouden, voldoen ze aan de strenge nauwkeurigheidsnormen die gelden voor journalistiek, academisch onderzoek of juridische doeleinden.
Er zijn echter situaties waarin schone transcriptie geschikt is voor interviews. Stel dat je een interview voor je podcast hebt afgenomen en dit wilt omzetten in een Q&A-blogpost voor je website. In dat geval levert schone transcriptie resultaten op die klaar zijn voor publicatie.
ElevenCreative Speech to Text ondersteunt zowel verbatim- als schone transcriptie in ElevenLabs Playground en in ElevenAPI, met het Scribe v2-model. Verbatimtranscripten zijn de standaard, maar je kunt schone transcripten maken door Clean Transcript/No Verbatim in het instellingenpaneel van Playground in te schakelen of door de parameter no_verbatim in ElevenAPI in te schakelen.
Sprekerlabels correct instellen
Bij interviewtranscriptie verduidelijken sprekerlabels wie wat heeft gezegd. Een onjuist sprekerlabel kan leiden tot een verkeerde toeschrijving van een citaat, dus het is belangrijk dat ze correct zijn.
AI-tools voor speech to text hebben twee methoden om sprekers te labelen. Welke methode je gebruikt, hangt af van hoe je je interviews opneemt.
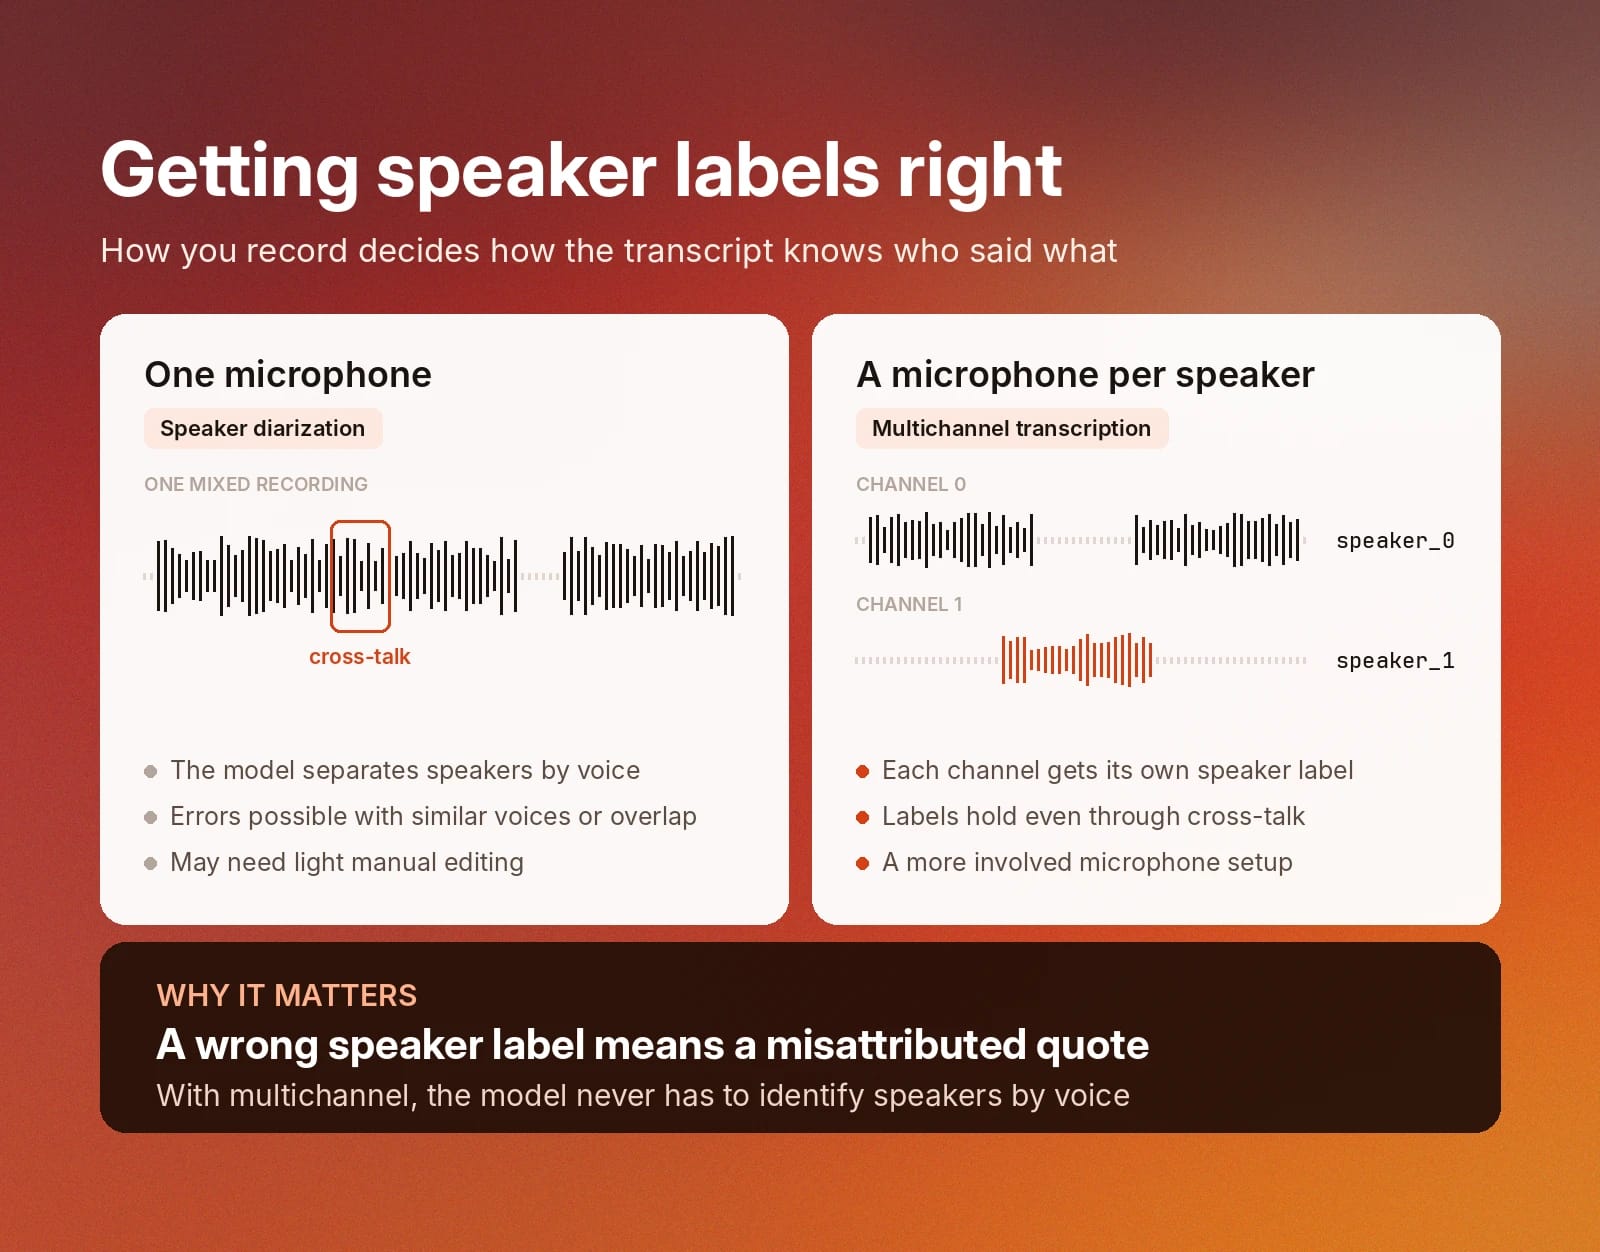
Als je één microfoon gebruikt om beide sprekers op te nemen, gebruikt het transcriptiemodel ingebouwde diarization om hen automatisch te identificeren, scheiden en labelen. Modellen die diarization gebruiken, kunnen fouten maken, vooral als sprekers vergelijkbare stemmen hebben of door elkaar praten.
Als elke spreker een eigen microfoon heeft, kun je multichannel-transcriptie gebruiken om ervoor te zorgen dat de sprekerlabels nauwkeurig zijn. Bij deze transcriptiemethode heeft elk audiokanaal een eigen sprekerlabel in het transcript.
Multichannel-transcriptie vereist een complexere microfoonopstelling dan één opname voor beide sprekers. Het levert echter duidelijkere, nauwkeurigere sprekerlabels op. Omdat elke spreker een vooraf geconfigureerd kanaal heeft, hoeft het transcriptiemodel sprekers niet op basis van hun stem te identificeren.
Omgaan met door elkaar praten en onderbrekingen
Sprekerlabels zijn niet altijd eenvoudig. Het is normaal dat sprekers tijdens een gesprek door elkaar praten of elkaar onderbreken.
Wanneer je een interview voor journalistiek of academisch onderzoek transcribeert, is het essentieel om door elkaar praten en onderbrekingen nauwkeurig te labelen. Zo wordt elk citaat aan de juiste spreker toegeschreven.
Gebruik indien mogelijk een aparte microfoon voor elke spreker en transcribeer in de multichannelmodus. In de multichannelmodus wordt elke spreker afzonderlijk opgenomen en getranscribeerd. Zo voorkom je labelingsfouten, zelfs wanneer sprekers door elkaar praten.
Als je één microfoon voor je interview gebruikt, gebruikt het transcriptiemodel geautomatiseerde sprekerdiarisatie om te labelen wie wanneer spreekt. Bij deze aanpak kunnen labelingsfouten optreden, vooral wanneer sprekers door elkaar praten. Mogelijk moet je het transcript voor de nauwkeurigheid licht handmatig bewerken.
De toon vastleggen bij het transcriberen van interviews
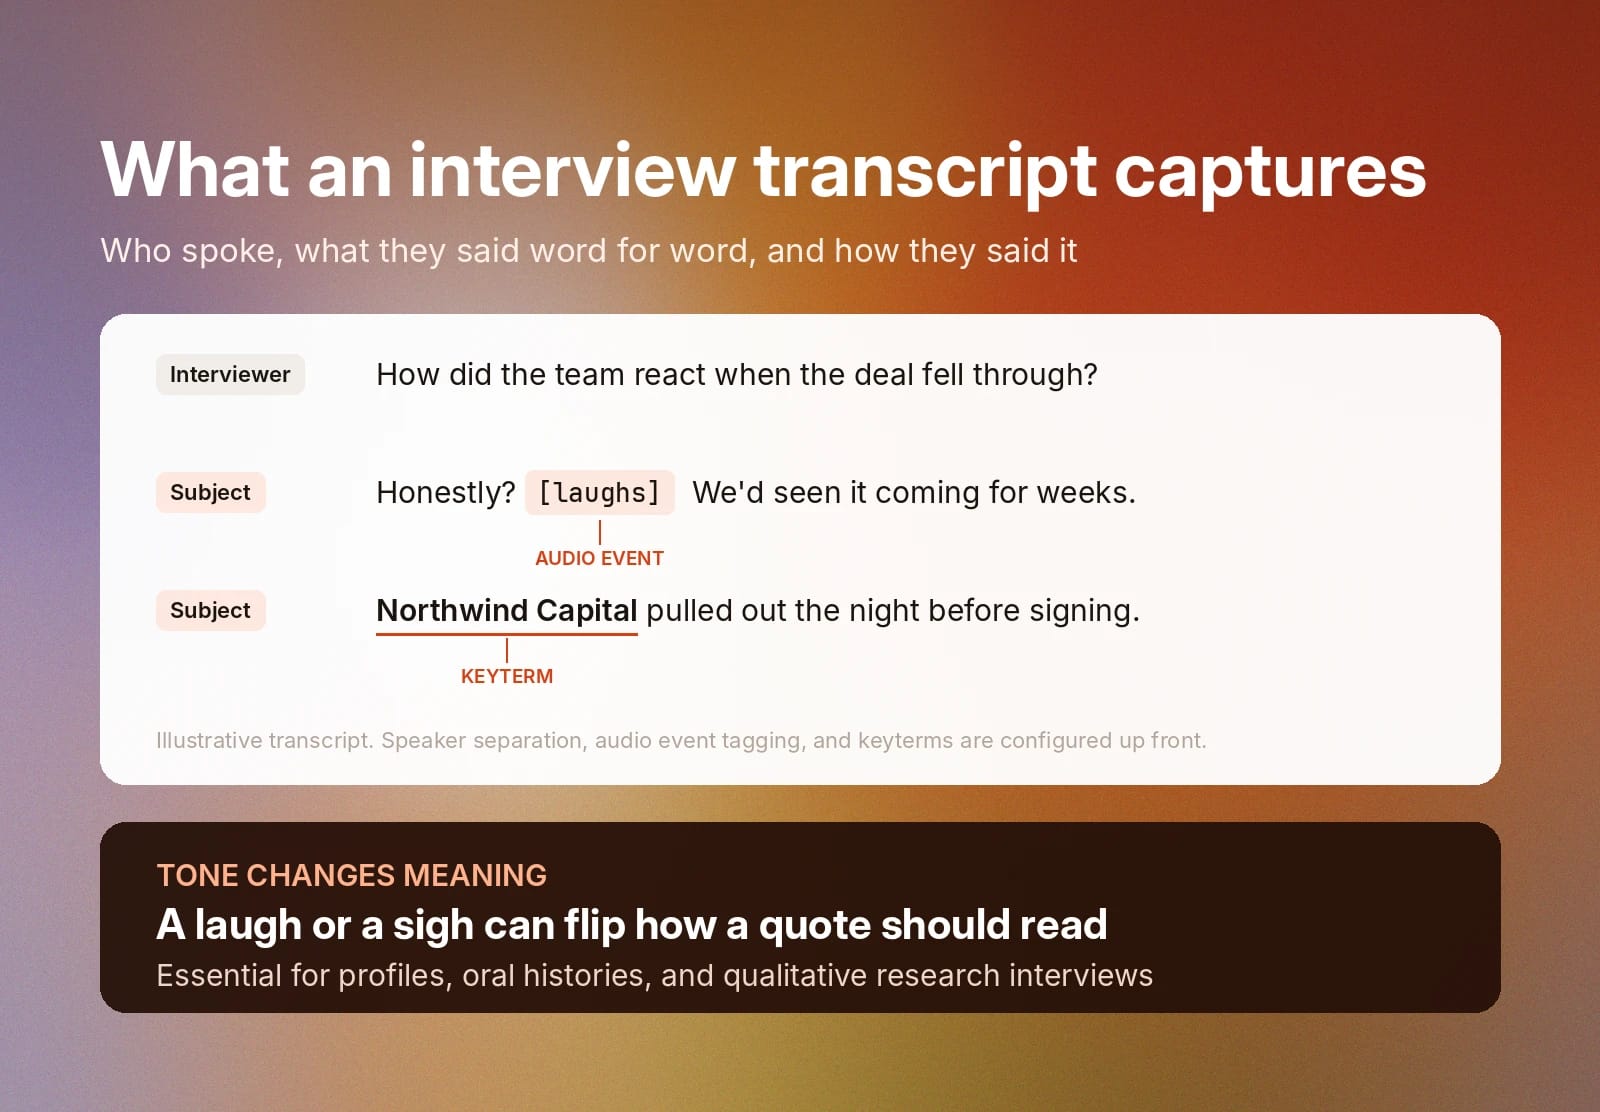
De toon van een spreker kan de betekenis van wat diegene zegt volledig veranderen, en je wilt ervoor zorgen dat deze nuances in je interviewtranscripten behouden blijven. Pas hiervoor de instellingen in je transcriptietool aan zodat deze lachen, fluisteren, zuchten en andere niet-spraakgebeurtenissen vastlegt.
Hiervoor gebruik je bij ElevenLabs de parameter tag_audio_events. Deze instelling wordt automatisch ingeschakeld wanneer je met ElevenCreative spraak naar tekst omzet en wanneer je ElevenAPI gebruikt.
Wil je deze gebeurtenissen niet vastleggen in je interviewtranscript, schakel dan bij het maken van een transcript in Playground ‘Audio-events taggen’ uit. Gebruik in ElevenAPI tag_audio_events="false" om deze instelling uit te schakelen.
Het taggen van niet-spraakgebeurtenissen is vooral belangrijk wanneer je iemand interviewt voor een profielartikel of mondelinge geschiedenis, omdat het de volledige bedoeling en expressie van de spreker vastlegt. Het is ook nuttig bij kwalitatieve onderzoeksinterviews, waar niet-spraakgebeurtenissen de uiteindelijke resultaten kunnen beïnvloeden.
Namen en termen correct vastleggen
Veel interviews bevatten namen en vakjargon die transcriptiemodellen niet zelfstandig zouden herkennen.
Met keyterm prompting kun je namen, woorden of zinsdelen verduidelijken voordat het transcriptieproces begint. Dit voorkomt dat het transcriptiemodel ze verkeerd spelt of verwart met andere, gangbaardere woorden.
ElevenLabs Scribe v2 ondersteunt maximaal 1.000 keyterms per transcript, terwijl ElevenLabs Scribe v2 Realtime 50 keyterms per transcript ondersteunt.
Twee manieren om te transcriberen: no-code-upload of de API
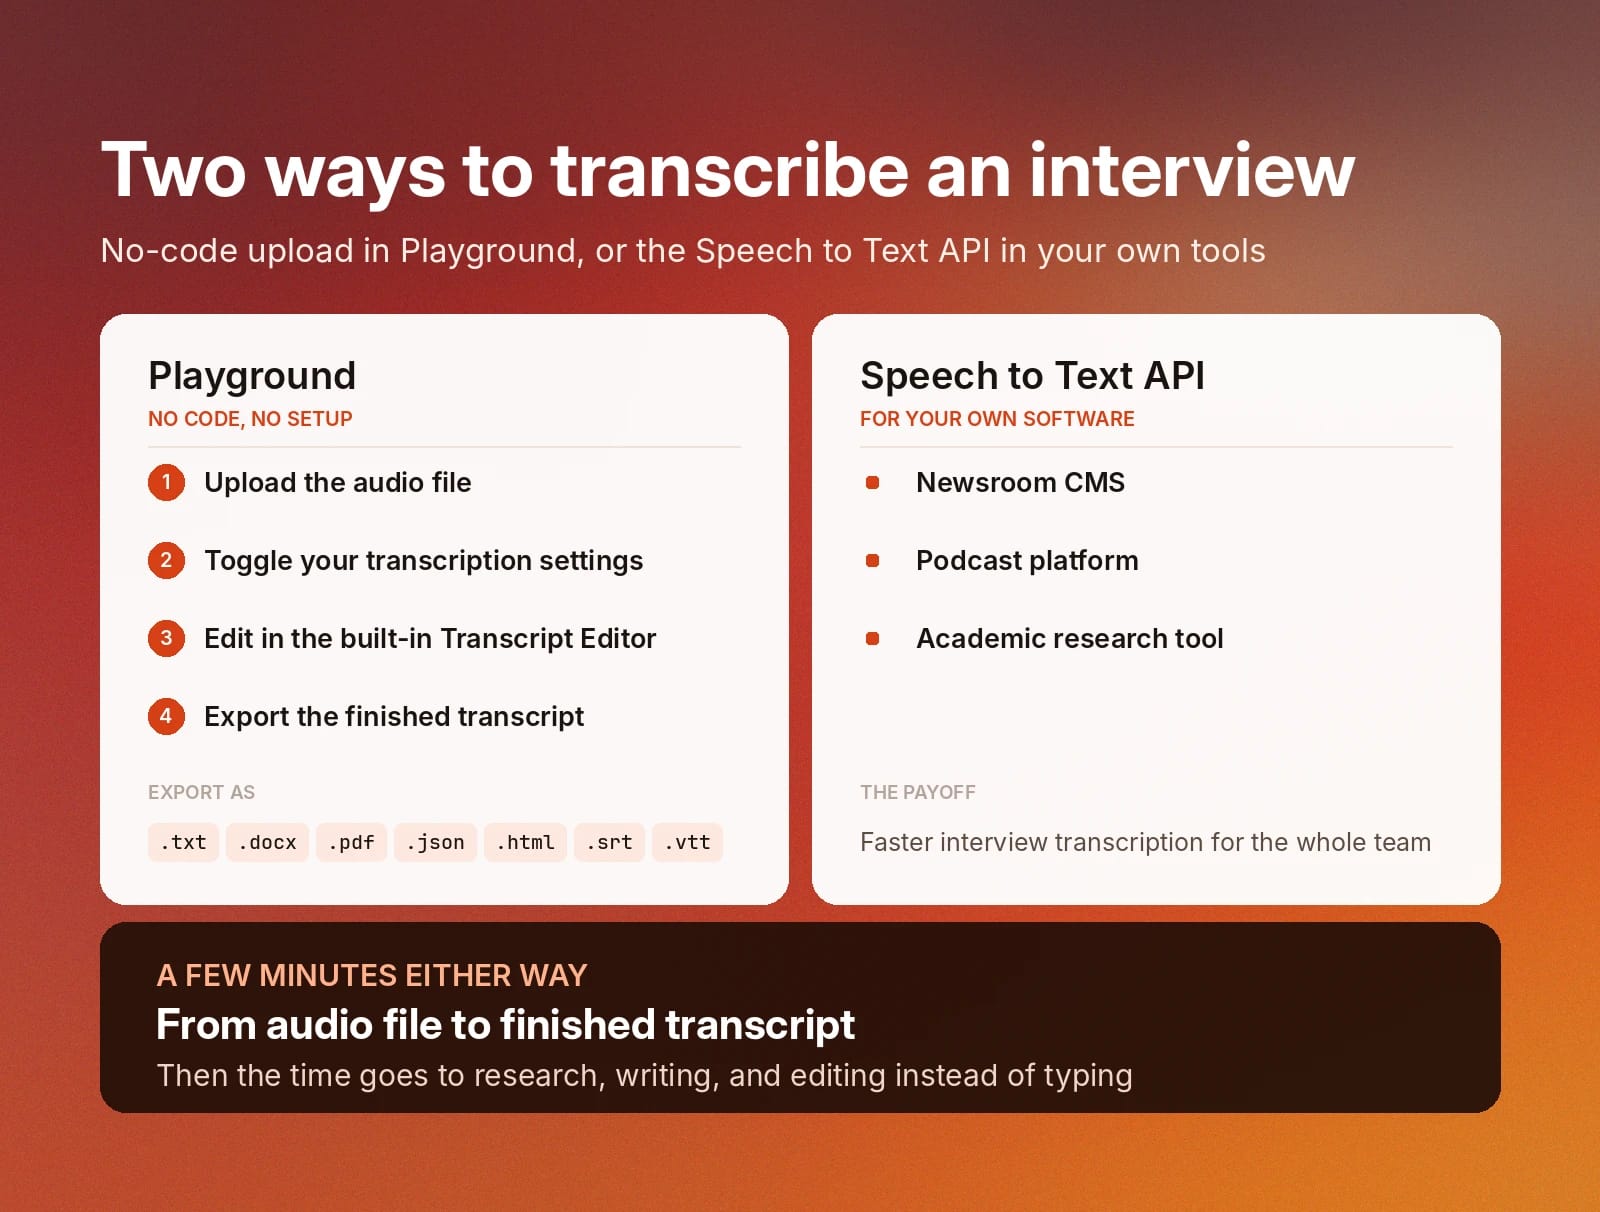
ElevenLabs biedt twee Speech to Text-methoden voor het transcriberen van interviews. ElevenLabs Playground is een no-code-tool, terwijl ElevenLabs Speech to Text API transcriptiemogelijkheden rechtstreeks toevoegt aan de digitale tools die je bouwt.
Een interview transcriberen met ElevenLabs Playground duurt slechts enkele minuten en vereist geen installatie. Upload het audiobestand rechtstreeks in het dashboard en schakel vervolgens de transcriptie-instellingen van je voorkeur in.
Voordat de transcriptie begint, kun je het taggen van niet-spraakgebeurtenissen, de verbatimmodus en de multichannelmodus aanpassen aan je voorkeuren. Je kunt ook relevante keyterms toevoegen.
Wanneer het transcript klaar is, kun je het eindresultaat rechtstreeks bewerken in de ingebouwde Transcript Editor. Je kunt het transcript ook exporteren naar diverse bestandsindelingen, waaronder .txt, .docx, .pdf, .json, .html, .srt en .vtt.
Als je eigen software bouwt en interviewtranscriptie wilt toevoegen, kun je de ElevenLabs Speech to Text API gebruiken. Door deze functie toe te voegen aan je CMS voor de redactie, podcastplatform of onderzoekstool, versnel je het transcriptieproces voor interviews voor je hele team.
Transcribeer je interviews met ElevenCreative
Bij het transcriberen van interviews is nauwkeurigheid essentieel. Functies zoals verbatimtranscriptie, multichannel-transcriptie, het taggen van audio-events en keyterm prompting leggen elk detail van je interview vast voor nauwkeurige resultaten.
ElevenCreative Speech to Text-tools maken in enkele minuten interviewtranscripten, zodat je meer tijd overhoudt voor onderzoek, schrijven, redigeren en meer. ElevenLabs Playground heeft een gebruiksvriendelijke interface zonder installatie, waarmee je in enkele minuten van audiobestand naar voltooid transcript gaat. ElevenAPI brengt interviewtranscriptie rechtstreeks naar je softwareplatform voor snellere workflows.
Registreer je vandaag nog bij ElevenLabs om je interviews te transcriberen of ontdek alles wat ElevenCreative te bieden heeft.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


