
Wat is sprekerdiarisatie? Hoe het werkt en toepassingsgebieden
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Speakerdiarisatie neemt een audiostream met een onbekend aantal sprekers en produceert een tijdlijn met gelabelde segmenten: spreker A van 0:00 tot 0:42, spreker B van 0:42 tot 1:15 en spreker A weer vanaf 1:15. Het systeem weet niet wie de sprekers zijn, maar wel dat het verschillende personen zijn, en houdt hun labels gedurende de hele opname consistent.
Dit proces maakt audio met meerdere sprekers bruikbaar. Vergaderverslagen, callcenteranalyses, transcripties van interviews, podcastbewerking en juridische verslagen zijn allemaal afhankelijk van niet alleen weten wat er is gezegd, maar ook wie het heeft gezegd.
In deze gids lees je hoe diarisatie werkt, hoe het verschilt van gerelateerde technieken zoals segmentatie en identificatie, welke open-sourcetools dit ondersteunen en hoe je meet of een diarisatiesysteem goed presteert.
Samenvatting
- Speakerdiarisatie segmenteert een audio-opname op basis van wie er spreekt en produceert gelabelde spreekbeurten zonder iemand bij naam te identificeren.
- Speakerdiarisatie verschilt van sprekersegmentatie, die vaststelt wanneer sprekers wisselen, en sprekeridentificatie, die stemmen aan echte namen koppelt.
- De prestaties van diarisatie worden gemeten met de diarization error rate (DER) voor de algehele nauwkeurigheid en de Jaccard error rate (JER) om te controleren of die nauwkeurigheid voor elke spreker geldt.
Wat is speakerdiarisatie en hoe werkt het?
Speakerdiarisatie is het proces waarbij een audiostream wordt opgedeeld in segmenten op basis van wie er spreekt. Een transcript met speakerdiarisatie voorziet elk audiosegment van een sprekeridentiteit. Simpel gezegd beantwoordt het de vraag: "Wie sprak wanneer?"
Een ruw transcript van een vergadering geeft je de woorden, terwijl een gediariseerd transcript aangeeft dat spreker 1 de vraag stelde, spreker 2 die beantwoordde en spreker 3 halverwege onderbrak.
De meeste speakerdiarisatiesystemen volgen een pipeline met vier fasen:
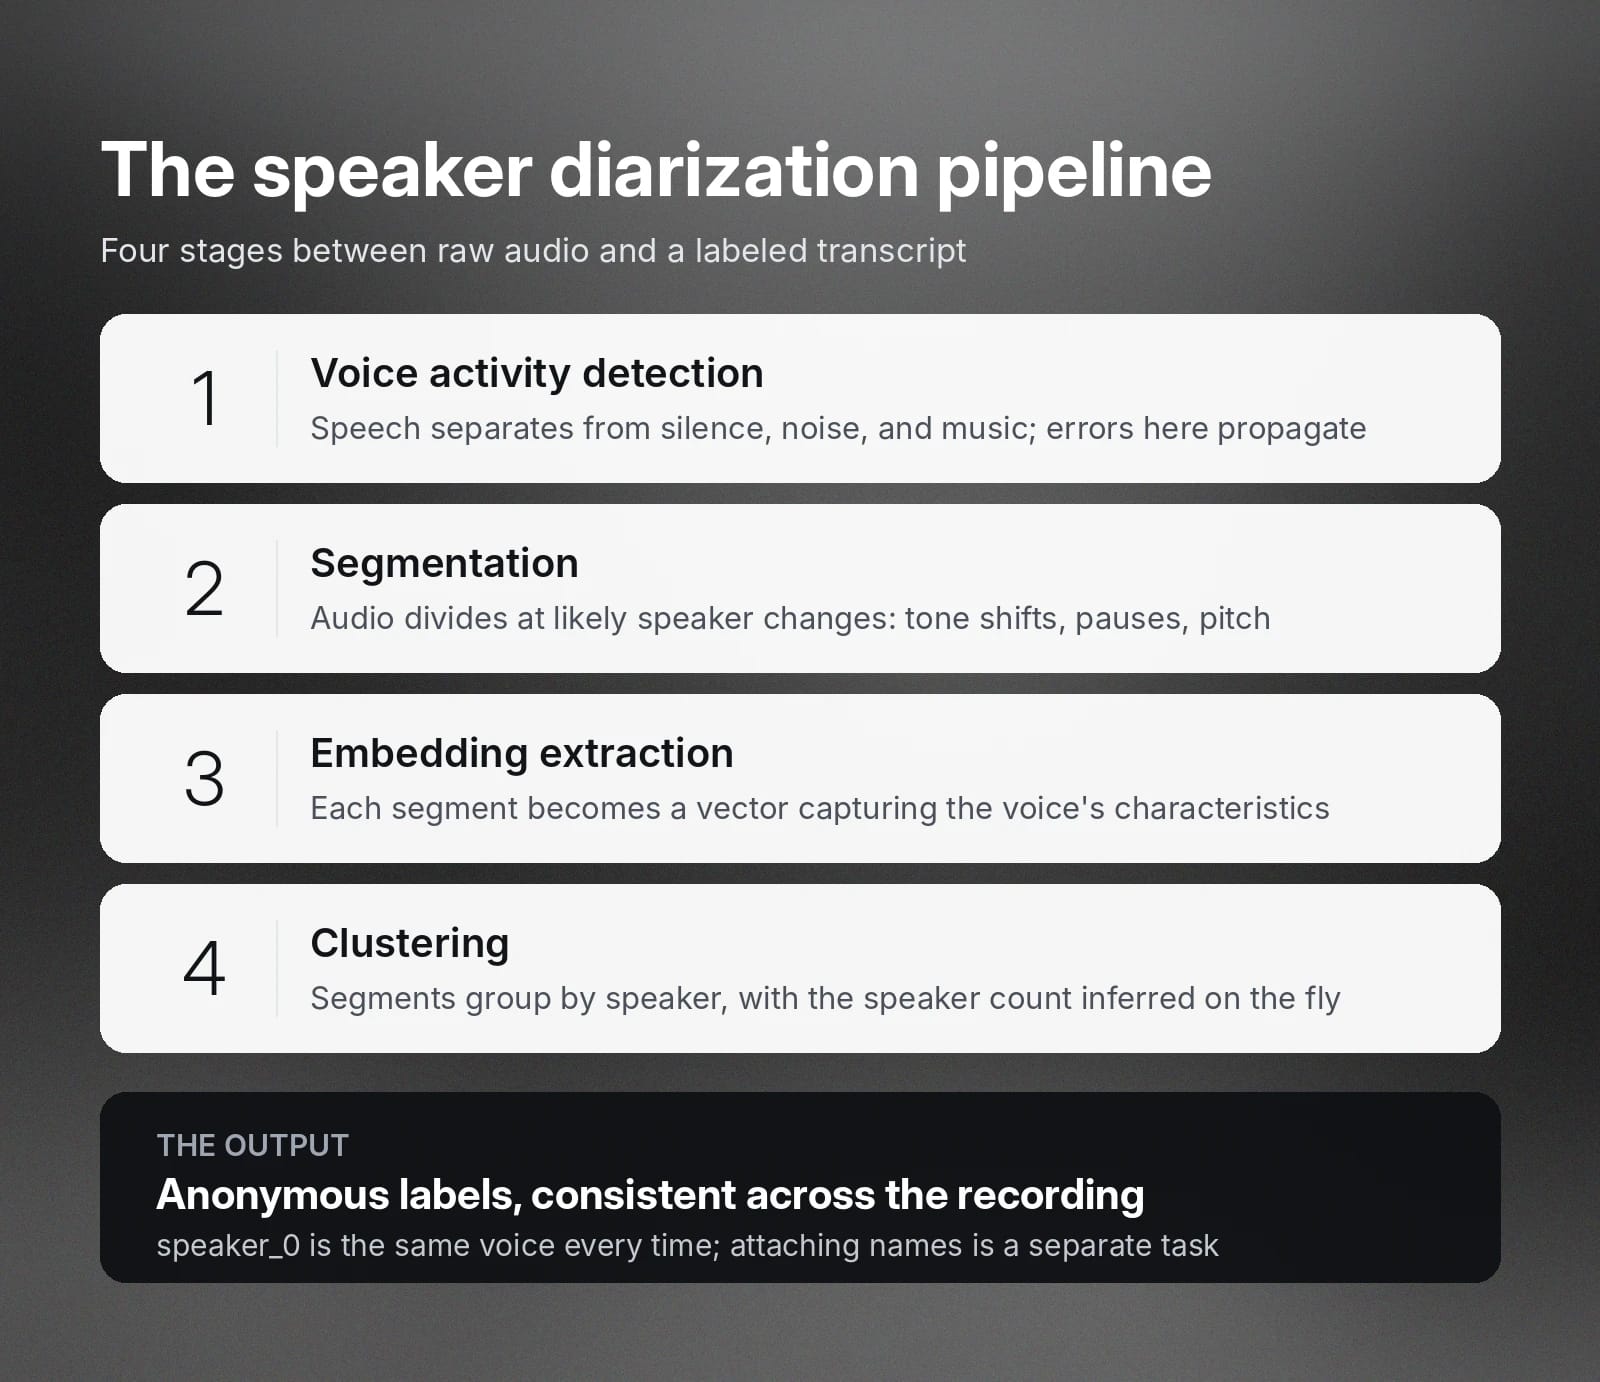
Laten we deze fasen nader bekijken.
Spraakactiviteitsdetectie (VAD)
Spraakactiviteitsdetectie scheidt spraak van al het andere: stilte, achtergrondgeluid, muziek, of toetsenbordklikken. Alleen de audiosegmenten met daadwerkelijke spraak gaan door naar de volgende fase.
Fouten in deze fase werken door in alle volgende fasen.
Segmentatie
Deze segmenten met spraak worden vervolgens opgedeeld op punten waar de spreker waarschijnlijk wisselt, bijvoorbeeld door een verandering in stemklank, een pauze tussen spreekbeurten of een ander toonhoogtepatroon. De meeste systemen detecteren deze wisselpunten rechtstreeks door de akoestische kenmerken aan beide kanten van een mogelijke grens te vergelijken.
Sommige segmentatietools knippen audio in korte, uniforme vensters, zoals stukken van twee seconden, en vertrouwen vervolgens op de clusteringfase om aangrenzende vensters van dezelfde spreker samen te voegen.
Embeddings extraheren
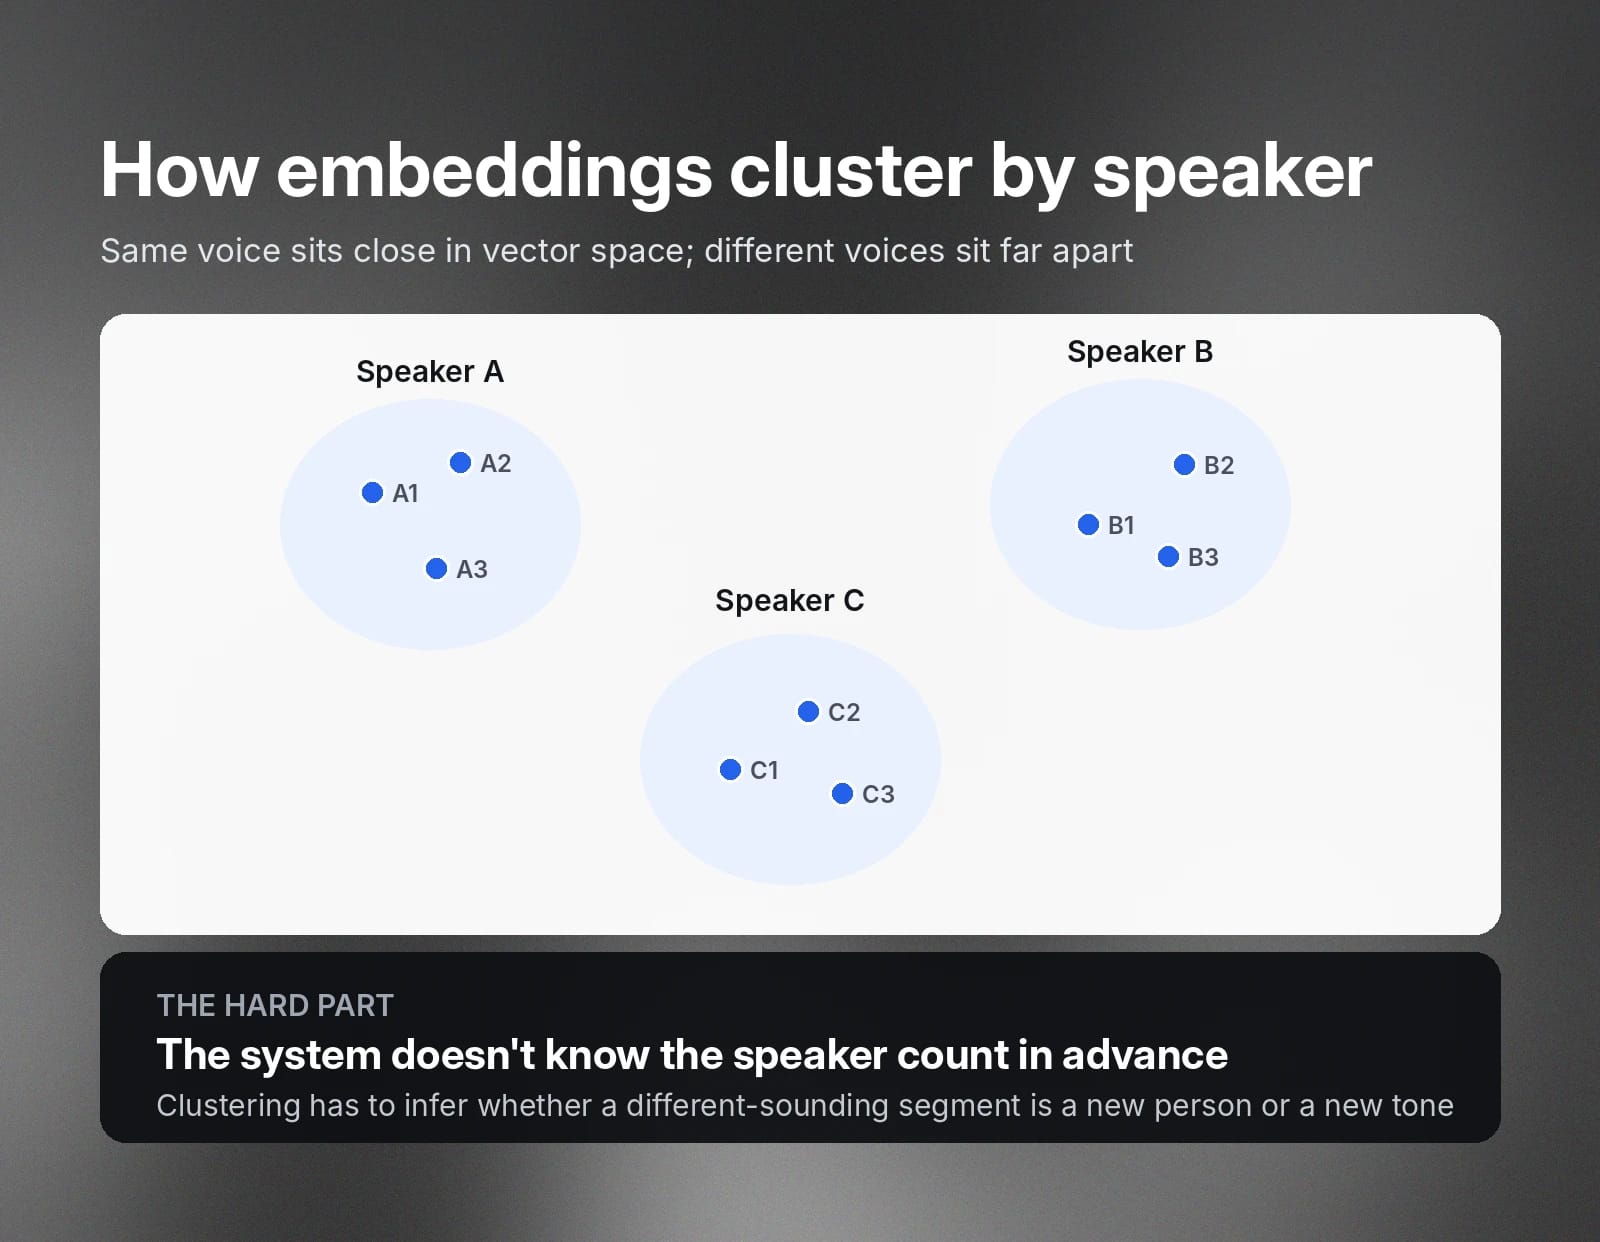
Elk spraaksegment wordt omgezet in een speaker embedding: een numerieke vector die de stemkenmerken vastlegt van degene die in dat segment spreekt. Embeddings van dezelfde spreker clusteren dicht bij elkaar in de vectorruimte, terwijl embeddings van verschillende sprekers verder uit elkaar liggen.
Clustering
De embeddings worden vervolgens gegroepeerd, zodat segmenten van dezelfde spreker hetzelfde label krijgen. Het systeem weet doorgaans niet vooraf hoeveel sprekers er zijn, dus het clusteringalgoritme moet dit afleiden en bepalen of dat iets anders klinkende segment van een nieuwe spreker komt of van dezelfde persoon met een andere toon.
De output is een set sprekerlabels gekoppeld aan tijdsbereiken, meestal samen met een transcript. Een gediariseerd transcript van een gesprek tussen twee personen ziet er bijvoorbeeld zo uit:
- [speaker_0] Bedankt dat je belt. Hoe kan ik helpen?
- [speaker_1] Hallo, ik bel over mijn factuur van vorige maand.
- [speaker_0] Natuurlijk, ik zoek het even op.
De labels zijn anoniem en intern consistent. Speaker_0 is telkens dezelfde stem wanneer deze verschijnt, maar het systeem weet niet dat speaker_0 Fergal heet. Echte identiteiten koppelen is een andere taak, die we hieronder bespreken.
Belangrijkste verschillen tussen sprekersegmentatie en sprekeridentificatie
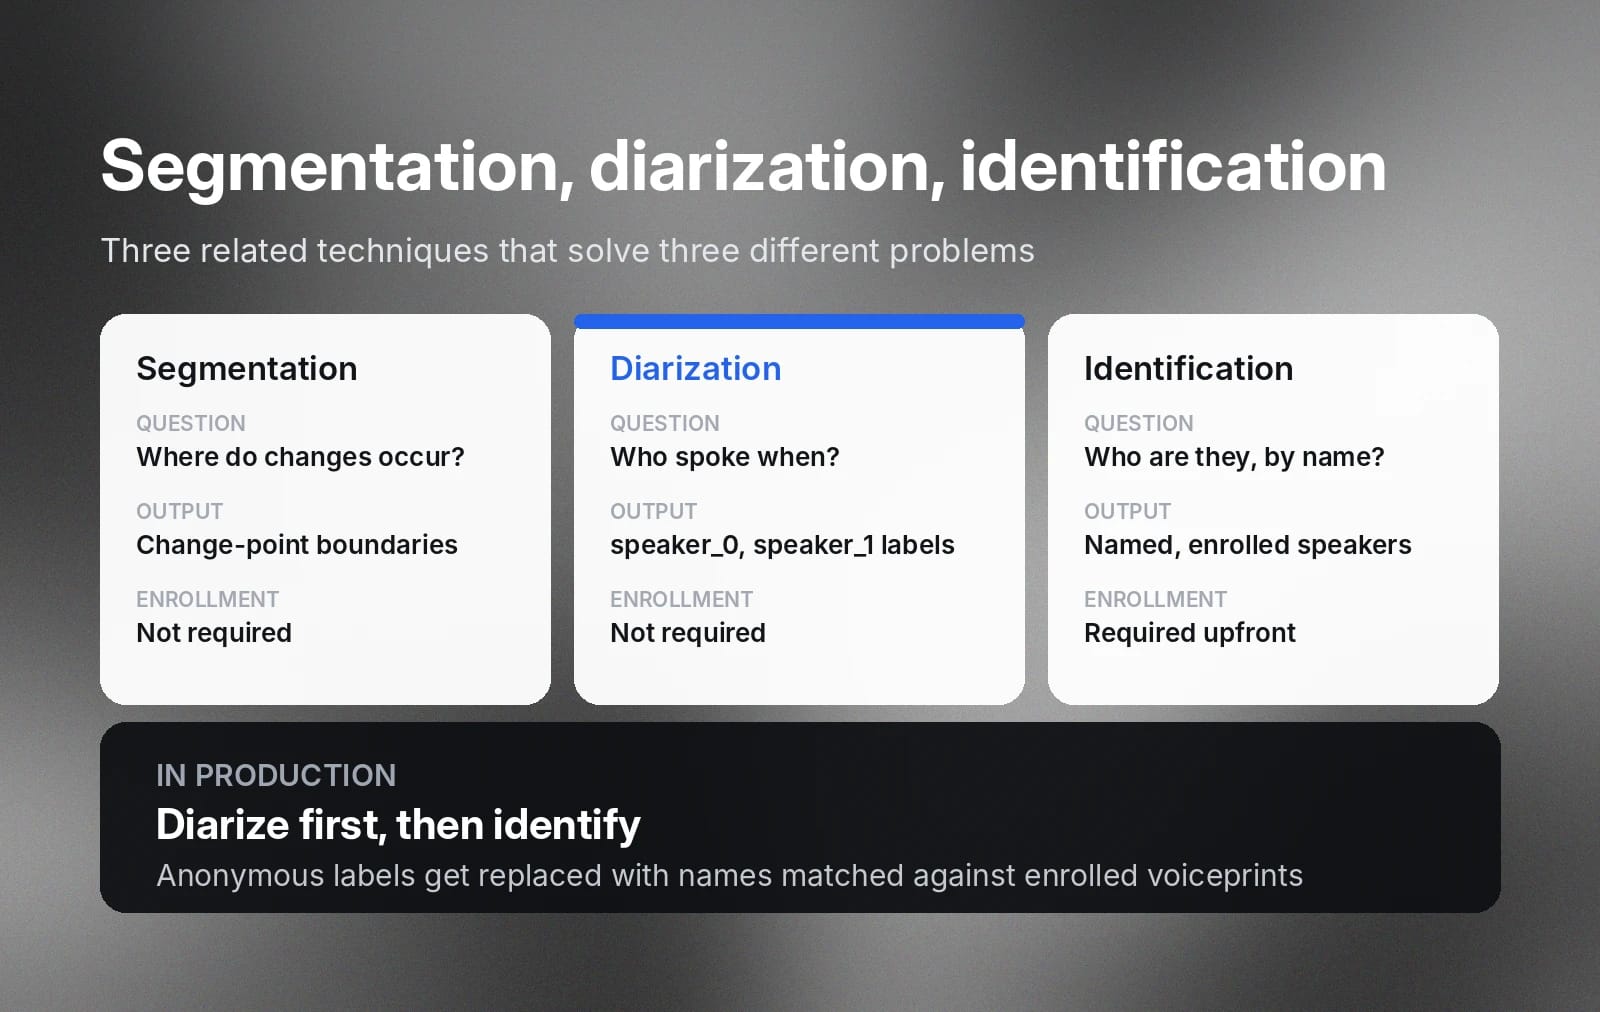
Sprekersegmentatie en sprekeridentificatie overlappen beide sterk met diarisatie, waardoor de drie vaak met elkaar worden verward.
Elk lost een iets ander probleem op, dus het is belangrijk het onderscheid te begrijpen bij het beoordelen van tools.
Zoals we eerder uitlegden, is sprekersegmentatie een stap binnen diarisatie die vroeg in de pipeline plaatsvindt. Het vindt de grenzen waar de spreker van de ene naar de andere stem wisselt, zonder labels toe te wijzen. Segmentatie vertelt je dat er op 0:42 een wisseling plaatsvond. Diarisatie bouwt daarop voort door de resulterende segmenten te groeperen en volledig gelabelde output te produceren, zodat je weet dat de stem op 1:15 dezelfde is als die aan het begin van de opname sprak.
Sprekeridentificatie is een afzonderlijke mogelijkheid buiten diarisatie, maar wordt er vaak mee gecombineerd. Identificatie bepaalt wie die sprekers daadwerkelijk zijn. Een identificatiesysteem vergelijkt stemmen met geregistreerde stemafdrukken en gebruikt een referentie van bekende sprekers om identiteiten terug te geven. Na identificatie worden speaker_0 en speaker_1 "Fergal" en "Eric".
Veel producten combineren deze tools om een uitgebreider eindtranscript te produceren. Een vergadertool kan dit automatisch doen, mogelijk zelfs met gegevens zoals de naam die iemand in Teams of Meet heeft ingesteld, zodat de bijdragen van elke aanwezige zonder handmatige controle bij naam worden toegeschreven.
Populaire open-sourcetools en -bibliotheken voor speakerdiarisatie
Open-sourcetools voor speakerdiarisatie zijn het overwegen waard wanneer je controle, flexibiliteit of lokale implementatie nodig hebt. De beste keuze hangt af van het type audio dat je verwerkt (telefoongesprekken, vergaderingen, podcasts, uitzendingen), je latencyvereisten en hoeveel engineeringtijd je kunt investeren.
Hier zijn enkele van de populairste opties.
Pyannote.audio
Pyannote.audio is een op PyTorch gebaseerde toolkit die specifiek is gebouwd voor speakerdiarisatie en een van de meest gebruikte open-sourceopties. De toolkit biedt vooraf getrainde pipelines voor de volledige diarisatiestack, waaronder VAD, segmentatie, embeddings en clustering, plus de bouwstenen om modellen te trainen of te finetunen op je eigen data.
De vooraf getrainde modellen worden via Hugging Face verspreid en worden vaak gebruikt als diarisatielaag in grotere transcriptieprojecten.
WhisperX
WhisperX combineert Whisper van OpenAI ASR met diarisatie en forced alignment. Whisper produceert op zichzelf sterke transcripties, maar wijst geen sprekerlabels toe en de tijdstempels zijn slechts bij benadering. WhisperX voegt uitlijning van tijdstempels op woordniveau toe en integreert op pyannote gebaseerde diarisatie. Zo ontstaan transcripties waarin elk woord zowel een nauwkeurige tijdstempel als een sprekerlabel heeft.
NVIDIA NeMo
NVIDIA NeMo omvat diarisatie als onderdeel van het bredere conversational AI-framework. Het biedt trainbare diarisatiemodellen, waaronder end-to-endbenaderingen die overlappende spraak verwerken, en is ontworpen voor teams die aangepaste spraaksystemen op schaal bouwen op GPU-infrastructuur.
Met elk van deze tools moet je de diarisatie-infrastructuur beheren, waaronder modelimplementatie, schaalvergroting, monitoring en updates. Voor teams die die operationele overhead niet willen, bieden beheerde API's voor spraakdiarisatie een eenvoudiger alternatief. Ze kunnen met bestaande workflows integreren of de volledige diarisatiepipeline afhandelen, waardoor ze zeer geschikt zijn voor productietoepassingen, zoals analyses voor klantondersteuning, vergadertranscriptie en podcastverwerking.
Realtime diarisatie: uitdagingen en toepassingen
Realtime diarisatie is aanzienlijk moeilijker dan diarisatie van een voltooide opname, omdat het systeem beslissingen moet nemen met onvolledige context.
Een offline systeem ziet de hele opname voordat het ergens een besluit over neemt. Het kan een stem op minuut 2 vergelijken met een stem op minuut 40 en met vertrouwen bepalen dat het dezelfde spreker is, omdat beide momenten tegelijk beschikbaar zijn. Een realtime systeem heeft die luxe nooit: het moet spraak labelen zodra die binnenkomt, zonder toegang tot wat er daarna wordt gezegd en met weinig tot geen mogelijkheid om een beslissing later te herzien.
Die ontbrekende toekomstige context maakt drie specifieke problemen veel moeilijker om realtime op te lossen:
- Latency versus nauwkeurigheid: Zonder de mogelijkheid om de hele conversatie heen en weer te bekijken, gaat het halen van striktere reactietijdbudgetten rechtstreeks ten koste van de nauwkeurigheid.
- Overlappende spraak: Wanneer mensen door elkaar praten, zou een systeem dat de audio opnieuw kan verwerken dit mogelijk kunnen ontwarren. Een realtime systeem moet dit onmiddellijk in één label dwingen of vertrouwen op gespecialiseerde modellen die met overlap omgaan.
- Korte uitingen: Een snel "ja" of "ga je gang" geeft het systeem nauwelijks genoeg stemmateriaal om mee te werken, en zonder omringende context moet het toch direct een label toewijzen.
Ondanks de moeilijkheid kunnen sommige toepassingen niet wachten tot een opname is afgelopen. Live ondertiteling voor vergaderingen en uitzendingen heeft sprekerlabels nodig terwijl mensen spreken. Callcentersoftware die tijdens een gesprek begeleiding biedt aan agenten moet realtime weten welke woorden de klant gebruikt. Voice agents die gesprekken met meerdere deelnemers afhandelen, moeten zonder vertraging bijhouden wie wat vraagt. In elk geval is een iets minder nauwkeurig maar direct systeem beter dan een nauwkeuriger systeem met vertraging.
Voor workloads die niet echt realtime labels vereisen, zoals analyses, compliancecontroles en transcriptgeneratie, blijft batchdiarisatie de betere keuze omdat deze aanzienlijk nauwkeuriger is.
Prestaties van speakerdiarisatie evalueren
Twee metriekwaarden zijn het belangrijkst wanneer je de nauwkeurigheid van diarisatie meet: de diarization error rate (DER), die de algehele nauwkeurigheid weergeeft, en de Jaccard error rate (JER), die controleert of die nauwkeurigheid voor elke spreker standhoudt.
DER berekent specifiek het deel van de totale spreektijd dat onjuist is toegeschreven. Het combineert drie soorten fouten:
- Onterechte spraakdetectie: Het systeem labelde een segment als spraak terwijl niemand sprak.
- Gemiste spraak: Iemand sprak, maar het systeem labelde dit als stilte.
- Sprekerverwarring: Spraak werd gedetecteerd, maar aan de verkeerde spreker toegeschreven.
DER = (onterechte detectie + gemiste spraak + sprekerverwarring) / totale spraakduur
Een DER van 10% betekent dat de fouten, verdeeld over die drie typen, gelijk zijn aan een tiende van de totale spreektijd. Lager is beter, en scores zijn alleen vergelijkbaar wanneer ze onder dezelfde omstandigheden op dezelfde data worden gemeten. DER varieert sterk met de audiokwaliteit, het aantal sprekers en hoeveel overlap de opname bevat.
De Jaccard error rate (JER) meet de nauwkeurigheid van diarisatie afzonderlijk voor elke spreker en middelt vervolgens het resultaat over alle sprekers. Voor elke referentiespreker koppelt de beoordelaar het dichtstbijzijnde sprekerlabel van het systeem en vergelijkt de tijd waarin ze correct overlappen met de totale tijd die aan een van beide sprekers is toegewezen.
Stel je bijvoorbeeld een vergadering van 60 minuten voor, waarin spreker A 50 minuten spreekt en spreker B 10 minuten. Een diarisatiesysteem labelt 48 van de 50 minuten van spreker A correct, maar slechts 4 van de 10 minuten van spreker B. De algehele DER kan er nog steeds relatief sterk uitzien, omdat het grootste deel van de vergadering aan spreker A toebehoort. JER laat het slechte resultaat van spreker B even zwaar meetellen, omdat spreker A en spreker B onafhankelijk worden beoordeeld voordat hun scores worden gemiddeld.
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
De uiteindelijke JER is het gemiddelde van die foutpercentages per spreker:
JER = (1 / N) * Σ[JER_speaker_i] of i = 1..N
Door zowel DER als JER bij te houden, krijg je een vollediger beeld van de nauwkeurigheid van de diarisatie: DER voor de algehele nauwkeurigheid en JER om te zien of die nauwkeurigheid voor elke deelnemer geldt, ook voor mensen die minder vaak spreken.
Testen met audio die representatief is voor productie
Bereken bij het evalueren van een speakerdiarisatiesysteem zowel DER als JER op audio die overeenkomt met je daadwerkelijke implementatieomstandigheden: je gebruikelijke aantallen sprekers, je audiokwaliteit en de mate van door elkaar praten.
Gepubliceerde benchmarkscores kunnen zijn gemeten op schone, gecontroleerde datasets zoals studioopnames, die zelden overeenkomen met hoe echte gespreksopnames of livevergaderingen klinken. Een systeem dat goed scoort op benchmarks kan nog steeds aanzienlijk slechter presteren op rumoerige, overlappende audio uit de praktijk. Test op je eigen data voordat je kiest voor een diarisatieproduct.
Ga aan de slag met ElevenAPI voor speakerdiarisatie
Als je klaar bent om een transcriptiefunctie met ondersteuning voor meerdere sprekers te bouwen, Scribe v2 van ElevenLabs maakt speakerdiarisatie beschikbaar via één Speech to Text-API. Stuur audio naar het endpoint met diarize=true en het JSON-antwoord voorziet elk woord van een spreker-ID, voor maximaal 32 sprekers, in meer dan 90 talen, in bestanden van maximaal 10 uur lang.
Twee opties breiden de standaardoutput van diarisatie uit. Voor gespreksopnames labelt detect_speaker_roles=true sprekers als agent en klant in plaats van met anonieme nummers. Als je workspace geregistreerde sprekerprofielen heeft, kan use_speaker_library=true gedetecteerde sprekers koppelen aan geregistreerde stemmen, waardoor diarisatie en identificatie in één request samenkomen.
Een parameter voor de diarisatiedrempel laat je de afweging tussen sprekers te veel opsplitsen en samenvoegen afstemmen. En wanneer je sprekers al op afzonderlijke audiokanalen zijn geïsoleerd, zoals bij stereo-opnames van gesprekken, transcriptie met meerdere kanalen sprekers toe op basis van kanaal en slaat diarisatie volledig over.
De Speech to Text-quickstart begeleidt je stap voor stap bij de eerste integratie. Voor gereguleerde implementaties voldoet het platform aan SOC 2, ISO 27001, PCI DSS L1 en HIPAA, met EU-dataresidentie en een modus zonder gegevensbewaring.
Klaar om speakerdiarisatie in je systemen te bouwen? Begin met je API-sleutel ophalen of bekijk de ElevenLabs Docs voor meer informatie.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


