
Tutorial JavaScript-spraakherkenning: bouw voice-UX
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Spraakherkenning toevoegen aan websites en browsergebaseerde apps is nu eenvoudiger dankzij browser-native speech to text-API's (STT), zoals de Web Speech API. Ontwikkelaars kunnen eenvoudig microfooninvoer streamen, audiogegevens analyseren en transcripts verwerken via API-aanroepen, zonder een lokale server voor automatische spraakherkenning te bouwen.
De Web Speech API is een veelgebruikte API voor spraakherkenning waarmee je spraakopdrachten in JavaScript implementeert. De API biedt methoden, argumenten en properties waarmee je realtime transcriptie in een webbrowser kunt uitvoeren. Ontwikkelaars kunnen de Web Speech API echter beperkt vinden voor complexe webclients.
In deze gids doorlopen we hoe je een eenvoudige webapp voor JavaScript-spraakherkenning opzet met de Web Speech API, wat de beperkingen zijn en welke alternatieven er zijn om robuustere clients voor realtime transcriptie te bouwen.
Samenvatting
- Web Speech API is een browser-native speech to text-API die microfoonaudio naar een cloudbackend stuurt voor verwerking.
- Ontwikkelaars gebruiken de API-klasse SpeechRecognition om JavaScript-applicaties voor spraakopdrachten te bouwen.
- Houd bij het bouwen van een app voor spraakherkenning rekening met de privacy van gebruikers door aan te geven dat er audio wordt opgenomen.
- De Web Speech API heeft verschillende beperkingen, waaronder inconsistente transcriptie, afhankelijkheid van de browser en een gebrek aan intentherkenning.
- ElevenLabs biedt zeer nauwkeurige speech to text-API's van productiekwaliteit die zowel client- als server-side streaming ondersteunen.
Hoe de Web Speech API werkt
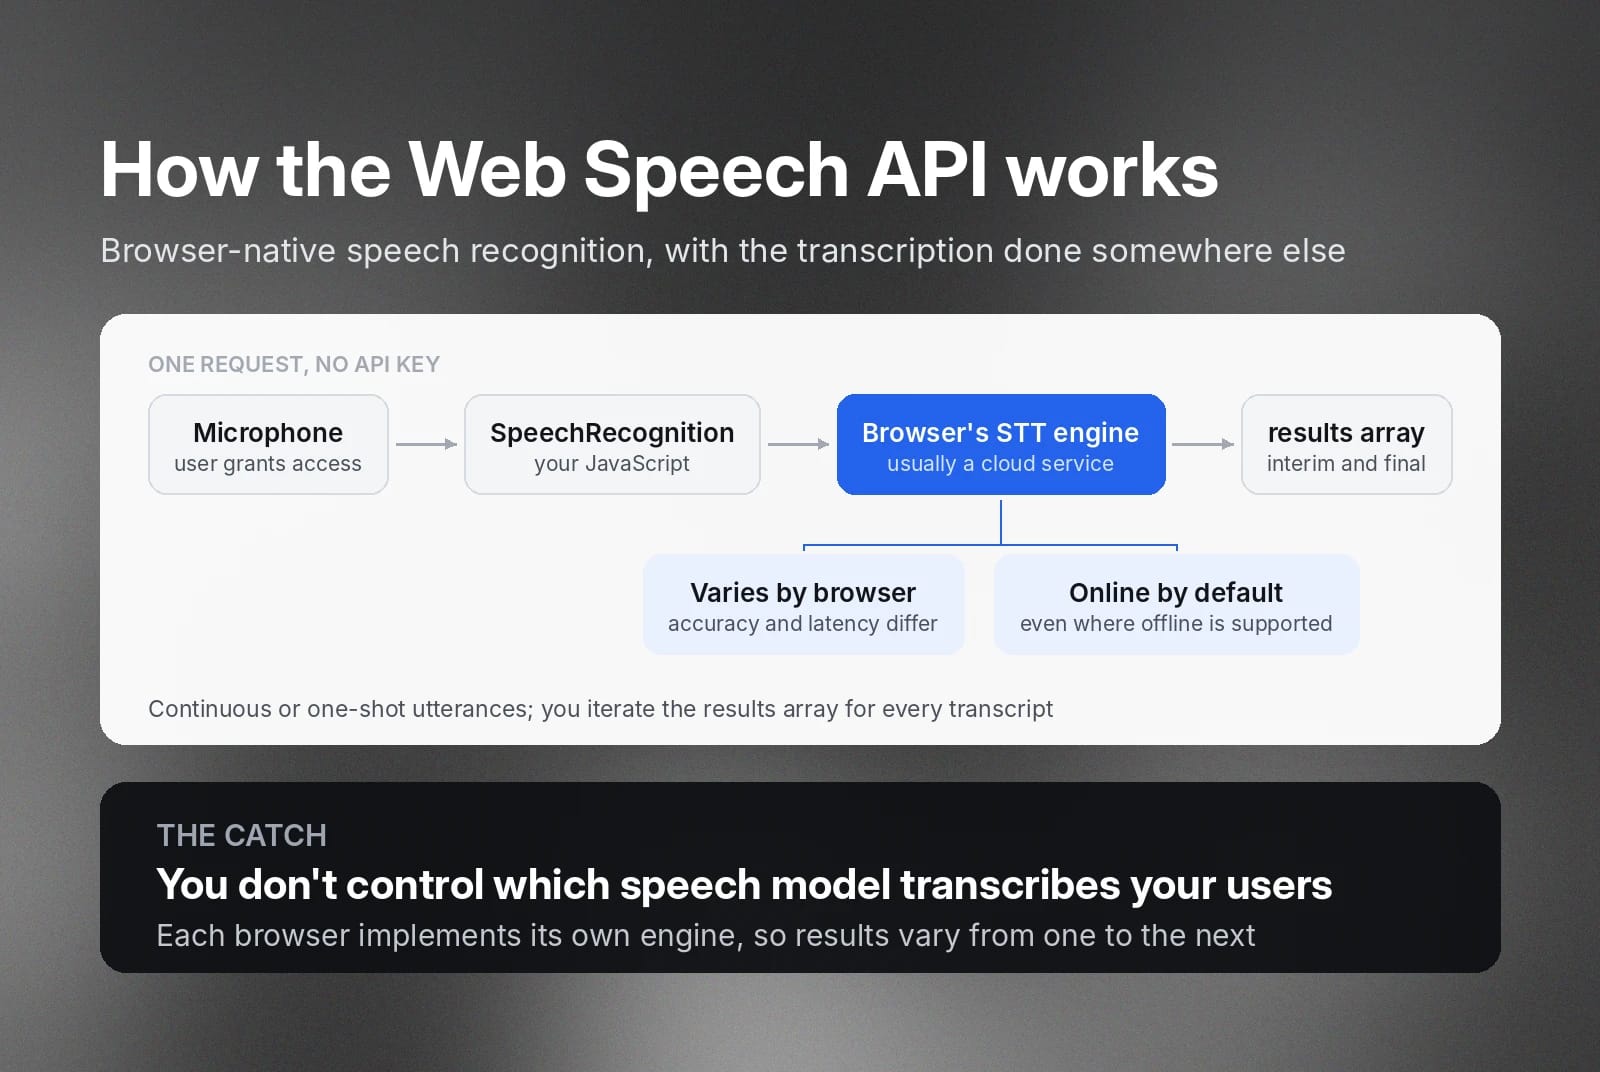
De Web Speech API biedt webontwikkelaars browser-native spraakherkenning zonder dat daar een lokale server voor nodig is. In feite stuurt de Web Speech API een audiostream vanuit je webbrowser naar een cloudbackend om audio te verwerken, analyseren en om te zetten in transcripts. Omdat transcriptie afhankelijk is van de backend-engine van de browser, kunnen resultaten per browser verschillen.
Over het algemeen vereist de Web Speech API een actieve internetverbinding om audiostreams te transcriberen, vooral als je voor Chrome en Safari bouwt. Sommige browsers ondersteunen nu echter offline transcriptie. Bij offline transcriptie werkt de browser als de speech to text-engine, die fonemen herkent en omzet in samenhangende tekst.
Ongeacht welke browser je gebruikt, de basisprincipes van de API zijn hetzelfde.
- Je hebt geen API-sleutel nodig om een API-request te doen.
- De Web Speech API ondersteunt doorlopende of eenmalige uitingen.
- De API retourneert zowel tussentijdse als definitieve transcripts.
Omdat elke browser de STT-engine anders kan implementeren, kunnen nauwkeurigheid en latency verschillen.
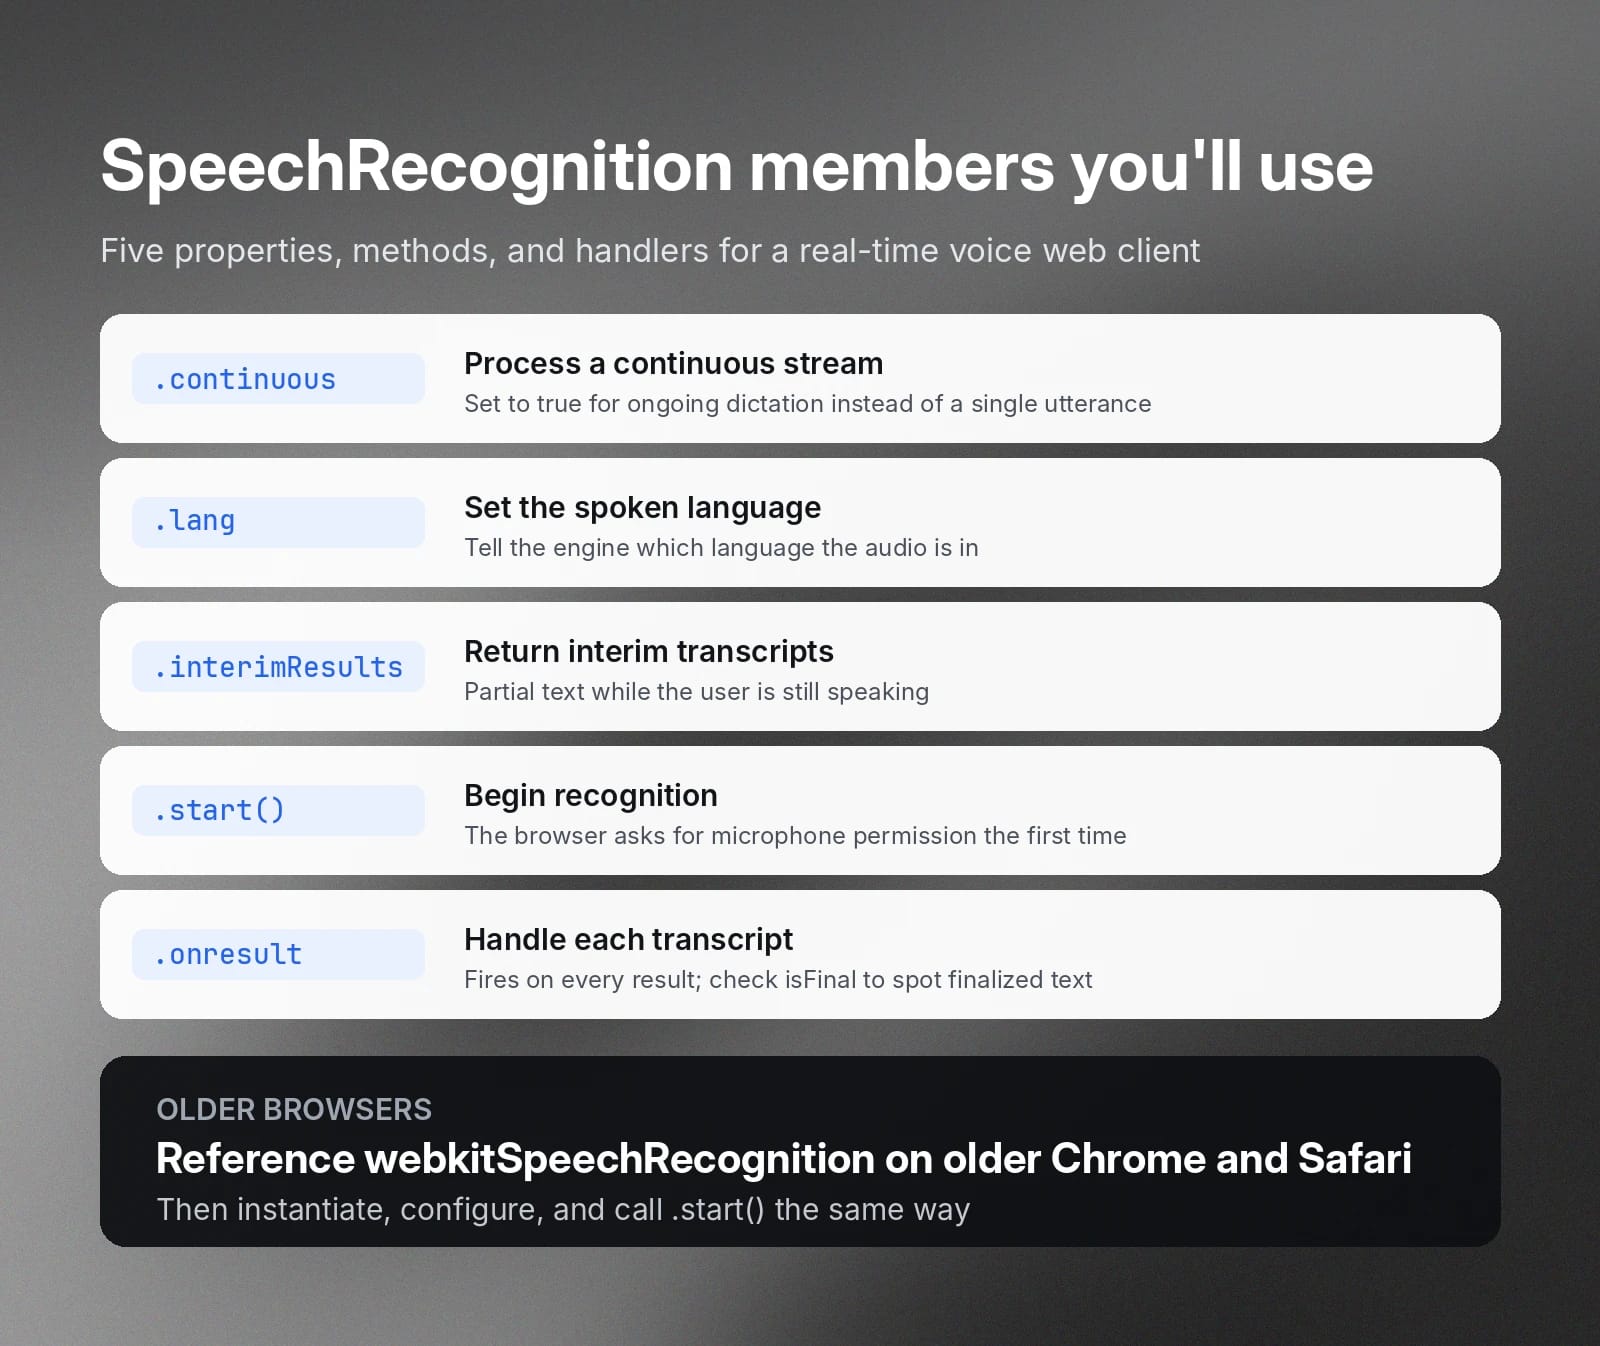
Om de Web Speech API te gebruiken, initialiseer je de SpeechRecognition-interface in je JavaScript-code. Vervolgens gebruik je tijdens het programmeren methoden, attributen en event handlers. Hieronder staan enkele onderdelen die je gebruikt om een webclient voor spraakgestuurd zoeken te bouwen.
- SpeechRecognition.continuous: Hiermee kan de spraakengine een doorlopende stream verwerken wanneer deze is ingesteld op true.
- SpeechRecognition.lang: Stelt de taal van de audio in.
- SpeechRecognition.interimResults: Geeft de engine de opdracht om tussentijdse transcripts te retourneren.
- SpeechRecognition.start(): Start het spraakherkenningsproces.
- SpeechRecognition.onresult: Accepteert een event handler, die de API activeert wanneer de transcriptie is voltooid.
De Web Speech API retourneert de transcriptie in een stringarray. Wanneer de STT-engine een transcript retourneert, tussentijds of definitief, vind je dat in de array results. Deze kan een of meer strings retourneren. Daarom moet je door de resultaatstrings itereren om alle getranscribeerde tekst op te halen.
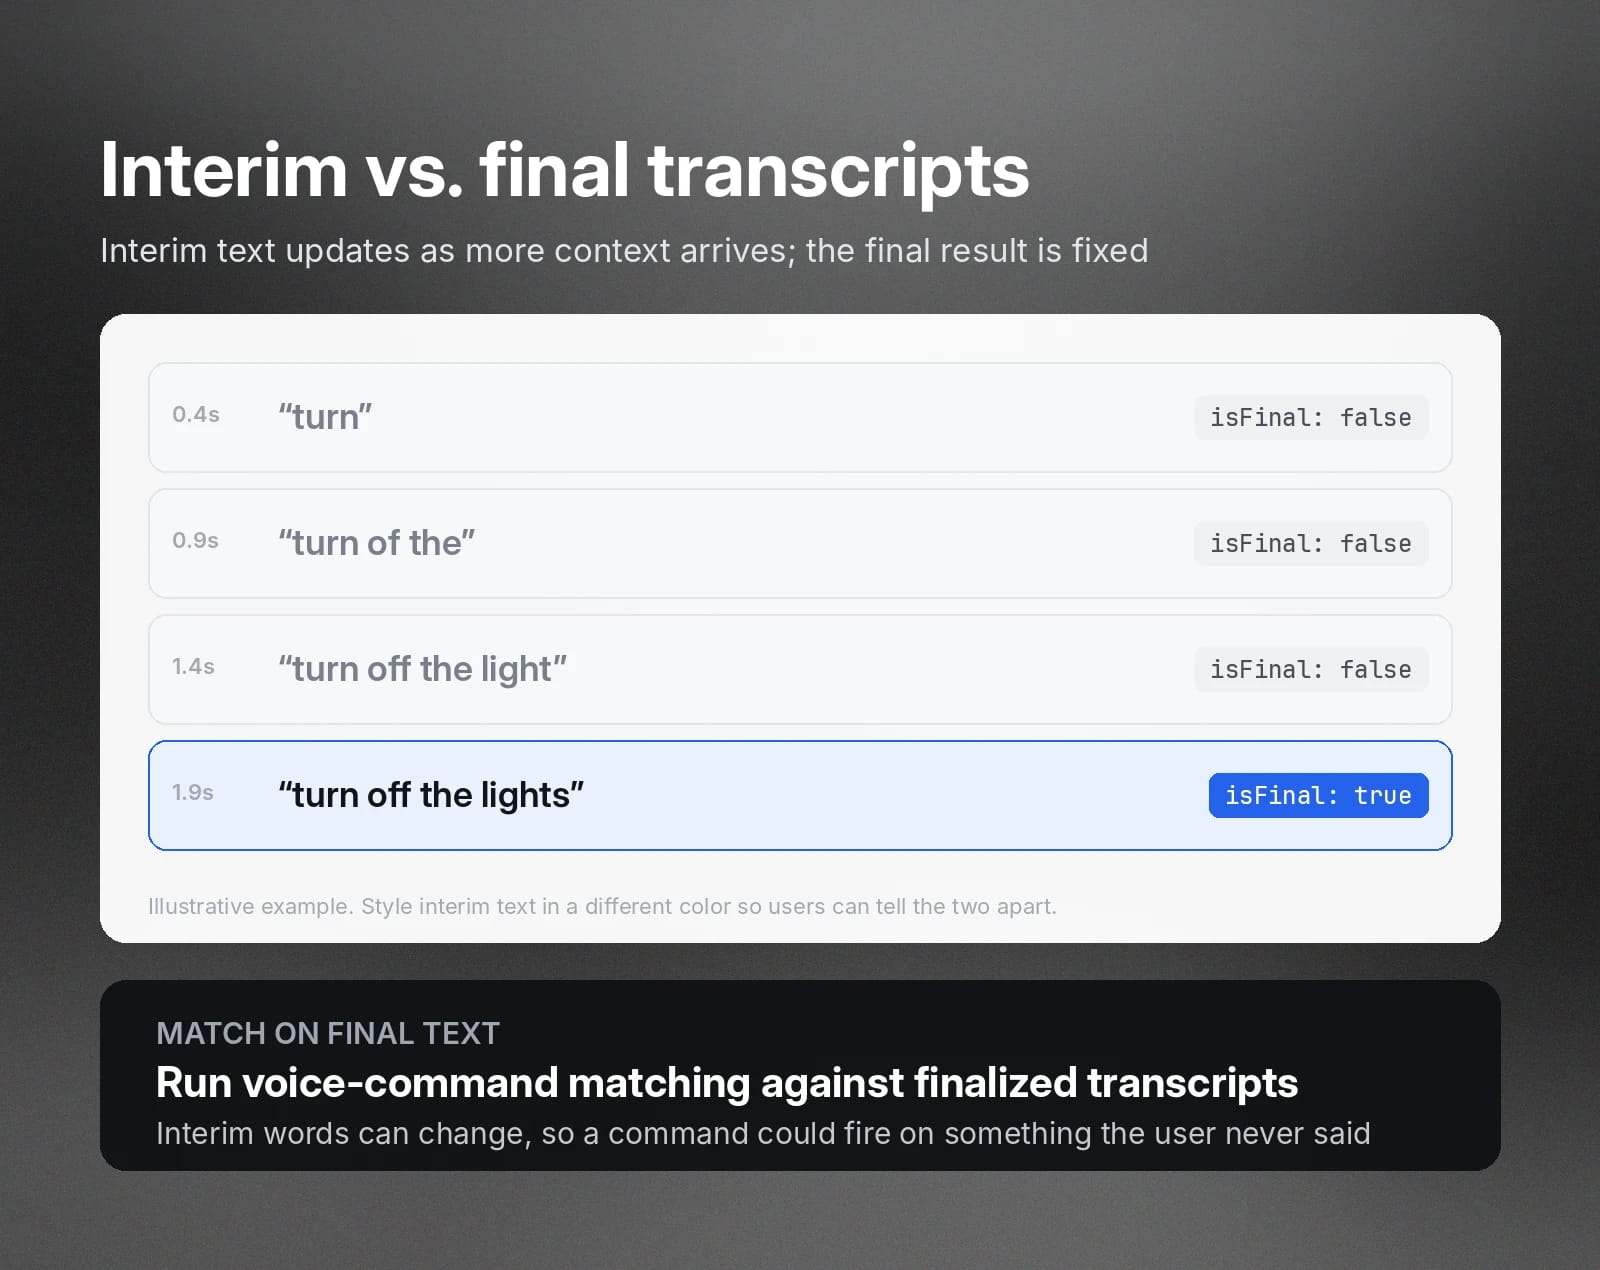
Opmerking: Als je tussentijdse transcriptie hebt ingeschakeld, controleer je de property isFinal om te bepalen of de tekst een definitief transcript is.
Bouw een voorbeeld voor JavaScript-spraakherkenning
Dit voorbeeld gebruikt de JavaScript-interface SpeechRecognition om een webapp voor realtime transcriptie te bouwen. De onderstaande screenshot toont de voltooide pagina.
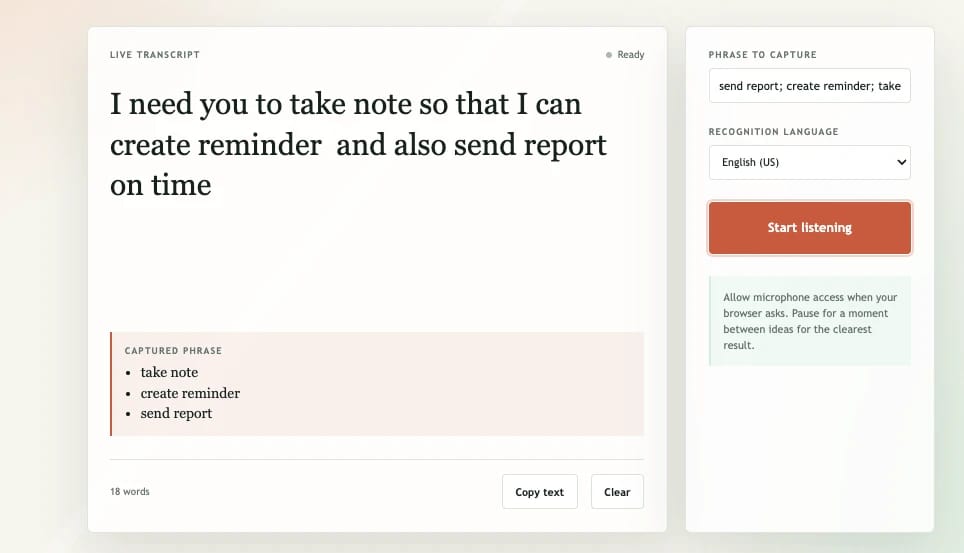
Op de voorbeeldpagina start een knop Luisteren starten de opname. Terwijl de gebruiker spreekt, stuurt de browser de audio naar de STT-engine, wacht op de transcriptie en toont zowel de tussentijdse als de definitieve tekst.
Het voorbeeld bevat ook een functie voor spraakopdrachten, die specifieke termen vastlegt die de gebruiker opgeeft. Deze vergelijkt het transcript met een vooraf bepaalde lijst met zinnen in je eigen code, wat verschilt van keyterm prompting in een speech to text-API.
De onderstaande snippets tonen de belangrijkste onderdelen van dit voorbeeld.
Stel de SpeechRecognition API in en vraag microfoontoegang aan
Om deze in je code te gebruiken, moet je eerst een instantie van de klasse SpeechRecognition maken. Als je een oudere versie van Chrome of Safari gebruikt, verwijs je naar webkitSpeechRecognition.
Maak vervolgens een SpeechRecognition-instantie en configureer de streamingmodus, ondersteuning voor tussentijdse transcriptie en de gesproken taal.
Daarna kun je transcriptie starten door de methode .start() aan te roepen.
Wanneer je het spraakherkenningsproces voor het eerst start, vraagt de browser de gebruiker om toestemming. De gebruiker moet op Toestaan klikken om transcriptie te starten. Anders retourneert de API de waarde "not-allowed” in de SpeechRecognitionErrorEvent handler.
Toon live transcripts en definitieve resultaten
In dit voorbeeld tonen we het transcript terwijl de gebruiker in de microfoon spreekt. Hiervoor koppelen we een functie aan de event onresult.
Tussentijdse transcripts zijn niet definitief. De getoonde tekst komt dus mogelijk niet exact overeen met de woorden die je hebt uitgesproken. Wanneer de STT-engine meer context krijgt uit volgende woorden, corrigeert deze het transcript en retourneert het in de string.
Je kunt tussentijdse tekst ook in een andere kleur opmaken, zodat die zich onderscheidt van het definitieve transcript. Deze CSS doet dat:
Voeg spraakopdrachten toe in JavaScript
Voeg een tekstvak toe waarin gebruikers de zinnen invoeren die ze willen detecteren, gescheiden door puntkomma's. (Je kunt de zinnen ook in een JSON-bestand opslaan en in je code laden.)
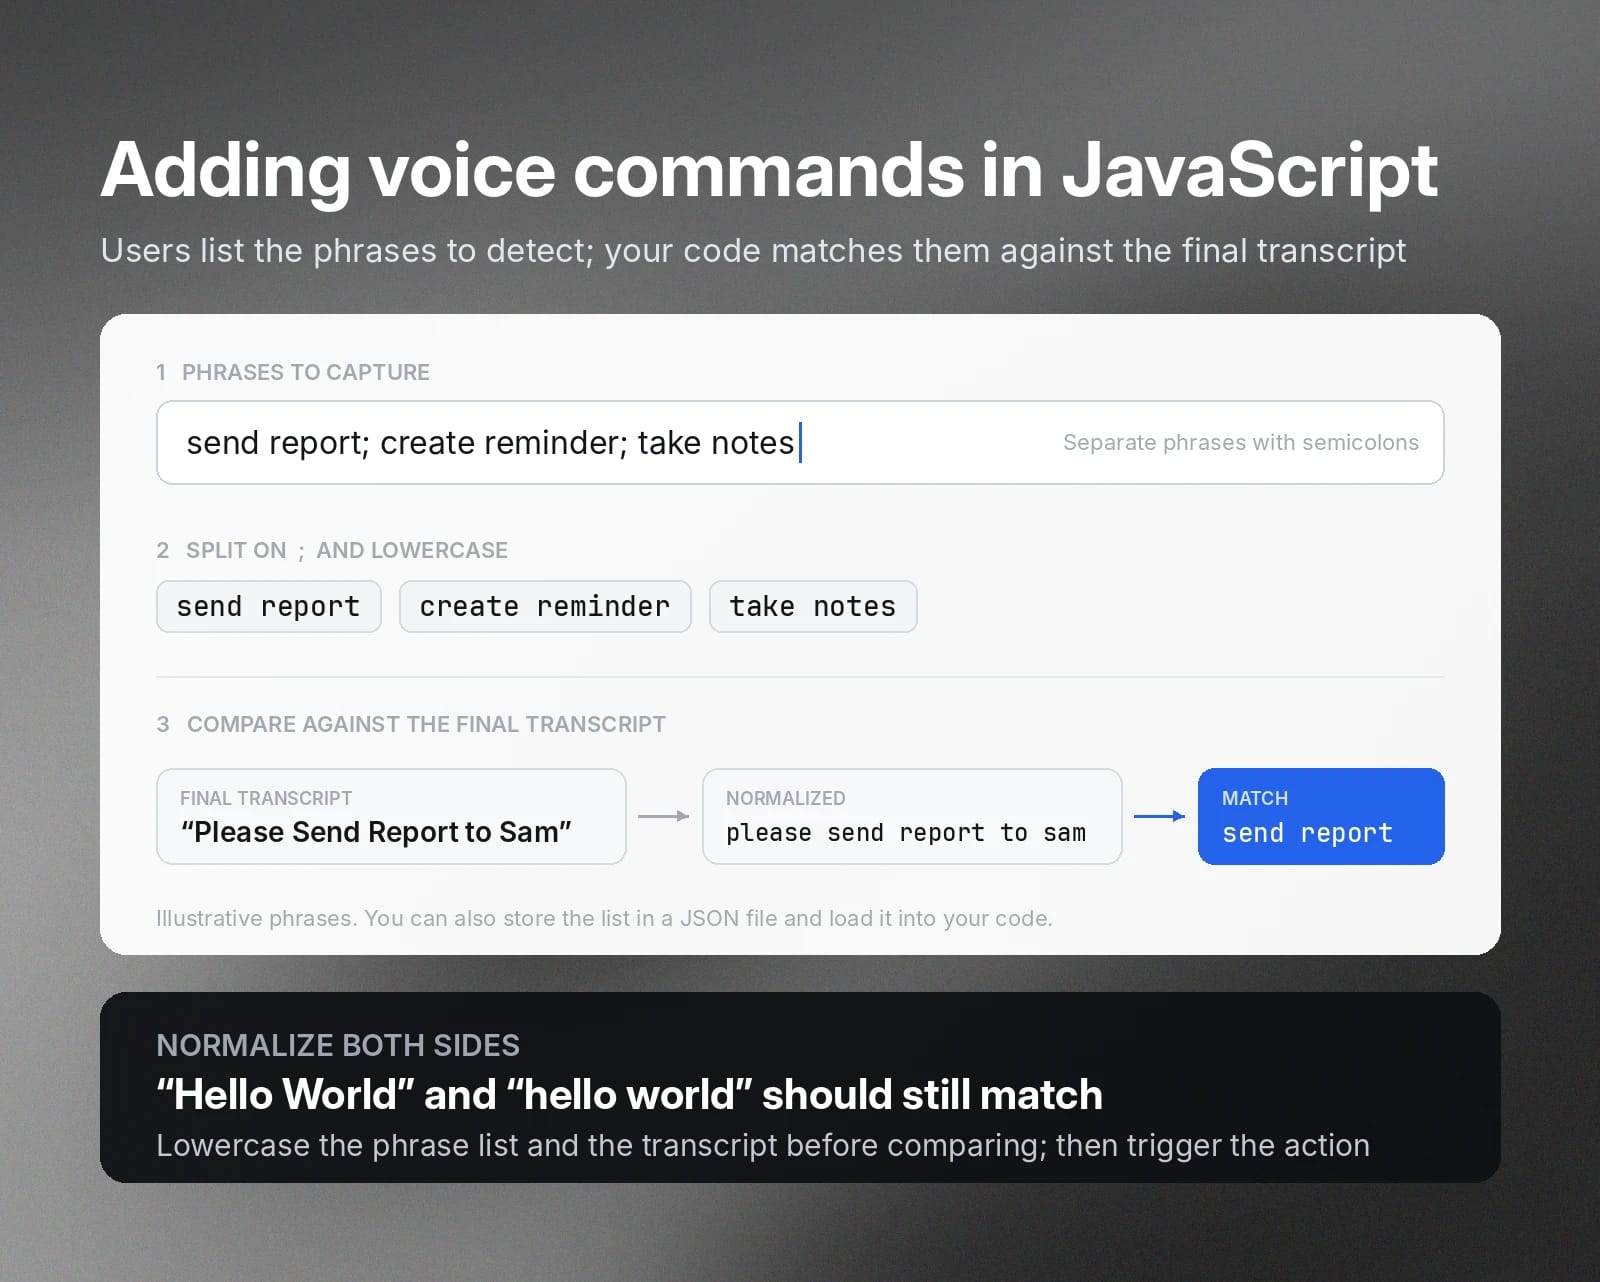
Maak vervolgens een functie die het definitieve transcript vergelijkt met de lijst met zinnen. Normaliseer bij tekstvergelijking beide lijsten door ze om te zetten naar kleine letters. Gebruikers kunnen woorden namelijk met hoofdletters schrijven, waardoor er geen overeenkomst kan worden gevonden, zelfs als het hetzelfde woord is. Zo moeten “Hello World” en “hello world” een overeenkomst opleveren, ook als een van beide met hoofdletters is geschreven.
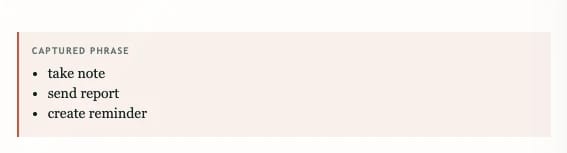
Elke keer dat de code een transcript ontvangt, doorloopt deze de lijst met zinnen. Als er een overeenkomst is, activeer je een actie, zoals het starten van een applicatie of, in dit geval, het tonen van de overeenkomende zin in een apart paneel.
Verwerk browserondersteuning, machtigingen en herkenningsfouten
De Web Speech API maakt speech to text-herkenning in JavaScript toegankelijk, maar werkt niet altijd zonder problemen. Gebruikers kunnen een browser gebruiken met beperkte of geen backendondersteuning voor de SpeechRecognition API. In sommige gevallen zorgen netwerkproblemen ervoor dat de transcriptie mislukt.
Je code moet deze situaties daarom verwerken en gebruikers hierover informeren.
Je kunt gebruikers bijvoorbeeld informeren dat ze Chrome of Edge moeten gebruiken, browsers waarin de SpeechRecognition API aantoonbaar werkt.
Om fouten te verwerken, koppel je ondertussen een foutafhandelingsfunctie aan de onerror event handler en verwerk je de betreffende foutcode.
Bijvoorbeeld:
Foutcode
Actie
not-allowed
Toon tekst die de gebruiker vertelt de browserinstellingen te controleren.
no-speech
Instrueer de gebruiker om dichter bij de microfoon te spreken
network
Vraag de gebruiker om de internetverbinding te controleren
aborted
Informeer de gebruiker dat het spraakherkenningsproces is gestopt.
Maak JavaScript-spraakherkenning toegankelijk en privacybewust
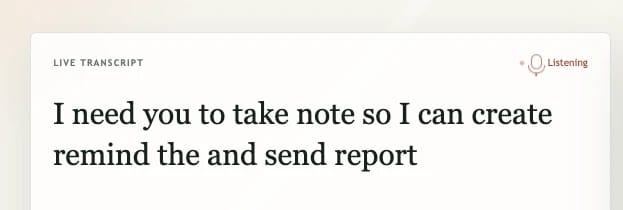
Houd bij de integratie van de Web Speech API rekening met privacy. Toon altijd een visuele of verbale indicator voordat de webclient begint met opnemen. Toon bijvoorbeeld een luistericoon als visuele aanwijzing terwijl de JavaScript-code voor spraakherkenning het microfoonsignaal actief naar de speech to text-engine stuurt.
Gegevensprivacy is een ander aandachtspunt voor ontwikkelaars. Wanneer je transcribeert met de SpeechRecognition API, voert de API transcriptie standaard online uit. Zelfs als de browser offline speech to text ondersteunt, probeert de API eerst online transcriptie uit te voeren.
Deze technische specificaties zijn cruciaal wanneer je transcriptiediensten bouwt waarbij datalocatie, governance en compliance strikt worden gereguleerd.
Weet wanneer spraakherkenning in de browser niet genoeg is voor productie
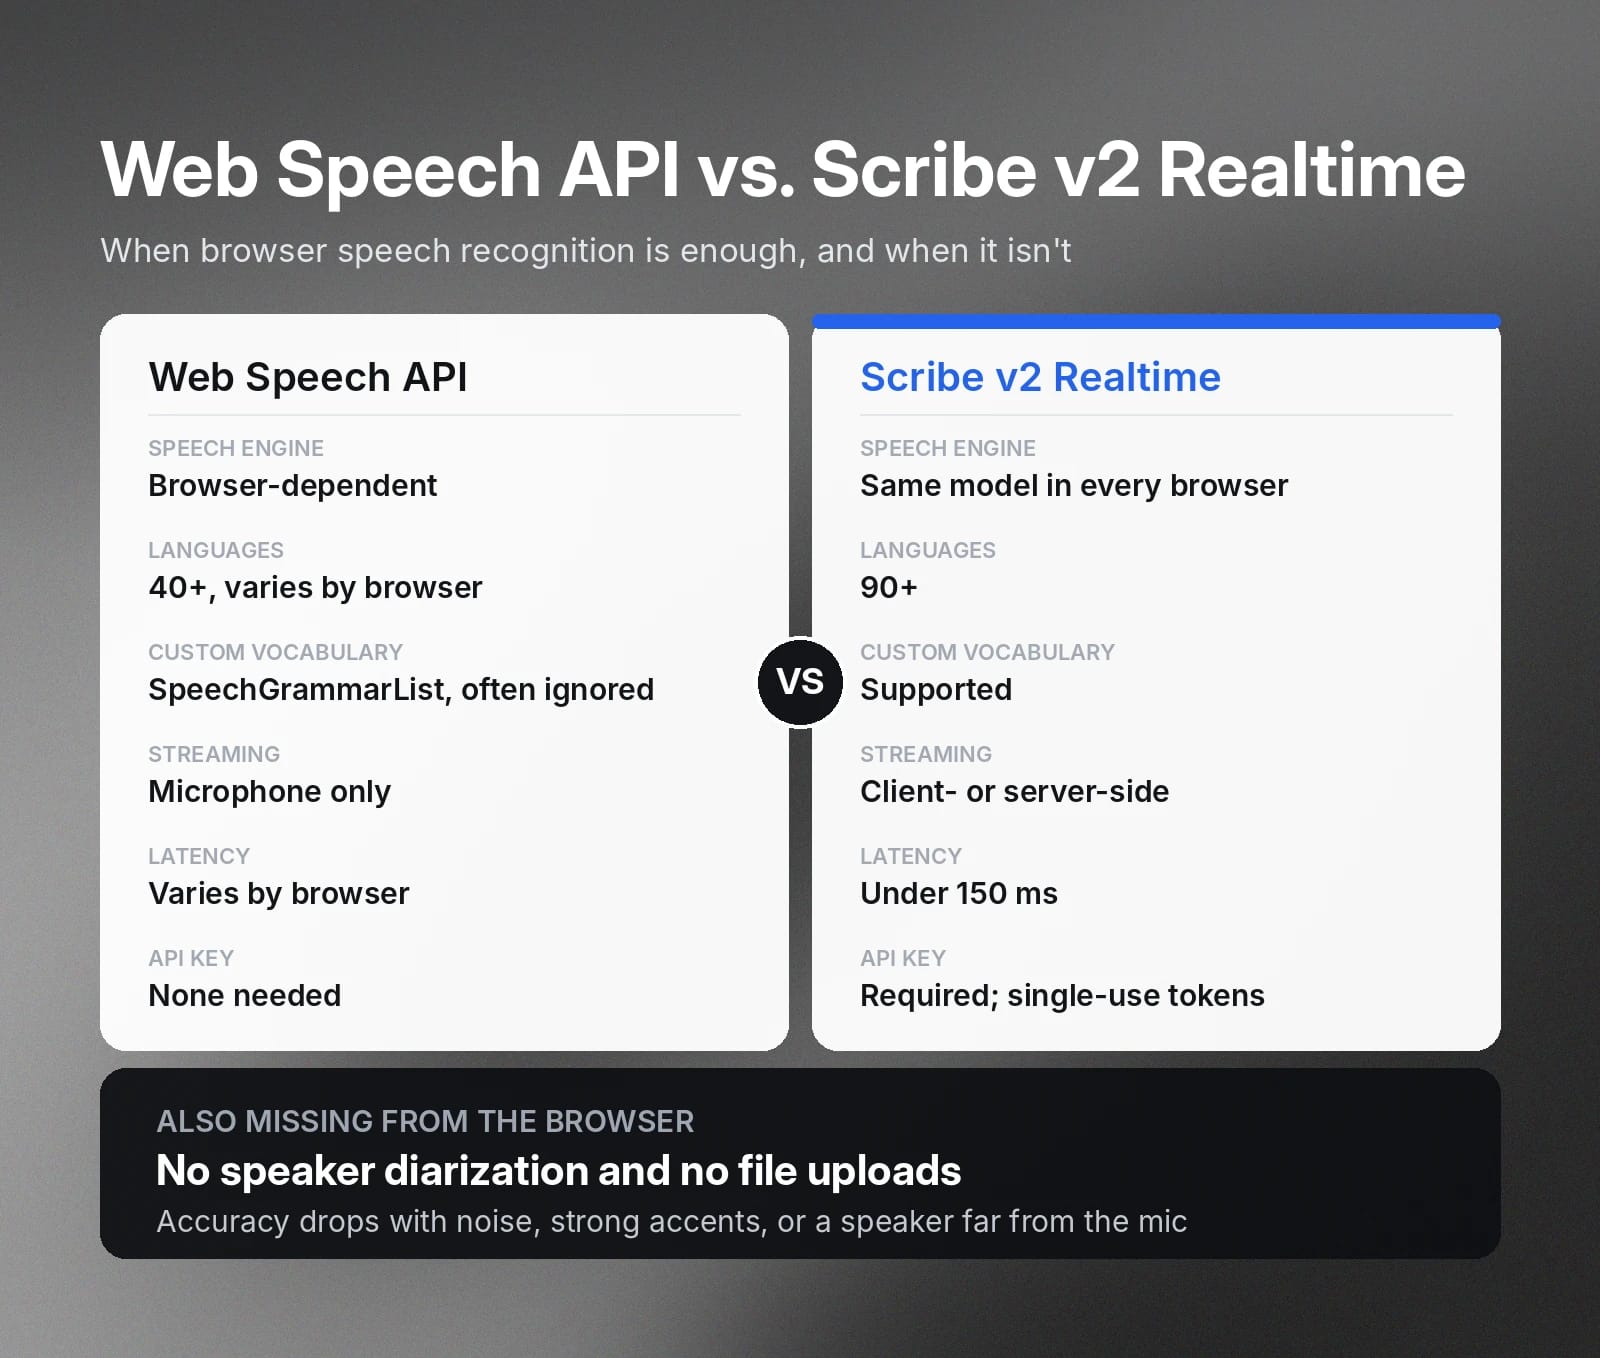
We hebben stappen getoond om automatische spraakherkenning voor browsergebaseerde spraakapps te bouwen met de Web Speech API. De API maakt speech to text-mogelijkheden toegankelijk voor JavaScript-ontwikkelaars. Verschillende beperkingen beperken echter de use cases, vooral voor commerciële webproducten.
- Browserafhankelijk: Transcriptie is sterk afhankelijk van de browser van de gebruiker. Ontwikkelaars hebben geen controle over de specifieke stemmodellen die ze gebruiken, wat leidt tot inconsistente transcriptieprestaties.
- Beperkte taalondersteuning: De API ondersteunt meer dan 40 talen, maar het exacte aantal kan per browser verschillen.
- Sprekerdiarisatie: Je kunt niet detecteren wie spreekt en individuele sprekers in het transcript weergeven.
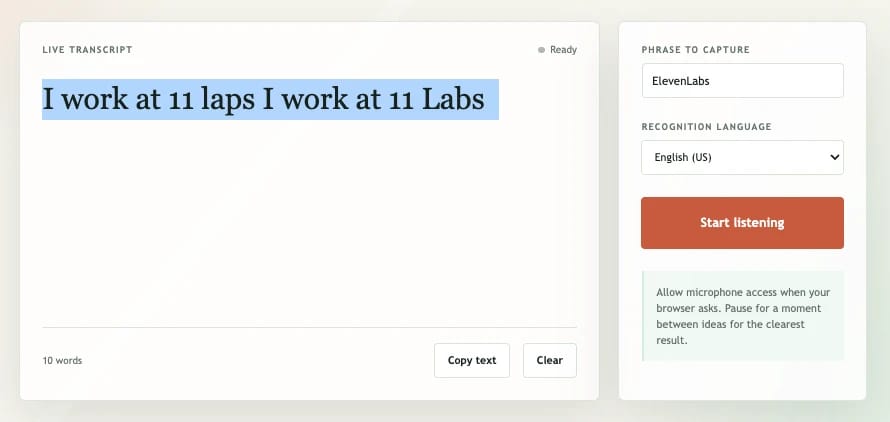
- Aangepaste vocabulaires: De SpeechRecognition API biedt geen betrouwbare ondersteuning voor aangepaste vocabulaires. De API kan bijvoorbeeld “ElevenLabs” niet nauwkeurig transcriberen. (De officiële SpeechRecognition API biedt via SpeechGrammarList een interface voor een aangepaste vocabulaire, maar moderne browsers negeren die vaak.)
- Nauwkeurigheid: De transcriptienauwkeurigheid daalt wanneer de spreker zich in een rumoerige omgeving bevindt, een sterk accent heeft of ver van de microfoon is.
- Server-side streaming: Je kunt alleen vanaf de microfoon streamen, omdat de Web Speech API geen serverstreaming of handmatige uploads van audiobestanden ondersteunt.
Als deze beperkingen je ervan weerhouden je product voor spraakherkenning commercieel aan te bieden, raden we aan ElevenLabs Scribe v2 Realtime te gebruiken.
ElevenLabs Scribe v2 Realtime is een model voor spraakherkenning dat zeer nauwkeurige realtime transcriptie met een latency van minder dan 150 ms biedt. Het ondersteunt meer dan 90 talen, consistente resultaten onafhankelijk van de browser en aangepaste vocabulaires. Met ElevenLabs Scribe v2 Realtime kun je client- of server-side streaming uitvoeren passend bij de architectuur van je webapp.
Tutorial JavaScript-spraakherkenning met ElevenLabs Scribe v2 Realtime
Een spraakopdracht in JavaScript bouwen met ElevenLabs volgt een vergelijkbare aanpak. Je moet echter een ElevenLabs API-sleutel maken om de API-requests te autoriseren. Hieronder vind je snelle stappen om een webclient te maken die vanaf een microfoon streamt.
- Installeer de ElevenLabs SDK
- Maak een token voor eenmalig gebruik om de API-sleutel door te geven zonder deze bloot te stellen
- Configureer en verbind met het model Scribe v2 Realtime met de gewenste parameters
- Maak event handlers om transcripts te verwerken en uitzonderingen af te handelen
Bekijk voor uitgebreide informatie over Scribe v2 Realtime onze officiële documentatie.
Ga aan de slag met ElevenAPI voor speech to text in productie
ElevenAPI biedt modellen van productiekwaliteit voor speech to text voor de ontwikkeling van webclients en servers. Naast realtime spraakherkenning gebruiken ontwikkelaars ElevenAPI speech to text-modellen voor batchtranscriptie met sprekerdiarisatie, timestamps op woordniveau en asynchrone verwerking.
In plaats van de speech to text-engine voortdurend te pollen, kun je een webhook maken in het ElevenLabs-dashboard en een callback-URL opgeven waar de API het voltooide transcript aflevert.
Of je nu een webclient of serverapp met automatische spraakherkenning wilt bouwen, ElevenAPI biedt audiomodellen die je eenvoudig in je code kunt integreren.
Haal je ElevenLabs API-sleutel op en bekijk de API-documentatie om te beginnen met bouwen.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


