
Wat is intentherkenning: gebruikersdoelen begrijpen in NLP
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Elk bericht dat een gebruiker schrijft, of het nu aan een LLM-agent is of als invoer voor Google, heeft een intentie erachter. De gebruiker werkt aan een doel, zoals specifieke informatie vinden of een actie uitvoeren.
Intentherkenning is het proces waarbij wordt vastgesteld wat dat doel is, in kaart wordt gebracht wat de gebruiker op basis van dat doel nodig heeft en het verzoek zo nauwkeurig mogelijk wordt uitgevoerd. Een systeem met een nauwkeurig afgestemd begrip van intentie kan klanten beter helpen met precieze antwoorden, wat de betrokkenheid en tevredenheid vergroot.
In dit artikel bespreken we wat intentherkenning is en hoe intentie zich heeft ontwikkeld in het tijdperk van LLM-zoeken.
Samenvatting
- Intentherkenning is een techniek binnen natural language processing die het doel van invoer categoriseert.
- Om de intentie in een gesprek te herkennen, doorloopt een model vier stappen: voorverwerking van het gesprek, feature extraction, classificatie en entity extraction.
- Bij interactie met een LLM kan de intentie informatief, transactioneel, conversationeel of navigerend zijn.
- Veelvoorkomende uitdagingen waarmee onderzoekers rekening houden bij het finetunen van intentherkenning zijn taalkundige ambiguïteit, invoer buiten het bereik en gesprekken met meerdere intenties.
Wat is intentherkenning?
Intentherkenning is een techniek binnen natural language processing (NLP) die gesproken of geschreven invoer classificeert op basis van wat de gebruiker in de context wil bereiken. Deze classificatiehandeling is ook de reden waarom deze techniek soms intentclassificatie wordt genoemd: software moet invoer begrijpen en bepalen welke actie moet volgen.
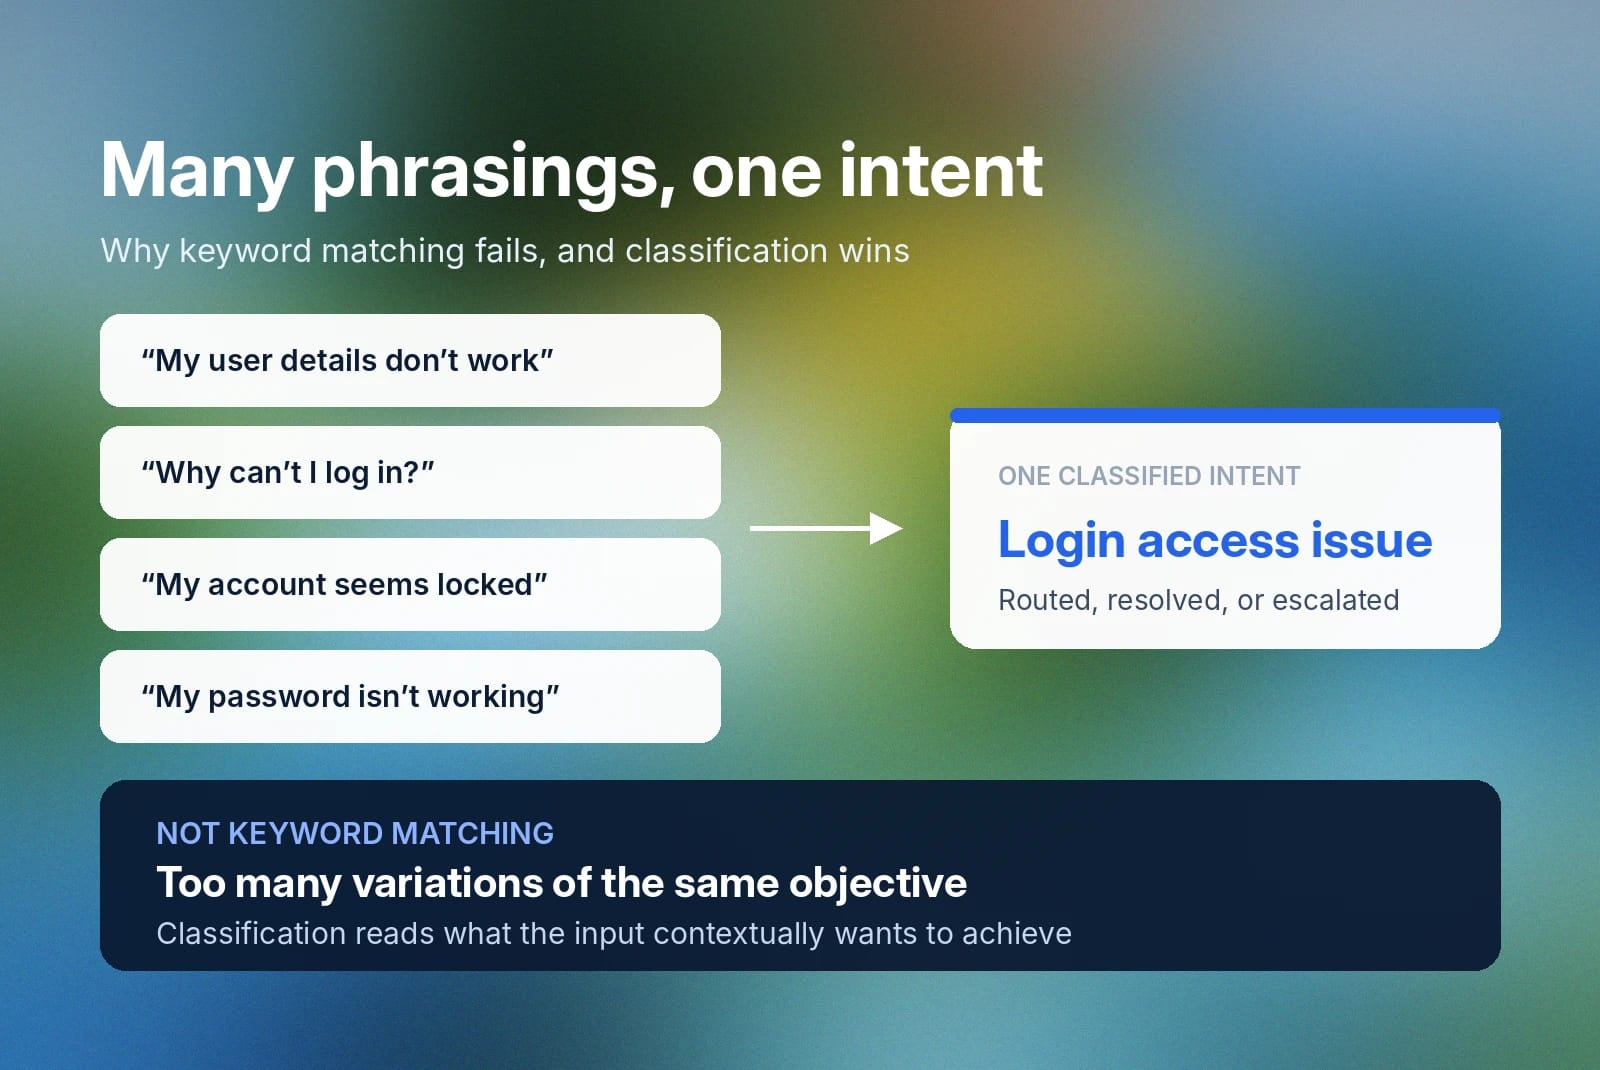
Het is belangrijk te weten dat intentherkenning niet simpelweg keyword matching is. Er zijn te veel taalkundige variaties van hetzelfde doel om matching te gebruiken. Zo zijn “Mijn gebruikersgegevens werken niet”, “Waarom kan ik niet inloggen?”, “Mijn account lijkt geblokkeerd” en “Mijn wachtwoord werkt niet” allemaal verschillende geschreven variaties van dezelfde onderliggende intentie.
Door intentherkenning als functie van NLP te gebruiken, kunnen AI-systemen beter begrijpen wat een gebruiker van de interactie verwacht. Daardoor kunnen ze in elk gesprek de best mogelijke ervaring bieden.
Hoe werkt intentherkenning?
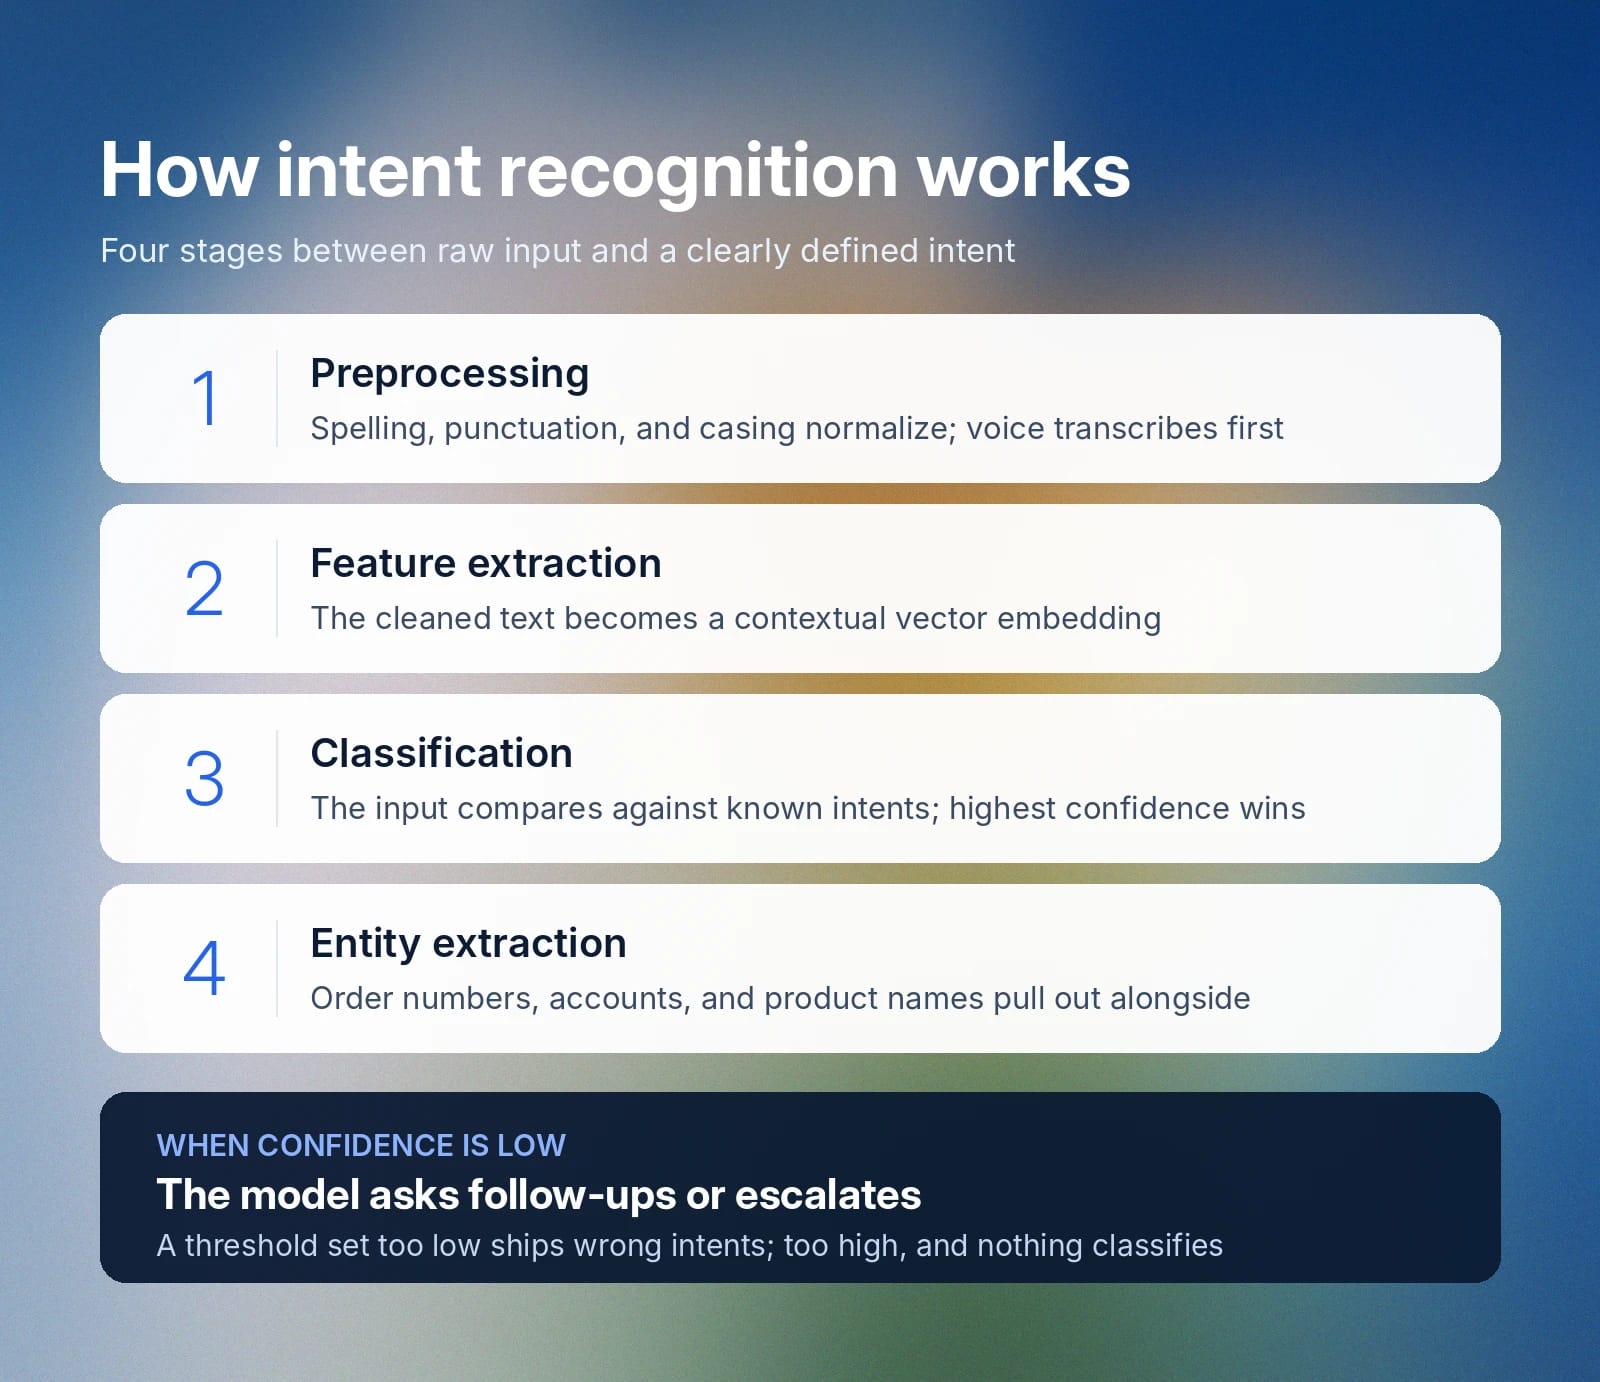
Welke exacte architectuur een AI-systeem voor intentherkenning gebruikt, hangt af van de aanbieder. Meestal gebruikt het systeem echter een variant van dezelfde vier kernfasen om onbewerkte invoer om te zetten in een duidelijk gedefinieerde intentie.
Dit zijn de vier fasen van intentherkenning:
- Voorverwerking
- Feature extraction
- Classificatie
- Entity extraction
Laten we deze nader bekijken.
Voorverwerking
Invoer, of het nu spraak of tekst is, moet worden opgeschoond zodat het model met een consistent, herkenbaar formaat kan werken. Bij tekst betekent dit spelfouten corrigeren, leestekens en hoofdletters verwijderen en ongebruikelijke of lange woorden vervolgens met tokenization opsplitsen in kleinere subwoordeeneheden. Deze fase kan voor de duidelijkheid ook veelvoorkomende functiewoorden als “een” en “de” verwijderen, tenzij ze natuurlijk rechtstreeks de betekenis van de zin beïnvloeden.
In automatic speech recognition-pipelines moet het systeem binnenkomende spraakgegevens eerst naar tekst transcriberen. Daarmee komt er nog een fase bij de voorverwerking voordat het model met het genormaliseerde transcript kan werken.
Feature extraction
De opgeschoonde tekst wordt vervolgens omgezet in een numerieke representatie waarmee de software kan werken. Feature extraction behoudt de semantische betekenis van een zin, maar legt die numeriek vast.
De strategieën die onderzoekers in deze fase gebruiken, zijn de afgelopen jaren sterk geëvolueerd. Eerdere benaderingen gebruikten Bag-of-Words-modellen of Term Frequency-Inverse Document Frequency-representaties (TF-IDF) om woorden te wegen op basis van hoe onderscheidend of frequent ze zijn. Hoewel dit snel resultaat gaf, kon het de nuances van zinnen niet vatten. “Ik wil niet annuleren” en “Ik wil annuleren” bevatten immers bijna dezelfde woorden, maar betekenen iets totaal anders.
Een ander voorbeeld dat lastig kan zijn met TF-IDF is "Hond bijt kat" tegenover "Kat bijt hond", waarbij de betekenis volledig verandert door slechts enkele wijzigingen in de zin.
De modernere aanpak voor feature extraction is het gebruik van dichte vectorrepresentaties om een vector embedding te maken die de invoer van de gebruiker weergeeft. Deze embeddings leggen context vast via nabijheid, waarbij woorden met een vergelijkbare betekenis worden gegroepeerd om context uit die ruimtelijke relatie af te leiden.
Transformer-gebaseerde encoders gaan nog een stap verder en creëren contextuele kaarten waarin de vector voor een woord verandert afhankelijk van de woorden eromheen. Dit is essentieel voor woorden die, afhankelijk van hun context, meerdere betekenissen hebben (“lees deze instructies”, “ik las dat artikel gisteren”).
De contextuele representatie van een zin geeft intentherkenningssystemen de mogelijkheid te begrijpen wat een gebruiker wil en dit in de latere fasen te classificeren.
Classificatie
Met een duidelijke representatie van invoer kan een model die invoer vergelijken met verschillende bekende intenties en daarbij betrouwbaarheidswaarden toekennen. Nadat het verschillende intentietypen heeft doorlopen, kiest het de intentie met de hoogste betrouwbaarheidswaarde.
Sommige teams experimenteren met een betrouwbaarheidsdrempel voor classificatie. Als die te laag is, kan een vrij onnauwkeurige intentie toch naar de volgende stap worden meegenomen. Maar als die te hoog is, gebeurt het tegenovergestelde: het model kan de intentie niet definitief classificeren en niet naar de volgende stap gaan.
Door je classificatiemodel te finetunen, kun je de waarde vinden die het beste werkt voor je organisatie.
Als het model geen intentie kan identificeren, zal het waarschijnlijk aanvullende vragen stellen aan de gebruiker of escaleren naar een menselijke agent, als het daarvoor is geconfigureerd.
Entity extraction
We behandelen entity extraction als een afzonderlijke stap, maar in werkelijkheid loopt die tegelijk met de classificatie. Entity extraction haalt details uit invoer die later nuttig zijn voor een antwoord, zoals ordernummers, accountgegevens, productnamen of andere specifieke gegevens die het model helpen het verzoek uit te voeren.
De entiteiten die in deze stap worden geëxtraheerd, leveren gebruikersspecifieke informatie om het verzoek succesvol uit te voeren. Als de classificatie bijvoorbeeld vaststelt dat een gebruiker een bestelling wil annuleren, vertelt entity extraction de agent om welke bestelling en welk klantaccount het gaat.
Intentherkenning versus intentdetectie
Intentherkenning en intentdetectie worden vaak door elkaar gebruikt, al hebben ze een iets andere betekenis. Intentherkenning is het volledige proces van het classificeren van de intentie in een verzoek van een gebruiker. Intentdetectie omvat alleen de eerste fase van dat proces: vaststellen of er op basis van de reactie van de gebruiker überhaupt een intentie is.
In de praktijk is het verschil alleen relevant voor edge cases. Bijvoorbeeld: een customer support agent die een vraag ontvangt die volledig losstaat van zijn aangeleerde context, kan met intentdetectie eerst vaststellen dat de intentie niet van toepassing is op zijn kennisbank. Wat de agent daarna doet, bijvoorbeeld netjes aangeven dat hij niet kan helpen, wordt bepaald door de configuratie van intentherkenning.
Typen intentie
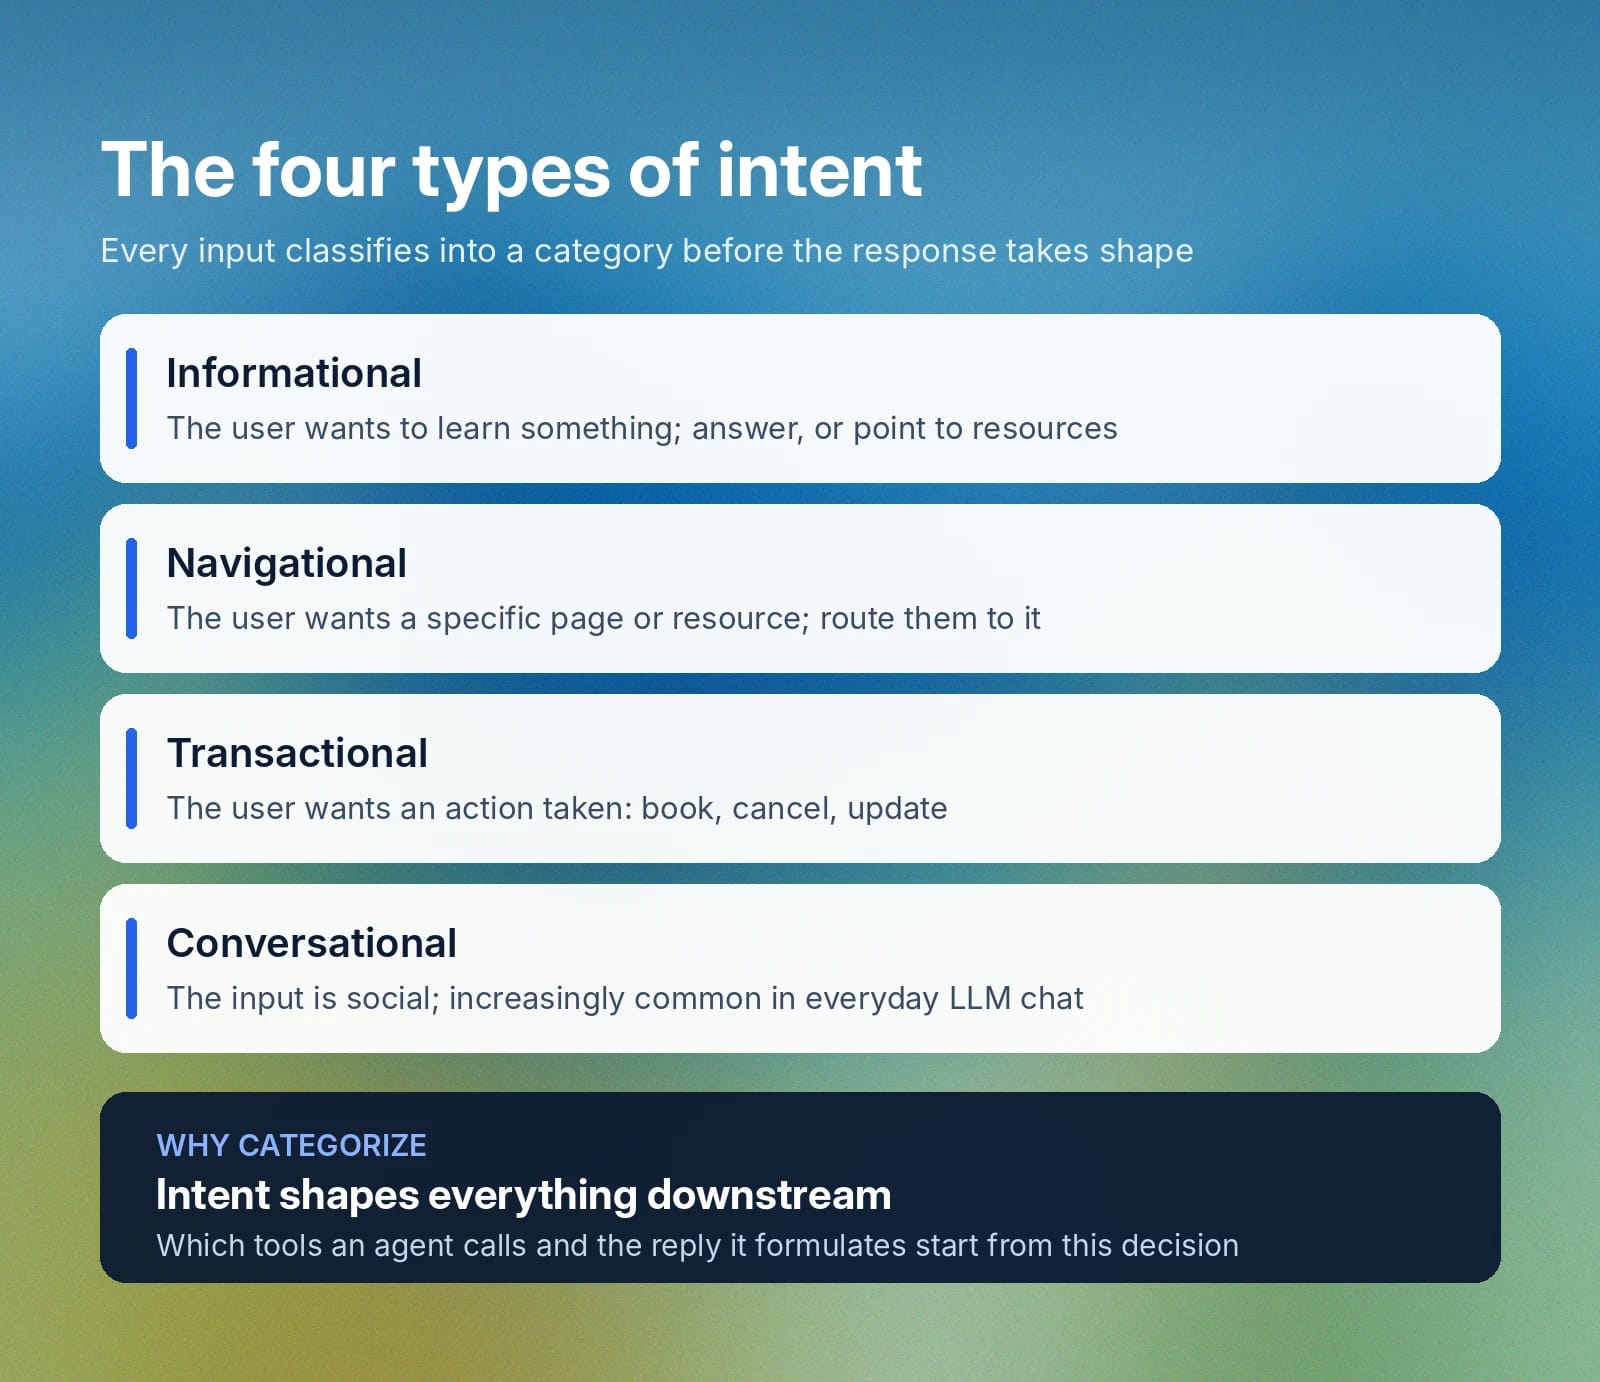
Er zijn evenveel specifieke intenties als vragen. In plaats van voor elke mogelijke formulering van een vraag een andere intentie te vereisen, identificeert het systeem meestal eerst de intentiecategorie en onderneemt vervolgens de bijbehorende actie.
De belangrijkste typen intentie in NLP-systemen zijn:
- Informatieve intentie: Beschrijft invoer waarbij het voornaamste doel van een gebruiker is om specifieke informatie te leren of te verkrijgen. Het juiste antwoord is hier de gevraagde inhoud bieden, als uitleg of door te verwijzen naar de juiste bronnen waar de gebruiker dit kan vinden.
- Navigerende intentie: Beschrijft wanneer een gebruiker een specifieke bron of pagina wil vinden. Het systeem categoriseert deze intentie en extraheert entiteiten om de gebruiker vervolgens naar de juiste locatie te sturen.
- Transactionele intentie: Beschrijft invoer waarbij een gebruiker een specifiek doel wil bereiken, zoals een afspraak maken of een abonnement opzeggen. Een transactionele intentie is altijd gebaseerd op acties met gevolgen.
- Conversationele intentie: Beschrijft invoer die vooral sociaal is, in plaats van in een van de andere categorieën te vallen. Deze vorm van intentie komt nu vaker voor door de opkomst van breed beschikbare LLM's, waarbij sommige mensen algemene agents gebruiken als een interface voor dagelijkse gesprekken.
Een LLM kan al deze intentietypen in al deze categorieën verwerken. Inzicht in de intentiecategorie van invoer helpt hoe dan ook om een nauwkeuriger antwoord te formuleren. Alles, van welke tool calls een agent uitvoert tot het precieze antwoord dat hij formuleert, begint met het vaststellen van de onderliggende intentie van de invoer van een gebruiker.
Toepassingen van intentherkenning in verschillende sectoren
Intentherkenning staat centraal in elk geautomatiseerd reactiesysteem, omdat het antwoord moet aansluiten op de intentie om het gesprek logisch te laten verlopen.
Hier zijn enkele voorbeelden van toepassingen van intentie in verschillende sectoren:
- Klantenservice: Een spraakagent gebruikt intentherkenning om het gesproken verzoek van een klant te begrijpen en die als reactie naar de juiste afdeling of bron te leiden. Een verkeerde classificatie kan ertoe leiden dat de klant met het verkeerde personeelslid spreekt of dat de vraag onbeantwoord blijft.
- Zorg: Intentherkenning ondersteunt zorgassistenten die afspraken beheren. Sectoren met een hoger risico, zoals zorg of financiën, gebruiken vaak hogere betrouwbaarheidsdrempels om foutieve categorisaties te voorkomen die tot kritieke fouten kunnen leiden.
- Human resources: Een conversationele HR-assistent kan in interne bedrijfsdocumenten werken en medewerkers naar de bronnen leiden die ze nodig hebben. Een medewerker kan bijvoorbeeld vragen naar verlofregelingen, waarna de agent de informatieve intentie begrijpt en die gegevens uit de bredere wiki naar voren haalt.
Nauwkeurige intentherkenning is overal de eerste factor voor een succesvol gesprek. Als de intentie niet klopt, klopt het gesprek dat daarop volgt ook niet.
Uitdagingen bij intentherkenning
De intentie van een uitspraak herkennen is volledig een taalkundige uitdaging. Betekenissen veranderen, woorden krijgen afhankelijk van hun context een andere functie en dezelfde zin kan iets anders betekenen afhankelijk van hoe hij wordt uitgesproken. Vooral omdat intentherkenning steeds vaker wordt ingezet in spraakagenten, is dat laatste punt uiterst belangrijk.
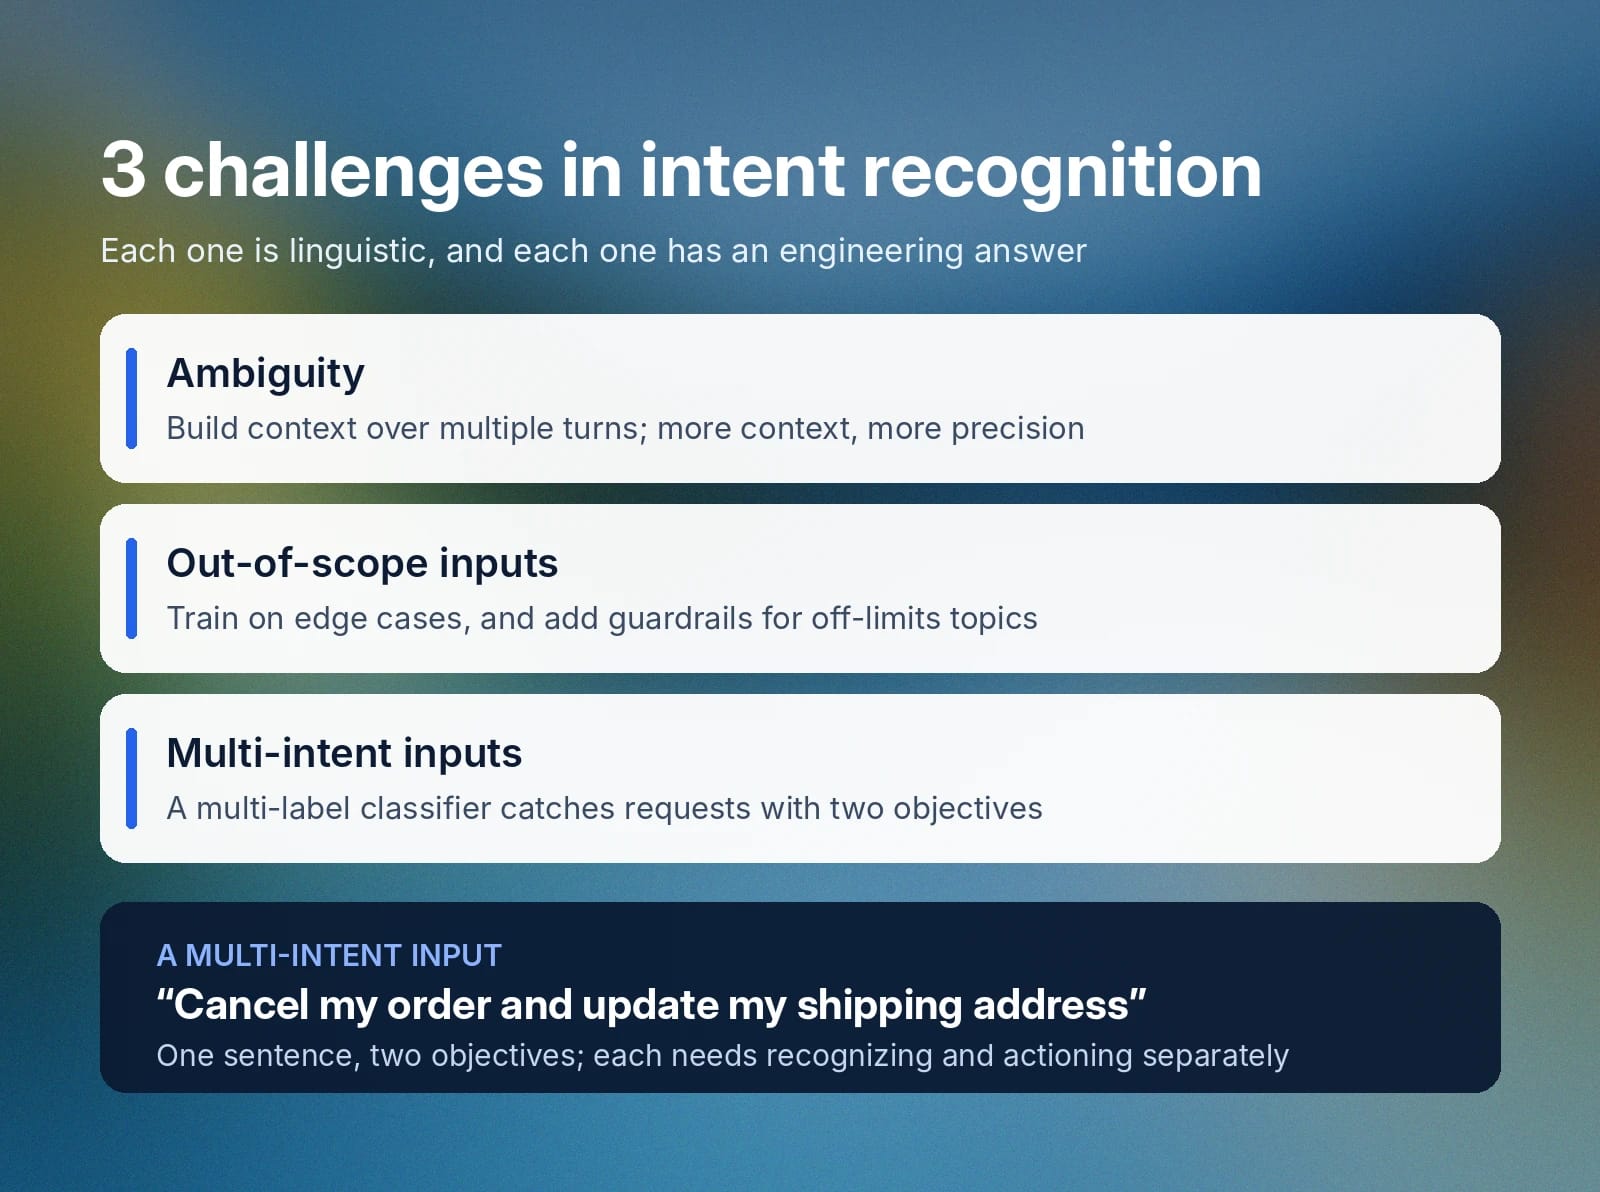
Dit zijn enkele belangrijke uitdagingen bij intentherkenning en manieren om ze op te lossen:
- Ambiguïteit: Wanneer dezelfde zin twee verschillende dingen betekent afhankelijk van hoe iemand hem uitspreekt, kan taalkundige ambiguïteit de zekerheid van intentherkenning verminderen. Om dit te ondervangen, bouwen modellen context op over meerdere gespreksbeurten heen, zodat ze beter begrijpen wat iemand mogelijk wil. Hoe meer context een model kan gebruiken, hoe nauwkeuriger het zijn antwoord kan opbouwen.
- Gesprekken buiten het bereik van een model: Als een gebruiker een model iets vraagt dat ver buiten het bereik van zijn kennis ligt, kan het model de intentie verkeerd indelen in de meest vergelijkbare categorie, wat tot een onnauwkeurig antwoord leidt. Een oplossing is modellen trainen op edge cases om de kans hierop te verkleinen. Door deze aanpak te combineren met guardrails die voorkomen dat bepaalde onderwerpen in gesprekken kunnen worden overschreden, beperk je het risico.
- Invoer met meerdere intenties: Een gesprek heeft natuurlijk niet altijd een 1:1-relatie tussen invoer en intentie. “Kun je mijn bestelling annuleren en ook mijn verzendadres voor toekomstige bestellingen bijwerken?” heeft twee afzonderlijke doelen. Een multi-label classifier helpt gespreksreeksen met meer dan één intentie of doel te identificeren, waardoor de nauwkeurigheid bij meerdere onderliggende wensen toeneemt.
Door deze uitdagingen te begrijpen en erop te anticiperen, kunnen onderzoekers vooraf maatregelen treffen om ze te beperken.
Ga aan de slag met ElevenAgents
In een spraakagent helpt intentherkenning conversationele AI-systemen nauwkeurig te houden en de klanttevredenheid hoog. Herhaalde mismatches in intentie ondermijnen het vertrouwen van klanten in je agent en verminderen de bereidheid van gebruikers om met je AI-supportsystemen te werken.
ElevenAgents gebruikt intentherkenning om precies te begrijpen wat een gebruiker nodig heeft en daarop in het gesprek in te spelen, door de interactie correct te routeren, relevante informatie op te halen of het gesprek waar nodig te escaleren.
Ontdek meer over ElevenAgents of registreer je om spraakagenten te bouwen die begrijpen wat je gebruikers willen.
Veelgestelde vragen over intentherkenning

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.



