
Real-time vs. batchtranscriptie: de belangrijkste verschillen
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
Bij het kiezen van een AI-gestuurd transcriptiemodel heb je twee opties: real-time- of batchtranscriptie. Beide zetten spraak om in tekst, maar gebruiken een andere aanpak.
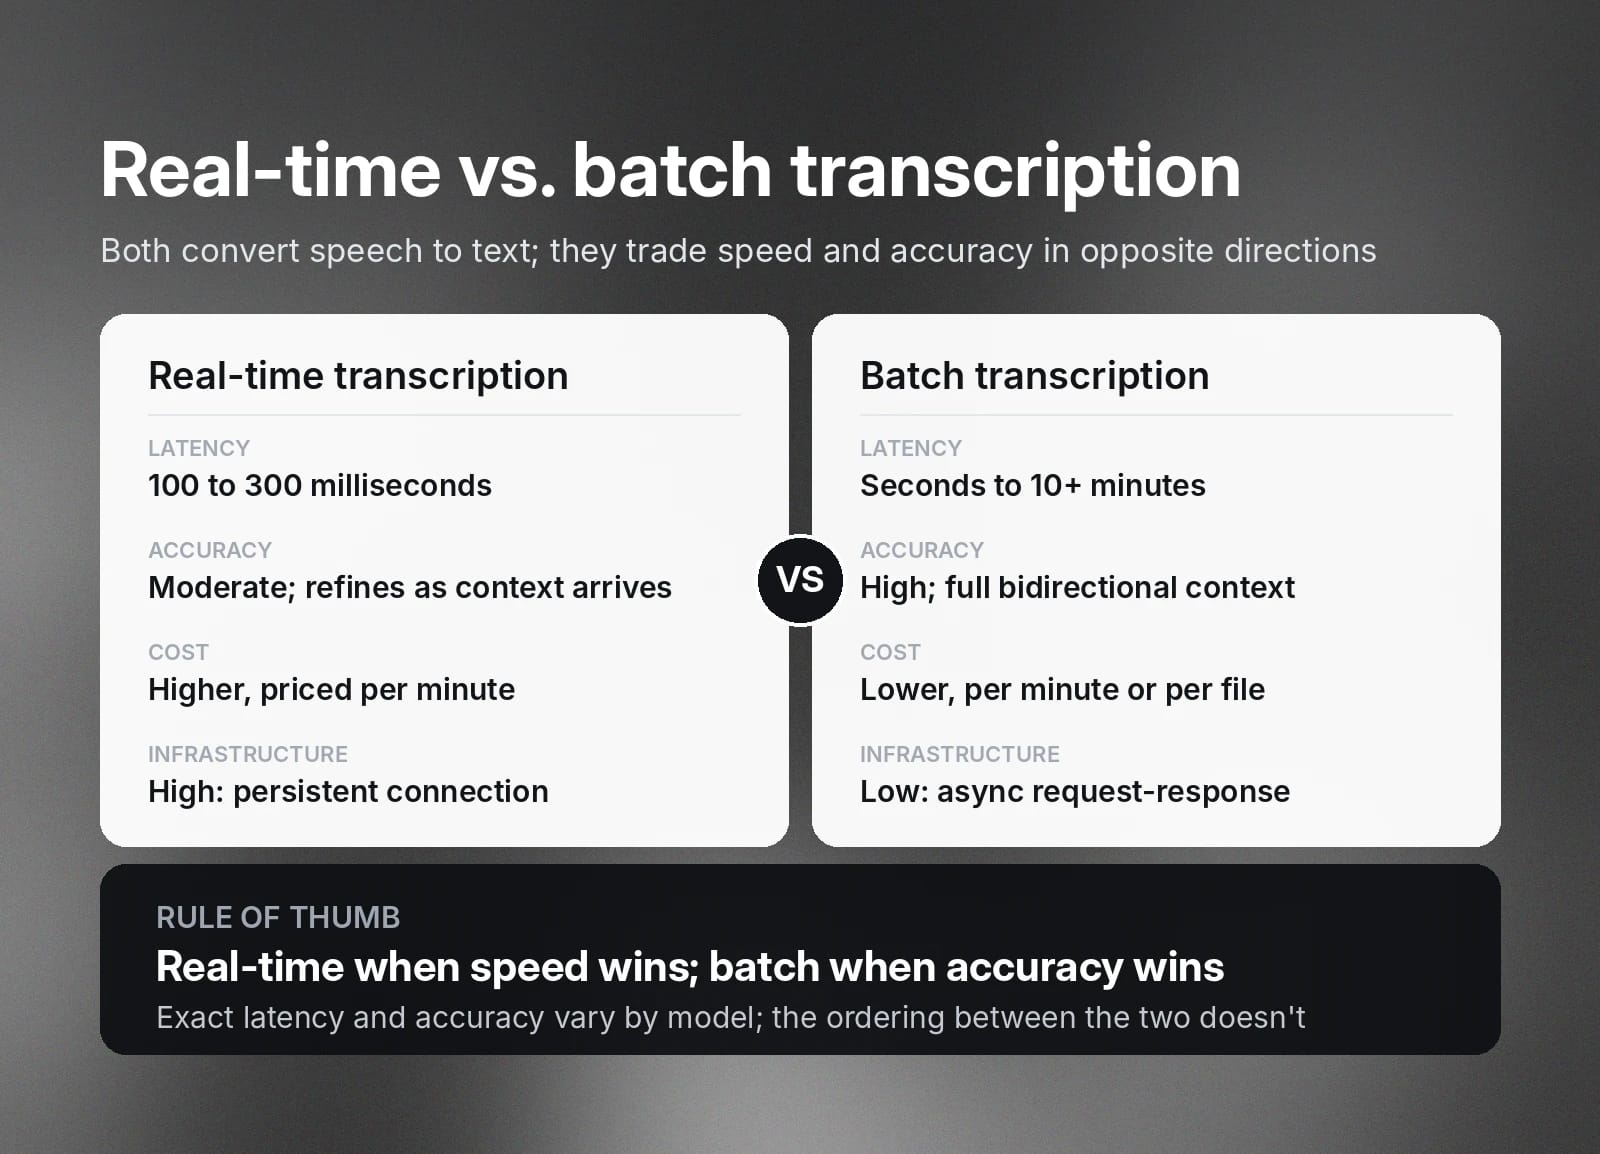
Real-timetranscriptie verwerkt audio terwijl die plaatsvindt, terwijl batchtranscriptie een volledige audio-opname verwerkt nadat deze is afgerond. Real-timetranscriptie levert direct resultaten, maar batchtranscriptie is vaak nauwkeuriger.
In deze gids vergelijken we real-time- en batchtranscriptie, zodat je het juiste model voor je volgende project kunt kiezen. We leggen uit hoe elk model werkt, wat de voor- en nadelen zijn en welke toepassingen veelvoorkomend zijn.
Samenvatting
- Real-timetranscriptie verwerkt audio terwijl die plaatsvindt.
- Batchtranscriptie verwerkt een volledig audiobestand in één keer.
- Real-timetranscriptie is sneller, maar batchtranscriptie is nauwkeuriger omdat het model bidirectionele context uit het hele audiobestand heeft.
- Real-timetranscriptie is het meest geschikt voor toepassingen zoals live spraakagents, live ondertiteling van video's of vergadernotities, waarbij snelheid belangrijker is dan nauwkeurigheid.
- Batchtranscriptie is nauwkeuriger en kosteneffectiever voor het in grote aantallen transcriberen van audio nadat deze is opgenomen.
Wat is real-timetranscriptie in STT?
Real-timetranscriptie is wanneer een speech-to-textmodel (STT-model) audio omzet in geschreven tekst terwijl die plaatsvindt. Dit wordt soms ook streamingtranscriptie genoemd.
Bij real-timetranscriptie verwerkt het STT-model de audio in kleine stukken. De geschreven tekst is al milliseconden nadat de woorden zijn uitgesproken beschikbaar. Naarmate het gesprek vordert, verzamelt het STT-model meer gegevens en context, die het gebruikt om het transcript te verfijnen.
Deze vorm van transcriptie werkt het best in situaties waarin snelheid belangrijker is dan nauwkeurigheid. Deze modellen maken audio- en videostreams bijvoorbeeld toegankelijker met real-timeondertiteling. Een andere veelvoorkomende toepassing is in platforms voor real-time notities maken.
Wat is batchtranscriptie in STT?
Batchtranscriptie zet een volledige audio-opname in één keer om van spraak naar tekst, nadat de opname is afgerond. Het proces duurt enkele seconden tot meer dan 10 minuten, afhankelijk van de lengte en complexiteit van de opname.
Batchtranscriptiemodellen gebruiken tijdens hun werk context uit de volledige opname. Volledige context helpt het model delen met complexe taal, achtergrondgeluid of onderbrekingen nauwkeurig te interpreteren. Batchtranscriptiemodellen voegen ook interpunctie en opmaak toe, waar sommige real-timemodellen moeite mee kunnen hebben.
Batchtranscriptie werkt het best in situaties waarin nauwkeurigheid de hoogste prioriteit heeft. Veel organisaties gebruiken batchmodellen om lange interviews, vergaderingen of podcasts voor hun archief te transcriberen.
Hoe batch- en streamingarchitecturen transcriptie vormgeven
Bij een vergelijking van batch- en streamverwerking voor transcriptie gebruiken de twee modellen fundamenteel verschillende processen, die het eindresultaat beïnvloeden.
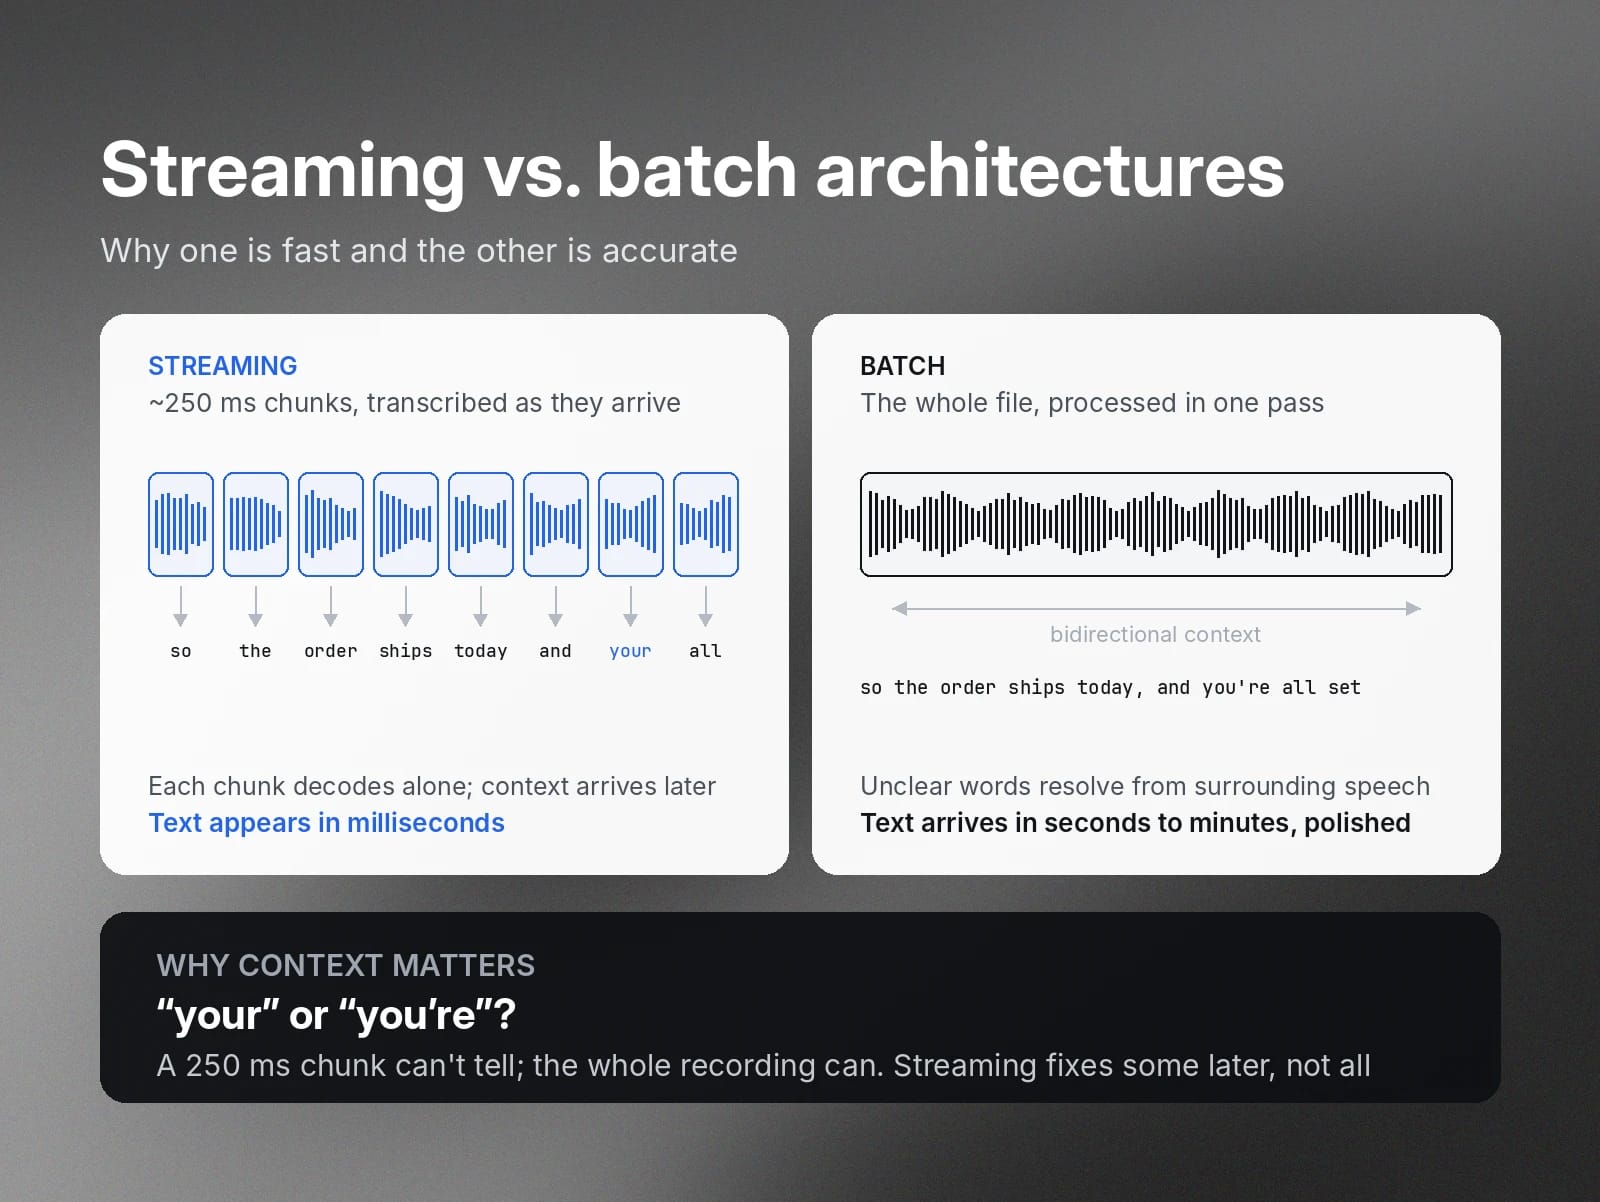
Streamingtranscriptiemodellen delen audio op in stukken en transcriberen elk stuk terwijl het plaatsvindt. Deze stukken zijn zeer klein, meestal ongeveer 250 milliseconden of minder. Door audio in deze vorm te verwerken, kan het transcriptiemodel snel werken, zodat de tekst slechts enkele seconden na de audio verschijnt.
Omdat deze audiostukken zo klein zijn, heeft het Speech to Text-model niet de volledige context van het gesprek, wat tot fouten kan leiden. Het transcriptiemodel kan bijvoorbeeld 'jou' gebruiken in plaats van 'jouw'.
Een real-timetranscriptiemodel corrigeert een deel van deze fouten naarmate het gesprek doorgaat en de context duidelijker wordt. Er is echter meestal niet genoeg tijd of context om elke fout te corrigeren, waardoor het uiteindelijke transcript niet altijd 100% nauwkeurig is.
Batchtranscriptiemodellen verwerken daarentegen het hele audiobestand in één keer. Dit betekent dat het transcriptiemodel bidirectionele context voor het gesprek heeft, waarmee het onduidelijke woorden of zinnen oplost. Als iets in het audiobestand onduidelijk is, analyseert het model de woorden ervoor en erna om te bepalen wat er is gezegd en dit nauwkeurig te transcriberen.
Door deze extra context zijn batchtranscriptiemodellen langzamer dan real-timetranscriptiemodellen. Het eindproduct is echter veel nauwkeuriger en verzorgder.
Belangrijkste kenmerken van real-time- en batchtranscriptiemodellen: latentie, nauwkeurigheid en kosten
Zowel real-time- als batchmodellen zijn effectief voor transcriptie: het hangt volledig af van het type project waaraan je werkt. Sommige projecten vereisen directe resultaten, terwijl andere een hoge nauwkeurigheid vereisen.
Houd rekening met de volgende factoren bij je keuze tussen real-time- en batchtranscriptie:
Real-timetranscriptie
Batchtranscriptie
Latentie
100 tot 300 milliseconden
Van seconden tot meer dan 10 minuten, afhankelijk van de bestandslengte
Nauwkeurigheid
Gemiddeld
Hoog
Kosten
Hoog, prijs per minuut
Gemiddeld, prijs per minuut of per bestand
Complexiteit van de infrastructuur
Hoog, vereist een stabiele verbinding en load balancing
Laag, gebruikt een asynchrone request-response-structuur
De exacte latentie en nauwkeurigheid verschillen per transcriptiemodel dat je gebruikt. Real-timetranscriptie is echter consequent sneller, terwijl batchtranscriptie nauwkeuriger is.
Real-timetranscriptie kost meer dan batchtranscriptie omdat hiervoor complexere infrastructuur nodig is en de operationele overhead hoger is. Real-timemodellen vereisen een stabiele verbinding om hun snelheid te behouden en kosten meer tijd om in te stellen en te onderhouden dan batchmodellen.
Real-timemodellen zijn de investering waard voor toegankelijkheid tijdens live gesprekken. Met batchtranscriptie bespaar je echter geld en installatietijd bij projecten waar snelheid geen prioriteit is.
Vergelijking van API's voor real-time- en batchtranscriptie: de beste keuze voor je project
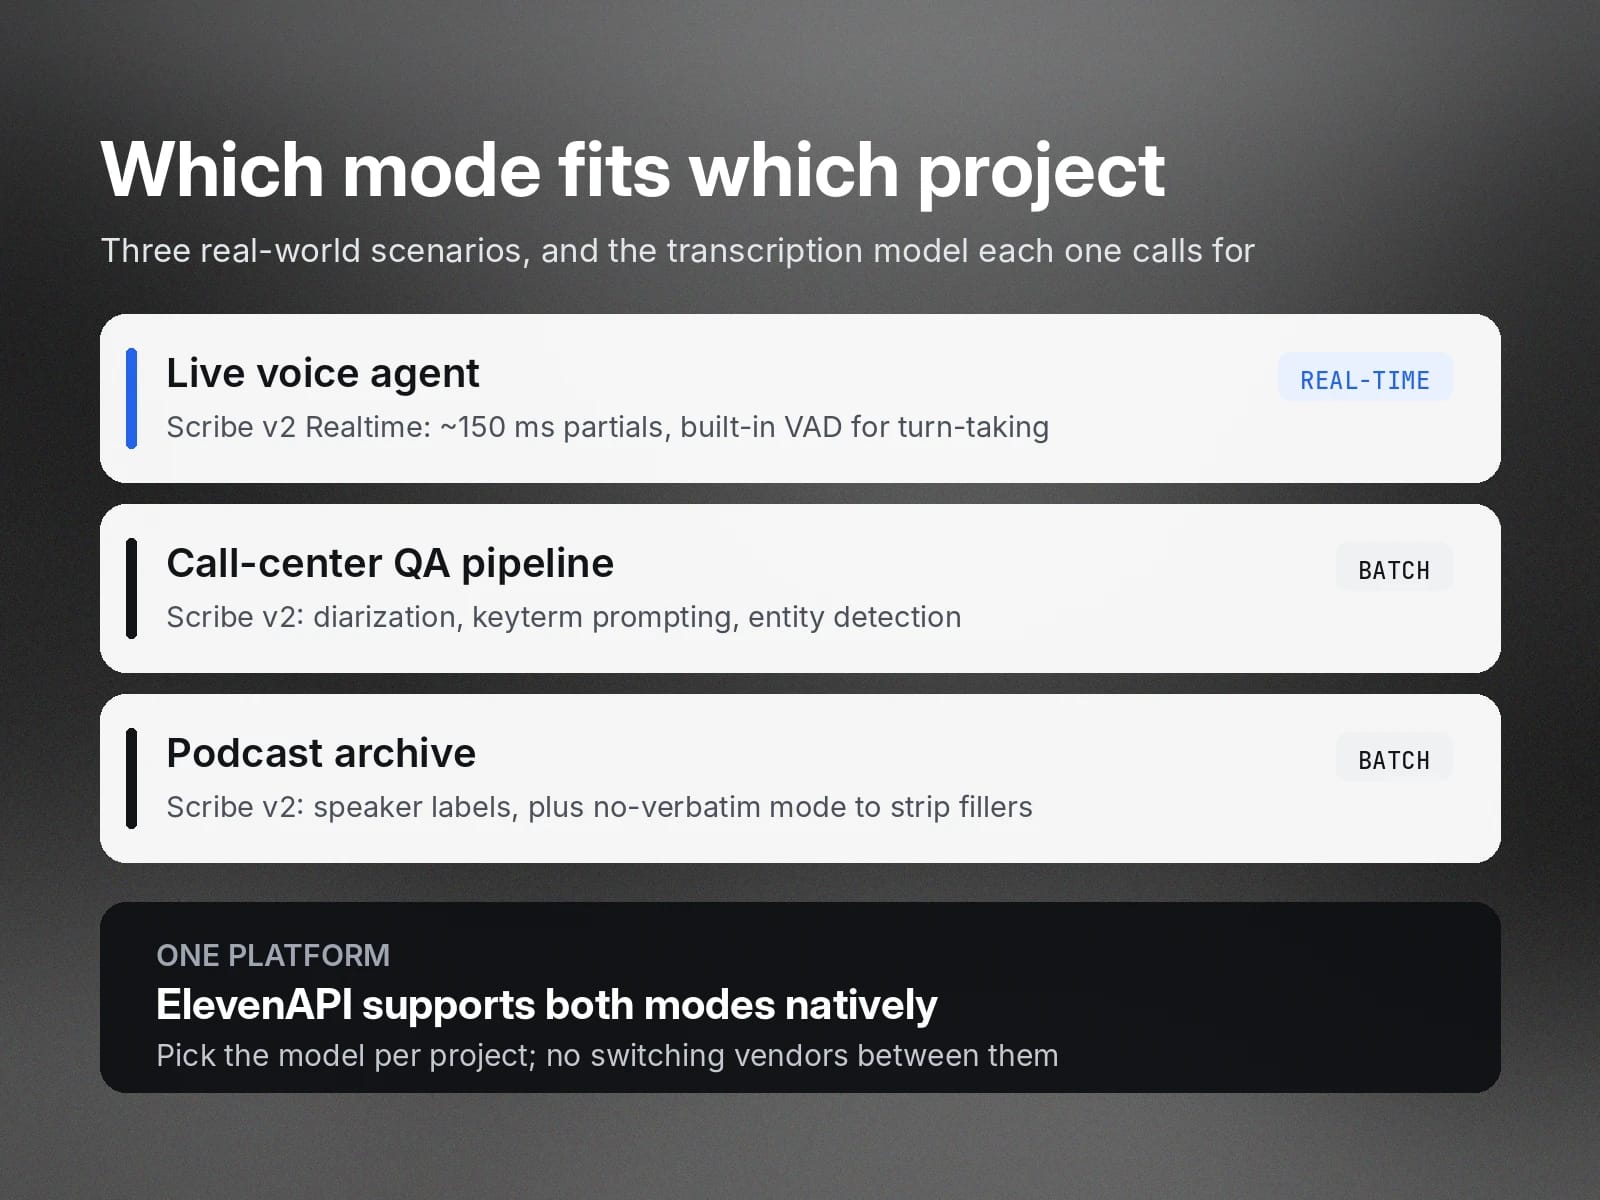
Voordat je een nieuw transcriptieproject start, moet je de voor- en nadelen van batch- en real-timemodellen afwegen om te zien welk model het beste bij je doelen past. Zo ziet het besluitvormingsproces eruit in drie praktijkscenario's.
Live spraakagent: Real-timetranscriptie
Live conversationele AI-modellen vereisen vrijwel onmiddellijke transcriptie voor toegankelijkheid, vooral bij complexe operationele uitdagingen of uitdagingen in de klantenservice.
Een real-timemodel, zoals Scribe v2 Realtime, levert de lage latentie die nodig is voor soepele, natuurlijke gesprekken. Scribe v2 Realtime levert gedeeltelijke transcripties in ongeveer 150 milliseconden.
Transcriptiemodellen voor live spraakagents vereisen ook nauwkeurige beurtwisseling. Dit betekent dat ze moeten kunnen detecteren wanneer een gebruiker begint of stopt met spreken en onmiddellijk moeten reageren. Effectieve beurtwisseling en onderbrekingsbeheer helpen voorkomen dat het transcript achterloopt op het gesprek.
Real-timetranscriptiemodellen geven prioriteit aan nauwkeurige beurtwisseling voor snelle resultaten. Scribe v2 Realtime heeft bijvoorbeeld ingebouwde Voice Activity Detection, waardoor het transcript automatisch wordt gesegmenteerd wanneer het stilte tussen sprekers detecteert.
QA-pipeline voor callcenters: Batchtranscriptie
Nauwkeurigheid is essentieel bij kwaliteitscontrole, dus een batchtranscriptiemodel zoals Scribe v2 is in dit scenario de meest logische keuze.
Transcripties van callcenters bevatten vaak unieke namen en branchespecifieke details. Als deze niet correct worden getranscribeerd, is het voor analisten lastig om te bepalen of een gesprek echt succesvol was. Omdat batchmodellen de volledige opname in één keer verwerken, beschikken ze over de context die nodig is voor nauwkeurige transcriptie en opmaak.
Scribe v2 heeft verschillende functies om de nauwkeurigheid van transcripties te verbeteren. Sprekerdiarisatie zorgt ervoor dat agents en klanten altijd correct worden gelabeld, ook wanneer mensen door elkaar heen praten. Keyterm prompting geeft het model vooraf merknamen en vaktermen, zodat ze nauwkeurig worden getranscribeerd.
Transcripten van callcenters kunnen ook gevoelige informatie bevatten die moet worden verwijderd, zoals burgerservicenummers en creditcardnummers. Scribe v2 heeft entiteitsdetectie om deze gevoelige gegevens te vinden en van een tijdstempel te voorzien, zodat je ze kunt verwijderen.
Podcastarchief: Batchtranscriptie
Bij het bouwen van een podcastarchief heb je verzorgde transcripties nodig waar je team en je publiek altijd naar kunnen verwijzen. Nauwkeurigheid en nette opmaak zijn hierbij essentieel, waardoor batchtranscriptie de juiste keuze is.
Met batchtranscriptie krijg je nauwkeurige transcripties met sprekerlabels en diarisatie voor al je podcastbestanden. Scribe v2 heeft ook no-verbatim mode, die stopwoorden, stotteren en herhalingen automatisch verwijdert. Zo besteed je minder tijd aan handmatige bewerking en kun je je podcastarchief sneller opbouwen.
ElevenAPI ondersteunt standaard zowel real-time- als batchmodi. Als je meerdere transcriptieprojecten tegelijk uitvoert, kun je ElevenAPI gebruiken om ze allemaal op hetzelfde platform te beheren. Kies gewoon het juiste model voor elk project, zonder steeds tussen serviceproviders te hoeven wisselen.
Hybride transcriptiemodellen: een brug tussen real-time en batch
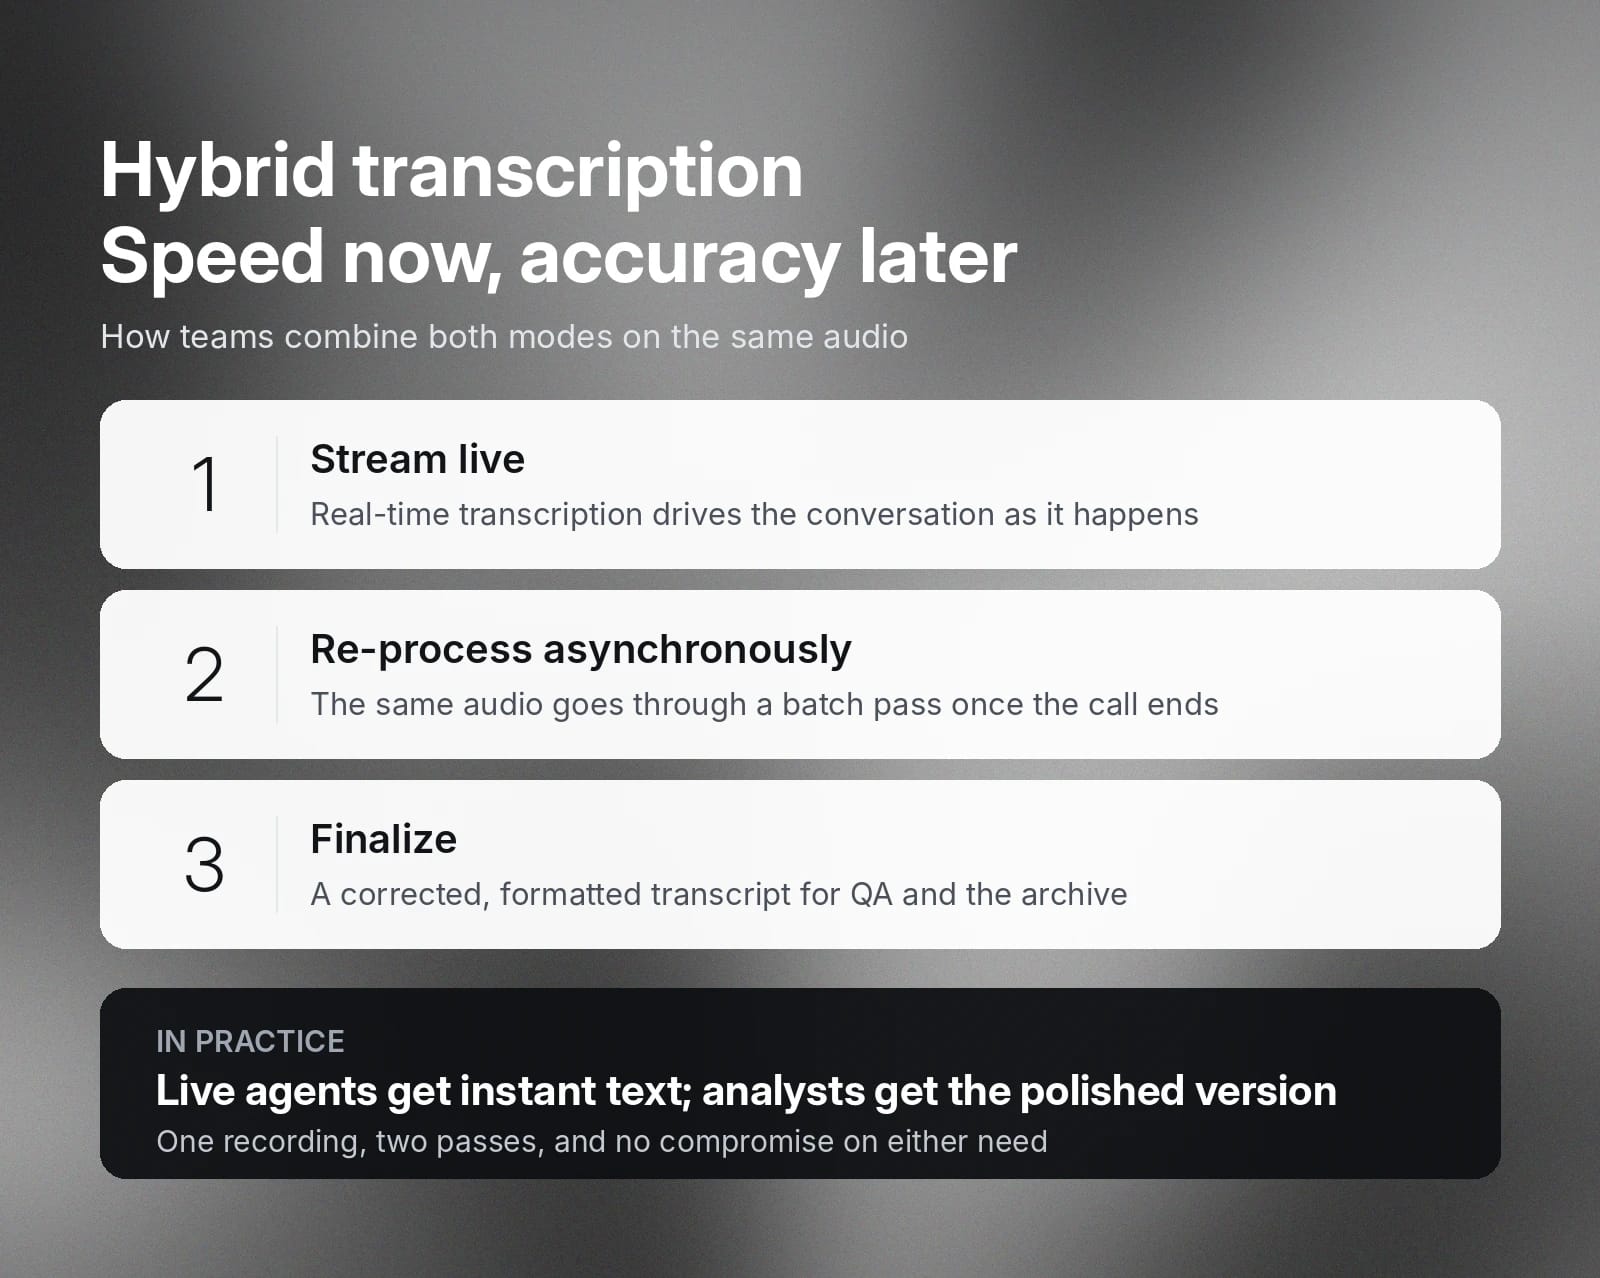
Hybride transcriptiearchitecturen combineren real-time- en batchmodellen voor een balans tussen snelheid en nauwkeurigheid.
Een klantenserviceteam kan bijvoorbeeld een hybride model gebruiken om tijdens live gesprekken direct output te leveren en het transcript vervolgens te verfijnen voor kwaliteitscontrole en archivering. Live agents gebruiken real-timetranscriptie en sturen het eerste transcript vervolgens naar een batchmodel voor asynchrone herverwerking.
Zo werkt die flow:
Ga aan de slag met ElevenAPI voor flexibele transcriptieoplossingen
ElevenAPI biedt zowel real-time- als batchmodellen voor snelle, nauwkeurige transcripties in meer dan 90 talen. De toonaangevende transcriptiemodellen van ElevenAPI leveren nauwkeurige resultaten, zelfs bij audio van lage kwaliteit, achtergrondgeluid of sterke accenten.
ElevenAPI biedt zowel real-time- als batchmodellen voor snelle, nauwkeurige transcripties in meer dan 90 talen. Scribe v2 levert toonaangevende transcriptienauwkeurigheid en Scribe v2 Realtime levert uitzonderlijke nauwkeurigheid voor live toepassingen. Beide leveren betrouwbare resultaten, ook bij audio van lage kwaliteit, achtergrondgeluid of sterke accenten.
Beide modellen zijn beschikbaar op hetzelfde handige platform, zodat je een transcriptiearchitectuur kunt bouwen die bij je behoeften past. Bekijk ElevenLabs Speech to Text API om het in actie te zien, of maak een API-sleutel om aan de slag te gaan.
Veelgestelde vragen over real-time- en batchtranscriptie

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


