Hoe worden synthetische stemmen gemaakt voor natuurlijke spraak?
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
De geavanceerde AI-modellen van vandaag creëren synthetische stemmen die klinken als natuurlijke spraak. Deze modellen zijn getraind op enorme datasets van echte menselijke stemmen en gebruiken geavanceerde neurale netwerken om authentieke spraakpatronen te herkennen en na te bootsen. Het creëren van een synthetische stem wordt ook wel spraaksynthese of stemsynthese genoemd, terwijl de geproduceerde audio synthetische spraak heet.
Om een nieuwe synthetische stem te maken, neemt een gebruiker zichzelf op terwijl die spreekt. Het AI-model analyseert ondertussen de unieke fonetische patronen en intonatie en gebruikt deze data om de stem na te bootsen. Vervolgens kan de gebruiker stemeigenschappen zoals accent, toon en tempo aanpassen om het eindresultaat te creëren. Sommige synthetische stemmen zijn een directe kloon van de spraak van één persoon, terwijl andere een combinatie van meerdere stemmen zijn. Stemmen kunnen ook worden ontworpen op basis van een tekstbeschrijving, volledig zonder opname.
Synthetische stemmen bieden allerlei creatieve mogelijkheden voor podcasts, luisterboeken, videogames en reclame. In dit artikel onderzoeken we hoe synthetische stemmen worden gemaakt, waardoor ze natuurlijk klinken en hoe je met ElevenLabs je eigen synthetische stem maakt.
Samenvatting
- Synthetische stemmen worden gemaakt met neurale AI-modellen die menselijke spraakpatronen analyseren en nabootsen.
- Synthetische stemmen zijn handig voor het inspreken van luisterboeken, het genereren van dialogen voor videogames, het op schaal maken van podcasts en voice-overs, het creëren van klantenservice-AI-agents en zelfs het behouden van stemmen die verloren dreigen te gaan.
- Stemklonen werkt door opnamen van de stem van een specifieke persoon te analyseren en diens unieke accent en spraakpatronen na te bootsen.
- Moderne AI-stemmen klinken natuurlijk omdat ze menselijke prosodie nabootsen en contextbewust zijn, in plaats van alleen losse woorden of lettergrepen na te bootsen.
Hoe synthetische stemmen stap voor stap worden gemaakt
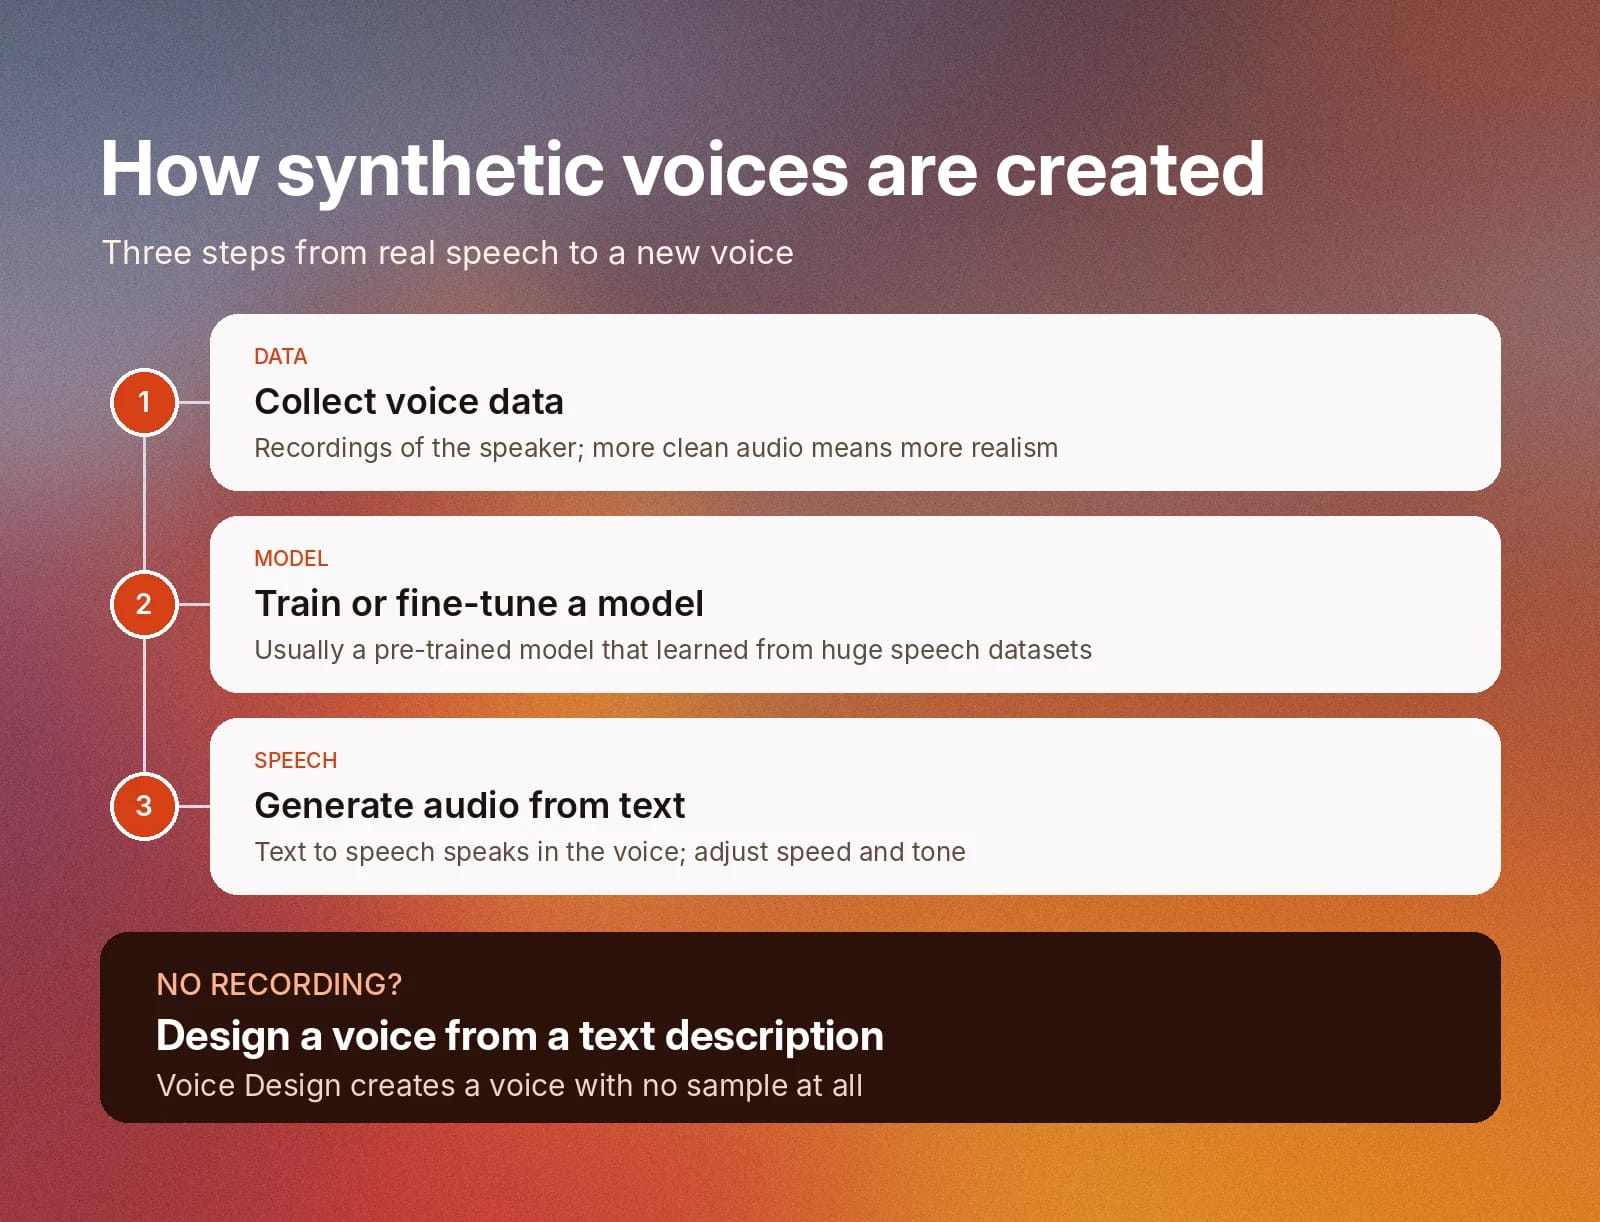
Het maken van een synthetische stem bestaat uit drie stappen.
Zo ziet dat er in de praktijk uit:
- Stap 1: Verzamel stemdata: Synthetische stemmen beginnen met echte menselijke spraak. Om een nieuwe stem te maken, heb je audio-opnamen nodig van de sprekers die je wilt nabootsen. Hoe meer data je aanlevert, hoe nauwkeuriger en realistischer de uiteindelijke stem wordt. Hier vind je enkele best practices voor stemklonen.
- Stap 2: Train of finetune een AI-model: Om synthetische stemmen te maken, analyseren AI-modellen eerst uitgebreide datasets met uiteenlopende spraakopnamen. De modellen gebruiken deze data om menselijke spraakpatronen te begrijpen. Nadat een AI-model is getraind, kan het stemmen van echte mensen klonen met één spraakopname. In de meeste gevallen gebruik je een vooraf getraind model, in plaats van zelf een model vanaf nul op te bouwen.
- Stap 3: Audio genereren uit tekst: Synthetische stemmen gebruiken text to speech om audio te genereren. Je kunt factoren zoals snelheid en toon aanpassen aan je voorkeuren. Lees onze gids over hoe text to speech-technologie werkt voor meer informatie.
Van spraakdata tot neurale text to speech
Neurale text to speech-modellen worden getraind op talrijke datasets met opnamen van echte spraak. Deze datasets bevatten opnamen in verschillende talen, met verschillende accenten, emoties en toonhoogtes. Neurale text to speech is tegenwoordig een veelgebruikte vorm van spraaksynthese.
Traditionele modellen voegden bestaande opnamen van woorden, lettergrepen en fonemen samen. De resultaten klonken erg robotachtig, omdat ze de variaties in toonhoogte, ritme en expressie die spraak menselijk laten klinken niet konden nabootsen.
In plaats van alleen te leren hoe letters en lettergrepen klinken, leren moderne neurale text to speech-modellen natuurlijke menselijke uitspraakpatronen en spraakritmes. Bij het omzetten van tekst naar spraak beoordelen deze modellen de tekst, zetten ze die om in akoestische kenmerken en gebruiken ze die kenmerken vervolgens om golfvormen te genereren.
Doordat akoestische kenmerken zoals toonhoogte, ritme en toon zijn ingebouwd in neurale AI-modellen, klinkt de resulterende spraak veel natuurlijker en authentieker dan bij modellen uit het verleden.
De resultaten zijn ook aanpasbaar: je kunt factoren zoals snelheid, emotie en zelfs accent wijzigen om precies de stem te krijgen die je zoekt. Je merk kan bijvoorbeeld op je hele website dezelfde synthetische stem gebruiken, maar voor marketingcontent enthousiasme en urgentie inzetten en voor klantenservice-interacties rust.
Standaard, neurale en generatieve text to speech
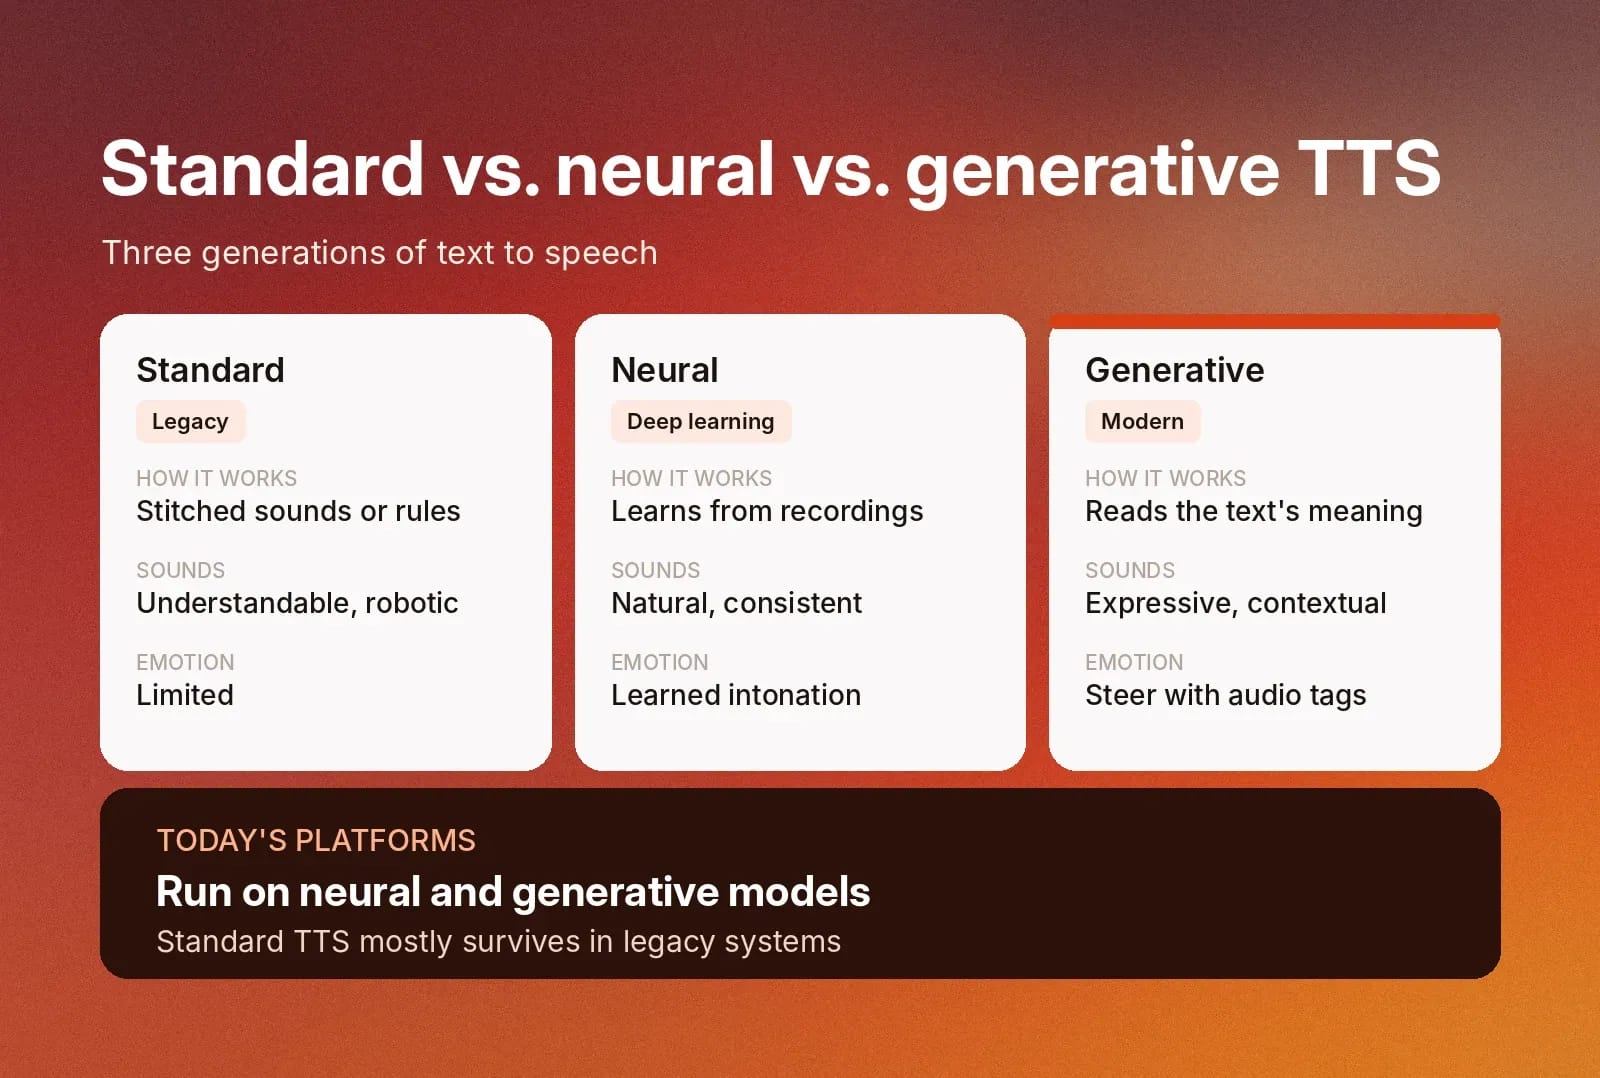
Text to speech-modellen vallen in drie brede generaties.
Als je de verschillen begrijpt, wordt duidelijker waarom moderne modellen, zoals ElevenLabs Text to Speech, zo natuurlijk kunnen klinken.
- Standaard text to speech: Deze systemen voegen vooraf opgenomen geluiden samen of volgen regels en statistische modellen om tekst uit te spreken. De uitvoer is begrijpelijk, maar robotachtig en met beperkte emotie.
- Neurale text to speech: Deep learning-modellen leren uitspraak, ritme en intonatie uit grote verzamelingen opnamen en genereren spraak die veel natuurlijker en consistenter klinkt.
- Generatieve text to speech: Generatieve modellen worden getraind op nog grotere en gevarieerdere spraakdata. Ze gebruiken de betekenis van de tekst om emotie, tempo en nadruk te bepalen. Je kunt de voordracht sturen met instructies, zoals audio tags.
Moderne stemplatforms vertrouwen op neurale en generatieve modellen, terwijl standaard text to speech vooral nog in legacy-systemen voorkomt.
Waardoor klinkt AI-stemgeneratie natuurlijk?
Door AI gegenereerde synthetische stemmen klinken sterk vergelijkbaar met menselijke stemmen. Het kan zelfs lastig zijn om het verschil te horen als je niet goed luistert.
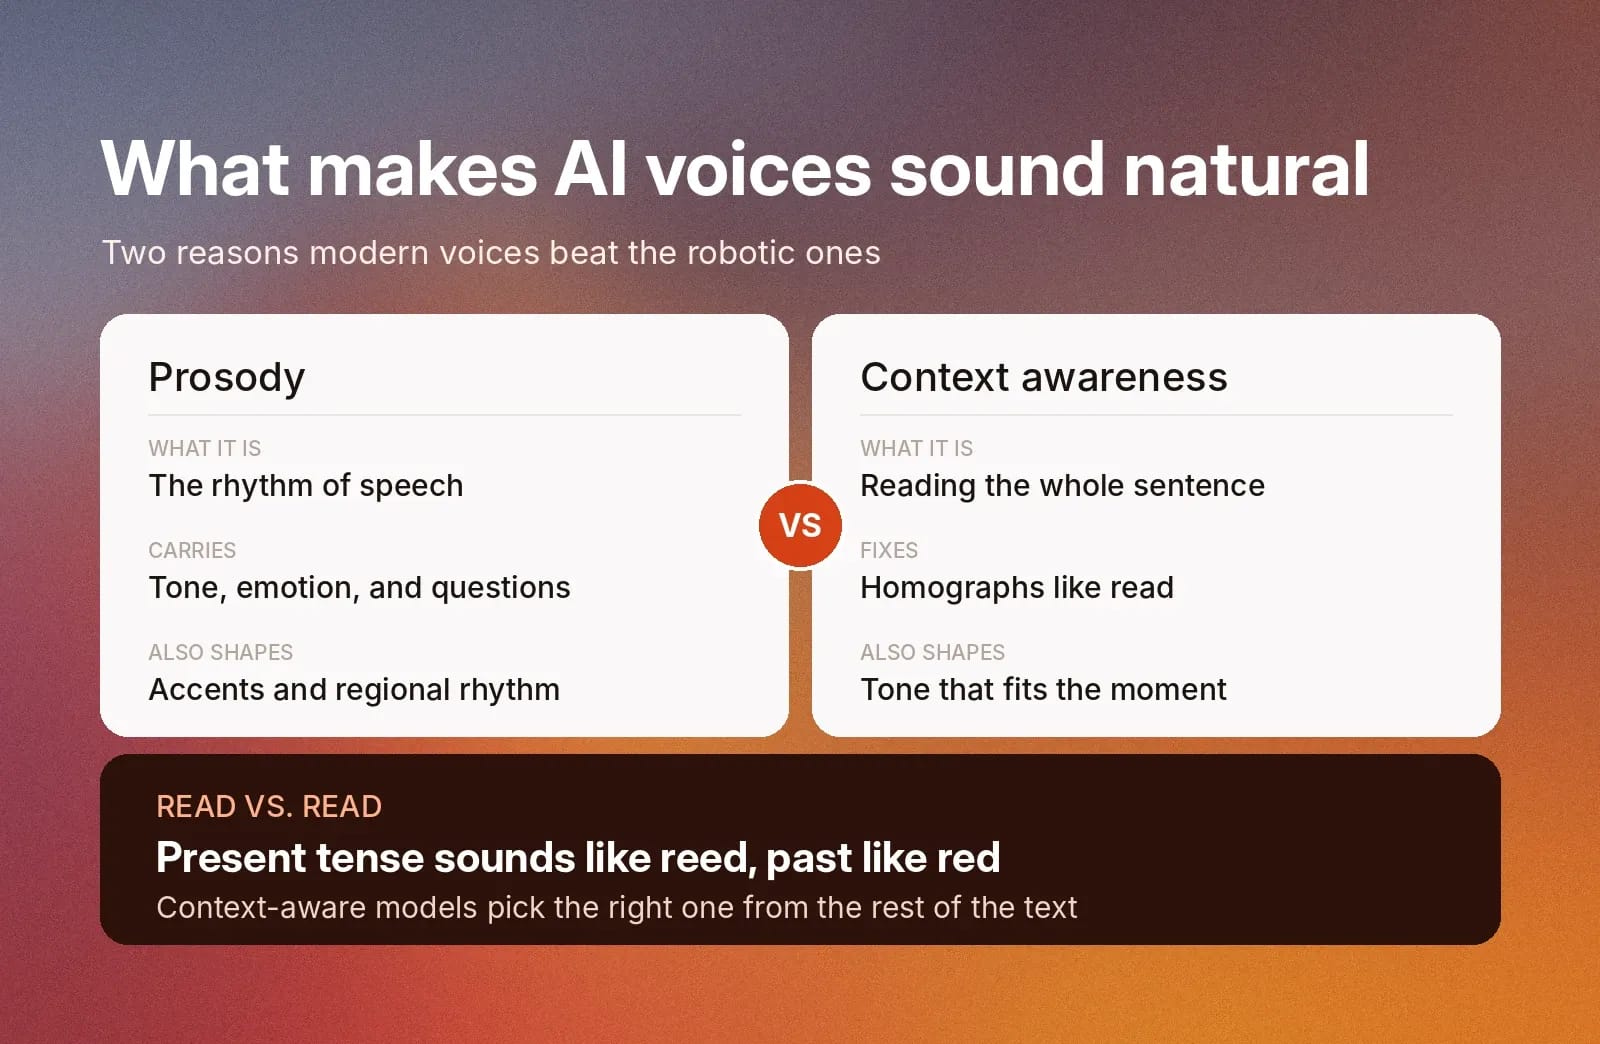
Er zijn twee redenen waarom door AI gegenereerde stemmen natuurlijker klinken dan de robotachtige stemmen van vroeger: prosodie en contextbewustzijn.
Prosodie
Prosodie is het ritme van natuurlijke menselijke spraak. Kleine veranderingen in intonatie en snelheid brengen tijdens het spreken toon en emotie over. Snel spreken kan bijvoorbeeld stress of enthousiasme uitdrukken, terwijl het verhogen van je toonhoogte aan het einde van een zin een mededeling in een vraag verandert.
De AI-stemmodellen van vandaag zijn getraind om prosodie te begrijpen en na te bootsen. Daardoor weerspiegelt de uitvoer de stroom van een natuurlijk menselijk gesprek, in plaats van stijf of vlak te klinken.
Als je een synthetische stem gebruikt om een luisterboek in te spreken of videogamedialogen te maken, gebruikt deze prosodie om de emoties van het personage weer te geven. Als je een voice-over voor educatieve content of een klantenservice-AI-agent maakt, past het AI-model de prosodie aan voor een rustige, empathische voordracht.
Door prosodie te begrijpen, kunnen AI-modellen ook unieke accenten nabootsen. Het ritme van een Noord-Amerikaans Engels accent klinkt bijvoorbeeld heel anders dan dat van een Brits, Schots of Iers Engels accent, ook al spreken ze dezelfde taal.
Contextbewustzijn
In plaats van elk woord afzonderlijk te verwerken, beoordelen TTS-modellen op basis van AI de volledige woordgroep, zin of conversatie en passen ze de voordracht aan op basis van de context.
Er zijn bijvoorbeeld veel woorden die hetzelfde worden gespeld, maar afhankelijk van de tijd en context anders worden uitgesproken. Het Engelse woord “read” wordt in de tegenwoordige tijd bijvoorbeeld uitgesproken als “reed”, maar in de verleden tijd als “red”.
Doordat AI-stemmen contextbewust zijn, herkennen ze op basis van de rest van de tekst de juiste uitspraak. Ze passen ook hun voordracht aan zodat de toon en emotie bij de situatie passen.
Hoe werkt stemklonen?
Stemklonen werkt door AI de stem van een echt persoon te laten beoordelen en vervolgens diens stemeigenschappen toe te passen op synthetische spraak.
Eerst moet de persoon die zijn stem kloont een kort audiofragment aanleveren. Het AI-model gebruikt dit audiofragment om het accent, de toonhoogte, de toon en het spreekritme van de persoon te identificeren. Het model gebruikt deze kenmerken om een digitale replica van de stem te maken. Gebruikers kunnen met text to speech-technologie nieuwe spraak in deze stem genereren.
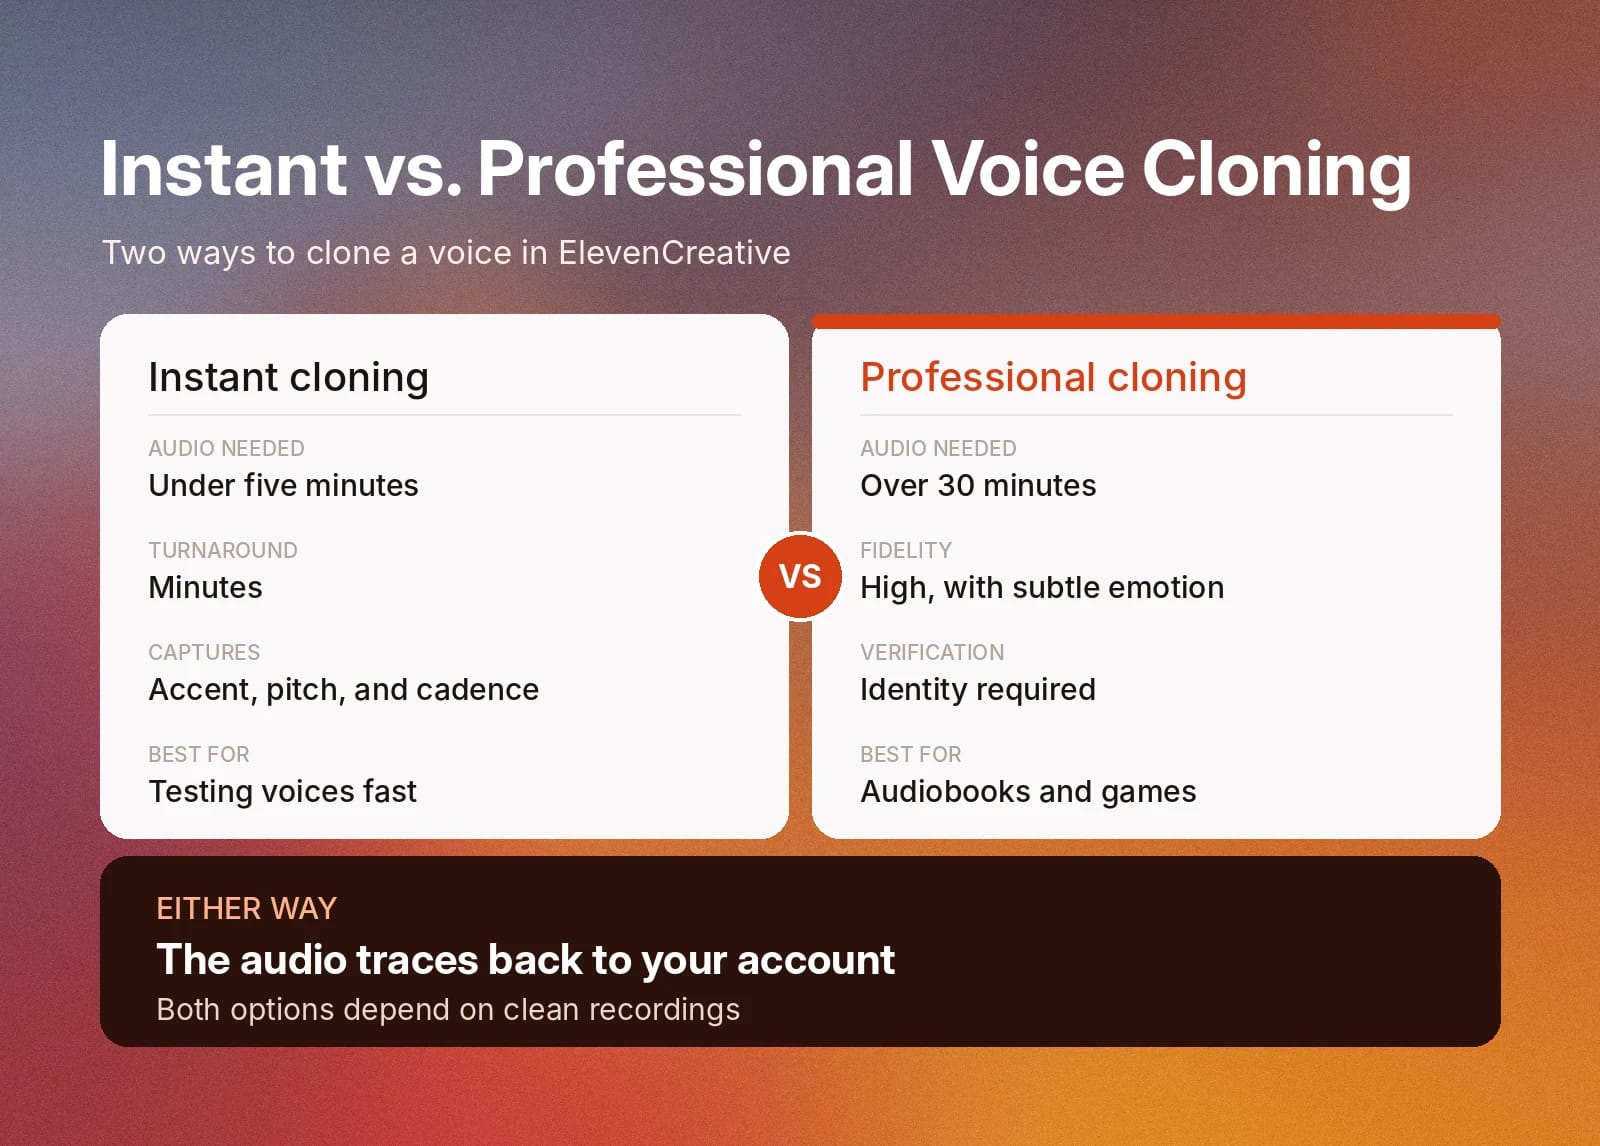
Er zijn twee soorten stemklonen: Instant en Professional. Met Instant-klonen maak je een stemreplica met minder dan twee minuten voorbeeld-audio. Zo kun je eenvoudig stemopties testen voordat je je vastlegt op een groter project.
Professional-klonen gebruikt tussen de 30 minuten en drie uur aan audiofragmenten om een stemkloon met hoge nauwkeurigheid te maken. Professional Voice Clones behouden subtiele details zoals emotie en intonatie die niet aanwezig zijn in Instant Clones. Ze vereisen ook identiteitsverificatie.
Stemklonen kent uiteenlopende toepassingen, van snel voice-overs genereren tot stemmen behouden die anders verloren zouden kunnen gaan.
Goede stemvoorbeelden opnemen voor spraaksynthese
De kwaliteit van een stemkloon hangt af van de kwaliteit van de opname. Ook zonder dure opnameapparatuur kun je veel kleine dingen doen om je stemkloon beter te laten klinken.
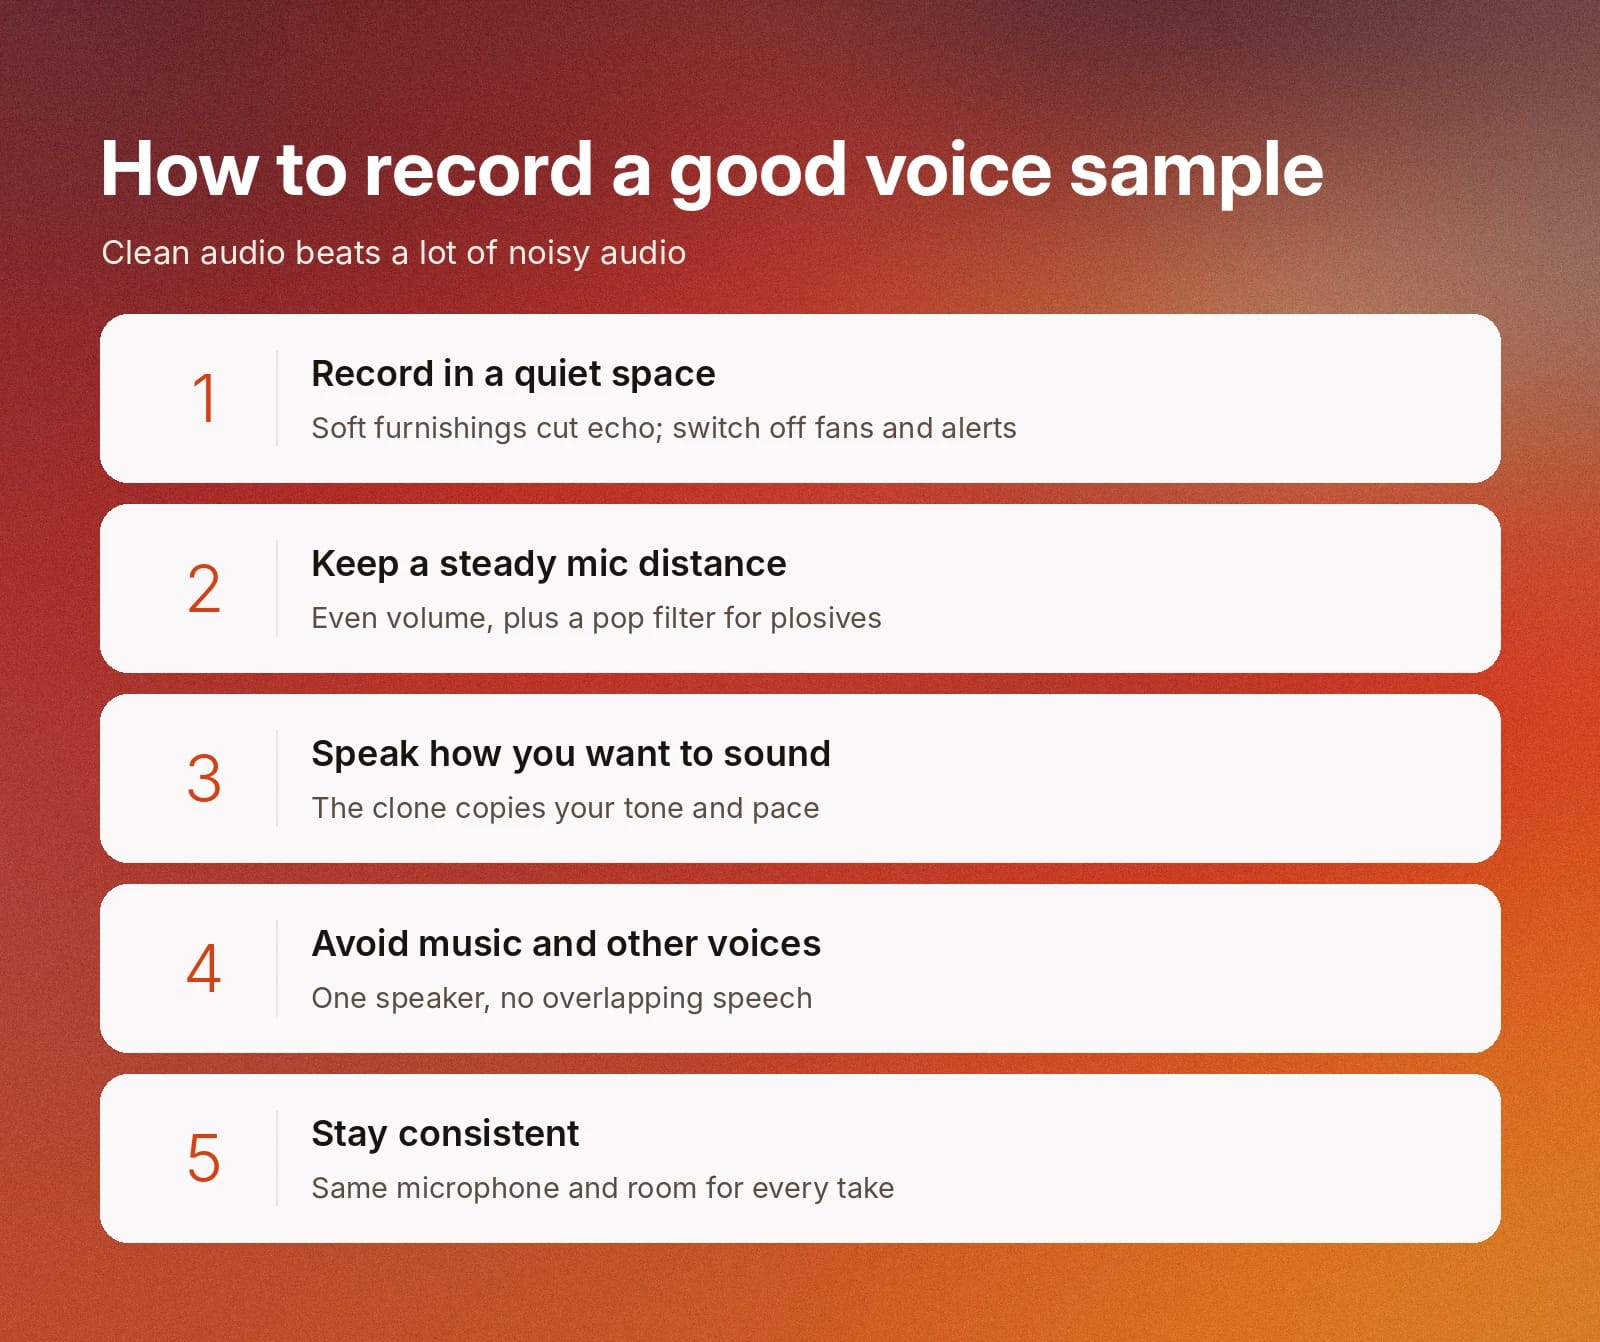
Met deze gewoonten leg je schone voorbeelden vast:
- Neem op in een stille ruimte: Zachte materialen zoals gordijnen en tapijten verminderen echo, en door ventilatoren en meldingen uit te schakelen, voorkom je achtergrondgeluid.
- Houd de microfoon op een vaste afstand: Een consistente afstand houdt het volume gelijkmatig en een popfilter vermindert harde plofklanken.
- Spreek zoals je wilt dat de kloon klinkt: De kloon kopieert je voordracht. Neem op in de toon en het tempo die je wilt gebruiken.
- Vermijd muziek en andere stemmen: Gebruik één spreker zonder achtergrondmuziek of overlappende spraak.
- Blijf consistent: Gebruik voor al je opnamen dezelfde microfoon en ruimte.
Hoewel Instant Cloning minder audio nodig heeft en Professional Cloning meer, zijn beide afhankelijk van schone opnamen. Schone audio van de juiste lengte levert betere resultaten op dan een grote hoeveelheid ruisende audio.
Een stem maken zonder opname: Voice Design
Niet elke synthetische stem begint met een opname. Met Voice Design beschrijf je in tekst de gewenste stem, met details zoals leeftijd, gender, accent, toon en tempo. Het AI-model genereert vervolgens stemopties die bij je beschrijving passen. Je kunt naar de opties luisteren, je favoriet kiezen en deze opslaan in je stemmenbibliotheek.
Voice Design is handig als je een stem nodig hebt voor een personage, merk of product en er geen echt persoon is om te klonen. Lees de Voice Design-documentatie om te leren hoe je effectieve stembeschrijvingen schrijft.
Hoe herken je of een stem door AI is gegenereerd
Er is niet één kenmerk dat bewijst dat een stem door AI is gegenereerd. Zorgvuldig luisteren, detectietools gebruiken en nagaan waar de audio vandaan komt, werkt beter dan op slechts één van deze methoden vertrouwen.
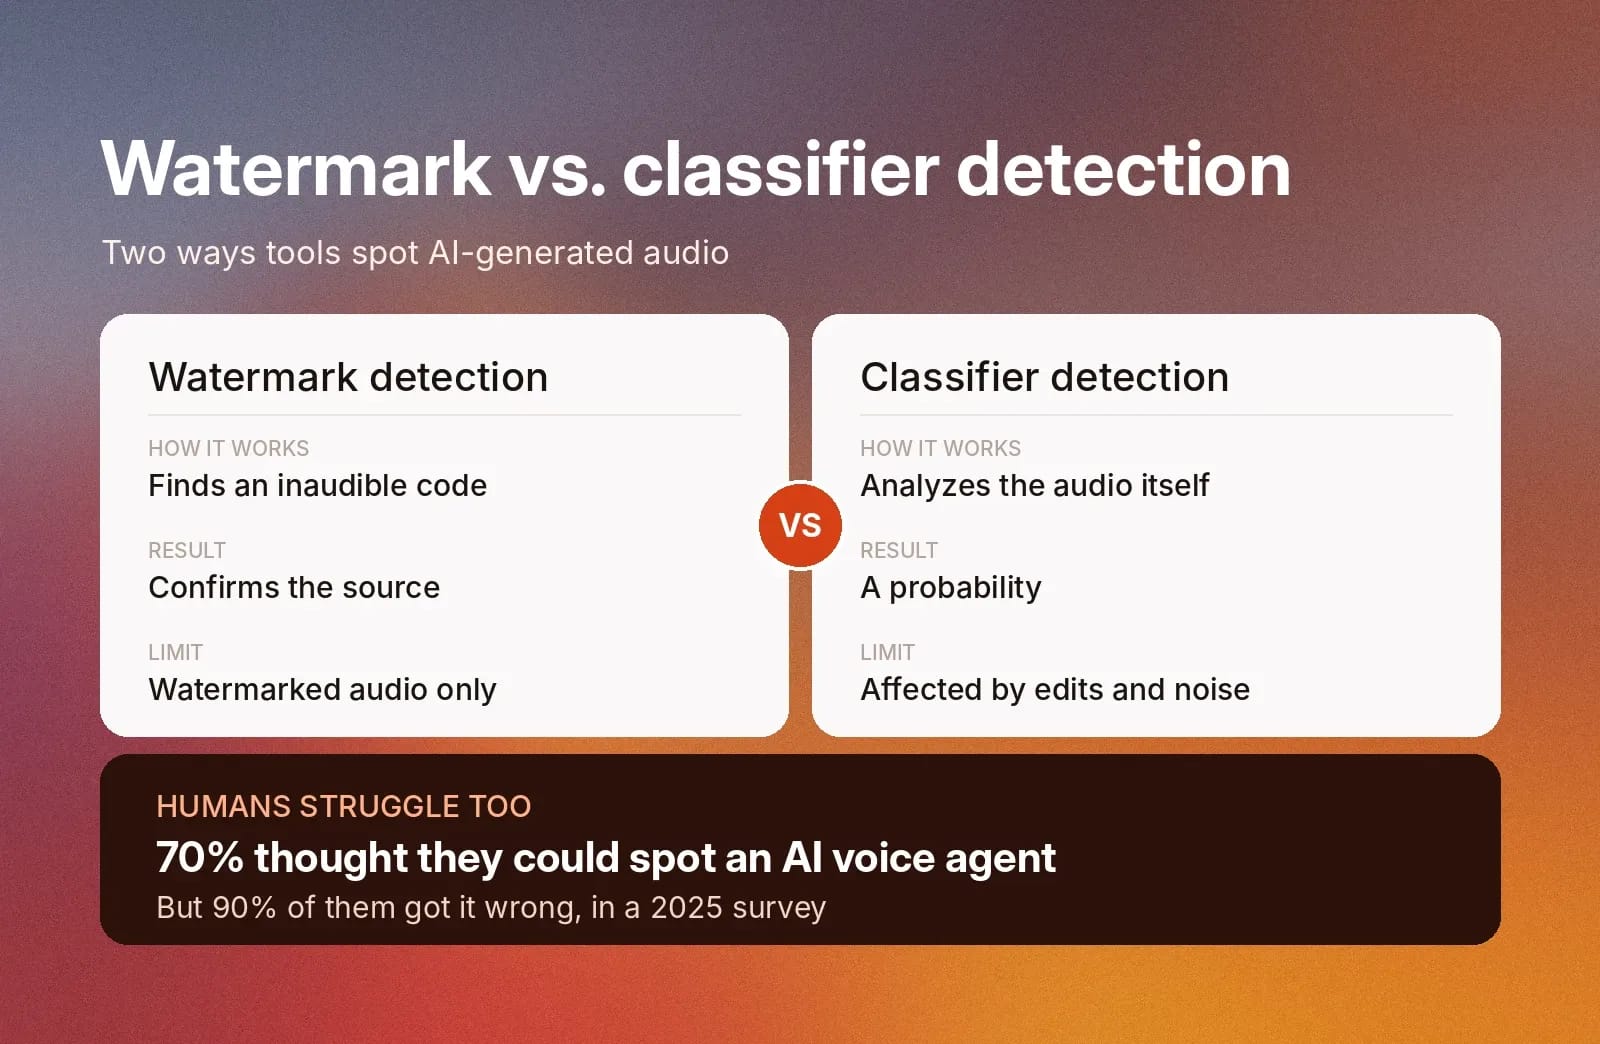
Veel mensen denken dat ze het verschil kunnen horen tussen een echte stem en een door AI gegenereerde stem, maar ze hebben het niet altijd bij het juiste eind. Uit een onderzoek uit 2025 bleek dat 70% van de consumenten dacht een AI-stemagent correct te kunnen herkennen, maar 90% van hen slaagde daar niet in.
In plaats van alleen op het menselijk oor te vertrouwen, kun je een detectietool gebruiken. Detectietools werken op twee manieren:
- Watermarkdetectie: Sommige AI-providers voegen een watermark, een code die mensen niet kunnen horen, toe aan de audio die ze genereren. Een detector kan het watermark vinden en bevestigen waar de audio vandaan komt. Dit werkt alleen bij audio die een watermark bevat.
- Detectie op basis van classifiers: Een classifier analyseert de audio en schat de kans dat deze door AI is gegenereerd. Deze kan audio zonder watermark markeren, maar het resultaat is een waarschijnlijkheid en kan worden beïnvloed door compressie, achtergrondgeluid of bewerking.
Geen van beide methoden is perfect. Zie een detectieresultaat als één bewijsstuk en toets het aan wat je over de bron weet. We hebben een handleiding geschreven over detectie van audio-deepfakes, die hier dieper op ingaat.
ElevenLabs Speech Classifier is een tool die de kans bepaalt dat een audiofragment is gegenereerd met ElevenLabs AI-stemmodellen. ElevenLabs werkt ook samen met Reality Defender aan initiatieven voor deepfakedetectie om stemfraude te herkennen en te voorkomen.
Waar je op moet letten
Detectietools zijn niet altijd beschikbaar, dus het helpt om de veelvoorkomende signalen van een synthetische stem te kennen.
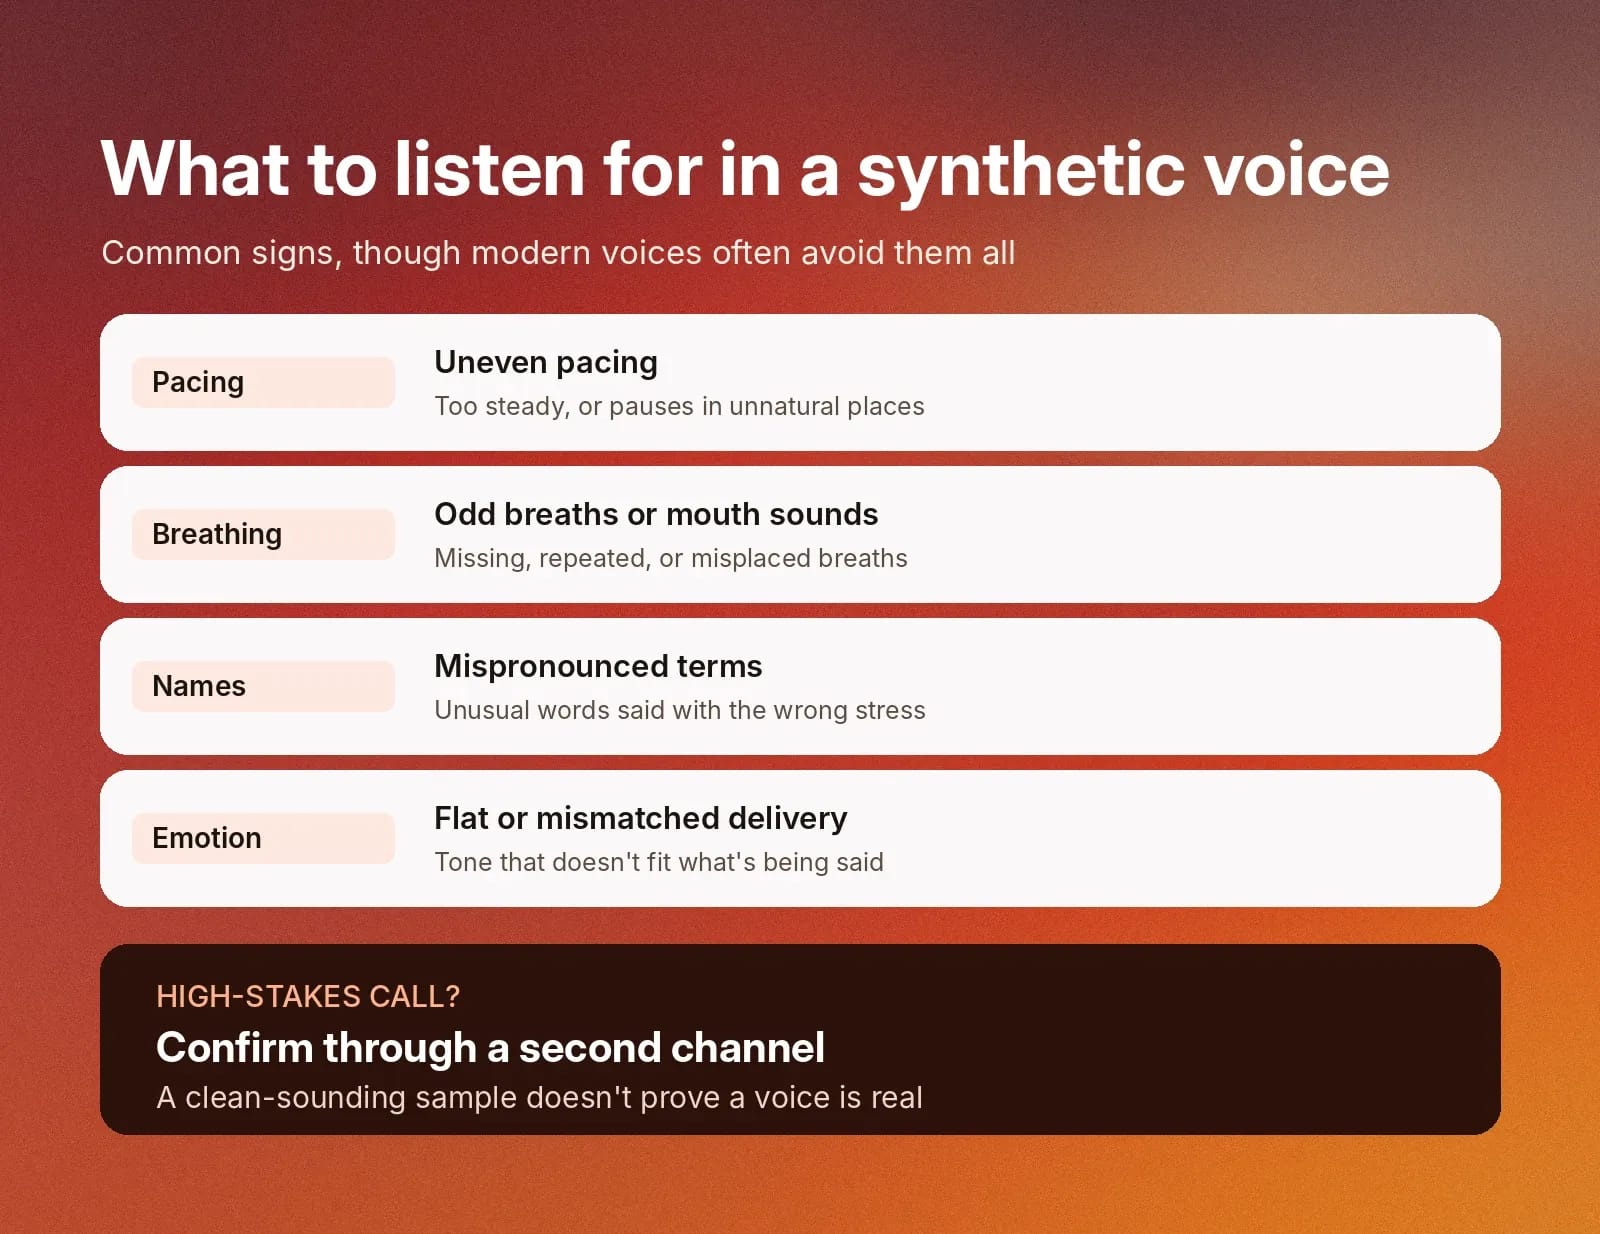
Let op:
- Ongelijkmatig tempo: Spraak die te gelijkmatig is of op onnatuurlijke plekken pauzeert.
- Vreemde ademhalings- of mondgeluiden: Ademhalingen die ontbreken, worden herhaald of verkeerd geplaatst. Dit kan wijzen op audioartefacten die een model onbedoeld heeft gegenereerd.
- Verkeerd uitgesproken namen of termen: Ongebruikelijke woorden die met de verkeerde klemtoon worden uitgesproken. Dit komt nog vaker voor in talen met accenttekens om bepaalde lettergrepen in woorden te benadrukken, zoals Spaans.
- Vlakke of niet-passende emotie: Een voordracht die niet past bij de betekenis van de woorden. Dit wijst op een gebrek aan begrip van de tekst zelf, een veelvoorkomend probleem bij legacy-TTS-modellen.
Moderne synthetische stemmen vermijden dit vaak allemaal. Een helder klinkend fragment bewijst niet dat een stem echt is. Bevestig via een tweede kanaal alles waarbij veel op het spel staat, zoals een telefoontje waarin om geld wordt gevraagd.
Bouw aangepaste stemervaringen met ElevenCreative
ElevenCreative helpt je aangepaste stemervaringen te bouwen voor je creatieve projecten. Kies uit een uitgebreide bibliotheek van meer dan 20.000 kant-en-klare stemmen of maak er zelf een met nauwkeurig en veilig stemklonen.
Gebruik ElevenCreative om je stem na te bootsen met Instant Voice Cloning of Professional Voice Cloning. Instant Voice Cloning werkt binnen enkele minuten, zodat je stemopties kunt testen of snel persoonlijke projecten kunt starten. Professional Voice Cloning gebruikt langere audiofragmenten om stemmen van hoge kwaliteit te creëren, ideaal voor langere projecten zoals luisterboeken, videogames of podcasts. Welke optie je ook kiest, de audio is voor veiligheid herleidbaar tot je account.
De aanpasbare Voice Library en stemklonentools van ElevenCreative helpen je creatieve projecten tot leven te brengen. Registreer je voor ElevenCreative om iconische stemmen te verkennen of je eigen stem te maken.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.