Audio-deepfakedetectie: hoe het werkt en hoe je audio van ElevenLabs verifieert
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
Audio-deepfakedetectie is het proces waarbij spraakaudio wordt geanalyseerd om te bepalen of de spraak authentiek is. AI-stemsynthesizers die deepfakes genereren, worden steeds toegankelijker. Zowel in het openbare leven als in het bedrijfsleven is het steeds belangrijker om snel vast te stellen of de spraak die je hoort echt is of door een kwaadwillende is gemanipuleerd.
In dit artikel bespreken we hoe audio-deepfakedetectie werkt, de verschillende soorten detectie, hun sterke en zwakke punten en hoe je deepfakedetectie kunt integreren in systemen voor fraudedetectie op grote schaal.
Samenvatting
- Door deepfakes gesynthetiseerde spraak wordt steeds moeilijker alleen op het gehoor te herkennen. Dit vormt een aanzienlijk risico in zowel het openbare leven als het bedrijfsleven.
- Er bestaan verschillende soorten software voor deepfakedetectie. Conventionele tools gebruiken statistische analyses om de kans te beoordelen dat een audiofragment door AI is gegenereerd.
- Nieuwe watermerktechnologie geeft een definitief ja-of-neeantwoord op de vraag of een stemfragment is gesynthetiseerd.
- Watermerken zijn zeer nauwkeurig, maar detectoren werken alleen voor de eigen audio van een provider. Zo kan de Audio Detector van ElevenLabs met hoge nauwkeurigheid watermerken herkennen die door eigen producten zijn gegenereerd, maar niet die van andere bedrijven.
- Watermerken zijn een belangrijk hulpmiddel voor organisaties die deepfakes op grote schaal moeten detecteren, maar ze moeten slechts een van de vele tools in hun deepfakedetectiestack zijn.
Wat is audio-deepfakedetectie?
Audio-deepfakedetectie is het proces om te bepalen of spraakaudio door kunstmatige intelligentie is gegenereerd of gemanipuleerd.
Een deepfake is elke vorm van media (meestal afbeeldingen, video of audio) die door een generatieve AI-applicatie is gemaakt om onjuist weer te geven wat iemand zegt of doet. Audio-deepfakes hebben veel kwaadwillende toepassingen. Ze kunnen worden gebruikt voor fraude, om toegang te krijgen tot persoonlijke accounts, als politieke propaganda of om in huiselijke conflicten in het geheim een partner of familielid te imiteren.
Op basis van huidige trends zijn de slachtoffers van audio-deepfakefraude waarschijnlijk:
- Politici en andere publieke figuren: Personen met online uitgebreide stemfragmenten die beschikbaar zijn voor training, kunnen hun stem door tegenstanders of derden laten deepfaken om het publiek te misleiden.
- Familieleden: Een kwaadwillende kan proberen gevonden stemopnamen te gebruiken om oudere familieleden op te lichten met deepfakeverzoeken om geld.
- Bedrijfsbestuurders: Vervalste interviews, presentaties en calls over bedrijfsresultaten kunnen worden gebruikt om het merk van een bedrijf te schaden.
- Klantenserviceteams: Oplichters kunnen verzamelde stemfragmenten gebruiken om klantenserviceteams te misleiden zodat ze toegang geven tot privéaccounts.
Helaas zijn mensen geen betrouwbare detectoren van deepfakes. In gecontroleerde onderzoeksomgevingen is het vermogen van mensen om ze te herkennen niet beter dan toeval, en dat onderzoek stamt al uit 2024. Generatieve media zijn sindsdien aanzienlijk geavanceerder geworden.
Onderwijs en wetgeving helpen de samenleving sterk te beschermen tegen de invloed van deepfakes, maar betrouwbare detectiemethoden blijven noodzakelijk.
Hoe werkt audio-deepfakedetectie?
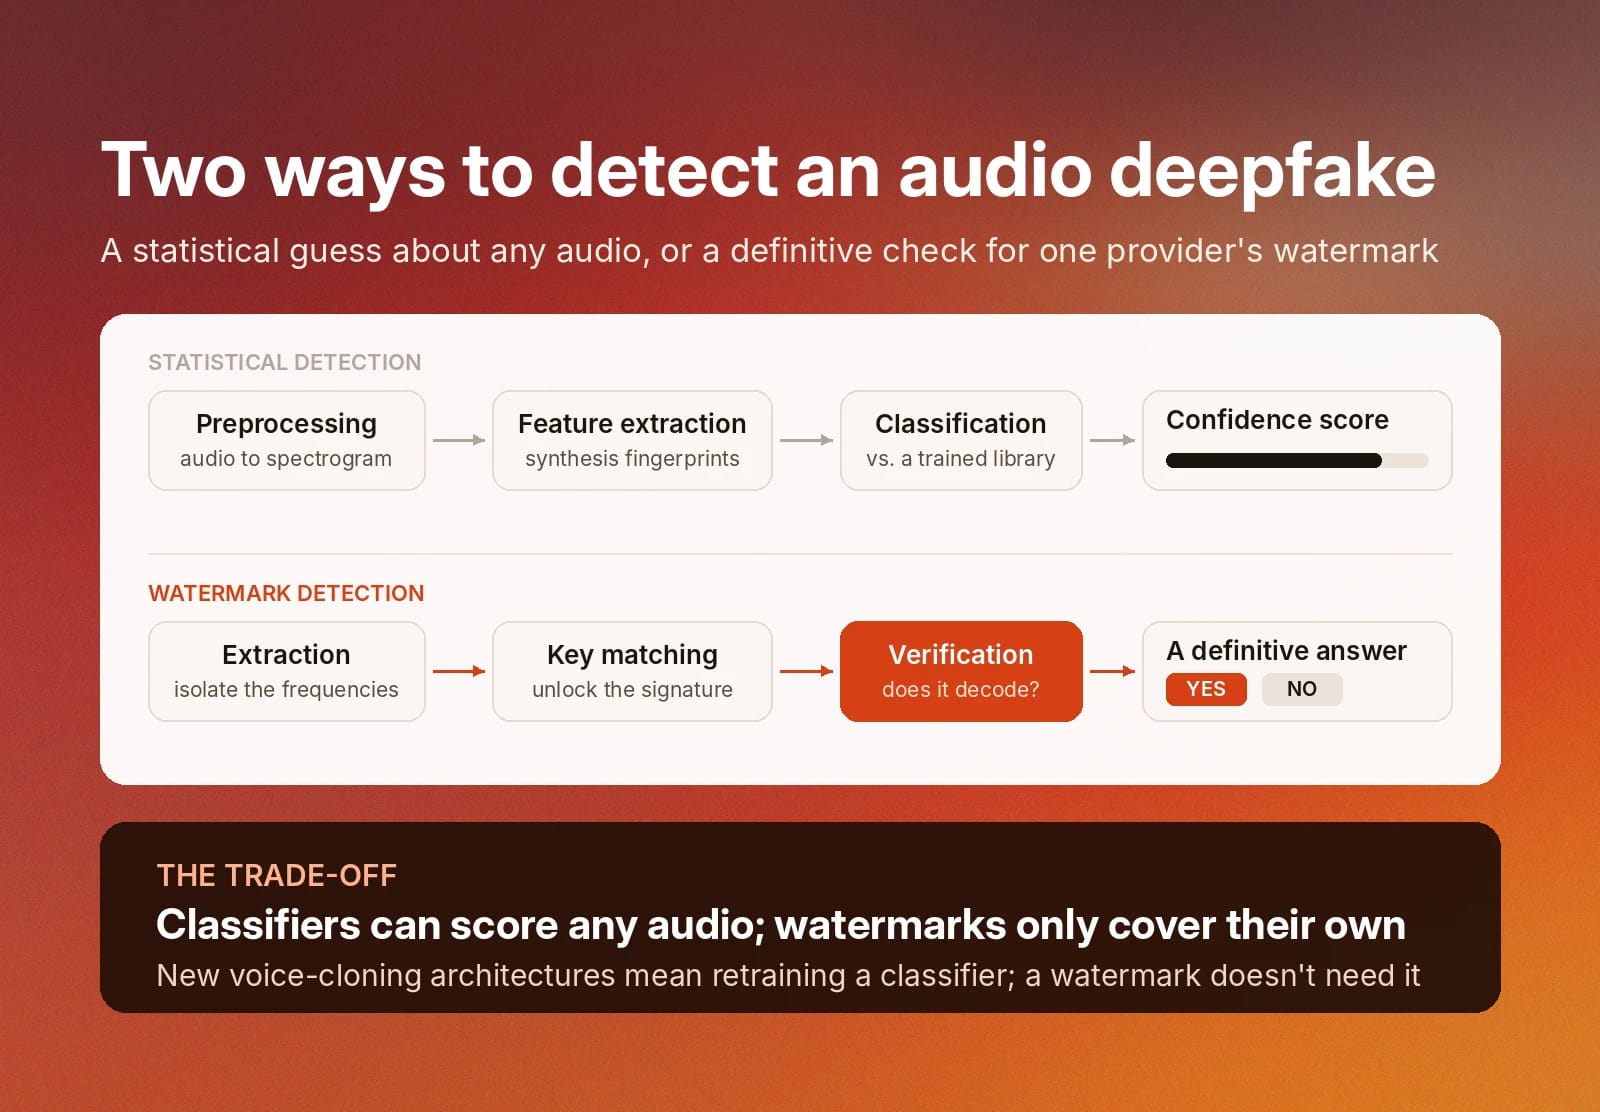
Conventionele deepfakedetectie gebruikt statistische analyse om de waarschijnlijkheid te meten dat media door AI zijn gegenereerd. Een detectietool gebruikt machinelearningtechnieken om de onderliggende patronen in verschillende soorten gesynthetiseerde spraak te herkennen.
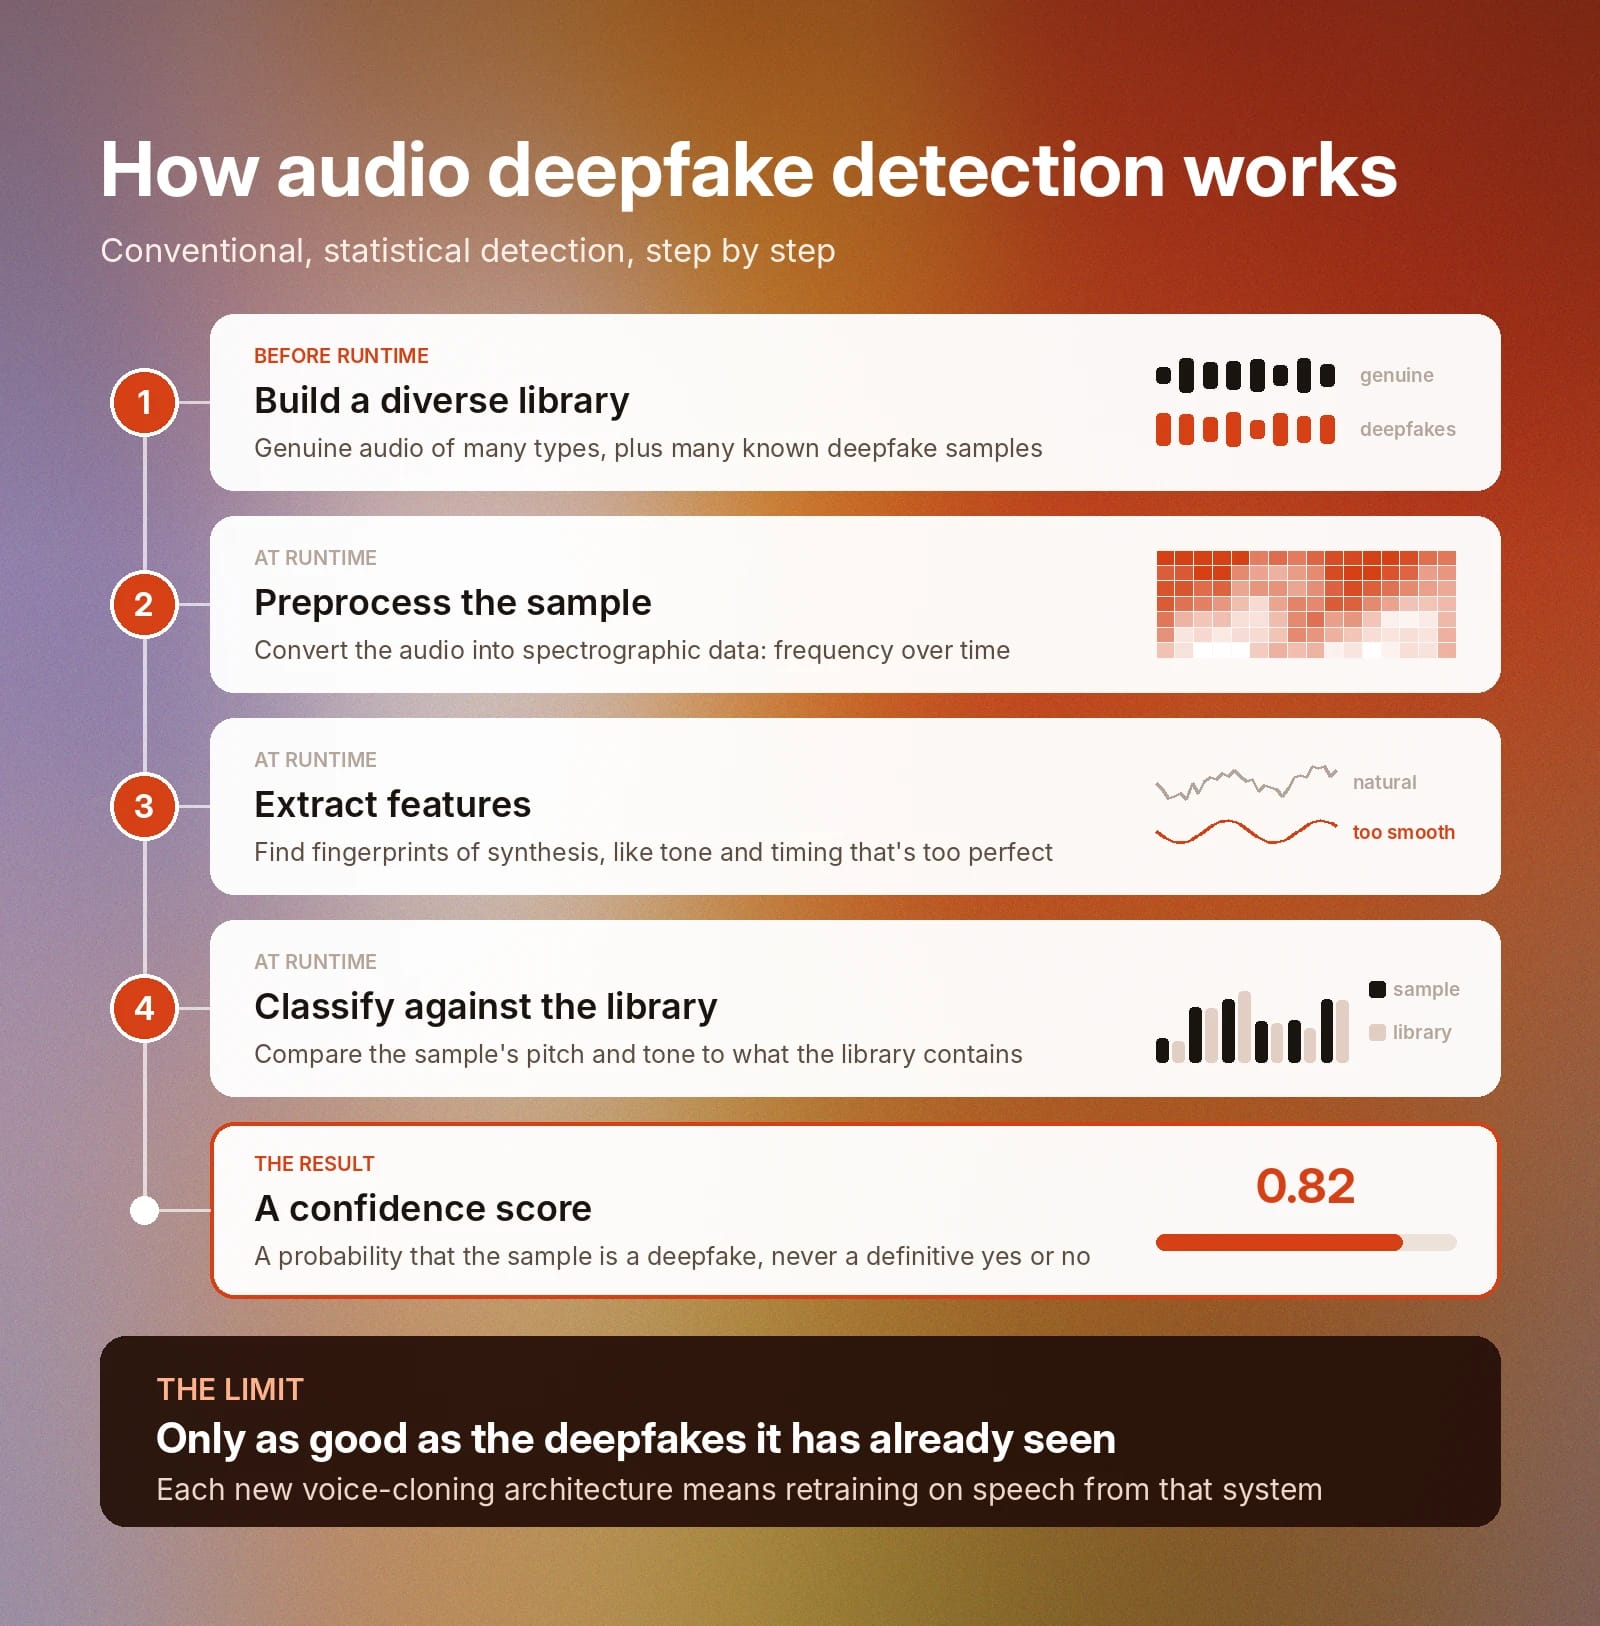
De eerste stap is het opbouwen van een bibliotheek met audio-inhoud waarmee vermoedelijke deepfakes kunnen worden vergeleken. Dit moet een diverse dataset zijn, met authentieke audiofragmenten van uiteenlopende soorten en veel bekende deepfakefragmenten om positieve detecties mogelijk te maken.
Tijdens gebruik volgt de tool een proces in drie stappen: voorbewerking, kenmerkextractie en classificatie.
Audiovoorbewerking
Wanneer je een getrainde detectietool een audiofragment geeft, zet deze het om in spectrografische data, oftewel een wiskundige weergave van frequentieveranderingen in de tijd.
Kenmerkextractie
Vervolgens haalt de detectietool kenmerken uit de voorbeelddata die als vingerafdrukken voor gesynthetiseerde spraak dienen. AI-spraak is bijvoorbeeld soms te perfect en mist de onregelmatigheden in toon en timing die natuurlijke spraak kenmerken. Het vergelijken van de toonhoogte en klank van de spreker met de bibliotheek helpt de tool ook andere waarschuwingssignalen te herkennen.
Classificatie
Omdat conventionele deepfakedetectie via statistische analyse werkt, kan deze geen definitief antwoord met “ja” of “nee” geven op de vraag of een fragment een deepfake is. In plaats daarvan genereert de tool een betrouwbaarheidsscore, of waarschijnlijkheid, dat het fragment een deepfake is.
Omdat conventionele tools overeenkomsten meten tussen een fragment en een bestaande audiobibliotheek, zijn ze beperkt door de bekende deepfakefragmenten die hun ter beschikking staan. Telkens wanneer iemand een nieuwe architectuur voor stemklonen uitbrengt, moet je je detectietool opnieuw trainen met spraak die in dat nieuwe systeem is gesynthetiseerd om deze nauwkeurig te detecteren.
Wat is het verschil tussen watermerken en statistische detectie?
Watermerken vormen een volledig andere benadering van spraakclassificatie. Een machinelearningclassificator doet op basis van zijn trainingsdata een probabilistische inschatting of een fragment authentiek is. Daarbij gebruikt deze wat hij over natuurlijke spraak weet, zoals hoe echte emotionele lading en nadruk eruitzien in spectrografische data en welke veranderingen in toon en timing natuurlijk zijn.
Watermerken zijn deterministisch. Een watermerk is een wiskundige handtekening die de synthesizer in audiodata inbedt op niveaus die een menselijke luisteraar niet kan horen. Een watermerkdetector controleert met ja of nee of deze die verborgen handtekening vindt.
Een detector werkt in drie eenvoudige stappen:
- Extractie: De tool haalt spectrografische data op en isoleert de frequenties waarin deze een watermerk verwacht te vinden.
- Sleutelvergelijking: De tool probeert de handtekening met een sleutel te ontgrendelen.
- Verificatie: Als het signaal correct wordt gedecodeerd, bevestigt de tool dat de AI-stemgenerator in kwestie de audio heeft gegenereerd.
Het detectieproces voor watermerken van ElevenLabs
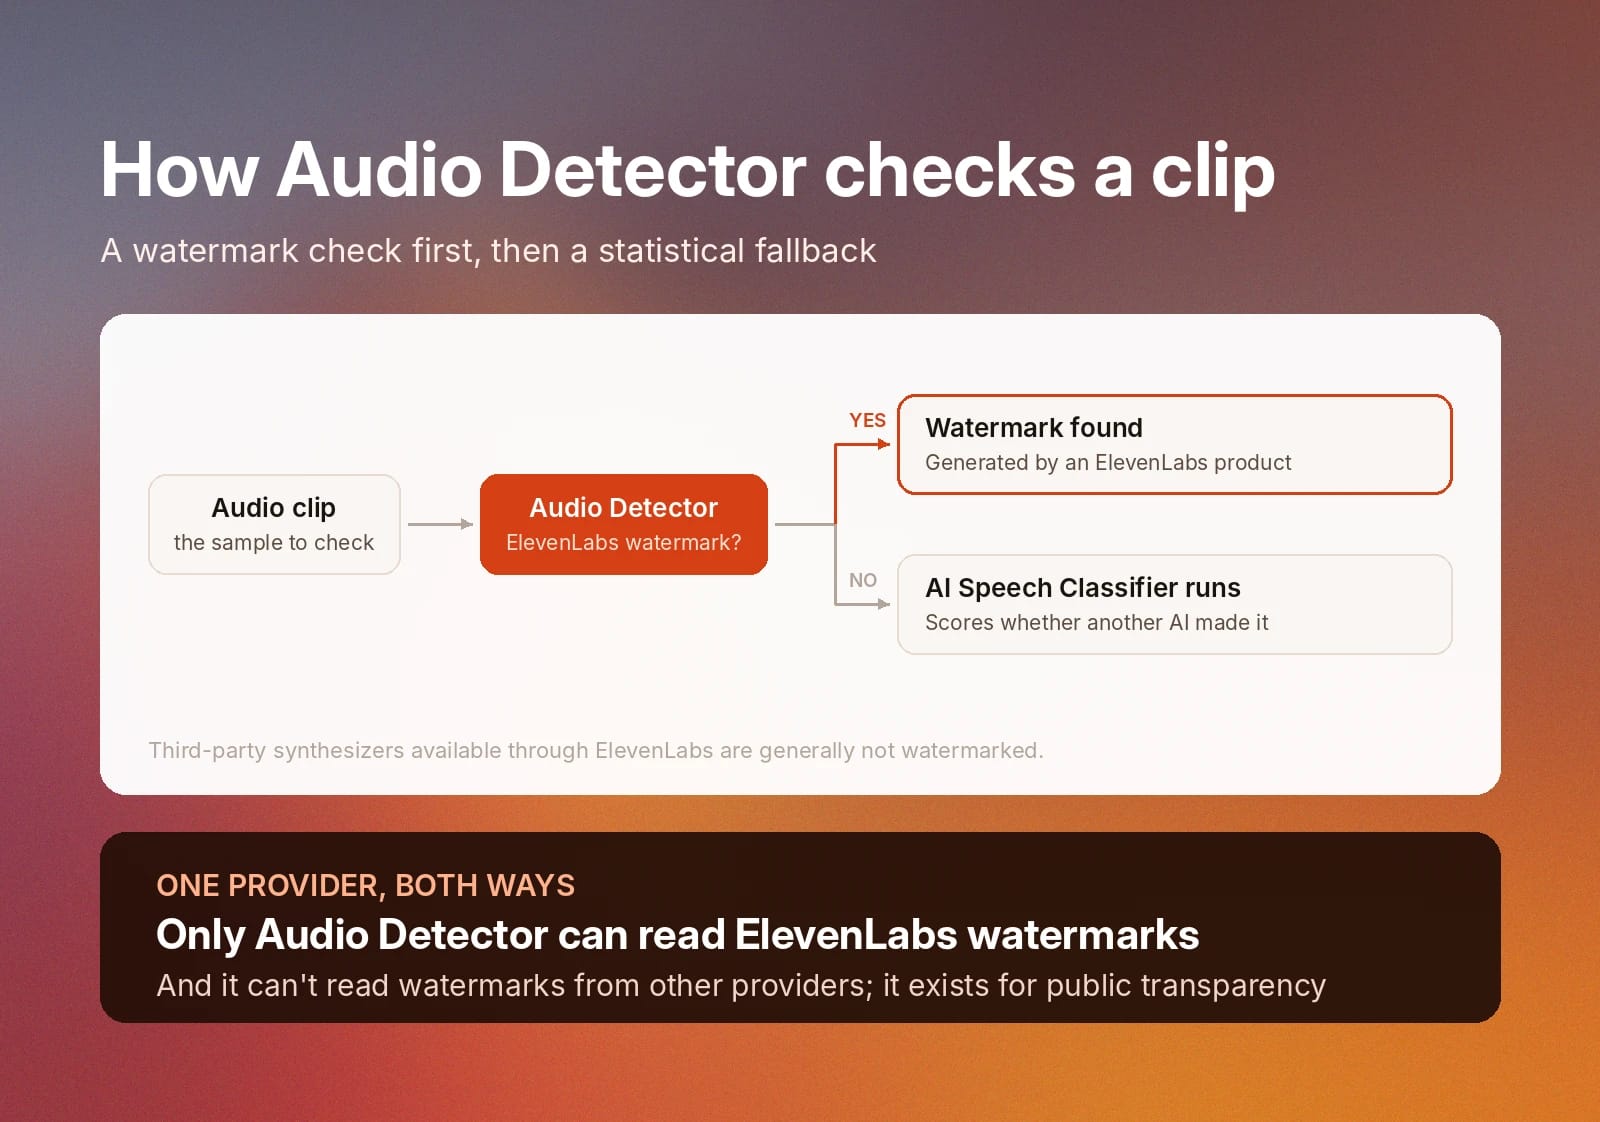
De tool voor watermerken van ElevenLabs is Audio Detector. Deze scant audiofragmenten en verifieert of de inhoud door een product van ElevenLabs is gegenereerd. Als deze geen watermerk vindt, voert de tool vervolgens de statistische AI Speech Classifier uit om te beoordelen of de audio door AI uit een andere bron is gegenereerd.
Door de werking van watermerken detecteert ElevenLabs Audio Detector alleen audio die door ElevenLabs is gegenereerd. De tool kan momenteel geen watermerken van andere AI-stemproviders herkennen.
Omgekeerd kan alleen Audio Detector van ElevenLabs watermerken van ElevenLabs detecteren.
Houd er ook rekening mee dat inhoud die is gegenereerd door synthesizers van derden die via ElevenLabs beschikbaar zijn, doorgaans geen watermerk heeft.
Andere opties om door ElevenLabs gegenereerde audio te detecteren
De ElevenCreative AI Speech Classifier is gratis beschikbaar zonder in te loggen. Deze analyseert de eerste minuut van een audiofragment en geeft een betrouwbaarheidsscore voor de waarschijnlijkheid dat de audio door een model van ElevenLabs is gegenereerd.
Houd er rekening mee dat deze Eleven v3-audio niet betrouwbaar kan classificeren. De tool is het meest effectief voor het classificeren van audio die door oudere ElevenLabs-TTS-modellen is gegenereerd. De nauwkeurigheid neemt ook af bij analyse van sterk gecomprimeerde of bewerkte spraakinhoud.
Hoe kun je synthetische stemmen op grote schaal detecteren?
Sommige bedrijfsteams moeten deepfakes op grote schaal en bijna realtime kunnen detecteren. Neem bijvoorbeeld het klantenserviceteam van een nationale bank. De medewerkers hebben dagelijks contact met duizenden klanten. Teamleden moeten regelmatig privéaccountgegevens delen en bijwerken.
Het management van dat team vindt het erg belangrijk hoe snel het zowel een frauduleuze beller kan identificeren als legitieme klanten kan helpen. Het heeft een stemdetectiestack nodig die tijdens klantgesprekken live audio van alle belangrijke engines voor stemgeneratie kan herkennen.
Een volledige stemdetectiestack bouwen
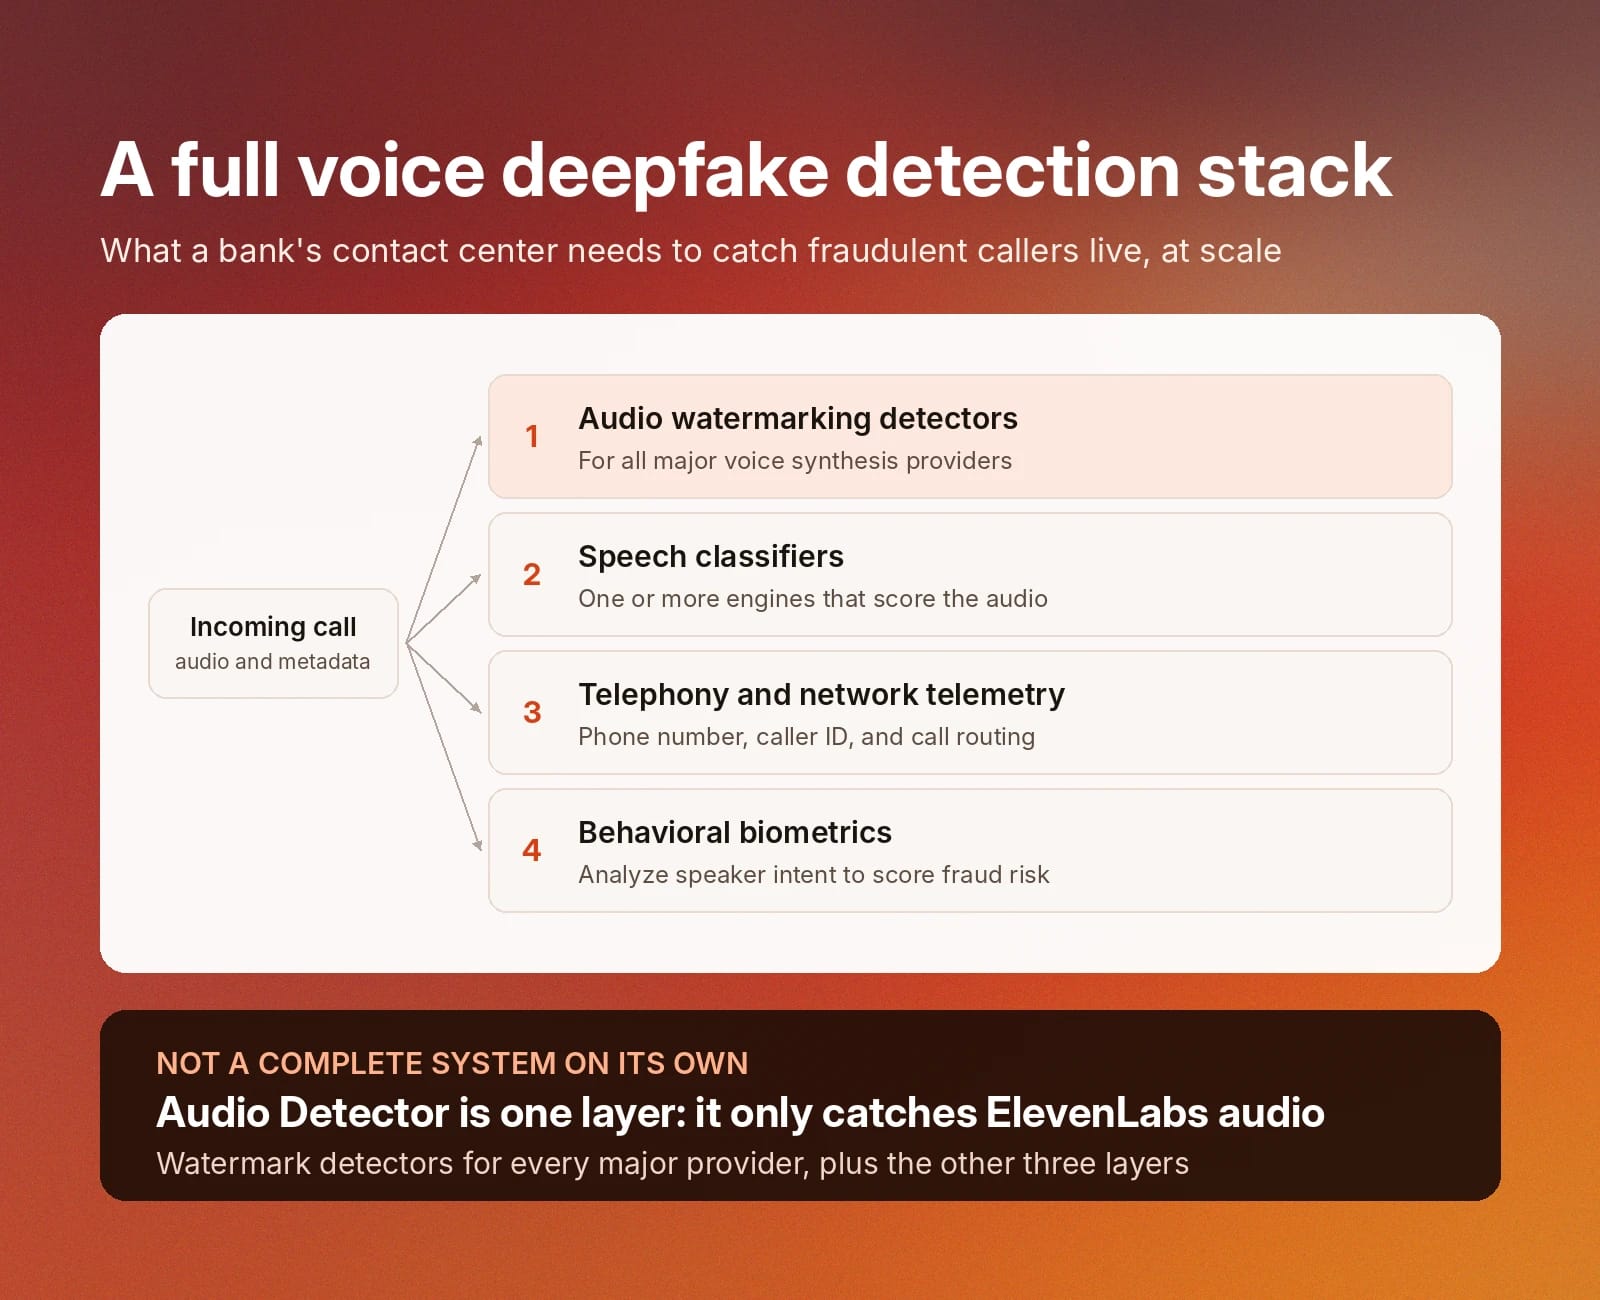
Audio Detector van ElevenLabs speelt hierin een belangrijke rol, maar het is belangrijk om opnieuw te benadrukken dat deze alleen audio met een ElevenLabs-watermerk detecteert. Op zichzelf is dit geen volledig stemdetectiesysteem. Organisaties die volledige mogelijkheden voor stemdetectie willen, moeten verschillende soorten tools samenstellen:
- Audiowatermerkdetectoren: Voor alle belangrijke providers van stemsynthese.
- Spraakclassificatoren: Een of meer classificatie-engines die audiodata kunnen beoordelen.
- Telemetrie voor telefonie en netwerken: Analyses voor callmetadata, zoals telefoonnummer, beller-ID en gespreksroutering.
- Gedragsbiometrie: Software die de intentie van de spreker analyseert om het frauderisico te beoordelen.
Ga aan de slag met deepfakedetectie van ElevenLabs
ElevenLabs zet zich in om een positieve bijdrage te leveren aan het openbare leven, zowel met betekenisvolle diensten voor stemgeneratie als door het publiek de tools te bieden die het nodig heeft om deepfakes en ander kwaadwillig gebruik van door AI gegenereerde audio te herkennen.
Heb je een audiofragment dat je op deepfakes wilt testen? Registreer je om de ElevenLabs Audio Detector te proberen, of ga vandaag aan de slag met de AI Speech Classifier.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.