
Wat is een contextvenster? Wat elke LLM-gebruiker moet weten
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Een contextvenster is de hoeveelheid informatie die een groot taalmodel (LLM) in één request kan verwerken. Gemeten in tokens kan het je prompt, gesprekshistorie, systeeminstructies, opgehaalde documenten, toolresultaten en de door het model gegenereerde reactie bevatten.
Met een groter contextvenster kan een model meer informatie in één request verwerken. Een coding agent die bijvoorbeeld een bug onderzoekt, kan tegelijk relevante bronbestanden, documentatie, testresultaten en recente codewijzigingen gebruiken, in plaats van elk onderdeel afzonderlijk te analyseren en tussen requests nuttige context te verliezen.
Een groter contextvenster staat echter niet gelijk aan perfect geheugen. Langere prompts vereisen meer rekenkracht, verbruiken meer tokens en kunnen het voor een model lastiger maken om vast te stellen welke details er echt toe doen. Onderzoek naar modellen met lange context, waaronder de Lost in the Middle-studie en NVIDIA's RULER-benchmark, heeft herhaaldelijk aangetoond dat modellen minder gebruiken van wat hun ter beschikking staat naarmate de context groeit, vooral wanneer relevante informatie verscholen zit tussen minder bruikbaar materiaal.
In dit artikel leggen we uit hoe contextvensters werken, hoe ze worden gemeten, wat er gebeurt wanneer ze vol raken en hoe ontwikkelaars ze effectief kunnen beheren.
Samenvatting
- Een contextvenster is het totale tokenbudget dat een LLM voor één request gebruikt. Het omvat de gebruikersprompt, gesprekshistorie, opgehaalde content en output.
- Grotere contextvensters maken langere documenten, codebases en gesprekken mogelijk, maar garanderen niet dat het model elk onderdeel goed gebruikt.
- Modellen halen informatie het minst betrouwbaar op uit het midden van lange prompts, een patroon dat is vastgelegd in de Lost in the Middle-studie en de RULER-benchmark.
- Effectief contextbeheer (retrieval, samenvatting, caching) is meestal beter dan simpelweg zo veel mogelijk tokens versturen.
- De beste contextstrategie past bij je daadwerkelijke workload, niet bij het grootste geadverteerde contextvenster.
Wat is een contextvenster in een AI-model?
Een contextvenster is de actieve werkruimte van een model, waar alles wat relevant is voor het huidige request samenkomt voordat het model een reactie genereert.
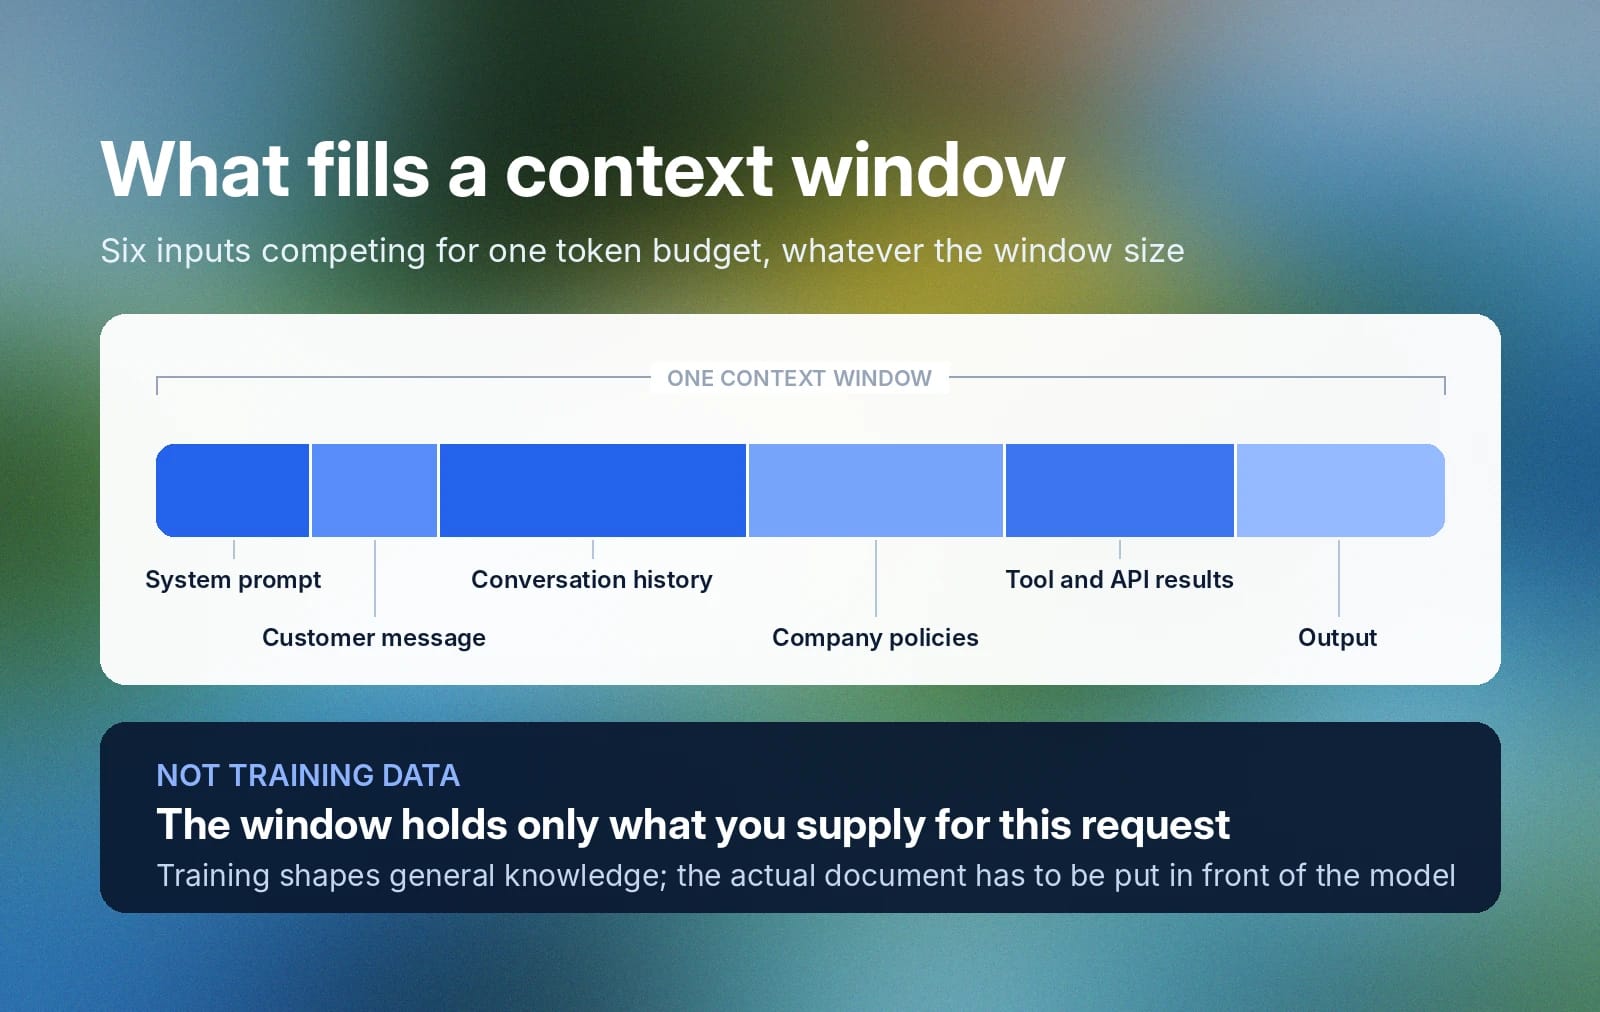
Neem een AI-agent die een klantenservice-gesprek samenvat en een oplossing aanbeveelt. Om dat goed te doen, moet het model het volgende verwerken:
- De systeemprompt
- Het bericht van de klant
- De gesprekshistorie
- Het bedrijfsbeleid
- De tool- en API-resultaten
- De output
Dit alles concurreert om ruimte binnen hetzelfde contextvenster, ongeacht hoe groot dat venster is.
Contextvensters bevatten geen trainingsdata. Training legt informatie permanent vast in de parameters van een model en vormt daarmee wat het model in algemene zin ‘weet’. Een contextvenster bevat daarentegen alleen informatie die voor de huidige taak wordt aangeleverd.
Dit onderscheid is in de praktijk belangrijk: als een applicatie wil dat een model redeneert over een specifiek beleid, klantdossier of technisch document, is die informatie niet beschikbaar alleen omdat het model op soortgelijk materiaal is getraind. De informatie moet doorgaans rechtstreeks via de prompt of via een retrieval- of toolsysteem in de werkcontext van het model terechtkomen, anders redeneert het model op basis van algemene kennis in plaats van het daadwerkelijke document dat voorligt.
Tokenisatie en contextvensters: hoe data wordt verwerkt
Voordat een LLM tekst verwerkt, splitst een tokenizer die op in kleinere eenheden die tokens worden genoemd. Een token kan een volledig woord, een deel van een woord, een leesteken of een ander kort stuk tekst voorstellen.
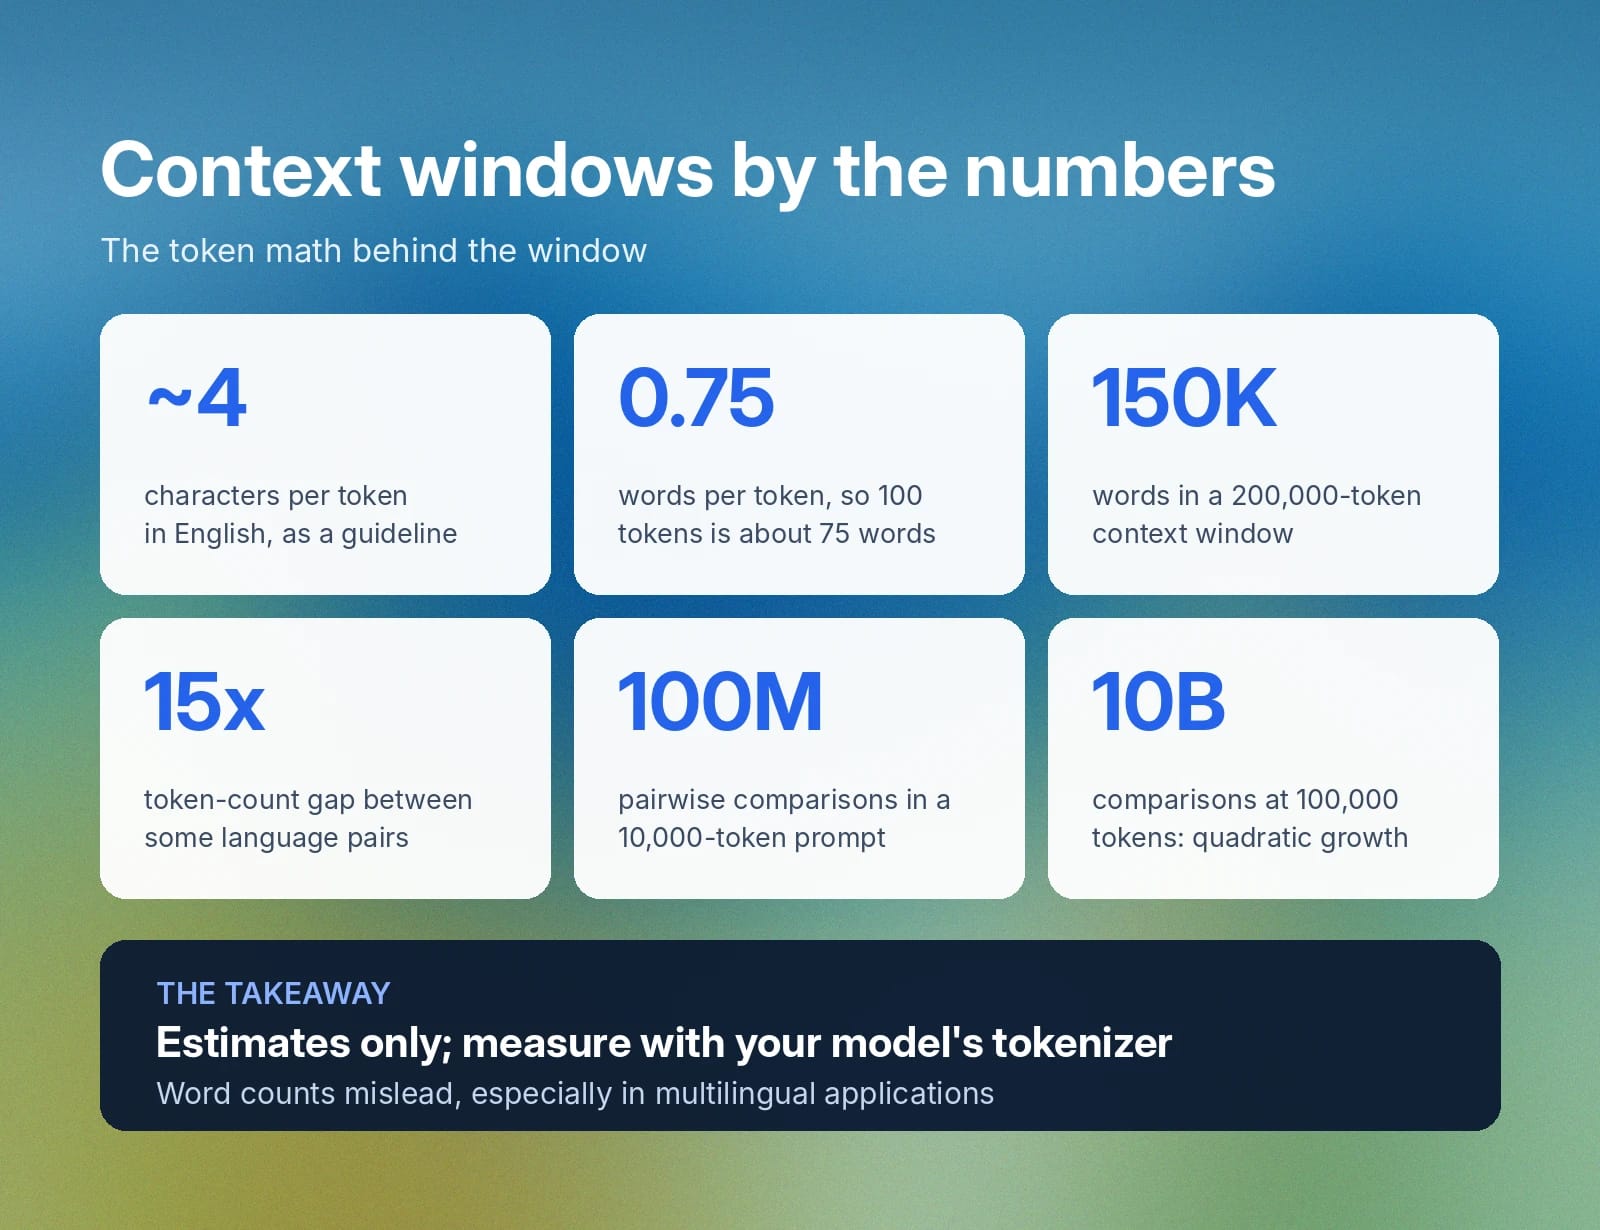
Voor het Engels is een bruikbare richtlijn dat één token ongeveer vier tekens of circa driekwart woord voorstelt. Volgens die schatting komen 100 tokens overeen met ongeveer 75 woorden. Dit is echter slechts een benadering. Neem de zin ‘Contextvensters beïnvloeden de prestaties van applicaties.’ Een tokenizer stelt die niet per se voor als vijf volledige woorden; afhankelijk van de tokenizer kunnen één of meer woorden worden opgesplitst in meerdere subwoordtokens.
Tokenisatie verschilt ook aanzienlijk tussen talen. Twee zinnen met een vergelijkbare betekenis en zichtbare lengte kunnen, afhankelijk van de taal en tokenizer, heel verschillende aantallen tokens verbruiken. Onderzoek naar eerlijkheid van tokenizers heeft aangetoond dat sommige taalparen voor gelijkwaardige tekst tot wel 15 keer verschillen in getokeniseerde lengte, zelfs met tokenizers die zijn ontwikkeld voor meertalige ondersteuning. Ontwikkelaars die meertalige applicaties bouwen, moeten het tokengebruik meten met de daadwerkelijke tokenizer van hun model in plaats van het op basis van woordaantallen te schatten.
Een contextvenster van 200.000 tokens klinkt misschien enorm, maar een applicatie die voortdurend gesprekshistorie, opgehaalde documentatie, toolreacties en systeeminstructies toevoegt, kan die limiet sneller naderen dan verwacht. Daarom monitoren productieapplicaties vaak het tokengebruik en gebruiken ze technieken zoals samenvatting, het opschonen van historie, retrievalfiltering en promptcompressie om de meest relevante informatie binnen de actieve context te houden.
Hoe werkt een contextvenster in taalmodellen?
Een contextvenster werkt via het attentionmechanisme van de transformerarchitectuur, dat berekent hoe elk token in een invoer zich tot elk ander token verhoudt voordat het model een reactie produceert.
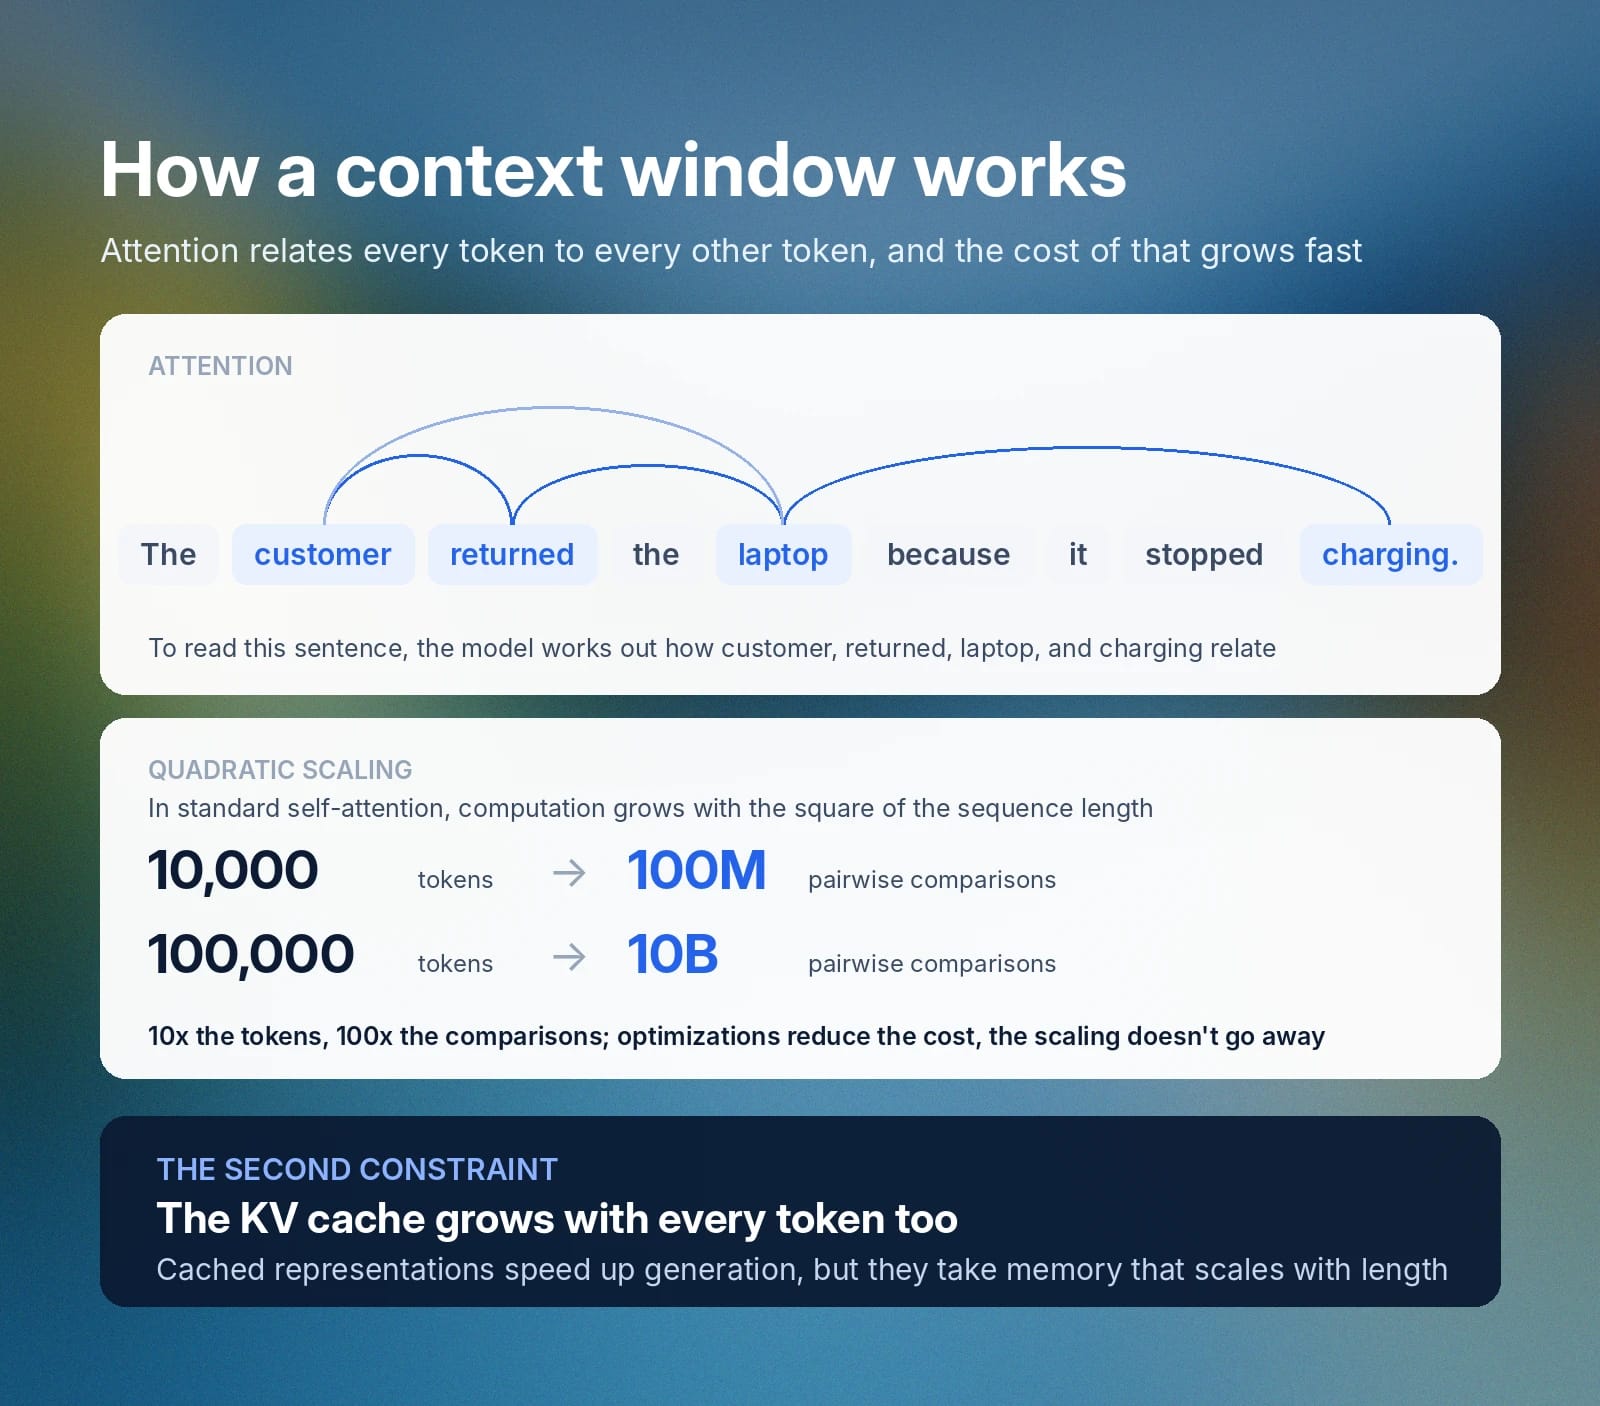
Neem de zin ‘De klant bracht de laptop terug omdat deze niet meer oplaadde.’ Om die juist te interpreteren, moet het model bepalen hoe klant, laptop, terugbracht en opladen zich tot elkaar verhouden. Naarmate een reeks langer wordt, groeit het aantal van deze relaties snel.
Bij standaard self-attention groeit de benodigde berekening ongeveer met het kwadraat van de reekslengte. Een prompt van 10.000 tokens vereist bijvoorbeeld ongeveer 100 miljoen paarsgewijze vergelijkingen, terwijl een prompt van 100.000 tokens er ongeveer 10 miljard vereist. Moderne modellen gebruiken allerlei optimalisaties in architectuur en infrastructuur om die kosten in de praktijk te verlagen, maar het onderliggende schaalbaarheidsprobleem verdwijnt niet.
Lange gesprekken voegen een tweede beperking toe: de key-valuecache, of KV-cache. Tijdens het genereren behouden modellen tussentijdse representaties van eerdere tokens, in plaats van ze voor elk nieuw token opnieuw te berekenen. Dat versnelt inferentie aanzienlijk. De cache zelf neemt echter geheugen in beslag en groeit naarmate de reeks langer wordt.
Maximale contextlengte in AI-modellen en waarom die belangrijk is
De maximale contextlengte van een model bepaalt hoeveel informatie het in één request kan accepteren en verwerken. Of het model een groot contextvenster effectief gebruikt, is echter een afzonderlijke vraag.
Langere contextvensters maken use cases mogelijk die met eerdere LLM's moeilijk of onpraktisch waren. Ontwikkelaars kunnen een model een volledige coderepository, een uitgebreid juridisch document, een onderzoeksartikel, een vergadertranscript, of een omvangrijke gesprekshistorie geven zonder het materiaal eerst terug te brengen tot enkele duizenden tokens.
Dit is belangrijk omdat het behouden van meer van de oorspronkelijke context het vermogen van het model kan verbeteren om vragen nauwkeurig te beantwoorden, verbanden tussen ver uit elkaar liggende stukken informatie te herkennen en taken uit te voeren die afhankelijk zijn van het document als geheel. Een coding assistant moet bijvoorbeeld mogelijk meerdere bestanden onderzoeken om te begrijpen hoe een functie wordt aangeroepen, terwijl een assistent voor juridische documenten definities in een sectie mogelijk moet vergelijken met verplichtingen die veel later in het document worden beschreven.
Een groter contextvenster levert echter niet automatisch betere resultaten op. Zeer lange invoer kan de kosten en latentie verhogen, en modellen kunnen minder aandacht besteden aan informatie die in het midden van een grote context verborgen zit. Ontwikkelaars moeten relevante informatie daarom selectief opnemen, lange invoer duidelijk structureren en waar passend technieken zoals retrieval, samenvatting en het opschonen van context gebruiken.
Contextvenstergroottes per model vergelijken
Contextvensters verschillen sterk tussen de belangrijkste modelfamilies van nu, van enkele honderdduizenden tokens tot 10 miljoen. Zo vergelijken de huidige vlaggenschipmodellen zich:
Model
Contextvenster
Opmerkingen
10 miljoen tokens
Meta's model met open weights; op het moment van schrijven het grootste publiek beschikbare venster
1 miljoen tokens
Google's huidige model op Pro-niveau voor analyse van lange documenten en meerdere bestanden
1 miljoen tokens
Anthropic's huidige model op Sonnet-niveau; het venster geldt standaard voor de hele Claude API
Geadverteerde limieten veranderen snel wanneer aanbieders nieuwe modellen uitbrengen en hun grenzen verhogen. Beschouw een tabel als deze dus als een momentopname, niet als een permanente rangschikking. Contextgrootte is bovendien slechts één factor bij het kiezen van een model. Op zichzelf zegt die niets over redeneerkracht, outputlimieten, latentie of kosten.
Gevolgen van een klein versus groot contextvenster
Een klein contextvenster dwingt ontwikkelaars om selectief te zijn. Lange documenten worden opgeknipt, oudere gesprekshistorie wordt samengevat en externe kennis wordt alleen opgehaald wanneer die daadwerkelijk nodig is.
Een groot contextvenster neemt enkele van die beperkingen weg. Je kunt meer voorbeelden aanleveren, meer gesprekshistorie behouden of een grotere verzameling documenten analyseren zonder alles eerst op te splitsen.
Een groter venster brengt echter een ander probleem met zich mee: verdunning van aandacht. Wanneer een prompt veel informatie bevat, kan het model moeite hebben om te bepalen welke details het meest relevant zijn voor het huidige request. Belangrijke instructies of bewijsmateriaal kunnen begraven raken tussen minder relevante content, waardoor het risico op onvolledige, inconsistente of minder nauwkeurige reacties toeneemt.
Waarom modellen de draad kwijtraken in het midden
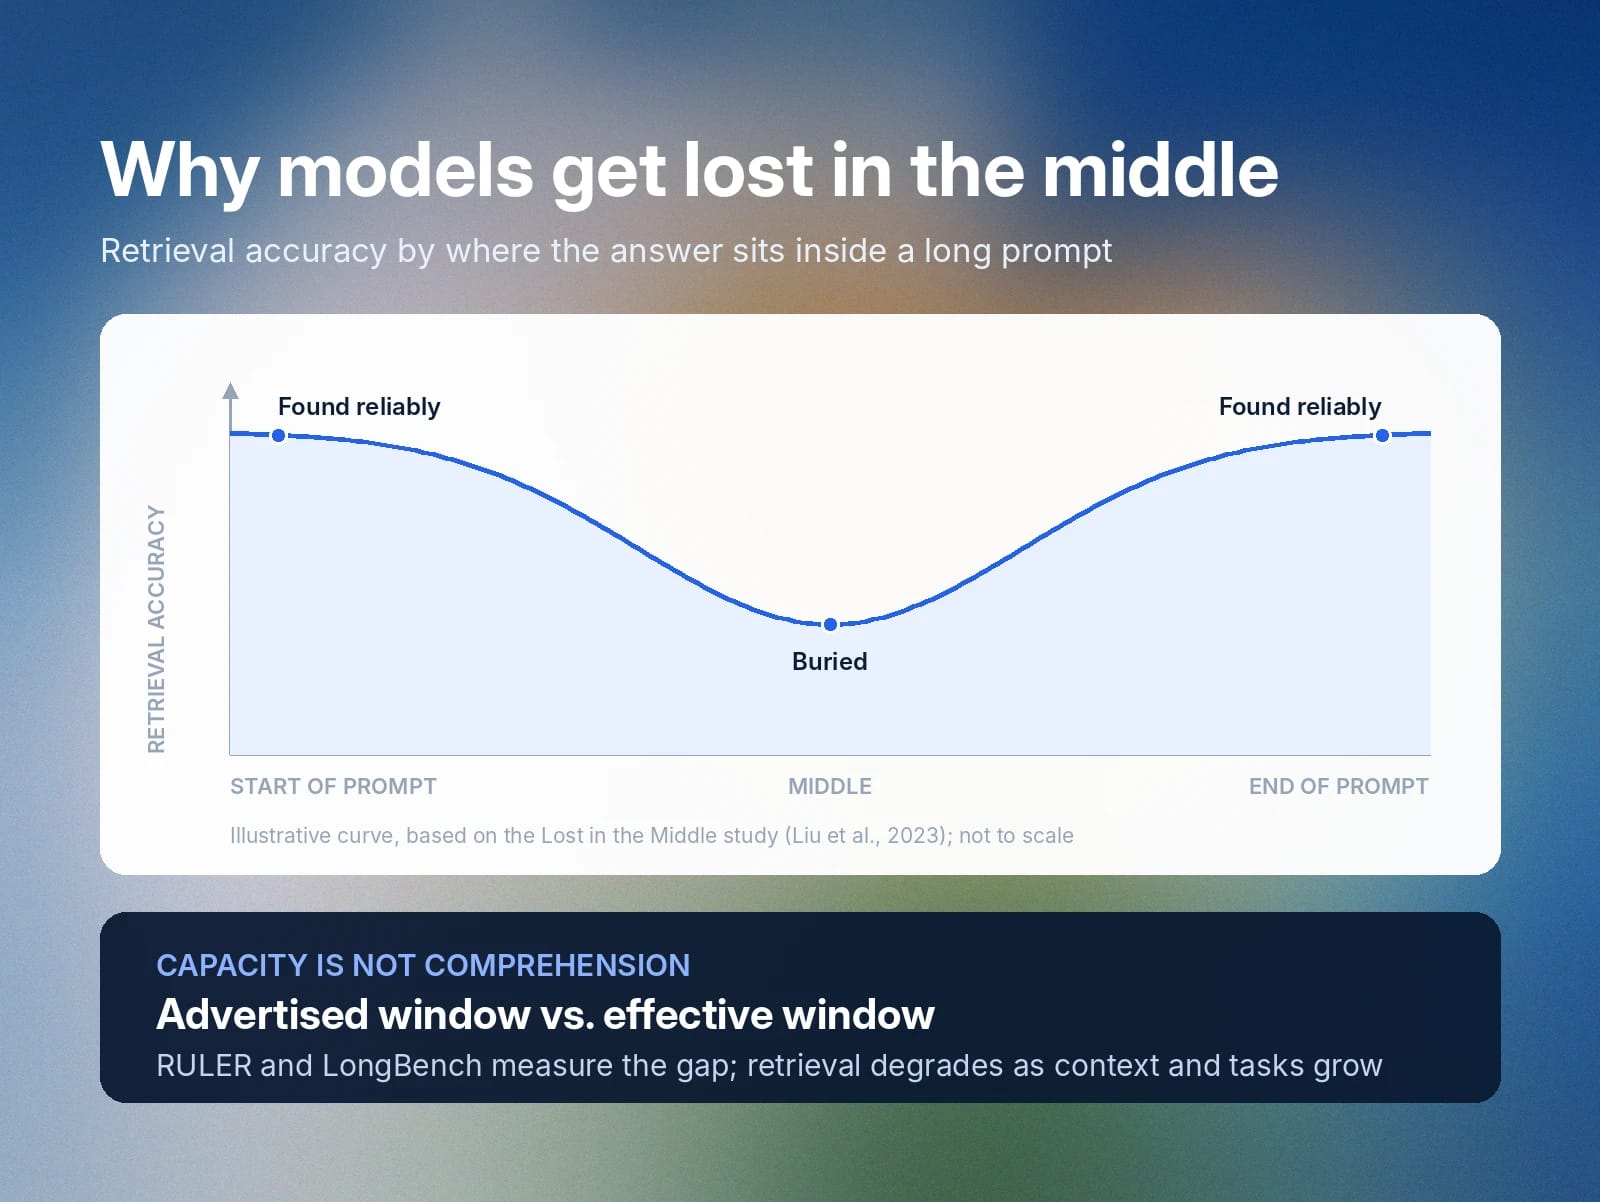
Modellen halen informatie doorgaans het best op wanneer die zich aan het begin of eind van een lange prompt bevindt, en het slechtst wanneer die in het midden verborgen zit. De invloedrijke Lost in the Middle-studie testte dit rechtstreeks door het antwoord op een vraag op verschillende posities binnen een lange prompt te plaatsen en te meten hoe vaak modellen het vonden. De nauwkeurigheid was consequent het hoogst aan het begin en eind van de context en het laagst in het midden.
Dat betekent dat een model technisch gezien een document kan accepteren zonder elk onderdeel betrouwbaar te gebruiken. Stuur een LLM 100 supportdocumenten omdat één daarvan het antwoord bevat op de vraag van een klant, dan kan een groter contextvenster ervoor zorgen dat ze alle 100 passen. Maar het model moet nog steeds één relevante passage uit 99 irrelevante passages halen, en een langer venster garandeert niet dat dit lukt.
Het is dus de moeite waard om onderscheid te maken tussen het geadverteerde contextvenster van een model en het effectieve contextvenster voor een bepaalde workload. Benchmarks zoals RULER en LongBench proberen die kloof te meten. RULER stelde vast dat modellen die bijna perfect scoorden op eenvoudige retrievaltests alsnog minder goed presteerden naarmate de contextlengte en taakcomplexiteit toenamen. LongBench evalueert bredere taken, waaronder het beantwoorden van vragen over documenten, redeneren over meerdere documenten, samenvatten, few-shot learning en codeaanvulling.
Lange context biedt nog steeds echte meerwaarde. Capaciteit en begrip zijn simpelweg verschillende eigenschappen, en beide zijn belangrijk bij het kiezen van een model voor een bepaalde taak.
Contextlimieten beheren: best practices voor ontwikkelaars
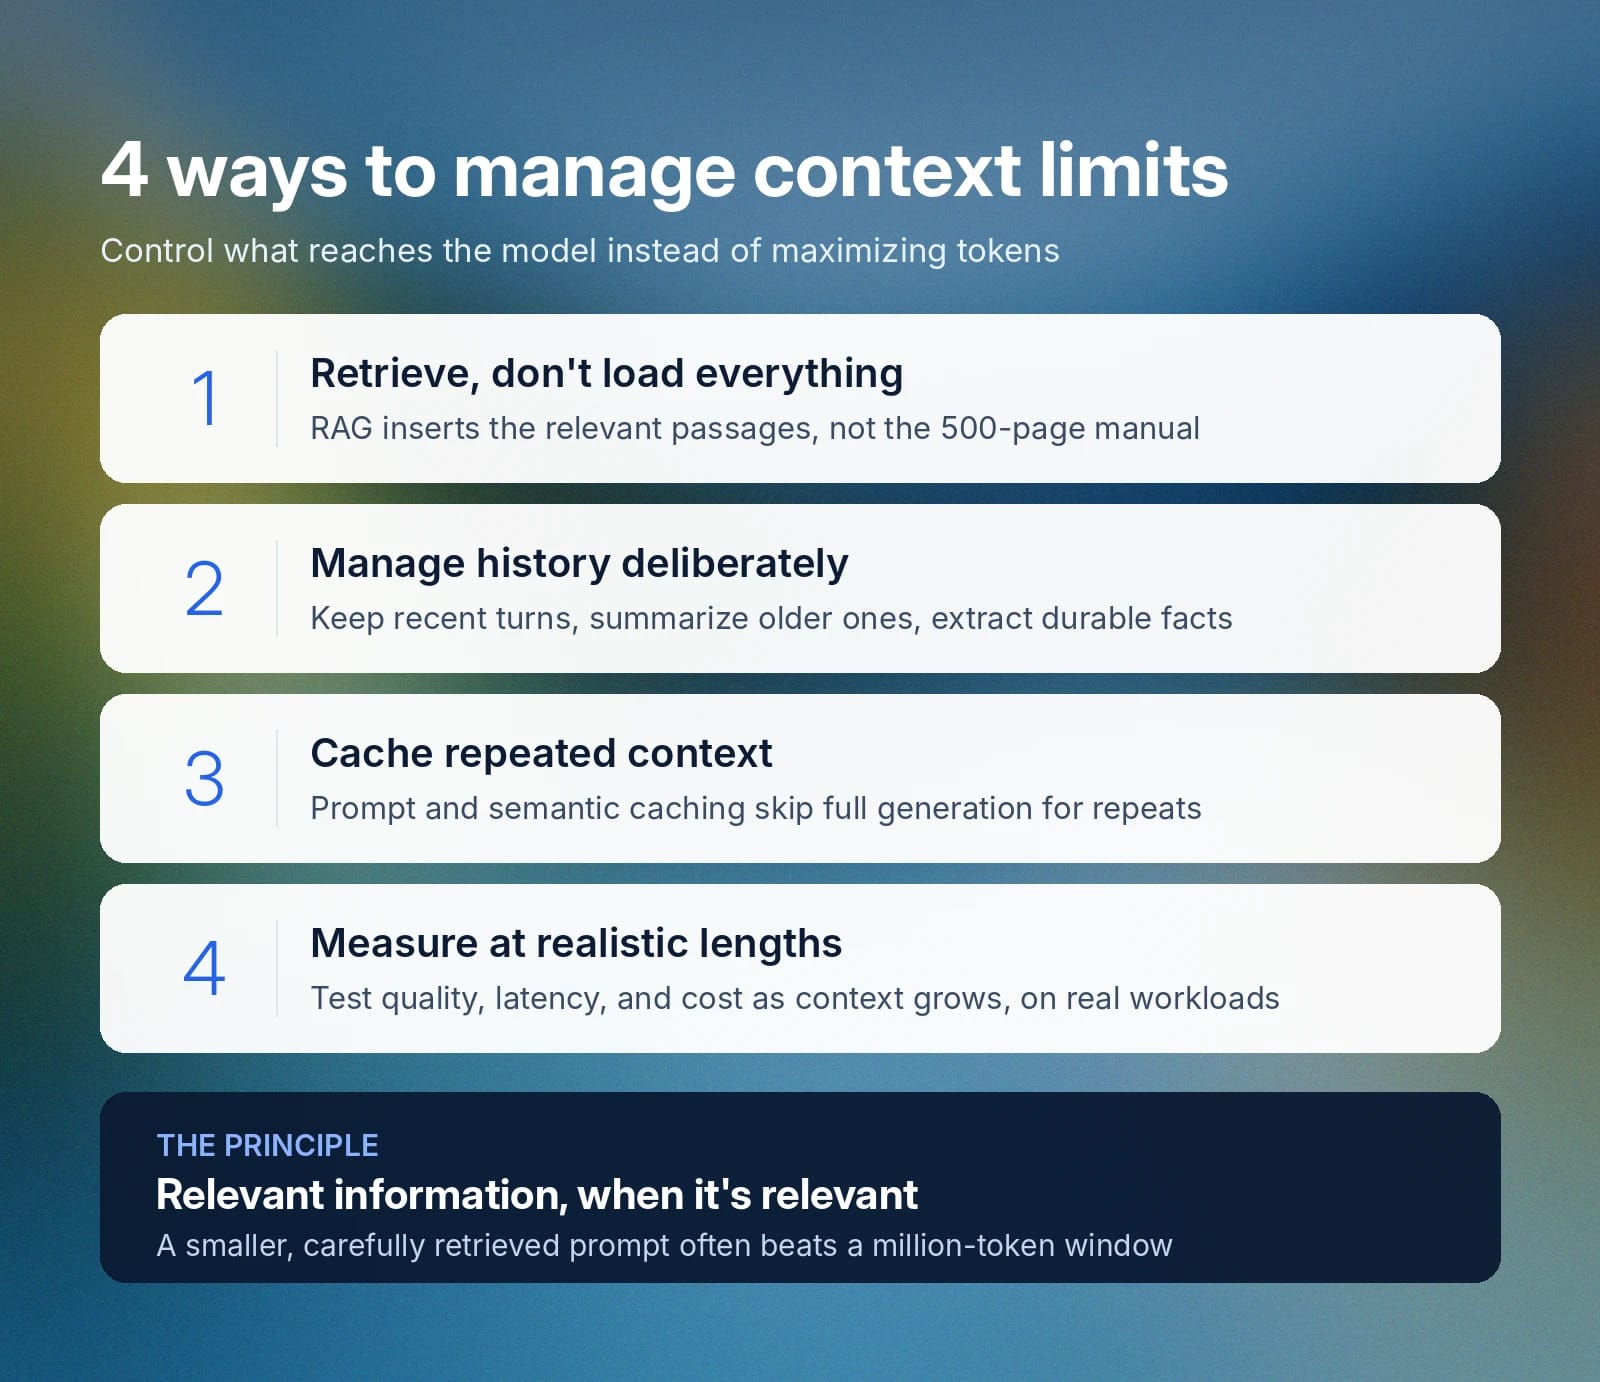
Goed contextbeheer betekent dat je bepaalt wat het model bereikt: de informatie aanleveren die relevant is voor de taak op het moment dat die relevant is, in plaats van te proberen het aantal tokens in elk request te maximaliseren. De volgende werkwijzen kunnen ontwikkelaars helpen om onnodige context te verminderen, de kwaliteit van reacties te verbeteren en kosten en latentie te beheersen.
1. Haal relevante informatie op in plaats van alles te laden
Met retrieval-augmented generation, of RAG, kan een applicatie een externe kennisbank doorzoeken en alleen relevante passages in de context van het model invoegen. In plaats van een volledige handleiding van 500 pagina's in elk supportrequest op te nemen, haalt de applicatie de paar passages op die het dichtst bij de daadwerkelijke vraag van de klant liggen.
Dat verlaagt het tokengebruik en geeft het model een veel duidelijker signaal over wat belangrijk is. De kwaliteit van retrieval blijft tellen: productie-RAG-systemen verbeteren resultaten doorgaans door documenten zorgvuldig op te delen, meerdere kandidaatpassages op te halen, die kandidaten opnieuw te rangschikken en alles wat irrelevant is weg te filteren voordat de uiteindelijke prompt wordt opgebouwd. ElevenLabs heeft bijvoorbeeld zijn RAG-pipeline opnieuw opgebouwd om query rewriting en parallelle modelcalls toe te voegen, waardoor de mediane retrievallatentie halveerde.
2. Beheer gesprekshistorie bewust
Conversatieapplicaties verzamelen snel context. Elk eerder bericht onbeperkt blijven toevoegen verspilt tokens en kan irrelevante details meenemen naar latere beurten.
Applicaties pakken dit aan door de recentste beurten te bewaren, oudere uitwisselingen samen te vatten, blijvende feiten in gestructureerd geheugen vast te leggen en oudere details alleen op te halen wanneer ze weer relevant worden. Zo ontstaat een nuttig onderscheid tussen kortetermijncontext voor het gesprek, die het model direct nodig heeft, en applicatiegeheugen voor de langere termijn, dat later weer kan worden opgehaald.
3. Gebruik caching wanneer context zich herhaalt
Veel applicaties sturen herhaaldelijk dezelfde uitgebreide instructies, of beantwoorden vragen die semantisch vergelijkbaar zijn met vragen die ze al hebben verwerkt. Caching vermindert die overhead.
Met prompt- of contextcaching kan herhaalde invoer efficiënter worden hergebruikt, en semantische caching gaat nog een stap verder door te herkennen wanneer een nieuwe vraag ongeveer hetzelfde betekent als een vraag die het systeem al heeft beantwoord. ‘Wat is jullie retourbeleid?’ en ‘Hoe lang heb ik om een artikel terug te sturen?’ zijn verschillende tekenreeksen die een semantische cache als dezelfde vraag kan behandelen. Daardoor is een volledige generatiecall niet nodig en dalen zowel de latentie als de tokenkosten.
4. Meet prestaties bij realistische contextlengtes
Kies geen contextstrategie uitsluitend op basis van de geadverteerde tokenlimiet van een modelaanbieder. Test representatieve productieworkloads en meet de kwaliteit van reacties, retrievalnauwkeurigheid, latentie, tokengebruik, kosten en foutpercentages naarmate de contextlengte toeneemt.
Vergelijk strategieën zoals meer context aanleveren, minder passages ophalen, gesprekshistorie samenvatten of retrieval combineren met samenvatting. Een model met een contextvenster van één miljoen tokens kan je applicatie technisch ondersteunen, terwijl een kleinere, zorgvuldig opgehaalde prompt snellere en nauwkeurigere resultaten oplevert tegen lagere kosten.
Ga aan de slag met ElevenAgents voor schaalbare taaloplossingen
Contextbeheer is het belangrijkst voor conversatieagents, die de huidige uiting moeten combineren met eerdere beurten, bedrijfsinstructies, klantinformatie, content uit de kennisbank en toolresultaten, terwijl ze snel genoeg moeten reageren om het gesprek natuurlijk te laten aanvoelen.
ElevenAgents brengt deze onderdelen samen in één platform voor het bouwen en implementeren van AI-spraakagents. De orchestratie-engine coördineert spraakherkenning, een LLM en Text to Speech, terwijl ontwikkelaars prompts, kennisbanken, tools, workflows en het onderliggende taalmodel configureren. Expressieve overdracht, waaronder de manier waarop een agent emotionele context in spraak overbrengt, is afhankelijk van dezelfde context die in de eerste plaats bepaalt wat de agent zegt.
Specifiek voor kennisbeheer ondersteunt ElevenAgents zowel documenten met volledige context als RAG, rechtstreeks te configureren op het platform. Kleine documenten gaan rechtstreeks in de prompt van een agent, zodat hun content gedurende het hele gesprek beschikbaar blijft. Grotere kennisbanken worden in plaats daarvan geïndexeerd, waarbij RAG voor elke query de relevante passages ophaalt in plaats van alles tegelijk in het contextvenster te laden.
Ga aan de slag door je vandaag voor ElevenAgents te registreren of met ons team te praten voor meer informatie over je implementatieopties.
Veelgestelde vragen over contextvensters

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


