Een API voor vergadertranscriptie gebruiken: realtime en batch met Scribe v2
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
Handmatig vergadernotities maken is tijdrovend en foutgevoelig, vooral als een vergadering langer dan een uur duurt. Dit kost tijd en leidt deelnemers af van de discussie. Zelfs met een audio-opname is het lastig om specifieke gesprekken aan afzonderlijke sprekers te koppelen.
Met een API voor vergadertranscriptie zet je live of opgenomen vergaderingen in je product om in tekst met tijdstempels en sprekerlabels. Je stuurt audio in en ontvangt een gestructureerd transcript terug, zonder zelf een spraakmodel te hoeven bouwen.
In dit artikel wordt uitgelegd hoe een API voor vergadertranscriptie werkt, worden realtime- en batchtranscriptie vergeleken en zie je hoe je bouwt met Eleven Scribe v2 en Eleven Scribe v2 Realtime.
Samenvatting
- Een API voor vergadertranscriptie zet vergaderaudio om in transcripten met tijdstempels en sprekerlabels.
- Realtimetranscriptie biedt ondertiteling met lage latentie tijdens vergaderingen, terwijl batchtranscriptie audio-opnames verwerkt nadat de vergadering is afgelopen.
- De nauwkeurigheid van vergadertranscriptie hangt af van de audiokwaliteit, stempatronen van sprekers en het onderliggende spraakmodel.
- ElevenLabs biedt de modellen Scribe v2 en Scribe v2 Realtime, waarmee engineeringteams zeer nauwkeurige producten voor vergadertranscriptie kunnen bouwen.
Wat een API voor vergadertranscriptie doet en wie er een nodig heeft
Een API voor vergadertranscriptie gebruikt vergaderaudio als invoer en geeft tekst terug. De API verwerkt spraakherkenning, sprekerdiarisatie en tijdstempels, zodat je een compleet pakket hebt om mee te werken. Vergeleken met handmatig notities maken biedt speech to text voor vergaderingen deelnemers een doorzoekbaar verslag dat ze later kunnen raadplegen.
Nu steeds meer teams AI-agents inzetten, worden geschreven vergaderverslagen doorzoekbare context. Een interne agent doorzoekt transcripten op details en brengt informatie naar boven die datasilo's vermindert en de toegang tot informatie tussen teams verbetert.
Veel commerciële tools bieden transcriptie, maar voldoen mogelijk niet volledig aan de vereisten van een organisatie.
Voor productengineeringteams is het soms beter haalbaar om een STT-app voor vergaderingen te bouwen of deze mogelijkheid aan een bestaande tool toe te voegen. Met eigen software voor vergadertranscriptie heb je controle over het volgende:
- Privacy: ElevenLabs biedt Zero Retention Mode voor enterprisegebruikers en voldoet daarmee beter aan privacyvereisten in bepaalde regio's.
- Aangepaste woordenlijst: Je geeft het model aanvullende context, zodat het termen die specifiek zijn voor je bedrijf, product en branche kan begrijpen en transcriberen.
- Aangepaste workflow: In plaats van beperkt te zijn tot leveranciersspecifieke workflows, bouw je een tool voor vergadertranscriptie die verbinding maakt met je interne database, CRM en bedrijfssoftware.
ElevenLabs biedt toonaangevende spraak- en audiomodellen die je helpen een app voor vergadertranscriptie te bouwen. Met onze API voor vergadertranscriptie kun je nauwkeurig vastleggen wat er in een vergadering wordt gezegd in tekstuele notities. Onze modellen ondersteunen meer dan 90 talen, zodat je Engels, Frans, Mandarijn en tientallen andere talen kunt transcriberen.

Realtime of batch speech to text voor vergaderingen: hoe kies je
Realtimetranscriptie legt audiostreams vast terwijl er wordt gesproken en zet ze om in live ondertiteling. Je gebruikt realtimetranscriptie om tijdens de vergadering tekstuele ondersteuning te bieden of om tijdens een sessie acties te activeren met een live bot. Batchtranscripties verwerken daarentegen de volledige opname na een vergadering en leveren een beknopter en gestructureerd transcript. Batchtranscriptie helpt bij het maken van notities na de vergadering, administratie en het bijhouden van controleerbare gegevens.
Het is belangrijk om de technische gevolgen en kosten te begrijpen wanneer je kiest tussen realtime- en batch-spraak-naar-teksttranscriptie.
Hieronder zie je in één oogopslag hoe beide methoden zich vergelijken.
Kenmerken
Realtimetranscriptie
Batchtranscriptie
Technische werking
Legt audiostreams live vast terwijl er wordt gesproken. Vereist een actieve verbinding met het spraakmodel.
Verwerkt de volledige audio-opname na een vergadering. Kan asynchroon werken.
Nauwkeurigheid
Standaard. Verwerkt audio direct, zonder volledige context.
Hoger. Heeft voldoende tijd om de volledige gesprekscontext te analyseren.
Gebruiksscenario's
Live ondertiteling tijdens vergaderingen, vergaderbot.
Notities na de vergadering, administratie.
Kosten
Hoger, omdat een blijvende verbinding nodig is.
Lager dankzij efficiënte bulkverwerking.
Uiteindelijk hangt je keuze af van je prioriteiten. Als je een live vergaderassistent bouwt, moet je in realtime transcriberen. Anders gebruik je batchtranscriptie, dat voordelen biedt op het gebied van kosten en nauwkeurigheid.
Een API voor vergadertranscriptie instellen met Scribe v2
ElevenLabs Speech to Text laat je vergaderingen transcriberen met Scribe v2 Realtime en Scribe v2. Beide spraakmodellen zijn getraind om sprekers nauwkeurig te labelen bij uiteenlopende accenten, dialecten en audiokwaliteit. Met Scribe v2 Realtime kun je live spraak direct transcriberen, terwijl Scribe v2 audio-opnames omzet in zeer nauwkeurige transcripten.
Je hebt toegang tot beide modellen via de API die we bieden. Hieronder bekijken we elk model in detail, met aandacht voor belangrijke functies, API-architectuur en manieren om het met je transcriptieoplossing te integreren.
Optie 1: Realtime- (live)transcriptie
Met realtimetranscriptie kun je gesprekken tijdens een vergadering verwerken en omzetten in tekst terwijl sprekers praten. Er zijn weinig tot geen merkbare onderbrekingen tussen de hoorbare en getranscribeerde spraak.
Om in realtime te transcriberen, gebruik je het model Scribe v2 Realtime, dat een lage latentie van 150 ms tussen audio-invoer en tekstuitvoer bereikt (bijna directe gedeeltelijke transcripten). Dit betekent dat je ondertiteling zonder onderbrekingen hebt wanneer je het model in je transcriptie-app integreert.
Scribe v2 Realtime is ontworpen voor live gesprekken en past bij gebruiksscenario's die live ondertiteling, realtime vergadernotities of het doorsturen van live tekst naar een AI-assistent voor vervolgacties vereisen. Daarnaast ondersteunt het model maximaal 50 sleuteltermen voor prompting.
Transcriberen met Scribe v2 Realtime
Verbind je product voor live transcriptie met Scribe v2 Realtime via ElevenAPI.
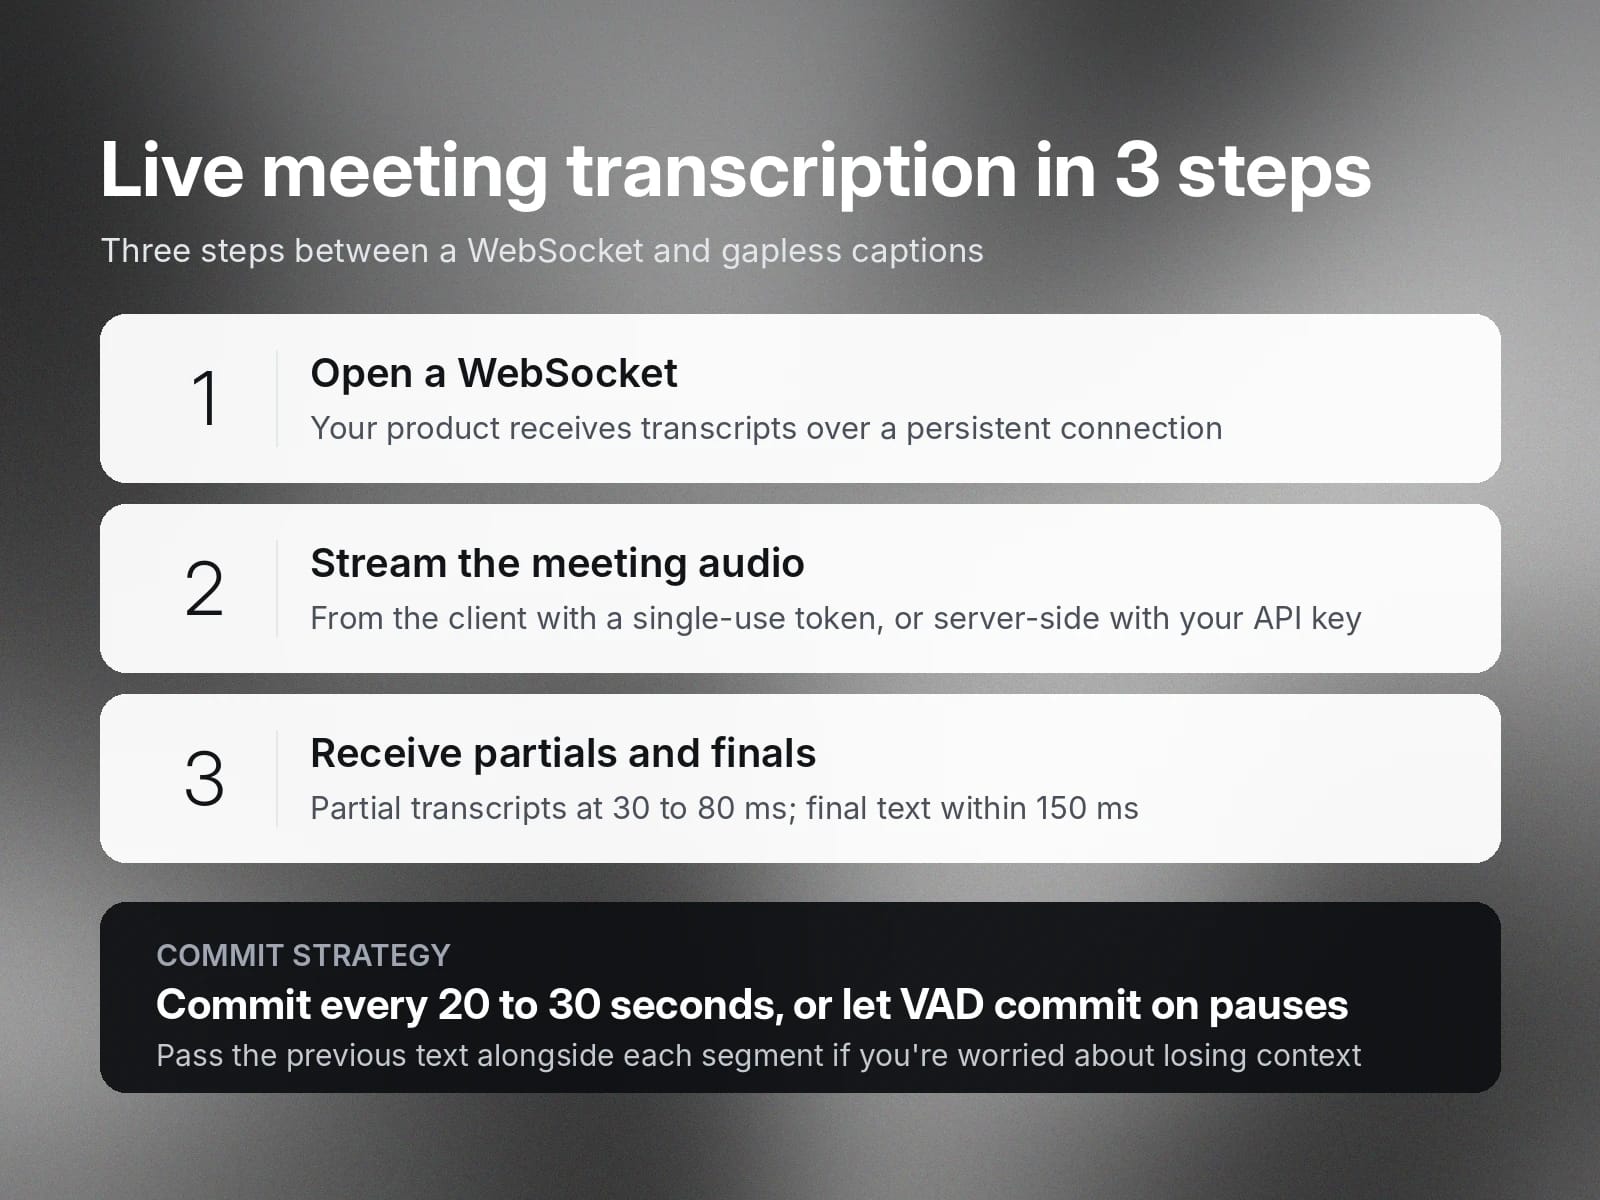
- Open eerst een WebSocket zodat je product transcripten van het model Scribe v2 Realtime kan ontvangen.
- Stuur vervolgens streams met live gesprekken uit vergaderingen naar het model.
- Ontvang ten slotte gedeeltelijke en definitieve transcripten binnen 150 ms.
In je code maak je handlers voor API-events die tijdens het volledige transcriptieproces plaatsvinden. Je code verwerkt bijvoorbeeld events bij het versturen van audiogegevens en het ontvangen van een vastgelegd transcript.
Methoden voor live streaming met Scribe v2 Realtime
Het onderstaande voorbeeld maakt een token voor eenmalig gebruik op je backend. Je client kan vergaderaudio naar de API voor vergadertranscriptie streamen zonder je API-sleutel bloot te geven.
Afhankelijk van de architectuur van je app kun je live gesprekken met Scribe v2 Realtime streamen vanuit de client-app of backendserver.
- Client-side streaming: Met deze methode stuur je de audio-invoer rechtstreeks vanaf de microfoon of via handmatige chunking naar het audiomodel. Om verbinding te maken met de API, valideer je met een token voor eenmalig gebruik, zodat je API-sleutel niet wordt blootgegeven.
- Server-side streaming: Met deze methode kun je audio rechtstreeks streamen vanaf een URL, uit bestandsuploads of uit een audiostream. Je gebruikt je ElevenLabs API-sleutel in plaats van een token voor eenmalig gebruik.
Een commitstrategie kiezen voor Scribe v2 Realtime
Het onderstaande voorbeeld configureert voice activity detection. De API commit een transcriptsegment telkens wanneer een spreker pauzeert.
Het definitieve transcript levert bewijsstukken die nauwkeurig vastleggen wat er in de vergadering wordt gezegd. Er zijn twee manieren om de definitieve transcripten te committen: handmatig of met Voice Activity Detection (VAD).
- Handmatige commit: Standaard moet je het transcriptsegment handmatig in je code committen. Voor optimale latentie raden we aan elke 20 tot 30 seconden te committen. Als je bang bent context te verliezen, kun je de voorgaande tekst samen met het te verwerken audiosegment versturen.
- Voice Activity Detection: Je kunt ook VAD gebruiken, dat stiltes in de audiostream detecteert om transcriptie te starten.
Optie 2: Batchtranscriptie (na de vergadering)
Batchtranscriptie is een effectieve manier om uren aan vergaderopnames om te zetten in tekst. Het levert beknopte, contextueel relevante en gesprekerdiariseerde transcripten op schaal.
Scribe v2 is een ElevenLabs-spraak-naar-tekstmodel dat dynamische audiotagging ondersteunt. Je kunt nauwkeurig gespreksgegevens extraheren, samen met niet-spraakgebeurtenissen, zoals lachen en voetstappen.
In tegenstelling tot realtimetranscriptie is Scribe v2 gebouwd voor vergadernotities na de opname. Je neemt bijvoorbeeld vergaderingen op via platforms als Zoom, Teams en Google Meet. Vervolgens upload je de audiobestanden na de sessie naar Scribe v2 voor batchtranscriptie.

Batch transcriberen met Scribe v2
Transcriberen met Scribe v2 gebeurt asynchroon via een REST API. Je hoeft geen actieve verbinding met het spraakmodel te onderhouden. In plaats daarvan gebruik je een webhook om een melding te krijgen wanneer het transcript klaar is.
Hieronder staat de logische flow die audio-opnames omzet in een transcript.
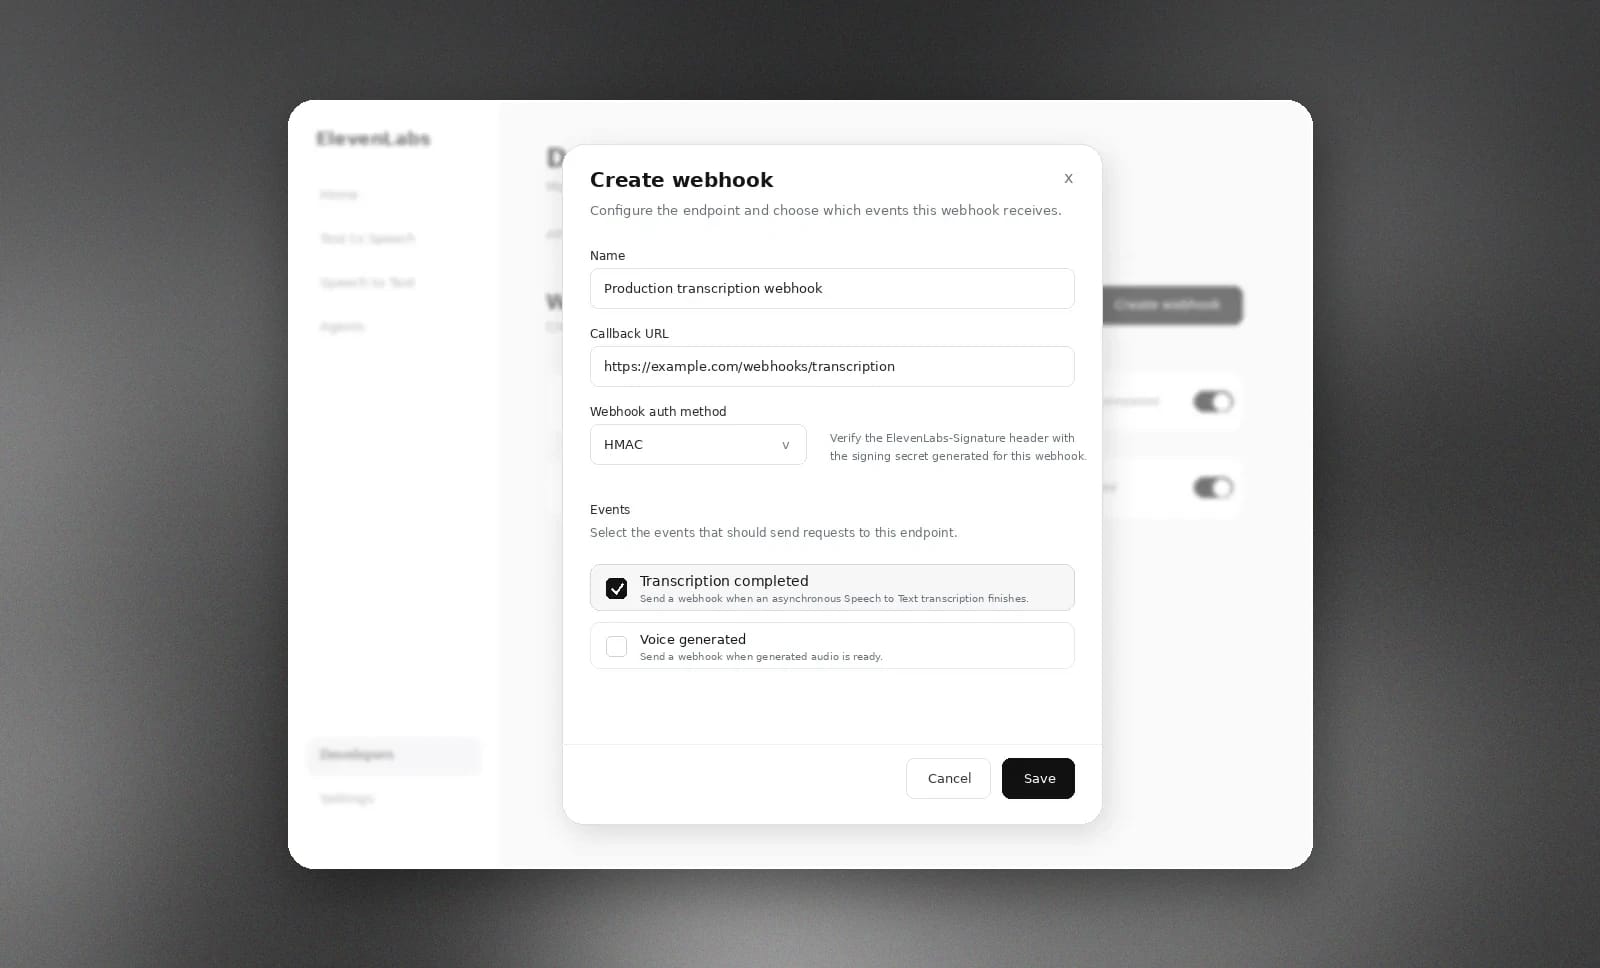
- Maak eerst een WebHook op het ElevenLabs-dashboard om de transcriptieresultaten te ontvangen.
- Maak vervolgens event handlers in je code om de teruggestuurde transcriptie te verwerken.
- Upload daarna audiobestanden naar het Scribe v2 REST-endpoint.
Zodra de transcriptie is voltooid, wordt de event handler aangeroepen die je hebt geconfigureerd.
Keyword prompting voor Scribe v2
Scribe v2 (batch) ondersteunt maximaal 1.000 termen voor keyword prompting. Wanneer je een audiobestand voor transcriptie verstuurt, kun je de termen in de API-aanroep opnemen. Anders dan bij een woordenlijst vergelijkt Scribe v2 de sleuteltermen met de context van het gesprek om de juiste transcriptie te bepalen.
Zo kan het model extra aandacht besteden wanneer iemand specifieke termen uitspreekt en ze nauwkeurig transcriberen.
In het onderstaande voorbeeld worden bedrijfs- en producttermen met de aanvraag meegestuurd, zodat de API ze in de juiste context transcribeert.
Zo transcribeert het bijvoorbeeld 'ElevenLabs' wanneer je het woord in de context van een merk of bedrijf uitspreekt.
Multichanneltranscriptie voor Scribe v2
Multichanneltranscriptie laat het model Scribe v2 afzonderlijke kanalen in een audiobestand met spraak van verschillende sprekers transcriberen. Deze functie is handig als je een transcriptietool voor conferenties, rechtbankopnames of podcasts bouwt.
Elk kanaal krijgt een unieke identifier die een spreker vertegenwoordigt.
Veelvoorkomende uitdagingen bij vergadertranscriptie en hoe de API ermee omgaat
Bij het transcriberen van vergaderingen krijgen engineeringteams vaak te maken met verschillende uitdagingen.

Overlappende gesprekken
Wanneer meerdere sprekers door elkaar heen praten, is het lastig te begrijpen wat er wordt gezegd. Gebruik diarization of multichanneltranscriptie, die Scribe v2 biedt, om sprekers te onderscheiden. Zo ontvang je afzonderlijke transcripten die aan de betreffende sprekers zijn gekoppeld.
Verkeerde interpretaties
Een ander probleem voor transcriptietools is het nauwkeurig herkennen en interpreteren van specifieke producten, merken of branchetermen. Zo kan 'DevOps', een term die bekend is bij softwareontwikkelaars, verkeerd worden getranscribeerd als 'dev ops'. Met de API voor vergadertranscriptie van ElevenLabs kun je het model met key term prompting helpen de term correct te interpreteren.
Meertalige sprekers
Sommige vergaderingen worden in verschillende talen gehouden, waarbij sprekers afwisselen tussen twee of meer talen die ze beheersen. Standaard spraakmodellen hebben moeite om de context en spraakinhoud te interpreteren, wat leidt tot een lage transcriptiekwaliteit. Scribe v2 maakt meertalige transcriptie in meer dan 90 talen mogelijk en legt gesprekken nauwkeurig vast terwijl ze zich ontvouwen.
Live ondertiteling en transcript na de opname
Sommige teams moeten live ondertiteling projecteren en een transcript na de vergadering genereren. Helaas biedt niet elke kant-en-klare transcriptietool beide functies. Met de ElevenLabs API kun je beide doen met Scribe v2 en Scribe v2 Realtime.
Aan de slag met de API voor vergadertranscriptie
ElevenAPI geeft je toegang tot toonaangevende Speech to Text-modellen om transcriptietools voor vergaderingen te bouwen. Een ontwikkelomgeving opzetten is eenvoudig. Je haalt een API-sleutel op en installeert de SDK voor Python of Node.js. Vervolgens integreer je Scribe v2 of Scribe v2 Realtime met je product via de aangeboden API.
Krijg toegang tot ElevenLabs en verstuur je eerste API-aanvraag nu.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.