Wat is meertalige transcriptie en hoe werkt het?
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Of je nu een internationale conferentie organiseert of gewoon nauwkeurige verslagen wilt van klantondersteuningsgesprekken in elke taal, meertalige transcriptie is belangrijker dan ooit tevoren.
Door audiogegevens om te zetten in nauwkeurige, doorzoekbare tekst, maken tools voor meertalige transcriptie van gesprekken bruikbare verslagen. De technologie die transcriptie in verschillende talen mogelijk maakt, is meegegroeid met het toenemende onderzoek naar Speech to Text-modellen (STT). Ontwikkelaars kunnen krachtige STT-API's nu zelfs in hun workflows integreren voor complexe pijplijnen voor meertalige transcriptie.
In dit artikel bespreken we wat meertalige transcriptie is, hoe het werkt via een desktopapp en API, en waarom het essentieel is voor bedrijven over de hele wereld.
Samenvatting
- Meertalige transcriptie zet een audiobestand om in geschreven tekst in verschillende talen.
- De beste tools voor meertalige transcriptie bieden extra functies, zoals sprekerdiarisatie, keyterm prompting en entiteitsdetectie.
- Je kunt tools voor meertalige transcriptie online gebruiken of een Speech to Text API integreren in ontwikkelworkflows.
- Automatische transcriptie biedt snelheid en schaalbaarheid, terwijl menselijke transcriptie nuttig kan zijn bij complexe gevallen met meerdere overlappende sprekers.
- De nauwkeurigheid van meertalige transcriptie wordt gemeten met de Word Error Rate (WER), die per taal verschilt.
Wat is meertalige transcriptie en waarom is het belangrijk?
Meertalige transcriptie zet gesproken audio om in geschreven tekst in meer dan één taal. Systemen met kunstmatige intelligentie detecteren automatisch welke taal of talen worden gesproken en transcriberen de audio. De uitvoer van meertalige STT kan een woordelijk transcript zijn of een vertaallaag bevatten om de invoertalen samen te brengen in één gemeenschappelijke uitvoertaal.
Tijdens een internationale conferentie kunnen sprekers bijvoorbeeld een vraag in hun moedertaal krijgen. De meertalige Speech to Text-tool kan rechtstreeks transcriberen wat elke spreker in diens eigen taal zegt, of één uitvoer in een doeltaal produceren die het publiek kan lezen. Organisaties kunnen met deze STT-tools de toegankelijkheid van hun evenementen vergroten.
ElevenLabs bouwt meertalige STT-mogelijkheden rechtstreeks in ons Speech to Text Scribe v2-model. Scribe v2 ondersteunt automatische taaldetectie, waardoor één bestand meerdere talen kan bevatten. Je kunt aangeven welke talen in een audioclip voorkomen of de instelling op “Detect” laten staan, zodat ons systeem alle talen in het geüploade bestand identificeert.
Bij gebruik van ElevenAPI staat de parameter language_code standaard op automatische voorspelling. Als je al weet welke talen aanwezig zijn, verbetert het vooraf opgeven ervan de prestaties.
Waarom meertalige transcriptie belangrijk is
Recent onderzoek wijst erop dat de wereldwijde markt voor transcriptiediensten tegen 2035 $ 6 miljard zal bereiken. De groei wordt mede versneld door het brede scala aan toepassingen van meertalige STT.
Er zijn verschillende praktische redenen waarom meertalige transcriptie belangrijk is:
- Toegankelijkheid: Ondertiteling is afhankelijk van nauwkeurige meertalige transcripties voordat vertaling of nasynchronisatie kan beginnen. Meertalige STT kan de toegankelijkheid voor gebruikers aanzienlijk verbeteren.
- Doorzoekbaarheid: Getranscribeerde audio kan indexeerbare tekst worden, waardoor je supportgesprekken of vergaderingen nuttige bronnen voor anderen worden. Doorzoekbaarheid is vooral belangrijk nu AI-systemen steeds meer gegevens uit interne documenten naar voren halen; duidelijke transcriptie helpt daarbij een uitgebreide invoerreferentie op te bouwen.
- Compliance: Veel gereguleerde sectoren hebben controleerbare schriftelijke verslagen van gesproken interacties nodig. Met meertalige STT kun je hierin voorzien in elke taal die je klanten gebruiken. Zo stelt de Financial Conduct Authority dat financiële instellingen opnames en transcripties van telefoongesprekken moeten bewaren.
- Wereldwijde contentpijplijnen: Of het nu gaat om nasynchronisatie of ondertiteling, workflows beginnen altijd met een zeer nauwkeurig eerste transcript als uitgangspunt. Kwalitatieve tools voor meertalige transcriptie maken de eerste stap mogelijk in deze bredere workflows voor wereldwijde contentdistributie.
Meertalige transcriptie is noodzakelijk in tal van sectoren: telecomproviders die supportgesprekken transcriberen, financiële dienstverleners die aan compliancevereisten voldoen, zorgteams die patiëntinteracties documenteren en zelfs filmstudio's die content lokaliseren. Of je nu in SaaS, reizen of nutsvoorzieningen werkt, een krachtig systeem zorgt ervoor dat je transcripties altijd nauwkeurig en van hoge kwaliteit zijn.
Belangrijke functies voor oplossingen voor meertalige transcriptie
Tools voor meertalige transcriptie moeten zich kunnen aanpassen aan de audio-invoer waarmee ze werken, talen dynamisch identificeren en deze zeer nauwkeurig transcriberen.
Dit zijn de belangrijkste functies van een hoogwaardige oplossing voor meertalige transcriptie:
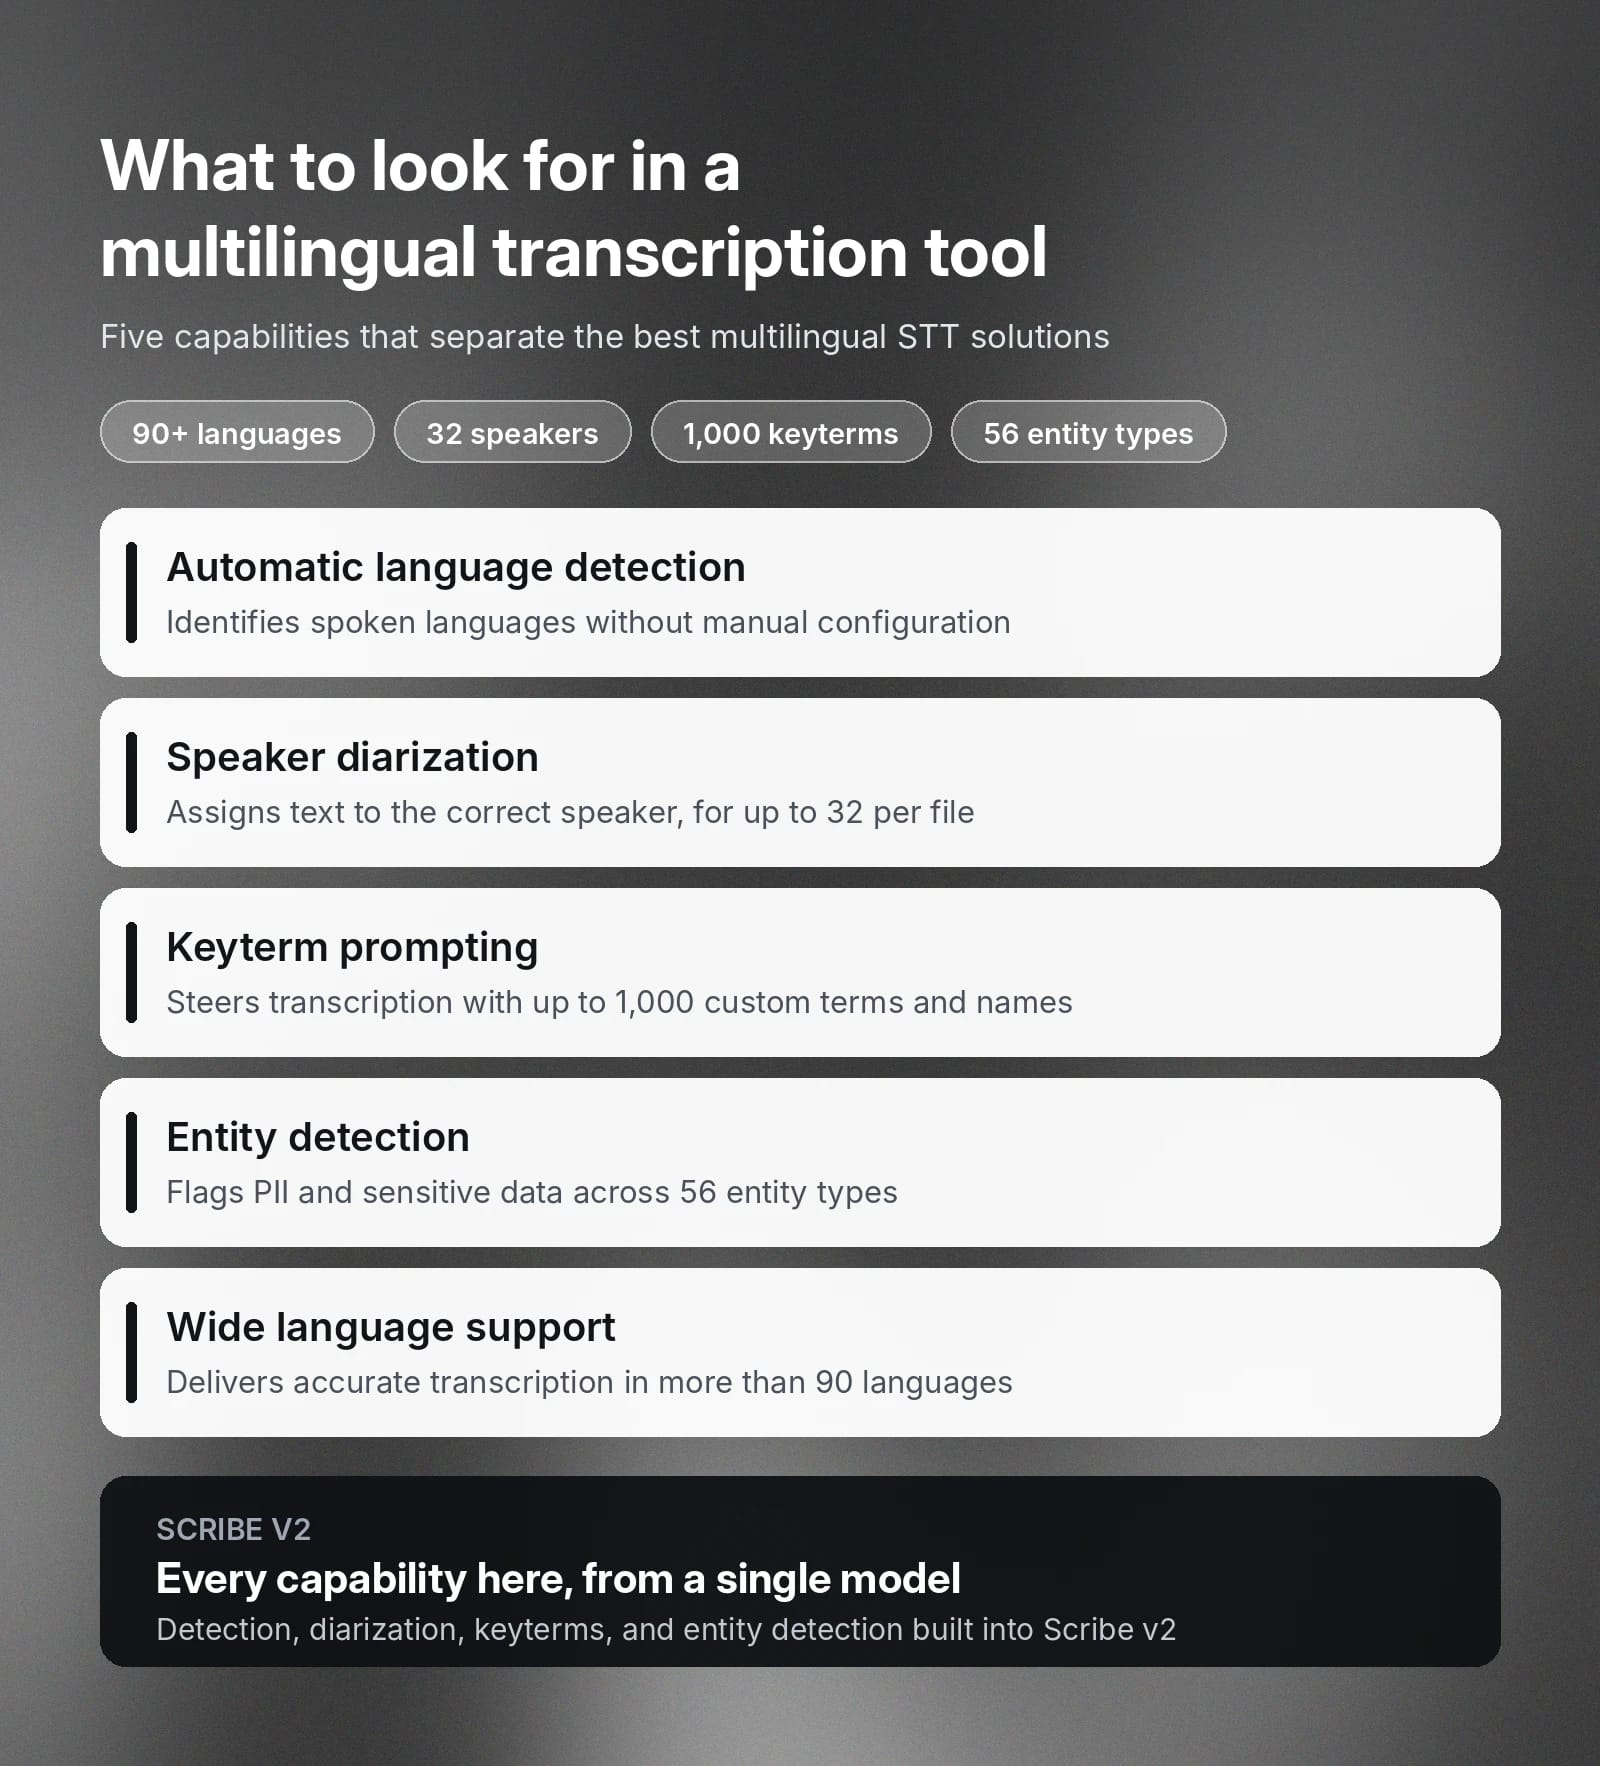
- Automatische taaldetectie: Het systeem moet de gesproken taal zelf identificeren, in plaats van transcriptie te blokkeren totdat de gebruiker een brontaal opgeeft. Vooral wanneer de invoertaal onbekend is of een clip meerdere talen bevat, zorgt automatische taaldetectie ervoor dat je meerdere talen beheert zonder handmatige configuratie.
- Sprekerdiarisatie: Diarisatie koppelt getranscribeerde tekst aan de juiste spreker in een bestand, wat belangrijk is voor audiotranscripties met meerdere sprekers. Er kunnen bijvoorbeeld meerdere personen in een panel zitten die je moet onderscheiden, of je wilt duidelijk zien wanneer een klant en een supportmedewerker spreken. Scribe v2 ondersteunt diarisatie voor maximaal 32 sprekers in één bestand.
- Keyterm prompting: Met keyterms kunnen gebruikers handmatig specifieke woordenschat invoeren, zoals productnamen of eigennamen, voor een correcte transcriptie. In batchsystemen ondersteunt Scribe v2 maximaal 1.000 keyterms, terwijl Scribe v2 Realtime voor live transcriptie er maximaal 50 biedt.
- Entiteitsdetectie: Entiteitsdetectie identificeert specifieke woorden in een transcript, wat essentieel is voor inspanningen rond compliance en veiligheid ter bescherming van gevoelige gegevens. Lees de ElevenLabs documentatie over entiteitsdetectie voor een volledig overzicht van de 56 ondersteunde entiteitstypen.
- Brede taalondersteuning: De beste meertalige STT-oplossingen kunnen transcriptie in een enorm aantal talen ondersteunen. Ter referentie: Scribe v2 biedt nauwkeurige transcriptie in meer dan 90 talen.
Samen ondersteunen deze mogelijkheden een breed scala aan toepassingen, zodat je een betrouwbaar STT-systeem kunt inzetten dat meerdere talen nauwkeurig verwerkt.
Audio efficiënt transcriberen in verschillende talen
De effectiefste manier om audio in verschillende talen te transcriberen, hangt af van de workload die je voor ogen hebt. Voor eenmalige batchbestanden kun je op de ElevenLabs-pagina voor Speech to Text een bestand uploaden en snel het transcript ontvangen.
Wanneer je met ElevenCreative werkt, is audio transcriberen heel eenvoudig:
- Je audio uploaden: Ga naar Speech to Text en klik op “Transcribe files”.
- Je opties selecteren: Selecteer de primaire taal of laat deze op “Detect” staan, schakel audio-gebeurtenissen in als je gelach of andere niet-spraakgebeurtenissen wilt taggen, en voeg indien nodig keyterms toe.
- Je resultaten bekijken: Nadat je je bestanden hebt geüpload, kun je op de naam van het audiobestand klikken om de transcriptie te bekijken. Daar kun je het transcript rechtstreeks in de Transcript Editor controleren en verfijnen en vervolgens exporteren naar het formaat dat elke vervolgstap in de workflow nodig heeft.
Gebruik voor programmatische transcriptie of grote volumes de Speech to Text API. Hier zijn enkele details waarmee je productie-pijplijnen kunt vormgeven:
- Modelselectie: De parameter model_id kiest tussen scribe_v2 en scribe_v1, zodat de pijplijn een specifiek model kan selecteren in plaats van te vertrouwen op een standaardinstelling die in de loop der tijd kan veranderen.
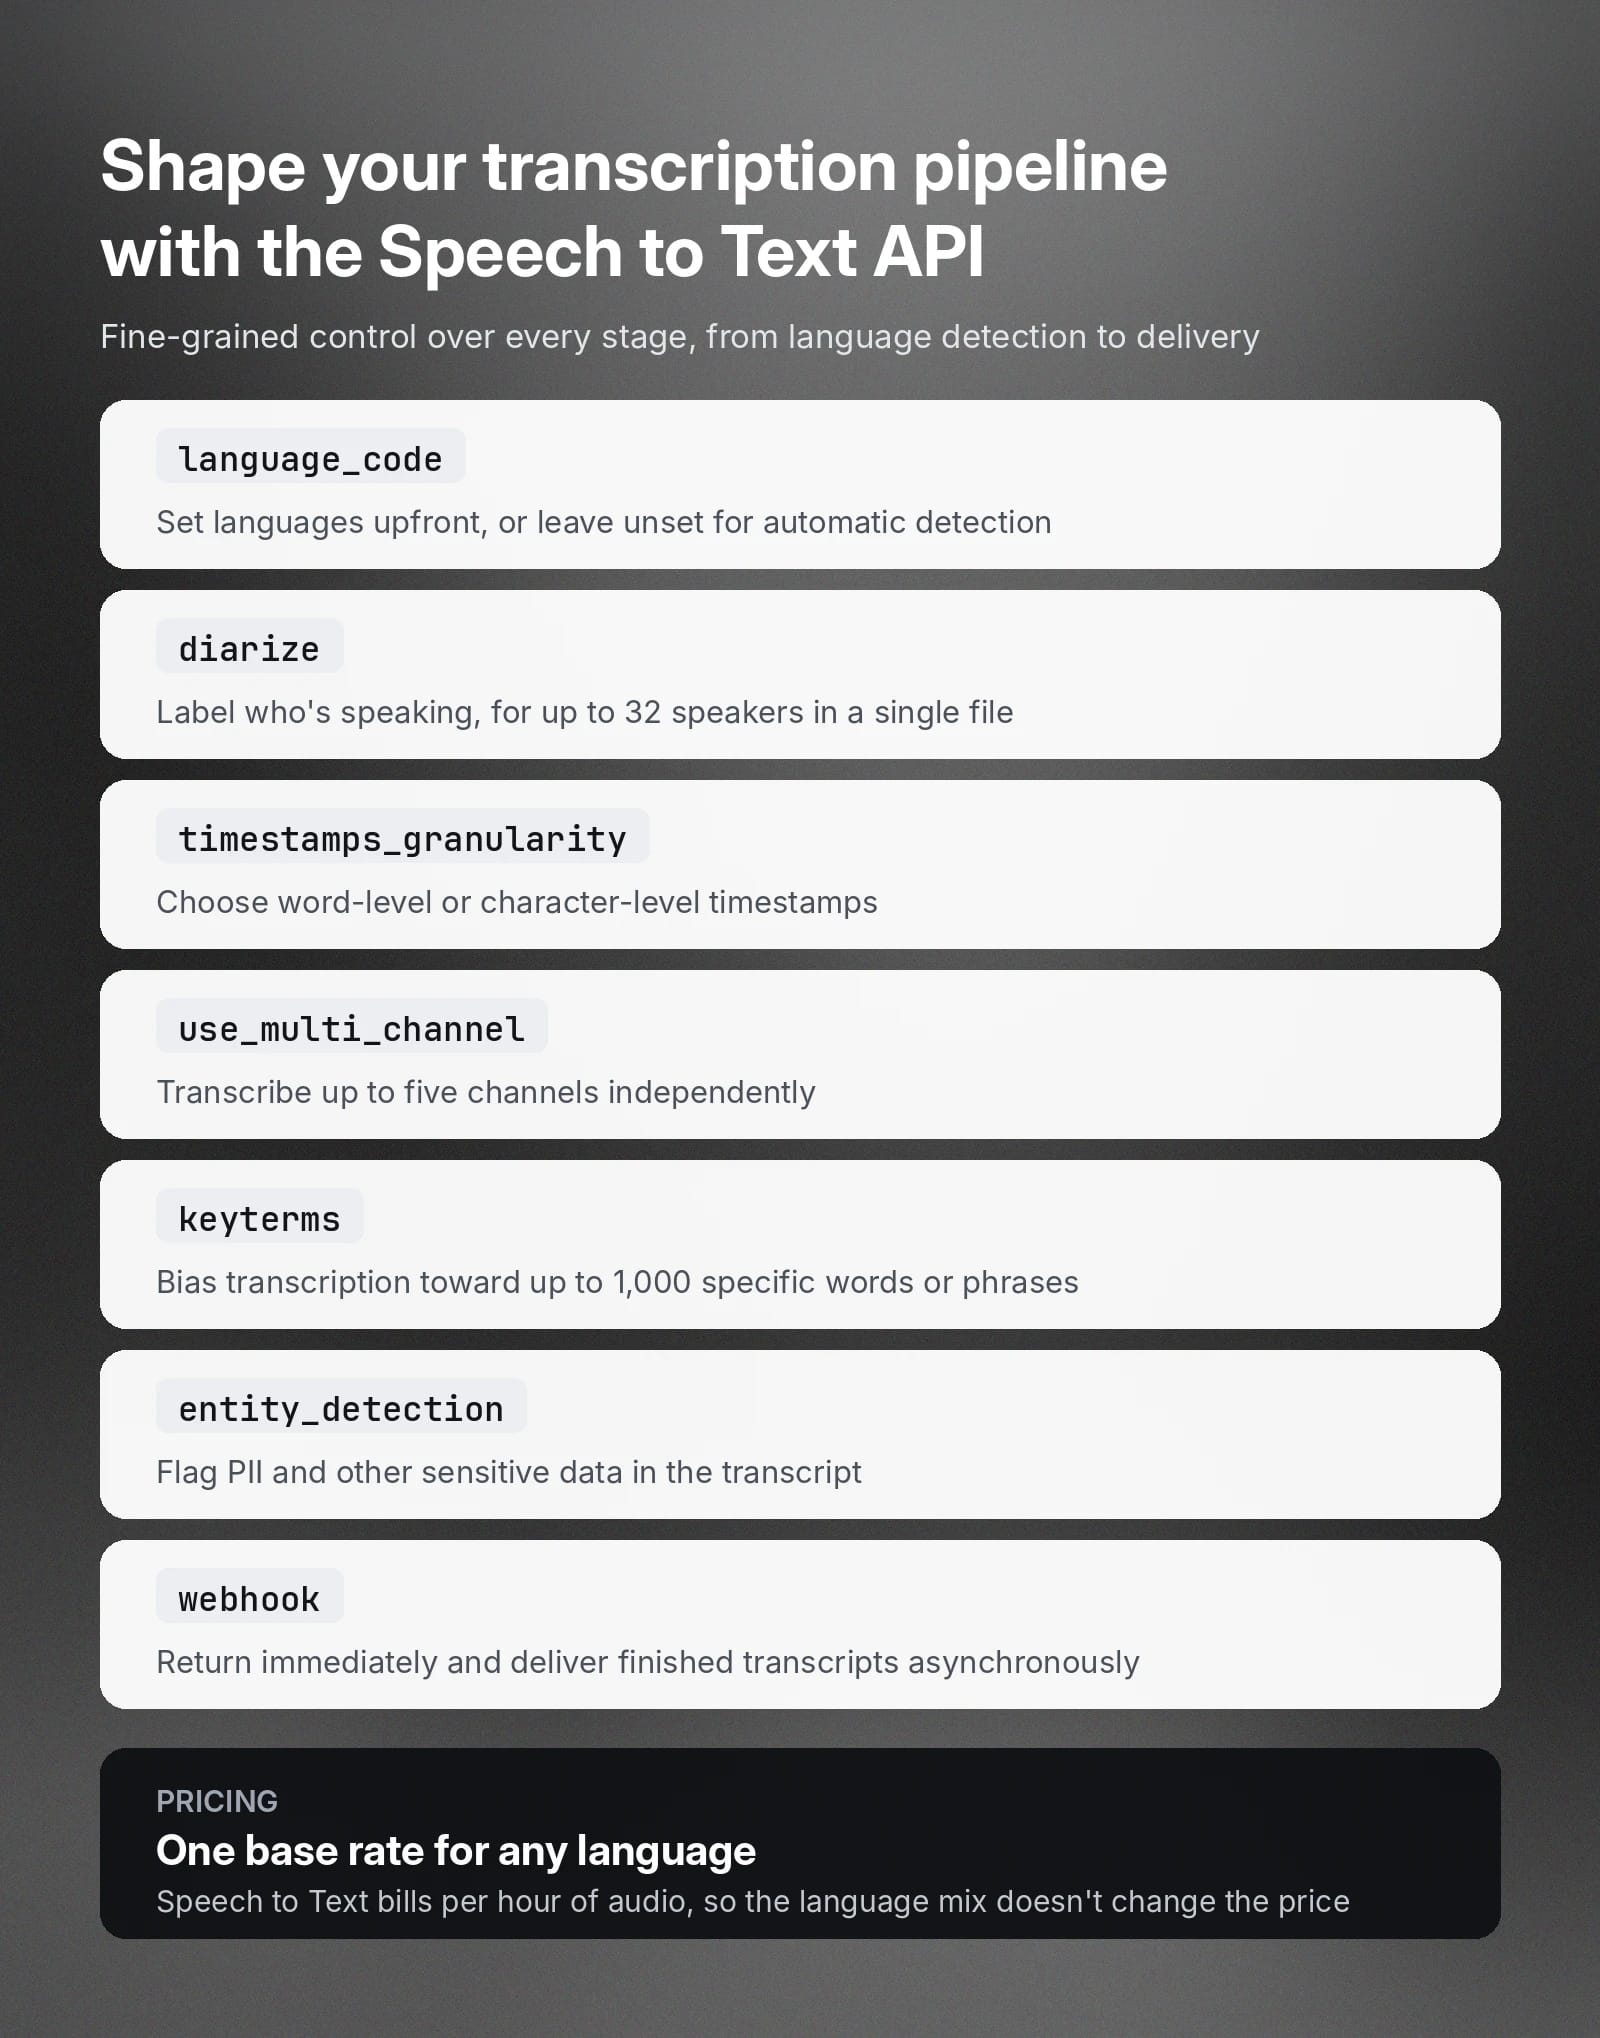
- Taalverwerking: De parameter language_code accepteert een ISO-639-1- of ISO-639-3-code en gebruikt standaard automatische detectie wanneer deze niet is ingesteld. Het rechtstreeks opgeven van een taal kan de prestaties verbeteren.
- Instellingen voor sprekerdiarisatie: Door diarize op true in te stellen, wordt aangegeven welke spreker aan het woord is. De parameter num_speakers beperkt het aantal tot 1 tot en met 32. Voor nauwkeurigere controle kun je de parameter diarization_threshold gebruiken om de afweging tussen verschillende sprekers af te stemmen.
- Nauwkeurigheid van tijdstempels: De parameter timestamps_granularity bepaalt het detailniveau van de uitvoer, met opties voor tijdstempels op woord- of tekenniveau tijdstempels (of geen).
- Asynchrone verwerking op schaal: Door webhook op true in te stellen, ontvang je de response direct en wordt het voltooide transcript na verwerking geleverd aan je geconfigureerde webhook. Het veld webhook_metadata voegt aangepaste trackinggegevens, zoals je interne job-ID, toe aan elke webhook-response.
- Multichannel-audio: Door use_multi_channel op true in te stellen, wordt elk kanaal onafhankelijk getranscribeerd, met maximaal vijf kanalen, en krijgt elk woord een veld channel_index.
- Verwerking van gespecialiseerde content: De parameter keyterms stuurt transcriptie richting maximaal 1.000 specifieke woorden of zinnen, entity_detection markeert PII en andere gevoelige gegevens, en no_verbatim verwijdert stopwoorden en valse starts uit de uitvoer.
Samen geven deze parameters je gedetailleerde controle over elke fase van de pijplijn. Van taaldetectie en sprekerlabels tot uitvoeropmaak en levering: de Speech to Text API past zich aan je productiebehoeften aan.
Ondersteunde talen voor transcriptiediensten uitgelegd
Taaldekking is een belangrijk onderscheid tussen de beste tools voor meertalige transcriptie. ElevenLabs Scribe v2 en Scribe v2 Realtime ondersteunen beide meer dan 90 talen; in de Speech to Text-documentatie staat de volledige lijst met ondersteunde talen.
Talen zoals Engels, Spaans, Italiaans, Pools, Frans en Duits beschikken over grotere hoeveelheden trainingsdata, waardoor STT voor deze talen vaak nauwkeuriger is. Sommige talen, zoals Amhaars, Ganda, Yoruba en Zoeloe, hebben lagere nauwkeurigheidspercentages dan de bovenstaande talen.
ElevenLabs Scribe-modellen hebben een Word Error Rate van <5% voor 36 verschillende talen en een WER van <10% voor 21 andere talen. Bekijk het ElevenLabs overzicht van taalondersteuning voor meer informatie over ondersteunde talen en hun WER's.
Hoeveel kost meertalige transcriptie?
De prijs van automatische transcriptie is doorgaans gebaseerd op de duur van een audiobestand, en niet op het aantal woorden of talen. ElevenLabs rekent voor Speech to Text op basis van audioduur, gefactureerd per uur audio. De specifieke tarieven verschillen per abonnement en model.
Dit zijn de belangrijkste factoren die de prijs van meertalige transcriptie beïnvloeden:
- Extra transcriptiefuncties: Sommige aanbieders rekenen extra kosten voor het inschakelen van bepaalde functies, zoals entiteitsdetectie.
- Multichannel-audio wordt per kanaal gefactureerd: Wanneer je use_multi_channel inschakelt, wordt elk kanaal afzonderlijk gefactureerd. Een opname met twee kanalen kost dus ongeveer twee keer zoveel als een opname met één kanaal.
- De taal verandert het basistarief niet: Prijzen op basis van duur betekenen dat meertalige STT elke taal kan ondersteunen tegen hetzelfde tarief per uur, wat budgettering vereenvoudigt voor teams die met meerdere talen werken.
Bekijk onze prijspagina voor meer informatie over de kosten van ElevenLabs Speech to Text.
Ga aan de slag met ElevenAPI voor nauwkeurige meertalige transcriptie
ElevenAPI brengt meertalige transcriptie in enkele stappen naar elke productieworkflow. Of je nu content voor wereldwijde media-archieven, klantondersteuningsinteracties, vergaderingen of onderzoeksinterviews transcribeert, of gewoon nauwkeurige spraakherkenning in tientallen talen zoekt: onze krachtige meertalige STT-engine kan helpen.
Verken de ElevenAPI Speech to Text API om alle mogelijkheden te bekijken, of maak een ElevenLabs-account om vandaag nog meertalige audio te transcriberen.
Veelgestelde vragen over meertalige transcriptie

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.