Word error rate (WER): kernbegrippen, formule en toepassingen
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
In theorie is de word error rate (WER) een metriek om de nauwkeurigheid van een Automatic Speech Recognition-tool (ASR) te bepalen. Een lage WER betekent dat je uiteindelijke transcript nauwkeuriger is; een hoger foutenpercentage wijst op verkeerd getranscribeerde informatie.
In de praktijk kan WER het verschil betekenen tussen medische transcriptiesoftware die noteert dat een patiënt ‘vijftien milligram’ in plaats van ‘vijftig milligram’ van een medicijn nodig heeft. Het is het verschil tussen een supporttool die de behoeften van een klant nauwkeurig transcribeert en een tool die je gebruiker gefrustreerd achterlaat.
In dit artikel leggen we uit wat WER is, hoe je het berekent en hoe je het kunt gebruiken om je eigen ASR-provider te benchmarken.
Samenvatting
- Word error rate telt drie soorten fouten: substituties, weglatingen en toevoegingen, gedeeld door het aantal woorden in het referentietranscript.
- De formule voor WER is WER = (S + D + I) / N.
- Lagere WER-scores betekenen dat de uiteindelijke output nauwkeuriger is.
- Een WER van minder dan 5% is een goede benchmark, al kunnen juridische of medische transcripties een nog lagere Word Error Rate vereisen.
- WER behandelt alle fouten als gelijkwaardig en is daardoor geen perfecte metriek voor het beoordelen van context. Opkomende metrieken, zoals Semantic Word Error Rate (SWER), proberen dit op te lossen door te meten of de betekenis van een uiting behouden is gebleven.
Wat is word error rate?
Word error rate (WER) is de standaardmetriek voor het meten van de nauwkeurigheid van spraakherkenning in speech-to-textmodellen. Het is een waarde van 0 tot 1 (0,8 staat voor een foutenpercentage van 80%) die aangeeft wat een STT-systeem verkeerd transcribeert, op basis van substituties, weglatingen en toevoegingen.
Een substitutie is wanneer een woord door een verkeerd woord wordt vervangen. Bij een weglating is een woord volledig gemist. Bij een toevoeging staat er een woord in het transcript dat nooit is uitgesproken. WER gebruikt al deze drie componenten en deelt ze vervolgens door het aantal woorden in het juiste transcript. Zo krijg je een getal waarmee je verschillende aanbieders kunt vergelijken.
De formule voor WER luidt:
WER = (S + D + I) / N
Waarbij:
- S: Substituties (woord is onjuist)
- D: Weglatingen (woord ontbreekt)
- I: Toevoegingen (extra woord is aanwezig)
- N: Totaal aantal woorden in het referentietranscript
Je kunt WER uitdrukken als decimaal getal of als percentage. Hoe lager de WER, hoe beter je score, omdat het model bij het transcriberen minder fouten maakte.
In de praktijk betekent een WER van 10% dat ongeveer 1 op de 10 woorden in je vergaderingstranscript opnieuw moet worden gecontroleerd.
Waarom is word error rate belangrijk in spraakherkenningssystemen?
Word error rate biedt een objectieve metriek waarmee teams verschillende aanbieders kunnen vergelijken. Het prikt door marketingclaims heen en laat duidelijk zien hoe nauwkeurig een spraakherkenningsmodel is. Door uit te gaan van bewijs, krijgt elke organisatie die haar opties beoordeelt een helder beeld van welke modellen momenteel toonaangevend zijn op dit gebied.
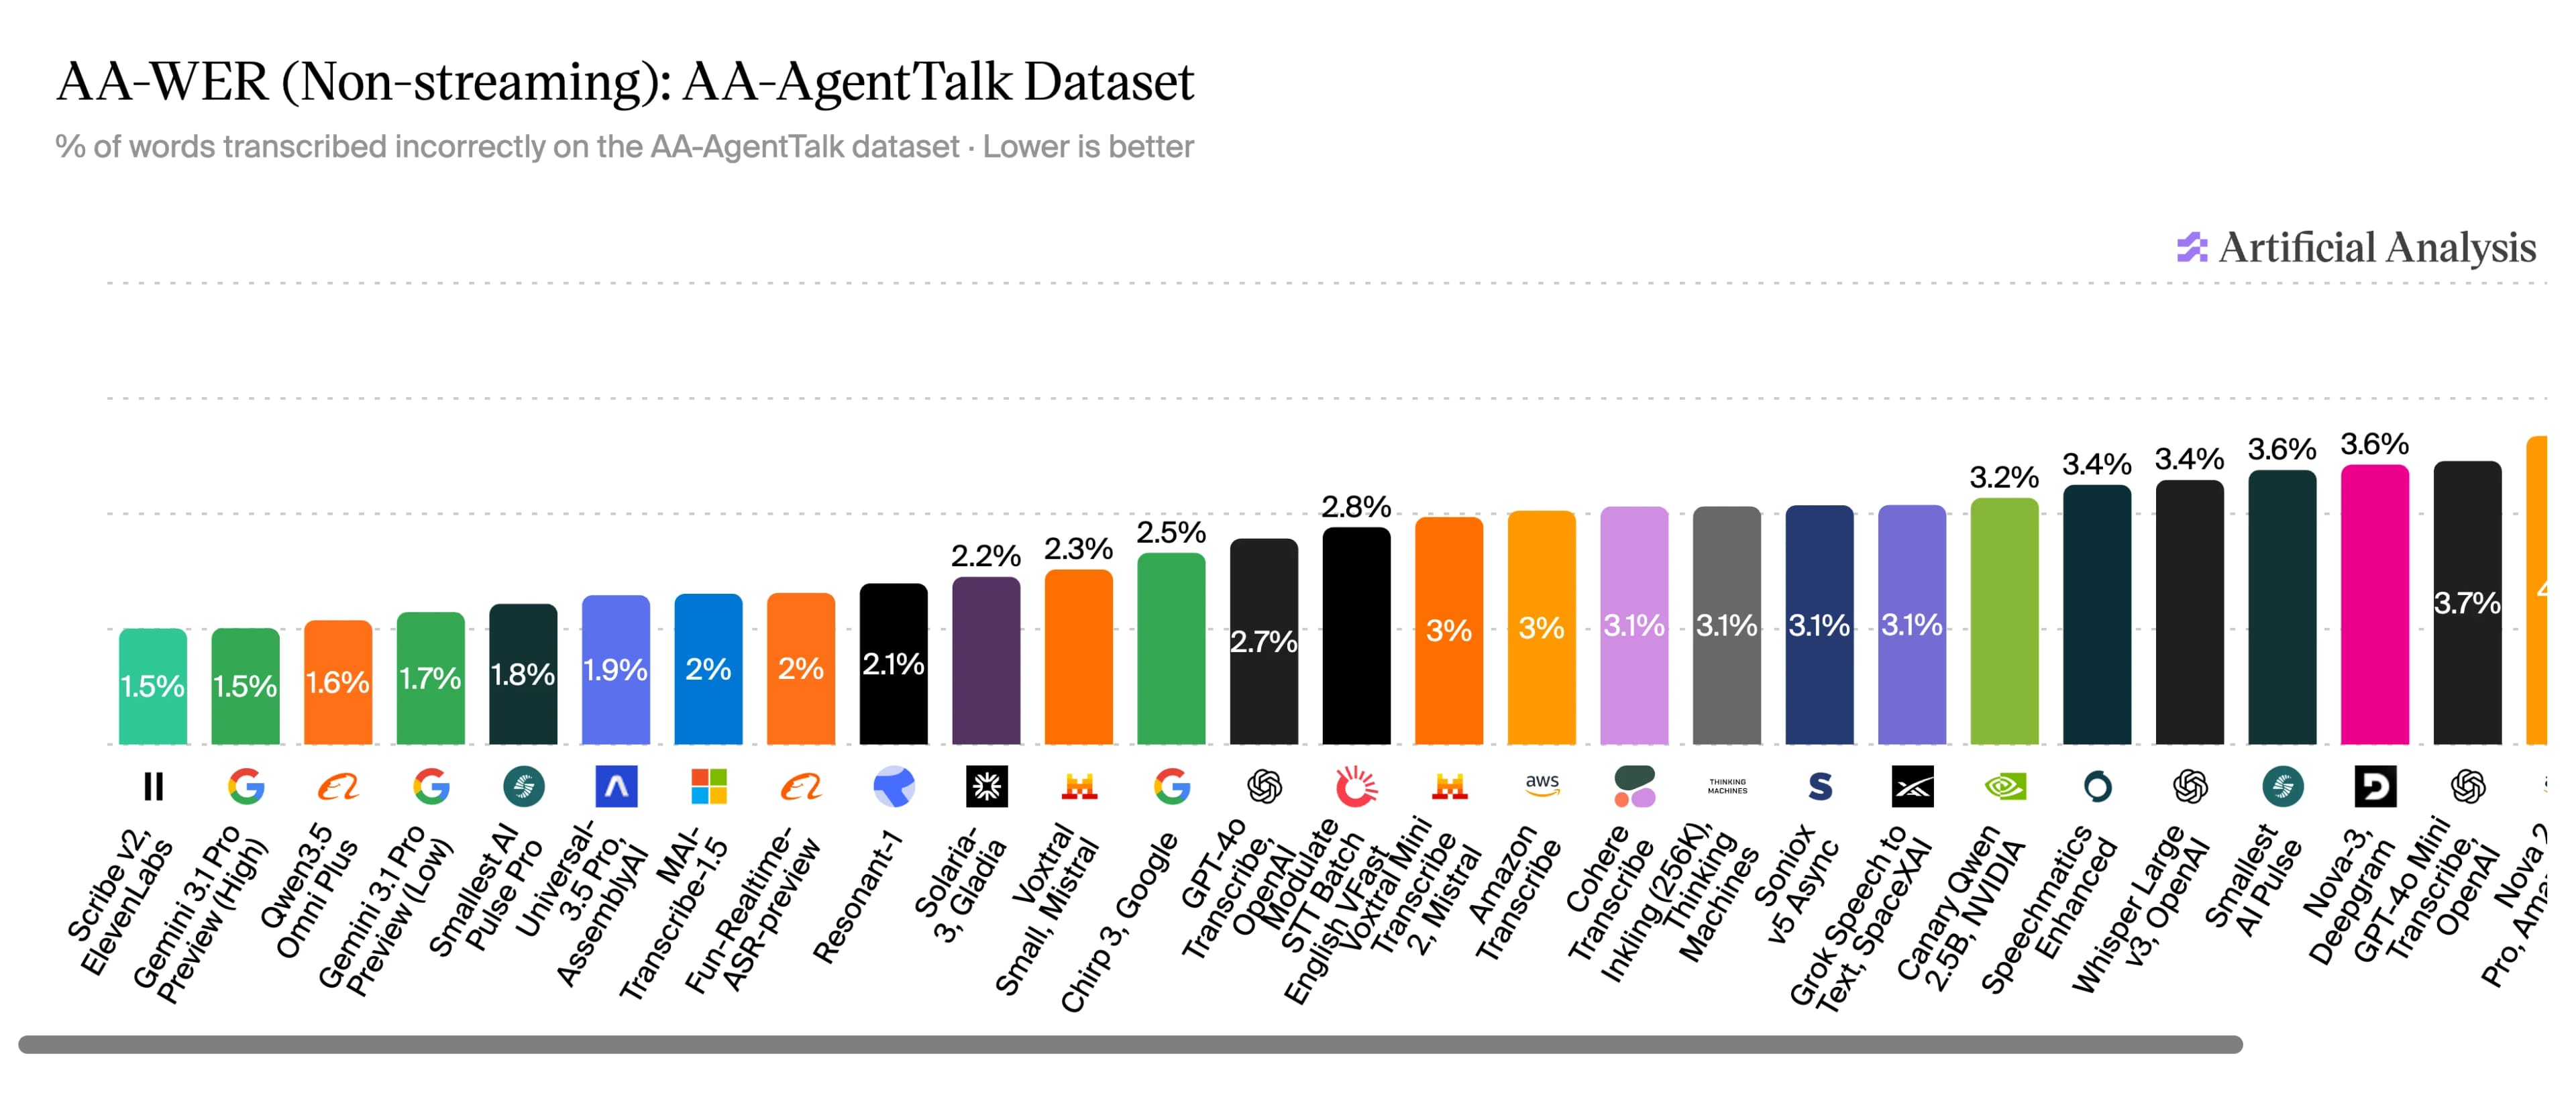
Bron: Artificial Analysis, geraadpleegd op 10 juli 2026.
Onafhankelijk onderzoek van Artificial Analysis rangschikt ElevenLabs' Scribe v2 sinds juli 2026 als het model met de laagste WER in de sector op de AA-AgentTalk-dataset voor non-streaming transcriptiemodellen, met een WER van 1,5%.
Naast de beoordeling van aanbieders heeft WER ook op productniveau gevolgen in de praktijk. Medische transcriptiesoftware met een WER van 12% kan kritieke fouten in patiëntendossiers introduceren. Verkeerde transcripties in een klantenservice-gesprek kunnen tot vervolgproblemen leiden, zoals onjuiste sentimentanalyse of slechte categorisatie.
Naast deze specifieke problemen per use case worden bij falende ASR-systemen vooral mensen getroffen voor wie het transcript de enige manier is om gesproken content te gebruiken. Het World Wide Web Consortium biedt uitgebreide documentatie over de minimumnormen die toegankelijkheidsinitiatieven verwachten.
Word error rate berekenen: formule en voorbeeld
Word error rate berekenen is eenvoudig zodra je de stappen kent. Zoals hierboven besproken, gebruik je de formule WER = (S + D + I) / N. Alle termen zijn hierboven beschreven, maar kort samengevat: substituties, weglatingen, toevoegingen en N voor het totale aantal woorden in de transcriptie.
Zo bereken je WER:
- Maak een referentietranscript: Gebruik menselijke transcriptie en verificatie om een nauwkeurige transcriptie van een audioclip te maken.
- Gebruik je STT-tool: Gebruik een ASR-platform om de audioclip te transcriberen en een AI-transcript te maken dat je als test gebruikt.
- Lijn de twee versies uit: Gebruik dynamic programming, en specifiek het Levenshtein-algoritme, om het minimale aantal bewerkingen te vinden. We gaan in een latere sectie verder in op dat algoritme.
- Pas de formule toe: Tel het totale aantal fouten in de door AI gegenereerde versie ten opzichte van de door mensen geverifieerde versie en gebruik vervolgens WER = (S + D + I) / N om de exacte WER te berekenen.
Op papier lijkt dit vrij technisch, maar in de praktijk is het veel eenvoudiger. Dit oefenvoorbeeld laat zien wat we bedoelen.
Referentietranscript: Mevrouw Dalloway zei dat ze de bloemen zelf zou kopen.
ASR-output: Juffrouw Dalloway zei dat ze bloemen zelf zou kopen.
Als we het totale aantal fouten berekenen, hebben we 1 S en 1 D op in totaal 9 woorden.
Met de formule krijgen we: WER = 2 / 9 = 0,222 = 22,2%.
Word error rate berekenen met Python
Hoewel de handmatige methode prima werkt, kun je tijd besparen door WER met Python te berekenen. De jiwer-bibliotheek verwerkt dit allemaal volledig automatisch.
Met de jiwer-documentatie kun je het package installeren, dat speciaal is gebouwd om een ASR-systeem te evalueren en kernmetrieken zoals WER te produceren. Na het downloaden kun je de volgende code gebruiken om WER snel met Python te berekenen:
Merk op dat de ASR-output in dit voorbeeld op twee plaatsen afwijkt van de oorspronkelijke referentie. Het woord ‘jumps’ werd onjuist getranscribeerd als ‘leaps’ (een substitutie) en ‘last’ werd vóór ‘lazy’ ingevoegd (een toevoeging). Met twee fouten in de negen woorden van het referentietranscript resulteert dit in een Word Error Rate (WER) van 0,222 of 22,2%.
Word error rate vergelijken met andere herkenningsmetrieken
Hoewel WER de standaardmetriek is om de nauwkeurigheid van een ASR te berekenen, zijn er andere tools die je kunt gebruiken. Bijvoorbeeld:
- Character Error Rate (CER): Net als WER meet deze de nauwkeurigheid van transcriptie op tekenniveau in plaats van op woordniveau. Het best voor talen zonder duidelijke woordgrenzen (scriptio continua) of taken waarbij spelling belangrijk is.
- Match Error Rate (MER): Meet het aandeel transcriptiefouten, waarbij substituties, toevoegingen en weglatingen iets anders worden behandeld dan bij WER. De focus ligt op het aandeel fouten in een zin.
- Word Information Lost (WIL): Een schatting van hoeveel van de oorspronkelijke informatie tijdens transcriptie verloren is gegaan. Dit biedt een maat voor begrijpelijkheid in plaats van de directe foutentelling van WER.
- Embedding Error Rate (EmbER): Biedt een semantische analyse tussen de transcripties. Deze metriek gaat verder dan WER en geeft inzicht in de semantische afstand tussen het juiste woord en de onjuiste transcriptie.
Elk van deze metrieken is het meest geschikt voor een ander scenario. Hier is een tabel die je kunt raadplegen:
Voorbeelden van Levenshtein-afstand: de wiskunde achter WER
Word error rate is in feite een maat voor de afstand tussen het origineel en de hypothese-output. Om dat verschil wiskundig te begrijpen, gebruiken we de Levenshtein-afstand.
De Levenshtein-afstand telt het minimale aantal bewerkingen van één eenheid dat nodig is om de ene reeks in een andere te veranderen. Voor WER gaat het daarbij specifiek om substituties, toevoegingen en weglatingen. Als we bijvoorbeeld Cat in Mat willen veranderen, moet je de letter ‘C’ door ‘M’ vervangen, wat een Levenshtein-afstand van 1 oplevert.
In CER-berekeningen zie je hier veel meer van, maar WER schaalt de Levenshtein-afstand op naar woordniveau. Elke eenheid is een volledig woord in plaats van een teken, waarbij de werkelijke afstand meet hoeveel woordbewerkingen nodig zijn om onze ASR-output om te zetten in het juiste origineel.
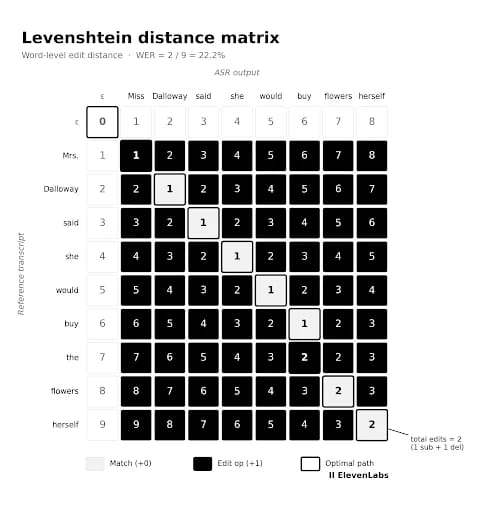
We bouwen een matrix waarin elke cel de totale afstand tussen het oorspronkelijke transcript en het ASR-transcript weergeeft. De Levenshtein-afstand vult de matrix vervolgens van linksboven naar rechtsonder, waarbij de laatste cel je het totale aantal bewerkingen op woordniveau geeft. Deel dat getal door N en je hebt je WER.
Deze matrix wordt meestal met afzonderlijke tekens berekend, maar voor de eenvoud zie je hier een opgeschaalde versie van ons vorige voorbeeld.
Veelvoorkomende valkuilen en misvattingen rond word error rate
Vooral nu STT-API's toegankelijker worden en ASR-software een gangbaar onderdeel wordt van bredere agentstacks, zullen we veel vergelijkingen tussen verschillende tools zien.
Voordat je zelf word error rates berekent, zijn er enkele veelvoorkomende problemen en misvattingen die je moet begrijpen.
- Alle fouten zijn gelijk: WER beschouwt elke fout als even belangrijk. In veel contexten is dat misschien prima, maar voor sommige use cases is dit onaanvaardbaar. In een ziekenhuis kan een foutpercentage van 5%, dat als een goede WER zou gelden, bijvoorbeeld nog steeds onbegrijpelijk zijn, omdat zelfs één of twee fouten een patiënt in gevaar kunnen brengen. Deze beperking heeft geleid tot nieuwere metrieken, zoals Semantic Word Error Rate (SWER), die probeert te meten of de betekenis van een zin behouden is gebleven in plaats van of elk woord exact overeenkomt.
- WER kan hoger zijn dan 100%: Hoewel we eerder aangaven dat WER tussen 0 en 1 ligt, kun je nog steeds een WER van meer dan 100% aantreffen. Dat komt doordat toevoegingsfouten meer woorden kunnen opleveren dan het totaal in het oorspronkelijke transcript. Een veelvoorkomend voorbeeld is ‘I’m’ transcriberen als ‘I am’, waarbij één woord er twee wordt.
- Een lagere WER is technisch gezien niet altijd beter: Een WER van 5% is op papier beter dan een WER van 10%. Maar als de fouten die bijdroegen aan die 5% de context van een zin aanzienlijk veranderden en die in de 10% dat niet deden, vertelt de metriek niet het hele verhaal. Context blijft hier heel belangrijk. Daarom worden metrieken zoals SWER ontwikkeld, specifiek om deze semantische impact vast te leggen.
In 2024 publiceerde Apple een interessant onderzoek naar het laatste punt hierboven. Toen mensen een WER-berekening van 9,4% beoordeelden op basis van de leesbaarheid van de ASR, gaven ze dezelfde passage een WER van slechts 2,2%. In het geteste voorbeeld zagen mensen de ‘fouten’ in veel gevallen als onbeduidend, wat resulteerde in een Human WER die meer dan 4x vergevingsgezinder was dan die van machines.
Branchebenchmarks voor WER
De ideale WER hangt sterk af van de branche of use case waarin je ASR-technologie gebruikt. Hoewel <5% een branchebenchmark is voor WER, hebben specifieke sectoren zoals medische of juridische transcriptie een veel lager percentage nodig.
In het onderzoek van Artificial Analysis uit juli 2026 behaalde Scribe v2 van ElevenLabs een WER van 1,5%. Het is echter belangrijk om te onthouden dat deze statistieken doorgaans zijn gebaseerd op Engels als primaire taal. STT-technologie is in andere talen mogelijk niet even effectief.
De ElevenLabs Docs leggen de algemene WER-banden uit voor alle talen die Scribe v1 en Scribe v2 ondersteunen.
Ga aan de slag met ElevenAPI om de herkenningsnauwkeurigheid te verbeteren
Wanneer je een applicatie of product bouwt waarbij transcriptiekwaliteit belangrijk is, zie je het verschil tussen een goed gekozen ASR-API en een middelmatige API eerst terug in je WER en vervolgens in de ervaring van je gebruikers.
ElevenLabs Scribe is de Speech to Text-laag die toegankelijk is via ElevenAPI. Naast meer dan 90 talen en een toonaangevende WER biedt het functies zoals sprekerdiarisatie, timestamps op woordniveau, keyterm prompting en entiteitsdetectie.
Bekijk de ElevenLabs Docs voor meer informatie over ElevenAPI, of ga aan de slag door je te registreren vandaag.
Veelgestelde vragen over word error rate

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.