Los problemen met de nauwkeurigheid van Speech to Text op met een slimmere workflow
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
De nauwkeurigheid van Speech to Text (STT) hangt af van drie dingen: de kwaliteit van je audio, de manier waarop mensen spreken en de woorden die ze gebruiken. Ruis en sterke compressie verwijderen details uit een opname, waardoor zelfs krachtige modellen moeite hebben met overlappende stemmen of onbekend jargon. In deze gids zie je waar elk STT-probleem vandaan komt en hoe je het oplost.
Transcriptiefouten blijven zelden beperkt tot het transcript. Een verkeerd verstaan medicijn in een klinische notitie of een onjuist rekeningnummer in een gesprekslogboek komt terecht in elk systeem dat die tekst gebruikt, van zoeken en analytics tot AI-agents die handelen op basis van wat er is gezegd. Een lage nauwkeurigheid kost ook extra controletijd, omdat iemand de fouten handmatig moet vinden en corrigeren.
Het goede nieuws is dat de meeste problemen met de nauwkeurigheid van STT op te lossen zijn. Voor veel oplossingen hoef je slechts kleine wijzigingen aan te brengen in je bestaande configuraties of opnameopstellingen. Daardoor kun je het probleem oplossen zonder je modelinstellingen te wijzigen.
Dit onderwerp wordt ook wel nauwkeurigheid van spraakherkenning, ASR-nauwkeurigheid of transcriptienauwkeurigheid genoemd. Speech to Text, spraakherkenning en automatic speech recognition (ASR) beschrijven allemaal hetzelfde proces: gesproken audio omzetten in geschreven tekst. De oplossingen in deze gids gelden ongeacht welke term je gebruikt.
Samenvatting
- De nauwkeurigheid van Speech to Text hangt af van de kwaliteit van de audio-input, sprekerdynamiek en lexicale en contextuele kwesties.
- Zoek om een nauwkeurigheidsprobleem op te lossen waar je in de pipeline (input, verwerking of output) een wijziging kunt aanbrengen.
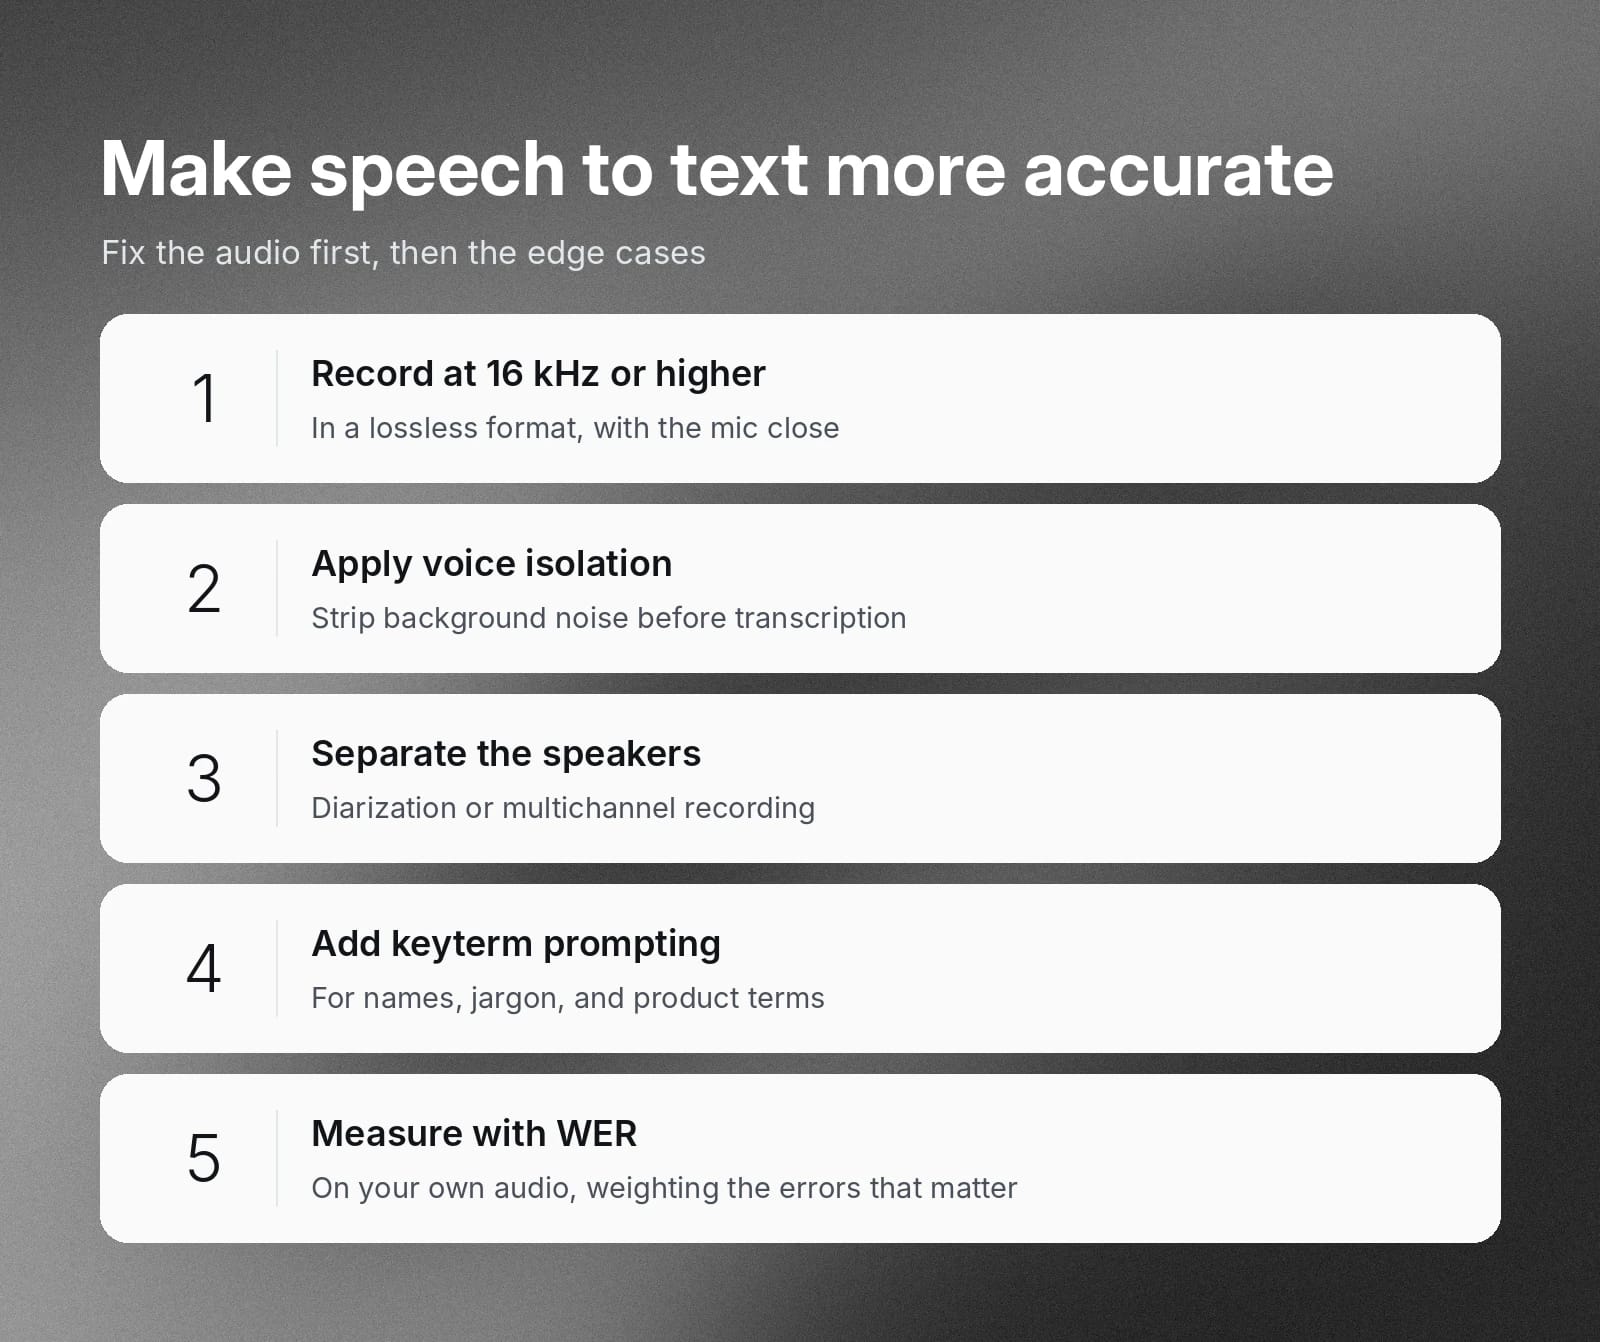
- Neem op met 16 kHz of hoger, gebruik lossless formaten en plaats microfoons vier tot zes inch van de spreker.
- Gebruik voice isolation, diarization of multichannel-opname en keyterm prompting voor ruis, overlappende sprekers en gespecialiseerde woordenschat.
- Meet de nauwkeurigheid met word error rate (WER) en controleer welke fouten het belangrijkst zijn voor je use case.
Wat veroorzaakt problemen met de nauwkeurigheid van Speech to Text?
Stel je voor dat iemand je vraagt een audio-opname te transcriberen van een professor met een sterk accent die complexe theoretische natuurkunde beschrijft, opgenomen in een druk restaurant met achtergrondmuziek en omgevingsgesprekken. Digitale computersystemen zijn niet van nature afgestemd op akoestische variatie. Er is aanzienlijke training en fine-tuning nodig om STT effectief te laten werken, en hoewel moderne AI-tools zeer effectief zijn, kunnen veel problemen de output nog steeds beïnvloeden. Maar als je begrijpt wat die problemen zijn, kun je ze aanpakken in je transcriptieworkflows.
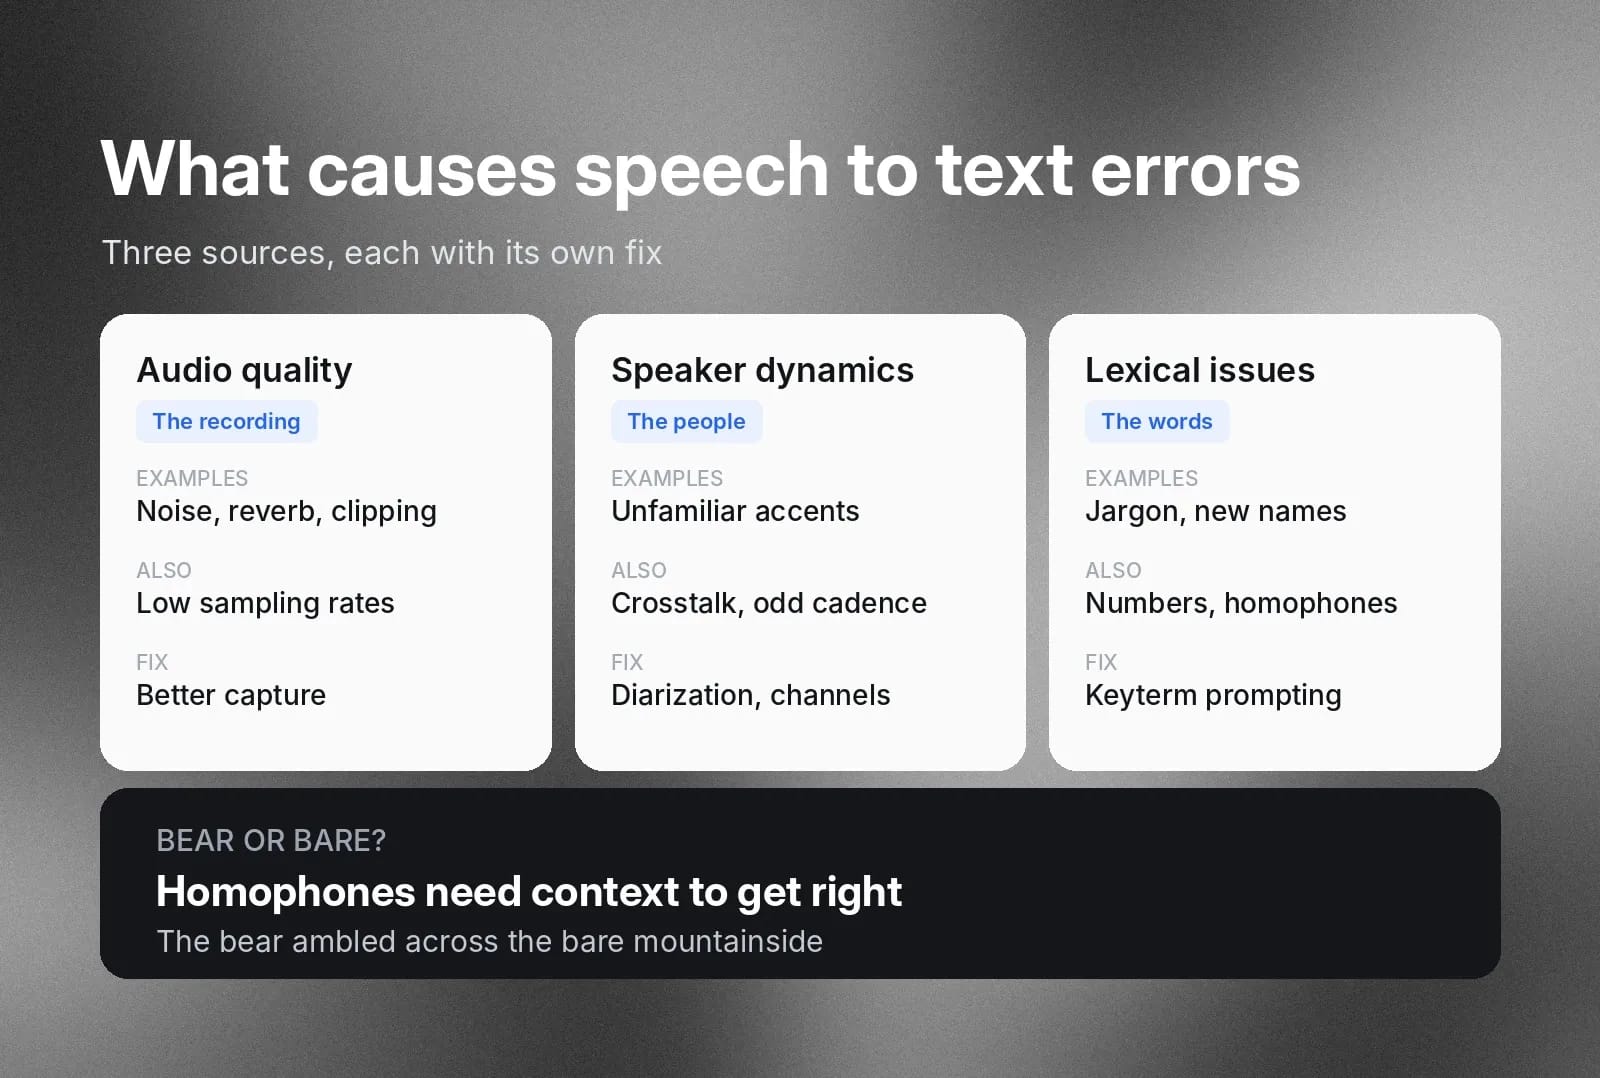
Er zijn drie hoofdoorzaken voor onnauwkeurige Speech to Text-conversie:
- Problemen met de kwaliteit van de audio-input
- Sprekerdynamiek
- Lexicale en contextuele kwesties
Elke oorzaak vereist een andere oplossing, die in de onderstaande secties achtereenvolgens wordt behandeld.
Problemen met de audiokwaliteit
Ten eerste kan de audio-opname zelf problemen bevatten. Problemen met de microfoon kunnen ertoe leiden dat spraak vervormd of afgekapt raakt. Galm door de akoestiek van de locatie, een slechte signaal-ruisverhouding (SNR) in de opname of een lage sample rate kunnen allemaal belangrijke fonetische informatie uit opnamen verwijderen.
Sprekerdynamiek
Een enkele spreker met een neutraal accent die in een rustige locatie spreekt, is relatief eenvoudig te transcriberen. Maar dat is zelden het type opname dat we willen transcriberen. Onbekende accenten en een hakkend of simpelweg niet-traditioneel spreekritme kunnen een STT-model dat is getraind op gestandaardiseerde spraak in de war brengen. Door elkaar praten of overlappende sprekers kunnen ook het vermogen van een model verstoren om nauwkeurig te analyseren wat er wordt gezegd.
Lexicale en contextuele kwesties
Ten slotte kan ook de inhoud van spraak sommige STT-modellen uitdagen. Vakjargon en nieuwe productnamen behoren mogelijk niet tot de taal die een STT-model tijdens de training is tegengekomen. Omdat het de statistisch meest waarschijnlijke output selecteert, is onbekende spraak mogelijk geen belangrijke voorspelling. Ook numerieke of wiskundige uitdrukkingen, of spraak die anders als cijfers zou worden geschreven, worden mogelijk niet duidelijk getranscribeerd.
Homofonen zijn woorden die hetzelfde klinken maar anders worden gespeld. Een STT-model heeft voldoende contextueel begrip nodig om ze van elkaar te onderscheiden. Bijvoorbeeld: “de beer liep over de kale berghelling.” Het model moet weten dat het dier als “beer” wordt gespeld en het bijvoeglijk naamwoord voor een onbedekt oppervlak als “kaal”.
Problemen met de nauwkeurigheid van Speech to Text oplossen, van audio tot output
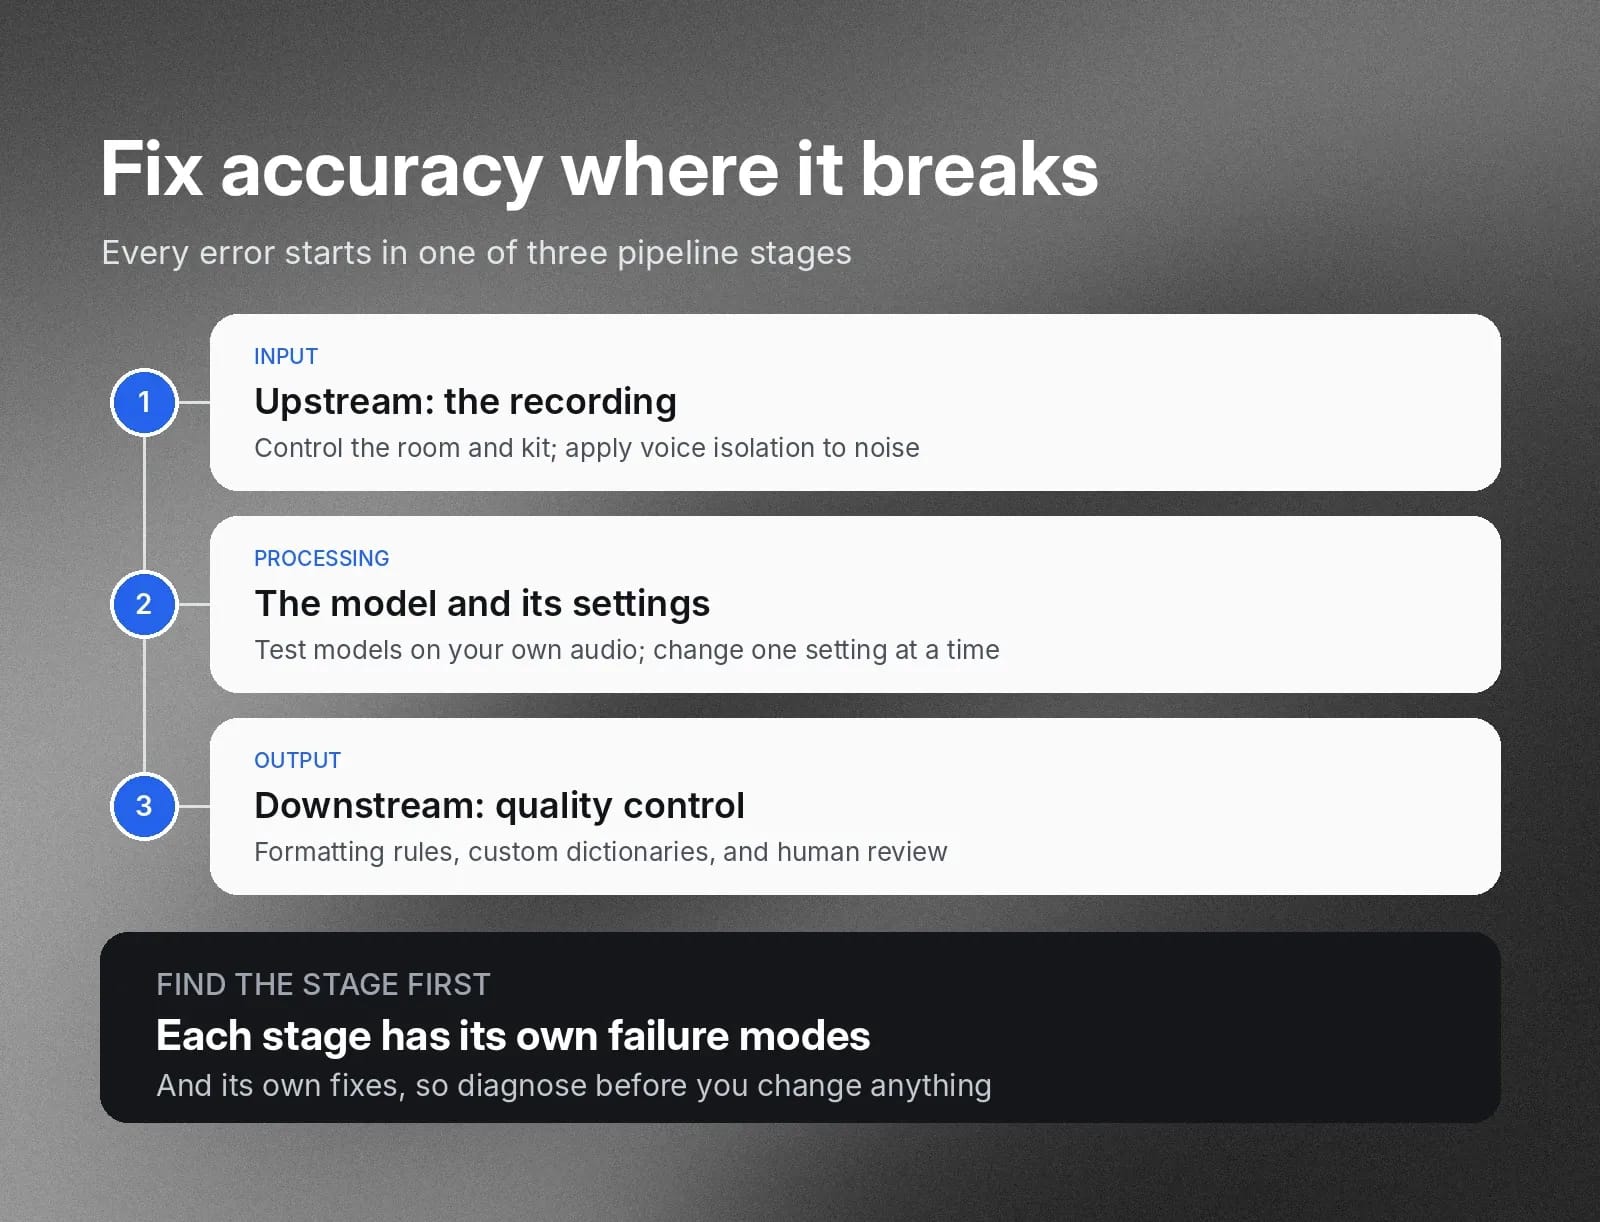
Speech to Text-verwerking vindt plaats in een reeks duidelijk gedefinieerde stappen. Om een nauwkeurigheidsprobleem op te lossen, moet je bepalen waar je in die pipeline een wijziging kunt aanbrengen. Grofweg bestaat het STT-proces uit:
- Input
- Verwerking
- Output
Elke fase heeft eigen foutmodi en eigen oplossingen.
Problemen met de nauwkeurigheid van upstream-input
Er kunnen problemen zijn met de omgeving waarin je opneemt. Veelvoorkomende problemen zijn achtergrondgeluid en echo's. Ook de opnameapparatuur kan een probleem veroorzaken als deze defect is.
Problemen in deze fase oplossen betekent meestal dat je isoleert wat het probleem veroorzaakt en dit verhelpt. Als je bijvoorbeeld weet dat de STT-tool moeite heeft met luide achtergrondgeluiden, is het een goed idee om gesprekken te voeren in een omgeving waar je meer controle over hebt.
Pas voor ruis die je niet kunt vermijden voice isolation toe voordat de audio het model bereikt.
Nauwkeurigheidsproblemen tijdens verwerking
De manier waarop je je API voor een STT-engine configureert, kan de verwerking beïnvloeden. Ook de promptstructuur en het model dat je kiest, kunnen van invloed zijn op de kwaliteit en het aantal onnauwkeurigheden.
Problemen in deze fase oplossen betekent dat je je setup test met je eigen audio. Voer dezelfde voorbeeldopnamen door elk kandidaatmodel, vergelijk hun word error rates en wijzig vervolgens telkens één instelling om verder te verfijnen.
Als een model één type spraak blijft missen, zoals een gesprek met veel ruis of een bepaald regionaal accent, test dan verschillende modellen op nauwkeurigheid in precies de omgeving waarin je ze gaat gebruiken.
Nauwkeurigheidsproblemen in downstream-output
Dit is je kwaliteitscontrolelaag, waar gespecialiseerde processen transcriptiefouten en dubbelzinnigheden opschonen die je primaire engine mogelijk heeft gemist. STT-pipelines gebruiken regelmatig op regels gebaseerde patroonherkenning om opmaak te standaardiseren, bijvoorbeeld door “tien dollar” te veranderen in “$10.00”. Dit proces heet inverse text normalization (ITN). Maar als een spreker een van deze termen op een niet-standaard manier gebruikt of verkeerd uitspreekt, zal een rigide zoek-en-vervangtool dit niet opmerken.
Ook is de vraag of een human-in-the-loop (HITL) de kwaliteit van de output controleert. Zo niet, dan kunnen onnauwkeurigheden in de productie-output terechtkomen. Zoals bij elke activiteit kan ook een mens fouten maken.
In deze fase betekent problemen oplossen dat je de fouten opvangt die je primaire engines achterlaten. Je kunt transcripties met een referentievoorbeeld vergelijken om te zien welke fouten terugkeren, en vervolgens gerichte regels of een aangepast woordenboek toevoegen voor die termen. Voeg vooral bij transcripties met grote gevolgen altijd een menselijke controlestap toe.
De nauwkeurigheid van spraakherkenning verbeteren met betere audio
Het verbeteren van de audiokwaliteit tijdens het opnemen kan veel nauwkeurigheidsproblemen downstream verminderen. Gebruik een hogere sample rate, pas minimale of geen compressie toe en zorg voor een zo helder mogelijke opnameomgeving.
Samplekwaliteit
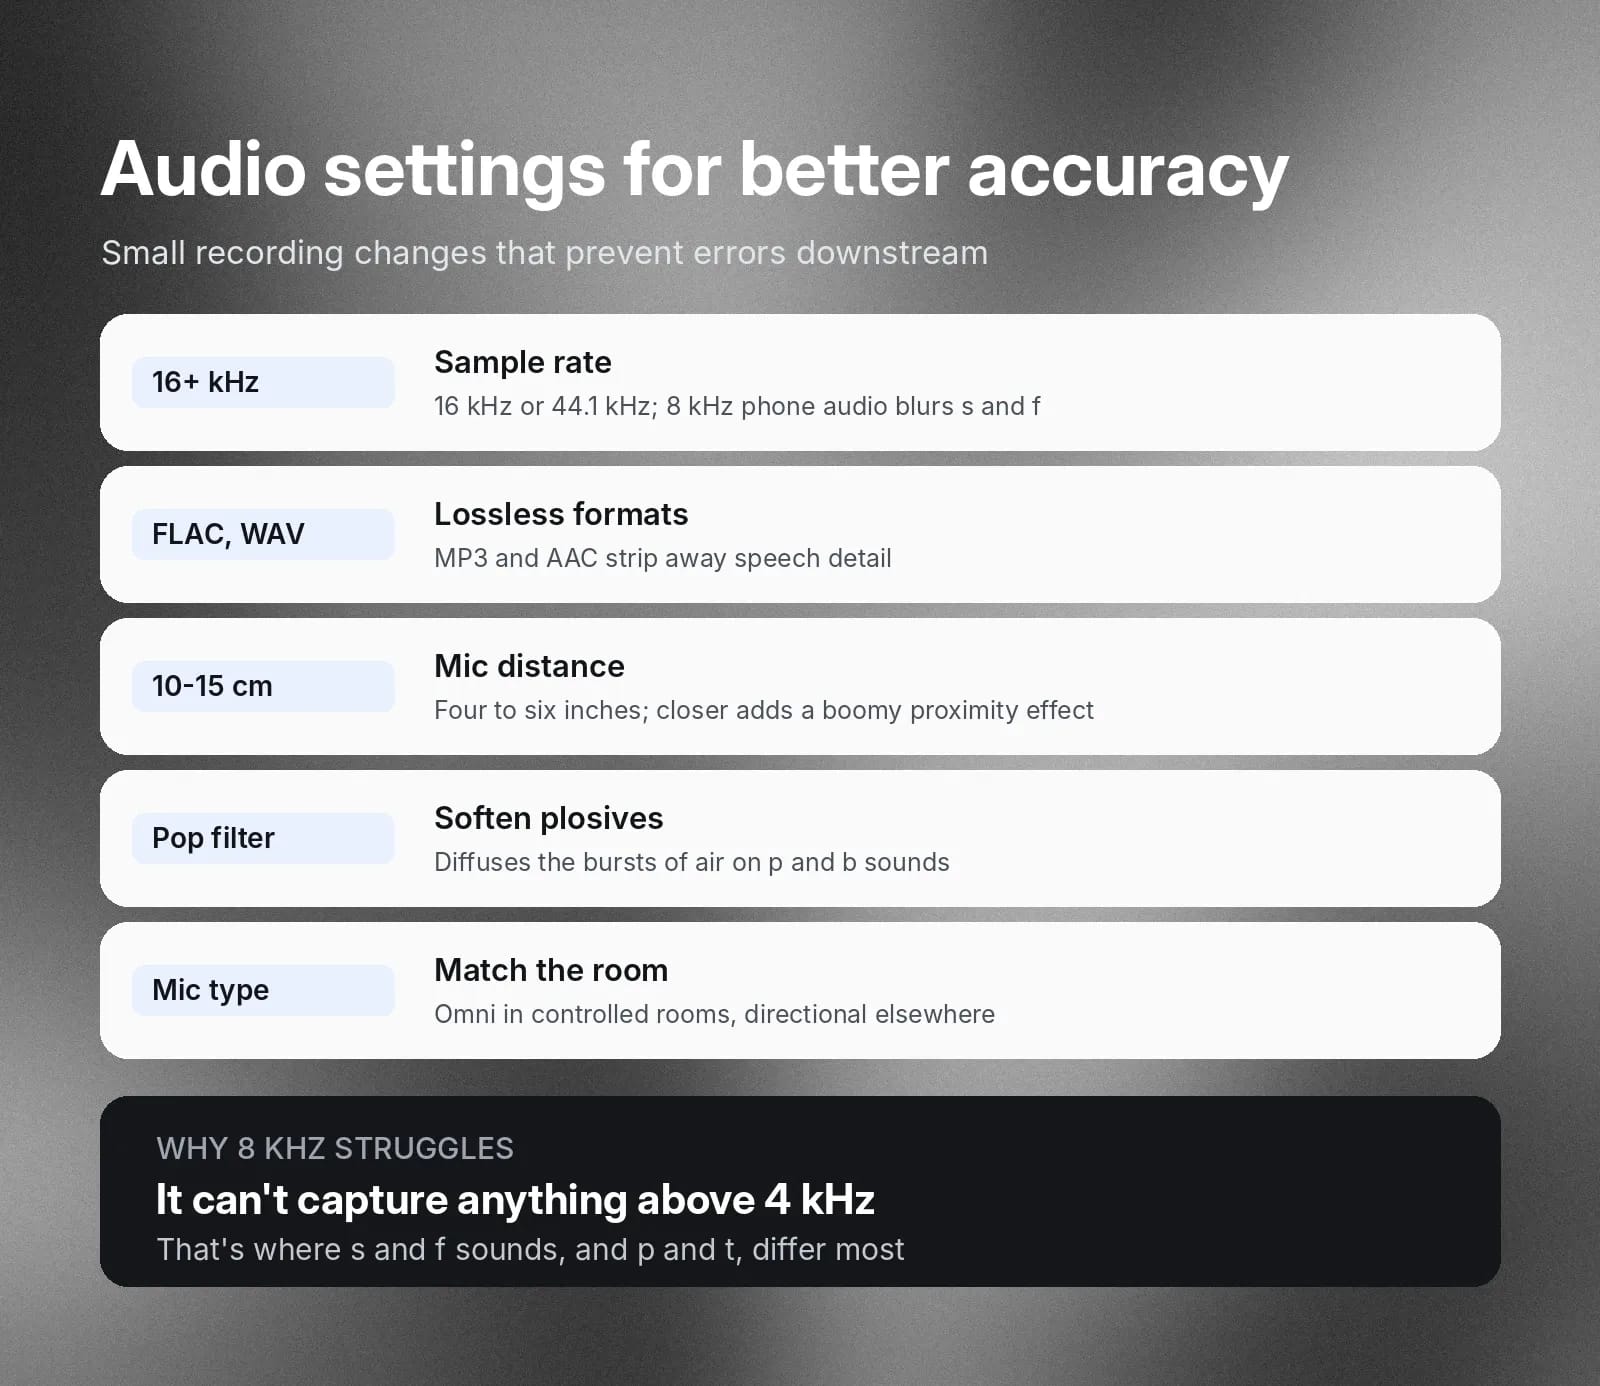
Gebruik audio van 16 kHz of 44,1 kHz voor opnamen. Oude telefonie-audiosampling van 8 kHz en lager kan voor STT-modellen lastig te analyseren zijn. Voor de modellen klinkt deze audio gedempt en vervormd, en ze kunnen sprekers niet vragen zichzelf te herhalen, zoals iemand tijdens een telefoongesprek kan.
Een sample rate kan alleen frequenties reproduceren tot de helft van de sample rate. Dit heet de Nyquist-frequentie van het systeem. Bij slechts 8 kHz valt alles boven 4 kHz weg, waardoor het voor een STT-model specifiek lastig wordt om fricatieven (“s”- tegenover “f”-klanken) en plosieven (“p”- tegenover “t”-klanken) te onderscheiden.
Compressie
Opnemen in lossy formaten, zoals MP3 en AAC, kan ook subtiele spraakdetails verwijderen. Er is dan minder signaal voor het model om mee te werken. Gebruik lossless of ongecomprimeerde formaten, zoals FLAC of PCM WAV.
Opnameomgeving
Volg best practices uit de audiotechniek voor het gebruik van microfoons. Omnidirectionele microfoons werken het best in gecontroleerde omgevingen. Anders zijn directionele microfoons beter om spraak te isoleren. Plaats microfoons vier tot zes inch (10-15 cm) van de mond van een spreker en probeer te voorkomen dat sprekers dichterbij leunen. Dat veroorzaakt een proximity effect en maakt de opname modderig door versterkte lage frequenties.
Gebruik waar mogelijk ook een plopfilter op je microfoon. Plopfilters verspreiden luchtstoten die ontstaan bij het uitspreken van plosieve medeklinkers, zoals “p”- en “b”-klanken.
Verminder achtergrondgeluid voor betere spraakherkenning
Zoals in de vorige sectie is aangegeven, kun je het beste waar mogelijk close-mic-opnamen gebruiken, idealiter vier tot zes inch van de mond van een spreker. Vermijd witte ruis en achtergrondgeluid die opnamen troebel maken. Veelvoorkomende bronnen die je zonder ervaring met veldopnamen misschien niet opmerkt, zijn gezoem van HVAC-systemen, toetsenbordgeklik en algemeen straatgeluid. Al deze geluiden kunnen het vermogen van een STT-model om spraak te analyseren bemoeilijken.
Het is echter vaak niet mogelijk om achtergrondgeluid te vermijden. Pas in dat geval voice isolation toe als voorverwerkingsstap voordat je je audio naar een STT-model stuurt. Voice isolation gebruikt softwarealgoritmen of een lichtgewicht, gespecialiseerd neuraal model om achtergrondgeluid uit spraakopnamen te filteren.
Ga om met accenten, overlappende sprekers en gespecialiseerde woordenschat
Moderne meertalige modellen zijn getraind op diverse spraaksets, maar hun nauwkeurigheidsniveau varieert nog steeds bij audio uit de praktijk. Voer je eigen benchmarks uit voor verschillende modellen met voorbeeldaudio uit relevante demografische groepen. Als je historische servicegesprekken kunt gebruiken, voer die dan door transcriptie: gesprekken met de accenten, ritmes en spraakpatronen die je in de praktijk wilt transcriberen.
Controleer de output op fouten en identificeer relevante patronen. Heeft het model moeite met slang van jongere leeftijdsgroepen? Struikelt het over een specifiek regionaal accent dat je vaak tegenkomt?
Overlappende sprekers aanpakken
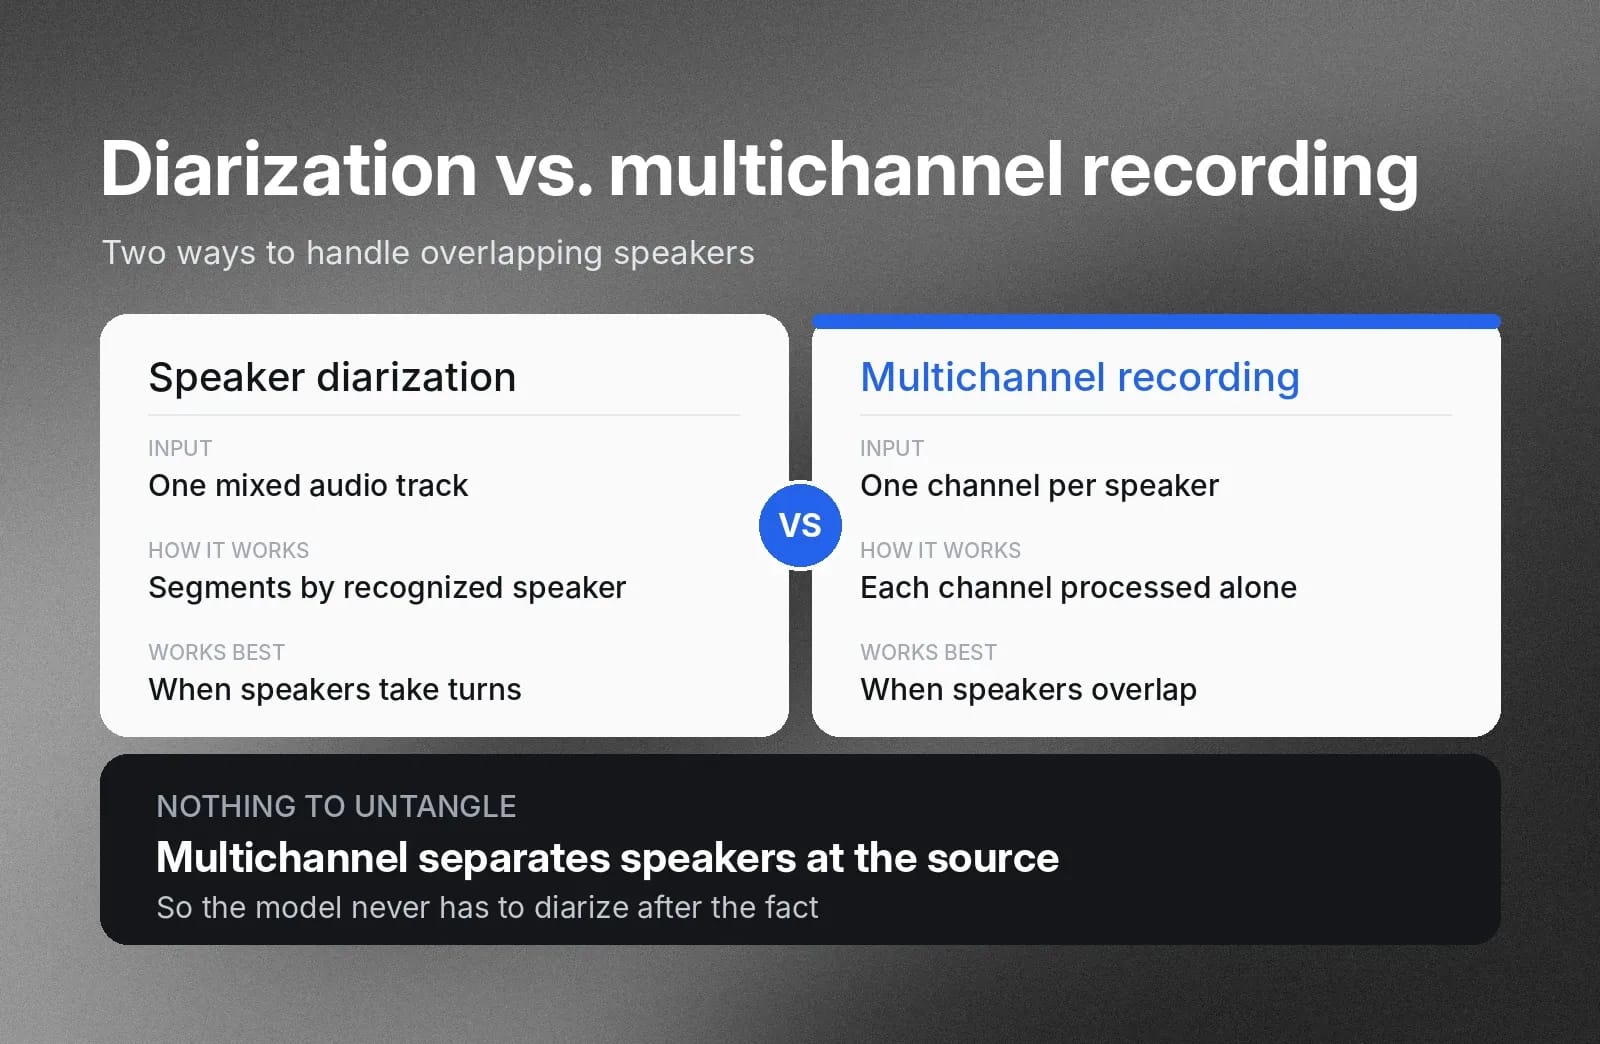
Je twee belangrijkste tools om overlappende spraak nauwkeurig te transcriberen zijn diarization en multichannel-opname. Een diarization-proces neemt ruwe audio-input en segmenteert deze per afzonderlijk herkende spreker. Het werkt goed wanneer sprekers duidelijk om beurten praten.
In plaats van alle spraakstromen in één audiotrack te mengen, kun je met native multichannel-opname elke spreker op een apart kanaal houden. Het STT-model kan die kanalen afzonderlijk herkennen en verwerken. Elke spreker is native gescheiden in de opname, dus een spraakmodel hoeft achteraf niets te diarizen.
Keyterm prompting zorgt voor positieve bias
Merknamen, nieuwe productnamen, vakjargon en andere unieke termen worden vaak niet nauwkeurig getranscribeerd als ze niet in de trainingsdata van een STT-model stonden. Keyterm prompting is het proces waarbij je een STT-model specifieke spellingen geeft die het moet bevoordelen. Dit zijn meestal geen één-op-één vervangingsprompts; je stuurt het model alleen richting de aangepaste spelling die je op basis van de context wilt.
Transcribeer nummers, ID's en medicijnnamen nauwkeurig
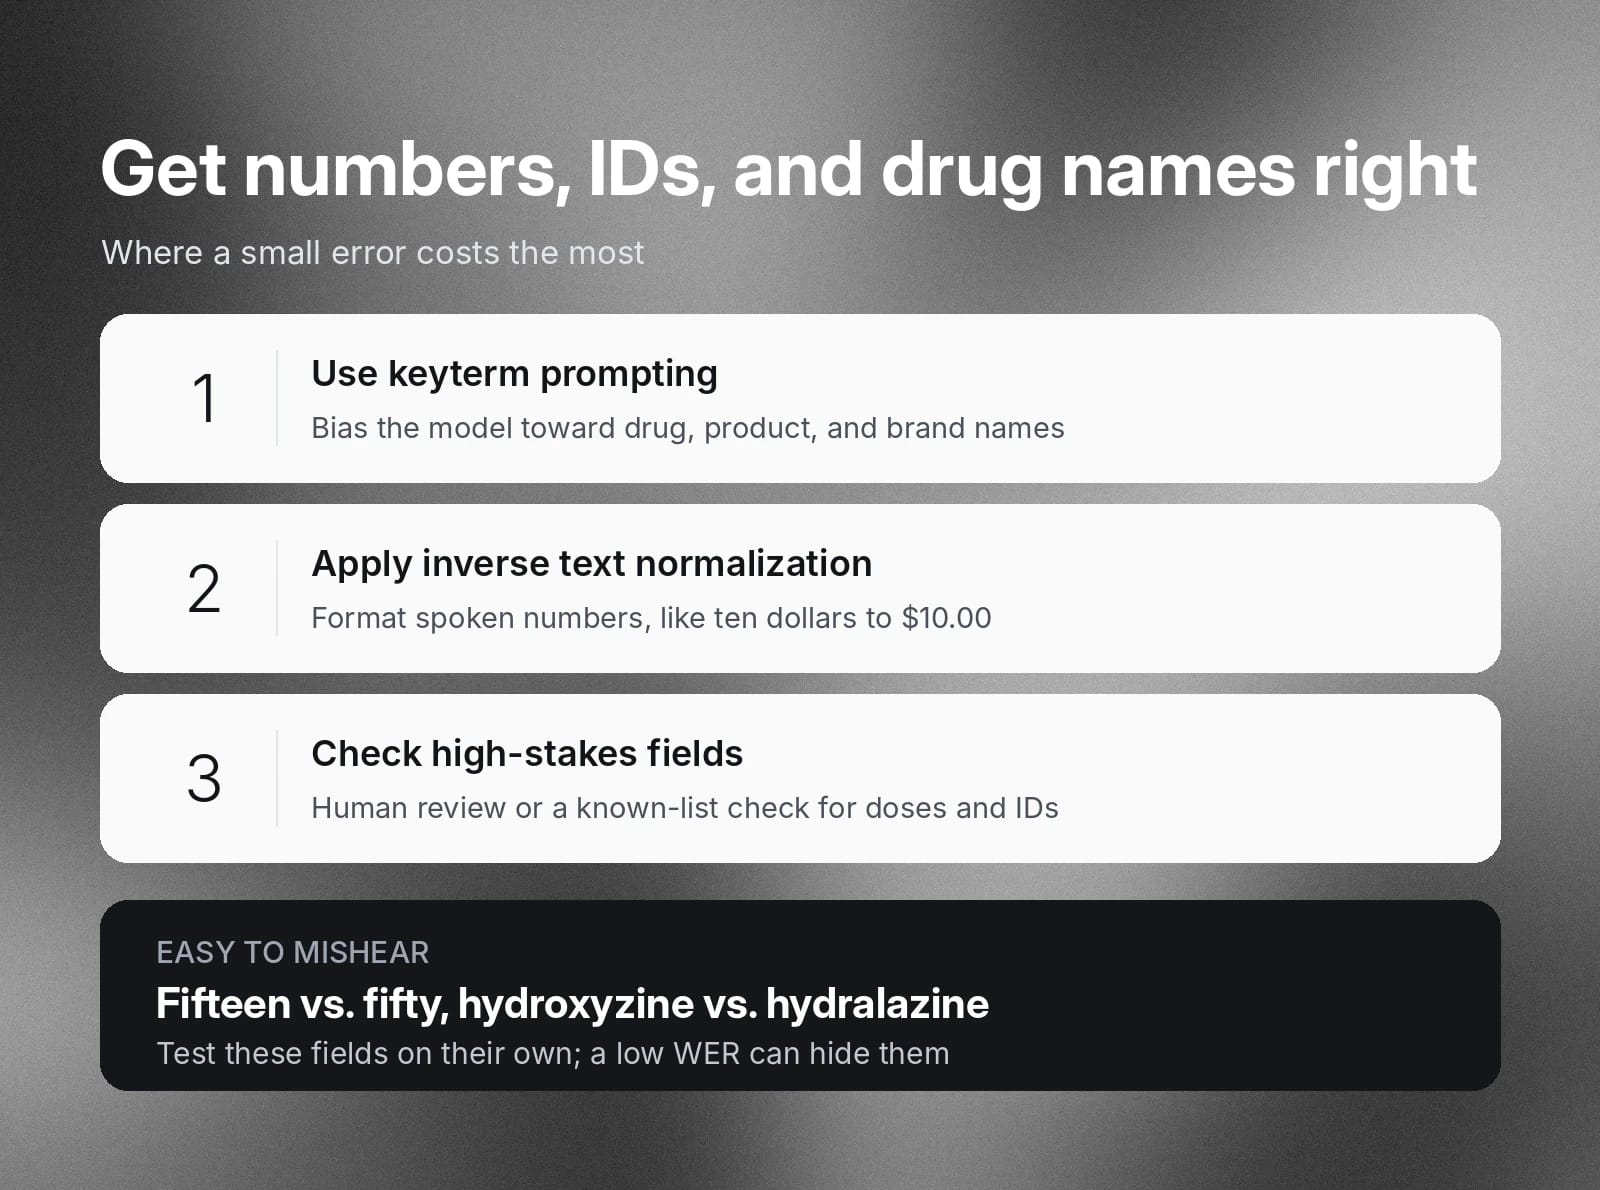
Bij nummers, account-ID's, postcodes en medicijnnamen heeft een kleine fout de grootste gevolgen. Een model kan “vijftien” verstaan als “vijftig”, of twee medicijnnamen verwarren die één lettergreep verschillen, zoals hydroxyzine en hydralazine.
Drie stappen helpen:
- Gebruik keyterm prompting: Stuur het model richting de spellingen van medicijnnamen, productnamen en andere termen die je verwacht.
- Pas inverse text normalization (ITN) toe: Formatteer uitgesproken getallen consequent, bijvoorbeeld door “tien dollar” te veranderen in “$10.00”.
- Voeg een controle toe voor velden met grote gevolgen: Gebruik menselijke controle of een geautomatiseerde controle op basis van een bekende lijst voor velden zoals medicijndoseringen en rekeningnummers.
Test deze velden afzonderlijk, want een lage totale WER kan fouten verbergen in precies de woorden die er het meest toe doen.
Meet kwaliteit met word error rate bij spraakherkenning
Word error rate (WER) is een nuttige meetwaarde om de nauwkeurigheid van een STT-engine te beoordelen. Je kunt de WER vergelijken tussen verschillende modeltests om inzicht te krijgen in hun relatieve nauwkeurigheid.
Zo wordt WER berekend:
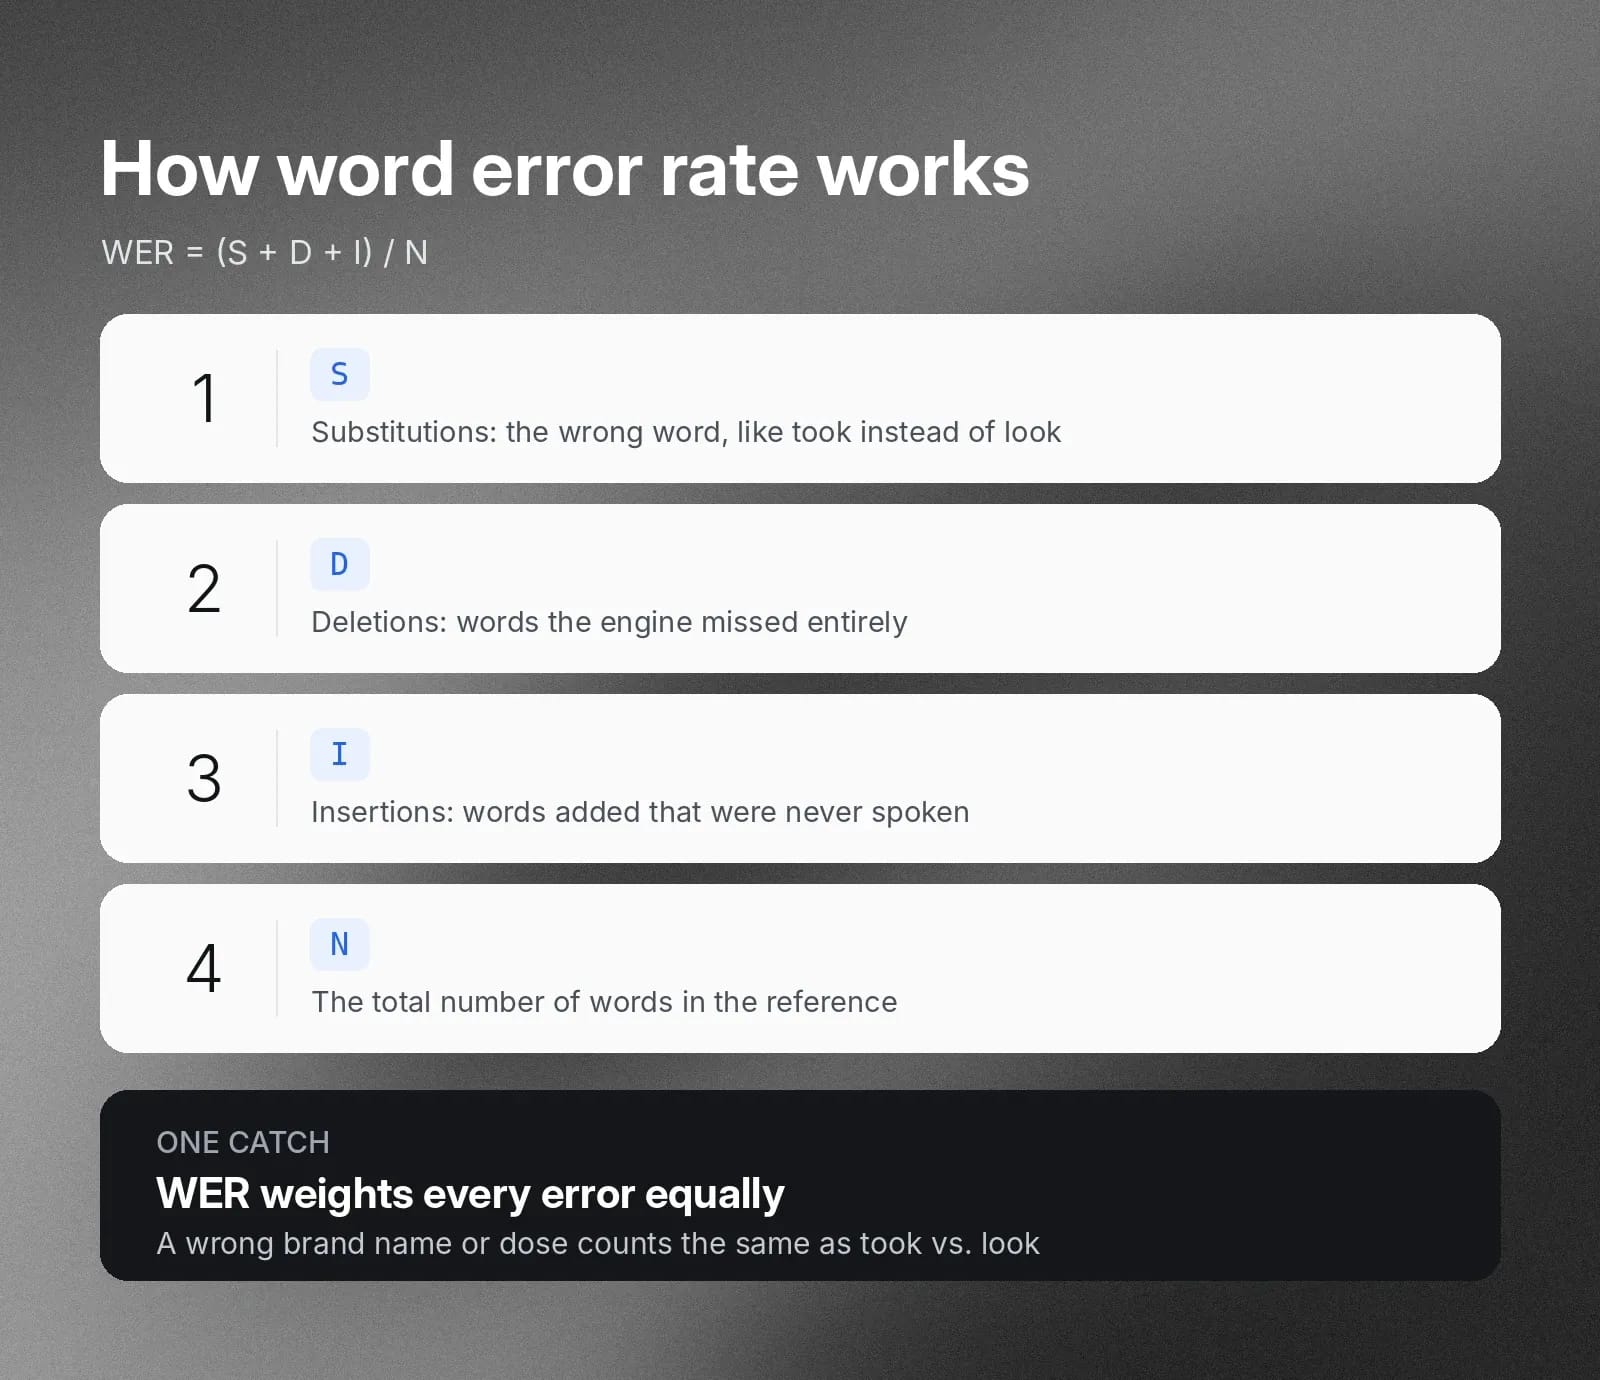
WER = (S + D + I) / N
- Vervangingen (S): Het aantal keren dat de STT-engine in een transcriptie het verkeerde woord output (bijvoorbeeld "took" in plaats van "look").
- Verwijderingen (D): Het aantal woorden dat volledig is gemist.
- Invoegingen (I): Het aantal woorden dat is toegevoegd maar nooit is uitgesproken.
- Totaal aantal referentiewoorden (N): Het totale aantal woorden in de gesproken voorbeeldinput.
Het is belangrijk om te weten dat WER alle fouten even zwaar weegt. Zo telt het vervangen van “took” door “look” even zwaar als het verkeerd herkennen van je merknaam of een belangrijk getal, zoals de omvang van een medicijndosis. Controleer de WER's voor verschillende modellen.
Wat wordt beschouwd als een goede word error rate?
Er is niet één goede WER, omdat het juiste doel afhangt van je audio en je use case. Schone audio met één spreker levert veel lagere foutpercentages op dan gesprekken met ruis en overlappende sprekers. Vergelijk modellen op je eigen opnamen in plaats van af te gaan op één opvallend getal.
Als referentiepunt voor gespecialiseerde audio behoort Scribe v2 Medical tot de best presterende modellen op openbare medische ASR-benchmarks. Bekijk de huidige benchmarkresultaten voor de meest recente cijfers.
Benchmarkresultaten veranderen wanneer nieuwe modellen worden uitgebracht. Controleer de actuele resultaten voordat je vergelijkt.
Nauwkeurigheid versus precisie: wat transcriptieteams moeten meten
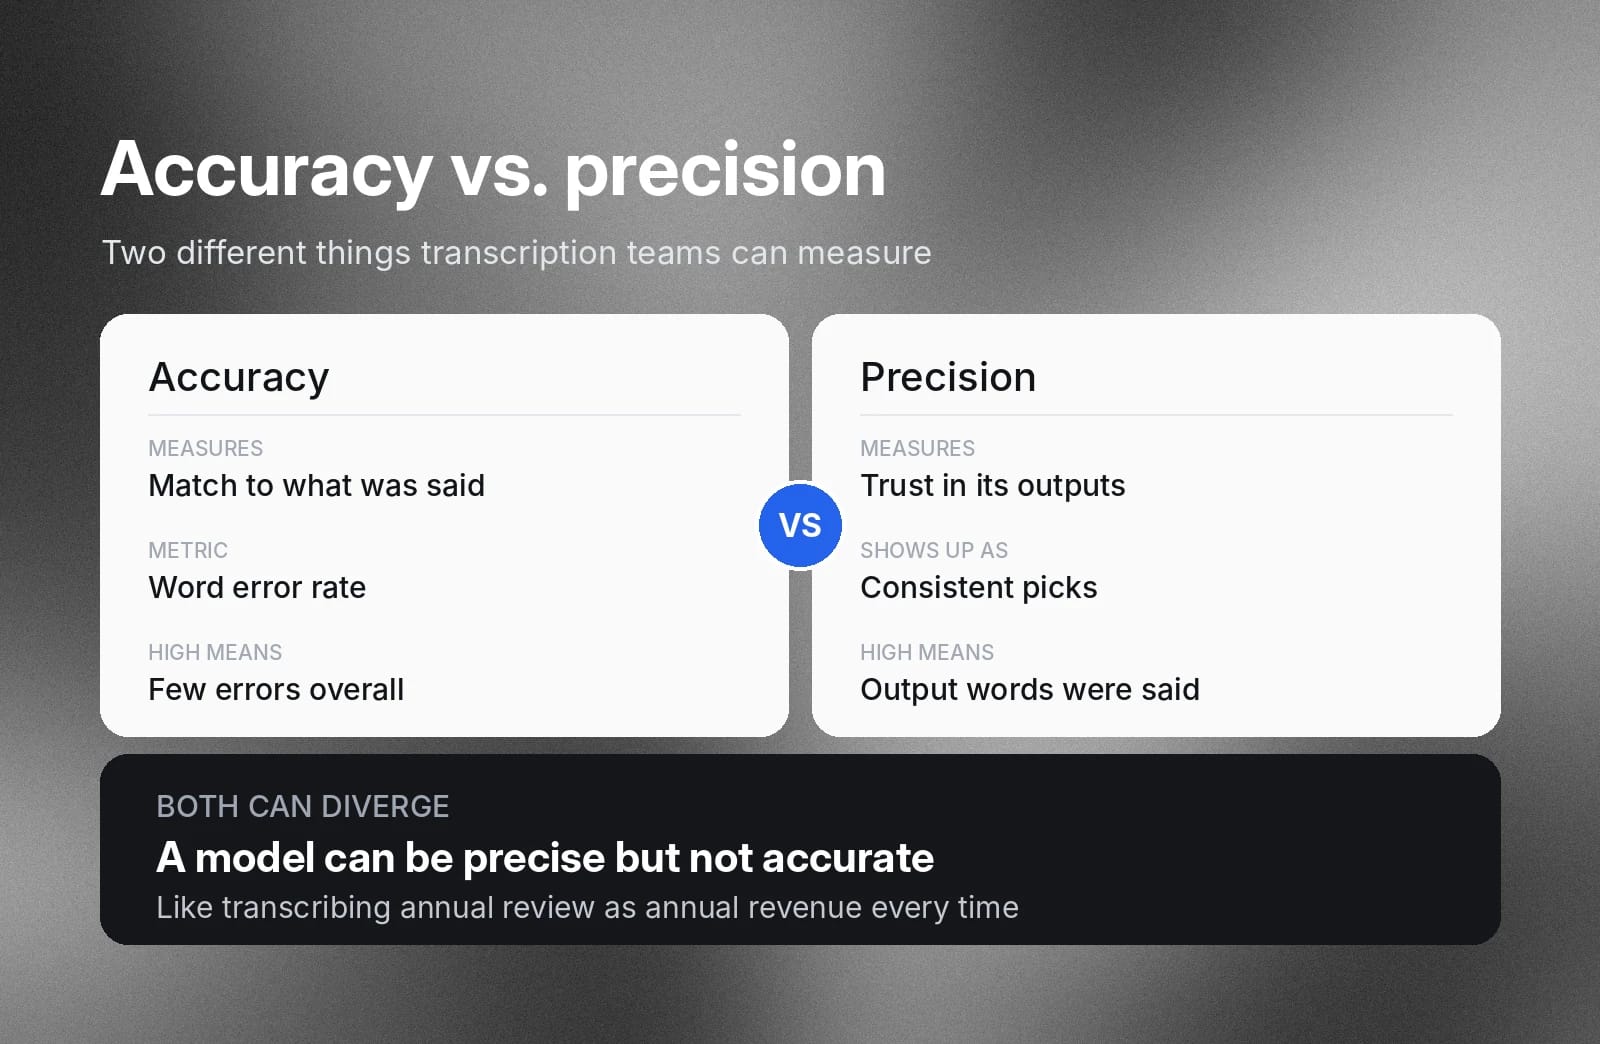
Nauwkeurigheid is de mate waarin de transcriptie-output overeenkomt met de gesproken “ground truth”-input. Word error rate meet nauwkeurigheid.
Precisie is de betrouwbaarheid van de positieve voorspellingen van het STT-model. Een zeer precies model kiest bij complexe spraak in meerdere uitvoeringen hetzelfde woord. Als het model een woord output, kun je erop vertrouwen dat dit woord in de spraak aanwezig was. Maar een zeer precies model kan nog steeds een lage nauwkeurigheid hebben, wat betekent dat het veel woorden verwijdert.
Ga aan de slag met ElevenAPI voor nauwkeurigere transcriptie
ElevenAPI geeft je toegang tot Scribe v2, het Speech to Text-model van ElevenLabs, samen met functies die de nauwkeurigheidsproblemen uit deze gids aanpakken: keyterm prompting voor namen en jargon, multichannel-transcriptie voor overlappende sprekers en speaker diarization.
Als je wilt transcriberen zonder de API te gebruiken, kun je ook ElevenCreateive STT gebruiken.
Ga vandaag nog aan de slag met hoogwaardige Speech to Text via ElevenAPI of lees meer over de Speech to Text-mogelijkheden van ElevenAPI.
Veelgestelde vragen over de nauwkeurigheid van Speech to Text

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.