Scribe v2 Medical is nu voor iedereen beschikbaar
- Geschreven door
- Min Kim
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Klinische audio is een van de lastigste tests voor nauwkeurige spraakherkenning. Medicijnnamen zijn lang, zeldzaam en gemakkelijk te verwarren (hydroxyzine en hydralazine verschillen maar één verkeerd verstaan lettergreep). De woordenschat is dicht op elkaar gepakt, met doseringen, eenheden en termen uit de anatomie en pathologie die snel achter elkaar kunnen komen. Er staat ook meer op het spel, omdat een transcriptiefout in het patiëntendossier terecht kan komen.
Daarom brengt ElevenLabs vandaag Scribe v2 Medical uit, ons voor klinische audio gefinetunede Speech to Text-model, dat nu algemeen beschikbaar is op ElevenAPI. In de onderstaande evaluaties behaalt het consequent een van de laagste woordfoutpercentages (WER) van de vergeleken modellen en verlaagt het de WER voor klinische audio met ongeveer 35% vergeleken met ons basismodel Scribe v2.
Modellen voor algemene doeleinden kunnen alledaagse spraak goed verwerken, maar kunnen minder goed presteren waar klinische workflows ze het hardst nodig hebben. We hebben een medische finetune van Scribe v2 getraind, gericht op medicijnnamen en klinische dictering, op openbare benchmarks die iedereen kan reproduceren.
Scribe v2 Medical is geoptimaliseerd voor klinische toepassingen
Klinische dictering (MedDictate)
MedDictate van Corti test de transcriptie van gedicteerde klinische notities, waaronder medicijnnamen, doseringen en eenheden die direct achter elkaar voorkomen in het Engels, Frans en Duits. In onze evaluatie behaalt Scribe v2 Medical de laagste totale WER van de modellen die we hebben getest, en een ongeveer 35% lagere WER dan het basis-Scribe v2.
Model
EN
FR
DE
Totale WER
Scribe v2 Medical
3.0%
8.3%
7.2%
4.9%
OpenAI GPT Transcribe
3.9%
7.8%
9.6%
5.9%
Scribe v2 (basis)
5.0%
10.7%
11.7%
7.6%
Muse Voice Transcribe 1.0
4.5%
11.0%
13.3%
7.8%
Deepgram Nova-3 Medical*
5.5%
-
-
-
*Alleen Engels (24 clips) - Deepgram Nova-3 Medical ondersteunt geen Frans of Duits.
Medische terminologie (MedTerm)
MedTerm is eveneens een door Corti gepubliceerde dataset en bevat een benchmark voor klinische terminologie met 600 samples in dezelfde drie talen, waarbij de medische termen in elk sample zijn geannoteerd. Dankzij die annotatie kunnen modellen naast de WER van het volledige transcript op twee andere dimensies worden beoordeeld. Termherkenning is het percentage geannoteerde medische termen dat correct in het transcript voorkomt (hoger is beter). Term-WER is het foutpercentage voor alleen die termen, zonder de gewone spraak eromheen mee te nemen (lager is beter).
Scribe v2 Medical voert alle geteste modellen aan op beide dimensies en presteert beter dan elke andere aanbieder in alle drie de talen:
Model
Termherkenning ↑
Term-WER ↓
Scribe v2 Medical
77.7%
10.4%
Scribe v2 (basis)
77.1%
10.7%
OpenAI GPT Transcribe
74.0%
12.3%
Muse Voice Transcribe 1.0
73.4%
12.9%
Deepgram Nova-3 Medical*
72.5%
13.6%
Eka Medical ASR-benchmark
De Eka Medical ASR-benchmark bevat 3.619 Engelse klinische audiosamples — van afzonderlijke namen van medicijnen en aandoeningen tot klinische zinnen en gesprekken tussen zorgverleners en patiënten — met annotaties per term en een gepubliceerd leaderboard op de datasetkaart.
Omdat de gepubliceerde dataset oudere modellen bevat, zoals Gemini 2.5 Flash en GPT-4o, hebben we de evaluatie uitgevoerd met nieuwere modellen. SemWER (semantische WER) beoordeelt of het model de juiste inhoud heeft gehoord, ongeacht de opmaak ("mg" en "milligram" tellen als hetzelfde antwoord), en kwWER (WER voor keywords) past dezelfde beoordeling alleen toe op de geannoteerde medische keywords.
Model
semWER
kwWER
Scribe v2 Medical
6.50%
6.02%
Scribe v2 (basis)
7.35%
7.04%
Deepgram Nova-3 Medical
7.79%
7.65%
Muse Voice Transcribe 1.0
8.85%
8.99%
OpenAI GPT Transcribe
13.90%
13.20%
Eka annoteert de medische termen in elk sample, waardoor we de verbeteringen van Scribe v2 Medical ten opzichte van het basismodel gedetailleerder kunnen beoordelen op alleen de medische termen. Scribe v2 Medical maakt 15% minder fouten dan het basismodel (9.5% versus 11.1%), en de verbeteringen zijn het grootst wanneer termen in volledige klinische zinnen voorkomen (7.5% versus 9.9%).
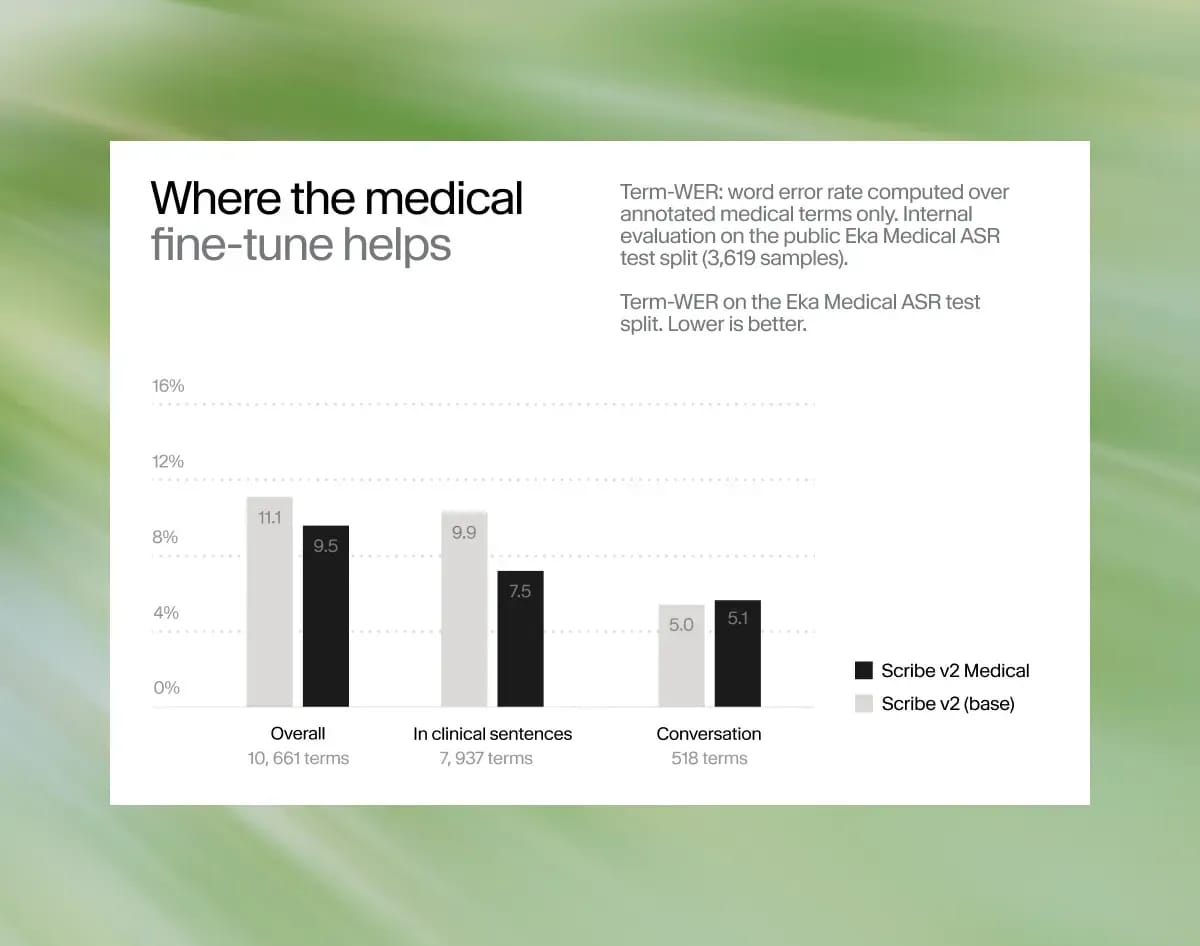
Een kanttekening bij dezelfde data is dat geïsoleerde clips met één woord (een losse medicijnnaam zonder omringende context) voor elk model op het leaderboard, waaronder Scribe v2 Medical, het moeilijkste geval blijven. Het scoorde 14.3% WER op geïsoleerde termen, vergeleken met 7.5% wanneer die termen in zinnen voorkomen. Zonder context kan een verkeerd verstaan lettergreep tot opvallende fouten leiden:
- etodolac (een NSAID) → "It'll do the luck"
- levomilnacipran (een antidepressivum) → "Leave me alone now, Sephora."
- methdilazine (een antihistaminicum) → "Let's play our scene."
Een manier om deze fouten te verminderen is keyterm prompting, waarmee je medicijnnamen of medische uitdrukkingen kunt markeren om het model te sturen deze correct te transcriberen.
Klanten in productie
Klanten gebruiken Scribe v2 Medical al in productie en zien verbeteringen in klinische audio.
"Sinds we van Deepgram zijn overgestapt op ElevenLabs Scribe v2 Medical, zien we een veel hogere nauwkeurigheid voor klinische terminologie, en dat heeft veranderd hoe het team werkt", zegt Mendel Erlenwein, CEO en oprichter van CareCo. "Wanneer onze coördinatoren de transcripten vertrouwen, hoeven ze minder tijd te besteden aan het corrigeren van notities en kunnen ze meer tijd aan de telefoon doorbrengen met patiënten. Onze patiënten volgen complexe behandelregimes en de notitie die het zorgteam leest, moet kloppen."
Sterke prestaties bij algemene spraak
Het team heeft ook geverifieerd dat de medische finetune de prestaties op andere gebieden niet verslechtert. Op 6.000 samples van alledaagse, niet-medische spraak afgeleid van Common Voice, scoort Scribe v2 Medical afgerond hetzelfde als het basis-Scribe v2: in beide gevallen een WER van 5.3%. Met v2 Medical profiteer je dus van een gespecialiseerd medisch model zonder nauwkeurigheid op deze benchmark in te leveren.
Ontworpen voor beschermde gezondheidsinformatie
Scribe v2 Medical komt in aanmerking voor HIPAA voor enterprise-klanten met Business Associate Agreements en met Zero Retention Mode (ZRM) ingeschakeld.
Wanneer ZRM is ingeschakeld voor requests naar de Speech to Text API, worden audio-invoer en tekstuitvoer onmiddellijk verwijderd nadat elke request is voltooid. ElevenLabs bewaart geen van beide en je applicatie ontvangt de volledige API-response en bepaalt hoe transcripten worden bewaard.
Aan de slag
Scribe v2 Medical is beschikbaar via de Speech to Text API. Geef eenvoudig de nieuwe model-id door: scribe_v2_medical
Het model draait op de batch-Speech to Text-endpoint.