
AI-dubbing-API: Audio en video op schaal nasynchroniseren
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Enkele decennia geleden betekende een video nasynchroniseren dat je een studio moest boeken, stemacteurs voor je doeltaal moest inhuren, elke zin moest opnemen (en opnieuw opnemen) en vervolgens weken moest wachten op de uiteindelijke oplevering.
Een AI-dubbing-API brengt dat proces terug tot een paar REST-calls. Stuur je audio of video en ontvang nagesynchroniseerde output in nieuwe talen, met behoud van de oorspronkelijke timing en emotionele reikwijdte.
In deze gids leggen we uit hoe een AI-dubbing-API werkt en wat een productieklare API onderscheidt van een in elkaar gezette pipeline. We bekijken ook hoe je de nieuwe Dubbing API van ElevenLabs, die nu Dubbing v2, ons nieuwste nasynchronisatiemodel, biedt, in elke workflow integreert.
Samenvatting
- Een AI-dubbing-API neemt bronmateriaal in audio of video en levert nagesynchroniseerde output in nieuwe talen.
- Dubbing v2 is een audio-naar-audiomodel dat de oorspronkelijke uitvoering als uitgangspunt neemt, waardoor emotie, toon en voordracht in elke nasynchronisatie behouden blijven.
- De ElevenLabs Dubbing API ondersteunt meer dan 90 talen met vertaling die rekening houdt met synchronisatie.
- Ontwikkelaars maken een nasynchronisatieproject, voegen doeltalen toe en downloaden voltooide nasynchronisaties met een handvol REST-calls.
- Enterprise-klanten kunnen brontranscripten en vertalingen bewerken en daarna alleen de gewijzigde segmenten opnieuw genereren.
Wat is een AI-dubbing-API?
Een AI-dubbing-API is een programmatische interface die audio of video in één taal accepteert en nagesynchroniseerde audio in doeltalen terugstuurt. De API automatiseert de volledige lokalisatieketen: de bron transcriberen, de dialoog vertalen, de stem van elke spreker klonen, spraak genereren in de doeltaal en de output afstemmen op de oorspronkelijke timing.
Ontwikkelaars hebben weliswaar Speech to Text, machinevertaling en Text to Speech-services gekoppeld tot geïmproviseerde nasynchronisatiepipelines, maar die zijn niet betrouwbaar voor workloads op schaal.
De identiteit van de spreker raakt tussen fasen versnipperd, de timing kan verschuiven en een script dat eerst emotioneel rijk was, wordt monotoon.
Een speciaal ontwikkelde dubbing-API bevat extra functies die deze problemen oplossen. Van sprekersscheiding en stembehoud tot interne synchronisatie en stemklonen: met een hoogwaardige AI-dubbing-API klinkt de output als de oorspronkelijke spreker in plaats van als een vlakke vertaling.
Hoe AI-dubbing werkt: audio naar audio versus cascaderende pipelines
De meeste geautomatiseerde nasynchronisatiesystemen zijn cascaderende pipelines. Ze transcriberen de bronaudio, vertalen het transcript en synthetiseren nieuwe spraak op basis van die tekst. Alles wat verder gaat dan het ruwe transcript, zoals aarzeling, spanning, sarcasme of een gefluisterde opmerking terzijde, gaat verloren voordat de synthese begint.
ElevenLabs Dubbing v2 kiest voor een andere aanpak.
Dubbing v2 biedt een audio-naar-audiomodel dat de output rechtstreeks baseert op de oorspronkelijke opname, in plaats van op een transcript daarvan. Toon, emotie en emotioneel register komen mee in de nasynchronisatie, omdat het model de uitvoering hoort in plaats van een beschrijving ervan leest.
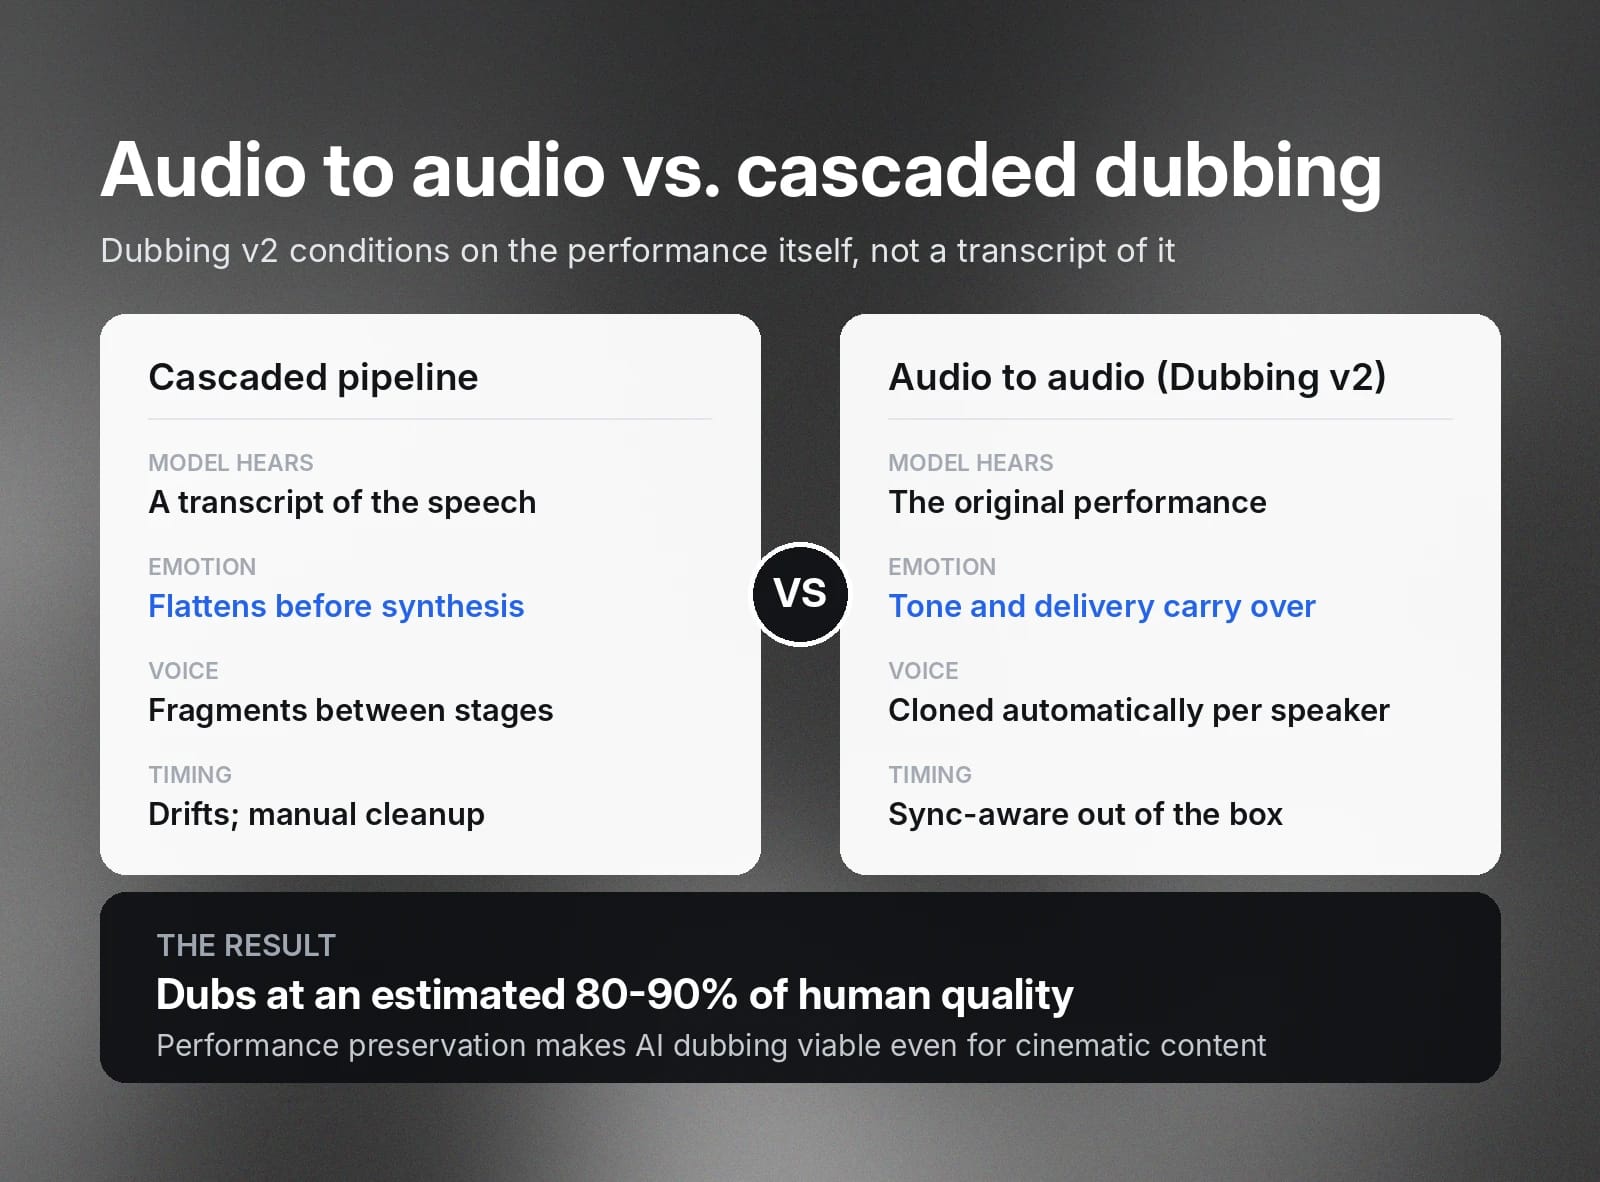
We schatten dat Dubbing v2 nasynchronisaties produceert die 80-90% van menselijke kwaliteit halen. Daardoor werkt AI-dubbing nu ook voor filmische content.
Drie andere kernmogelijkheden maken Dubbing v2 compleet:
- Vertaling met oog voor synchronisatie: Het model vertaalt met de timing in gedachten, zodat het begin en einde van de nagesynchroniseerde audio standaard aansluiten op het origineel. Er is geen videobewerking of lipsynchronisatie nodig. De audio komt precies op de plek waar de oorspronkelijke dialoog stond.
- Automatisch stemklonen: Elke vertaling wordt geleverd met een stemkloon van de oorspronkelijke spreker, zonder handmatige kloonstap. De sprekeridentiteit, toonhoogte en klankkleur blijven behouden in elke ondersteunde taal, ook bij meerdere sprekers.
- Nauwkeurigheid op locatieniveau: Dubbing v2 onderscheidt regionale varianten, zoals Latijns-Amerikaans of Castiliaans Spaans, met locatie-instellingen via taalcodes zoals pt-BR voor Braziliaans Portugees.
Waar je op moet letten bij een AI-dubbing-API
Bij het beoordelen van een AI-dubbing-API voor je ontwikkelaarspipeline zijn er een paar belangrijke criteria om op te letten.
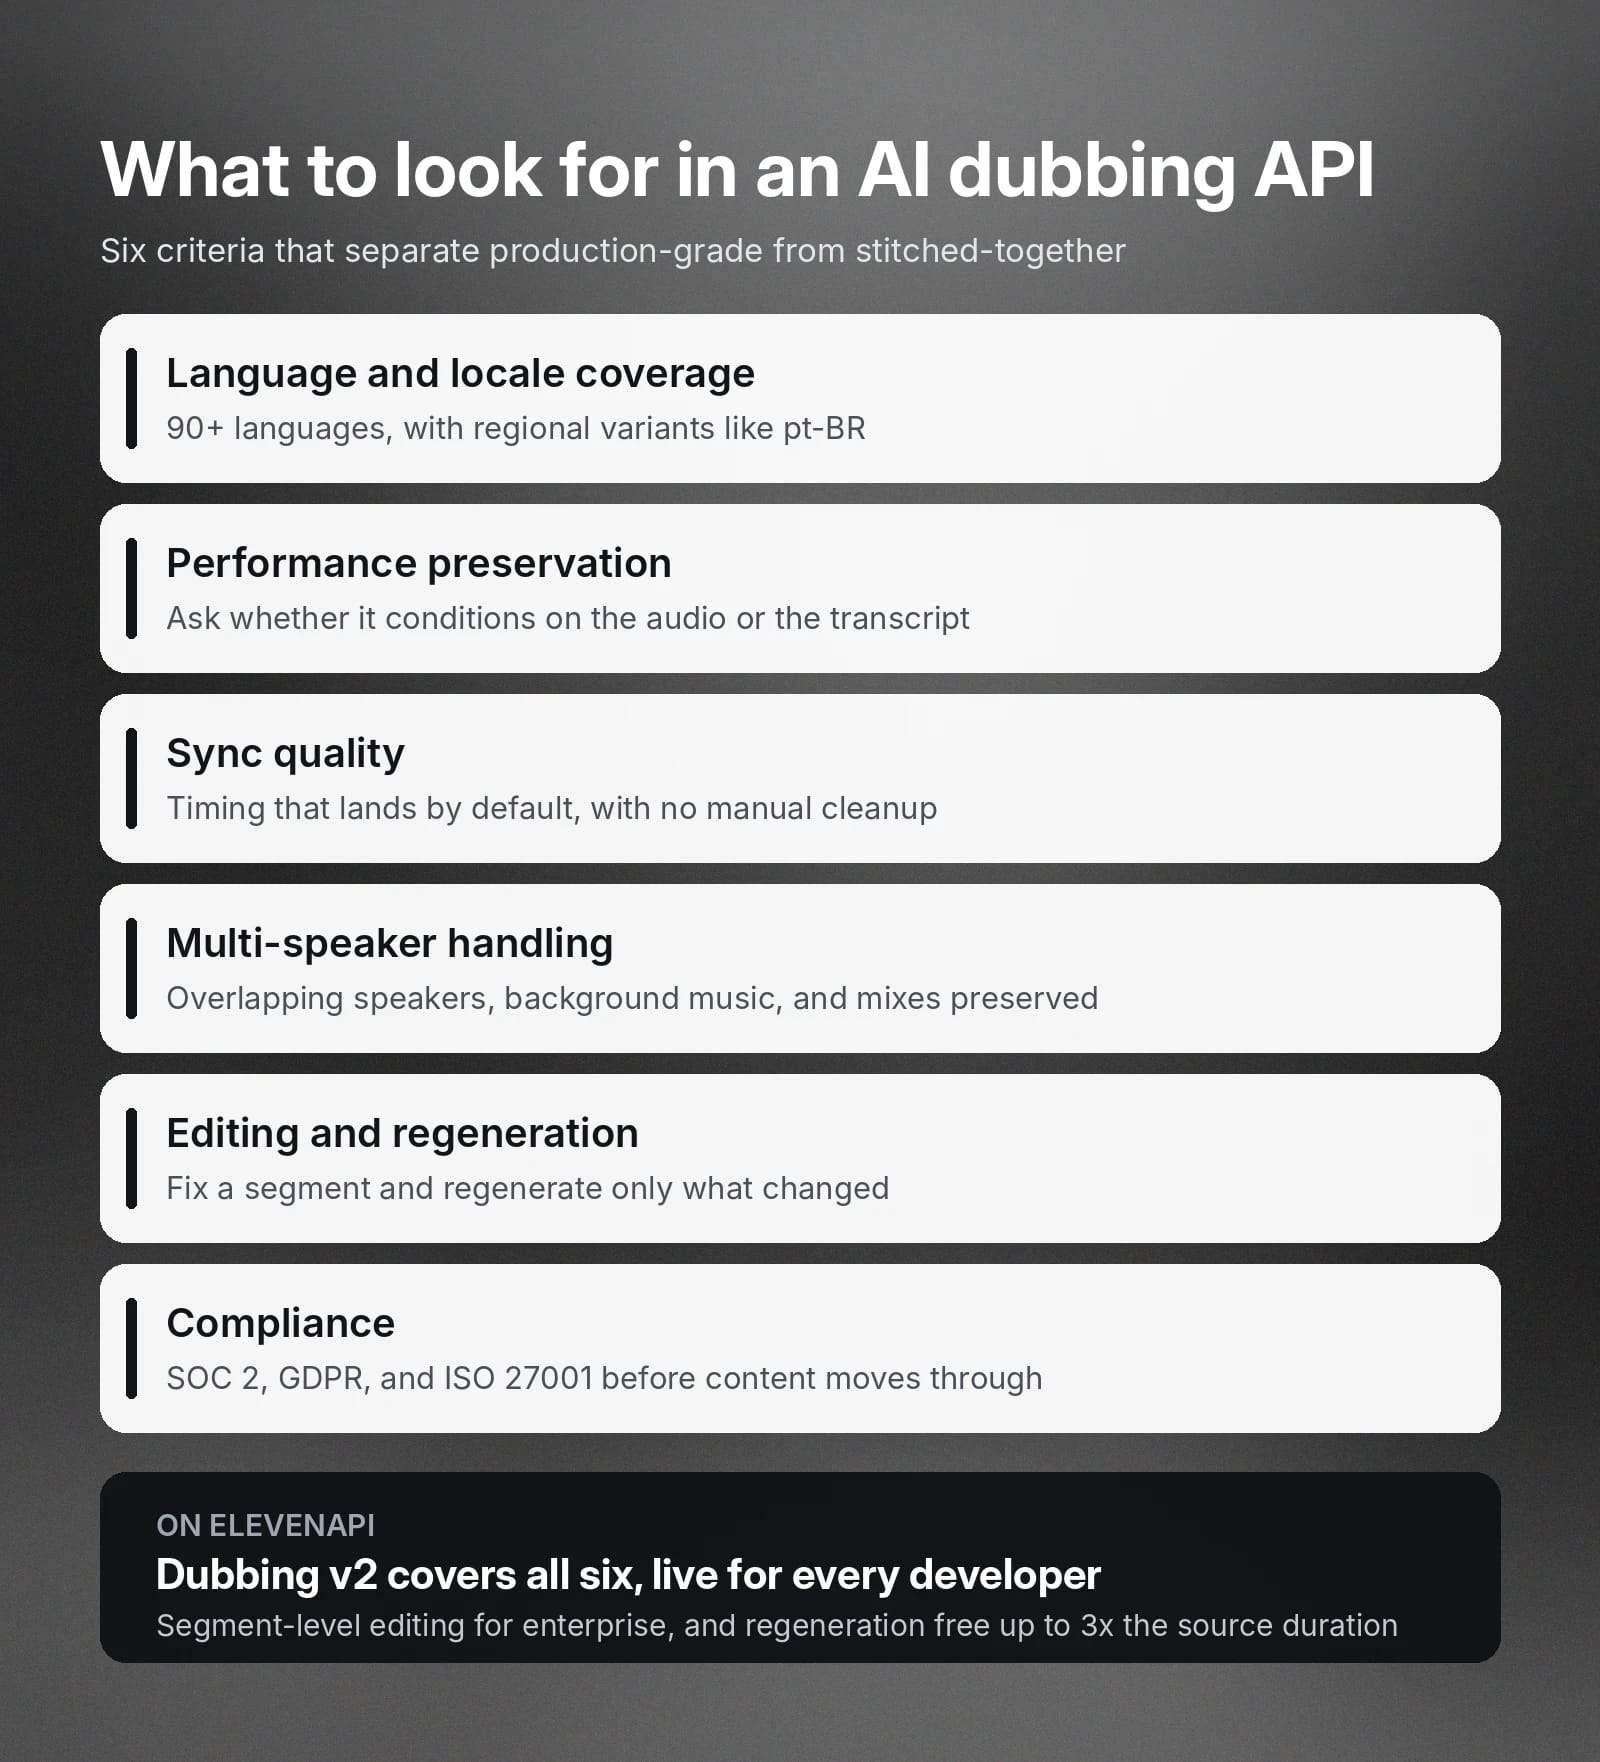
Dit zijn de belangrijkste kenmerken van de beste AI-dubbing-API's:
- Brede dekking van talen en locaties: Zoek naar een breed aanbod (meer dan 90 talen) en de mogelijkheid om aspecten zoals regionale varianten nauwkeurig te selecteren.
- Behoud van de uitvoering: Vraag of het systeem de bronaudio of het transcript als uitgangspunt neemt. De audio-naar-audioarchitectuur bepaalt of emotie de nasynchronisatie overleeft.
- Naadloze synchronisatiekwaliteit: Nagesynchroniseerde audio die afwijkt van de oorspronkelijke timing kost uren handmatig herstelwerk. Synchronisatie moet standaard werken om extra nabewerking te voorkomen.
- Mogelijkheden voor meerdere sprekers en achtergrondgeluid: Een AI-dubbing-API moet moeiteloos over elkaar heen pratende sprekers of geluidseffecten kunnen verwerken. De API moet ook achtergrond-muziek of mixes binnen een clip behouden.
- Bewerken en opnieuw genereren: Met een dubbing-API waarmee je een transcript kunt corrigeren, een vertaling kunt verfijnen en alleen de betrokken segmenten opnieuw kunt genereren, hoef je geen volledige bestanden opnieuw te synchroniseren.
- Compliance:Enterprise-workloads vereisen SOC 2-, AVG- en ISO 27001-compliance voordat content door het systeem gaat.
In de rest van deze gids bespreken we de Dubbing API van ElevenLabs, die alle functies uit bovenstaande lijst bevat.
Audio en video nasynchroniseren met de ElevenLabs Dubbing API
De Dubbing API is opgebouwd rond projecten. Elk project bevat één bronbestand en het bijbehorende transcript. Vervolgens kun je per taal waarin je wilt nasynchroniseren één doeltaal toevoegen. Elke taal bevat vervolgens een eigen vertaling en output.
De onderstaande basisworkflow voor maken en ophalen is beschikbaar voor alle gebruikers van het ElevenAPI-platform.
1) Maak een nasynchronisatieproject
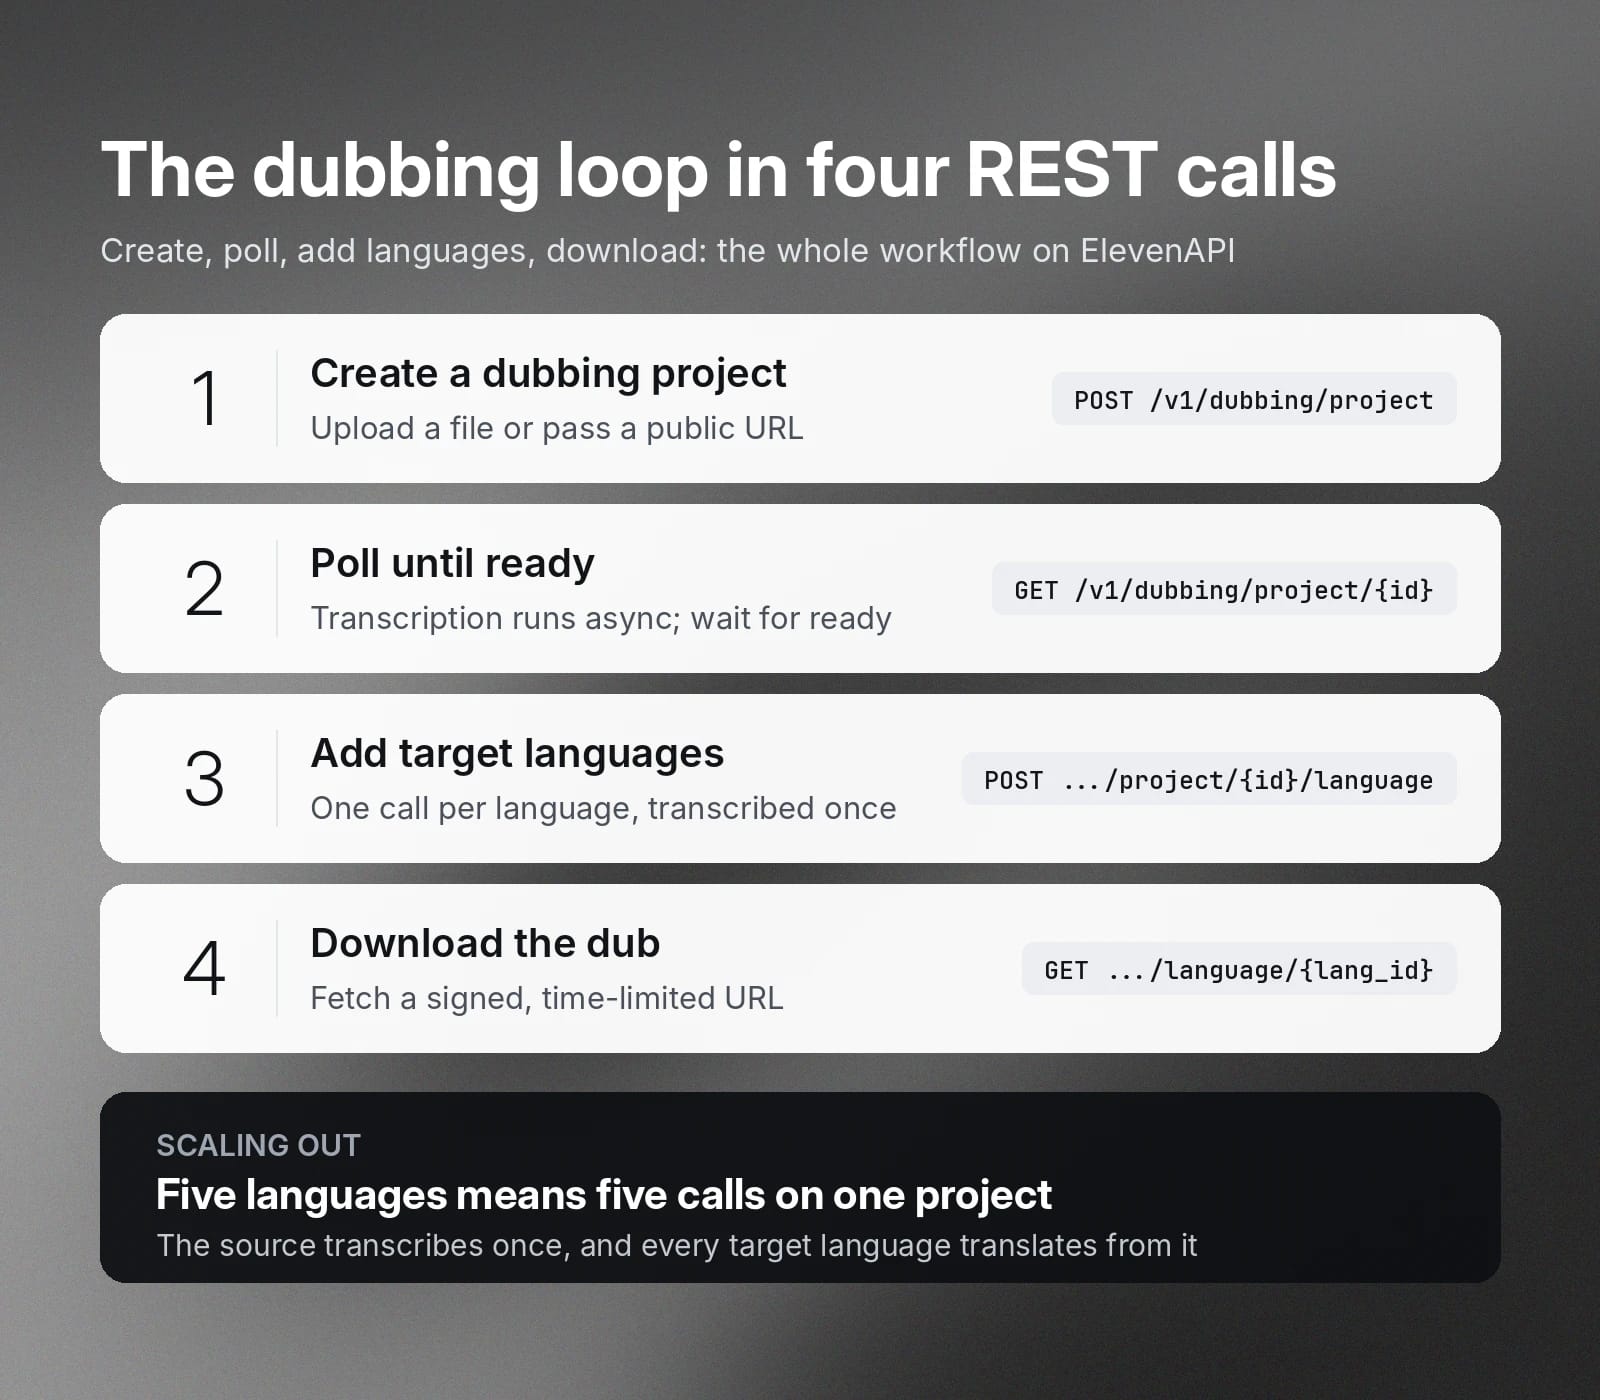
Stuur je bronmedia als bestandsupload of openbare URL. Authenticatie gebruikt je API-sleutel in de xi-api-key-header. Je kunt een optioneel referentielabel meegeven om het project aan jouw kant te identificeren, en keyterms om transcriptie en vertaling te sturen richting product- of merknamen.
Maken vanuit een URL
Maken vanuit een bestandsupload
De response retourneert een project_id met de status queued. Laat source_language weg en het model detecteert de taal automatisch tijdens de transcriptie.
2) Poll totdat het project klaar is
Bronnen worden asynchroon getranscribeerd, dus poll het project totdat de status ready bereikt.
Een klaar project heeft het brontranscript voorbereid en wacht tot je doeltalen toevoegt. De voortgang per taal bevindt zich bij de talen zelf, dus het project behoudt vanaf dit punt de status ready.
3) Voeg doeltalen toe
Voeg één taal per doel toe. De instelling cloning_strength (0 tot 10, standaard 7) bepaalt de afweging tussen gelijkenis met de oorspronkelijke stem en een natuurlijke voordracht in de doeltaal.
Elke taal doorloopt queued en processing tot completed.
Om naar vijf talen te dubben, doe je vijf calls voor hetzelfde project. De bron wordt één keer getranscribeerd en elke taal vertaalt daarvanuit.
4) Download de nagesynchroniseerde output
Haal de taal op zodra de status completed is. De response bevat een ondertekende download-URL voor de nagesynchroniseerde audio.
Houd er rekening mee dat download-URL's tijdelijk geldig zijn. Haal de taal dus opnieuw op wanneer je een nieuwe link wilt.
Met deze vier stappen heb je een volledig geautomatiseerde nasynchronisatielus: maken, pollen, talen toevoegen, downloaden.
Nasynchronisaties bewerken en opnieuw genereren via de API
Hoewel geautomatiseerde output de meeste use cases afdekt, is bij hoogwaardige lokalisatie vaak menselijke controle van de tekst nodig om ervoor te zorgen dat alles goed voelt. De Dubbing API geeft enterprise-klanten controle op segmentniveau over beide kanten van de vertaling.
Het brontranscript is de enige bron van waarheid waaruit elke taal vertaalt en is volledig bewerkbaar. Je kunt een verkeerd verstaan fragment corrigeren, een sprekerstoewijzing herstellen of de timing van elk segment aanpassen:
Elke doeltaal heeft een eigen transcript, waarin elk bronsegment wordt gekoppeld aan de vertaling. Vertalingen zijn op dezelfde manier bewerkbaar.
Je kunt ook je eigen brontranscript en vertaling aanleveren. Daarmee houdt je bestaande lokalisatieworkflow controle over de tekst, terwijl het model vervolgens de stemmen verwerkt.
Wanneer een transcript verandert nadat een nasynchronisatie is voltooid, wordt de taal als verouderd gemarkeerd en wordt deze met één call opnieuw gegenereerd op basis van de huidige tekst.
Opnieuw genereren is gratis tot 1x de duur van de bronmedia. Daardoor vermenigvuldigen iteraties op een vertaling je kosten voor nasynchronisatie niet. Boven het quotum van 1x wordt opnieuw genereren gefactureerd tegen je standaardtarief voor nasynchronisatie.
Use cases voor AI-dubbing-API's
Een video-dubbing-API is handig wanneer je audio op grote schaal moet lokaliseren. Handmatige nasynchronisatie kost veel tijd en moeite; met een AI-dubbing-API kun je het proces aanzienlijk versnellen.
Hier zijn enkele use cases voor AI-dubbing-API's:
- Platforms voor mediacreatie: Bouw nasynchronisatie rechtstreeks in je productieworkflows voor creators in, zodat gebruikers kunnen experimenteren zonder je app te verlaten.
- Trainings- en supportcontent:Organisaties met een wereldwijd wervingsbereik kunnen content naar verschillende talen lokaliseren en zo onboardingvideo's voor alle gebruikers ondersteunen.
- Streaming en media: Lokalisatiepipelines kunnen lange series of andere media automatisch nasynchroniseren voor distributie in meerdere regio's.
- Marketingmateriaal: Rol meertalige videocampagnes uit zonder teksten van stemacteurs opnieuw te hoeven opnemen in tientallen talen.
- Edtech:Cursusplatforms synchroniseren instructeursvideo's naar elke markt die ze bedienen, met behoud van de stem van de instructeur.
Over de hele linie maken dubbing-API's het toegankelijk om hoogwaardige, gelokaliseerde content op schaal te produceren.
Dubbing v2 is nu beschikbaar op ElevenAPI
De Dubbing API is beschikbaar voor zowel self-service- als enterprise-ontwikkelaars, met Dubbing v2 voor iedereen en endpoints voor bewerking voor enterprise-workspaces.
Verken de Dubbing API om alle mogelijkheden te bekijken, of registreer je en maak een API-sleutel om je eerste nasynchronisatie binnen enkele minuten uit te voeren.
Veelgestelde vragen over dubbing-API's

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


