
Wat is een vectordatabase? Hoe AI-zoekopdrachten betekenis vinden
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
Een vectordatabase is een opslagsysteem waarmee AI-modellen ongestructureerde data kunnen opvragen en ophalen op basis van semantische gelijkenis. Het helpt AI om antwoorden te genereren met kennis die verder gaat dan de trainingsdata.
Vectordatabases slaan informatie op in een formaat dat LLM's gemakkelijk kunnen verwerken. Ze bieden AI-modellen aanvullende informatie om relevante en nauwkeurige antwoorden te genereren.
Deze gids legt uit wat een vectordatabase is, hoe deze werkt, wat veelvoorkomende use cases en typen zijn, geeft voorbeelden en vergelijkt deze met relationele databases en graafdatabases.
Samenvatting
- Een vectordatabase slaat aangeleerde kenmerkrepresentaties op als vector embeddings in een multidimensionale ruimte.
- In tegenstelling tot traditionele databases die afhankelijk zijn van zoekwoordovereenkomsten, halen vectordatabases bij een query semantisch vergelijkbare data op.
- Een vector DB slaat interne documenten op die spraak-AI en klantenservice helpen contextbewuste antwoorden te geven met een RAG-systeem.
- Toepassingen zoals chatbots, AI-zoekmachines en conversationele AI profiteren van semantisch zoeken en ongestructureerde datatypen die vectordatabases ondersteunen.
- Vector DB's verschillen van graafdatabases. Graafdatabases verbinden gerelateerde entiteiten om multi-hopqueries te ondersteunen met behulp van algoritmen voor graafdoorloop, terwijl vectordatabases geschikt zijn voor eenvoudige queries die aanvullende context vereisen.
Wat is een vectordatabase en wat slaat deze op?
Een vectordatabase slaat data op als numerieke representaties, embeddings genoemd, waardoor AI-modellen semantisch kunnen zoeken met een lage latency. In tegenstelling tot een traditionele database, die informatie in rijen en kolommen opslaat, groepeert een vector DB embeddings in een multidimensionale ruimte op basis van semantische gelijkenissen.
In AI beschrijft de term ‘dimensie’ aangeleerde kenmerken of eigenschappen van een specifiek object. Je kunt je bijvoorbeeld voorstellen dat een hond dimensies heeft zoals vachtkleur en ras. In de praktijk komt een afzonderlijke dimensie in een aangeleerde embedding zelden overeen met één leesbaar kenmerk.
Generatieve AI-toepassingen, vooral toepassingen die verbinding maken met een externe kennisbron, gebruiken een vectordatabase om het ophalen van informatie te versnellen. In plaats van in een traditionele database te zoeken naar een directe zoekwoordovereenkomst, vindt het retrievalsysteem de meest vergelijkbare embeddings in de vector DB.
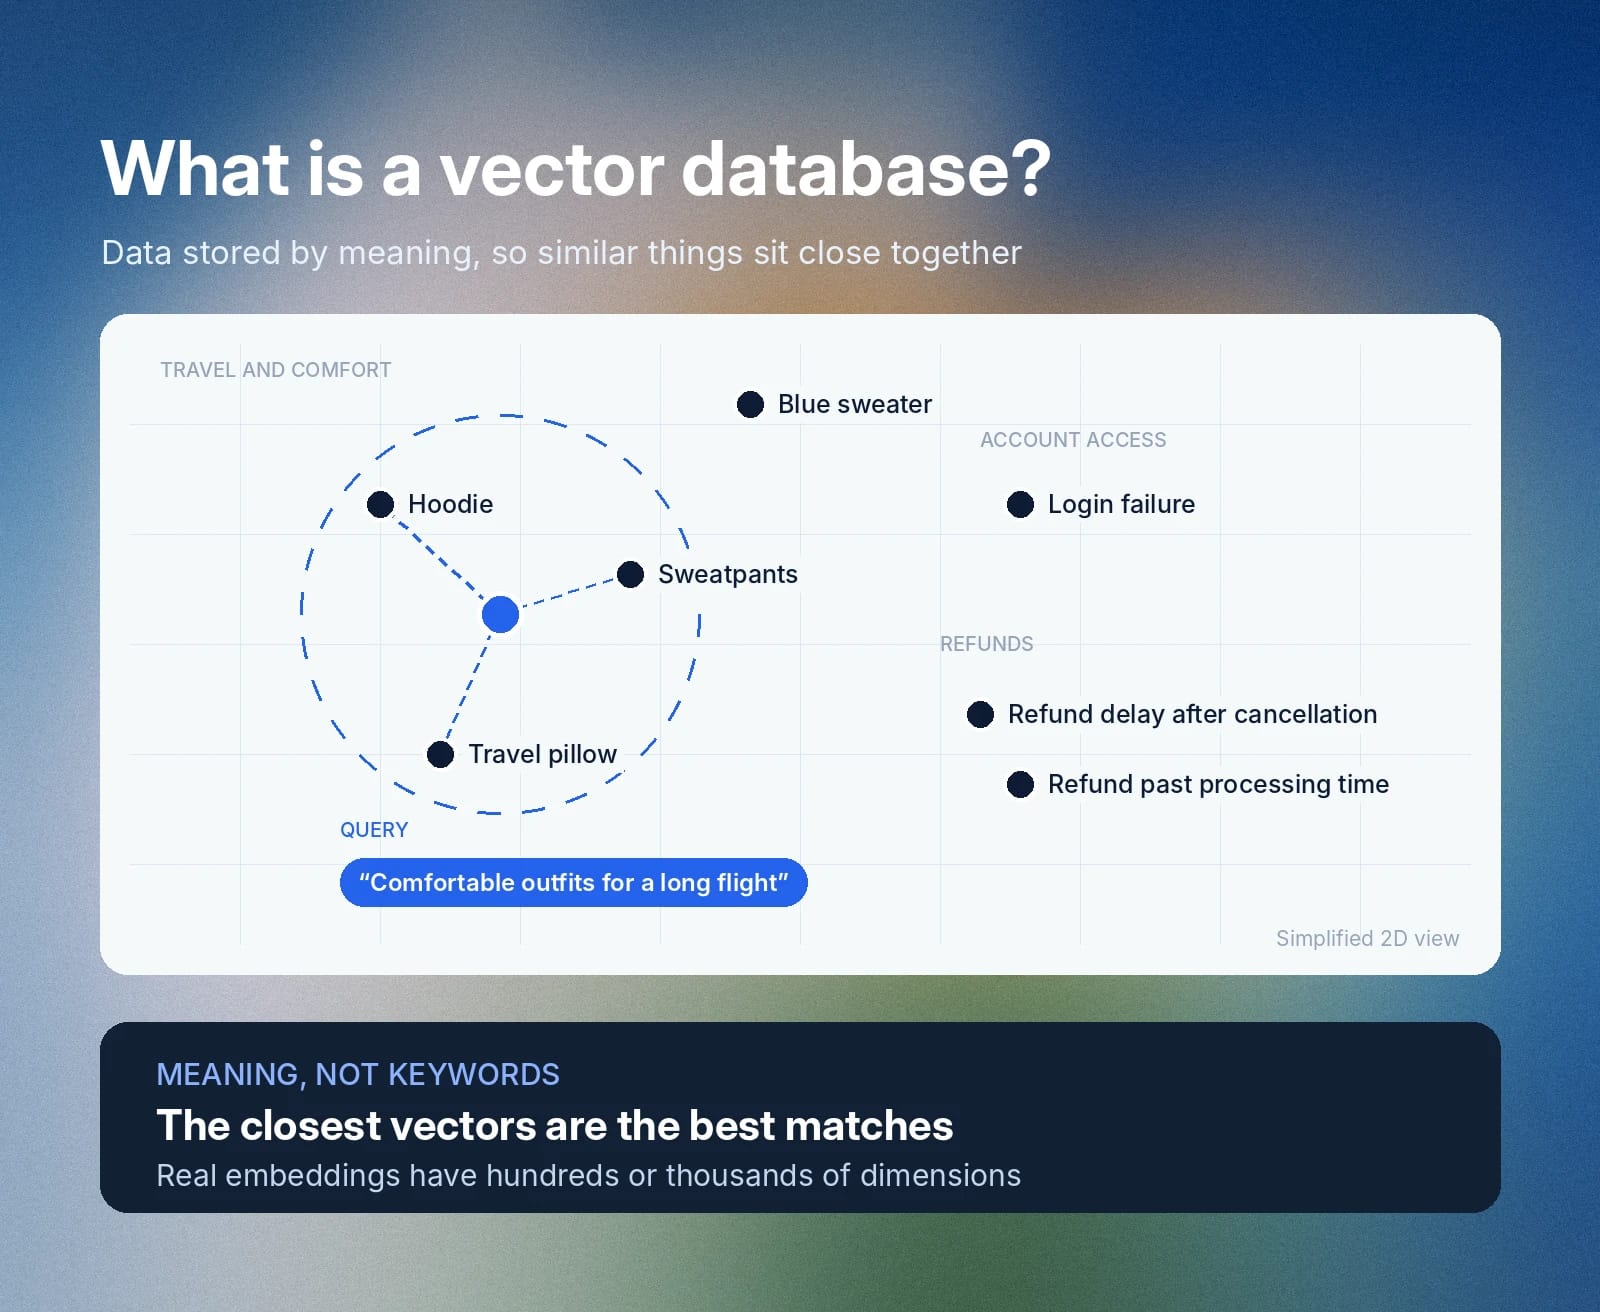
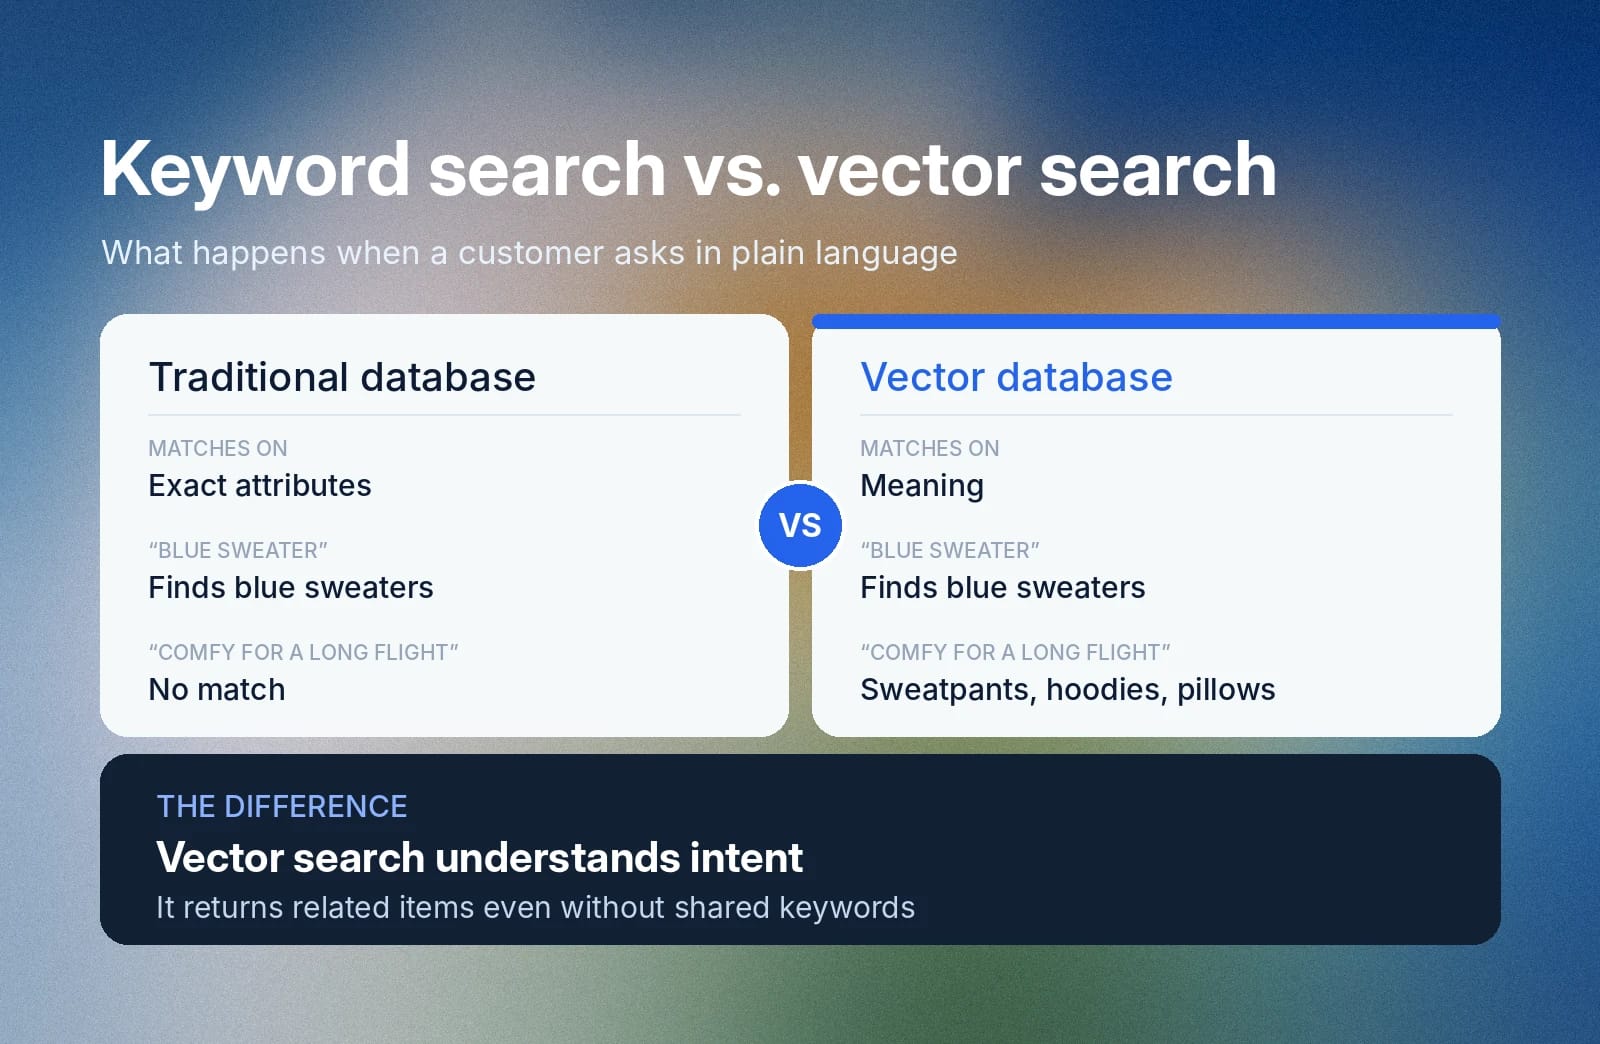
Stel dat een klant belt en je vraagt een “blauwe trui” aan te bevelen. Met een traditionele database zoek je naar producten die overeenkomen met de kenmerken “blauw” en “trui”. Maar als de klant “outfits die comfortabel zijn voor een lange vlucht” wil, kan een traditionele database geen antwoord geven.
Een vectordatabase legt daarentegen de semantische betekenis van het verzoek vast. Door het verzoek te koppelen aan de vectorruimte geeft het systeem outfits terug zoals joggingbroeken, hoodies en reiskussens, die nauw verwante kenmerkrepresentaties hebben. Dit vermogen om betekenis te koppelen onderscheidt een vector DB van een traditionele database.
Vector embeddings: spraak, tekst en afbeeldingen omzetten in getallen
Vector embeddings zijn reeksen getallen die ongestructureerde data zoals tekst, afbeeldingen en video representeren, zodat AI-modellen deze gemakkelijk kunnen verwerken.
Een vector is de wiskundige representatie van getallen over verschillende dimensies. Een vector legt echter niet de context, structuur en betekenis van een specifieke dataset vast.
Een lijst met kommagetallen zoals [0.82, 0.14, 0.67] is bijvoorbeeld een vector, maar wat deze representeert wordt bepaald door het embeddingmodel.
Embeddings leggen eigenschappen van de data vast en slaan deze op als een vector in een multidimensionale ruimte. Ze geven betekenis aan wat anders slechts een lijst met getallen zou zijn. Elk getal in de vector is één dimensie van de aangeleerde representatie.
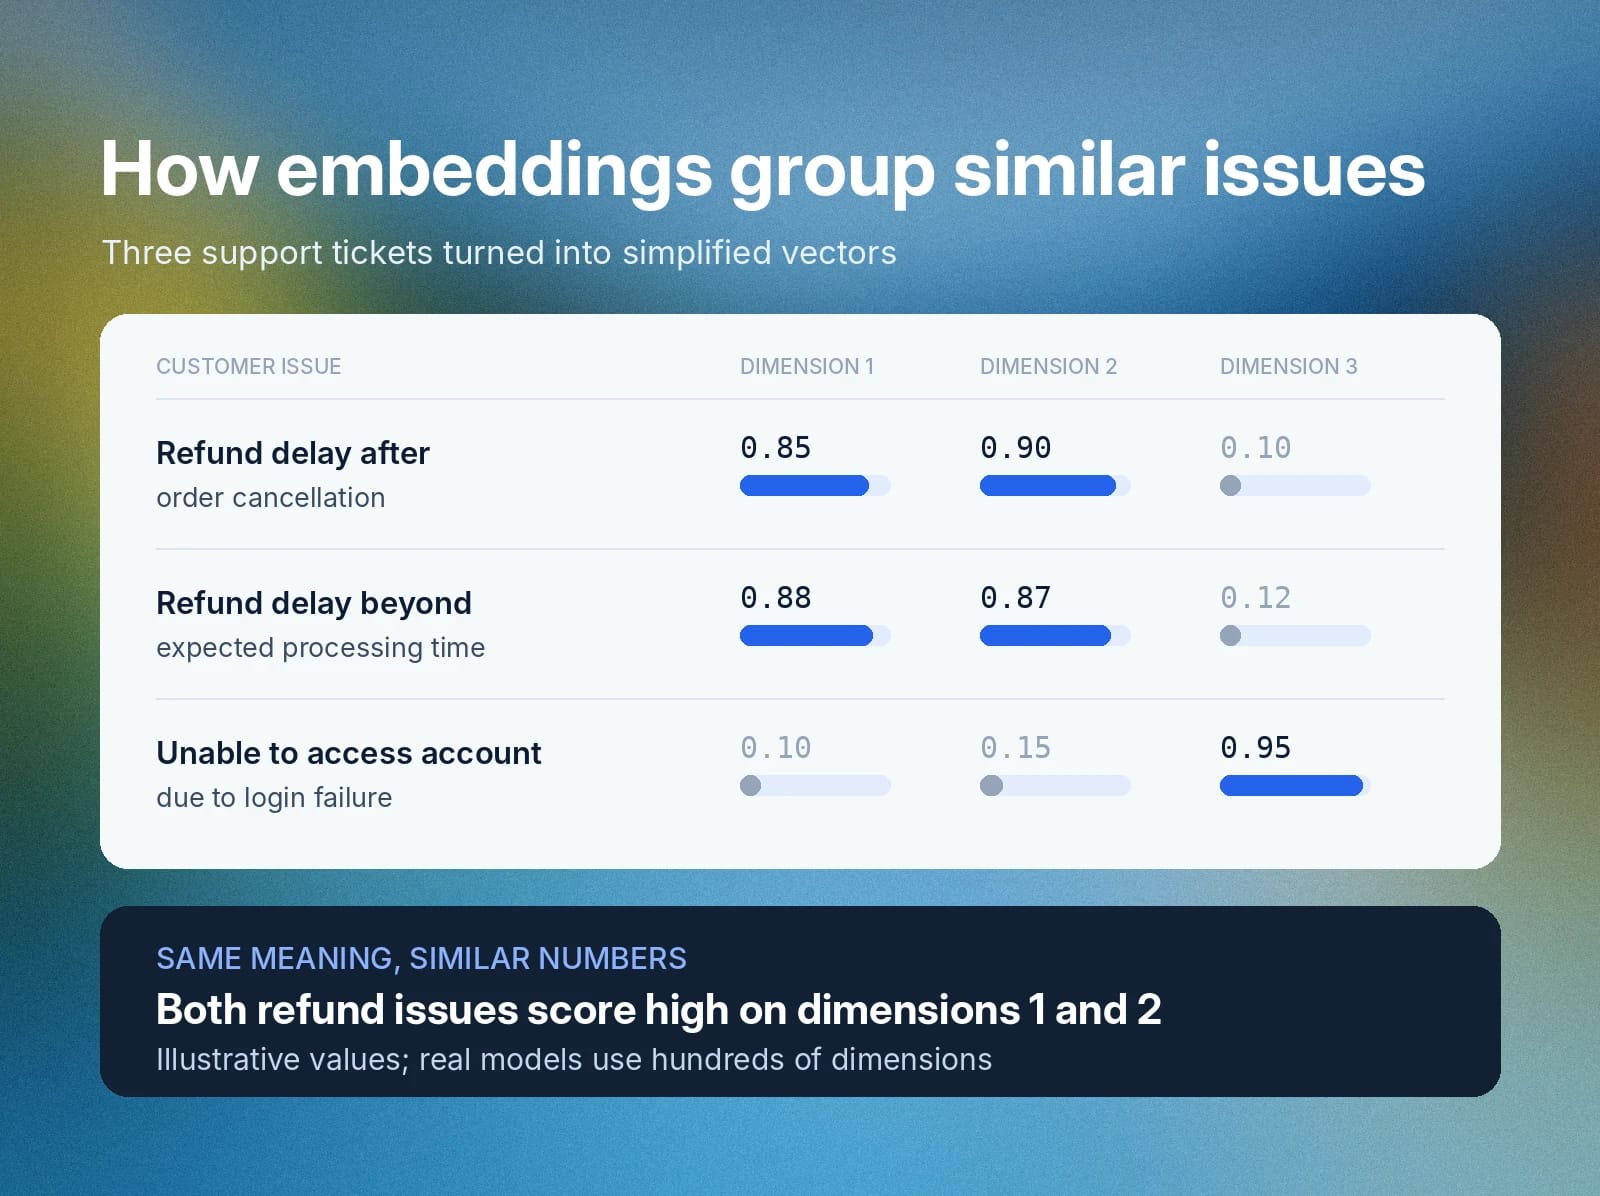
Stel dat je klantcases wilt opslaan in een vector DB. Met een embeddingmodel zet je tickettypen om in embeddings met verschillende waarden over dimensies. De onderstaande waarden zijn vereenvoudigd ter illustratie.
Klantprobleem
Embeddings
Terugbetaling vertraagd na orderannulering
[0.85, 0.90, 0.10]
Terugbetaling vertraagd na de verwachte verwerkingstijd
[0.88, 0.87, 0.12]
Geen toegang tot account door mislukte login
[0.10, 0.15, 0.95]
Beide problemen met terugbetaling hebben, ondanks verschillende oorzaken, hogere getallen in de eerste en tweede dimensie, terwijl het loginprobleem het hoogste getal in de derde dimensie heeft. Embeddingmodellen produceren doorgaans honderden of duizenden dimensies. Daarom zijn vectordatabases gebouwd om ze snel te vergelijken.
Hoe werken vectordatabases?
Vectordatabases zetten ongestructureerde data om in embeddings, slaan deze op in een multidimensionale ruimte en maken semantisch zoeken op gelijkenis mogelijk. Embeddings die nauw met elkaar verbonden zijn, hebben tot op zekere hoogte een kleinere afstand in de vectorruimte.
Wanneer de vectordatabase een query ontvangt, gebruikt deze approximate nearest neighbor-algoritmen (ANN) om de meest vergelijkbare embeddings op te halen zonder de hele database te scannen.
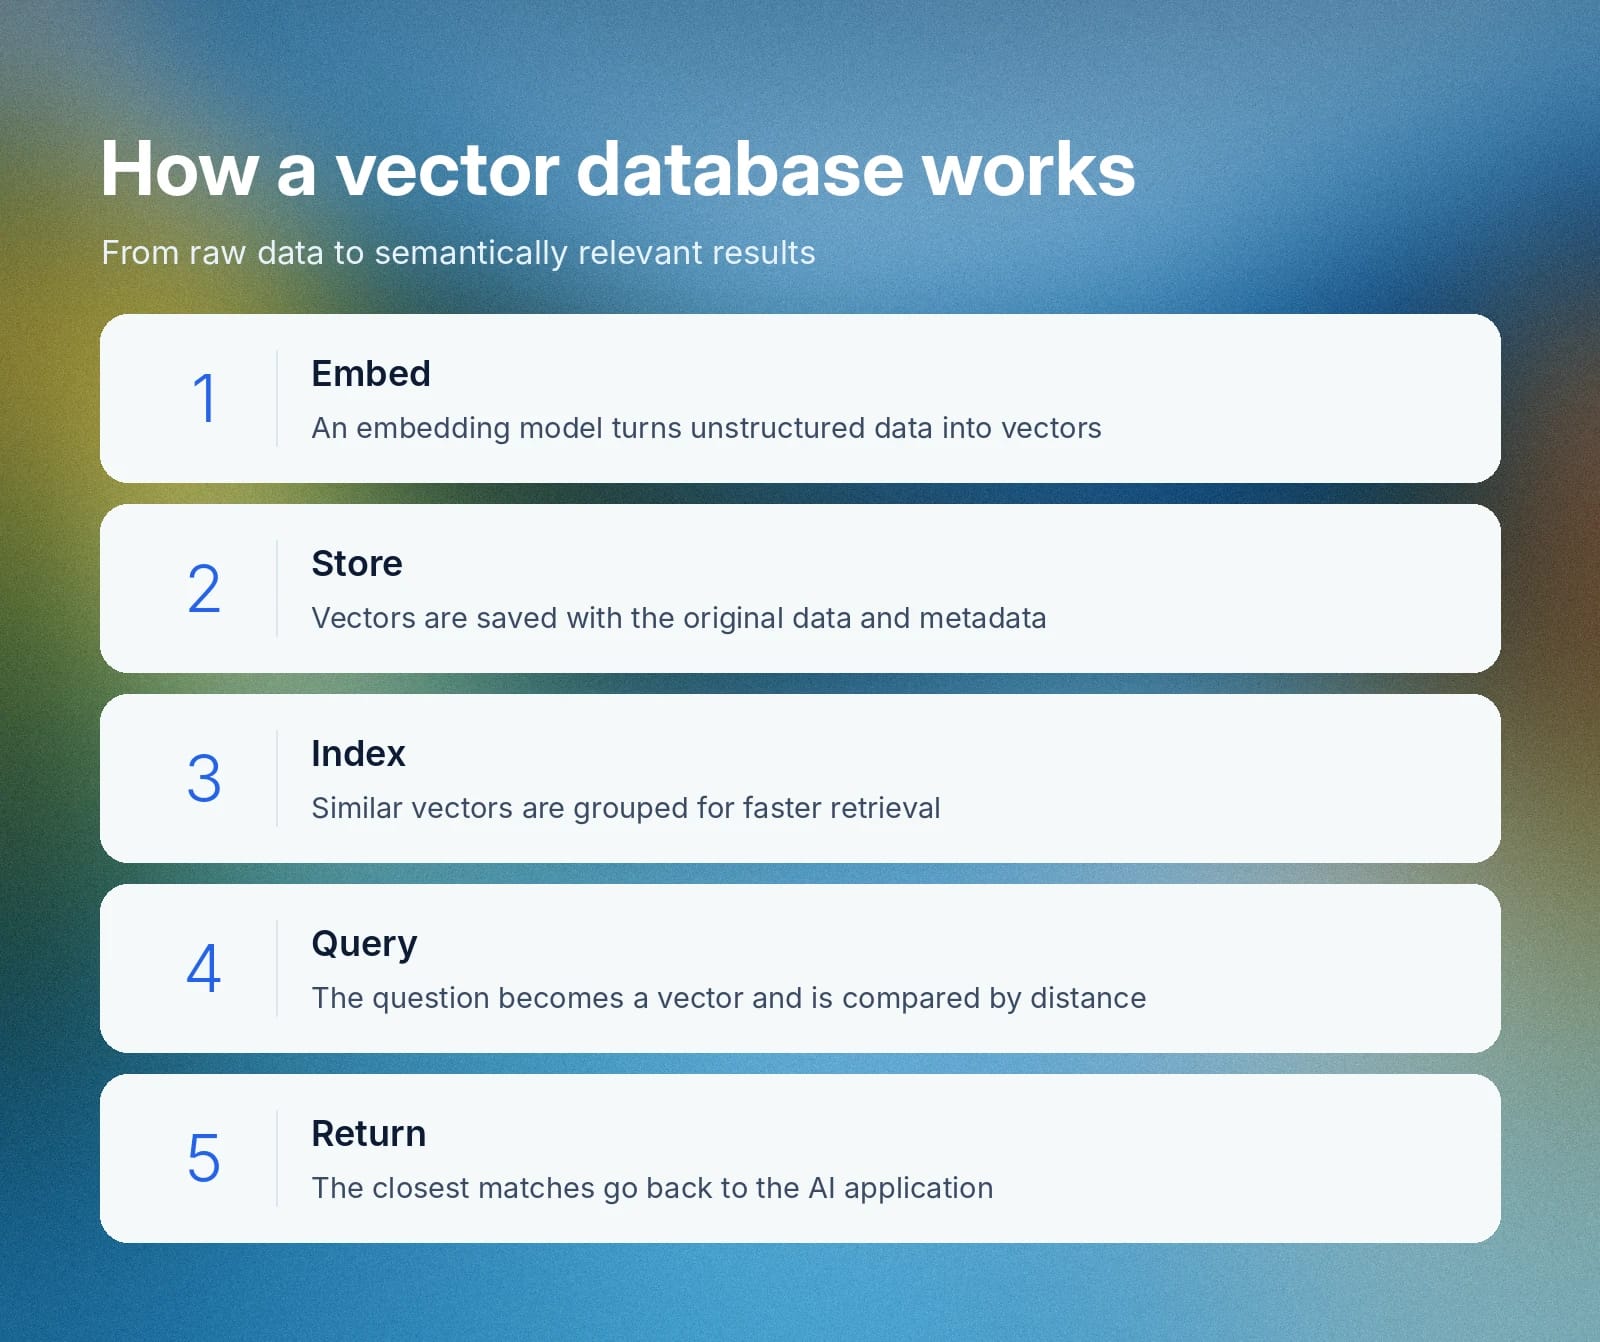
Dit zijn de stappen voor het instellen van en ophalen uit een vectordatabase.
Opslag voor embeddings
Eerst zet een embeddingmodel ongestructureerde data om in embeddings. Elke embedding representeert kenmerken die de semantische betekenis van het object in de echte wereld dragen. Vervolgens slaat het systeem de embeddings samen met de oorspronkelijke data en metadata op in de vector DB.
Omdat embeddings met een vergelijkbare betekenis dicht bij elkaar staan in de vectorruimte, kan de database relevante overeenkomsten ophalen door de afstand tussen vectoren te meten.
Indexering voor sneller ophalen
Indexering is een proces dat de vector embeddings ordent om het efficiënt ophalen te verbeteren. Vectordatabases gebruiken verschillende indexeringstechnieken om nauw verwante embeddings te groeperen. Een vector DB kan bijvoorbeeld een lijst-, graaf- of boomstructuur gebruiken, afhankelijk van de vereisten voor het ophalen.
Naast indexering kan de vector DB de data comprimeren met een techniek die product quantization heet. Product quantization comprimeert embeddings tot compacte codes, wat geheugen bespaart ten koste van een klein verlies aan zoeknauwkeurigheid.
Semantisch relevante data opvragen
Wanneer de vectordatabase een query ontvangt, zet deze die om in een embedding. Vervolgens vergelijkt deze de embedding van de query met de embeddings die zijn opgeslagen in de multidimensionale database van de vector, met technieken zoals cosinusgelijkenis, dotproduct en euclidische afstand.
Op basis van de resultaten geeft de vectordatabase embeddings terug met de meest vergelijkbare semantische score. Generatieve AI-toepassingen gebruiken deze om hun antwoorden aan te vullen. Samen zorgen opslag, indexering en query's ervoor dat de database snel relevante resultaten teruggeeft.
Hoe vector search en similarity search relevante resultaten opleveren
Similarity search is een brede categorie systemen voor het koppelen van informatie. Het omvat benaderingen op basis van zoekwoorden die exacte woorden in een query koppelen, evenals vector search, dat koppelt op basis van betekenis.
Vector search gebruikt een vectordatabase om semantisch gerelateerde antwoorden terug te geven. In plaats van een exacte zoekopdracht op zoekwoorden uit te voeren, vergelijkt vector search de afstand tussen de query en kandidaat-antwoorden om het meest passende resultaat te kiezen.
Vaak gebruikt de vector DB metadata om embeddings vooraf te filteren voordat similarity search wordt uitgevoerd. Zo kan de zoekopdracht bijvoorbeeld worden beperkt door embeddings binnen een specifiek tijdsbestek te filteren. Daardoor gaat het ophalen sneller.
Use cases van vectordatabases voor spraak-AI en klantenservice
Vectordatabases helpen klantenserviceteams spraak-AI en chatbots in te zetten die met nauwkeurige productkennis kunnen antwoorden. In een AI-gestuurd klantenservicesysteem slaat de vectordatabase bedrijfseigen kennisbanken op, zoals producthandleidingen, bedrijfsbeleid en klantcases.
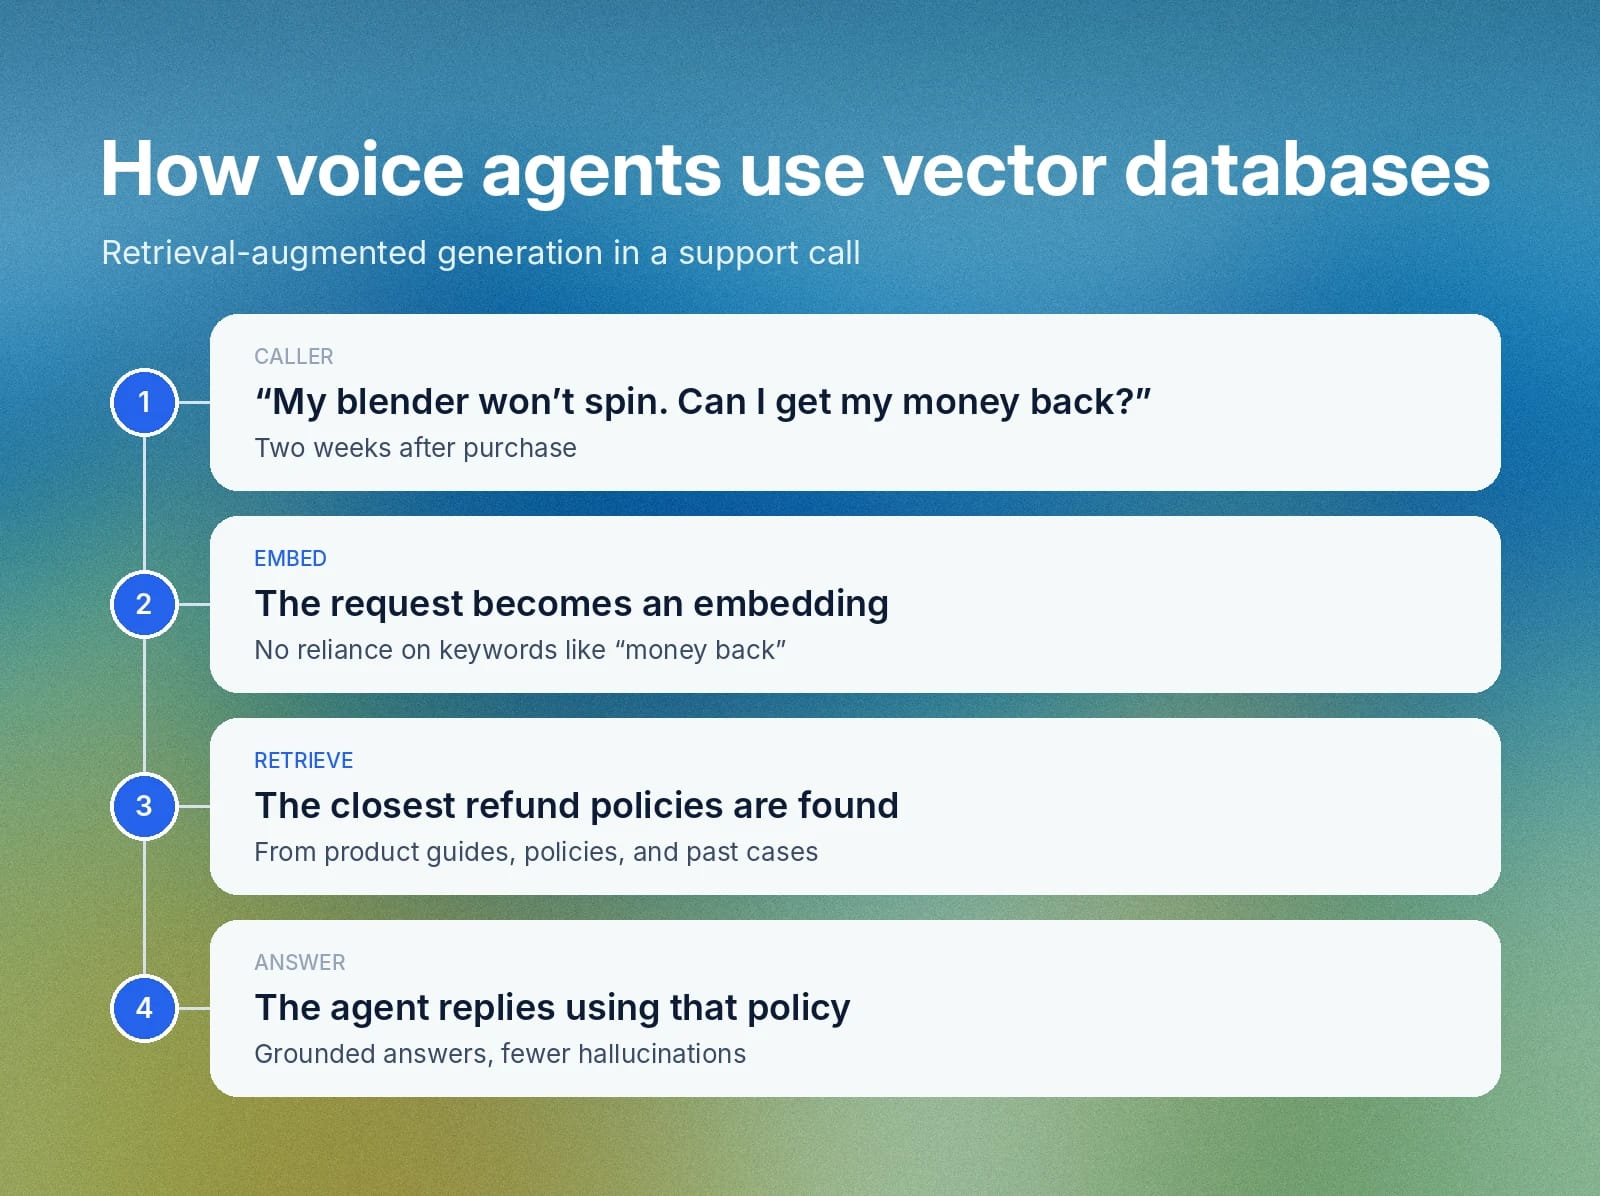
De AI-agent maakt verbinding met de vector DB via een retrieval-augmented generation-systeem (RAG) .
Wanneer de AI-spraakagent een query ontvangt, controleert deze of hij voldoende informatie heeft om de klant te antwoorden. Als actuele of voldoende data ontbreekt, haalt de RAG semantisch overeenkomende data op om het antwoord aan te vullen.
Stel dat een spraakagent de volgende klacht ontvangt: “Mijn blender draait niet meer na twee weken. Kan ik mijn geld terugkrijgen?” In plaats van te zoeken naar exacte zoekwoorden zoals “draait niet meer” en “geld terug”, zet de RAG het verzoek om in een embedding. Vervolgens haalt deze terugbetalingsbeleid op met de meest verwante betekenis.
Door relevante interne documenten op te halen, helpt een RAG-systeem dat wordt ondersteund door een vectordatabase hallucinaties bij spraakagenten te verminderen, al worden ze niet volledig voorkomen. In plaats van te gokken kunnen zowel AI-agents als menselijke agents interne documenten gebruiken om klantvragen op te lossen.
Vectordatabase versus relationele database: belangrijkste verschillen
Een relationele database gebruikt rijen en kolommen, samen met een vast schema, om data op te slaan. Een vector DB gebruikt in plaats daarvan embeddings, die ongestructureerde data representeren.
Relationele databases zijn geschikt voor exacte overeenkomsten en gestructureerde queries, zoals het vinden van elke bestelling die op een bepaalde datum is geplaatst. Vectordatabases halen daarentegen de opgeslagen embeddings op die qua betekenis het dichtst bij een query liggen, wat effectiever is voor vragen in natuurlijke taal.
Meestal gebruiken teams beide, omdat ze allebei een plek hebben bij het werken met data.
Vectordatabase versus graafdatabase: wanneer gebruik je welke?
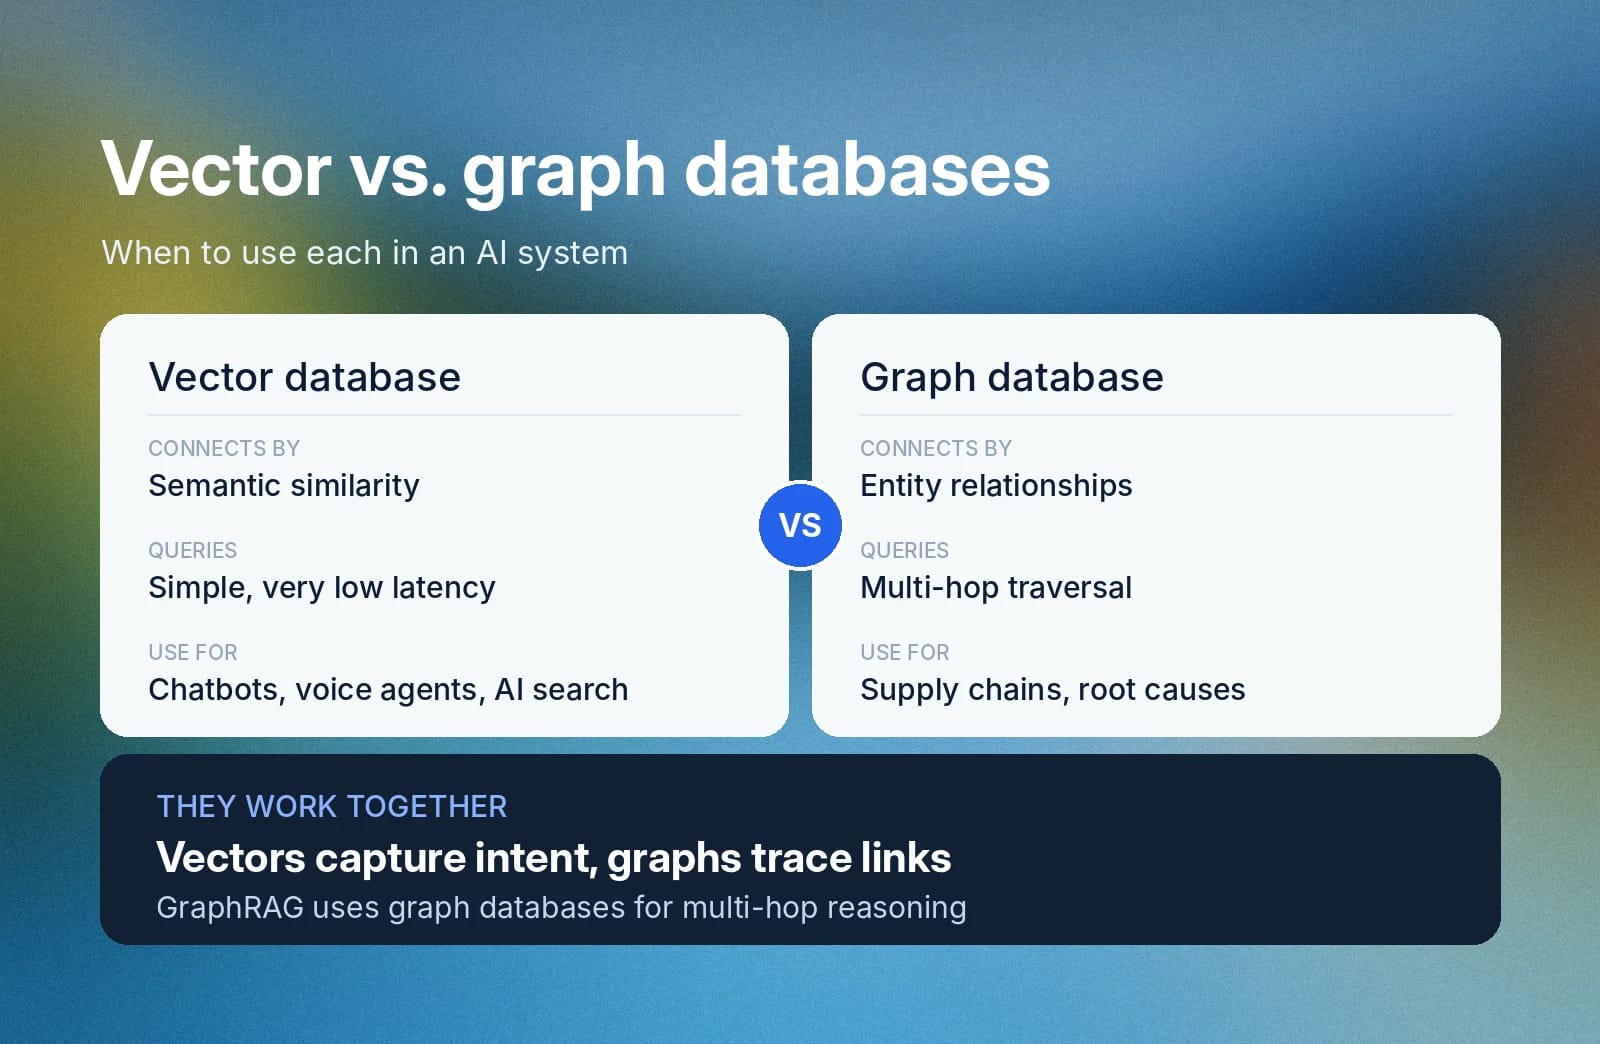
Graafdatabases gebruiken kennisgrafen om verschillende entiteiten te verbinden op manieren die hun hiërarchie en relaties weerspiegelen. AI-systemen zoals GraphRAG gebruiken graafdatabases om queries te beantwoorden die multi-hopredenering vereisen.
Wanneer je een graafdatabase bevraagt, vindt deze het startpunt in de data en gebruikt deze een algoritme voor graafdoorloop om gerelateerde entiteiten te vinden. Klantnamen kunnen bijvoorbeeld achtereenvolgens worden gekoppeld aan verlengingsdatums en supporttickets.
Vectordatabases slaan daarentegen ongestructureerde data op als numerieke representaties op basis van hun semantische betekenis. Ze laten RAG-systemen eenvoudige querymatching uitvoeren met zeer lage latency. Zo toont een vector DB het terugbetalingsbeleid bij het verwerken van “Ik wil mijn geld terug.”
Zowel vector- als graafdatabases zijn nuttig voor AI-systemen. Je kunt ze samen gebruiken:
- Gebruik een vector DB wanneer je een chatbot, spraakagent of AI-zoekmachine wilt ondersteunen die intentie in menselijke taal moet begrijpen.
- Gebruik een graafdatabase wanneer je problemen met onderlinge afhankelijkheden wilt oplossen, zoals het traceren van supply chains, het aanbevelen van relevante producten of het uitvoeren van een hoofdoorzaakanalyse.
Welke typen vectordatabases zijn beschikbaar?
Over het algemeen zijn er twee typen vectordatabases, die zich onderscheiden door hun architectuurstijl.
- Zelfstandige vector DB: Dit zijn onafhankelijke, doelgerichte databases die multidimensionale similarity search met lage latency ondersteunen. Veel generatieve AI-toepassingen maken verbinding met zelfstandige vector DB's om zware queryworkloads op te schalen.
- Vectordatabase-extensie: Bestaande databases kunnen vector search-mogelijkheden toevoegen om semantisch ophalen voor AI-modellen mogelijk te maken. Deze databases behouden hun oorspronkelijke architectuur, zoals een SQL-schema op basis van rijen, maar bieden ondersteuning voor vector-datatypen.
De keuze tussen beide hangt vooral af van of je een speciaal systeem voor grote queryworkloads nodig hebt, of juist een onderdeel voor semantisch zoeken wilt in een database die je al gebruikt.
Voorbeelden van vectordatabases
Hier zijn twee voorbeelden van vector DB's:
- Zelfstandige vector DB's: Pinecone is een beheerde vectordatabaseservice. Milvus, Weaviate, Qdrant en Chroma zijn open-sourcevectordatabases.
- Vector DB-extensies: pgvector voegt vector similarity search toe aan PostgreSQL, en MongoDB Atlas Vector Search voegt dit toe aan MongoDB.
Welke het beste past, hangt af van je schaal en hoeveel infrastructuur je zelf wilt beheren.
Ga aan de slag met ElevenAgents voor spraakagenten die klaar zijn voor retrieval
Met ElevenAgents kunnen spraakagenten informatie ophalen uit je eigen kennisbank om conversationele, contextbewuste antwoorden te geven. Met RAG haalt de agent de semantisch meest vergelijkbare content op uit de documenten, URL's of tekst die je aan de kennisbank toevoegt. Je kunt retrieval instellen op “On demand”, zodat de agent alleen in de kennisbank zoekt wanneer deze besluit dat nodig te hebben.
Het is begrijpelijk dat het implementeren van RAG de latency voor het genereren van antwoorden verhoogt. Dankzij onze technische verbeteringen hebben we de mediane RAG-latency van ElevenAgents teruggebracht van 326 ms naar 155 ms.
Ga aan de slag met ElevenAgents en lees hier hoe je je kennisbank instelt.
Veelgestelde vragen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


