
Framework voor de evaluatie van spraakagenten: 6 pijlers uitgelegd
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Voice agents moeten een symfonie van bijna gelijktijdige tools orkestreren. Het is een delicate wisselwerking tussen het opnemen van opmerkingen van een klant met realtime speech to text (STT), het verwerken van context en opstellen van een antwoord met een large language model (LLM), en vervolgens het genereren van een audiobestand met text to speech (TTS)-software.
Hoe evalueer je de prestaties van een voice agent nauwkeurig met zo veel bewegende onderdelen?
In dit artikel stellen we een evaluatiekader voor voice agents met zes pijlers voor, dat precies beschrijft wat je moet meten bij het beoordelen van het succes van een agent. We bespreken ook waarom verschillende sectoren deze pijlers anders moeten wegen en op welke veelgemaakte fouten je bij evaluaties moet letten.
Samenvatting
- De zes belangrijkste pijlers voor de evaluatie van voice agents zijn TTS-stemkwaliteit, gesprekskwaliteit, toolgebruik en taakvoltooiing, intelligentie, compliance en veiligheid, en betrouwbaarheid.
- De belangrijkste productiedoelen zijn een MOS van 4,3, een TSR boven 85% en een time-to-first-audio van minder dan 500 ms.
- Verschillende sectoren wegen elk van de pijlers anders, waarbij bepaalde implementaties de ene pijler boven de andere verkiezen.
- Veelgemaakte testfouten zijn alleen schone audio evalueren en P99-latencypieken negeren.
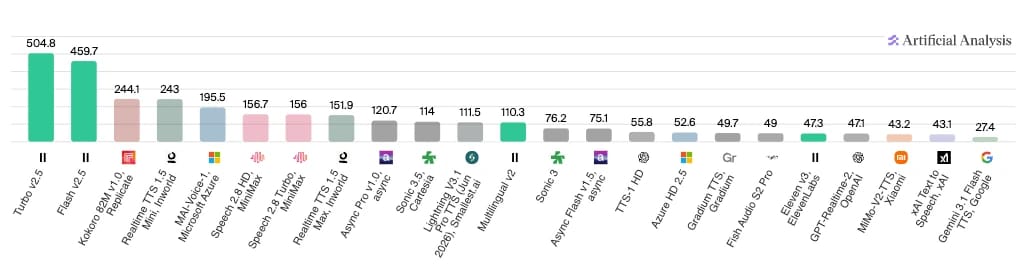
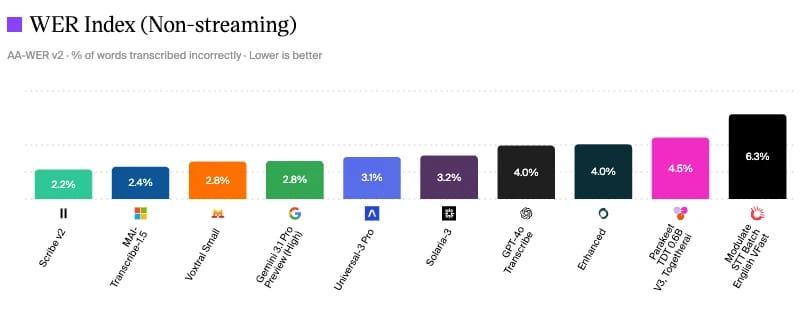
- ElevenLabs loopt voorop op de statistieken die het belangrijkst zijn: Scribe v2 behaalt met 2,2% de laagste WER in het veld (Artificial Analysis, juni 2026), Flash v2.5 en Turbo v2.5 behoren tot de snelste modellen (Artificial Analysis, juni 2026), en ElevenAgents levert een modelinference-latency van ~75 ms.
Wat is een evaluatiekader voor voice agents?
Een evaluatiekader voor AI-voice agents is een gestructureerd systeem waarmee je prestaties op meerdere dimensies kunt testen. Een uitgebreid kader bevat statistieken om alles te beoordelen, van audiokwaliteit tot gespreksverloop en zelfs naleving van regelgeving.
In tegenstelling tot een tekstchatbot leidt een voice agent elke interactie via minimaal drie gestapelde technologieën: automatische spraakherkenning (ASR), die de woorden van een gebruiker omzet in tekst; een LLM die een antwoord samenstelt; en een TTS-systeem dat dit antwoord weer omzet in audio. Als een van deze systemen faalt, verslechtert de hele ervaring.
Juist door deze complexiteit moeten bedrijven voice agents evalueren voordat ze een aanbieder kiezen en tot implementatie overgaan. Elke extra latency of onnauwkeurig antwoord kan gevolgen hebben in de echte wereld, zoals klantenverlies of, in het ergste geval, boetes van toezichthouders en reputatieschade.
Een kader voor het evalueren van voice agents gebruikt benchmarking en meetbare data om te bepalen of een agent geschikt is voor bepaalde use cases. Vanuit zakelijk perspectief kun je door verschillende stemmodellen te evalueren het beste model voor je klanten kiezen.
De zes pijlers voor de evaluatie van voice agents
Hoewel een AI-agent maken en implementeren nog nooit zo eenvoudig is geweest, zijn de actieve processen achter de schermen behoorlijk complex. Omdat verschillende componenten samenwerken om naar een gebruiker te luisteren, te begrijpen wat die wil, die informatie aan een LLM door te geven en vervolgens een audioantwoord te produceren, vinden er veel bijna gelijktijdige handelingen plaats.
Bedrijven die met de best mogelijke voice agent willen samenwerken, hebben een strikt kader nodig om mee te benchmarken.
Als je meer geïnteresseerd bent in testresultaten, biedt Artificial Analysis verschillende vergelijkingen van agents op basis van diverse componenten. Hieronder zie je de resultaten van hun snelheidsvergelijking tussen modellen, waarin ElevenLabs Turbo v2.5 en Flash v2.5 met een aanzienlijke marge vooroplopen in verwerkte tekens per seconde.
Voor ontwikkelaars of bedrijven die hun eigen experimenten willen uitvoeren, zijn dit de zes pijlers van een evaluatiekader voor AI-agents die je moet gebruiken:
- TTS-stemkwaliteit: Hoe natuurlijk, helder en expressief de gesynthetiseerde spraak voor eindgebruikers klinkt. Toonaangevende modellen, zoals Eleven v4, bieden mensachtige, emotionele spraak in meer dan 70 talen.
- Gesprekskwaliteit: Begrijpt een model menselijke spraak, verwerkt het de betekenis en reageert het snel en in context gedurende meerdere beurten?
- Toolgebruik: De mate waarin een AI-agent taken uitvoert met beschikbare middelen zonder menselijke tussenkomst.
- Intelligentie: Hoe goed een model redeneert, nieuwe invoer verwerkt en voorkomt dat het onnauwkeurige of gehallucineerde antwoorden produceert.
- Compliance en veiligheid: Naast alle mogelijkheden moeten AI-voice agents voldoen aan alle vereisten op het gebied van regelgeving en compliance, inclusief actieve guardrails.
- Betrouwbaarheid: Componenten zoals totale uptime en consistente prestaties onder belasting, om te bepalen of een conversational AI-agent kan meegroeien met de vraag.
Hoewel elk van deze pijlers onafhankelijk is, hangen ze samen om de gebruiker een hoogwaardige eindervaring te bieden. Als een model bijvoorbeeld de stemkwaliteit verbetert maar nog steeds een hoge latency heeft, ervaart de klant ongemakkelijke wachttijden voordat het model spraak levert.
Laten we elk van deze evaluatiepijlers voor voice AI nader bekijken.
TTS-stemkwaliteit
We beginnen met stemkwaliteit, omdat dit waarschijnlijk het eerste is dat iemand opmerkt bij interactie met een conversational AI-agent. Als deze robotachtig of onnatuurlijk klinkt, is de subjectieve ervaring met een agent aanzienlijk minder goed.
Een van de oorspronkelijke beoordelingsstatistieken, zoals gedefinieerd door de International Telecommunication Union Telecommunication Standard Sector (ITU-T), is de Mean Opinion Score (MOS). MOS werkt op een schaal van 1 tot 5, waarbij 1 onbruikbaar is en 5 uitstekend. Deze subjectieve meting gebruikt menselijke luisteraars en verzamelt na een gesprek hun feedback.
Alles onder MOS 3,5 op deze schaal is behoorlijk matig, zeker naar moderne maatstaven, en heeft waarschijnlijk gevolgen voor de klanttevredenheid.
Hoewel MOS de mensgerichte statistiek is, dragen verschillende technische vereisten bij aan dit cijfer:
- Consistentie van toonhoogte en jitter: Toonhoogte en jitter zijn twee taalkundige elementen die mensen tijdens het luisteren vanzelf opmerken. ‘Toonhoogte’ verwijst naar veranderende intonatie tijdens het spreken, zoals wanneer je je stem vanzelf verheft bij het stellen van een vraag. Bij jitter varieert het begrip van toonhoogte van een stemmodel, waardoor het geen coherente prosodie in een zin kan aanhouden. De industriestandaard voor jitter is 30 ms.
- Emotionele expressiviteit: Een stem die helder en precies is, klinkt alsnog verkeerd als de toon niet aansluit bij het bedoelde emotionele register van een zin. Zonder nauwkeurige toonaanwijzingen voelen menselijke luisteraars minder verbondenheid met conversational AI-agents en beoordelen ze deze lager. ElevenAgents biedt bijna mensachtige expressiviteit om elk antwoord een duidelijke emotionele bedoeling mee te geven.
- Achtergrondgeluid: Achtergrondgeluid in voice agents heeft twee afzonderlijke dimensies die het waard zijn om te evalueren. Aan de uitvoerkant wordt subtiel omgevingsgeluid aan antwoorden toegevoegd om agents natuurlijker te laten klinken. Aan de invoerkant is achtergrondruisfiltering in de STT-laag een optionele instelling die de nauwkeurigheid verbetert. Test bij het evalueren van een agent beide: luister of omgevingsgeluid natuurlijk klinkt en beoordeel de STT-nauwkeurigheid met het ruisfilter aan en uit.
Streef bij het berekenen van MOS naar 4,3-4,5; dat duidt op hoge scores voor al deze perceptuele categorieën. Voor MOS-voorspelling op schaal, zonder menselijke panels nodig te hebben, kun je tools gebruiken zoals UTMOS en NISQA.
Gesprekskwaliteit
Gesprekskwaliteit is een samengestelde pijler tussen stemkwaliteit en taakvoltooiing. Deze meet hoe effectief een voice agent de behoeften van een gebruiker begrijpt, deze in context onderbreekt en dit via een dialoog met meerdere beurten tot een afronding brengt.
De belangrijkste statistiek hier is de nauwkeurigheid van intentclassificatie, die doorgaans tussen 85% en 92% ligt en bij toppresteerders boven 96% uitkomt. Hoewel 85% hoog lijkt, betekent dat nog altijd dat 15% van al het binnenkomende verkeer verkeerd wordt gecategoriseerd en naar de verkeerde middelen wordt geleid.
De technische elementen die bijdragen aan een hoge nauwkeurigheid van intentclassificatie zijn:
- Beurtwisseling: Beurtwisseling bepaalt hoe goed een voice agent de natuurlijke gespreksstroom beheert. Hierbij wordt beoordeeld wanneer de agent weet dat hij moet luisteren, reageren of op meer invoer moet wachten. Dit omvat ook het omgaan met onderbrekingen, waarbij een model een antwoord in uitvoering wist en op basis van de nieuwe invoer een nieuw antwoord genereert. ElevenLabs gebruikt een multi-context websocket om deze soepele onderbrekingen naadloos af te handelen.
- Latency: Latency beschrijft de end-to-endvertraging tussen het moment waarop een gebruiker zijn zin afmaakt en het moment waarop de agent met zijn audioantwoord begint. Voice agents van productiekwaliteit moeten streven naar een time-to-first-audio van minder dan 500 ms; minder dan 300 ms is beter. ElevenLabs Flash-modellen bieden een toonaangevende modelinference-tijd van ~75 ms, waarmee je in deze categorie goed start.
- Fallbackpercentage: Het fallbackpercentage meet hoe vaak een AI-agent een gebruiker niet begrijpt en om verduidelijking of herhaling vraagt. Het is grotendeels een gevolg van STT-nauwkeurigheid: als de spraakherkenningslaag verkeerd hoort of verkeerd weergeeft wat een klant zei, ontvangt het LLM corrupte invoer. Het fallbackpercentage is een eenvoudige berekening met de formule: Fallbackpercentage (%) = (Aantal fallbacks / Totaal aantal interacties) * 100.
ElevenLabs Scribe V2 heeft met 2,2% de laagste WER in de speech-to-textmodelevaluatie van Artificial Analysis
Evaluatie van speech-to-textmodellen door Artificial Analysis
Een manier om gesprekskwaliteit te meten, is door te kijken naar industriële benchmarkstandaarden voor verschillende componenten. Zoals je ziet, heeft Scribe v2 van ElevenLabs sinds juni 2026 met 2,2% de laagste Word Error Rate, wat minder verkeerd verstaan, minder fallbacks en nauwkeurigere intentclassificatie betekent.
Bedrijven kunnen merken dat gesprekskwaliteit ook afhankelijk is van de workflow waarin een voice agent werkt. In customer support is bijvoorbeeld ook de kwaliteit van overdracht bij escalaties of het oplossen van veelgestelde vragen relevant.
Toolgebruik en taakvoltooiing
Waar kwaliteit meet hoe een gesprek aanvoelde, meet taakvoltooiing of het tot een succesvol resultaat leidde. Enterprises moeten goed letten op dit onderdeel van het evaluatiekader voor voice agents, omdat het rechtstreeks verbonden is met bedrijfsresultaten.
Een maatstaf voor toolgebruik is slot-fill-nauwkeurigheid, die bepaalt hoe goed AI-agents relatief routinematige taken kunnen uitvoeren, zoals het invullen van een formulier met klantgegevens. Een hoge slot-fill-nauwkeurigheid laat zien dat de agent naadloos van gesprek naar actie kan gaan zonder onderweg informatie te verliezen.
Task Success Rate (TSR) is een procentuele meting van de end-to-endtaken die een agent met succes heeft voltooid. Voltooiing is hierbij gebaseerd op het vermogen van een agent om zowel een verzoek te begrijpen als de juiste verbonden tools (API's, databases, Retrieval-Augmented Generation (RAG) en interne kennisbanken) te gebruiken voor ondersteuning.
De formule voor TSR is:
TSR = (Volledig voltooide taken / Totaal aantal geprobeerde taken) x 100
Voice agents die klaar zijn voor productie moeten streven naar een TSR boven 85%, met monitoring van de nauwkeurigheid en betrouwbaarheid van tool calls. Voer regressietests uit voor elke wijziging in prompts of verbonden modellen om daling in je TSR te voorkomen. Zelfs een kleine afwijking kan grote gevolgen hebben voor je TSR.
Intelligentie
Intelligentie omvat het redeneervermogen en de geavanceerde mogelijkheden van een voice agent. Deze pijler markeert duidelijk het verschil tussen een spraakgestuurde IVR (Interactive Voice Response) en een AI-voice agent.
Belangrijke dimensies om hier te evalueren zijn:
- Risico op hallucinaties: Hallucinaties, waarbij een agent informatie produceert die onnauwkeurig is of niet overeenkomt met bedrijfsdocumenten, zijn vooral schadelijk bij voice AI omdat ze zelfverzekerd kunnen worden uitgesproken. Recente onderzoeken suggereren dat veelvoorkomende hallucinaties de klanttevredenheid met voice agents aanzienlijk schaden.
- Omgaan met vragen buiten het bereik: Intelligente agents begrijpen wanneer een vraag buiten hun contextuele domein valt en kunnen gepast reageren. In plaats van een antwoord te hallucineren, weigeren ze of sturen ze het gesprek terug naar contextueel afgebakend terrein.
- Contextbehoud: Kan een agent gedurende meerdere beurten entiteiten en eerder gedane toezeggingen volgen? Zonder dit vermogen moeten klanten zich mogelijk herhalen of ervaren ze tegenstrijdige antwoorden.
- Redeneren en logica in meerdere stappen: Kan de agent conditionele logica correct verwerken of conclusies in meerdere beurten aaneenschakelen? Vooral bij technischere use cases, zoals financiële dienstverlening, is het vermogen om binnen een vooraf gedefinieerde context te redeneren essentieel voor succes.
Er bestaan diverse benchmarks van derden voor deze dimensies en componenten. Zo benchmarkt Stanford's Holistic Evaluation of Language Models (HELM) LLM-prestaties in verschillende categorieën. Voor hallucinaties biedt TruthfulQA een grondige analyse van hoe vaak onjuiste antwoorden in reacties sluipen.
Een voordeel van ElevenAgents is dat je, anders dan bij sommige spraakplatforms die je vastzetten op één onderliggend model, de LLM-laag volledig kunt vervangen. In de praktijk betekent dat dat je elk model kunt aansluiten dat voor jouw specifieke use case het beste scoort op redeneerbenchmarks.
Compliance en veiligheid
Bedrijven moeten actieve guardrails implementeren om schadelijke outputs of outputs die beleid schenden te voorkomen. Anders dan instructies in prompts op systeemniveau, die kunnen worden omzeild of overschreven, draaien onafhankelijke guardrailcontroles als een aparte laag buiten het model zelf. Deze beoordelen outputs voordat ze de gebruiker bereiken en stoppen het gesprek als het gevaarlijk terrein opgaat.
Auditability is een gerelateerde vereiste: productieagents moeten gedetailleerde logs van beslissingen en outputs bijhouden in een formaat dat beoordeling achteraf ondersteunt. Vooral in sterk gereguleerde sectoren is achteraf kunnen aantonen dat je aan de regels voldoet net zo belangrijk als er in eerste instantie aan voldoen.
De exacte regelgeving waaraan je bedrijf moet voldoen, verschilt per sector. Enkele van de meest toepasselijke kaders zijn:
- HIPAA: Voor beschermde gezondheidsgegevens in Amerikaanse zorgcontexten.
- PCI-DSS: Voor iedere agent die betaalkaartgegevens verwerkt.
- AVG: Verplichtingen rond gegevensprivacy voor de EU en bedrijven met klanten in de EU.
Voor bedrijven die hun compliancepositie evalueren: ElevenLabs voldoet aan AICPA SOC Type II en de AVG en heeft daarnaast AIUC-1-certificering behaald. De AIUC-1 is een beveiligingsstandaard die specifiek is ontworpen voor AI-agents.
Betrouwbaarheid
Betrouwbaarheid is de laatste pijler in ons evaluatiekader voor voice agents en gaat erover of een agent consistent realtime kan leveren.
Let bij het beoordelen van een voice agent op de volgende kenmerken:
- Uptime: Elke klantgerichte implementatie verwacht 99,9% uptime om uitval te voorkomen. Vooral voor use cases die altijd beschikbaar moeten zijn, zoals inkomende support, is betrouwbare uptime een belangrijke factor.
- Geleidelijke degradatie: Door de onderliggende complexiteit van voice agents moet de agent een degradatie van een component soepel afhandelen. In de praktijk betekent dit doorsturen naar een persoon, in plaats van met meer belasting of foutmeldingen door te blijven werken.
- Prestaties onder belasting:Loadtests moeten minimaal 2x je verwachte piekconcurrency simuleren voordat je live gaat. Testen onder zware belasting kan hogere latency of slechtere prestaties aanwijzen die alleen op schaal zichtbaar worden.
Zelfs een hoogwaardig model dat aan alle andere eisen voldoet, kan onbruikbaar zijn als het niet met je klantvraag kan meegroeien. ElevenAgents wordt vertrouwd door 1.000.000 toonaangevende creators en enterprises, wat laat zien dat het platform implementatie op enterpriseniveau kan ondersteunen zonder concessies aan prestatiebenchmarks.
MOS meten voor voice agents (stap voor stap)
Als je bedrijf MOS handmatig wil meten, heb je een grote groep menselijke luisteraars en een selectie audioclips uit echte gesprekken nodig. Het is een gestructureerd proces van feedback verzamelen, middelen en vervolgens de data interpreteren.
Zo meet je MOS voor voice agents in de praktijk:
- Bereid je testset voor: Selecteer een representatieve steekproef van audiooutputs van je agent, met ten minste 100 clips uit uiteenlopende gesprekken.
- Voer de beoordelingssessie uit: Vraag je menselijke luisteraars om elk fragment op een schaal van 1 tot 5 te beoordelen op basis van de kwaliteit van de communicatie-ervaring.
- Bundel beoordelingen en bereken scores: Middel de beoordelingen per clip en neem daarna het gemiddelde van alle clips in je steekproef om een totale MOS te verkrijgen. Een MOS van 4,3 of hoger geeft aan dat je voice agent klaar is voor productie.
Hoewel dit handmatig veel werk is, levert dit een degelijke MOS op voor de voice agent die je hebt gekozen. Als je de test op schaal wilt uitvoeren, kun je menselijke luisteraars vervangen door geautomatiseerde tools zoals NISQA, die MOS-scores programmatisch voorspellen. Je kunt deze systemen integreren in je actieve pipelines om MOS continu te monitoren.
Benchmarks voor AI- versus menselijke tests: FCR, AHT en CSAT
MOS herhaaldelijk berekenen is een manier om modelverbetering of regressie te zien, maar je krijgt extra context door te benchmarken tegen menselijke prestaties. Door te zien wat mensen daadwerkelijk bereiken in vergelijkbare rollen, kun je bepalen of je voice agent bijna op een ideaal niveau presteert.
Hier zijn enkele statistieken voor benchmarks van AI- versus menselijke tests.
AI-agents moeten menselijke FCR en CSAT kunnen evenaren en AHT aanzienlijk verbeteren. Die verbetering komt doordat AI-agents doorgaans algemenere gesprekken afhandelen dan menselijke agents. Veel bedrijven hanteren een workflow waarin AI-agents als eerste reageren en gesprekken alleen doorgeven aan menselijke agents als ze te complex zijn om zelfstandig af te handelen.
Data uit 2025 van Poe, een aggregator voor AI-vergelijkingen, laat zien dat ElevenLabs het sterkste algehele vermogen behield om verzoeken af te handelen, met 74,4% van alle binnenkomende verzoeken voltooid. Dit succes leidde tot snel groeiend gebruik: Eleven v3 en v2.5-Turbo waren samen goed voor meer dan 60% van de berichten die in de loop der tijd naar AI-modellen werden gestuurd.
Gebruik voor een betere ervaring Eleven v4 voor ons meest emotionele TTS-model.
Berichten die in de loop der tijd naar AI-modellen zijn verstuurd, met ElevenLabs als koploper in het evaluatiekader voor Poe-voice agents
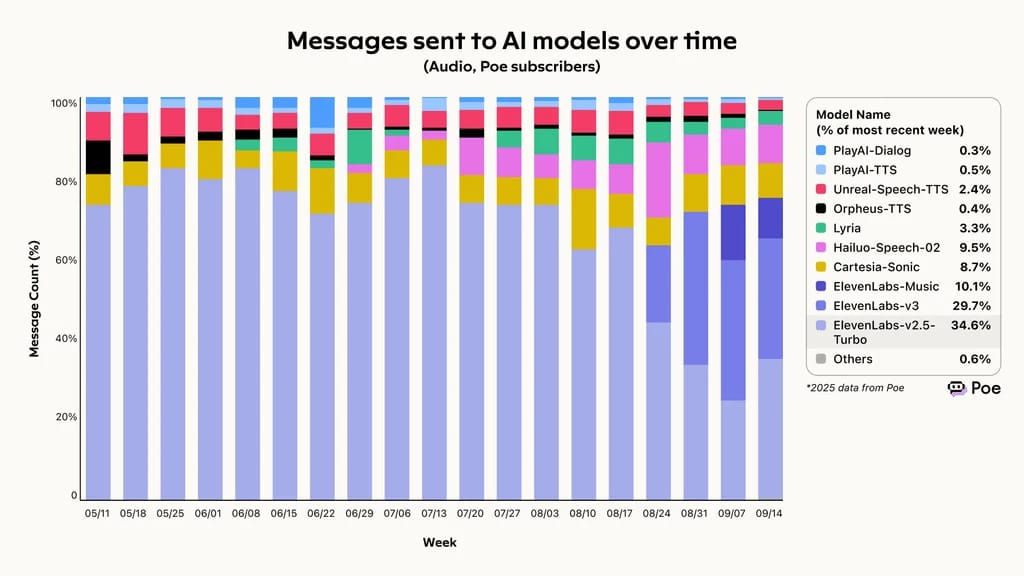
Berichten die in de loop der tijd naar AI-modellen zijn verstuurd, volgens benchmarks van Poe
Veelgemaakte fouten bij het testen van voice agents
Bij het volgen van een evaluatiekader voor voice agents is het verleidelijk om op bestcasescenario's te testen. De dagelijkse ervaring van klanten die met je voice AI-systemen werken, ontstaat echter niet onder ideale omstandigheden.
Hier zijn drie veelgemaakte fouten bij het testen van voice agents en hoe je ze oplost:
- Het eenvoudigste pad testen: Neem, vooral bij het selecteren van audioclips voor MOS, ook edge cases op. Clips met achtergrondgeluid of spraak met een accent komen in de praktijk zeer vaak voor; alleen testen met ‘schone’ audiobestanden leidt daarom tot een verkeerd gekalibreerde MOS.
- Containment boven oplossing prioriteren: Je modellen optimaliseren om gebruikers binnen je agentsysteem te houden, verhoogt de containmentpercentages zonder de resultaten te verbeteren. Als je FCR laag is ondanks een hoog containmentpercentage, laat de agent gebruikers rondgaan in een frustrerende lus. Zorg dat gebruikers met menselijke agents kunnen spreken als ze dat willen.
- Latencypercentielen negeren: SLA's duiden latency vaak aan met het P95-niveau. Hoewel deze statistiek belangrijk is om de meeste klanten een consistente ervaring te bieden, zijn de laatste 5% ook echte klanten. Op schaal betekent 5% van een systeem met 10.000 dagelijkse gesprekken nog steeds 500 mensen die een traag gesprek ervaren. Richt je voor je belangrijkste SLA-doel op P99, niet alleen op de mediaan of P95.
Door hier rekening mee te houden, kun je eerlijke en representatieve baselines vaststellen in plaats van uit te gaan van geïdealiseerde gemiddelden.
Waarom use-case-specifieke evaluaties belangrijk zijn
Hoewel de zes pijlers in dit kader richting geven aan de gebieden die je moet onderzoeken, hangt de weging van elke pijler af van je sector. Een bedrijf in de financiële dienstverlening kan bijvoorbeeld compliance en toolgebruik prioriteren, terwijl een consumentenmerk TTS-stemkwaliteit als leidend principe kiest.
Hier zijn twee voorbeelden van use-case-specifieke evaluaties in de praktijk en hoe ze de balans tussen de pijlers kunnen verschuiven.
Customer support
In bepaalde sectoren, zoals callcenters, zijn andere statistieken voor taakvoltooiing, zoals First Call Resolution (FCR), een belangrijk onderdeel van het gesprek. Een inkomend gesprek succesvol kunnen afhandelen zonder menselijke tussenkomst vermindert de vraag naar menselijke klantenserviceagents aanzienlijk. McKinsey schat dat callcenters die voice agents gebruiken het interactievolume met maximaal 50% kunnen verminderen.
Hoewel dit minder belangrijk is dan het slagingspercentage van taken, is containmentpercentage een andere dimensie om hier te overwegen. Het containmentpercentage is een statistiek die de totale duur van een gesprek onderzoekt. Als je containmentpercentage heel hoog is maar je FCR laag, houden je agents mensen aan de lijn zonder de klant een oplossing te bieden. In de praktijk kan dit voor de klant een frustrerende ervaring zijn waarin die rondjes blijft draaien.
Andere statistieken om bij te houden zijn AHT, waarbij AI-agents routinematige problemen snel moeten oplossen. Daarom zou het customer support-domein gesprekskwaliteit, met name beurtwisseling en fallbackpercentage, boven andere gebieden prioriteren.
Gezondheidszorg
Gezondheidszorg is een sterk gereguleerd domein, met strikte compliancevereisten die de inzet van voice agents bijzonder gevoelig maken. Compliance is een centrale zorg, waardoor de weging van de veiligheidspijler in het kader sterk verschuift naar deze pijler en intelligentie boven alles.
Chatbots voor de gezondheidszorg moeten afspraken inplannen, toegangstrajecten voor zorg op afstand beheren, symptomen triëren en vragen over verzekeringen beantwoorden. Dit alles vereist een hoge mate van intelligentie en toolgebruik, wat opnieuw laat zien dat eisen die specifiek zijn voor een sector of rol bepalen welke pijlers het belangrijkst zijn.
In welk domein je bedrijf ook actief is, inzicht in de kernpijlers van de evaluatie van voice agents en een evenwichtige toepassing ervan helpen je de beste agents voor jou te vinden.
Bouw met ElevenAgents voor hoge prestaties en lage latency
Het platform waarop je bouwt, heeft rechtstreeks invloed op hoe je voice agents presteren in echte workflows. Vooral in interacties met je klanten moet je erop kunnen vertrouwen dat je agent in elke categorie uitblinkt.
ElevenAgents is gebouwd voor voice-implementaties in productie en combineert toonaangevende TTS via Eleven v4, realtime STT via Scribe v2, en een agentorkestratielaag die is ontworpen voor enterpriseniveau. Elk onderdeel is gebouwd om te presteren volgens de benchmarks in dit kader, zodat je klanten hoogwaardige ervaringen kunt bieden.
Of je nu je opties afweegt of klaar bent om te beginnen met bouwen, ElevenLabs heeft een passende route. Verken het ElevenAgents-platform om te zien hoe het aansluit bij je use case, of registreer je en begin vandaag met bouwen.
Veelgestelde vragen over de evaluatie van voice agents

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.



