
Een AI-spraakassistent bouwen: AI-spraak die bij je merk past
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Stel je voor dat je een winkel belt om een terugbetaling aan te vragen, wordt begroet door mensachtige AI en het geld binnen enkele minuten op je bankrekening ontvangt. Elke interactie verloopt naadloos, zonder dat er menselijke supportmedewerkers nodig zijn. AI-spraakassistenten die complexe use cases aankunnen, ooit fictie, zijn nu werkelijkheid.
Steeds meer bedrijven zetten AI-spraakassistenten in voor klantgerichte toepassingen. Deze assistenten worden aangedreven door geavanceerde spraakagenten en generatieve AI en ondersteunen intentiematching, reacties met lage latentie en functionele integraties voor uiteenlopende use cases.
Met tools zoals ElevenAgents is het eenvoudiger dan ooit om stemassistenten in je workflows voor klantenservice te integreren. Definieer om een AI-stemassistent te bouwen welke taak die moet uitvoeren en verbind vervolgens Speech to Text, een LLM en Text to Speech in één realtime-pipeline. Voeg je kennisbank en bedrijfstools toe, schrijf systeeminstructies en fallbackregels, test op latentie en veiligheid en meet de resultaten na de lancering.
Deze gids laat zien hoe je een AI-spraakassistent bouwt die nauw aansluit bij je merk.
Samenvatting
- Een AI-spraakassistent verbindt Speech to Text, een LLM en Text to Speech om conversationele AI te creëren die actie kan ondernemen.
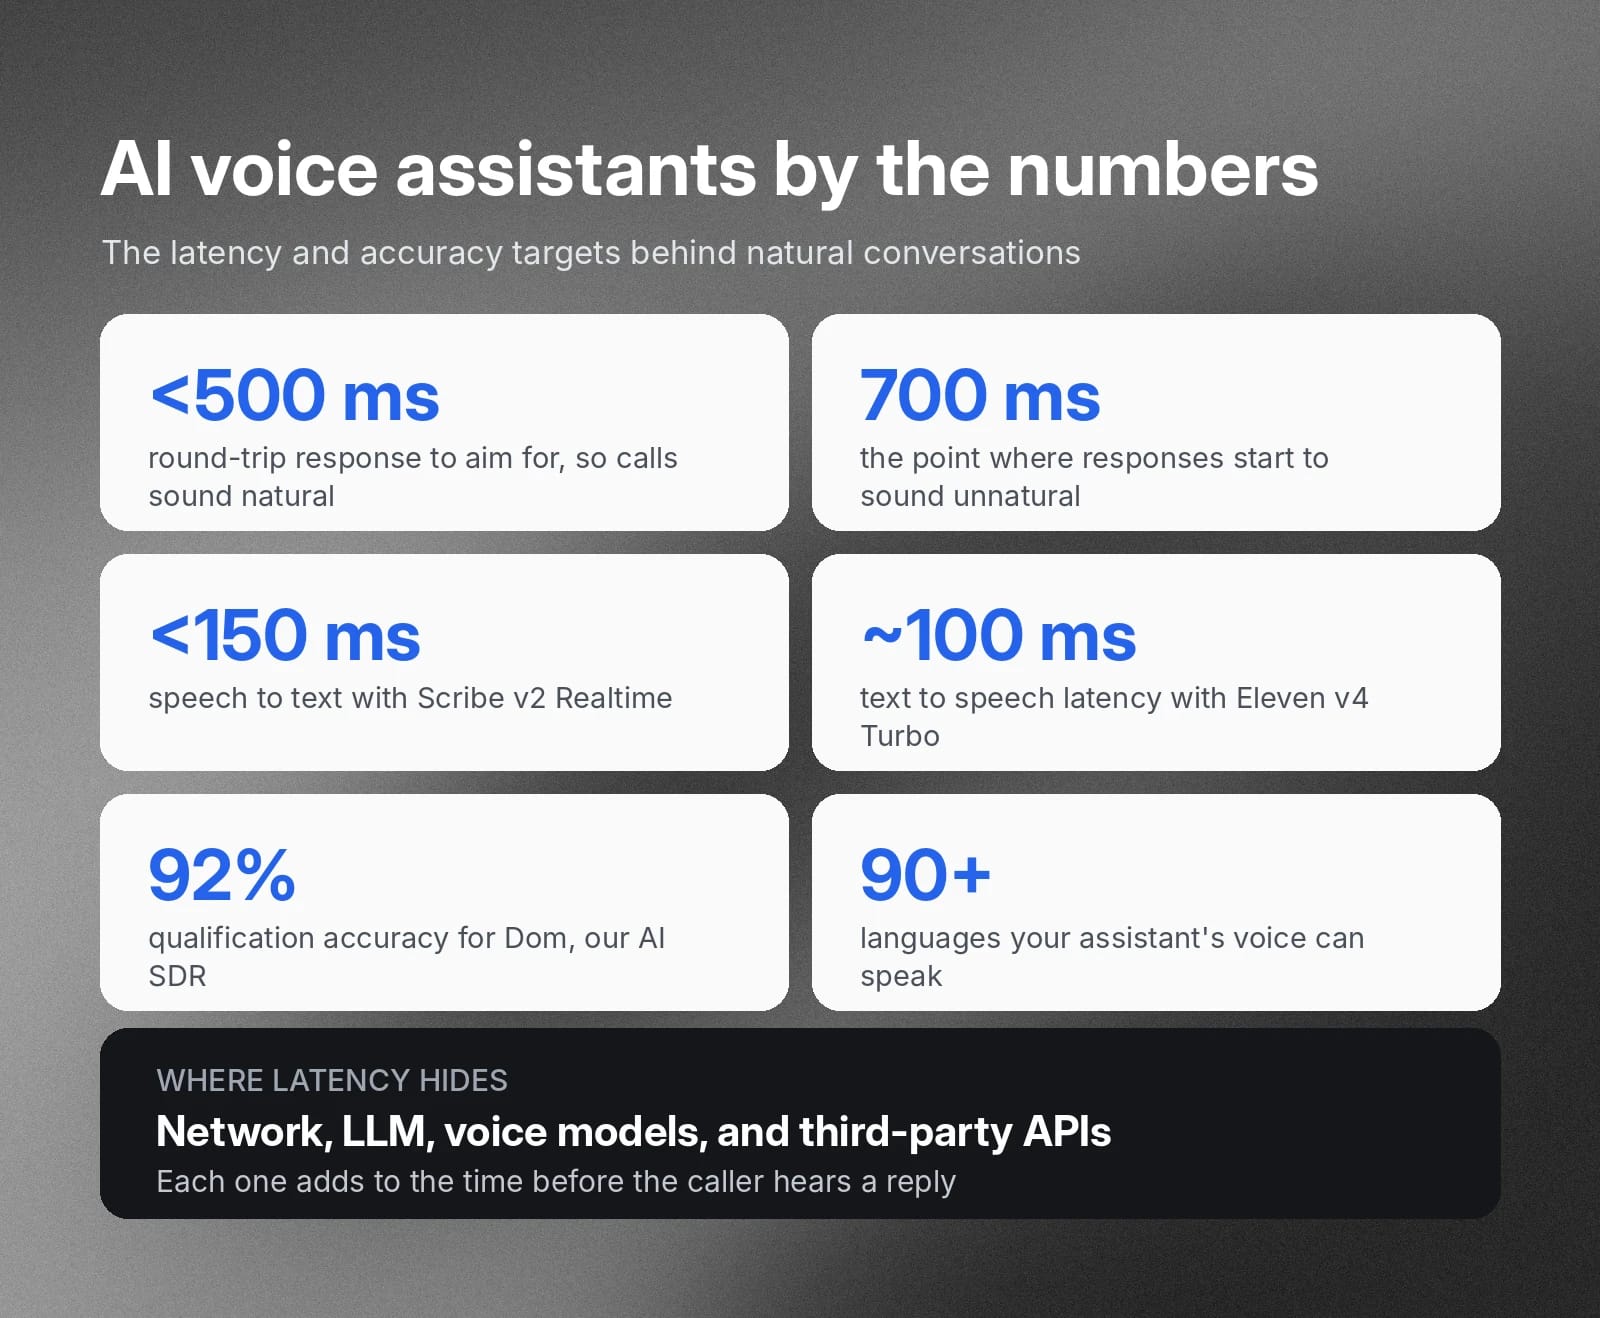
- Houd de round-tripreactietijd onder 500 ms met spraakactiviteitsdetectie (VAD), zodat de stem-AI natuurlijk klinkt en minder gesprekken worden afgebroken.
- Integreer met de interne kennisbank en tools voor contextbewuste, nauwkeurige en nuttige AI-antwoorden in verschillende scenario's.
- Pas waarborgen toe die expliciete mondelinge bevestiging vereisen en draag emotioneel beladen of complexe vragen over aan een menselijke agent.
- Gebruik ElevenAPI voor interactieve spraak- en audiomodellen met hoge nauwkeurigheid, ontworpen voor live interacties.
Wat is een AI-spraakassistent?
Een AI-spraakassistent is software die gesproken taal begrijpt en gebruikers laat communiceren met verbonden systemen. Deze combineert Speech to Text, AI-modellen en Text to Speech-technologieën om gesprekken om te zetten in acties.
AI-spraakassistenten kunnen meer dan tekst transcriberen: ze kunnen taken uitvoeren, zoals een app starten, gegevens ophalen en machines bedienen. Afhankelijk van het spraakmodel dat je gebruikt, kunnen sommige AI-assistenten vrijwel niet van menselijke opnamen worden onderscheiden.
AI-spraakassistenten zijn echter geen nieuwe technologie. Veel consumenten gebruiken Siri, Alexa en Google Assistant, commerciële spraakassistenten die reageren op eenvoudige opdrachten. Maar naarmate AI-technologieën zich ontwikkelen, bouwen meer organisaties AI-spraakassistenten voor complexere enterprise-workflows.
Zo bouwde Admiral, een verzekeraar, een AI-spraakassistent om miljoenen klanten te ondersteunen. De AI-assistent beantwoordt vragen, haalt documenten op en bevrijdt menselijke agenten van repetitieve taken.
Wil je een AI-spraakassistent bouwen voor commerciële of industriële workflows? Lees dan verder. We nemen je stap voor stap mee aan de hand van een Python AI-spraakassistent-voorbeeld, waarmee we belangrijke implementatiedetails toelichten.
Een AI-spraakassistent bouwen: bepaal welke taak je AI-spraakagent moet uitvoeren
Stem-AI automatiseert vaak klantenservice in callcenters. Maar gezien de brede mogelijkheden van een AI-spraakagent, kun je een AI-spraakassistent bouwen voor vrijwel elke use case, waaronder sales, product en HR.
Ongeacht de toepassing van je spraakagent, moet deze aansluiten bij de bedrijfslogica. Raadpleeg domeinexperts over veelvoorkomende uitdagingen voor eindgebruikers om een goed presterende spraakassistent te bouwen. Breng vervolgens de klantinteractiereis in kaart en stel meetbare indicatoren vast.
Gebruik je stem-AI voor een salesfunnel, dan moet de agent bijvoorbeeld prekwalificatievragen kunnen stellen.
Onze AI sales development representative (SDR), Dom, deed dit en behaalde 92% nauwkeurigheid bij kwalificatie.
Kies succesmetrics, kanalen en escalatiepaden
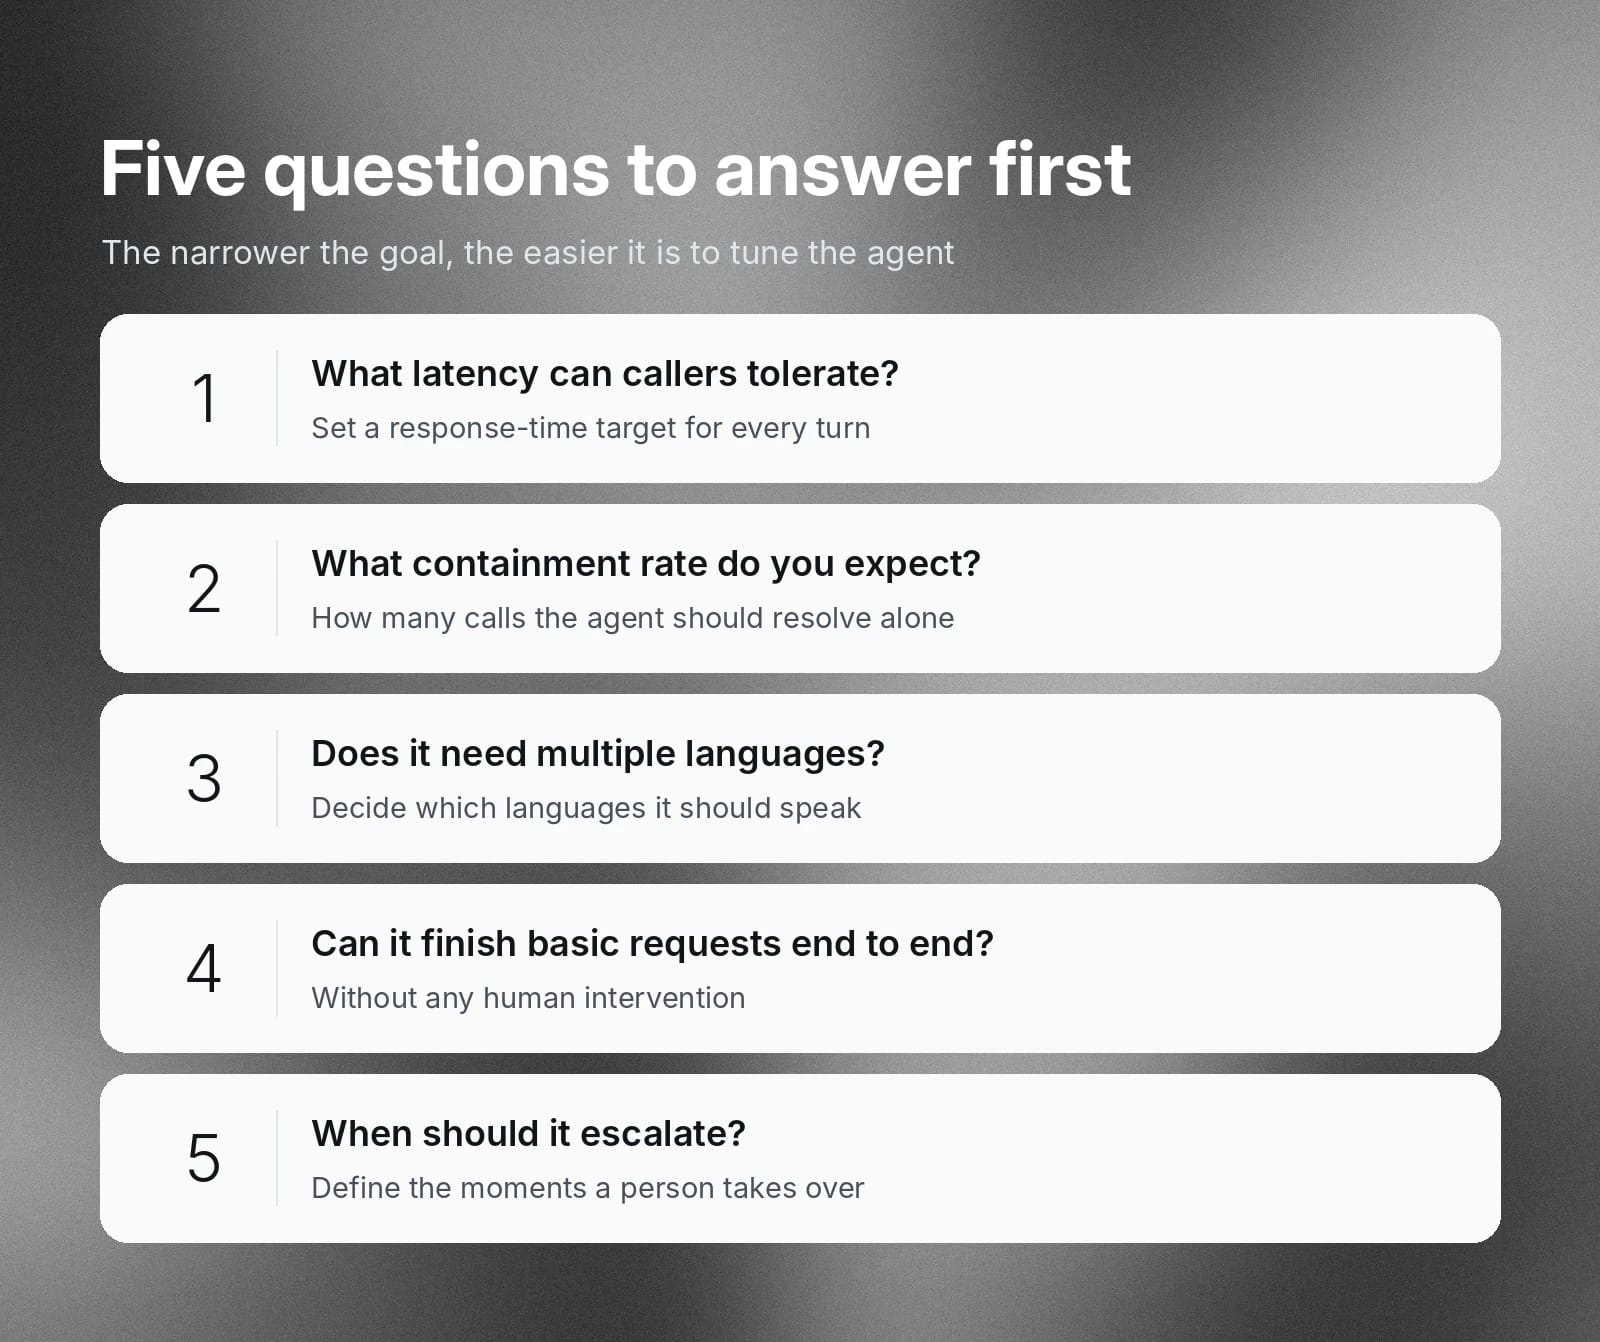
In een enterprise-omgeving moet de agent consistent presteren ten opzichte van specifieke doelen. Hoe smaller het doel, hoe makkelijker je de agent kunt beoordelen en finetunen.
Stel daarom vroeg in de ontwikkeling vragen zoals:
- Welke reactielatentie is acceptabel?
- Wat is de verwachte containment rate?
- Moet de agent in meerdere talen kunnen communiceren?
- Kan de AI-assistent basisverzoeken volledig afhandelen zonder menselijke tussenkomst?
- Onder welke omstandigheden moet de agent escaleren naar menselijke support?
Bouwen met raw API's of ElevenAgents gebruiken?
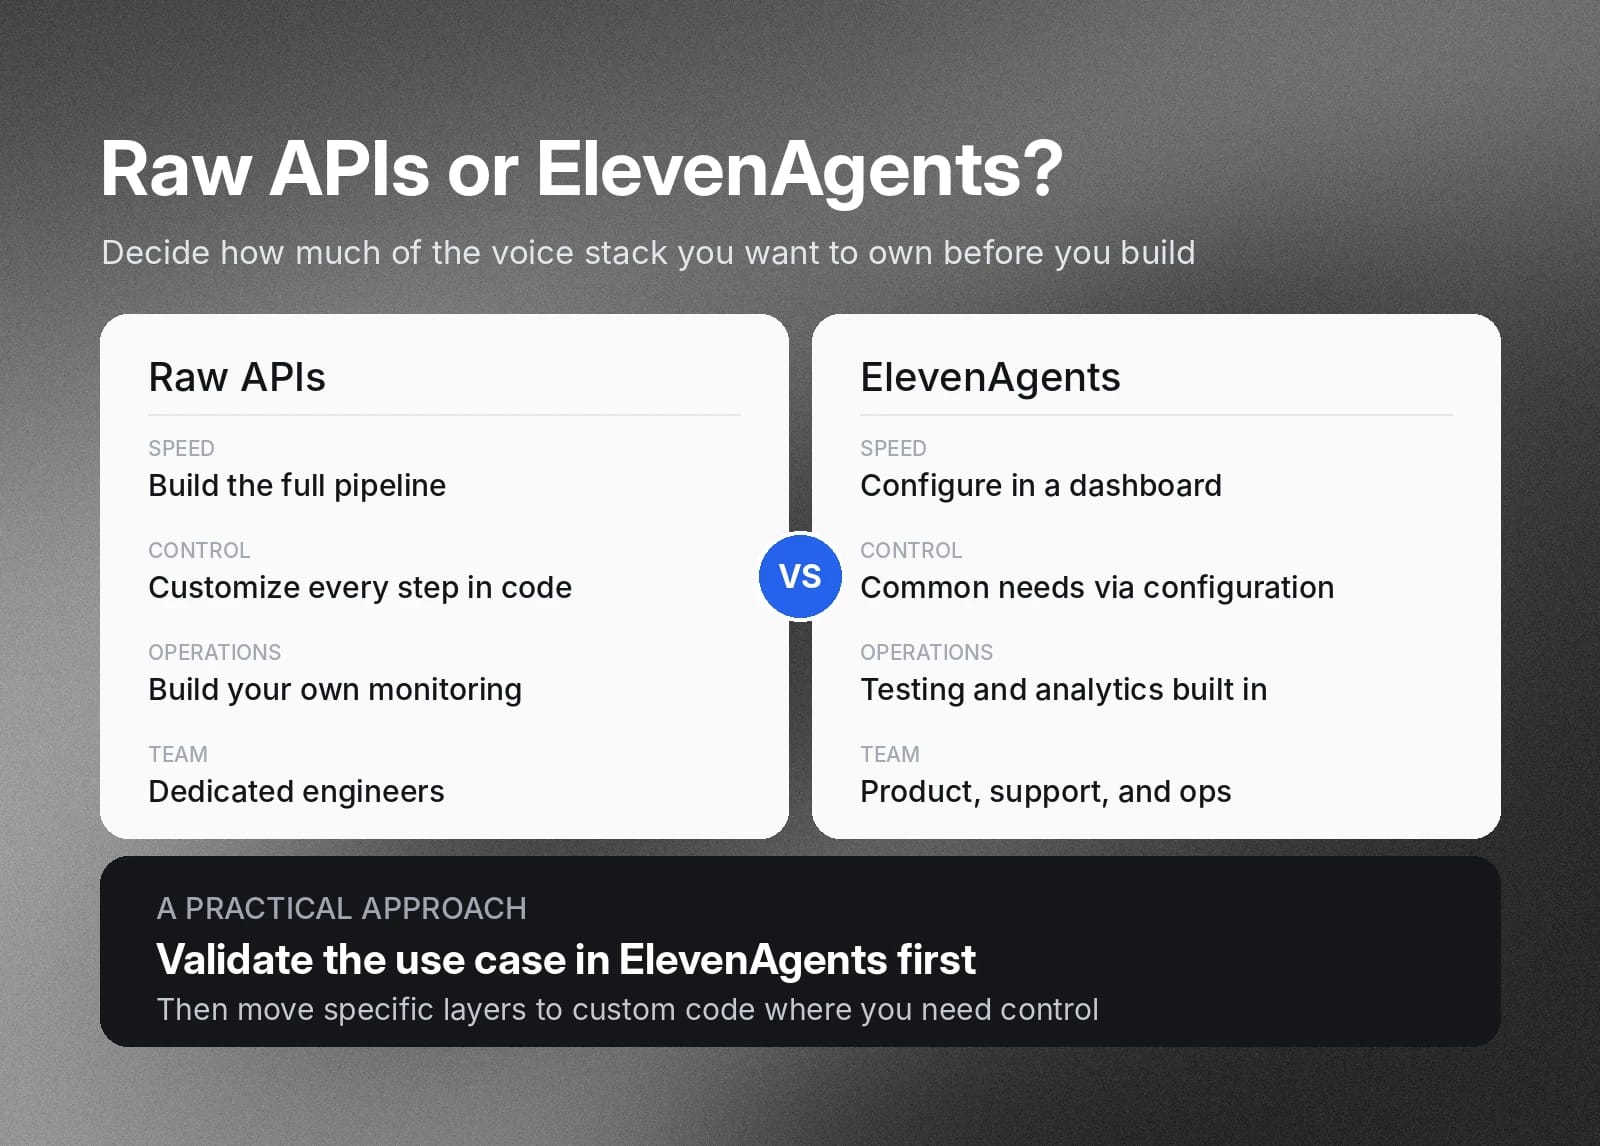
Bepaal voordat je code schrijft, hoeveel van de spraakstack je zelf wilt beheren. Je kunt Speech to Text, een LLM en Text to Speech zelf via ElevenAPI koppelen, of ElevenAgents gebruiken: een beheerd platform dat deze onderdelen bundelt.
Bouwen met raw API's geeft je volledige controle over elke laag. Je kiest de LLM, schrijft de orchestrationcode en beheert beurtwisseling, onderbrekingen, telefonie en monitoring. Dit pad past bij teams met specifieke architectuurvereisten en wordt gevolgd in de Python-walkthrough in deze gids.
ElevenAgents brengt modellen, tools, een kennisbank en workflows samen in één dashboard. Het koppelt telefonieproviders, zoals Twilio en Amazon Connect, aan bedrijfstools zoals Salesforce, Zendesk en HubSpot. Ook bevat het simulaties en geautomatiseerde tests voor de lancering, plus achteraf analytics over succespercentage, CSAT en transcripts.
Gebruik deze vragen om te kiezen:
- Snelheid: Met ElevenAgents kan een team vanuit een dashboard een agent configureren en lanceren, terwijl raw API's vereisen dat je de volledige pipeline bouwt en onderhoudt.
- Controle: Met raw API's kun je elke stap in code aanpassen, terwijl ElevenAgents via configuratie in veelvoorkomende behoeften voorziet.
- Operations: ElevenAgents bevat tests en analytics, terwijl je met raw API's zelf monitoring moet bouwen.
- Team: ElevenAgents past bij gemengde teams van product-, support- en operationsmedewerkers, terwijl raw API's passen bij teams met gespecialiseerde engineers.
Een praktische aanpak is om de use case eerst in ElevenAgents te valideren en specifieke lagen pas naar custom code te verplaatsen wanneer je meer controle nodig hebt.
Breng de architectuur van de AI-spraakassistent in kaart
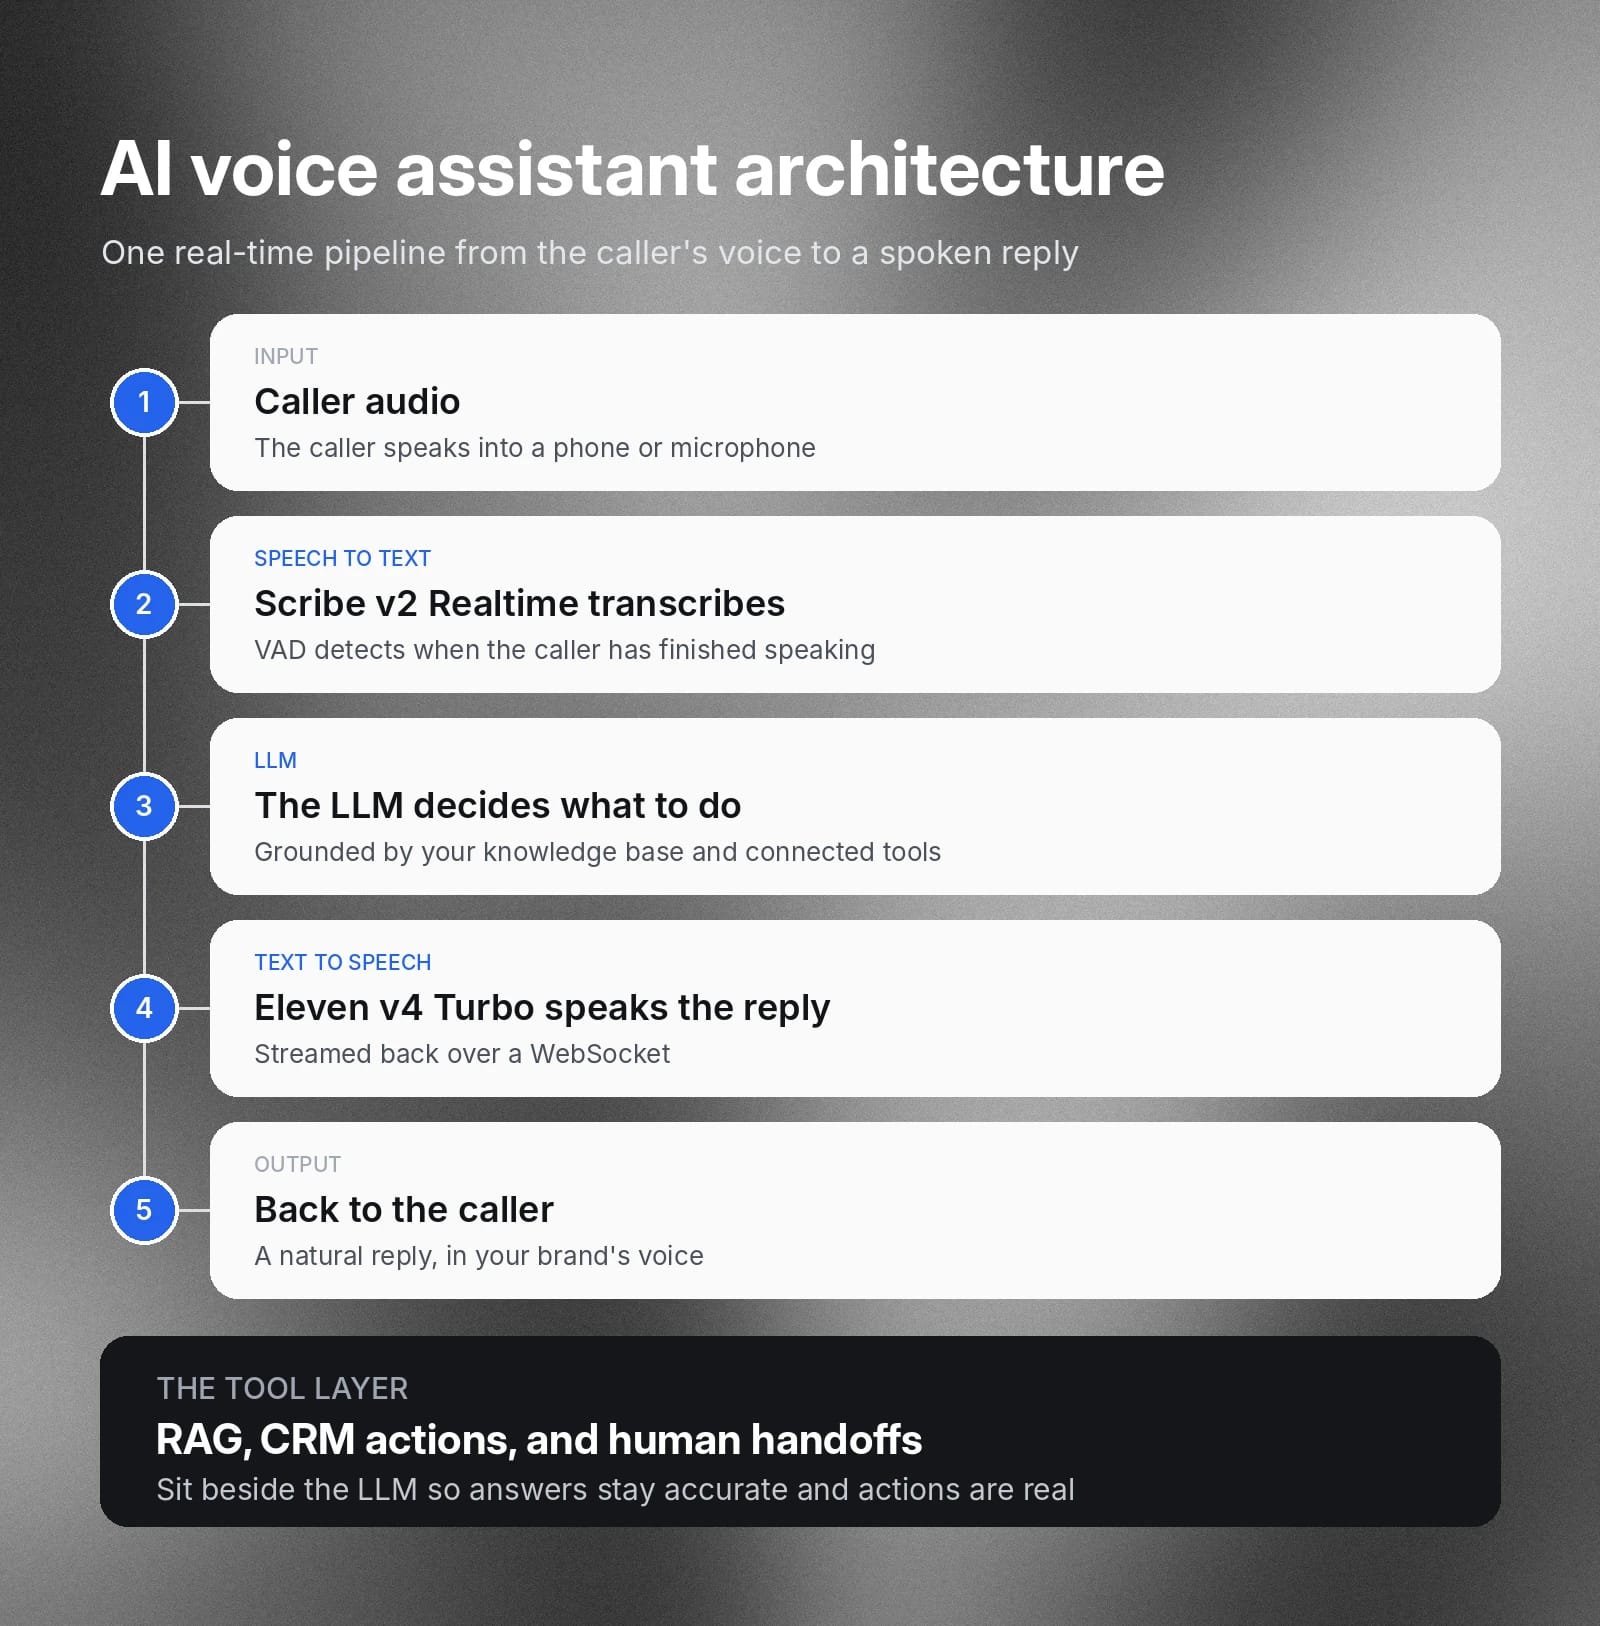
Zodra je het bedrijfsdoel hebt bepaald, koppel je de functies van de agent aan de juiste technologieën. Een AI-spraakassistent is afhankelijk van verschillende belangrijke onderdelen die samenwerken om spraak om te zetten in tekst, acties te activeren en een samenhangend antwoord te geven.
- Een Speech to Text-model registreert gesproken uitingen, herkent fonemen en maakt transcripts van het gesprek.
- Een AI-engine, variërend van een eenvoudig regelgebaseerd algoritme of een bibliotheek voor natuurlijke taalverwerking tot een large language model (LLM), fungeert als het brein van de spraakassistent.
- Een Text to Speech-model synthetiseert conversatieantwoorden met mensachtige stemmen en volgt merkrichtlijnen.
ElevenLabs biedt Speech to Text- en Text to Dialogue-spraak- en audiomodellen die product- en engineeringteams helpen bij het ontwerpen van AI-spraakassistenten. Onze modellen ondersteunen genuanceerde intonatie, emotioneel bewustzijn en reacties met lage latentie. Je hebt via ElevenAPI toegang tot de spraakmodellen.
Je keuze voor AI-modellen hangt sterk af van de doelen en vereisten van de spraakassistent. Hoewel LLM's zoals OpenAI GPT-modellen, Gemini en Claude uitblinken in redeneren, hebben ze aanvullende finetuning nodig om aan domeinspecifieke behoeften te voldoen. Soms is een eenvoudiger neuraal netwerk of een regelgebaseerde parser praktischer.
Naast spraak- en AI-modellen heb je ook custom software nodig die specifieke entiteiten uit gesprekken of gebruikersverzoeken haalt. Wanneer een beller bijvoorbeeld zegt: “Ik wil met de verkoopafdeling spreken”, moet je code “verkoopafdeling” herkennen en de juiste actie activeren.
Maak API-sleutels en verbind Speech to Text, een LLM, tools en Text to Speech
Voordat je verbinding maakt met spraak- en taalmodellen. Ook heb je API-sleutels nodig om API-requests te doen wanneer je tools van externe diensten in je spraakassistent integreert.
- Een ElevenLabs API-sleutel maken? Klik hier.
- Een OpenAI LLM gebruiken? Haal hier je sleutel op.
- Als je verbinding maakt met CRM's, ERP's en andere tools van derden, raadpleeg dan de officiële documentatie om een API-sleutel te maken en ondersteunde API's te vinden.
Sla de API-sleutels na het ophalen op in je ontwikkelomgeving.
Vervolgens start je de tools, LLM en audiomodellen en krijg je er toegang toe door de juiste argumenten aan de API door te geven.
1. Maak eerst verbinding met ElevenLabs Scribe v2 Realtime om automatische spraakherkenning uit te voeren. Met ElevenLabs Scribe v2 Realtime kun je voice agents met lage latentie maken die gesprekken in minder dan 150 ms omzetten in tekst (exclusief netwerk- en applicatietijd).
Hieronder staat een Python-codefragment dat microfoonopnamen vastlegt met ElevenLabs Scribe v2 Realtime.
2. Vervolgens stuur je het transcript naar een LLM met sterke redeneercapaciteiten om een antwoord te genereren. In dit voorbeeld gebruiken we OpenAI GPT-4o mini.
Zo stuur je in je Python-code een transcript naar een LLM.
3. Zet de output van de LLM na ontvangst om in een realistische gesproken reactie met ElevenLabs v4 Turbo. Ons Text to Speech-model is zeer expressief, ontworpen voor realtime interactie en heeft een uiterst lage latentie van ~100 ms (dit betreft alleen de inferentietijd van het model. De daadwerkelijke end-to-endlatentie varieert afhankelijk van factoren zoals je locatie en het gebruikte endpointtype).
De onderstaande code toont hoe de agent een WebSocket gebruikt om spraakantwoorden te streamen met de ElevenLabs Text to Dialogue API.
Je agent voor automatische spraakherkenning moet gesprekken met meerdere beurten soepel kunnen afhandelen. Daarvoor heb je een spraakagent nodig die weet wanneer spraak begint en stopt.
Ontwerp gesprekken die natuurlijk klinken en bij de taak blijven
Conventionele systemen voor interactive voice response (IVR) werken niet buiten de scenario's waarvoor ze zijn geprogrammeerd. Wanneer ze problemen moeten oplossen die niet in hun regels zijn gedefinieerd, geven deze IVR's geen bevredigende antwoorden. Bovendien klinken ze niet altijd natuurlijk, wat de klantervaring schaadt.
Met geavanceerde AI- en spraakmodellen kan een spraakassistent natuurlijker reageren en uitzonderingssituaties afhandelen. Je kunt verschillende scenario's ontwerpen waarop de agent moet anticiperen, plus een escalatiepad voor gevallen die deze niet kan oplossen. Sommige klanten bellen bijvoorbeeld om naar de verzendstatus te vragen, terwijl anderen gefrustreerd zijn door defecte producten en erop staan een CX-manager te spreken.
Schrijf systeeminstructies, regels voor beurtwisseling en fallbackreacties
Om verschillende scenario's af te handelen, maak je specifieke code voor logica-afhandeling en systeemprompts in de AI-spraakagentapplicatie.
De systeemprompt hieronder detecteert bijvoorbeeld frustratie en instrueert de LLM om empathischer te reageren.
AI-gesprekken mogen nooit gehaast aanvoelen of worden onderbroken. Het spraakmodel moet detecteren wanneer de gebruiker is uitgesproken en op tijd reageren. Met ElevenLabs Scribe v2 Realtime kun je VAD activeren wanneer je naar microfooninput luistert. Anders dan conventionele VAD, die alleen afgaat op de duur van stilte, gebruikt ElevenLabs Scribe v2 Realtime deep-learningalgoritmen om te bepalen of een klant is uitgesproken.
Stel de parameter in je code in wanneer je met de Speech to Text API werkt om VAD in te schakelen.
Geef vervolgens beleefde, respectvolle fallbackreacties als de agent het verzoek van de klant niet naar tevredenheid kan beantwoorden. Een AI-agent kan ook een fout tegenkomen tijdens het transcriberen van gesprekken. Je code moet technische problemen afhandelen en open communiceren met klanten.
Voor fallbackreacties gebruik je voorwaardelijke logica in je code. Het onderstaande codefragment legt bijvoorbeeld een foutstatus vast vanuit de Speech to Text API en activeert passende reacties.
Bouw de kennis- en toollaag voor betrouwbare antwoorden
LLM's bieden sterke redeneercapaciteiten, waardoor een AI-spraakassistent natuurlijk kan reageren. Een conversationeel antwoord betekent echter niet altijd dat het nauwkeurig is. Zonder onderbouwende gegevens kunnen LLM's hallucineren, waardoor de spraakagent plausibele maar onjuiste antwoorden geeft.
Als je GPT-4o mini bijvoorbeeld vraagt naar een product dat je onlangs hebt gelanceerd, kan het niet met vertrouwen een antwoord geven. Daarvoor moet je de LLM met een retrieval-augmented generation-systeem (RAG) verbinden met je interne kennisbank. RAG laat de LLM interne producthandleidingen raadplegen en een nauwkeurig antwoord geven.
Voeg retrieval, API-acties, rechten en overdrachten aan mensen toe
Om RAG te gebruiken, moet je een vectordatabase maken. Een vectordatabase slaat documenten op als numerieke representaties in een multidimensionale ruimte. Het volgende codefragment laat zien hoe de voice agent relevante documenten uit de vector store ophaalt voordat de LLM wordt geraadpleegd.
Naast RAG heeft je AI-spraakassistent waarschijnlijk toegang nodig tot CRM-, ERP- en andere enterprisesystemen. Zo kan de spraakagent noodzakelijke informatie, zoals klantgegevens, historische transacties en markttrends, als context gebruiken bij het opstellen van antwoorden.
Je kunt bijvoorbeeld ElevenLabs met HubSpot integreren met API's. Zo kun je veelvoorkomende problemen oplossen met de CRM-kennisbank, tickets maken en support escaleren met de volledige gesprekscontext.
Hier is een codefragment waarmee de spraakagent een supportticket in HubSpot kan maken.
Hoewel AI-spraakagenten het oplossen van problemen kunnen versnellen, moeten klanten hun opties kennen, vooral wanneer wijzigingen hun account aanzienlijk kunnen beïnvloeden. Anders dan bij tekstgebaseerde chatbots, vereist het mondeling opsommen van opties meer waarborgen. Zodra klanten een keuze hebben gemaakt, kan het lastig zijn die tijdens een gesprek terug te draaien.
In dat geval raden we aan de beller te authenticeren en om mondelinge bevestiging te vragen. Als de klant bijvoorbeeld een aankoop wil annuleren, moet je spraakagent expliciet vragen: “Weet je zeker dat je de bestelling wilt annuleren?” en op een antwoord wachten.
Hieronder tonen we een voorbeeld.
De identiteit van een beller verifiëren met een AI-spraakagent
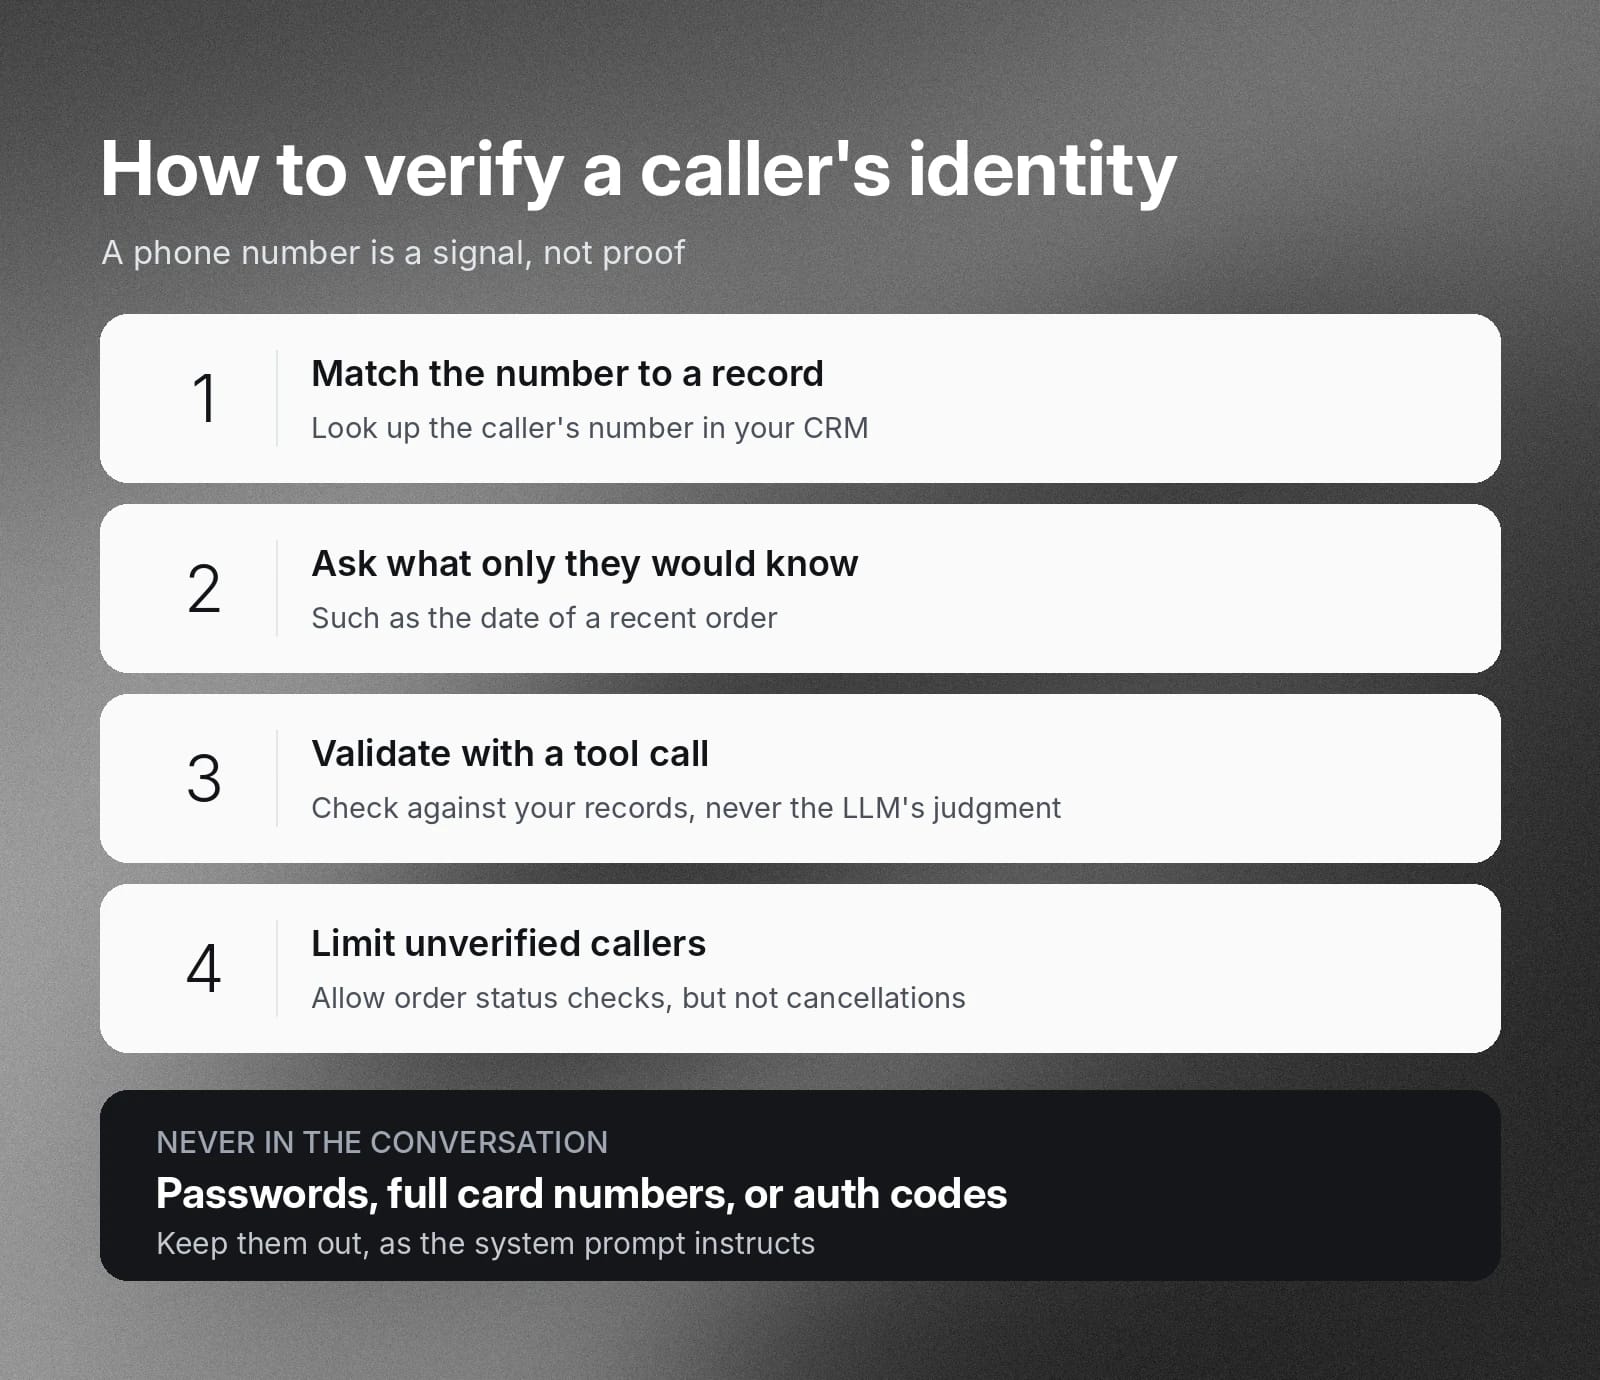
Voordat een AI-spraakagent accountgegevens deelt of een account wijzigt, moet deze bevestigen met wie deze spreekt. Het telefoonnummer van een beller is een nuttig signaal, maar bewijst de identiteit niet. Combineer het met andere controles:
- Koppel het nummer van de beller aan een klantrecord in je CRM.
- Vraag om gegevens die alleen de accounthouder zou weten, zoals een recente besteldatum.
- Valideer de antwoorden via een tool call met je gegevens en vertrouw nooit op de LLM om te beoordelen of ze juist zijn.
- Beperk wat een niet-geverifieerde beller kan doen, bijvoorbeeld door orderstatuscontroles toe te staan maar annuleringen niet.
Houd wachtwoorden, volledige betaalkaartnummers en authenticatiecodes buiten het gesprek, zoals de systeemprompt hierboven voorschrijft.
AI-spraakagent met live gespreksdoorschakeling en escalatie
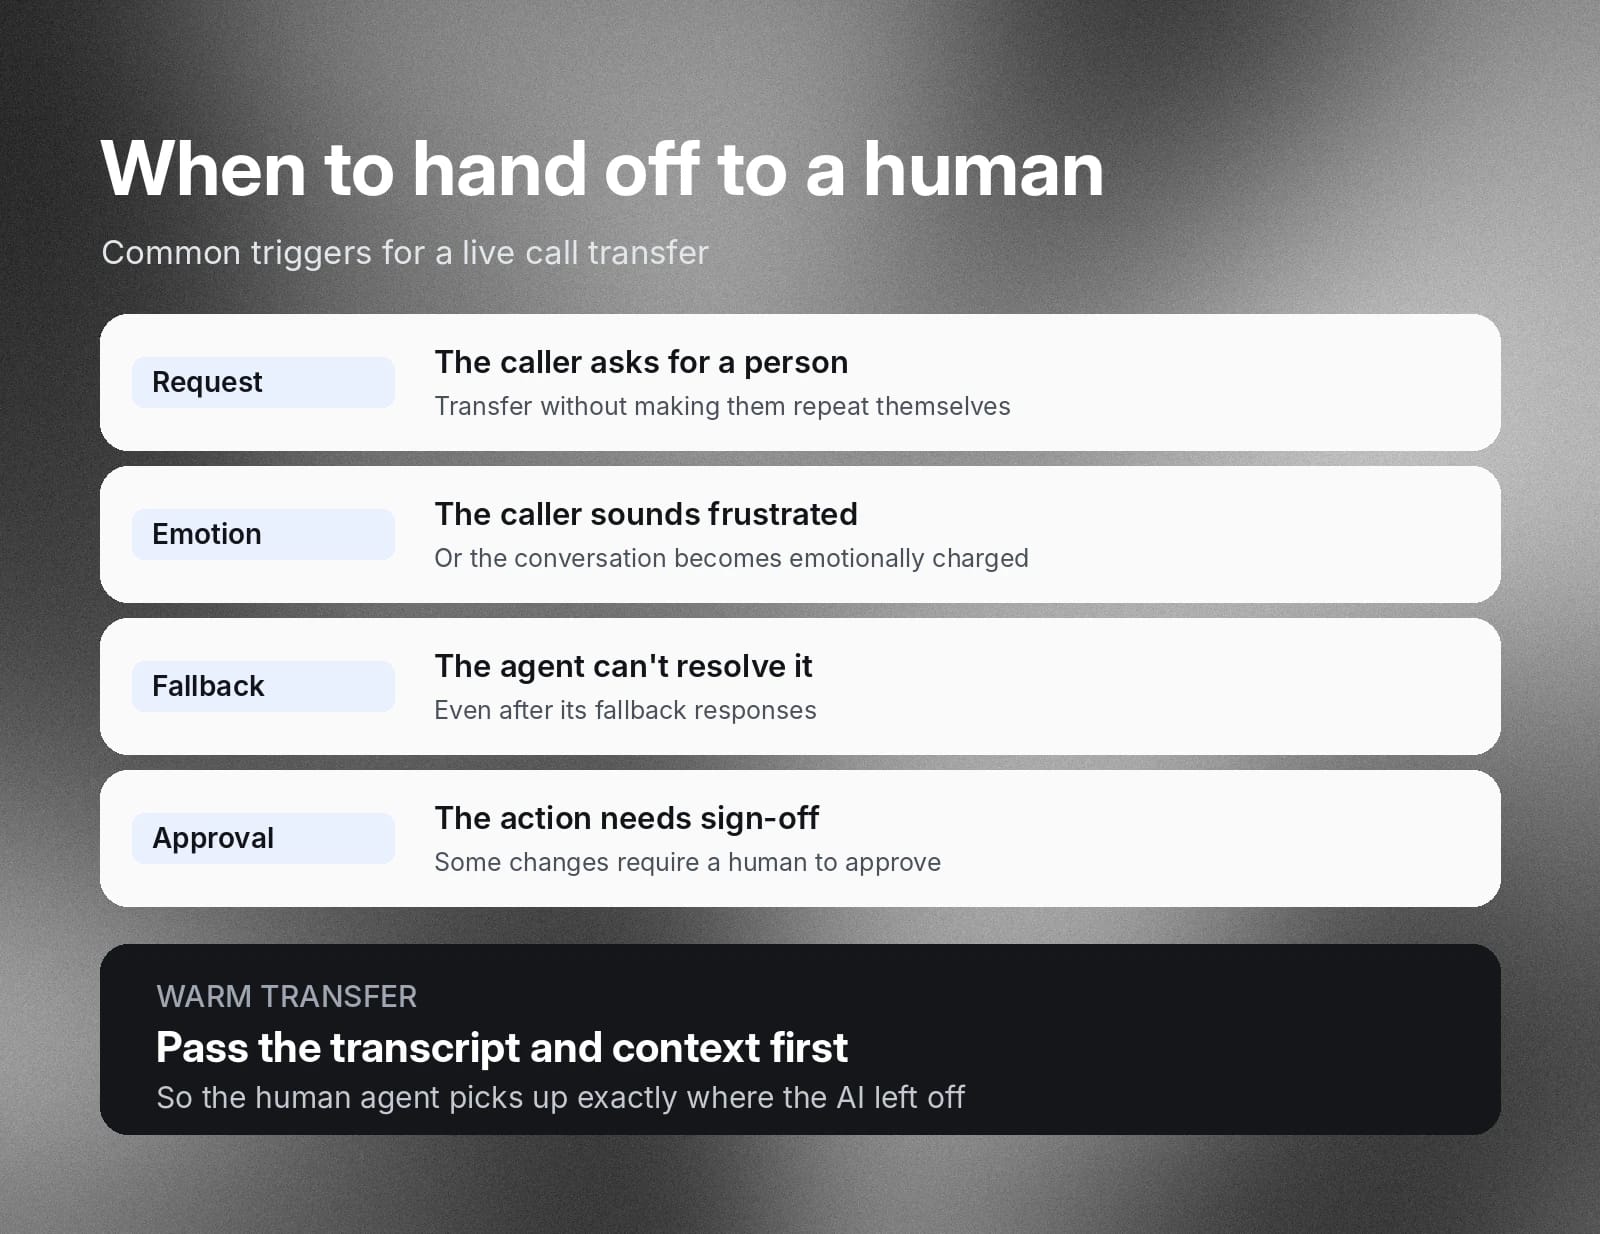
Bij een directe doorverbinding wordt de beller doorverbonden met een menselijke agent zonder dat die persoon alles hoeft te herhalen. Bij een warm transfer geeft de voice agent het transcript en de context door aan de medewerker voordat het gesprek wordt doorverbonden. Veelvoorkomende triggers zijn:
- De beller vraagt om met een persoon te spreken.
- De beller klinkt gefrustreerd of het gesprek wordt emotioneel beladen.
- De agent kan het verzoek niet oplossen na de fallbackreacties.
- Het verzoek vereist een actie die menselijke goedkeuring nodig heeft.
In sommige gevallen moet de AI-agent het gesprek doorschakelen naar een menselijke agent. Vaak detecteert de voice agent intenties die op frustratie wijzen of specifieke woorden die de doorschakeling activeren. In je code moet de gespreksdoorschakeling naadloos verlopen en voor klanten onzichtbaar zijn.
Voor de overdracht geef je het transcript, klantgegevens en andere ondersteunende context door aan de live supportdesk. ElevenLabs biedt een tool voor overdracht naar een nummer die gesprekken van AI-agenten doorstuurt naar een SIP-trunk of Twilio-telefoonnummer.
Het onderstaande codefragment toont een overdracht via een Twilio-conferentie.
Bouw zonder code een AI-spraakassistent in ElevenAgents
Als je geen custom code nodig hebt, kun je dezelfde assistent in ElevenAgents lanceren. De stappen volgen de architectuur hierboven, maar je configureert elke laag in een dashboard in plaats van deze te schrijven.
- Maak een agent en beschrijf de taak in de systeemprompt, inclusief toon, bereik en wanneer deze moet escaleren.
- Kies een stem uit de Voice Library, of ontwerp of kloon je eigen stem, en stel de talen in die de agent moet spreken.
- Voeg je kennisbank toe zodat de agent vanuit je eigen documenten kan antwoorden.
- Verbind tools en integraties, zoals je CRM of helpdesk, zodat de agent actie kan ondernemen.
- Stel een overdracht naar een menselijke agent in voor gesprekken die de assistent niet kan oplossen.
- Voer simulaties en geautomatiseerde tests uit om het gedrag voor de lancering te controleren.
- Implementeer de agent op een telefoonnummer of kanaal en bekijk vervolgens succespercentages, CSAT en transcripts.
De richtlijnen voor testen en meten in de onderstaande secties gelden zowel wanneer je met als zonder code bouwt.
Een AI-spraakassistent bouwen die bij je merk past
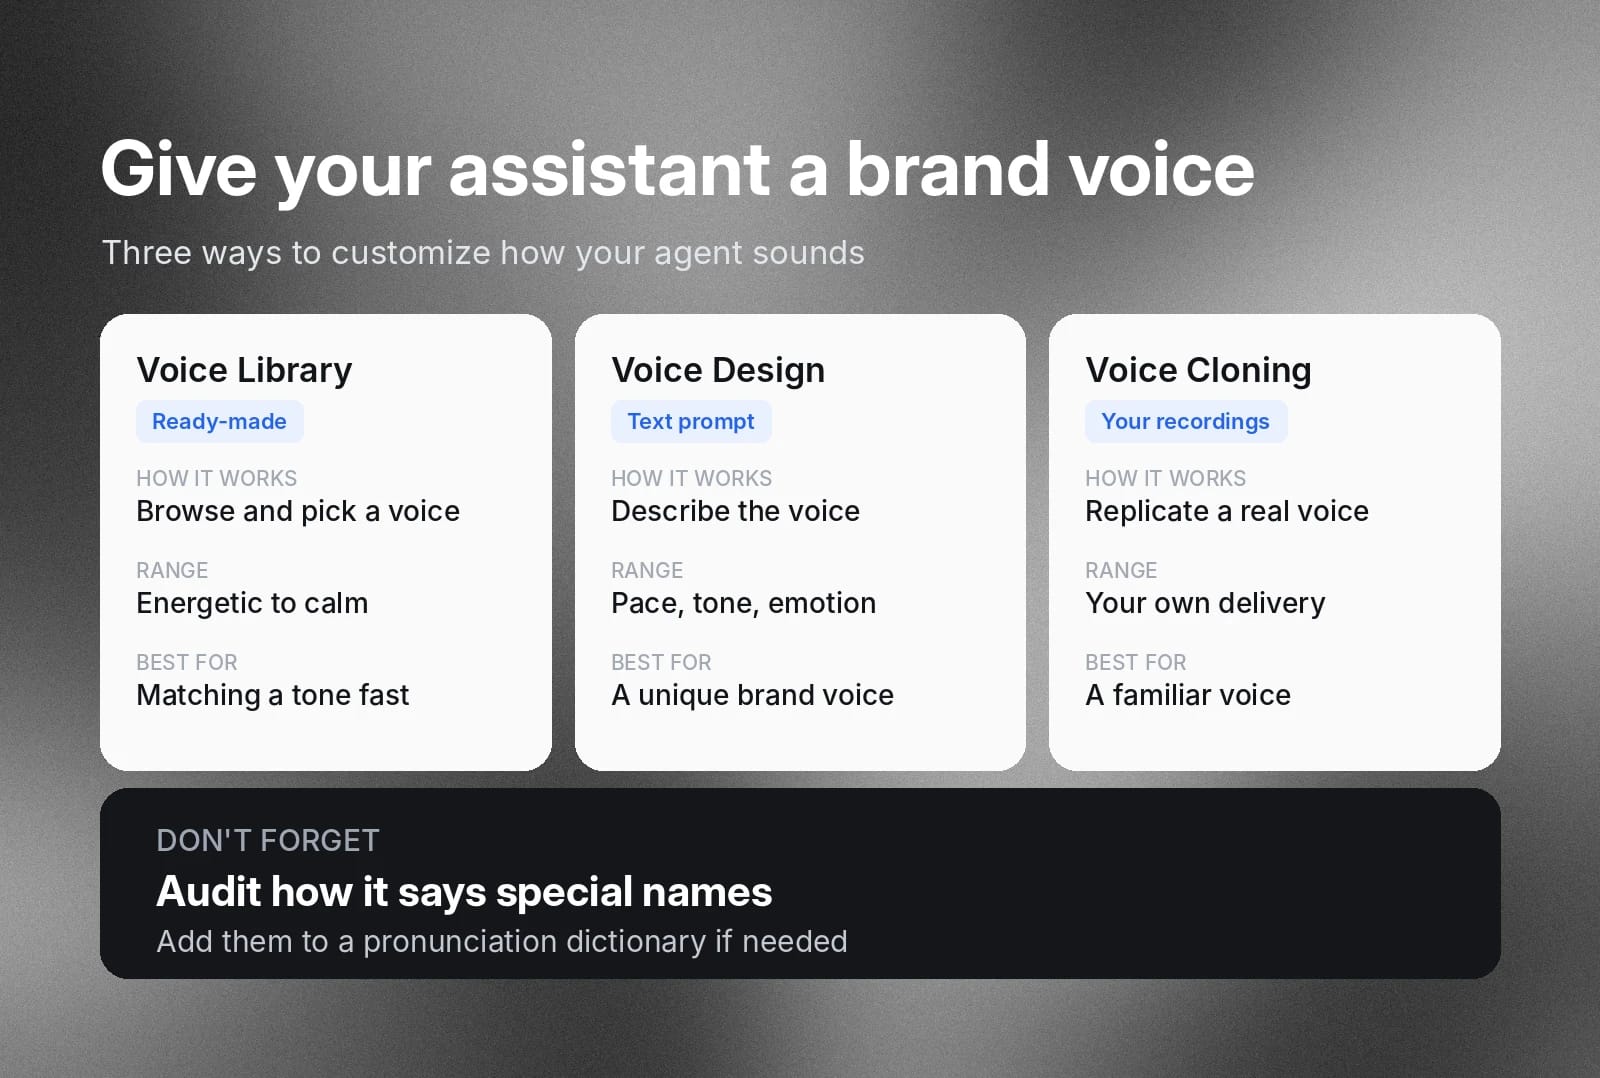
Organisaties kunnen de stem van de AI-agent aanpassen aan hun merk. Een consistente toon gedurende het gesprek helpt vertrouwen op te bouwen. Met ElevenLabs kun je de stem van je AI-agent op verschillende manieren aanpassen.
- ElevenLabs Voice Library biedt meer dan 20.000 AI-stemmen die natuurlijk worden gesproken in meer dan 90 talen. Van energiek tot kalm en zelfverzekerd: je kunt elke stem bekijken en gebruiken die bij je merktoon past.
- ElevenLabs Voice Design laat je met een tekstprompt een unieke stemidentiteit creëren. Beschrijf het tempo, de toon, emotie en andere vocale kenmerken om de gewenste stem te krijgen.
- AI-stemklonen van ElevenLabs maakt een digitale replica van je stem door een sample van je gesproken opnamen te analyseren.
Naast het goed krijgen van emotie en nuances is het belangrijk om de uitspraak van de AI-stem te controleren, vooral bij bijzondere namen. Maak indien nodig een uitspraakwoordenboek dat je spraakmodel kan raadplegen.
Test latentie, onderbrekingen, nauwkeurigheid en veiligheid voor de lancering
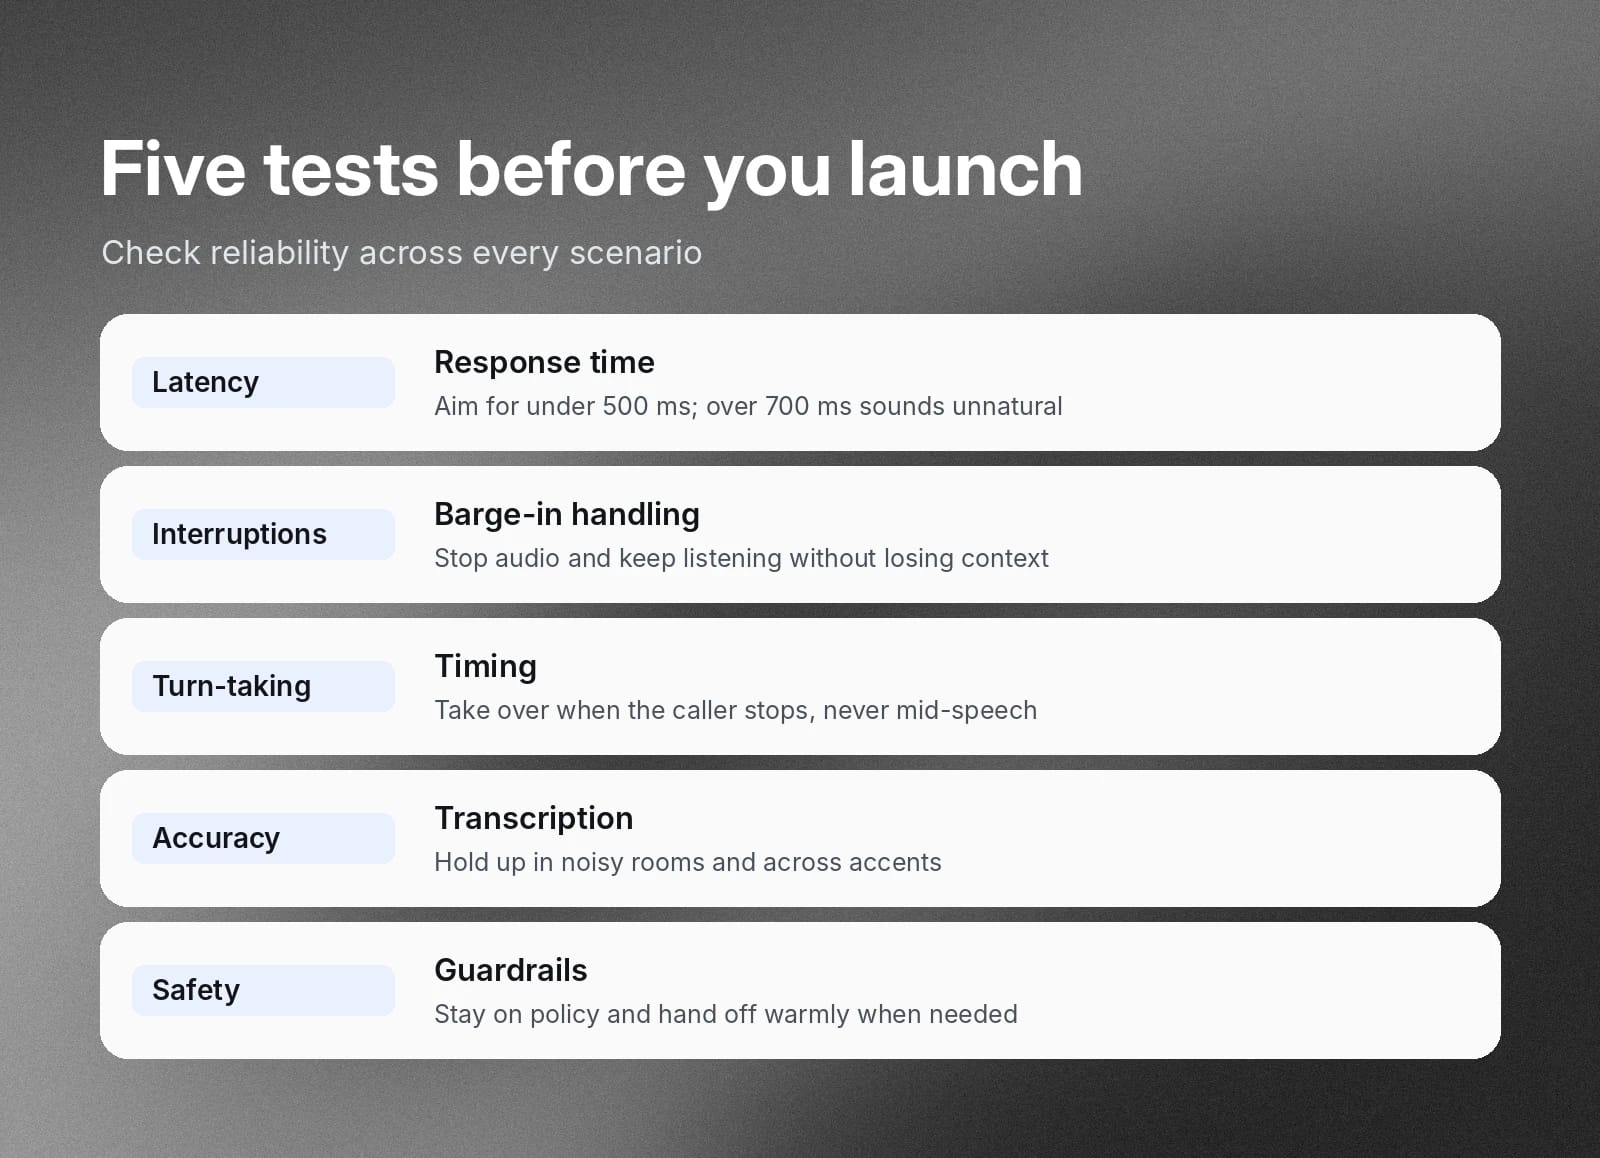
Test je AI-spraakagent grondig voor de lancering om te zorgen dat deze betrouwbaar presteert in verschillende scenario's.
- Latentietest: Een agent die meer dan 700 ms nodig heeft om te reageren, klinkt onnatuurlijk voor klanten. Afhankelijk van je setup kunnen netwerksnelheid, de LLM, spraakmodellen en API's van derden de latentie beïnvloeden. Houd de conversatielatentie idealiter onder 500 ms.
- Onderbrekingstest: controleer of de agent onderbrekingen midden in het gesprek afhandelt. De agent moet met name output-audioframes verwijderen, TTS stoppen en de gesproken input weer vastleggen zonder context te verliezen.
- Test voor beurtwisseling: Wanneer de gebruiker stopt met spreken, moet de agent het natuurlijk overnemen. Beoordeel of de agent dit op het juiste moment doet en niet midden in een uiting onderbreekt. Lees voor een uitgebreide gids hoe ElevenLabs hier beurtwisseling afhandelt.
- Nauwkeurigheidstest: Elke onnauwkeurigheid in de STT-laag werkt door naar volgende lagen. Zorg dat de spraakassistent spraak ook in rumoerige omgevingen begrijpt. Ook moet het spraakmodel spraak met verschillende accenten consistent nauwkeurig transcriberen.
- Veiligheidstest: Zorg dat guardrails systeemgedrag voorkomen dat het merkbeleid schendt. Als een interactie emotioneel beladen raakt, moet de agent volgens vooraf ingestelde richtlijnen een warme overdracht naar een menselijke agent faciliteren.
Meet resultaten en verbeter de ontwikkeling van je spraakassistent
Het voldoen aan interne testcriteria bereidt je AI-spraakagent voor op implementatie in de praktijk. Het is echter niet het einddoel in de ontwikkelcyclus. Iteratie na implementatie is even belangrijk om ervoor te zorgen dat je AI-spraakagent klantverzoeken blijft oplossen.
Je gebruikt feedback uit conversationele AI-metrics om hiaten in je AI-assistent te identificeren. Verfijn vervolgens geleidelijk de applicatielogica, API-integraties, modelkeuzes en andere onderdelen van de tech stack om de prestaties van conversationele AI te verbeteren.
Volg containment, afhandeling, klanttevredenheid en foutmodi
Meet je AI-assistent voortdurend aan de hand van benchmarks in de branche. Enkele metrics om bij te houden zijn:
- Containment: houdt bij hoeveel gesprekken de AI-agent succesvol afhandelt.
- Escalatiepercentage: meet gesprekken waarvoor uiteindelijk menselijke tussenkomst nodig is.
- Woordfoutpercentage: Een nauwkeurigheidsmaatstaf die aangeeft hoe precies AI audio transcribeert.
- Hallucinatiepercentage: toont incidenten waarin LLM's onjuiste maar plausibele antwoorden genereren.
- CSAT: klantfeedback die aangeeft hoe tevreden klanten zijn over de AI-spraakagent.
Ontdek meer over metrics voor conversationele AI.
Ga aan de slag met ElevenAPI voor AI-spraakassistenten
ElevenAPI vereenvoudigt de ontwikkeling van AI-spraakassistenten. Met toonaangevende Text to Speech- en Speech to Text-modellen kun je contextbewuste conversationele AI-agenten maken die naadloos in je enterprise-workflow passen. Onze spraak- en audiomodellen bieden consistent hoge nauwkeurigheid en lage latentie voor een natuurlijke klantervaring.
Haal hier je ElevenAPI API-sleutel op en bekijk onze officiële documentatie om te beginnen met bouwen.
FAQ: een AI-spraakassistent bouwen

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.


