
Mogelijkheden van voice agents: geheugen, escalatie en meer
- Geschreven door
- Jack Limebear
- Gepubliceerd
LuisterenLuister naar dit artikel
Traditionele telefoonsystemen waren afhankelijk van vooraf ingestelde, menu-gestuurde antwoorden. Daardoor konden ze zich beperkt aanpassen aan natuurlijke spraak of complexe workflowverzoeken afhandelen. De mogelijkheden van voice agents gaan tegenwoordig veel verder: ze brengen realtime spraakherkenning, redeneren en context samen in responsievere spraaksystemen.
Moderne voice agents kunnen een klant authenticeren, informatie in het systeem opzoeken, passende antwoorden geven met live data, herkennen wanneer de situatie moet worden overgedragen en meer. Dit alles gebeurt tijdens een live gesprek, zonder de gebruiker via een telefoonwachtrij te laten wachten op een menselijke agent.
Deze gids beantwoordt zes vragen over de mogelijkheden van AI-voice agents: hoe ze bellers onthouden, hoe ze met frustratie omgaan, met welke data ze worden getraind, hoe ze personaliseren, hoe ze gevoelige data beschermen en wat ze doen voor de klanttevredenheid. Elk antwoord beschrijft hoe ElevenAgents dit in de praktijk doet.
Samenvatting:
- Voice agents combineren realtime spraakherkenning met redeneren op basis van live data, waardoor ze bellers kunnen authenticeren, met actuele informatie kunnen antwoorden en taken tijdens een gesprek kunnen afronden zonder iemand via een telefoonwachtrij te leiden.
- Het geheugen van een agent werkt binnen één gesprek en tussen terugkerende interacties. Aan het begin wordt de klanthistorie via dynamische variabelen uit een CRM opgehaald en uitkomsten worden via post-call webhooks teruggeschreven.
- Gefrustreerde bellers worden afgehandeld met sentimentdetectie en realtime de-escalatie, met een overdrachtsroute naar een mens of gespecialiseerde agent wanneer de frustratie een drempel overschrijdt of de beller om een persoon vraagt.
- Agents bouwen kennis op uit geüploade content in onder meer PDF, Word, tekst, Markdown, HTML en EPUB. Ze gebruiken RAG om relevante passages op te halen, terwijl kleinere documenten in volledige context blijven.
- Gepersonaliseerde aanbevelingen combineren CRM-data, het live verzoek en productopzoekingen tijdens het gesprek via tool calling, zodat de agent de werkelijke beschikbaarheid afstemt op de geschiedenis van de beller.
- Configureerbare privacyinstellingen regelen databewaring, audio-opslag, redactie van transcripts en zero-retention mode, met HIPAA-geschiktheid voor enterprise-zorgimplementaties.
Wat zijn de mogelijkheden van voice agents?
Een voice agent is een systeem met kunstmatige intelligentie (AI) dat realtime gesproken gesprekken met klanten kan voeren. Dit gaat verder dan traditionele spraakmogelijkheden, doordat het de intentie en context van de situatie begrijpt en taken namens de klant uitvoert. Deze agents luisteren naar de klant, redeneren over wat ze horen, raadplegen de systemen die nodig zijn om het verzoek af te handelen en spreken vervolgens op natuurlijke toon met de klant, vergelijkbaar met een menselijke klantenserviceagent.
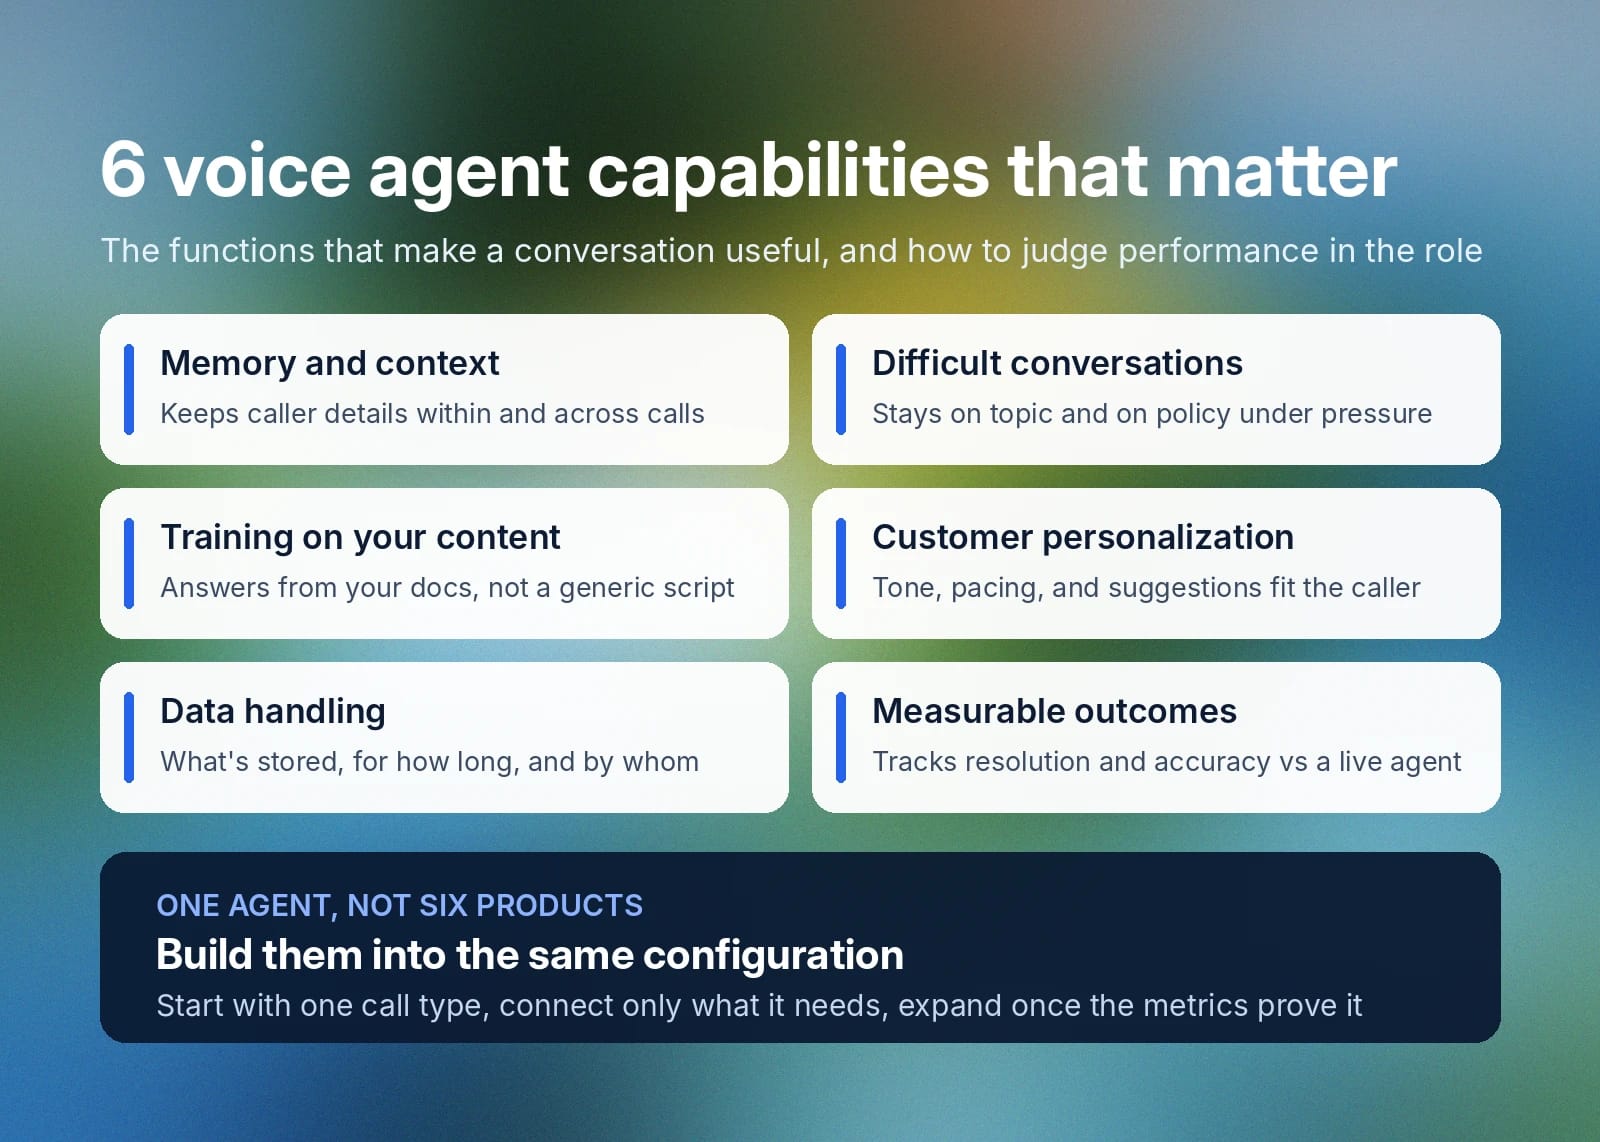
De mogelijkheden van voice agents zijn de specifieke functies die gesprekken tussen de agent en de klant nuttig maken. Deze functies kun je in verschillende categorieën indelen om te bepalen hoe goed een agent in die rol presteert:
- Geheugen en context: Het vermogen om informatie over een klant te bewaren tijdens één gesprek of meerdere interacties met dezelfde klant.
- Omgaan met lastige scenario's en gesprekken: Agents blijven bij het onderwerp en volgen beleid wanneer een beller gefrustreerd, verward of niet bereid is de uitkomst te accepteren.
- Trainingsmogelijkheden met je content: Agents leren van bestaande interne bedrijfsdocumentatie en beleidsregels om antwoorden voor de interactie op te halen, in plaats van een algemeen script te gebruiken.
- Klantpersonalisatie: Agents passen hun toon, tempo of aanbevelingen aan op basis van wie de beller is, in plaats van een algemeen optiemenu te gebruiken.
- Dataverwerking: De informatie die met agents wordt gedeeld, wordt beheerd op basis van welke data wordt opgeslagen, hoe lang het bedrijf deze bewaart en wie er toegang toe heeft.
- Meetbare resultaten voor succes: Een systeem bepalen dat interne tracking biedt om beter vast te stellen of een voice agent problemen oplost en dit nauwkeurig doet in vergelijking met een menselijke agent.
Deze mogelijkheden van voice agents kunnen bedrijven uiteindelijk helpen hun agents beter af te stemmen op de behoeften van klanten.
Hoe onthouden voice agents eerdere gesprekken met klanten?
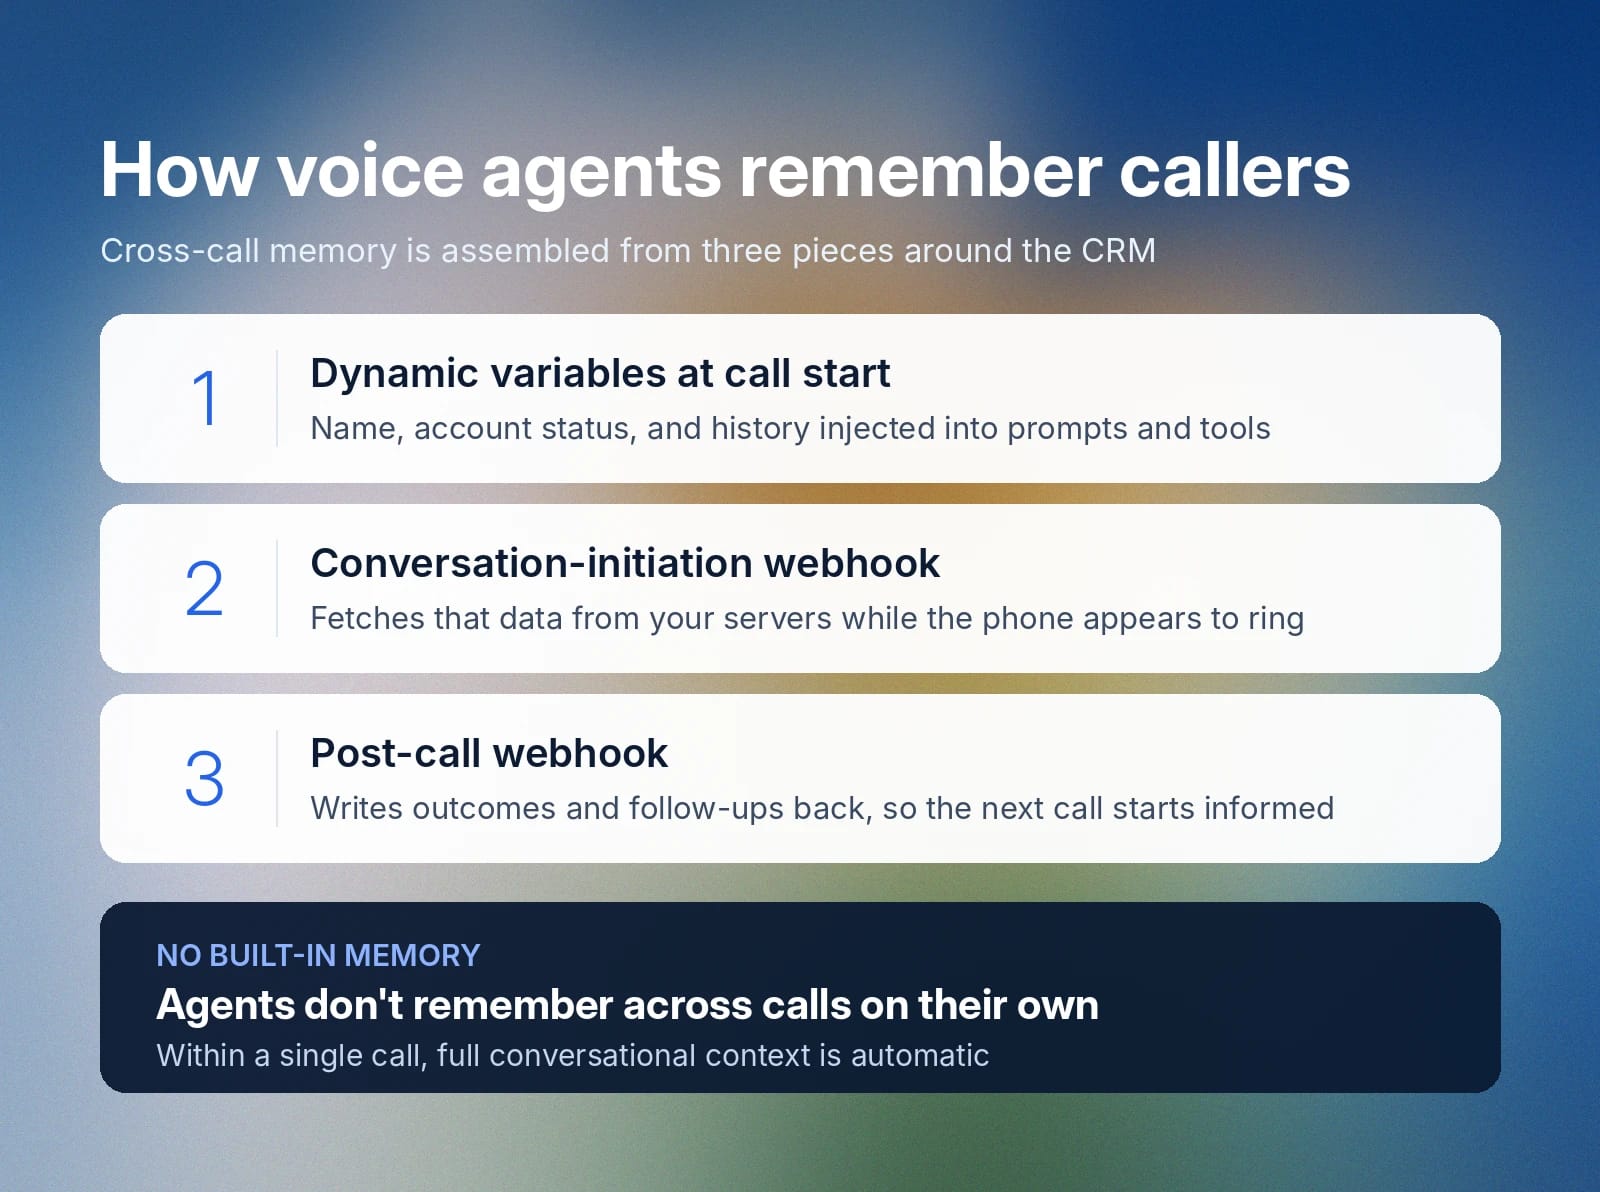
Voice agents hebben geen ingebouwd geheugen tussen gesprekken. Het geheugen tussen gesprekken bestaat uit drie onderdelen: dynamische variabelen die CRM-data aan het begin van een gesprek invoegen, een webhook voor het starten van een gesprek die deze data ophaalt, en een post-call webhook die de uitkomsten terugschrijft. Binnen één gesprek bewaart de agent automatisch de volledige gesprekscontext.
Afhankelijk van je specifieke architectuur kunnen voice agents het klantgeheugen op twee niveaus beheren:
- Binnen één gesprek: De agent behoudt de gesprekscontext en houdt bij wat er binnen de sessie wordt gezegd, waardoor de klant zich tijdens het gesprek minder vaak hoeft te herhalen.
- Tussen meerdere interacties: Dit geheugen wordt mogelijk gemaakt door integratie via meerdere kanalen. De agent haalt aan het begin van het gesprek de klanthistorie op uit het CRM of de database van het bedrijf en documenteert vervolgens de uitkomsten van de interactie, zodat het volgende gesprek met kennis van de geschiedenis begint.
Aan het begin van het gesprek wordt context ingevoegd via dynamische variabelen in ElevenAgents. Deze variabelen voegen runtimewaarden toe aan de prompts, berichten en tools van de agent. Zo kan de agent elk gesprek personaliseren met gebruikersspecifieke informatie, zonder voor elke klant een afzonderlijke agent te bouwen. De naam, accountstatus, identificeerbare informatie en eerdere interactiegeschiedenis van een beller kunnen allemaal aan de voice agent worden doorgegeven zodra het gesprek begint.
Voor inkomende telefoongesprekken kan ElevenAgents via een webhook voor het starten van een gesprek initiële data ophalen van bedrijfsservers. Daarbij wordt de JSON toegepast die het endpoint retourneert terwijl de agent context laadt. In een live situatie haalt het platform de benodigde data op tijdens de eerste verbinding met de klant. Dit proces kan doorgaans overkomen als gewoon overgaan of wachtmuziek, terwijl de agent parallel de context bekijkt.
Nadat het gesprek is beëindigd, verloopt de stroom in omgekeerde richting. De agent doet dit door de gespreksuitkomsten terug te sturen naar het CRM of supportsysteem via post-call webhooks of andere gesprekstools. De agent registreert wat er tijdens het gesprek is gebeurd en wat mogelijk nog met de klant moet worden opgevolgd. De documentatie van de klantinteractie zorgt ervoor dat het geheugen van de voice agent behouden blijft. Zo heeft de volgende agent of menselijke medewerker met wie de klant spreekt de volledige achtergrond voordat het gesprek begint.
Hoe gaan voice agents om met gefrustreerde of boze klanten?
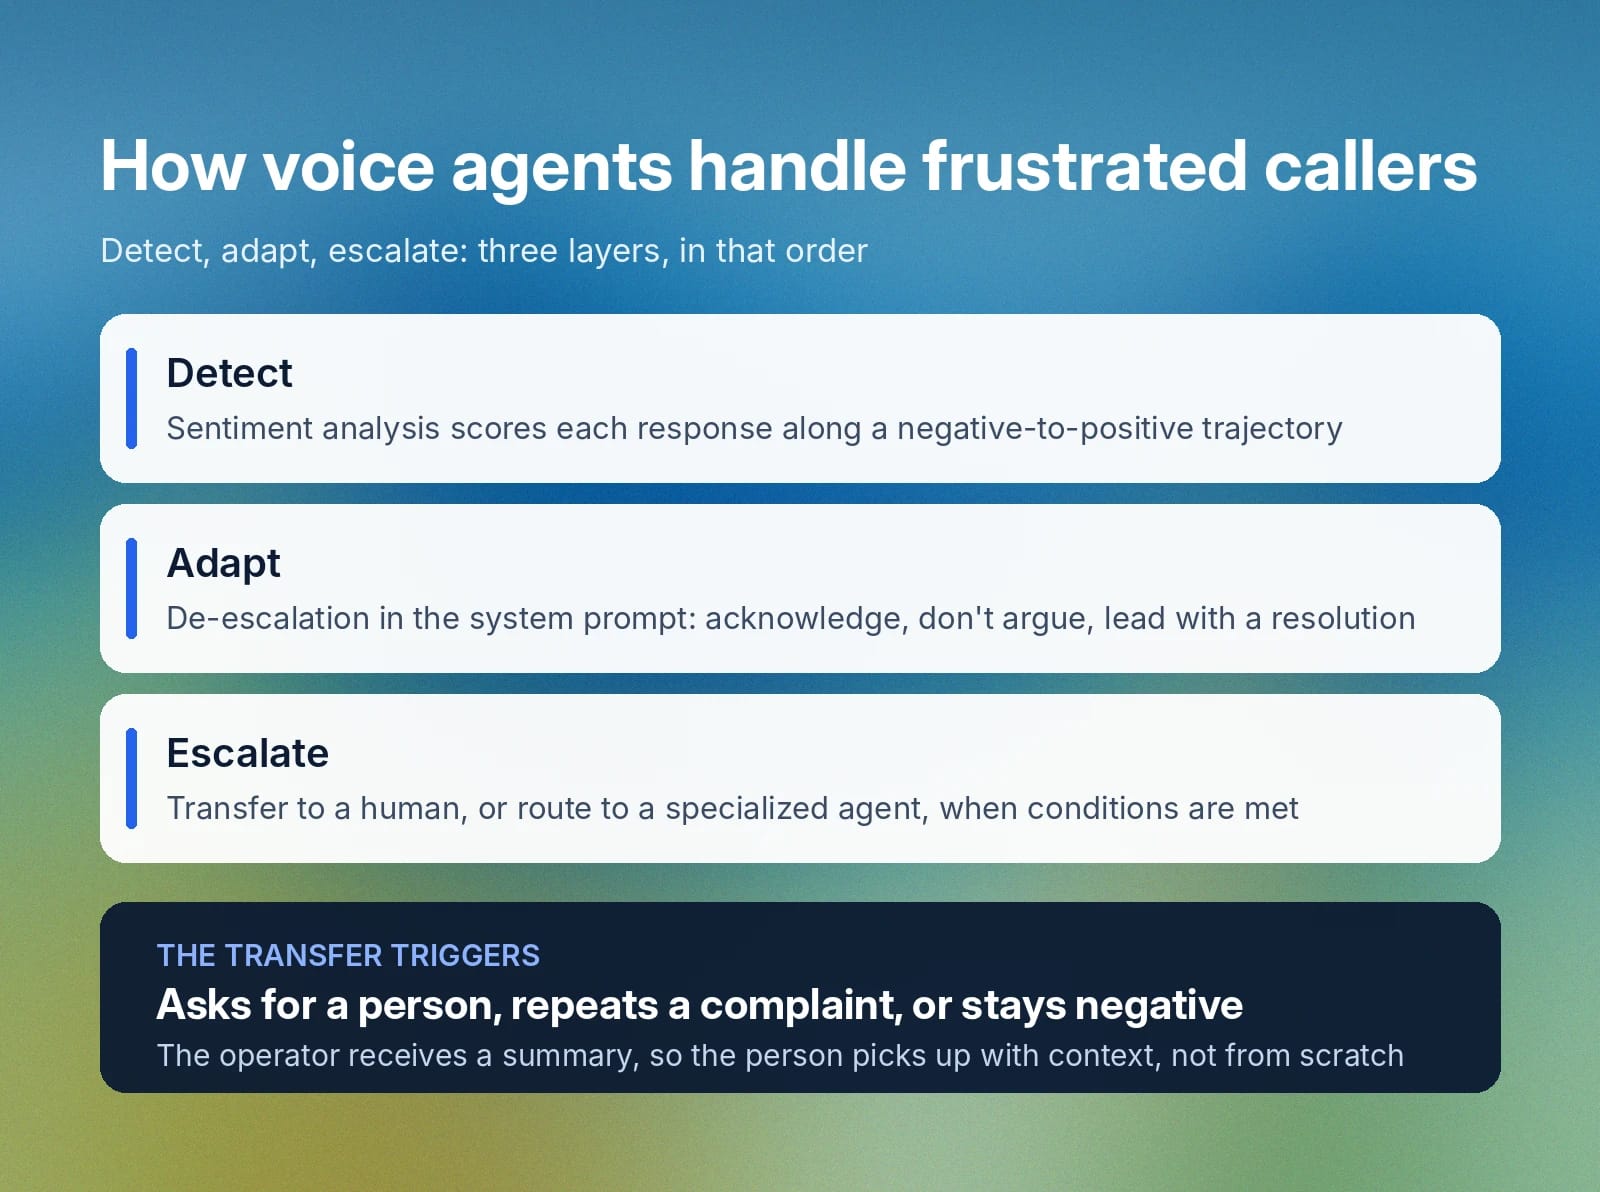
Gefrustreerde en boze klanten komen onvermijdelijk voor, op elk niveau en in elke klantenserviceomgeving. Voice agents kunnen dit soort situaties goed afhandelen door te detecteren, zich aan te passen en waar nodig te escaleren.
Zo navigeren voice agents door lastige situaties met klanten:
- Frustratie detecteren: Het detecteren van klantreacties werkt het effectiefst met sentimentanalyse. Deze analyse beoordeelt gesprekken als positief, negatief of neutraal. Bij individuele gesprekken plaatst sentimentanalyse elke gebruikersreactie op een beoordeeld verloop van negatief naar positief, zodat je kunt zien waar een gesprek verkeerd liep. Wanneer detectie wordt samengevoegd per onderwerp, kan dit onthullen welke onderwerpen bellers het meest frustreren en data bieden over waar verbetering mogelijk is. Met toonaangevende voice agent-modellen, zoals die van ElevenLabs, kunnen agents zelfs de toon uit live transcripts begrijpen en zich daarop aanpassen.
- Zich in realtime aanpassen: De-escalatiegedrag kan rechtstreeks worden vastgelegd in de system prompt van een agent. Daardoor kan deze de frustratie van de beller erkennen, discussie vermijden, de reacties rustig en bij het gesprek houden en beginnen met een oplossingstraject.
- Escaleren naar een mens: De transfer to number tool draagt het gesprek over aan een mens wanneer aan vastgelegde voorwaarden wordt voldaan, meestal wanneer de beller om een persoon vraagt, tweemaal dezelfde klacht herhaalt of het sentiment meerdere beurten achter elkaar negatief blijft. Leg deze voorwaarden vast in de system prompt. De agent kan een bericht afspelen terwijl de beller wacht en een aparte samenvatting doorgeven aan de medewerker die het gesprek ontvangt, zodat diegene met context opneemt in plaats van opnieuw te beginnen. ElevenAgents ondersteunt ook agent-to-agent transfer, waarmee het gesprek wordt doorgestuurd naar een gespecialiseerde agent als de beller andere expertise nodig heeft dan die van een mens.
Het belangrijkste onderdeel van de mogelijkheden van voice agents voor het omgaan met gefrustreerde klanten is de overdrachtsroute.
Welke bestandsindelingen kun je gebruiken om een voice agent te trainen?
Moderne voice agents worden niet getraind in de traditionele AI/LLM-betekenis. Ze krijgen kennis waarop ze kunnen voortbouwen. Deze voice agents ontvangen documentatie, webpagina's of bronnen in platte tekst die verwijzen naar een kennisbank, waaruit de agent tijdens gesprekken relevante passages ophaalt. Deze aanpak heet retrieval-augmented generation (RAG). Dankzij dit proces kan de agent veel meer informatie gebruiken dan één enkele prompt zou bieden.
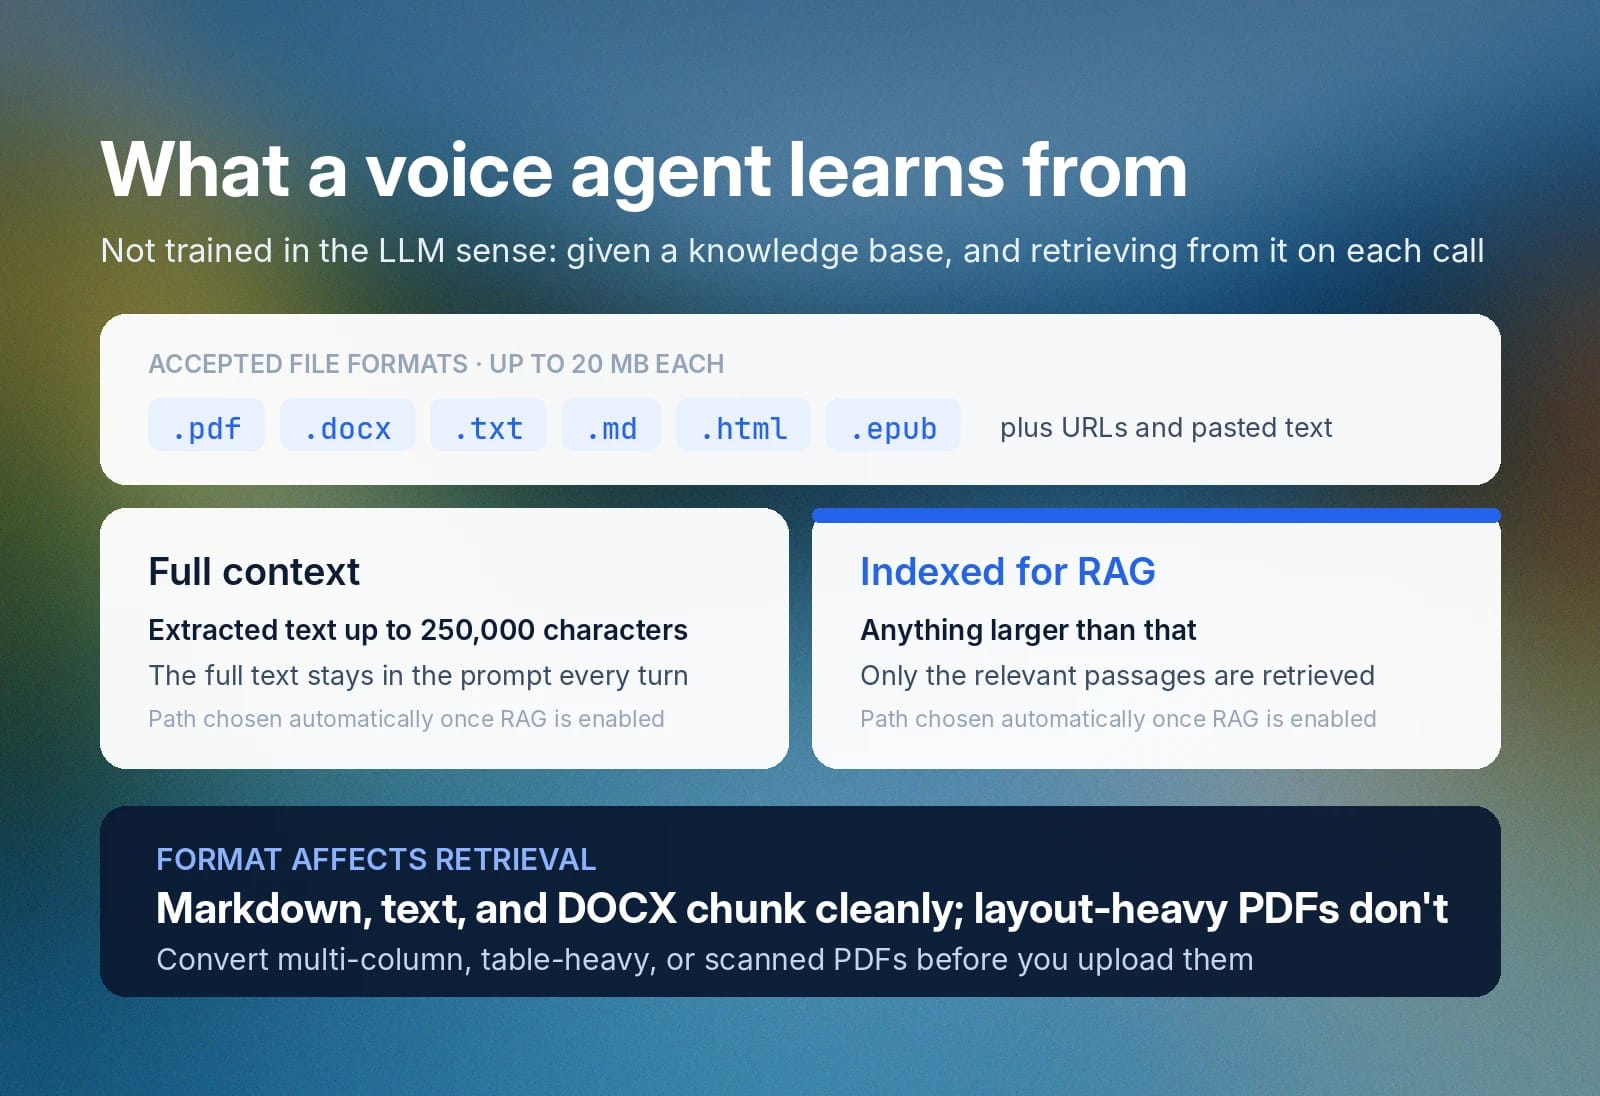
Je kunt op verschillende manieren informatie aan een kennisbank toevoegen. Begin met het uploaden van een bestand, de agent naar een URL verwijzen of de tekst rechtstreeks plakken. In ElevenAgents mogen geüploade bestanden elk maximaal 20 MB groot zijn en de volgende indelingen hebben:
- .docx
- .txt
- .md
- .html
- .epub
De indeling beïnvloedt de kwaliteit van het ophalen. Markdown, platte tekst en DOCX worden schoon geëxtraheerd en voorspelbaar in segmenten verdeeld voor RAG. PDF's met lay-outs in meerdere kolommen, tabellen of gescande pagina's worden slecht geëxtraheerd en kun je het beste vóór het uploaden converteren.
Zodra het document is gekoppeld, gebruikt de agent het op een van twee manieren. Kleine documenten kunnen in de volledige context staan, waarbij de volledige documenttekst bij elke beurt in de prompt blijft. De tweede manier is grotere documenten indexeren voor RAG.
Tijdens dit proces worden alleen de passages opgehaald die het meest relevant zijn voor elke vraag op het moment van het gesprek. Een document kan bijvoorbeeld alleen in volledige context worden gebruikt als de geëxtraheerde tekst binnen 250.000 tekens past. Alles wat groter is, loopt via RAG. Zodra RAG is ingeschakeld, kan het systeem zo automatisch de juiste route kiezen.
Hoe geven voice agents gepersonaliseerde productaanbevelingen?
Gepersonaliseerde productaanbevelingen ontstaan door meerdere invoergegevens over de beller te combineren op het moment dat diegene met de voice agent communiceert. Deze invoergegevens omvatten wie de beller is, wat diegene vraagt en wat beschikbaar is. De agent kent informatie over de beller uit CRM-data die via dynamische variabelen wordt doorgegeven.
De agent kent het verzoek ook uit het live gesprek en weet wat beschikbaar is door productdata via tool calls te bekijken. Vervolgens redeneert de agent over al deze gegevens om de beller gepersonaliseerde opties aan te bevelen, zoals een goed geïnstrueerde menselijke medewerker dat zou doen.
Om beter te begrijpen hoe dit werkt in een realistische context van een voice agent, zie je hieronder hoe dit eruitziet in een echt gesprek.
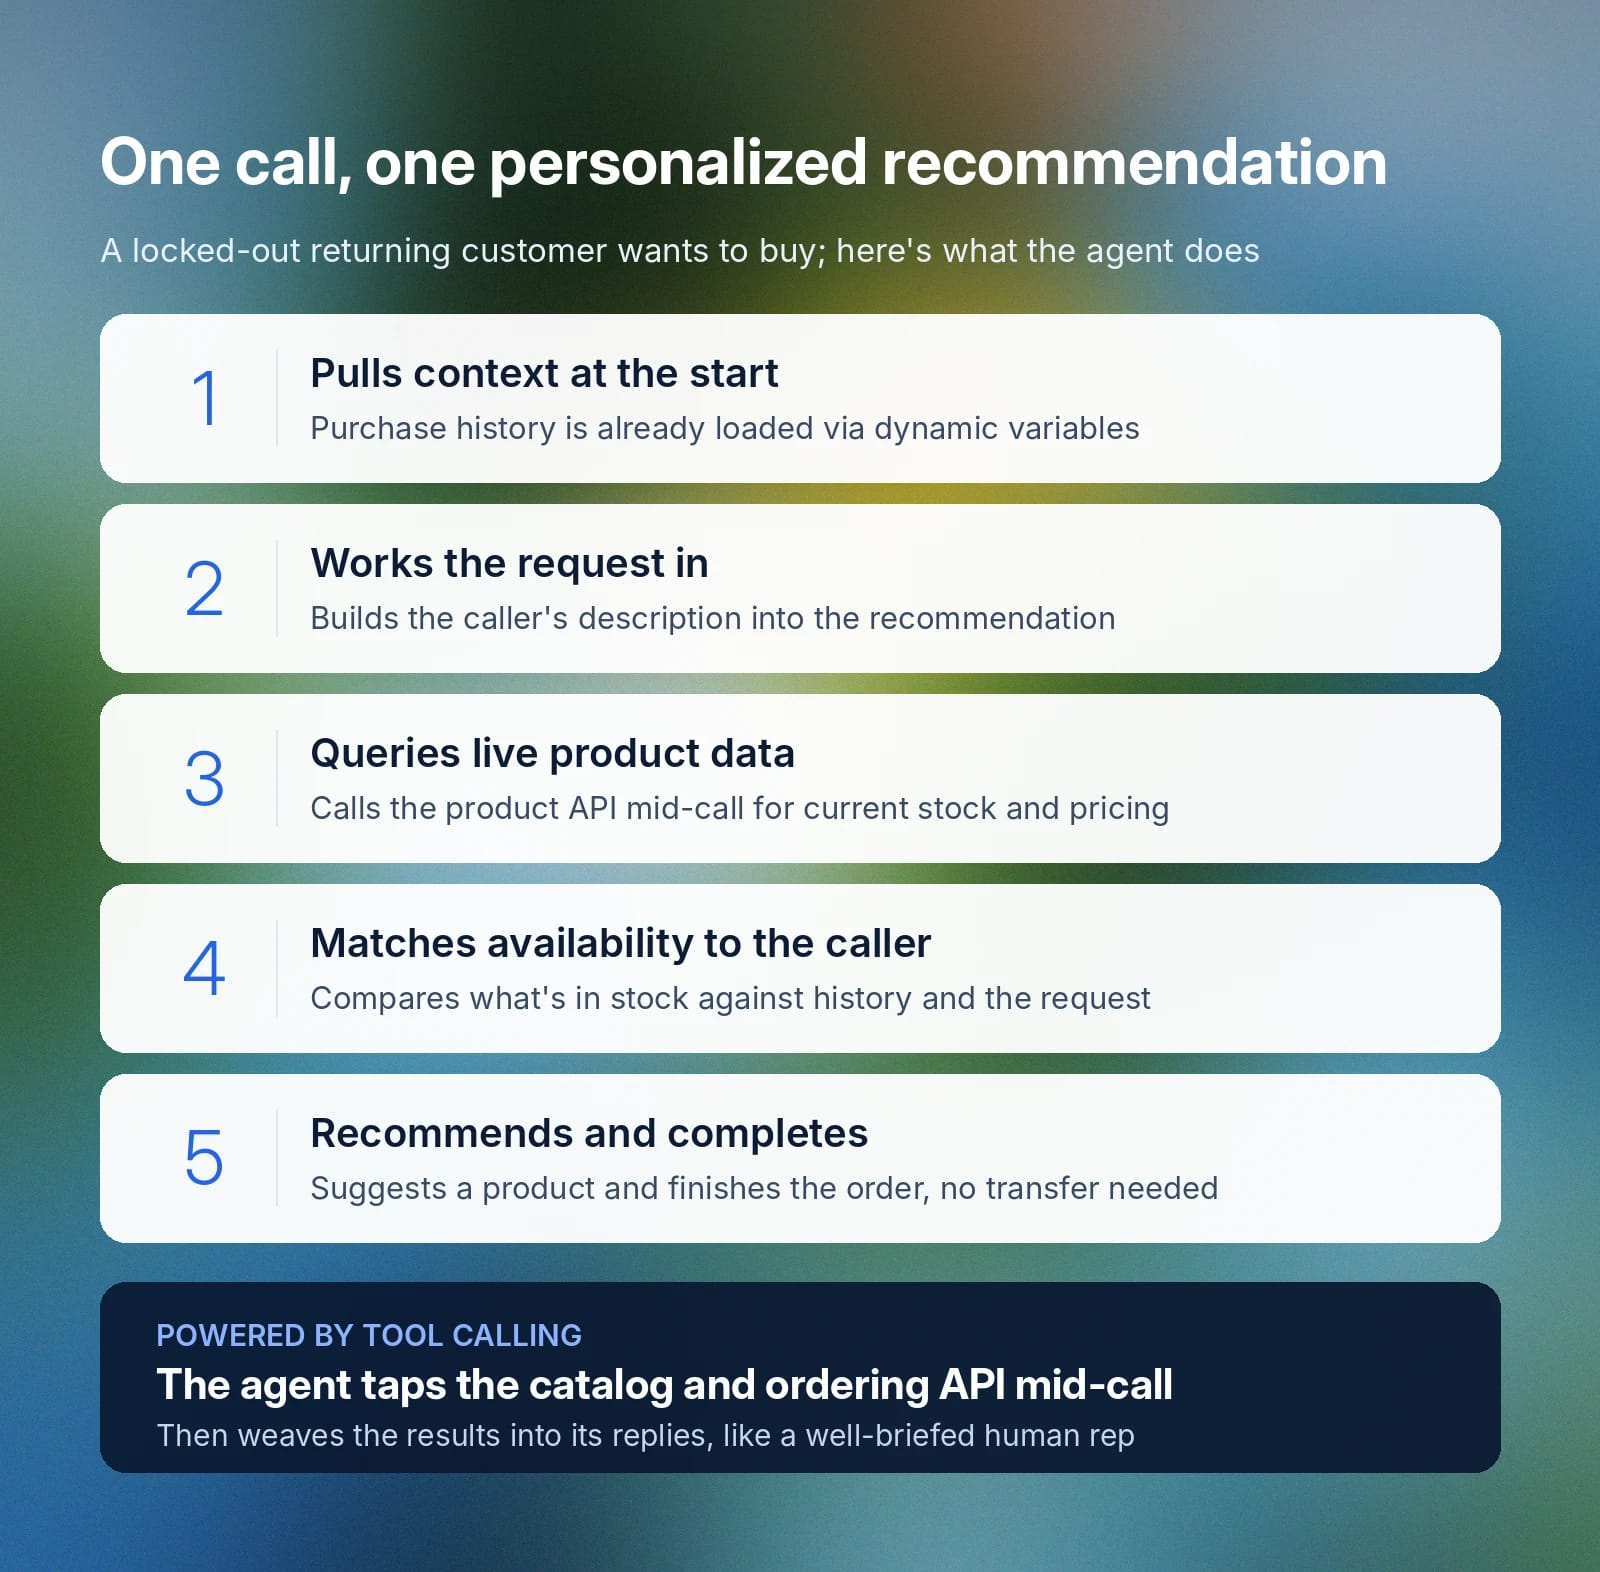
Een terugkerende klant belt de technische supportlijn van een retailer omdat diegene niet in het gebruikersaccount kan en een aankoop wil doen. Zo zet de voice agent dat gesprek om in een gepersonaliseerde aanbeveling:
- Haalt context op bij de start: De agent kent de aankoopgeschiedenis van de beller en andere gerelateerde informatie al, omdat die aan het begin van het gesprek is opgehaald.
- Verwerkt het verzoek in de aanbeveling: De beller beschrijft wat diegene nodig heeft en de agent verwerkt die beschrijving in de aanbeveling, in plaats van vanaf nul te beginnen.
- Vraagt tijdens het gesprek live productdata op: De agent roept tijdens het gesprek de product-API aan om de actuele voorraad en prijzen te controleren, in plaats van te vertrouwen op informatie uit de training.
- Stemt beschikbaarheid af op de beller: De agent vergelijkt wat op voorraad is met de beschrijving en aankoopgeschiedenis van de beller.
- Beveelt aan en rondt de bestelling af: De agent stelt een product voor en rondt de bestelling op verzoek af, zonder de beller ergens anders heen te hoeven doorsturen.
Dat hele gesprek wordt mogelijk gemaakt door tool calling. Hiermee kan een voice bot externe systemen aanroepen, zoals een productcatalogus of bestel-API, en die informatie vervolgens in de antwoorden verwerken. De documentatie van ElevenLabs over tools legt uit hoe je die koppeling configureert.
Kunnen voice agents gevoelige klantdata verwerken?
Voice agents bieden configureerbare instellingen voor bewaartermijnen, de optie om gespreksaudio niet op te slaan, redactie van de gespreksgeschiedenis en strikte bewaarbeleidsregels voor sterk gereguleerde sectoren zoals de zorg.
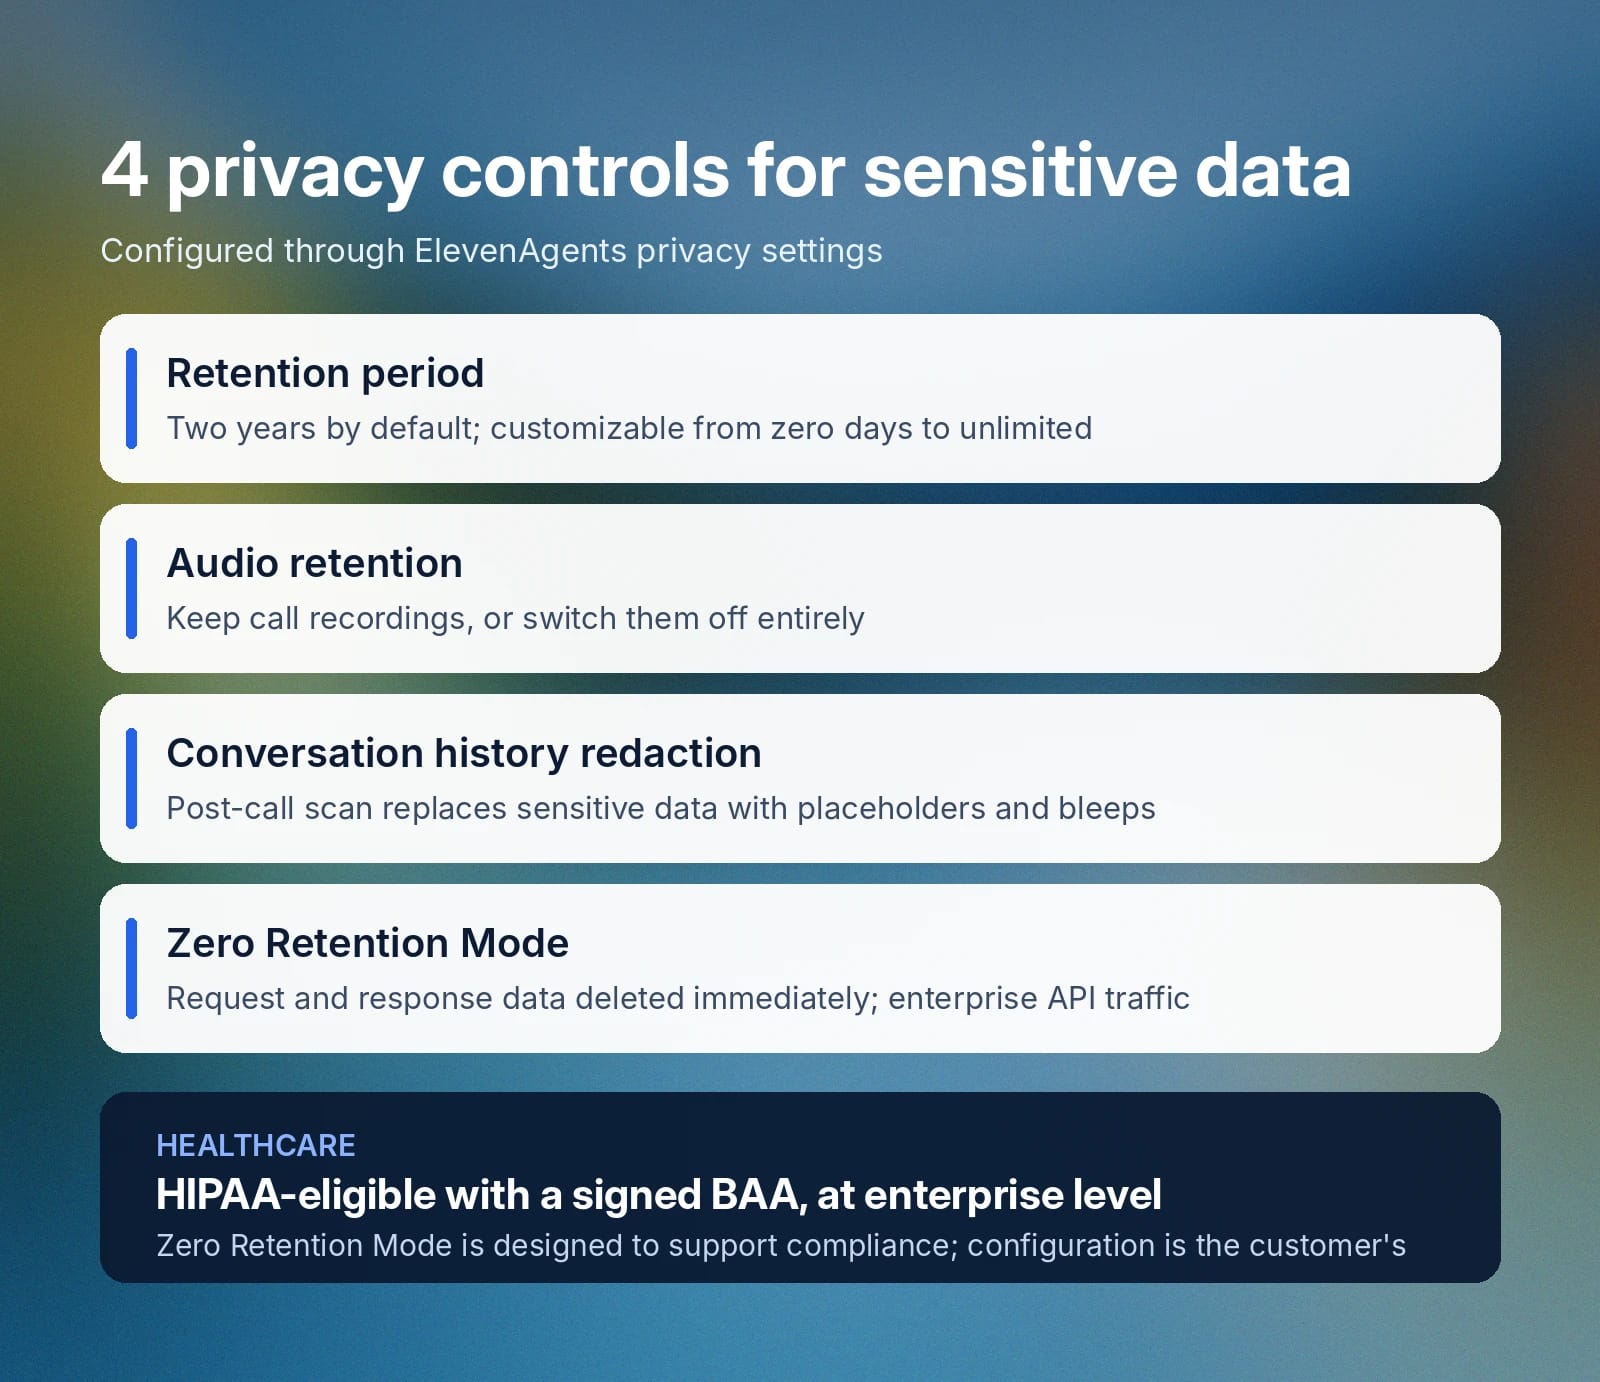
In ElevenAgents configureer je elk van deze instellingen via privacyinstellingen. Zo werkt het:
- Bewaring: Transcripts van gesprekken en audio-opnamen worden alleen gedurende een specifieke periode opgeslagen. ElevenAgents bewaart transcripts en opnamen standaard twee jaar; je kunt dit aanpassen van nul dagen tot onbeperkt. Voor HIPAA-naleving wordt minimaal zes jaar bewaring aanbevolen. Houd er voor volledige afstemming op HIPAA rekening mee dat het daadwerkelijk verwerken van Protected Health Information op ons platform vereist dat Zero Retention Mode is ingeschakeld. Dit betekent dat je die zes jaar aan gegevens via webhooks veilig op je eigen infrastructuur opslaat.
- Audiobewaring: Audio-opnamen van gesprekken kunnen worden bewaard om klanten te behouden, of volledig worden uitgeschakeld zodat klantaudio niet wordt bewaard. Als je het opslaan van audio-opnamen uitschakelt en een bewaarbeleid van nul dagen instelt, worden de data direct na het gesprek verwijderd.
- Redactie van gespreksgeschiedenis: Nadat het gesprek is afgelopen, helpt een nabewerkingsstap die na elk gesprek het transcript en de audio scant gevoelige klantdata te beschermen door redactie. Bij deze stap worden de audio en het transcript gescand om gevoelige informatie te detecteren. In transcripts wordt een tijdelijke aanduiding getoond en in audiofragmenten klinkt een pieptoon. Zo blijft de gespreksgeschiedenis beschikbaar voor beoordeling, terwijl de blootstelling aan gevoelige informatie afneemt.
- Zero-Retention Mode: Deze configuratie is het meest geschikt voor strikte bewaareisen. De meeste data in requests en responses worden direct verwijderd zodra de request is voltooid. Deze configuratie geldt voor API-verkeer en is beschikbaar voor enterprise-klanten.
Voor implementaties in de zorg is ElevenAgents HIPAA-geschikt in combinatie met Business Associate Agreements (BAA's) die beschikbaar zijn voor enterprise-klanten. In combinatie met een ondertekende BAA is onze Zero Retention Mode ontworpen ter ondersteuning van HIPAA-naleving, afhankelijk van hoe de klant het platform configureert en gebruikt om aan de eigen compliancevereisten te voldoen. Volledige configuratiedetails voor deze instellingen vind je in onze privacydocumentatie van ElevenLabs.
Welke verbeteringen in klanttevredenheid bieden voice agents?
Factoren die vaak tot een betere klanttevredenheid leiden, zijn het wegnemen of verkorten van wachttijd, consistentie en snellere afhandeling. Omdat voice agents gesprekken zonder vertraging kunnen beantwoorden, ontvangen bellers doorgaans reacties van consistente kwaliteit, ongeacht het tijdstip. Daardoor worden routinematige verzoeken sneller afgehandeld dan voorheen, toen ze in een wachtrij wachtten op een menselijke agent.
Het voorbehoud is dat, wanneer een klantinteractie verkeerd loopt, een gefrustreerde klant vastzetten in een agentlus de klantervaring sneller schaadt dan wacht muziek dat ooit deed. Veel organisaties meten klanttevredenheid niet vaak afzonderlijk. Metrics die daarnaast worden gerapporteerd zijn onder meer de containment rate (het percentage verzoeken dat de agent zonder menselijke tussenkomst oplost), de gemiddelde afhandeltijd en oplossing bij het eerste gesprek.
Wanneer je deze samen in een rapport beoordeelt, vertellen ze vaak een ander verhaal dan één afzonderlijke metric. Een hoge containment rate die samenvalt met een dalende klanttevredenheidsscore geeft bijvoorbeeld vaak aan dat gesprekken snel worden afgehandeld zonder dat een mens erbij betrokken is.
Admiral is een goed voorbeeld van een organisatie die oplossing bij het eerste contact boven containment stelt. Zoals besproken in dit webinar, streefden ze naar een oplossingspercentage van 90%, naast 24/7 beschikbaarheid en een duidelijke stijging van de NPS. Een overdracht naar een mens telde nooit negatief voor de agent, omdat het oplossen van het probleem belangrijker was dan het gesprek binnen de agent houden.
Meer informatie over hoe deze mogelijkheid van de voice agent aansluit op hun CRM- en spraakconfiguratie.
Ga aan de slag met alle mogelijkheden van voice agents in ElevenAgents
De mogelijkheden van voice agents die in deze gids zijn behandeld, zijn geen afzonderlijke of losstaande producten. Deze mogelijkheden moeten worden ingebouwd in dezelfde agent en configuratie, met de juiste dynamische variabelen, tools en privacyinstellingen voor de bedrijfsbehoeften van de organisatie.
Aan de slag gaan kan zo eenvoudig zijn als beginnen met één gesprekstype en dit alleen koppelen aan de systemen die het nodig heeft. Van daaruit kun je de agent uitbreiden zodra de metrics laten zien dat deze werkt.
Lees meer over ElevenAgents of neem contact op met sales om vandaag aan de slag te gaan.

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.



