
Conversational AI meten: essentiële metrics voor succes
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Conversationele AI-tools verlagen de kosten voor klantenservice die dag en nacht beschikbaar is aanzienlijk. Dat doen ze zonder nachtdiensten te hoeven bemensen of de privacyrisico's te nemen die het uitbesteden van functies naar het buitenland met zich meebrengt.
Maar kostenbesparingen zijn alleen relevant als een AI-agent klantproblemen kan oplossen. Door conversationele AI aan de hand van de juiste KPI's te meten, weet je of die werkt, vooral in grote organisaties die grote aantallen klantvragen verwerken.
In dit artikel lees je hoe het evalueren van conversatieverloop en antwoordnauwkeurigheid zowel de klantervaring als je merk beschermt. We leggen uit hoe teams voor klantervaring effectieve A/B-tests uitvoeren met begroetingen voor bellers. Je leert ook hoe je een betrouwbaar, meertalig platform voor conversationele AI onderhoudt.
Samenvatting
- Door conversationele AI systematisch te meten aan de hand van kwaliteits-, ervarings- en operationele metrics, krijg je de gegevens die nodig zijn om de klantervaring te beschermen.
- Geautomatiseerde evaluatietools volgen en verbeteren metrics voor conversationele AI continu op schaal, terwijl medewerkers regelmatig steekproeven uitvoeren.
- Door bij A/B-tests steeds één specifieke variabele te isoleren, kun je eenvoudig precies vaststellen wat er misging, zodat je oplossingen implementeert die rechtstreeks op de vastgestelde problemen zijn gericht.
- Continue verbetering is nodig, omdat AI-bedrijven de onderliggende modellen vaak bijwerken. Daardoor gedragen chatbots die eerder betrouwbaar waren zich in productie vaak anders.
Wat het meten van conversationele AI inhoudt en waarom het belangrijk is
Het meten van conversationele AI omvat een systematische evaluatie van hoe goed je geteste of geïmplementeerde AI-agents klantverzoeken afhandelen en problemen oplossen. Het doel is vast te stellen hoe effectief je geautomatiseerde systemen in de praktijk gesprekken met meerdere beurten afhandelen op basis van de prestatienormen die je instelt. Deze normen weerspiegelen doorgaans hoe goed de modellen de intentie van gebruikers begrijpen, bij je merk blijven, nauwkeurige antwoorden geven en het probleem succesvol oplossen.
Modelbeoordelingen lijken misschien veel extra werk voor een systeem dat juist de taken van je team moet verminderen. Maar zonder consistente evaluatie is het lastig om te weten hoe goed het model in echte use cases presteert. Met andere woorden: je weet dat je AI-systeem de operationele kosten van klantenservice verlaagt, maar kun je bevestigen dat klanten er tevreden van worden en niet op zoek gaan naar andere oplossingen?
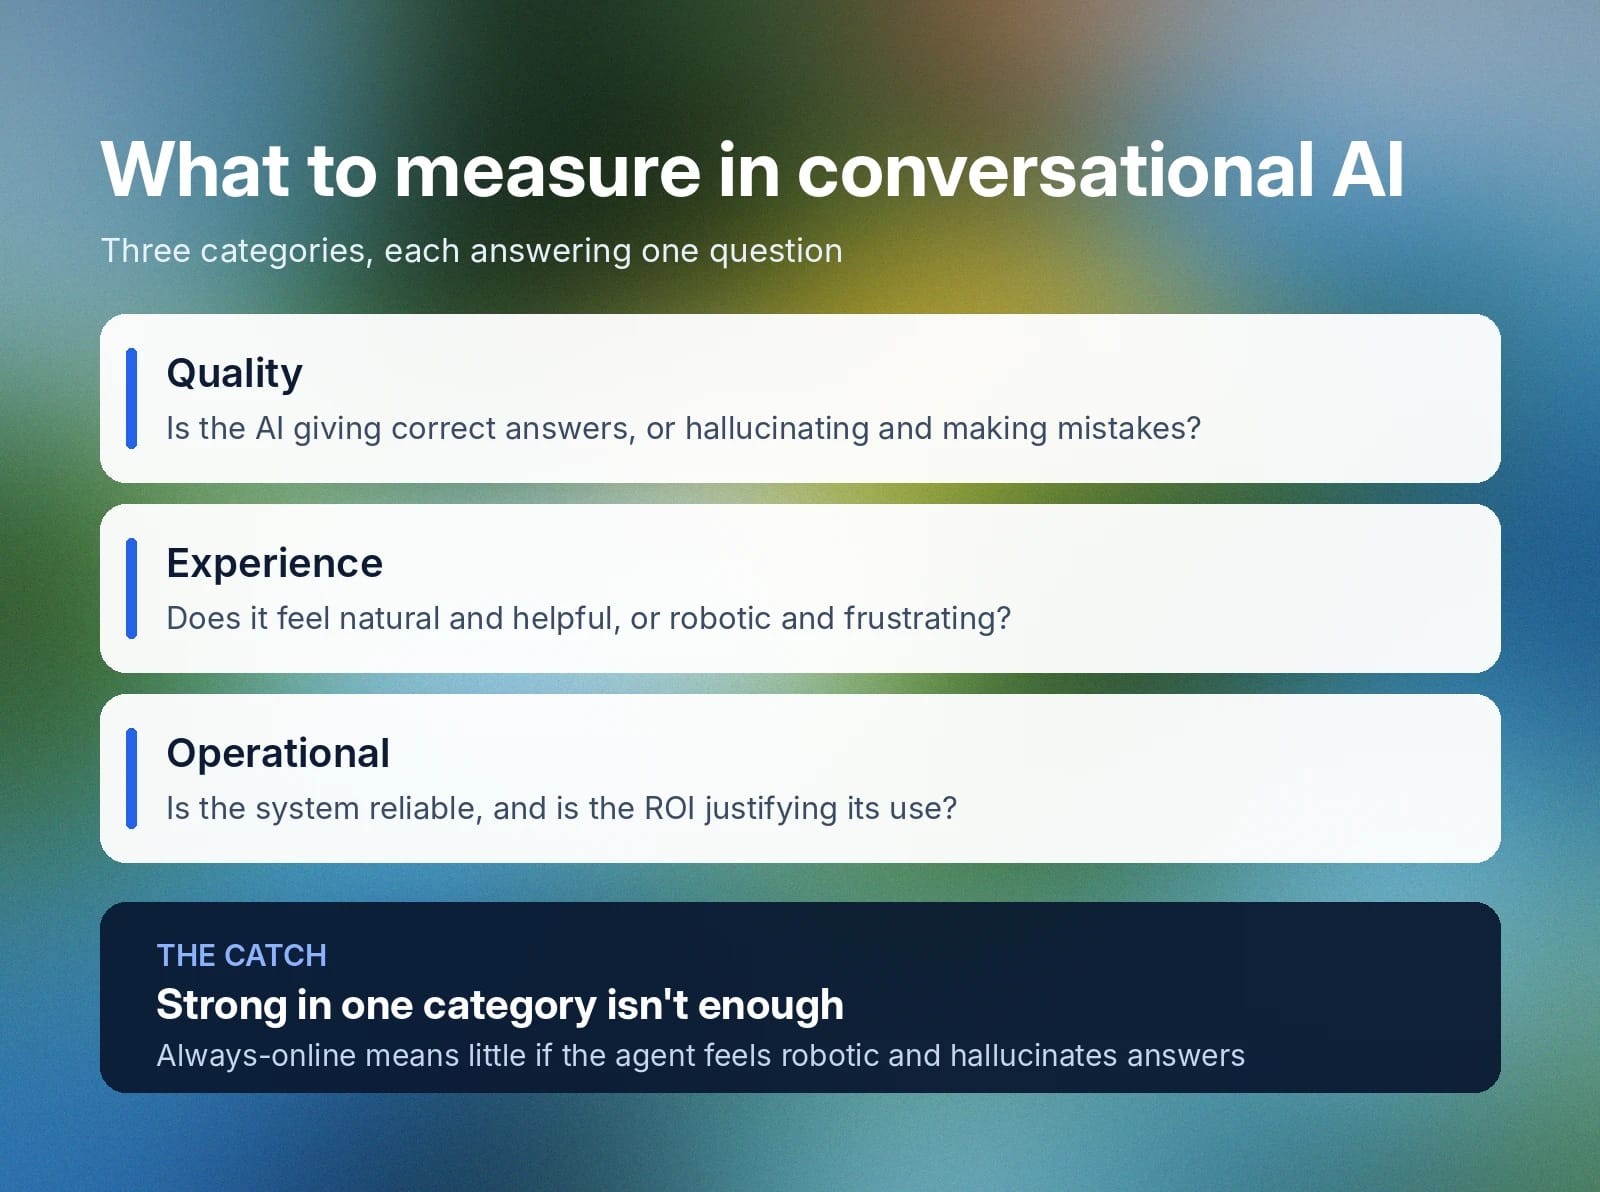
Voor een uitgebreide meting moet je het model in drie hoofdcategorieën bekijken:
- Kwaliteit: Beoordeel hoe nauwkeurig, coherent en relevant de antwoorden van een AI zijn op basis van het oorspronkelijke verzoek van de gebruiker. De hoofdvraag is: doet de AI het goed en geeft die gebruikers de juiste antwoorden, of hallucineert die en maakt die fouten?
- Ervaring: Beoordeel de klantervaring, bijvoorbeeld of de AI snel antwoordde en hoeveel beurten nodig waren voor een bevredigend antwoord. De hoofdvraag is: voelt de ervaring natuurlijk en behulpzaam voor de gebruiker, of robotachtig en frustrerend?
- Operationeel: Bepaal of het systeem betrouwbaar presteert en een kosteneffectieve oplossing blijft voor je klantenservicebehoeften. Veelvoorkomende vragen zijn: heeft het systeem een hoge uptime en levert het het benodigde rendement op om het gebruik ervan te rechtvaardigen?
Succes ziet er voor elk team anders uit, en de knelpunten die je had voordat je de klantenservice automatiseerde, spelen daarbij een grote rol. Als je team bijvoorbeeld aanvankelijk moeite had met het bieden van 24/7 klantenservice, verbetert de voortdurende beschikbaarheid van AI-agents de prestaties van de klantenservice al snel. Toch is elke categorie belangrijk voor het algehele succes. Een systeem dat altijd online is en zelden crasht, helpt klanten dus weinig als het robotachtig aanvoelt en antwoorden hallucineert.
Belangrijke metrics voor conversationele AI om bij te houden
Houd duidelijke, bruikbare cijfers bij om de prestaties van agents bij klanten te beoordelen en om na te gaan of je huidige implementatie echte bedrijfswaarde oplevert. Continue beoordeling maakt ook regelmatige verbetering mogelijk. Als je precies vaststelt waar je workflow knelpunten heeft of aanpassingen nodig zijn, heb je de gegevens om de hoofdoorzaak effectief aan te pakken.
Gebruik deze metrics voor conversationele AI als uitgangspunt bij het beoordelen van telefoongesprekken en chatbotprestaties:
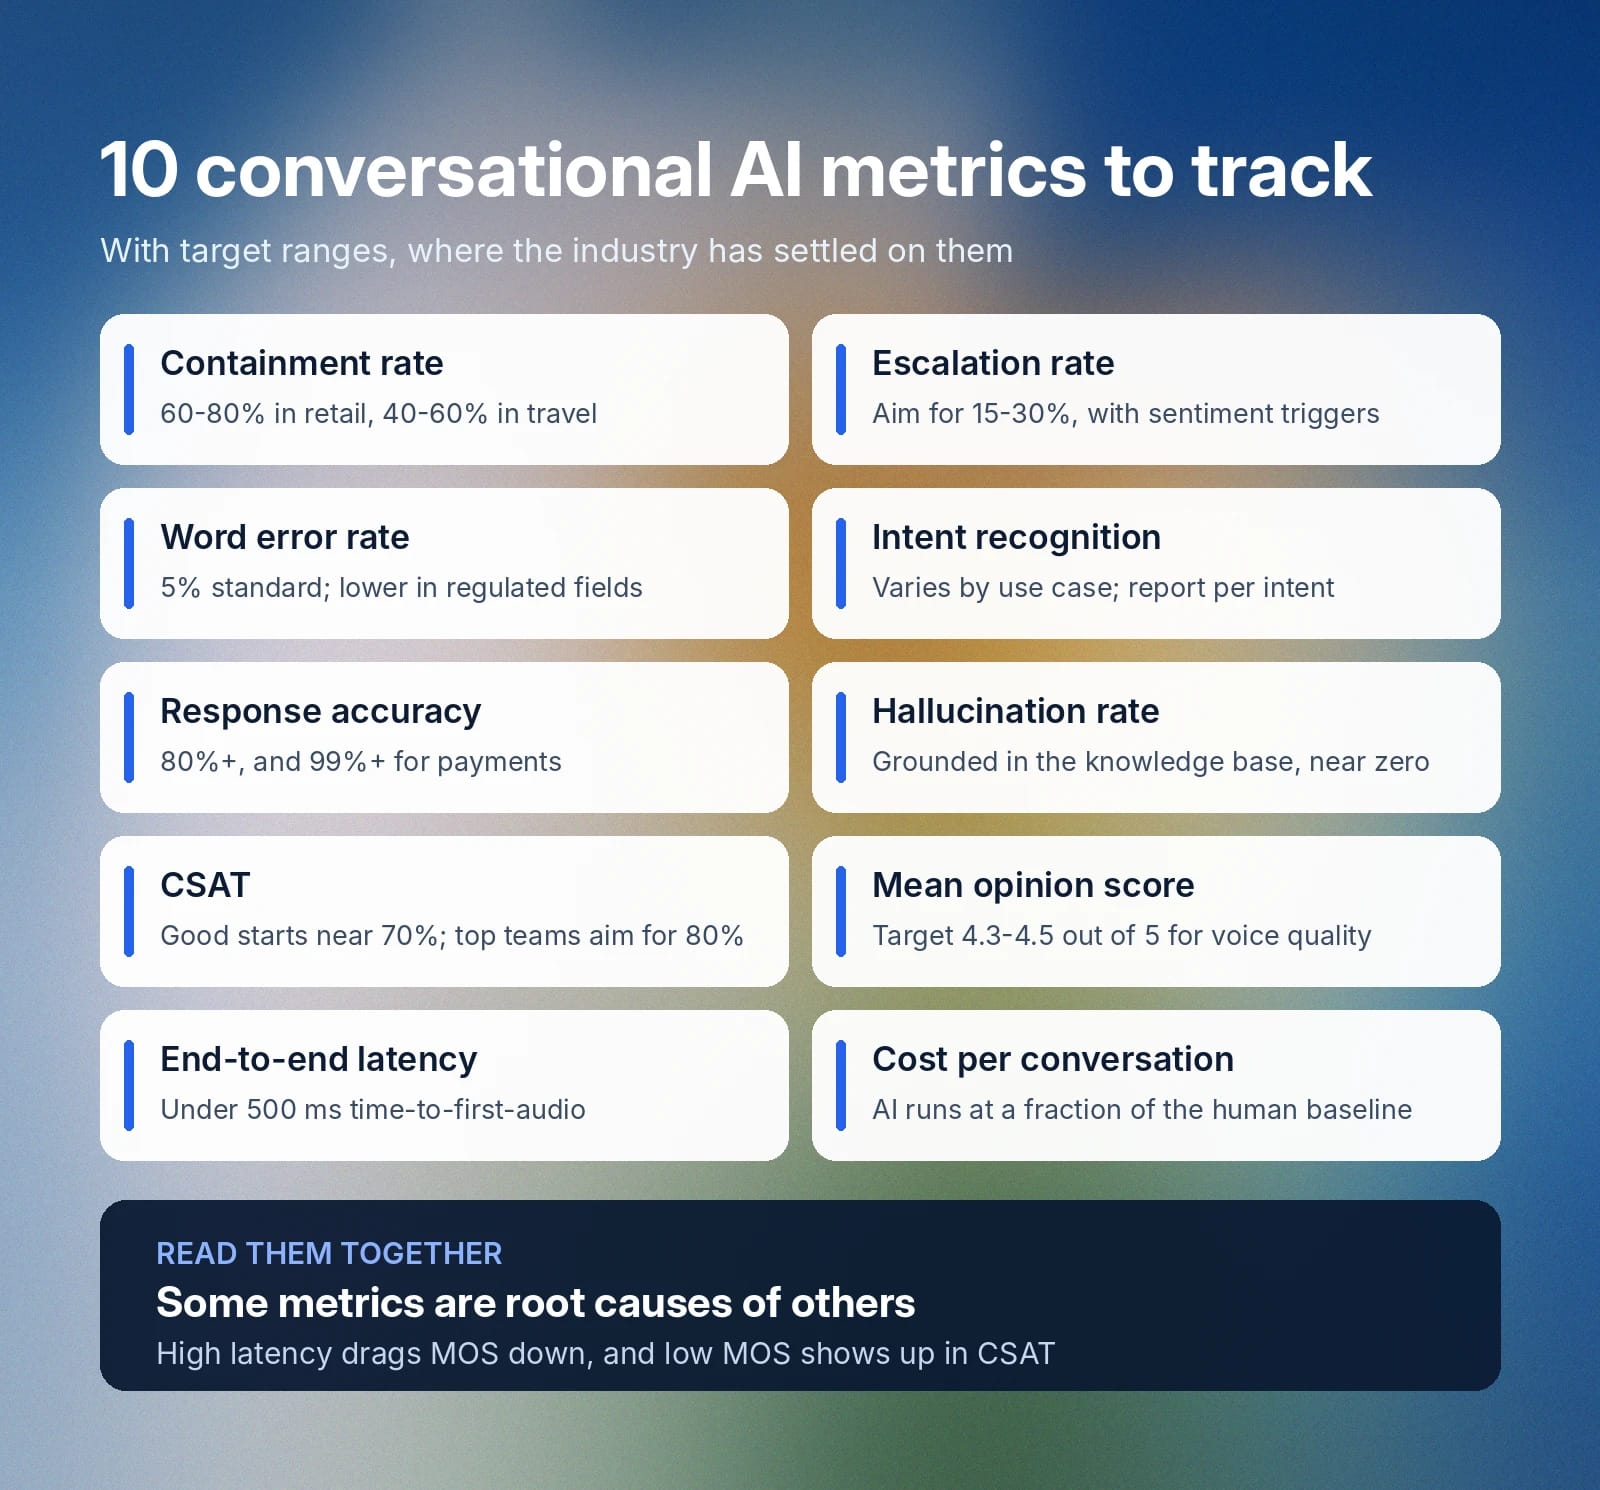
- Containment rate: Houd het percentage vragen bij dat volledig binnen het geautomatiseerde kanaal wordt opgelost. Doelen verschillen per branche, context, use case en bottype. Zo is 60–80% redelijk standaard voor retail, terwijl de cijfers voor reissites tussen 40–60% liggen.
- Escalation rate: Meet hoe vaak AI-agents gesprekken afhandelen zonder ze naar een medewerker te escaleren. Proactieve bedrijven stellen automatische drempelwaarden in om gesprekken naar medewerkers door te zetten zodra de sentimenten negatief worden. Goede escalatiepercentages verschillen per branche en taakcomplexiteit, maar streef naar 15–30%.
- Word error rate (WER): Houd bij hoe goed de AI woorden tijdens een gesprek of transcriptie nauwkeurig 'hoort'. Een goede industriestandaard is 5%, maar je hebt een lagere WER nodig voor use cases in gereguleerde sectoren of voor use cases met gevoelige informatie, zoals de zorg, financiën en juridische dienstverlening.
- Nauwkeurigheid van intentieherkenning: Succesvolle prestaties van AI-agents beginnen niet alleen bij woorden, maar ook bij het nauwkeurig begrijpen van het knelpunt van de gebruiker en wat die nodig heeft. Nauwkeurigheidsdoelen verschillen per use case en per intentiecategorie.
- Antwoordnauwkeurigheid: Bepaal hoe betrouwbaar het model waarheidsgetrouwe en betekenisvolle antwoorden geeft. Dit is cruciaal om ervoor te zorgen dat klanten hun problemen oplossen. Voor algemene vragen aan de klantenservice is 80% of hoger nodig, maar gevoelige use cases, zoals betalingen, vereisen 99% of hoger.
- Hallucinatiepercentage: Hoewel dit nauw samenhangt met antwoordnauwkeurigheid, bepaalt hallucinatie specifiek de feitelijke juistheid van antwoorden op basis van de kennisbank. Lage hallucinatiepercentages zijn cruciaal voor behulpzaamheid en om te zorgen dat modellen geen beloften doen die het bedrijf niet kan nakomen.
- Klanttevredenheid (CSAT): Verzamel klantsentiment via enquêtes na een gesprek om de tevredenheid te bepalen. Bedrijven verzamelen deze gegevens met een vijfpuntsschaal, maar drukken de resultaten vaak uit in percentages. Volgens SurveyMonkey beginnen goede CSAT-scores doorgaans rond 70%, waarbij sommige bedrijven streven naar 80% of hoger.
- Mean opinion score (MOS): Deze mensgerichte metric gebruikt ook een vijfpuntsschaal, maar heeft als doel te meten hoe natuurlijk het AI-antwoord klinkt en hoe helder de synthetische stem is. Streef naar een MOS rond 4,3-4,5.
- End-to-end-spraaklatentie: Meet de totale vertraging tussen het moment waarop een gebruiker zijn verzoek afrondt en het moment waarop de agent begint te antwoorden. Agents van productiekwaliteit streven naar een end-to-end time-to-first-audio (TTFA) van minder dan 500 milliseconden. Het model ElevenLabs Flash v2.5 behaalt momenteel een interne inferentielatentie van ongeveer 75 ms. De werkelijke end-to-endlatentie varieert door factoren zoals je locatie en het gebruikte endpointtype.
- Kosten per gesprek: Meet de totale operationele kosten van elke geautomatiseerde klantinteractie in vergelijking met gesprekken met medewerkers. Gesprekken via ElevenLabs beginnen vanaf 10 cent per minuut, terwijl het gemiddelde uurloon van klantenservicemedewerkers erop wijst dat menselijke gesprekken ongeveer 32 cent per minuut kosten. Dit levert een kostenbesparing van ongeveer 70% op, al kunnen prijzen verschillen per abonnement en gebruik. Bekijk de prijspagina van ElevenLabs voor actuele prijzen.
Houd bij het kiezen van de metrics waarmee je modelprestaties meet rekening met de gebieden die het belangrijkst zijn voor je branche en bedrijfsmodel. Nauwkeurigheid en feitelijke juistheid zijn bijvoorbeeld extra belangrijk voor sectoren zoals het bankwezen en patiëntinformatie, terwijl latentie, MOS en escalatiepercentages het belangrijkst zijn voor bedrijven die prioriteit geven aan de klantervaring.
Houd er rekening mee dat sommige metrics de hoofdoorzaak van andere metrics aangeven. Hoge latentie leidt bijvoorbeeld waarschijnlijk tot een lage MOS-score en daardoor tot een lage klanttevredenheid, uitgedrukt als CSAT.
Hoe je de nauwkeurigheid van conversationele AI meet
Meet de nauwkeurigheid van het model door een ground-truthtestset op te bouwen uit ongeveer 500 tot 1.000 echte historische gesprekken. Echte logs leggen de rommelige, natuurlijke formuleringen vast die synthetische data vaak niet bevat, zoals typefouten, slang en gebruikersfouten. Evalueer vervolgens je systeem aan de hand van deze echte logs op intentieherkenning, antwoordnauwkeurigheid en hallucinatiepercentage.
Voer geautomatiseerde evaluaties van deze interacties uit met een LLM-as-a-judge-scoremethode. Valideer de geautomatiseerde scores echter altijd aan de hand van systemen met menselijke labels om zeker te weten dat ze overeenkomen. Menselijke beoordelaars voeren vervolgens wekelijkse steekproeven uit om chatbotprestaties te evalueren met een eenvoudige drieschaal:
- Juist: Het antwoord is feitelijk juist, contextueel relevant en voldoet rechtstreeks aan de primaire intentie van de gebruiker.
- Acceptabel: Het antwoord is technisch juist en behulpzaam, maar bevat enkele kleine stilistische problemen, wat onhandige formuleringen of een opmaak die niet bij het merk past.
- Onjuist: Het antwoord moet onmiddellijk worden gecorrigeerd omdat het feitelijke fouten, ernstige hallucinaties bevat of de intentie van de gebruiker volledig verkeerd begrijpt.
Idealiter gebruik je een methode per intentie om het model te evalueren, omdat AI-agents in sommige contexten goed presteren en in andere volledig falen. Door geaggregeerde cijfers te gebruiken, kunnen goed presterende gebieden kritieke zwakke punten verhullen.
We hebben deze workflow vereenvoudigd door Next Reply (Scenario)-tests rechtstreeks in onze ElevenAgents-tests te bouwen. De functie Next Reply evalueert het vervolgbericht dat een agent verstuurt in plaats van het volledige gesprek met meerdere beurten. Je geeft daarbij wel de chatgeschiedenis voorafgaand aan het evaluatiepunt op en beoordeelt het antwoord aan de hand van normen voor beleid, toon en kwaliteit.
Hoe je A/B-tests uitvoert voor antwoorden van conversationele AI
A/B-tests verzamelen feedback uit de praktijk, zodat je niet hoeft te gissen naar wat klanten prefereren. Vervolgens gebruik je deze empirische gegevens om de prestaties van AI-modellen te verfijnen. Nadat je metrics hebt bijgehouden, heeft je team waarschijnlijk een lijst met zaken die het wil wijzigen of experimenten die het wil uitvoeren. Als je meerdere zaken tegelijk wijzigt, is het echter moeilijk om erachter te komen wat wel en niet werkte.
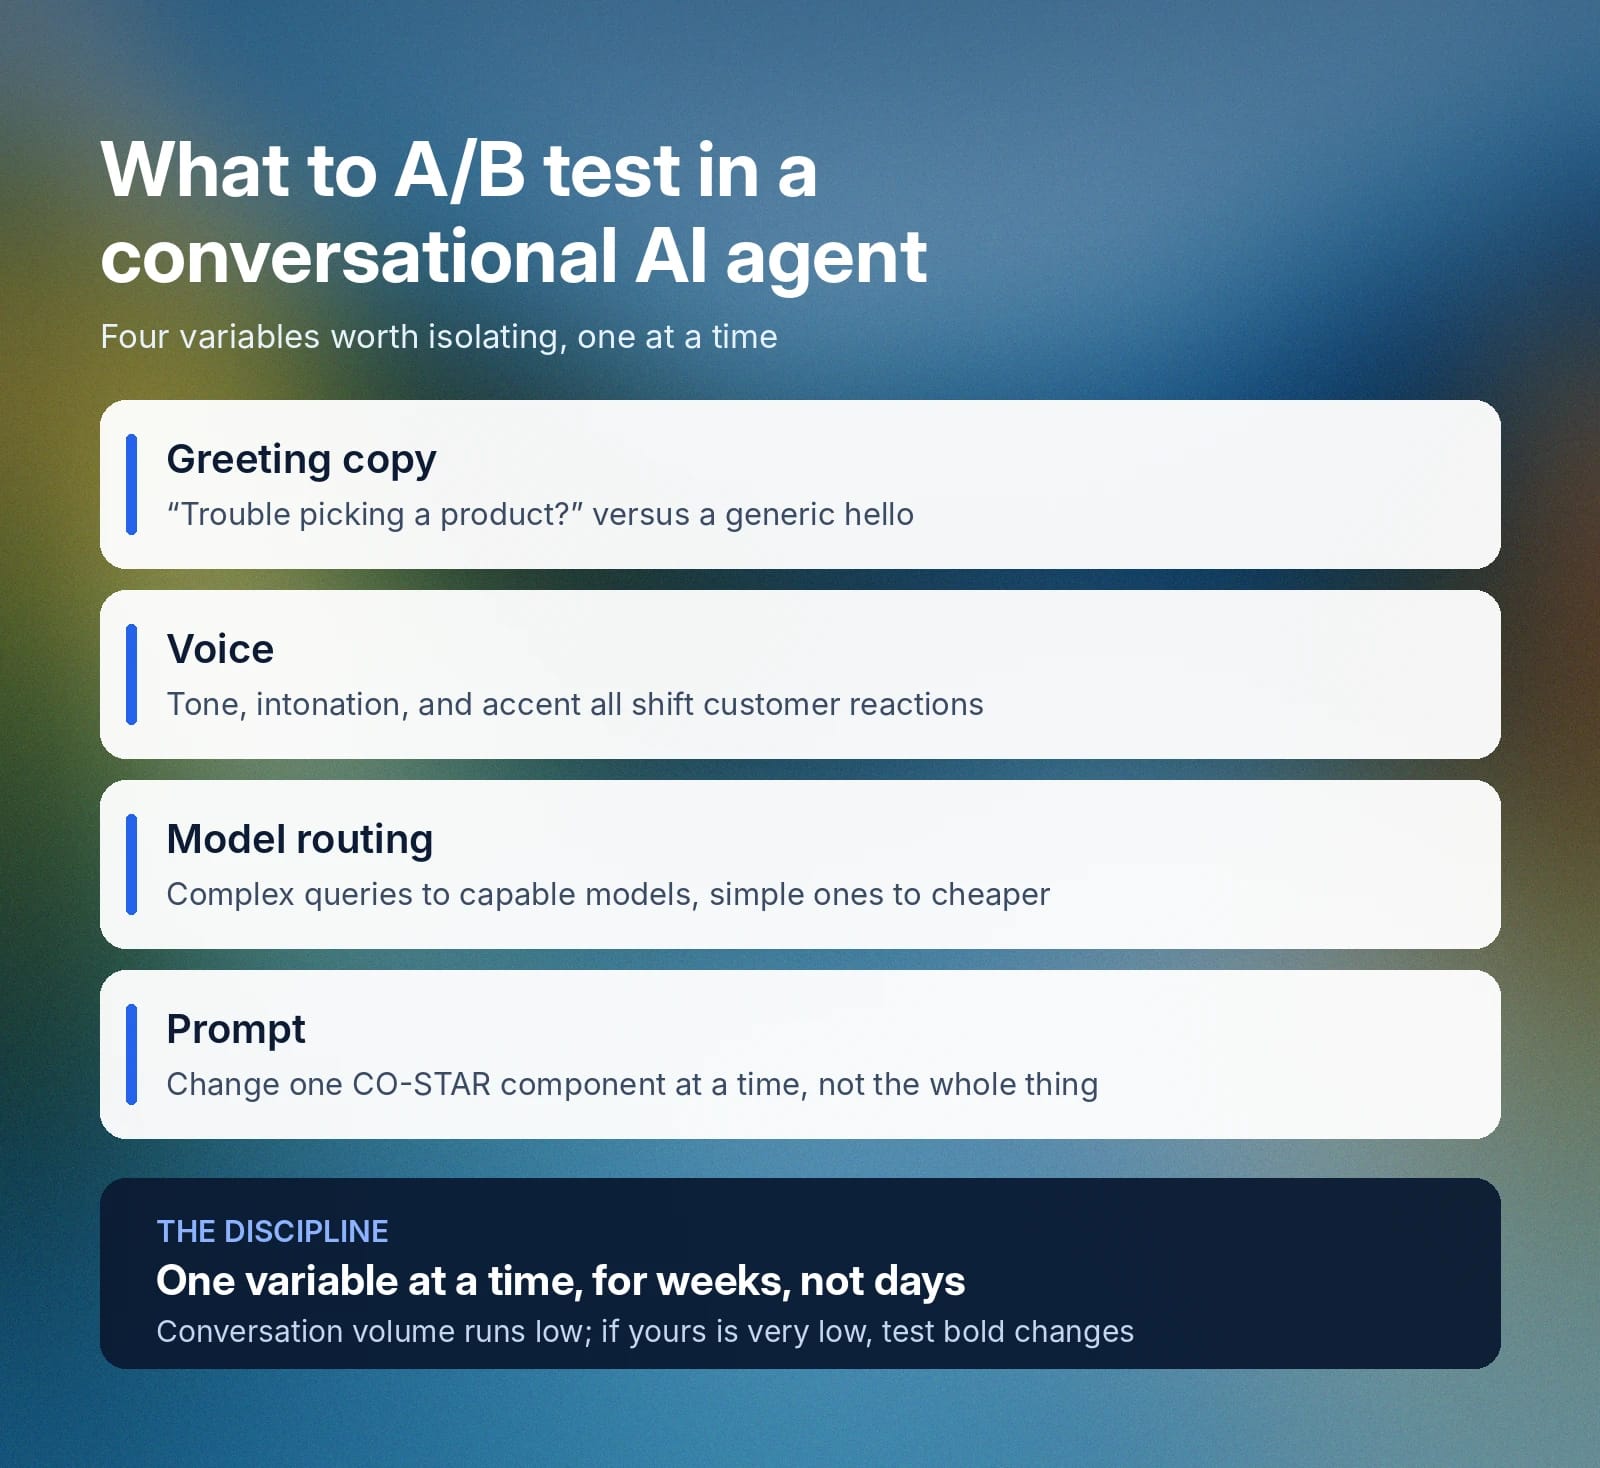
Voor een geldige test moet je daarom steeds één specifieke variabele isoleren, terwijl je de rest van de onderliggende kennisbank gelijk houdt. Mogelijke elementen om te variëren zijn:
- Tekst voor begroeting: Pas het eerste begroetingsbericht aan naar iets specifieks, zoals: 'Hoi. Heb je moeite met het kiezen van een product?' in plaats van alleen: 'Hallo, hoe kan ik helpen?'
- Stem: Klanten kunnen in specifieke omstandigheden positiever reageren op bepaalde stemmen dan op andere, op basis van masculiniteit tegenover feminiteit, toon, intonatie en zelfs accent.
- Modelrouting: Zeer capabele modellen kosten meestal meer. De efficiënte en kosteneffectieve optie is daarom complexe en eenvoudige vragen naar het juiste model te routeren.
- Prompt: Prompts hebben meerdere onderdelen, dus wijzig steeds slechts één aspect, zoals de context, doelstelling, stijl, toon, doelgroep of antwoordtemplate (CO-STAR).
Teams moeten ook de testperiode aanpassen. Conversatieverkeer is doorgaans veel lager dan het aantal webpaginaweergaven, dus je moet de test weken in plaats van dagen uitvoeren om statistische significantie te bereiken. Als je volume uiterst laag is, test dan grote, ingrijpende veranderingen in plaats van kleine aanpassingen.
Een praktische workflow vereist ook agentversiebeheer, vergelijkings- en rollbacktools. We hebben deze rechtstreeks in ElevenAgents ingebouwd.
Hoe je een conversationele AI-agent test vóór implementatie
Klantenservice is een direct contactmoment met de mensen die je bedrijfsresultaat beïnvloeden, en AI reageert soms onvoorspelbaar op kleine wijzigingen. Test daarom altijd een nieuwe of aangepaste conversationele AI-agent voordat je deze in productie neemt. Alleen 'vibe testing' is niet genoeg.
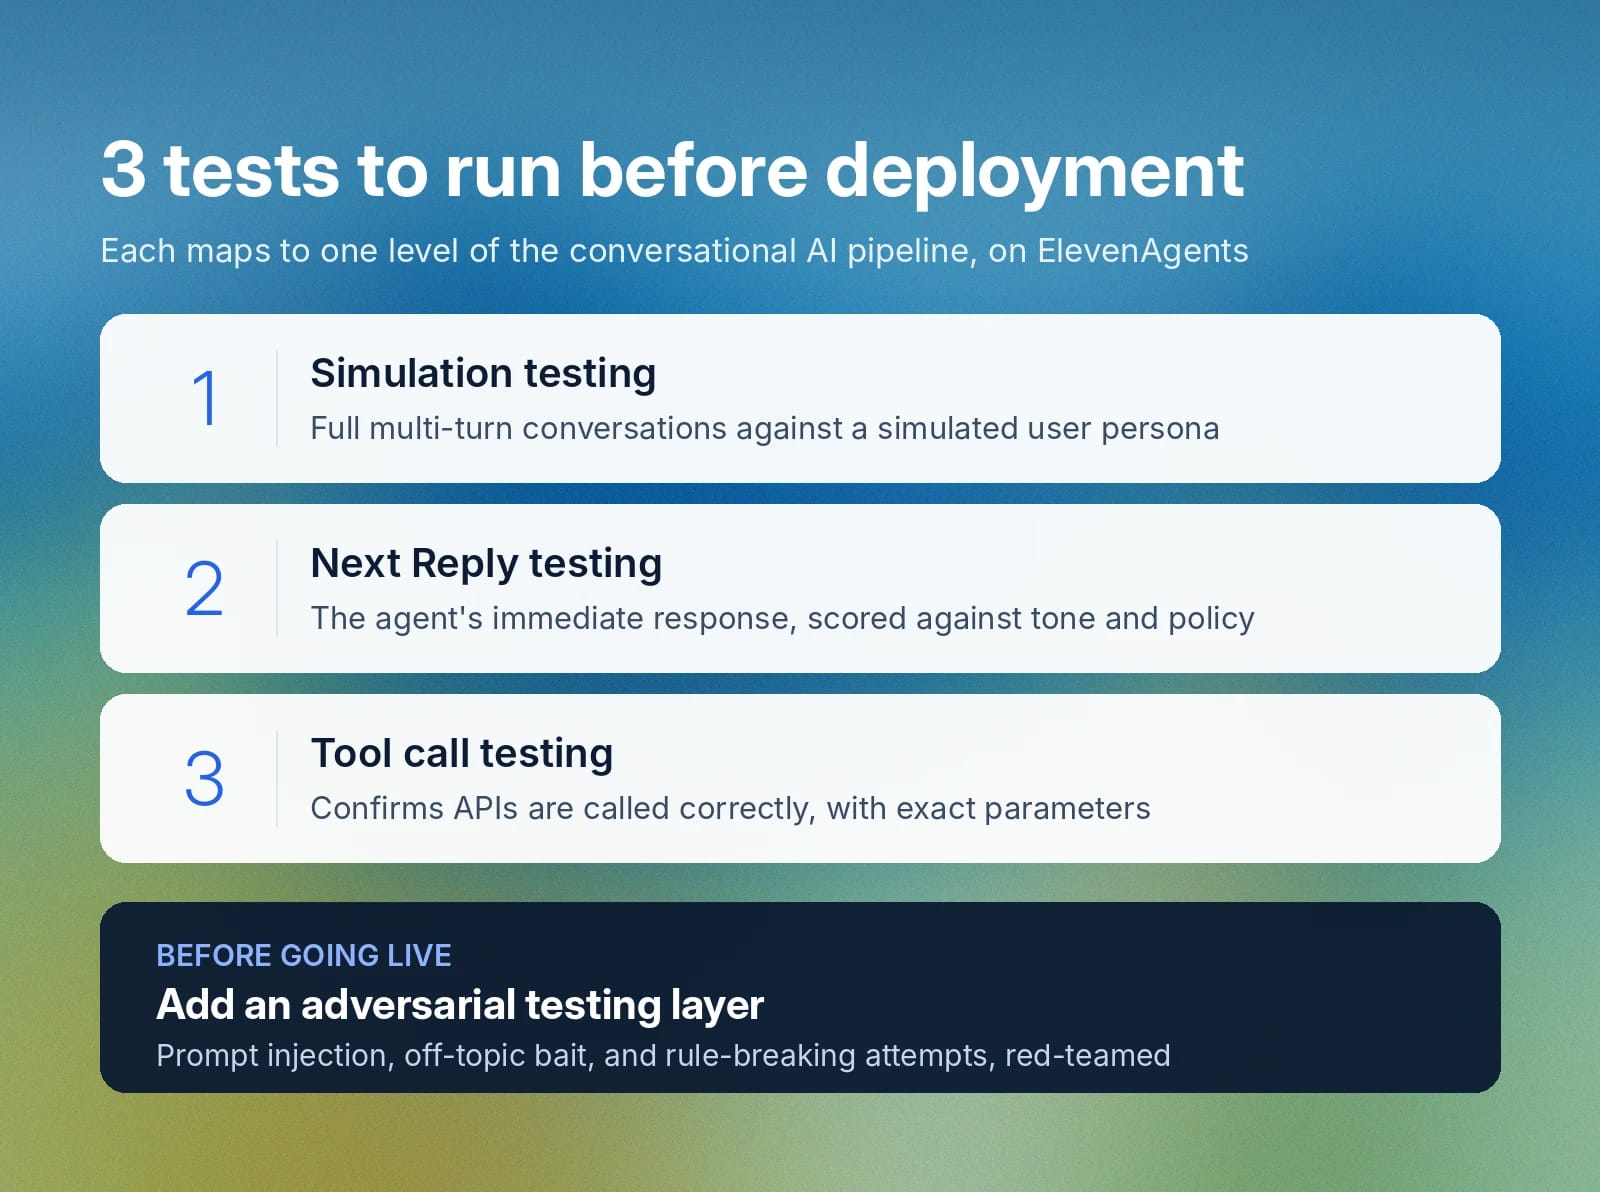
We hebben ons testframework voor ElevenAgents ontworpen rond drie belangrijke testtypen die zijn gericht op specifieke niveaus van je pipeline voor conversationele AI:
- Simulatietests: Voert een volledig gesprek met meerdere beurten met een gesimuleerde gebruiker persona uit om te bevestigen dat de dialoog aan de gewenste prestatieniveaus voldoet.
- Next Reply-tests: Test alleen de directe antwoorden van de agent aan de hand van specifieke beperkingen voor toon, beleid of andere aspecten, om de geschiktheid en nauwkeurigheid van de antwoorden te bevestigen.
- Tool call-tests: Zorgt ervoor dat agents gekoppelde API's correct aanroepen en de exacte parameters doorgeven die nodig zijn voor databaseopzoekingen of overdrachten met grote gevolgen.
Omdat zoveel aanvallers modellen proberen te jailbreaken voor kwaadaardige doeleinden, heb je vóór de livegang ook een laag voor adversarial testing nodig. Werk samen met QA-teams, prompt engineers en cybersecurityprofessionals van red teams om promptinjectie, off-topic lokmiddelen en pogingen om regels te omzeilen te testen.
Tot slot, voer een gefaseerde uitrol uit door pilotversies voor een kleine groep gebruikers te lanceren en hun gedrag in de praktijk te monitoren. Stel strikte criteria op waaraan het model moet voldoen voordat je het uitbrengt voor een grotere groep of je volledige klantenbestand. Wijs één verantwoordelijke eigenaar aan die toezicht houdt op de release en maak een rollbackpad voor het geval een aanpassing leidt tot lagere prestatiemetrics.
Chatbotprestaties in productie evalueren
Definieer vóór je je model voor conversationele AI lanceert hoe succes er voor elke use case uitziet. Dit is vooral belangrijk voor toepassingen in sterk gereguleerde sectoren, waar nauwkeurigheid en gegevensprivacy aan hogere maatstaven en strengere vereisten moeten voldoen.
Geautomatiseerde antwoorden maken het eenvoudig om modellen op schaal met A/B-tests te testen, maar objectief testen vereist dat je dit combineert met ad-hoc transcriptlezing en feedback van menselijke testers. Mensen in de loop vangen nuance in gesprekken op die AI-modellen missen en bijzonderheden in de data die anders verloren gaan in geaggregeerde cijfers. Een uitgebreide evaluatiestrategie omvat ook sentimentanalyse en directe gebruikersfeedback.
Continue verbetering onderscheidt volwassen systemen die een hoog rendement opleveren verder. Terwijl concurrenten testen en monitoren als afzonderlijke taken behandelen, combineert een volwassen pipeline ze tot één geheel. In dat geval worden productiefouten rechtstreeks aan je testset toegevoegd om de volgende geoptimaliseerde agent te trainen.
Regelmatige aanpassingen worden ook nodig wanneer AI-bedrijven de basismodellen bijwerken waarop je agent draait. Deze wijziging zorgt er vaak voor dat een prompt die eerder effectief was, plotseling bijdraagt aan onbetrouwbare of zelfs ongepaste antwoorden.
We hebben deze feedbackloop rechtstreeks in ons platform ingebouwd. Gebruik onze tools voor gespreksanalyse om gestructureerde gegevensverzameling te automatiseren en sentiment eenvoudig te evalueren. Grote organisaties gebruiken ook onze enterprise-infrastructuur voor conversationele AI om hun agents wereldwijd met vertrouwen te monitoren en op te schalen.
Ga aan de slag met ElevenAgents voor klantenservicemetrics
Conversationele AI succesvol op schaal lanceren vereist meer dan alleen hoogwaardige stemmen en modellen met lage latentie. Je hebt een geïntegreerd ecosysteem nodig voor het ontwerpen, bouwen, testen, implementeren en aanpassen van workflows met meerdere agents.
ElevenAgents biedt de schaalbare infrastructuur die je nodig hebt. Je team heeft toegang tot tools zoals Next Reply-verificatie, sentimenttracking en automatische gegevensverzameling om modellen continu te monitoren en te optimaliseren voor de beste resultaten. Nog beter: je vangt regressies op voordat ze je klanten bereiken.
Ben je klaar om het proces voor het meten van conversationele AI te vereenvoudigen? Bekijk onze functies voor agenttests en ontdek hoe onze enterpriseteams betrouwbare agents implementeren die je klantenservicemetrics verbeteren.
Lees meer over ElevenAgents of registreer je om vandaag aan de slag te gaan.
Veelgestelde vragen over het meten van conversationele AI

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.



