Maak kennis met Eleven Realtime: een eenvoudigere manier om natuurlijke spraakagenten te bouwen
- Geschreven door
- Min Kim
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Een stemagent bouwen die natuurlijk klinkt, vereist vandaag de dag veel beslissingen. Je moet keuzes maken voor afzonderlijke componenten zoals spraakherkenning, detectie van stemactiviteit, beurtwisseling, het onderliggende LLM en Text to Speech. Deze stack bouwen is al een project op zich, en alle componenten goed laten samenwerken vraagt om meer testen en finetunen.
Eleven Realtime is een nieuwe categorie Speech to Speech-modellen die deze obstakels wegneemt. Elk model is een volledige stemagent, geoptimaliseerd voor afzonderlijke toepassingen. Beide ondersteunen meer dan 90 talen en kunnen elke van de ruim 17.000 stemmen in de ElevenLabs-bibliotheek gebruiken:
Vandaag lanceren we:
- Eleven Realtime v1 Mini voor natuurlijke gesprekken tegen lage kosten. Dit is de beste keuze voor AI-assistenten, docenten en interactieve personages en is voldoende voor de meeste toepassingen.
- Eleven Realtime v1 Max voor complexe taken. Dit model is ideaal voor klantenservice, leadkwalificatie en workflows met meerdere stappen, waarbij de agent een proces moet volgen en stappen moet doordenken.
Waarom we realtime modellen hebben gebouwd
Je zou geen configuratie-expert hoeven te worden om een stemagent te bouwen die natuurlijk klinkt. Een agent natuurlijk laten aanvoelen en klinken draait om kleine afwegingen die nuance vereisen, zoals hoe lang je na een pauze wacht voordat je antwoordt, hoe je herstelt wanneer de gebruiker de agent onderbreekt en hoe stem, prompts en een model samenwerken. In ElevenAgents zijn dit allemaal instellingen die je kunt aanpassen.
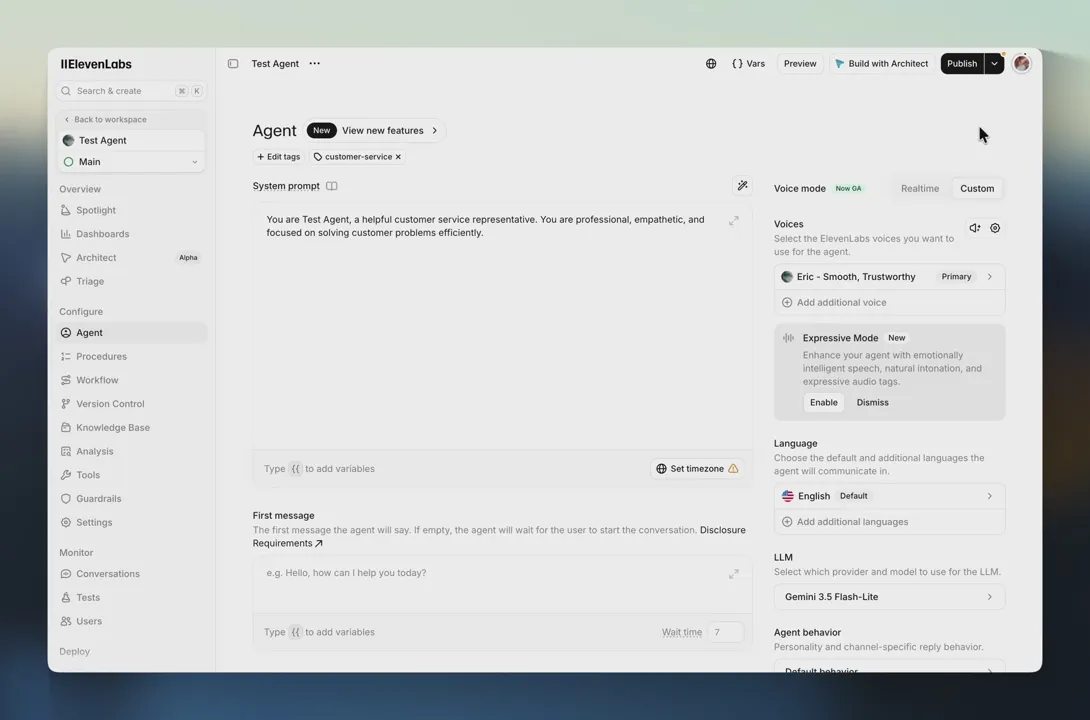
Hetzelfde geldt voor ontwikkelaars die al een realtime API gebruiken. Onze API is compatibel met de Realtime API van OpenAI, dus Eleven Realtime proberen betekent simpelweg dat je het endpoint en de modelnaam wijzigt in de code die je mogelijk al hebt.
Gebouwd op een cascadearchitectuur
Eleven Realtime is gebouwd op een cascadearchitectuur van de hierboven beschreven componenten, van begin tot eind gefinetuned. We noemen ze Speech to Speech-modellen, omdat je dat krijgt met audio in, audio uit, één model-ID en een systeem dat op dezelfde leaderboards kan worden gemeten als fused- en duplexmodellen.
Fused-modellen legden aanvankelijk de lat voor hoe natuurlijk een stemagent kan aanvoelen, terwijl een cascaded-opzet bij elke overdracht meer latentie betekende en de componenten nooit op elkaar waren afgestemd. Realtime neemt die afweging weg en het finetunen dat vroeger jouw project was, is al gedaan.
Cascaded heeft ook praktische voordelen in productie, omdat elke stap tekst oplevert. Je kunt zien wat de agent hoorde en wat die besloot te zeggen, zodat je een verkeerd verstaan woord kunt onderscheiden van een verkeerde beslissing. Diezelfde tekst maakt het voor ElevenAgents mogelijk om guardrails en PII-redactie toe te passen op een Realtime-agent.
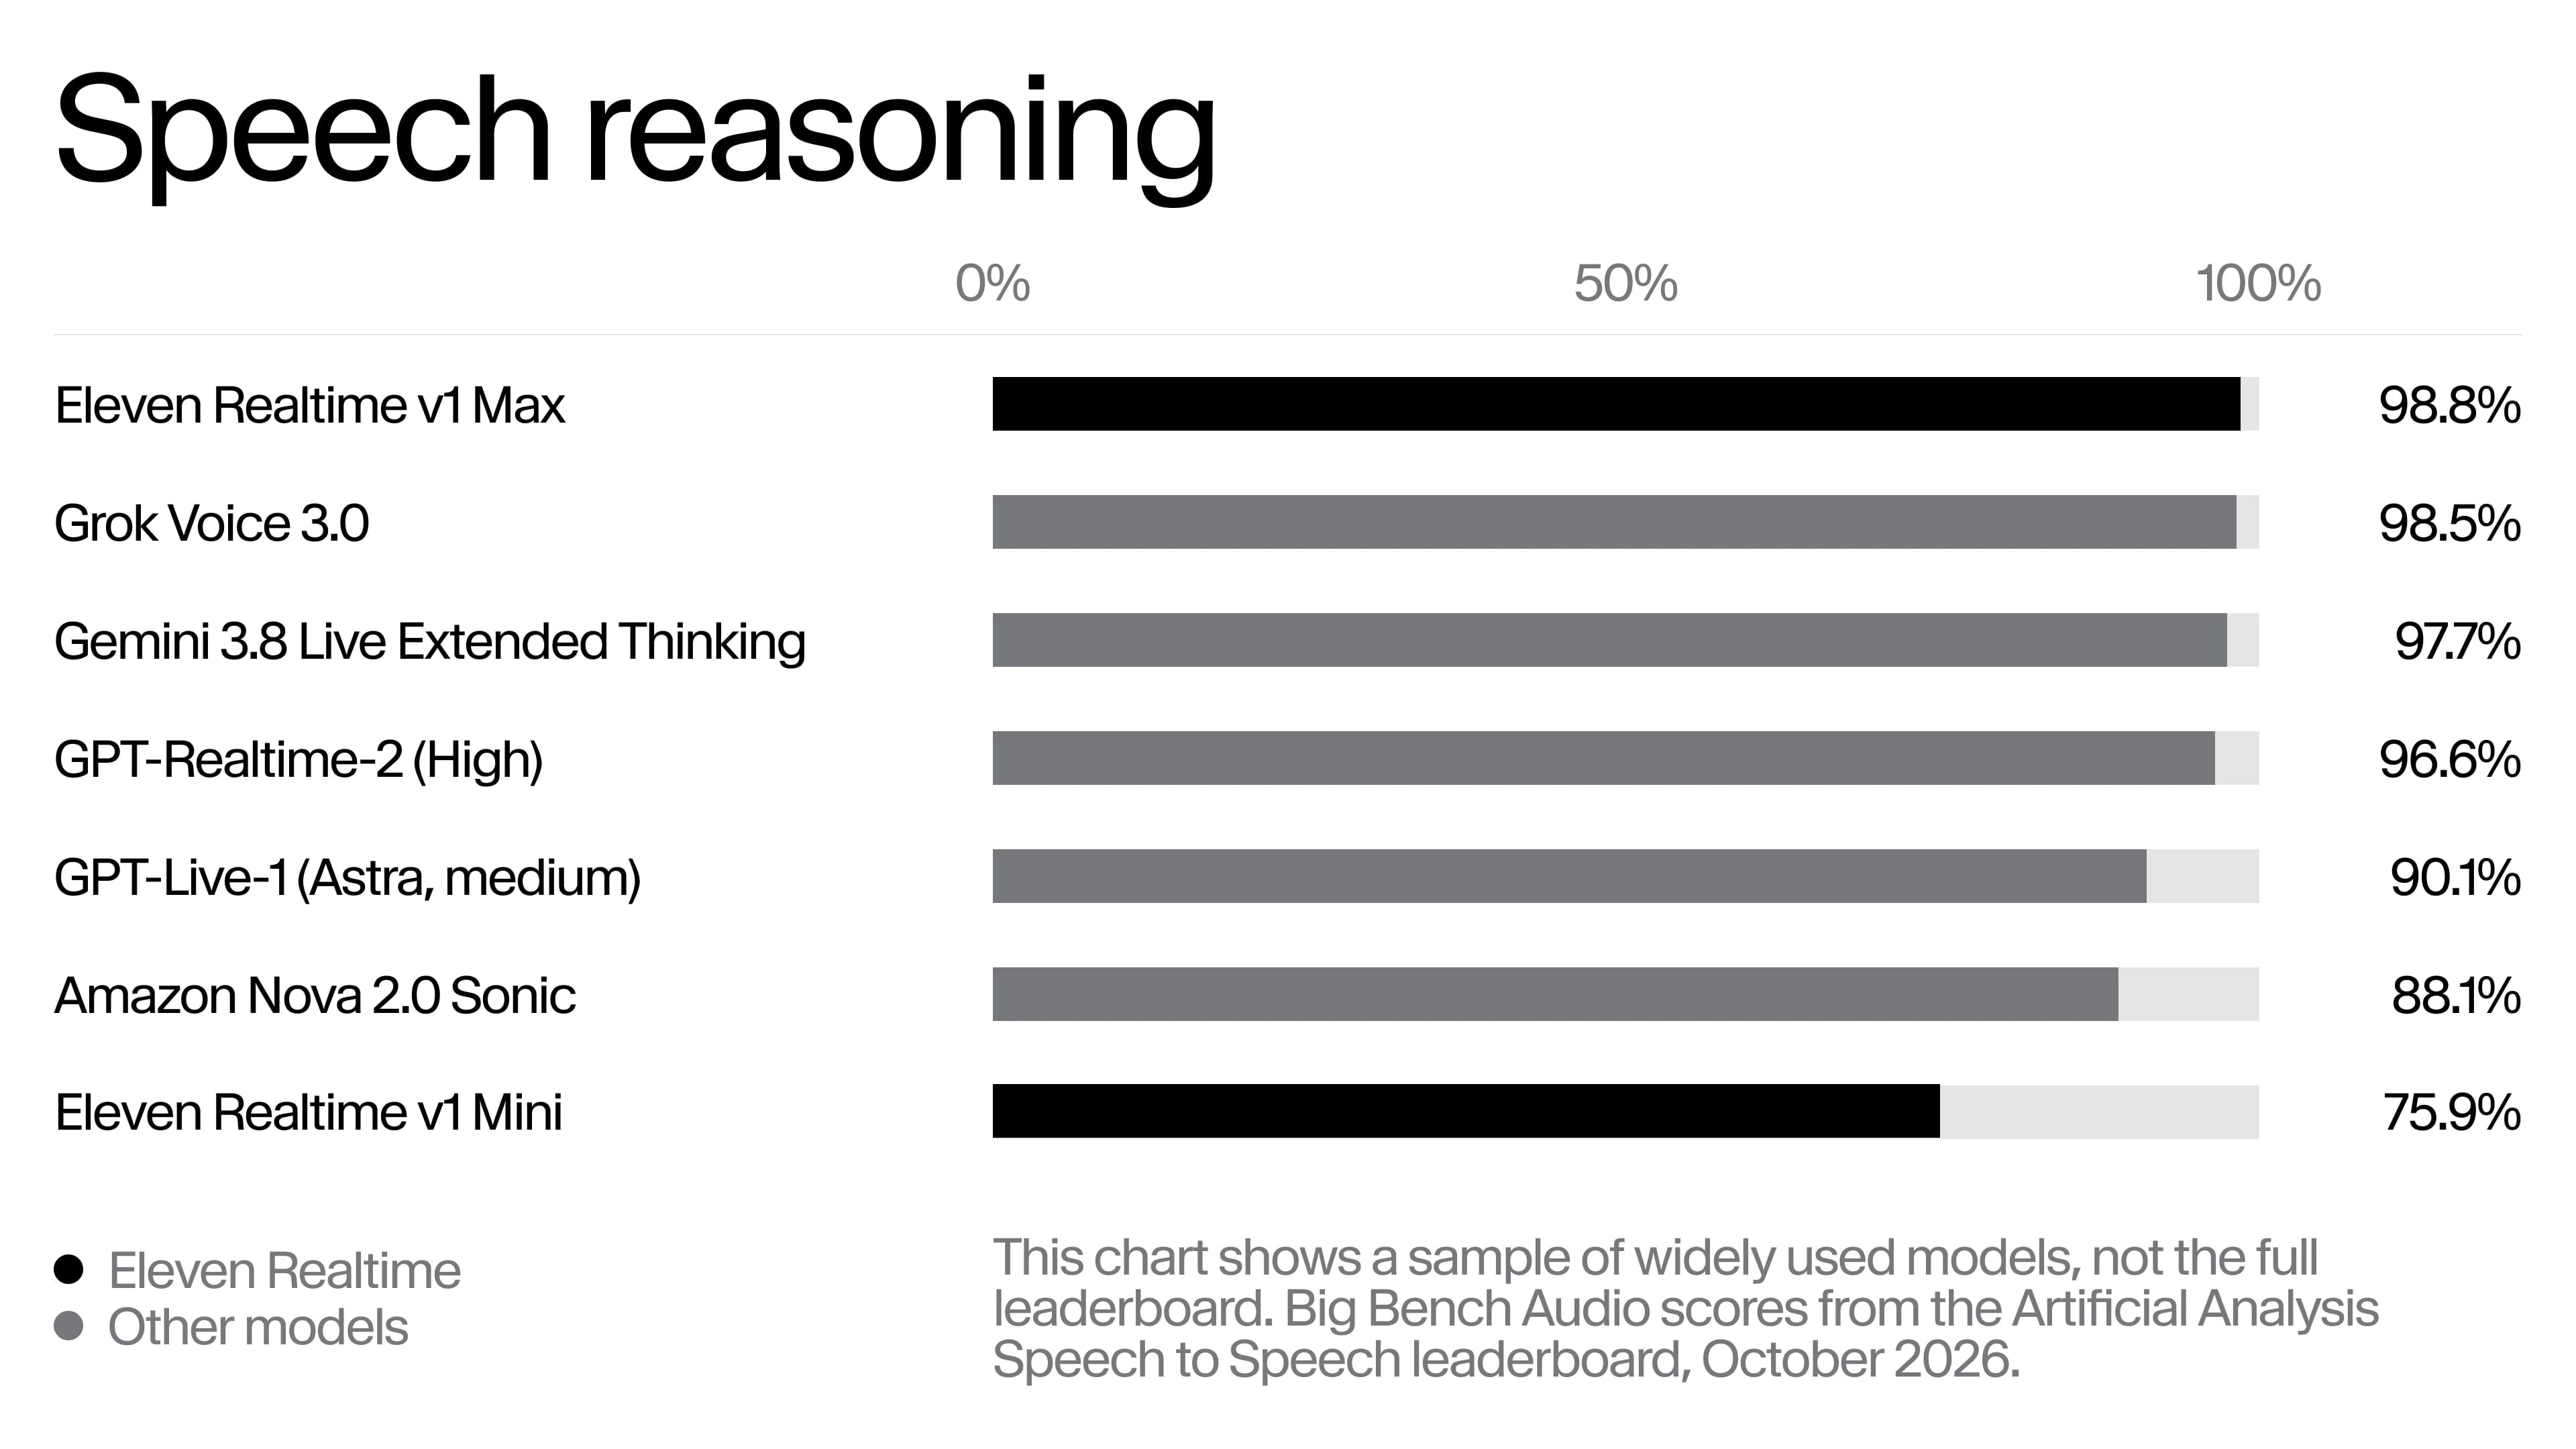
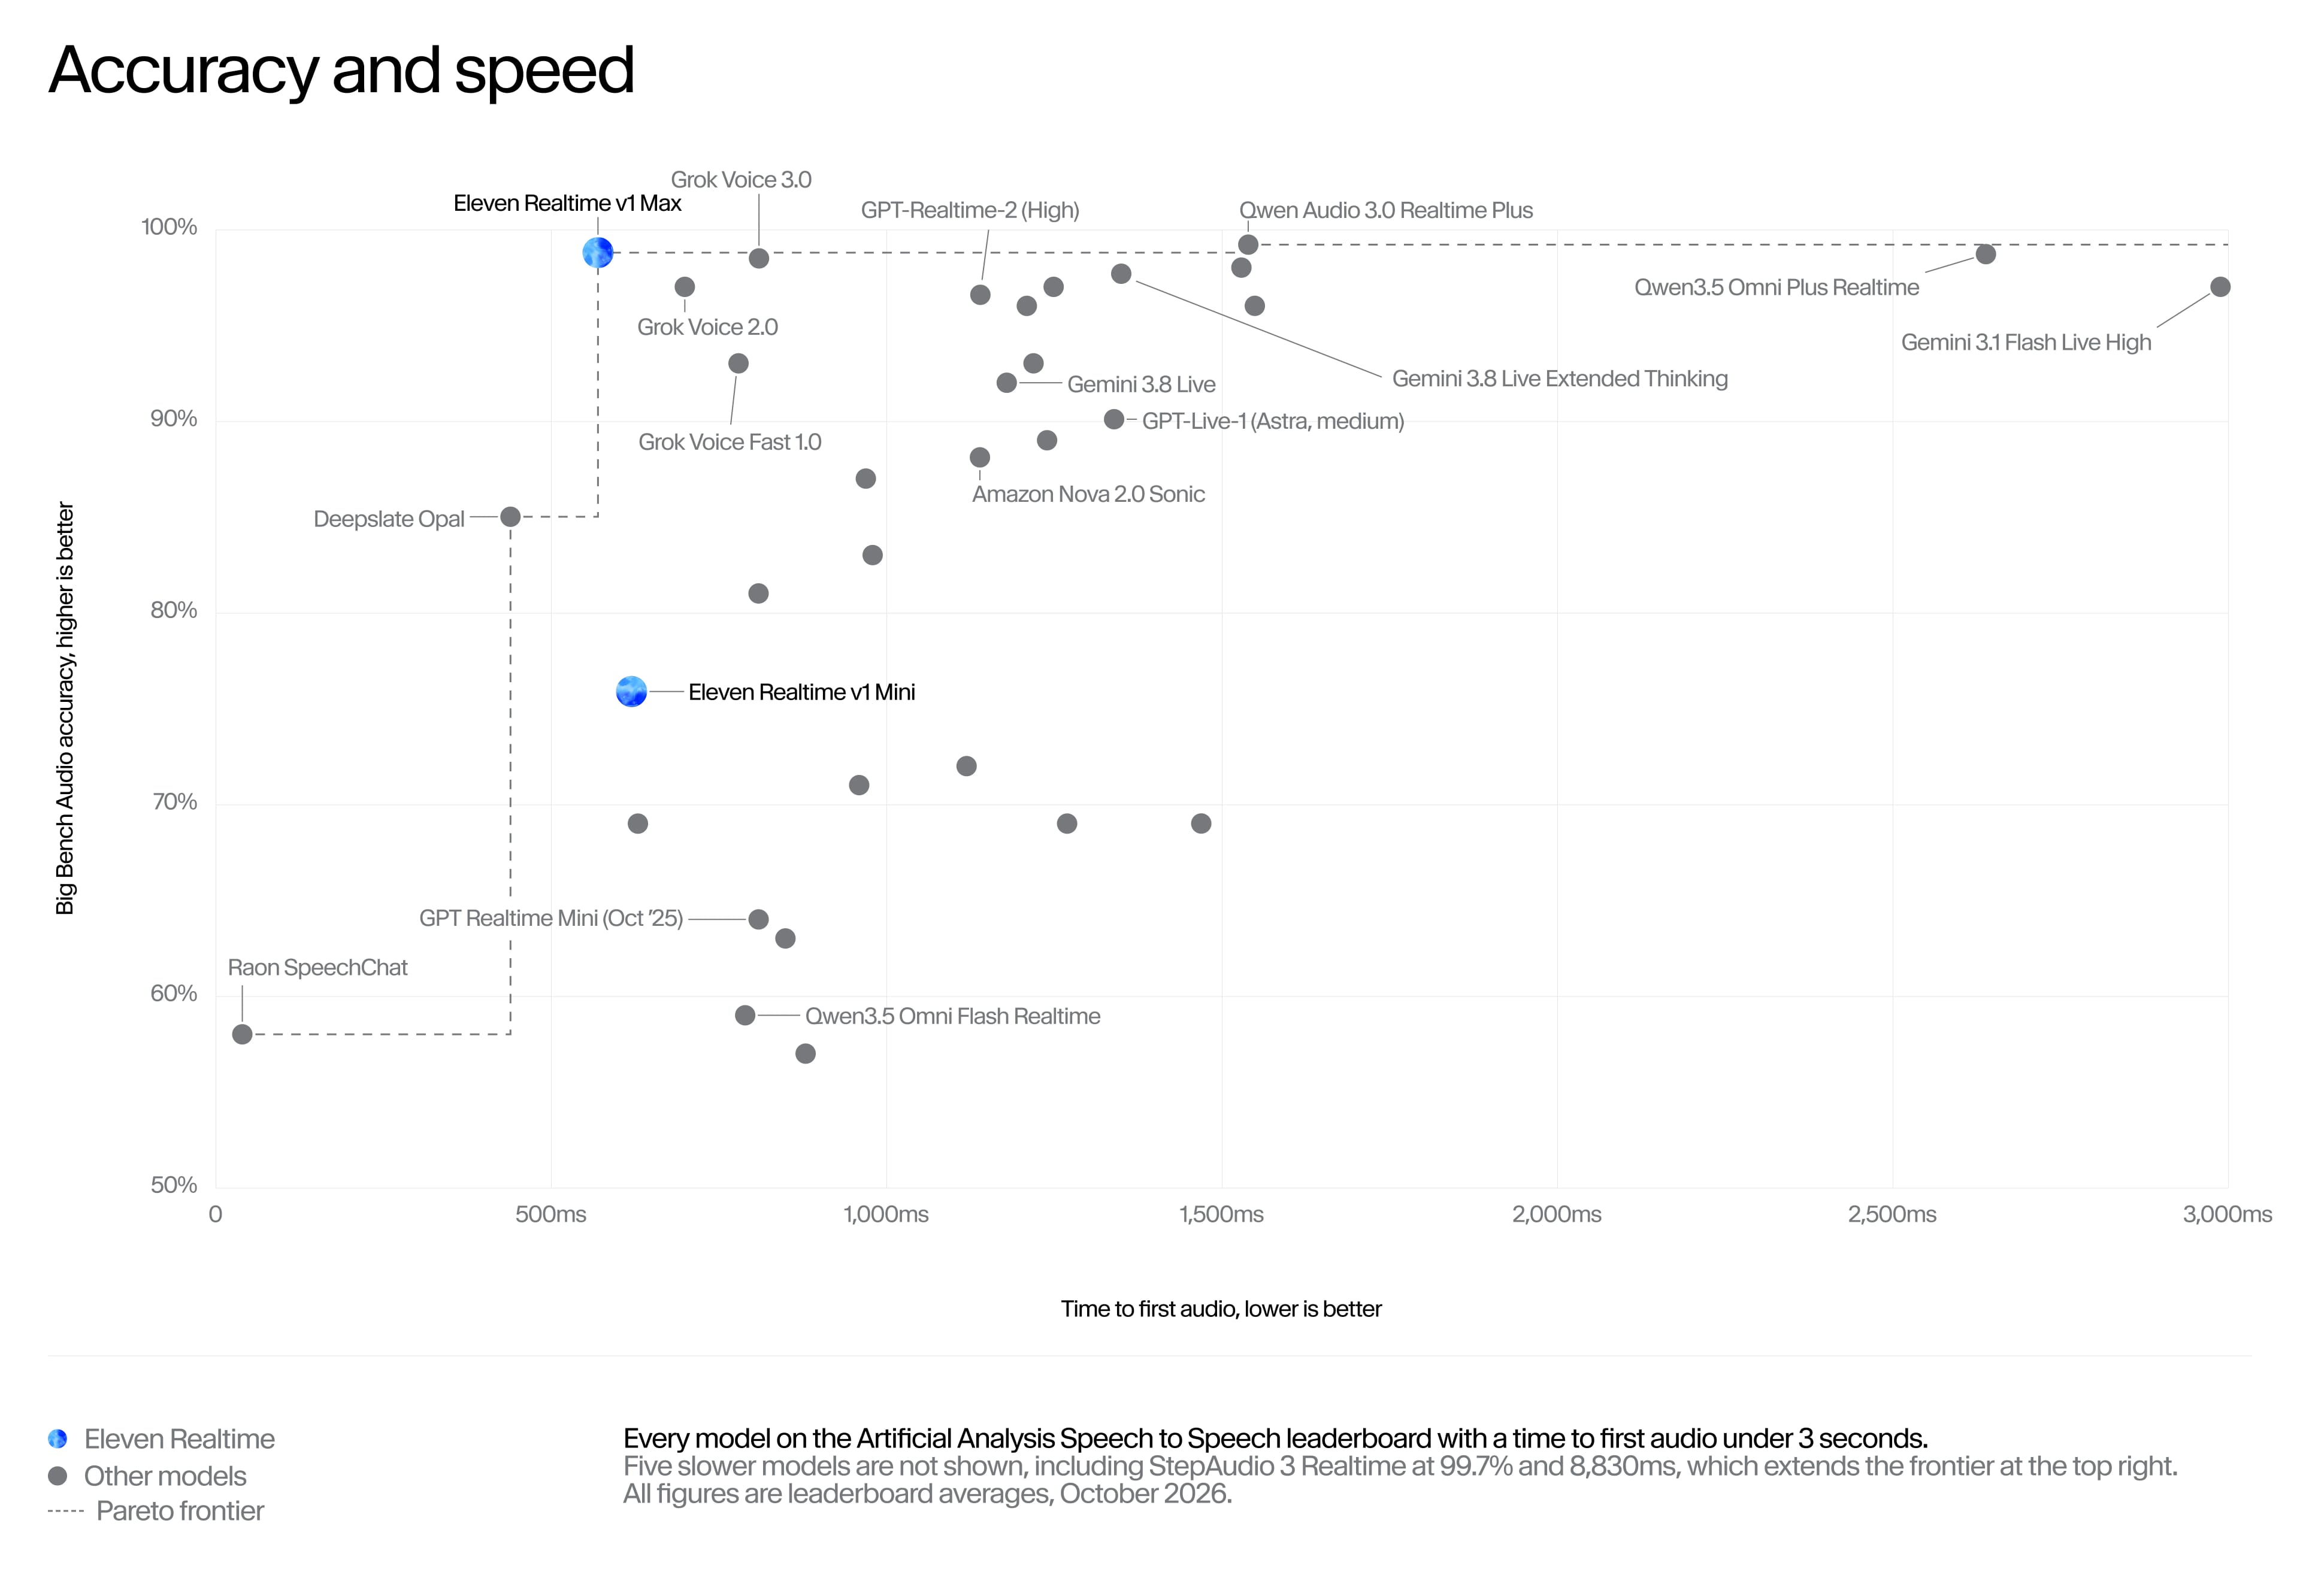
De benchmarks hieronder testen of die afweging echt is verdwenen. Bij gespreksdynamiek scoren beide modellen in dezelfde categorie als fused-modellen. Op nauwkeurigheid en snelheid samen is geen enkel model op de leaderboard van Artificial Analysis zowel sneller als nauwkeuriger dan v1 Max.
Hoe ze presteren
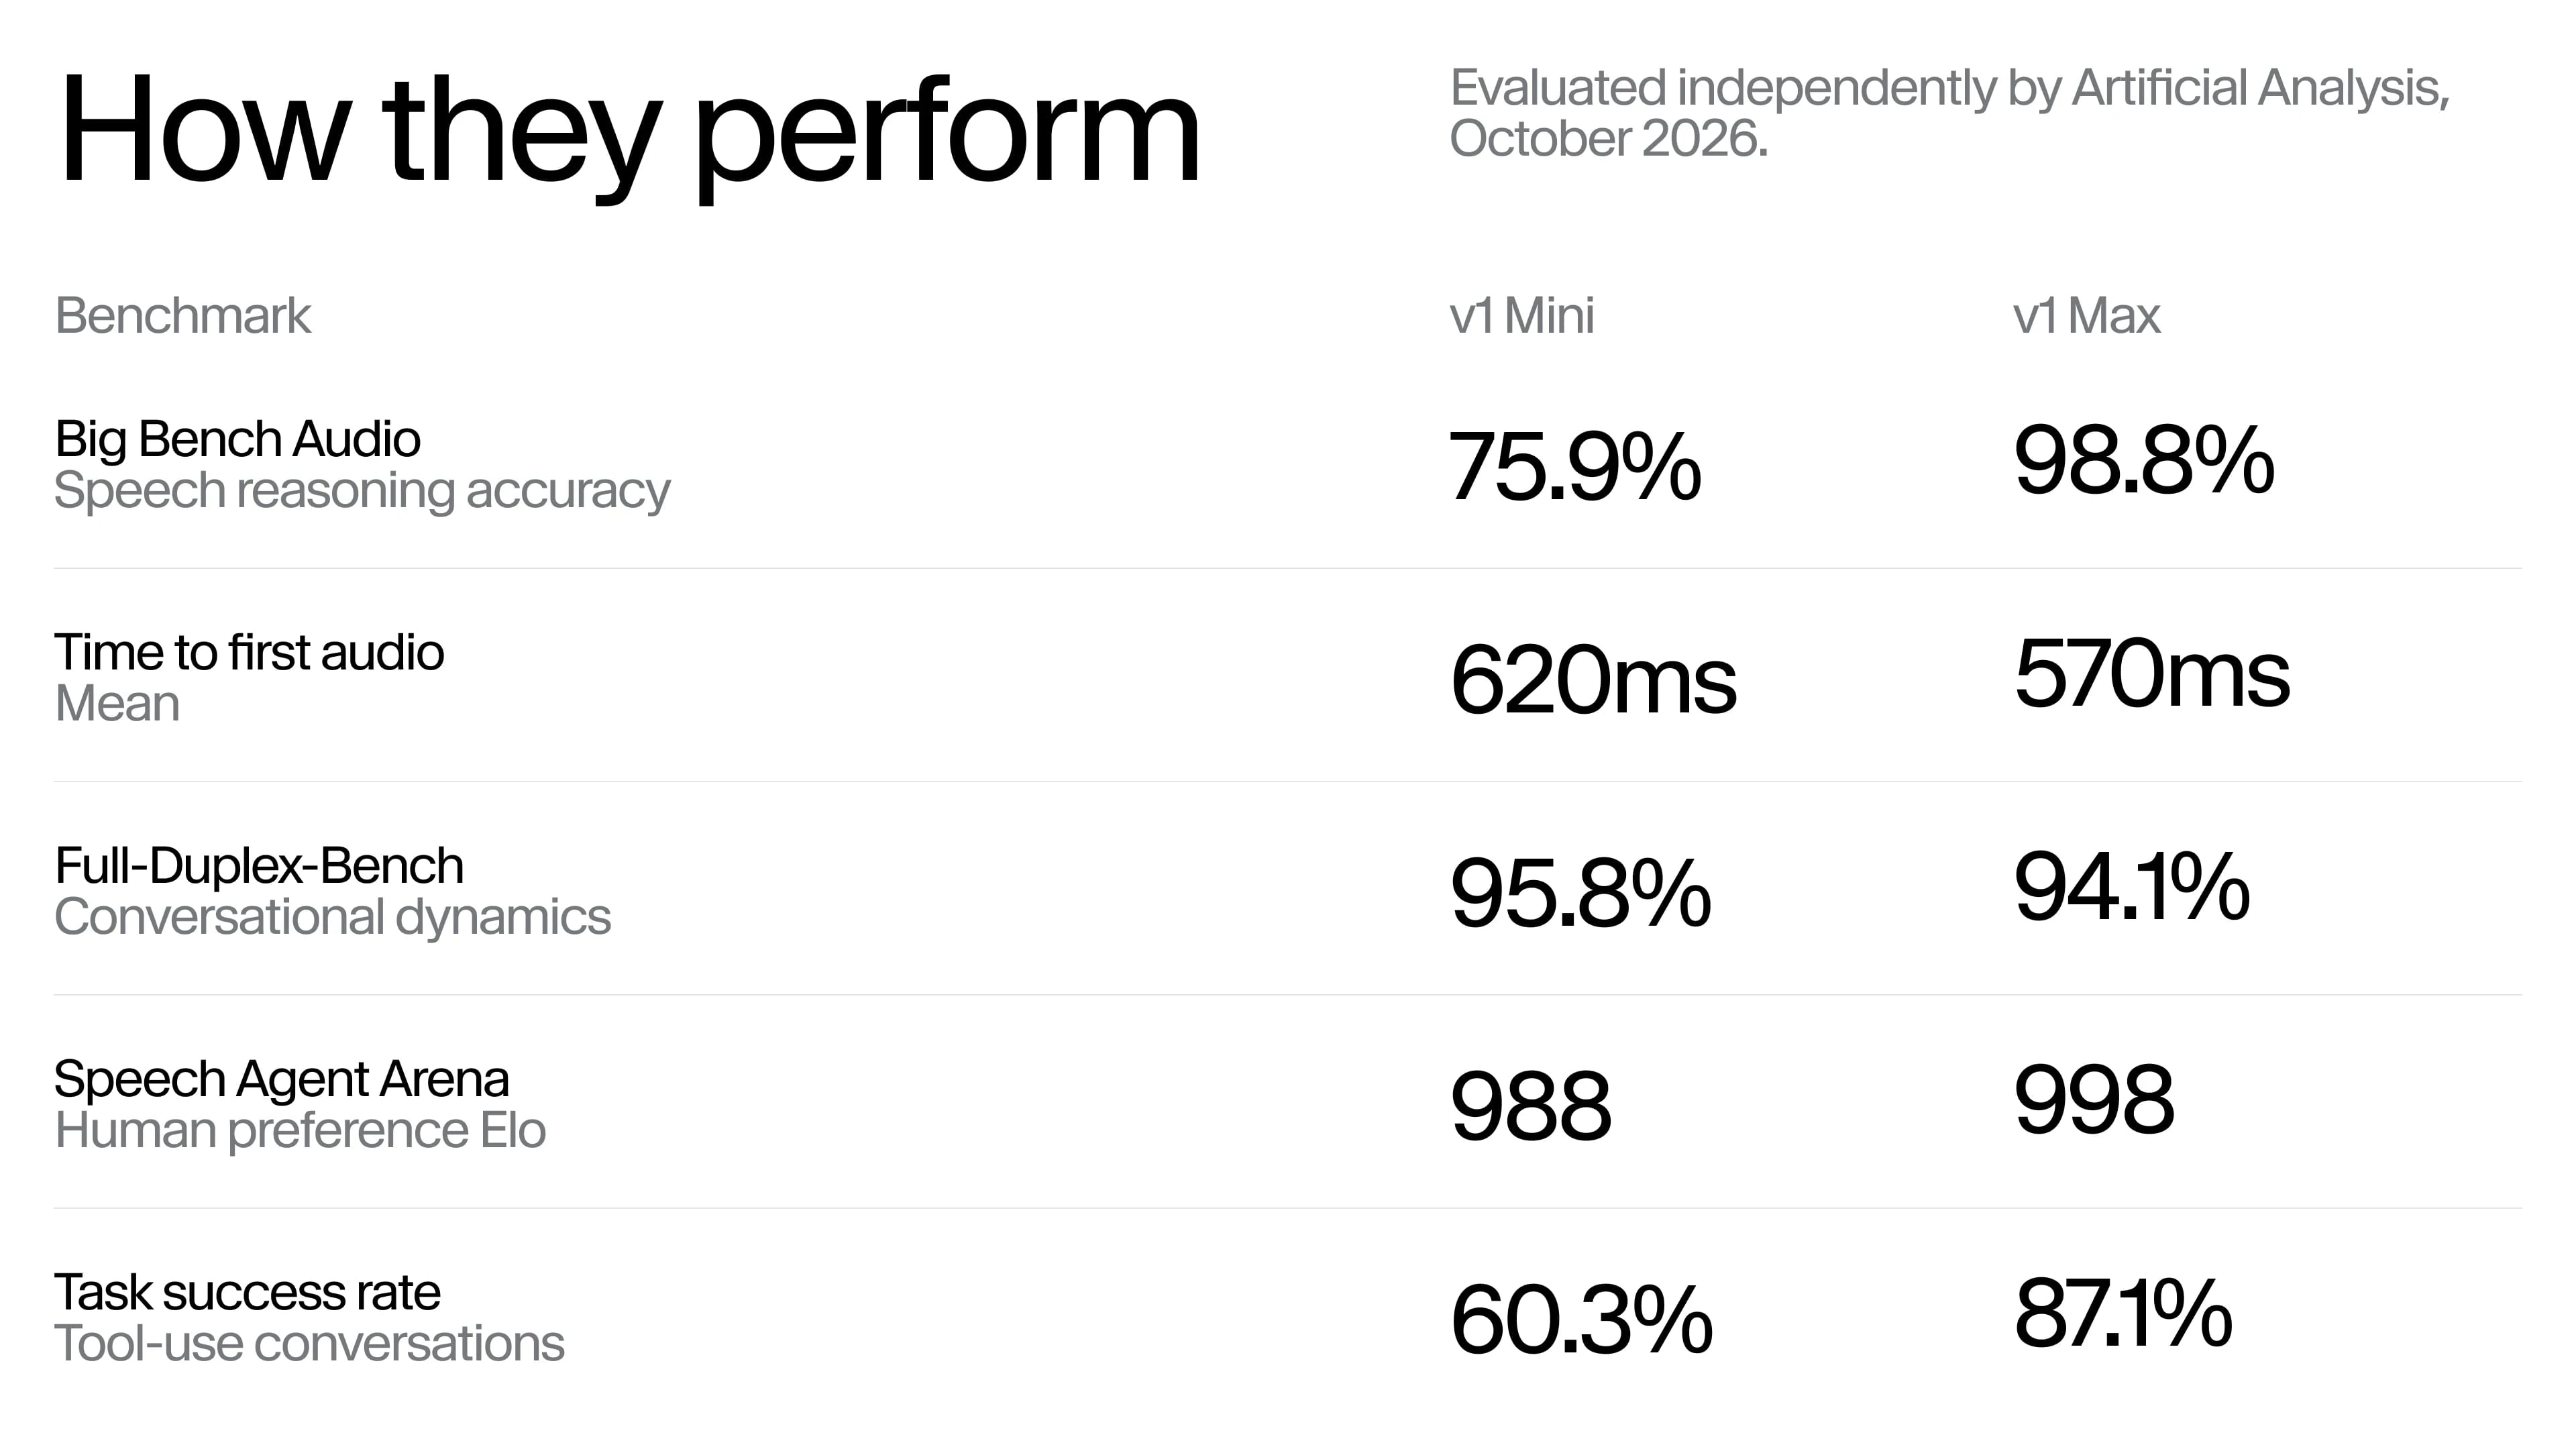
Artificial Analysis heeft beide modellen onafhankelijk beoordeeld aan de hand van drie openbare benchmarks: Big Bench Audio voor redeneren met spraak, Full-Duplex-Bench voor gespreksdynamiek en de Speech Agent Arena voor menselijke voorkeur en het succesvol uitvoeren van taken.
Redeneren met spraak
Big Bench Audio stelt 1.000 redeneervragen via spraak en beoordeelt het gesproken antwoord. Realtime v1 Max beantwoordde 98,8% van de vragen correct en v1 Mini 75,9%.
Snelheid
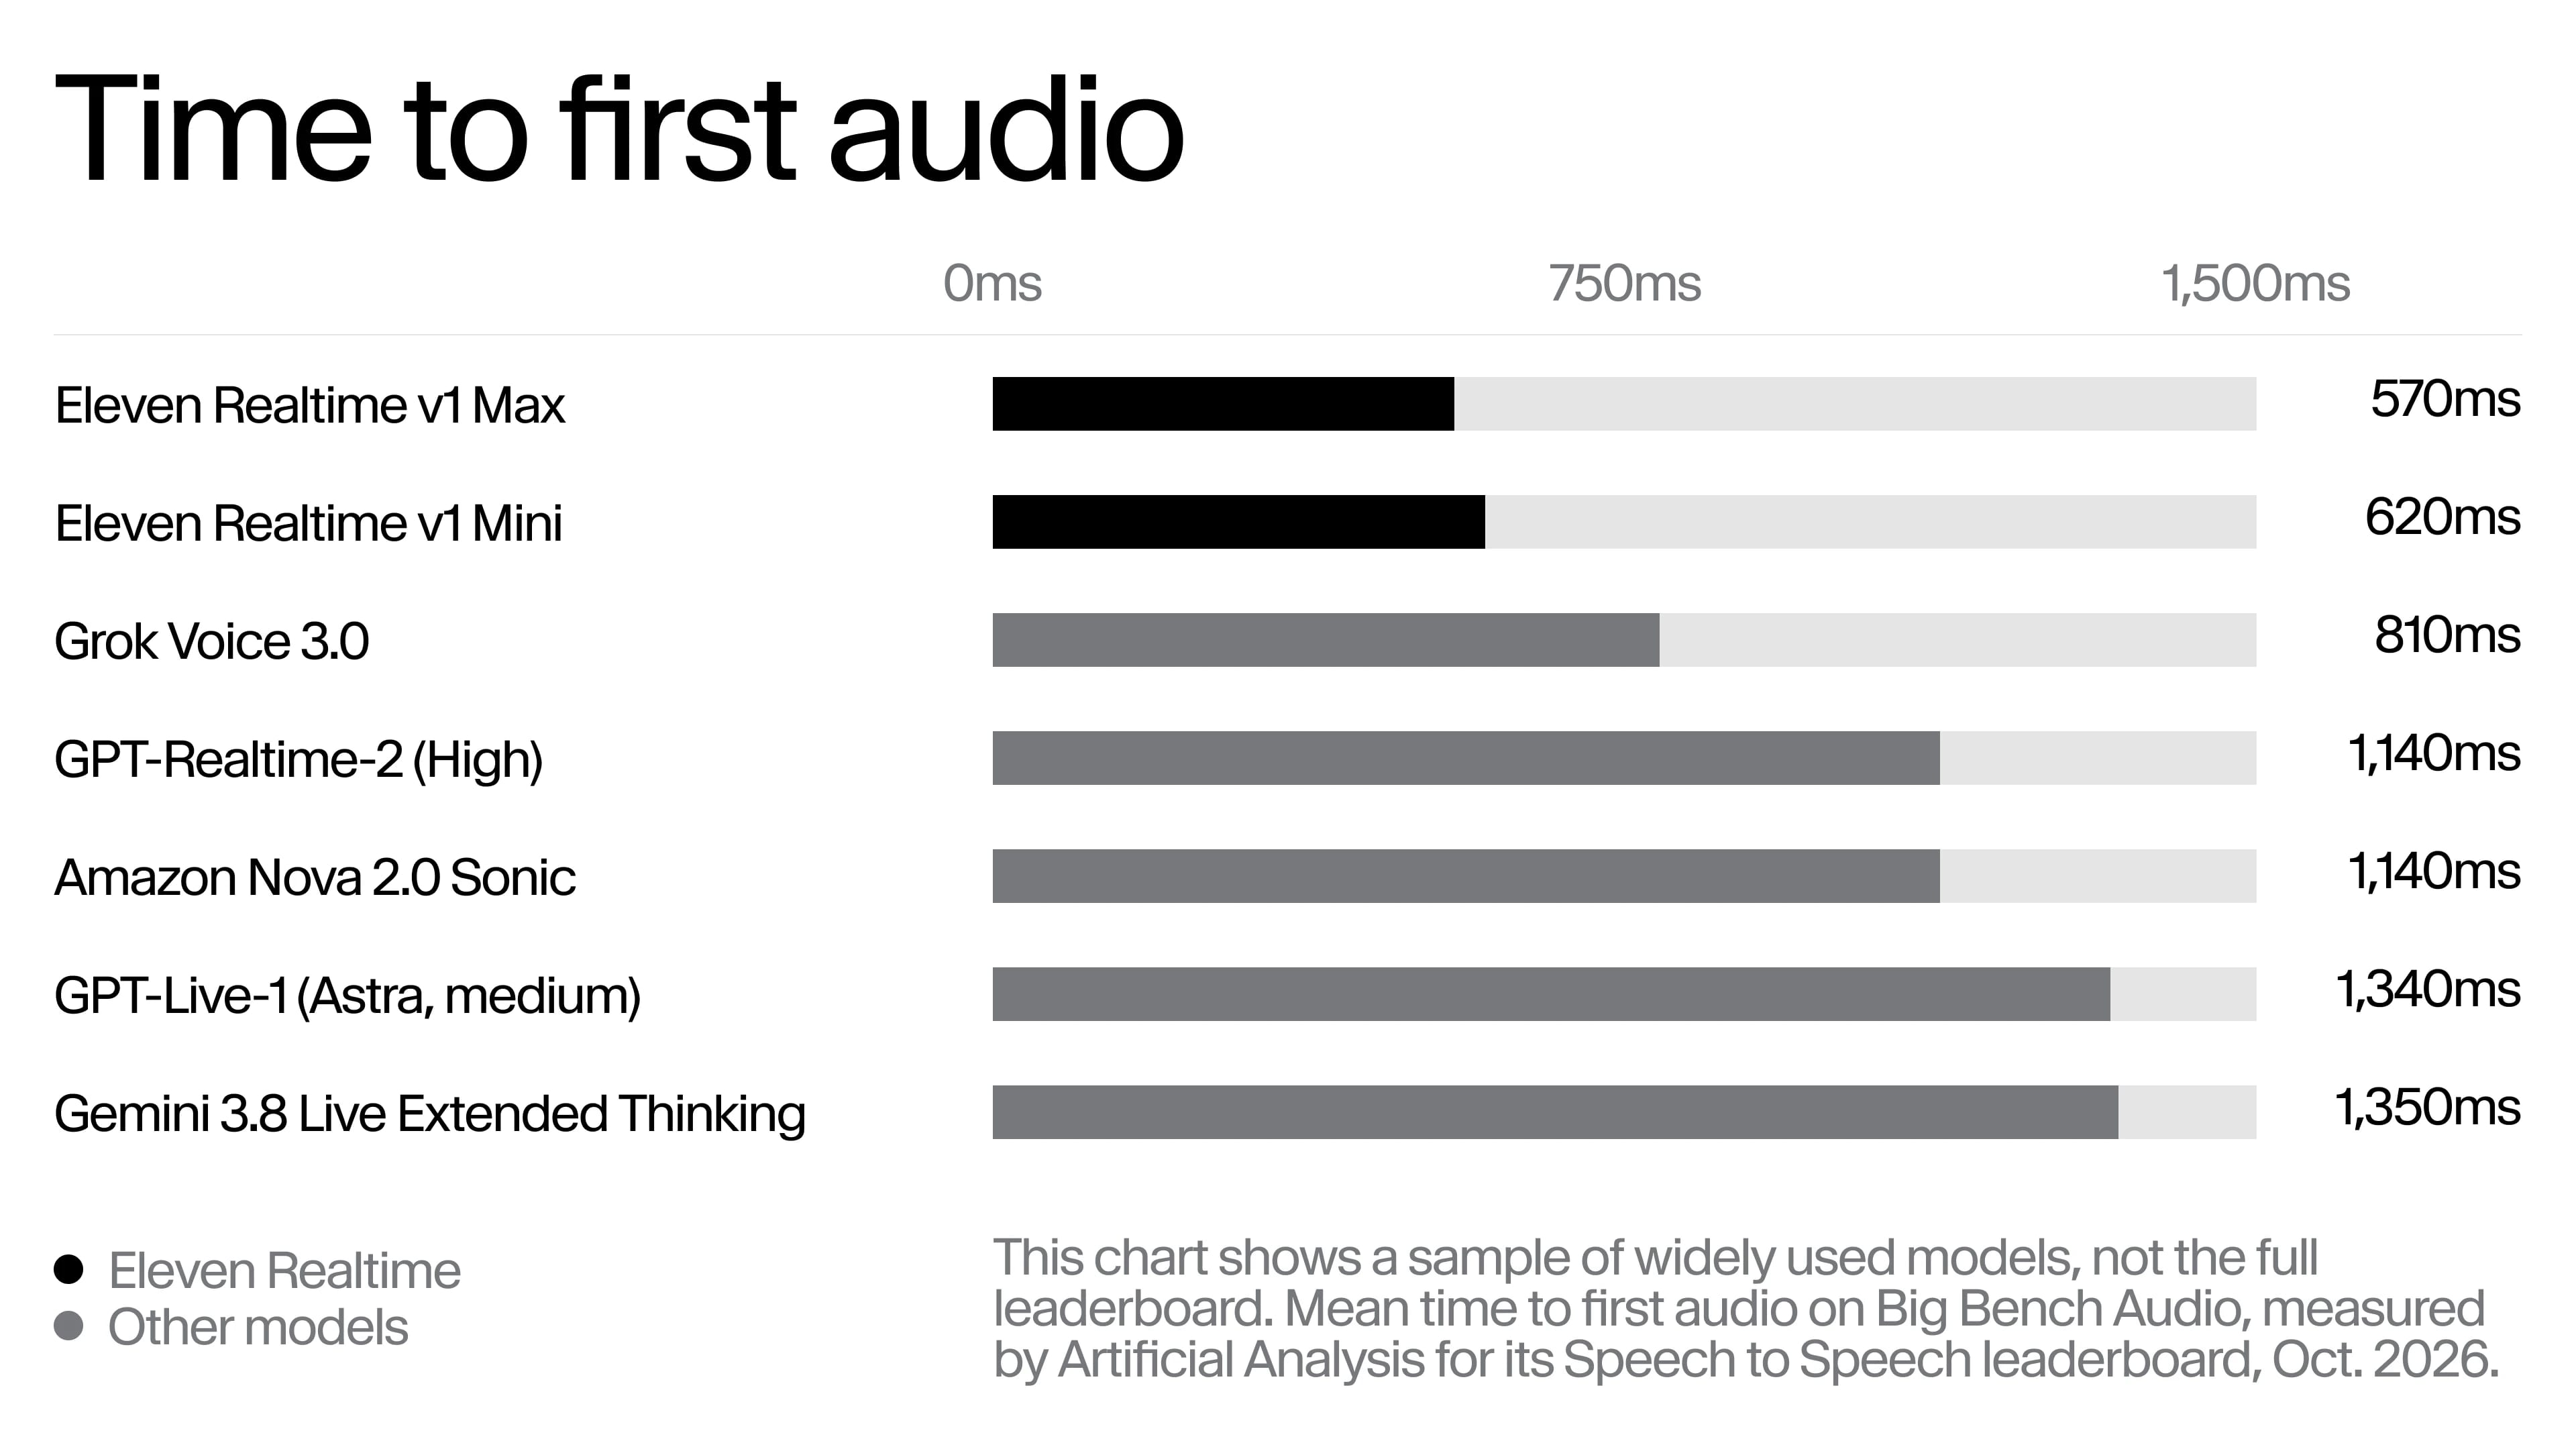
Big Bench Audio stelt 1.000 redeneervragen via spraak en beoordeelt het gesproken antwoord. V1 Max begint gemiddeld na 0,57 seconden te spreken en v1 Mini na 0,62 seconden.
De Pareto-grens voor nauwkeurigheid en snelheid
Nauwkeurigheid en snelheid worden doorgaans gezien als een afweging. De modellen die het hoogst scoren op Big Bench Audio doen er het langst over om te antwoorden, en de snelste leveren veel nauwkeurigheid in. v1 Max blinkt uit op beide metrics.
Gespreksdynamiek en menselijke voorkeuren
Op Full-Duplex-Bench, dat pauzes, beurtwisseling, onderbrekingen en backchannels test, scoort v1 Mini 95,8% en v1 Max 94,1%. In de Speech Agent Arena, waarin mensen twee modellen vergelijken in blinde livegesprekken, scoorde v1 Max 998 en v1 Mini 988. Bij taken met toolgebruik voltooide v1 Max 87,1% en v1 Mini 60,3%. Daarom raden we Max aan voor toepassingen met veel tool calling.
Aan de slag
In ElevenAgents (aanbevolen)
Maak een agent of open een bestaande agent en selecteer een Realtime-model in de dropdown. Vervolgens heb je alles wat ElevenAgents biedt om agents in productie te gebruiken. Dat omvat kanalen voor telefoon, web, WhatsApp en CCaaS, workflows, een kennisbank, guardrails, testen en monitoring.
Bekijk de ElevenAgents-documentatie voor meer informatie.
Via de Realtime API
Als je al een integratie hebt met de Realtime API van OpenAI, is de snelste manier om Eleven Realtime te proberen je code te behouden en te wijzigen waar die naartoe verwijst. De Realtime API maakt verbinding via WebSocket en volgt de OpenAI Realtime-specificaties, dus de SDK van OpenAI werkt zonder aanpassingen.
De Realtime API maakt alleen verbinding via WebSocket, dus een WebRTC-integratie moet eerst naar WebSocket worden overgezet. De API werkt ook los van ElevenAgents. Als je dus kanalen, een kennisbank of andere platformfuncties nodig hebt, bouw dan vanaf het begin op ElevenAgents.
De migratiehandleiding behandelt de stappen en de verschillen met de API van OpenAI.
Min werkt in het Growth-team bij ElevenLabs en richt zich op ElevenAPI en On-Prem/On-Device. Eerder leidde hij productmarketing bij Stainless als de tweede GTM-medewerker en daarvoor was hij een vroege PMM bij WorkOS, waar hij launches, enablement, content en groei aanstuurde.