
Bouw in 20 minuten een stemagent met ElevenLabs en Twilio
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Een spraakagent kan inkomende telefoongesprekken beantwoorden, bellers in realtime transcriberen met Speech to Text (STT), een reactie genereren met een groot taalmodel (LLM) en terugspreken met een Text to Speech (TTS)-module. Met ElevenLabs en Twilio kun je in ongeveer 20 minuten een werkende agent op een echt telefoonnummer hebben.
Voor ontwikkelaars bestaat de volledige stack die je gebruikt uit ElevenLabs voor spraaksynthese (Flash v2.5) en transcriptie (Scribe v2 Realtime), Twilio voor telefonie en OpenAI of Anthropic als LLM. Al deze onderdelen zijn echter uitwisselbaar, dus je kunt de componenten kiezen waarmee je het meest vertrouwd bent.
In dit artikel lees je hoe je in 20 minuten een spraakagent bouwt met Node.js en Typescript. Wil je een beheerd alternatief dat beurtwisseling, onderbrekingen en telefonie afhandelt zonder dat je de cascade zelf onderhoudt? Ga dan naar ElevenAgents.
Hoe de architectuur van een spraakagent werkt
Voordat je code schrijft, is het handig te begrijpen hoe de drie services in je techstack met elkaar verbonden zijn.
- Twilio: Handelt het telefoongesprek en audiotransport af.
- ElevenLabs: Handelt STT af via Scribe v2 Realtime en TTS via Flash v2.5.
- LLM: Handelt tool calling en het schrijven van de reactie af.
Elke fase is een dunne adapter. Daardoor kun je er één vervangen door een andere service zonder de rest aan te raken. Je kunt bijvoorbeeld het OpenAI-LLM vervangen door Anthropic zonder je andere componenten te herschrijven.
Een telefoongesprek bereikt je server via Twilio. Twilio beantwoordt het PSTN-gesprek, opent een WebSocket terug naar je server en stuurt de audio van de beller door als een stream van base64-gecodeerde mu-law-frames. Je server voert de cascade uit en streamt gesynthetiseerde audio terug via diezelfde WebSocket, waarna Twilio die afspeelt voor de beller.
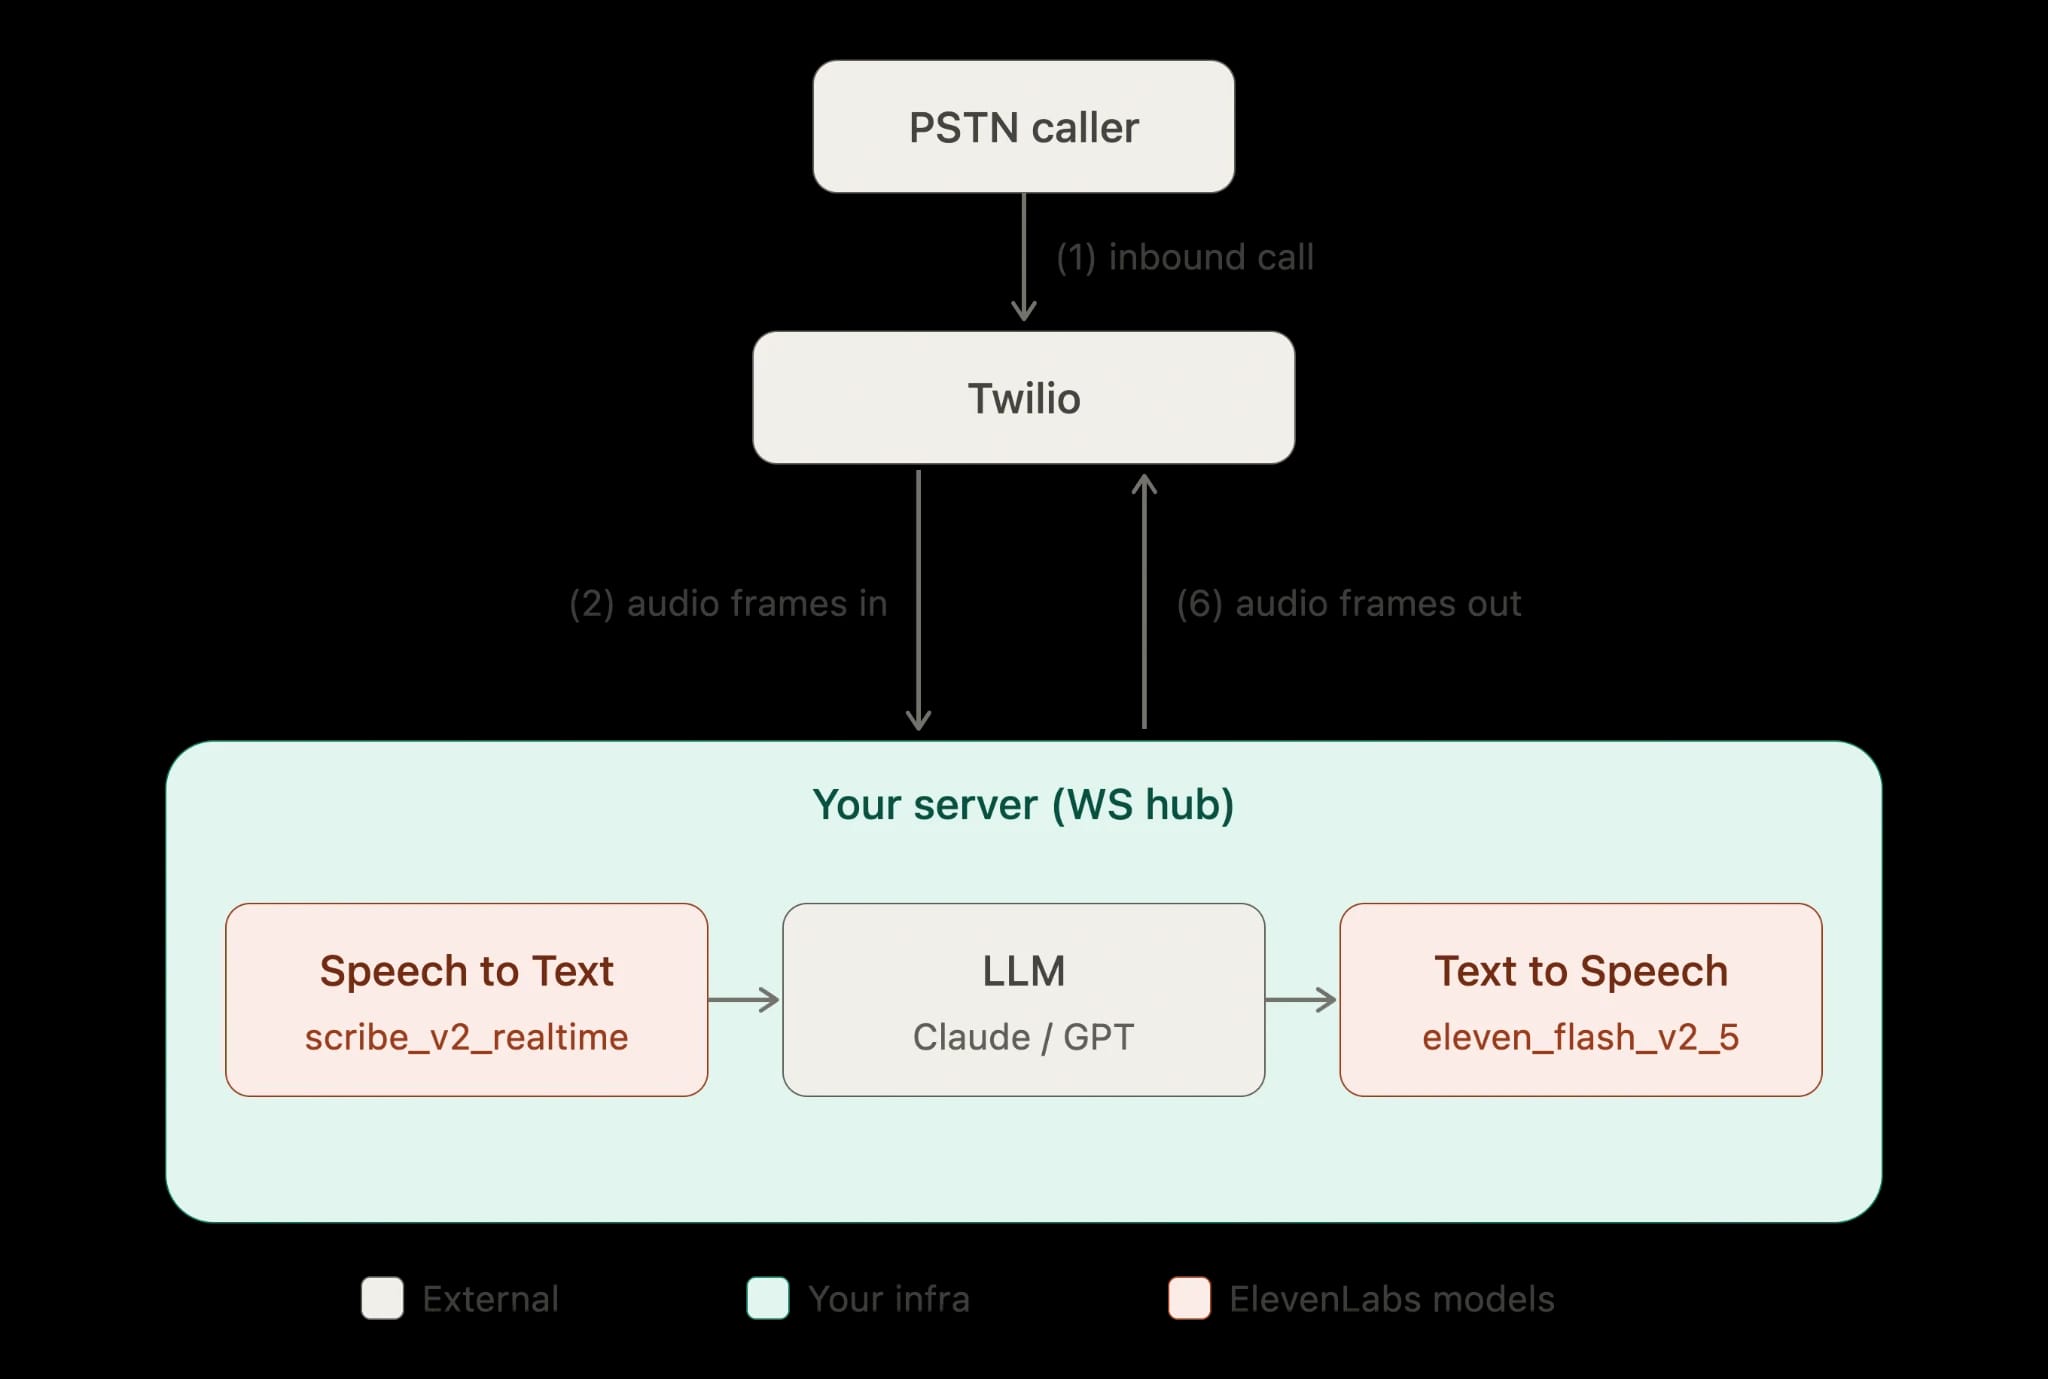
Dit is de flow waarmee je een spraakagent bouwt:
Een beller kiest je Twilio-nummer. Twilio haalt een TwiML-document op van je webhook. De TwiML vertelt Twilio een Media Stream naar je WebSocket-endpoint te openen. Twilio streamt inkomende audio als JSON-events met base64-mu-law-payloads (ulaw_8000).
Je server stuurt audiochunks door naar Scribe v2 Realtime voor streamingtranscriptie. Wanneer een beurt van de beller is afgerond, stuur je het transcript naar het LLM en synthesizeer je het antwoord met Flash v2.5 in ulaw_8000. Je stuurt de gesynthetiseerde mu-law-frames, base64-gecodeerd, via de WebSocket terug naar Twilio, dat ze voor de beller afspeelt.
Scribe v2 Realtime produceert gedeeltelijke transcripties met een latency van ongeveer 150 ms, en Flash v2.5 heeft ongeveer 75 ms modelinference nodig, exclusief netwerk- en applicatielatency. Het LLM levert de grootste en minst voorspelbare bijdrage aan time-to-first-audio en gebruikt het grootste deel van het latencybudget. Om de wachttijd kort te houden, streamen we de LLM-uitvoer token voor token en beginnen we met synthesizen voordat het model zijn zin heeft afgerond.
Zie voor de modelafwegingen achter deze keuzes het modeloverzicht en de uitleg over latency begrijpen.
Wat je nodig hebt voordat je een spraakagent gaat bouwen
In deze handleiding gaan we ervan uit dat je vier zaken hebt geregeld. Elk daarvan is snel in te stellen, maar zonder één ervan kan de server niet draaien.
Controleer of je aan deze vereisten voldoet:
- Een Twilio-telefoonnummer met Voice-functionaliteit: Noteer het nummer, samen met je Account SID en Auth Token uit de Twilio-console.
- ElevenLabs API-sleutel: maak deze in je ElevenLabs-dashboard. De sleutel wordt meegestuurd in de xi-api-key-header en is geheim, dus bewaar hem alleen server-side. Zie API-authenticatie.
- LLM API-sleutel: In deze tutorial zijn Anthropic Claude en OpenAI uitwisselbare backends, dus kies er één.
- Ngrok (of een andere tunnel) voor lokale ontwikkeling: Twilio moet je server via een openbare HTTPS- en WSS-URL kunnen bereiken; ngrok biedt dat zonder dat je iets hoeft te deployen.
Stel je geheimen in als omgevingsvariabelen en commit ze nooit.
Start vervolgens een tunnel die verwijst naar de poort die je server gebruikt:
Het Twilio Media Streams-protocol begrijpen
Twilio geeft je geen onbewerkte audiosocket. In plaats daarvan verpakt het alles in een gestructureerd JSON-protocol via WebSocket. Als je de vier eventtypen en de verzendindeling begrijpt, is de WebSocket-handler in stap 2 al volledig duidelijk voordat je hem schrijft.
Zodra Twilio verbinding maakt met je WebSocket, stuurt het een reeks JSON-tekstberichten met vier mogelijke eventtypen.
Het event connected komt als eerste binnen en bevestigt dat de WebSocket actief is. Het event start wordt één keer gestuurd wanneer de mediastream begint. Het bevat een streamSid die je moet opslaan om audio terug te sturen, plus metadata over het gesprek onder start.customParameters en start.callSid.
Het event media komt herhaaldelijk terug: media.payload is een base64-gecodeerd chunk van 8kHz mu-law-audio, 20 ms per frame, en media.track is inbound voor audio van de beller. Tot slot wordt stop gestuurd wanneer de stream eindigt, doorgaans omdat het gesprek is beëindigd.
Om audio terug af te spelen, stuur je een bericht van het type media met dezelfde streamSid en een base64-mu-law-payload. Om audio te onderbreken die je al in de wachtrij hebt geplaatst, stuur je een clear-bericht met de streamSid; dat leegt Twilio's uitgaande buffer.
De inkomende en uitgaande encoderingen zijn identiek (ulaw_8000). We vragen ulaw_8000 aan bij ElevenLabs Text to Speech en sturen de bytes rechtstreeks door naar Twilio zonder tussentijds iets te resamplen.
Stap 1: De TwiML-webhook aanbieden
Wanneer er een gesprek binnenkomt, doet Twilio een HTTP-request naar je webhook en antwoord je met TwiML dat het gesprek met je Media Stream verbindt. Het verb <Connect><Stream> opent een bidirectionele WebSocket. Gebruik hier <Connect> in plaats van <Start>: daarmee blijft het gesprek gedurende de stream actief en kun je audio terugsturen, wat het doel is van deze opzet.
De TwiML die de webhook terugstuurt, is:
In Express is dit één POST-handler die de host invult en het document terugstuurt:
Stel in de Twilio-console de webhook "A call comes in" van het nummer in op https://your-subdomain.ngrok.app/incoming-call met HTTP POST.
Stap 2: De Media Stream-WebSocket accepteren
De WebSocket-handler leest Twilio-events, stuurt de cascade aan en schrijft audio terug.
We bewaren een kleine hoeveelheid status per gesprek: de streamSid, een STT-verbinding en een vlag die aangeeft of de agent momenteel spreekt. De handler decodeert elk inkomend mediaframe uit base64 en stuurt de onbewerkte mu-law-bytes door naar STT:
Stap 3: Transcriberen met Scribe v2 Realtime
Scribe v2 Realtime accepteert streamingaudiochunks en retourneert gedeeltelijke en definitieve transcripties. Het ondersteunt mu-law-encoding rechtstreeks, dus we voeren de frames van Twilio ongewijzigd in.
Het biedt ook Voice Activity Detection voor segmentatie op basis van stilte en handmatige commitbesturing om een segment af te ronden. Voor een telefoonagent is VAD-gestuurde segmentatie doorgaans de juiste keuze, omdat een natuurlijke pauze het betrouwbaarste signaal is dat een beurt van de beller is afgelopen.
Dit zijn de stappen: open een STT-stream zodra het gesprek begint. Stuur elk inkomend mu-law-chunk door. Reageer op definitieve transcripties door het LLM aan te roepen.
De realtime STT-clientinterface is nog volop in ontwikkeling. Daarom staat de onderstaande vorm achter een kleine TypeScript-adapter (openRealtimeStt), die je implementeert voor de live API in plaats van voor een vaste set veldnamen. Beschouw onFinal als de hook die een afgeronde beurt van de beller doorgeeft aan de volgende fase.
De latency voor realtimeherkenning is ongeveer 150 ms voor gedeeltelijke resultaten. Daardoor blijft de ervaren pauze tussen het einde van de beller en de start van de agent kort. Zie voor de batchvariant en de volledige functionaliteit de Speech to Text-documentatie en de productpagina voor realtime Speech to Text.
Stap 4: Een antwoord genereren met een LLM
In deze fase wordt het antwoord geproduceerd. Het LLM ontvangt de gespreksgeschiedenis en retourneert de tekst van de assistent. Stream het antwoord, zodat je al bij de eerste zin met synthesizen kunt beginnen.
Hier wordt OpenAI als backend gebruikt:
De model-ID hierboven, gpt-4.1-mini, is een voorbeeld van een keuze met lage latency; claude-haiku-4-5 is een vergelijkbare optie van Anthropic. Beide providers kunnen hetzelfde llmReply-contract ondersteunen: vervang de body van de functie en de rest van de agent blijft ongewijzigd.
De system prompt beperkt de antwoordlengte, wat belangrijk is aan de telefoon: lange antwoorden voelen traag en zijn lastig op een natuurlijke manier te onderbreken.
Stap 5: Synthetiseren met Flash TTS in ulaw_8000
De tekst moet nu audio worden die Twilio kan afspelen. Vraag Flash v2.5 aan met outputFormat: "ulaw_8000", zodat de bytes overeenkomen met de encoding die Twilio verwacht. Stream vervolgens de audio en stuur elk chunk als media-event terug via de WebSocket.
Verzamel LLM-tokens in fragmenten ter grootte van een zin en synthesizeer elk fragment zodra het klaar is, in plaats van op het volledige antwoord te wachten. Dat verkort time-to-first-audio, omdat de beller de eerste zin hoort terwijl het model nog de tweede produceert. Voor meer controle over incrementele synthese laat de realtime TTS WebSocket-handleiding zien hoe je tekst naar één open synthesizesocket voert; de onderstaande HTTP-streamingaanpak is eenvoudiger en geschikt voor korte gespreksbeurten.
Je AI-spraakagent robuust maken voor productie
Na de vijf bovenstaande stappen heb je een werkende agent. Dat is niet hetzelfde als een productiedeployment.
Voordat je de agent op een echte telefoonlijn zet, moet je rekening houden met verschillende aandachtspunten.
Twilio-webhookhandtekeningen valideren
Iedereen die je webhook-URL kent, kan er een POST-request naartoe sturen. De eerste taak is dus bevestigen dat het request daadwerkelijk van Twilio afkomstig is. Twilio ondertekent elk request met je Auth Token in de header X-Twilio-Signature en je wijst alles af wat niet door de validatie komt. De handtekening wordt berekend op basis van de volledige URL en de POST-parameters, dus je moet hem op dezelfde manier berekenen als Twilio.
De helper van Twilio doet dat voor je:
Geheimen goed beheren
Bewaar ELEVENLABS_API_KEY, de LLM-sleutel en TWILIO_AUTH_TOKEN in een secrets manager, niet in de broncode en niet in plaintext-envbestanden die je naar een repo commit. Beperk de ElevenLabs-sleutel tot alleen de endpoints die deze service nodig heeft en geef hem een kredietquotum, zodat een lek een beperkte impact heeft in plaats van onbeperkt.
Enterprise-abonnementen kunnen een sleutel daarnaast met IP-whitelisting beperken tot specifieke IP-bereiken. Deze server gebruikt de API-sleutel rechtstreeks, omdat die je backend nooit verlaat. Verplaatste je audiologica naar een browser of mobiele client, dan zou je overschakelen op tokens voor eenmalig gebruik, zodat de sleutel nooit client-side wordt blootgesteld.
De concurrencylimiet begrijpen
Elk abonnement heeft een concurrencylimiet die per modelfamilie verschilt. Deze limiet telt hoeveel requests tegelijkertijd actief audio genereren.
Voor een telefoonagent werkt die berekening in je voordeel. Audiogeneratie is sneller dan afspelen, dus elk gesprek gebruikt alleen TTS-concurrency tijdens de korte momenten waarop een antwoord wordt gesynthetiseerd, niet gedurende de volledige duur van het gesprek. Als grove vuistregel kan een concurrencylimiet van ongeveer vijf zo'n 100 gelijktijdige gesprekssessies ondersteunen, omdat de generatie ruim vóór het afspelen klaar is.
Houd toch de beschikbare marge in de gaten in plaats van te gokken. ElevenLabs-responses bevatten de headers current-concurrent-requests en maximum-concurrent-requests; log ze en stuur een waarschuwing zodra je het maximum nadert. Overschrijd je de limiet, dan komen requests op prioriteit in de wachtrij, wat doorgaans ongeveer 50 ms toevoegt. Bij aanhoudende overbelasting krijg je HTTP 429 terug.
Verwerk HTTP 429-responses met een korte backoff. Als ze aanhouden, verhoog je de limieten door te upgraden op de prijspagina of, voor Enterprise-klanten, via je accountmanager.
Barge-in en onderbrekingen afhandelen
Een beller die begint te praten terwijl de agent spreekt, verwacht dat de agent stopt. Dit heet barge-in, en correcte afhandeling ervan is een belangrijk onderdeel van wat een agent natuurlijk laat aanvoelen in plaats van gescript.
Detecteer spraak van de beller tijdens het afspelen door de agent met het STT-VAD-signaal. Wanneer je dit detecteert, doe je twee dingen. Stop eerst met het doorsturen van TTS-chunks; de vlag agentSpeaking in speak doet dat al door de loop te onderbreken. Stuur vervolgens Twilio een clear-bericht om de audio te verwijderen die je daar al in de wachtrij hebt gezet.
Sla je clear over, dan blijft Twilio gebufferde audio afspelen nadat je bent gestopt met verzenden. Daardoor lijkt het alsof de agent door de beller heen praat.
Loggen, monitoren en fouten netjes afhandelen
Voorzie elke fase van instrumentatie, zodat je latency kunt toeschrijven wanneer een gesprek traag aanvoelt. Meet de tijd van het definitieve transcript tot het eerste LLM-token, van het eerste LLM-token tot de eerste TTS-byte en van de eerste TTS-byte tot het frame dat naar Twilio wordt gestuurd. Je zult zien dat het grootste deel van de variabele latency in de LLM-fase zit; de STT- en TTS-fasen zijn relatief stabiel.
Plan vervolgens voor gedeeltelijke fouten. Het LLM kan een timeout krijgen, de STT-stream kan wegvallen en de netwerk-roundtrip naar ElevenLabs varieert op het openbare internet afhankelijk van de locatie van ongeveer 20 tot 200 ms. Plaats je server dicht bij je bellers, niet alleen bij ElevenLabs, want ElevenLabs routeert al naar het dichtstbijzijnde cluster in Noord-Amerika, Europa of Zuidoost-Azië.
Laat de beller niet in stilte wanneer een fase faalt: synthesizeer een korte fallbackzin ("Sorry, kun je dat nog een keer zeggen?") en houd het gesprek actief. Wikkel elke fase in een timeout en een try/catch, zodat één mislukte beurt niet de hele WebSocket beëindigt.
Het is de moeite waard om vóór je live gaat nog een paar standaardinstellingen te configureren:
- Beperk de antwoordlengte in de system prompt, zoals getoond, zodat beurten kort blijven en kunnen worden onderbroken.
- Beperk de gespreksgeschiedenis, zodat lange gesprekken de LLM-context niet onbeperkt laten groeien.
- Stel een maximale gespreksduur in als vangnet tegen vastgelopen sessies die ongemerkt concurrency verbruiken.
Om de onderdelen die je beheert verder te blijven afstemmen, legt het latencydocument uit waar time-to-first-audio vandaan komt, behandelt het modeloverzicht de afwegingen tussen snelheid en kwaliteit, en laat de realtime TTS WebSocket-handleiding zien hoe je de syntheselatency met incrementele tekstinvoer verder verlaagt.
Productierijpe spraakagenten bouwen met ElevenAPI
Nu de 20 minuten voorbij zijn, heb je elke laag van een productieklare spraakagent. Twilio handelt telefonie af, Scribe v2 Realtime transcribeert, een LLM genereert antwoorden en Flash v2.5 spreekt terug via dezelfde WebSocket.
Wil je de cascade liever niet zelf onderhouden, dan biedt ElevenAgents beurtwisseling, afhandeling van onderbrekingen en telefonie-integratie als beheerde service, gebouwd op dezelfde modellen die je net handmatig hebt gekoppeld.
Wil je een stack die je zelf beheert verder afstemmen? Bekijk dan de productpagina van ElevenAPI voor abonnementen, concurrencylimieten en de Voice Library. Je kunt ook registreren en vandaag nog aan de slag gaan met je eerste gesprek.
Veelgestelde vragen over een spraakagent bouwen met Twilio en ElevenLabs

Tadas Petra is Developer Relations Engineer en helpt ontwikkelaars bouwen met de productreeks van ElevenLabs. Hij is ook de oprichter van Hungrimind, een onderwijsplatform voor ontwikkelaars. Eerder was hij Lead Developer Advocate bij Agora en docent bij Zero To Mastery.




