Conception de l’IA conversationnelle : comment créer des expériences utilisateur plus humaines
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
La conception d’IA conversationnelle consistait autrefois à construire un arbre de décision. Les premiers chatbots et menus SVI reposaient sur des branches rigides et préprogrammées : appuyez sur 1 pour la facturation, dites « oui » ou « non », et espérez que la question du client corresponde à l’un des parcours prévus. Ce modèle ne fonctionnait que tant que la conversation restait dans le cadre déjà construit.
Les agents IA ont levé cette contrainte. Ils peuvent désormais raisonner sur une conversation en temps réel, s’appuyer sur une base de connaissances, appeler des outils et mémoriser ce qui a déjà été dit. Ils ne sont donc plus limités à un script fixe.
Ce changement n’a toutefois pas supprimé le besoin de conception d’IA conversationnelle. Il a au contraire relevé les exigences. Sans script rigide sur lequel s’appuyer, la personnalité, le workflow et les points de décision d’un agent doivent être suffisamment bien définis pour fonctionner dans une conversation ouverte et en temps réel, plutôt que prédéterminée.
Ce guide explique concrètement ce que signifie la conception d’IA conversationnelle pour le chat et les agents vocaux, pourquoi elle est importante pour les indicateurs sur lesquels vous êtes déjà évalué, et les éléments à optimiser pour une expérience plus naturelle. Maîtrisez-les pour déployer des agents IA qui créent un lien avec les clients et offrent un service plus rapide et plus efficace.
En résumé
- La conception d’IA conversationnelle désigne la manière dont la communication d’un agent IA est structurée et optimisée pour qu’une conversation paraisse naturelle.
- L’IA vocale est moins tolérante que le texte : les problèmes de voix, de latence et de timing qui passent inaperçus dans une interface de chat peuvent donner une impression robotique à une conversation vocale.
- ElevenAgents permet de créer des agents IA vocaux et conversationnels plus humains grâce à des fonctionnalités qui vous donnent le contrôle de la voix, de la personnalité et du flux conversationnel, tout en optimisant la latence sur chaque canal.
Qu’est-ce que la conception d’IA conversationnelle ?
La conception d’IA conversationnelle est une pratique UX qui consiste à configurer le comportement d’un agent IA. Elle couvre sa personnalité, les garde-fous, les workflows et les bases de connaissances sur lesquels il s’appuie, afin que la conversation soit aussi aboutie que toute autre composante de l’expérience produit.
Cette configuration n’est toutefois pas identique partout. Les agents peuvent fonctionner sur plusieurs canaux, comme le chat, la voix ou les SMS, à partir d’une seule configuration. Chaque canal a ses propres contraintes, mais elles sont les plus fortes pour la voix. Lorsque la voix fait partie des canaux d’un agent, il doit choisir et délivrer une voix, gérer le rythme et les tours de parole en temps réel, puis répondre avant qu’un silence ne donne l’impression que l’appel a été coupé. Rien de cela n’est facultatif comme cela peut l’être en chat, où une réponse légèrement lente ou imparfaite interrompt rarement l’échange.
Voici les points à prendre en compte lors de la mise en œuvre d’une conception d’IA conversationnelle pour un agent de chat, et ce que la voix ajoute à ces exigences.
Les clients n’évaluent pas consciemment chacun de ces facteurs. Ils remarquent simplement lorsqu’un élément semble décalé, et ce ressenti suffit à éroder leur confiance dans l’agent dans son ensemble, compromettant les objectifs pour lesquels vous l’avez déployé.
Pourquoi la conception d’IA conversationnelle est essentielle à une bonne expérience utilisateur
Tous les facteurs décrits ci-dessus, de la gestion des tours de parole à la latence et à la personnalité, influencent la perception de votre marque par le client à un moment clé, qui peut en faire un ambassadeur ou un détracteur. Cette perception se reflète directement dans les indicateurs sur lesquels les équipes sont évaluées.
- Hausse de la satisfaction et du taux de résolution : Les clients évaluent plus favorablement une interaction lorsque l’agent répond rapidement et ne les interrompt pas maladroitement.
- Réduction de l’abandon : Les clients quittent une conversation pour bien plus que de longs délais d’attente. Une formulation qui ne répond pas à leurs attentes, qu’il s’agisse d’un silence gênant lors d’un appel ou d’une réponse rigide et peu conforme à la marque dans le chat, peut déclencher le même réflexe de mettre fin à l’échange.
- Résolution plus rapide : Des paramètres de flux conversationnel clairs et des workflows bien cartographiés entraînent moins d’impasses, de questions répétées et de moments du type « je vais vous transférer ».
- Moins d’escalades vers des agents humains : Lorsqu’un agent gère naturellement le flux conversationnel et suit un workflow défini, il résout davantage de demandes dès la première tentative, au lieu de dérouter le client et de l’amener à demander une personne.
Prenons l’exemple d’eDreams ODIGEO, l’une des plus grandes plateformes de voyage en ligne au monde. L’entreprise a déployé des agents IA avec ElevenAgents dans cinq langues principales et a constaté une amélioration à deux chiffres de la vitesse de résolution, ainsi qu’une réduction à deux chiffres des taux de transfert d’appels, notamment grâce à une synthèse vocale à faible latence et à une reconnaissance des intentions plus précise au début de chaque appel. Ces résultats dépendent de nombreuses variables au-delà de la seule conception conversationnelle, mais ils illustrent ce que permet une bonne conception d’IA conversationnelle.
Comment fonctionne la conception d’IA conversationnelle dans ElevenAgents
Dans ElevenAgents, vous pouvez optimiser la personnalité, la voix, les tours de parole, les transferts et la latence, autant de facteurs qui déterminent si un agent paraît humain. Voici comment configurer et optimiser chacun d’eux pour que votre agent tienne son rôle dans une conversation réelle.
Personnalité et sélection de la voix
La personnalité façonne la première impression du client, et un décalage érode la confiance avant même que la conversation ne commence. Une personnalité trop rigide pour une marque de vente au détail conviviale amène les clients à douter de l’agent avant qu’il ait dit quoi que ce soit d’utile. Commencez à la définir dans le prompt système, où vous définissez le rôle, la personnalité et les garde-fous de l’agent avant toute autre chose.
Pour les agents vocaux, cette personnalité doit également transparaître dans la voix. Une voix trop décontractée pour un appel financier envoie le même signal qu’une personnalité inadaptée dans un échange écrit : la sélection de la voix fait donc partie de la même tâche. Voici par où commencer :
- Sélection de la voix : Adaptez la voix à votre marque, votre audience et votre sujet. L’accent, le genre et le ton contribuent tous à établir la confiance avec un interlocuteur donné et à définir le ton de la conversation.
- Prise en charge multilingue : Sélectionnez une voix pour chaque langue prise en charge, plutôt que d’utiliser une voix unique sur tous les marchés. Une même voix utilisée de force dans plusieurs langues paraîtra souvent étrangère dans au moins l’une d’elles, ce qui nuit à la confiance que vous cherchez à instaurer.
ElevenAgents vous donne accès à plus de 11 000 voix dans la Voice Library, où vous pouvez effectuer des recherches par accent, personnage et cas d’usage : vous partez donc rarement de zéro. Si aucune ne convient, deux autres options s’offrent à vous : cloner une voix existante à partir d’un court échantillon audio ou en créer une de toutes pièces à l’aide d’un prompt textuel décrivant l’âge, l’accent, le ton et le rythme souhaités.
Paramètres du flux conversationnel
C’est dans la voix que la conversation obéit au rythme le plus strict. Contrairement au chat, où une pause n’est qu’un espace vide, une rupture de rythme au téléphone est immédiatement perçue comme un silence ou une connexion coupée. Trouver le bon rythme est le principal levier pour qu’un agent vocal paraisse être un participant naturel à la conversation, et cela commence par le modèle de gestion des tours de parole.
Le modèle de gestion des tours de parole d’ElevenLabs est un système fondé sur la recherche, conçu pour détecter qu’un interlocuteur a réellement fini de parler plutôt qu’il ne fait simplement une pause. Il peut ainsi déterminer quand un agent doit répondre, au lieu de se baser sur un délai fixe.
Vous pouvez également ajuster les paramètres suivants pour optimiser le flux conversationnel :
- Délai d’expiration du tour : Durée pendant laquelle l’agent attend en silence avant de répondre, afin de ne pas intervenir pendant que le client réfléchit encore ni le laisser sans réponse une fois qu’il a terminé.
- Délai d’expiration souple : Brève phrase de remplissage utilisée par l’agent pour couvrir un délai de traitement, par exemple « Un instant » ou « Je regarde », afin que le client ne pense pas que l’appel a été coupé. Évitez les formulations qui promettent une durée précise, comme « une seconde », car le temps de réponse réel varie.
- Interruptions : Indique si l’agent cesse de parler lorsque le client commence à parler par-dessus lui. Activez cette option pour un échange naturel. Désactivez-la lorsqu’il est essentiel de délivrer l’intégralité du message, notamment pour les mentions légales, les consignes de sécurité et tout contenu qui doit être entendu en entier.
- Réactivité du tour de parole : Vitesse à laquelle l’agent intervient dès que le client cesse de parler. Le mode « Réactif » convient au service client, où la rapidité de réponse prime. Le mode « Patient » est préférable pour recueillir des informations, comme un numéro de téléphone ou une adresse email, afin que l’agent ne coupe pas le client au milieu d’un chiffre. Le mode « Normal » constitue un bon réglage par défaut pour une conversation générale.
De petits ajustements peuvent avoir un effet considérable. Même une légère modification du délai peut faire la différence entre un agent attentif et un agent qui donne l’impression de couper la parole.
Workflow, conception des transferts et scripting
Les workflows sont le lieu où une grande partie de la conception d’IA conversationnelle prend forme dans ElevenAgents. Ils définissent ce qui se passe et à quel moment : points de décision, parcours d’escalade, transferts, tout ce qui serait autrement laissé à l’improvisation de l’agent.
Les workflows fonctionnent avec deux autres systèmes pour affiner votre agent. Le prompt système définit le comportement fondamental de l’agent, notamment son rôle, son ton et ce qu’il dira ou non, à des étapes clés telles que les salutations ou les transferts. Les procédures constituent une option plus prescriptive pour une tâche unique et clairement définie, comme vérifier l’identité d’un client ou l’accompagner dans un retour. Au lieu d’emprunter différentes branches selon les propos du client, elles suivent une séquence fixe, du début à la fin, étape par étape, quelle que soit l’évolution de la conversation.
La manière la plus simple de commencer à créer votre agent est d’utiliser des modèles d’agents prédéfinis, qui fournissent une base pour les workflows comme pour les prompts système, afin que vous puissiez affiner l’agent plutôt que le créer de zéro. Voici quelques modifications initiales pour les adapter à vos besoins :
- Cartographie des décisions : Définissez précisément ce que fait l’agent à chaque point de décision, afin que toute la conversation soit structurée, de l’ouverture à la résolution. Les nœuds de sous-agents vous permettent d’ajuster le prompt système, le modèle ou même la voix à certains endroits du flux, afin qu’une étape de vérification sensible s’exécute sous des garde-fous plus stricts qu’une conversation informelle au début de l’appel.
- Déclencheurs d’escalade : Définissez des déclencheurs clairs pour transférer l’échange à une personne, intégrés au workflow plutôt que laissés à la décision de l’agent sur le moment. Par exemple, déclenchez l’escalade lorsqu’un problème reste non résolu après deux tentatives, lorsque le client demande un responsable, ou lorsque la transaction est suffisamment sensible ou importante pour nécessiter une intervention humaine.
- Contexte du transfert : Dans le prompt système, définissez les informations que l’agent doit recueillir avant le transfert, comme un identifiant de commande ou un numéro de compte, ainsi que les conditions qui le déclenchent. Associez ensuite ces informations enregistrées à la configuration de l’outil de transfert, afin qu’elles soient transmises automatiquement, sans que le client doive se répéter auprès d’un conseiller humain.
- Formulations scriptées : Définissez des formulations exactes pour les moments critiques dans le prompt système. Les salutations d’ouverture, les messages d’erreur, les mentions légales et les transferts d’escalade ne doivent jamais être laissés à l’improvisation de l’agent. Une phrase précise comme « Je rencontre actuellement des difficultés pour accéder à ces informations » est plus fiable que de laisser l’agent deviner comment la formuler lorsqu’un problème survient.
Le workflow est conçu sous la forme d’un graphe visuel dans ElevenAgents, où chaque point de décision et déclencheur d’escalade est représenté par un nœud que vous visualisez et modifiez directement.
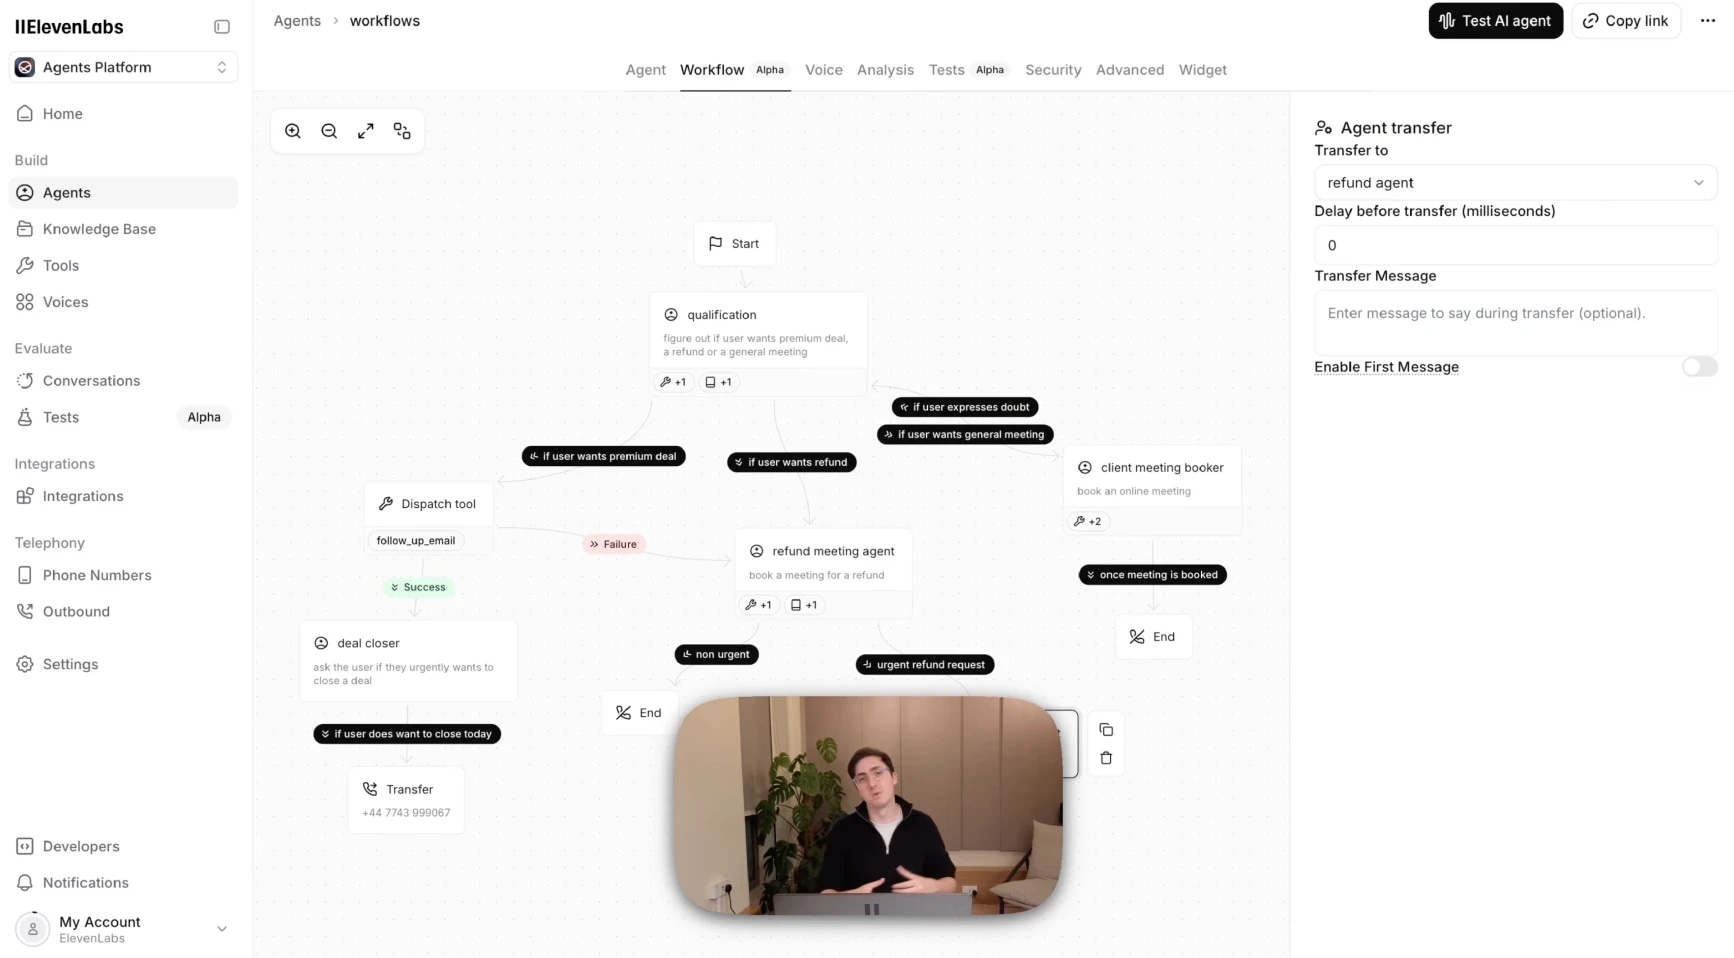
Une fois l’agent en production, les analyses superposent les données de conversation réelles sur ce même graphe : vous voyez précisément où les clients bloquent ou abandonnent, et vous pouvez corriger le problème sans tâtonner.
Latence et performances
La latence est l’un des principaux facteurs qui déterminent si une interaction paraît humaine ou non. Une réponse lente est l’un des moyens les plus rapides de rappeler au client qu’il parle à une machine, même si tout le reste de la conversation se passe bien.
Chaque composante du pipeline ajoute sa propre latence, que l’agent fonctionne par chat ou par voix. Certaines s’appliquent dans les deux cas. D’autres ne s’appliquent que lorsque la voix entre en jeu.
- LLM : Chaque choix de modèle implique un compromis entre coût, qualité de raisonnement et vitesse, et le bon équilibre dépend de la conversation. Les interactions simples et fréquentes, telles que les FAQ ou les confirmations de rendez-vous, peuvent utiliser un modèle plus rapide et plus léger sans dégrader l’expérience. Pour les tâches plus complexes, comme le conseil financier ou le dépannage en plusieurs étapes, il vaut généralement la peine d’opter pour un modèle au raisonnement plus puissant, même s’il répond un peu moins vite.
- Base de connaissances et RAG : Chaque recherche dans une base de connaissances ajoute un aller-retour avant que l’agent puisse répondre. Une base de connaissances concise et ciblée répond donc plus vite qu’une base que l’agent doit parcourir largement.
- Intégrations et appels d’outils : Chaque appel à un outil externe, comme la recherche d’une commande dans Salesforce ou la vérification de disponibilités dans un calendrier, ajoute son propre aller-retour. Rédigez des descriptions d’outils claires pour que l’agent n’hésite pas sur celui à appeler, et n’appelez que les outils réellement nécessaires à la conversation.
- Géographie et hébergement des données : Alignez la région de votre agent ElevenAgents sur celle où vos données sont hébergées et, pour les déploiements téléphoniques, sur celle de votre fournisseur de téléphonie, qu’il s’agisse de Twilio, SIP ou d’un autre service. Si la région de votre agent et celle de votre passerelle d’appel se trouvent aux extrémités opposées du monde, cet écart ajoute de la latence avant même le début de la conversation.
- Speech to Text (voix uniquement) : Scribe transcrit les propos du client avant que l’agent puisse les analyser. Utilisez la version en temps réel (Scribe v2 Realtime) pour les conversations en direct plutôt que la version par lots, conçue pour privilégier la précision à la vitesse.
- Gestion des tours de parole (voix uniquement) : Détermine à quel moment l’agent décide de répondre, comme expliqué en détail plus haut. Il est utile de le considérer comme un facteur de latence à part entière : un modèle qui hésite à détecter la fin d’un tour ajoute un délai avant même que le reste du pipeline ne démarre.
- Text to Speech et sélection de la voix (voix uniquement) : Les voix par défaut et synthétiques, ainsi que les Instant Voice Clones, répondent plus rapidement que les Professional Voice Clones. Utilisez les Professional Voice Clones uniquement lorsque leur fidélité supérieure justifie le compromis en matière de latence.
Pour approfondir le sujet de la latence, consultez les bonnes pratiques d’optimisation de la latence et découvrez comment la latence est mesurée et rapportée sur l’ensemble du pipeline.
Concevez votre premier agent avec ElevenAgents
Les leviers présentés ici illustrent concrètement ce que signifie la conception d’IA conversationnelle pour un agent IA. Tous sont intégrés nativement à ElevenAgents et configurables depuis une console sans code : vous pouvez ainsi créer un agent qui mène une véritable conversation, au lieu de simplement répondre correctement aux questions.
Pour les équipes souhaitant bénéficier d’un accompagnement concret, les Forward Deployed Engineers d’ElevenLabs travaillent directement avec votre équipe pour cadrer, créer et lancer un agent prêt pour la production, puis continuent d’optimiser ses performances une fois qu’il est en ligne.
Que vous le créiez vous-même ou fassiez appel à un accompagnement, le plus rapide pour constater la différence est de l’essayer. Commencez dès aujourd’hui en créant un agent ou en réservant une démo.
FAQ sur la conception d’IA conversationnelle

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.