SSMLタグを解説:テキスト読み上げの間、発音、ペースを調整する方法
- 公開日
音声合成マークアップ言語(SSML)は、テキストをタグで囲み、テキスト読み上げモデルに、間を置く場所、単語の発音方法、強調するフレーズを指示するXMLベースのマークアップ言語です。
この制御レイヤーは、すでに耳にしている多くのAI音声の背後にあります。確認番号を読み上げる自動音声応答(IVR)システムも、章の終わりで間を置くAIオーディオブックのナレーターも、何らかの形でこれを利用しています。AI生成音声をカスタマイズしたことがあれば、SSMLを目にしたことがあるでしょう。
SSMLは20年以上にわたりTTS技術の一部であり、多くのプロバイダーがTTSを提供するうえで今も重要な役割を果たしています。このガイドでは、SSMLとは何か、ElevenLabsのモデル群のどこで利用できるのかを解説します。さらに、Eleven v3とAudio Tagsシステム、そしてEleven v4が採用する、より自然なテキスト読み上げを実現するための進化した仕組みもご紹介します。
Audio TagsでEleven v4の実力を体験
Eleven v4を見る概要
- SSMLは、W3Cに基づくマークアップ言語で、合成音声の間、強調、発音、ペースを制御するために使われます。
- Eleven v3とEleven v4を除くElevenLabsモデルは、最大3秒の間を挿入するSSMLの<break>タグに対応しています。
- Eleven Flash v2とEleven Turbo v2は、英語の発音をカスタマイズする<音素>タグに対応しています。
- Eleven v3とEleven v4はSSMLにまったく対応していません。代わりに、オーディオタグを使用し、[whispering]や[sighs]のような角括弧付きの自然言語指示で、合成音声の流れを制御します。
- WebSocket APIでは、enable_ssml_parsingパラメータでSSML解析を制御し、遅延を増やさないようSSMLタグを完全なメッセージとして送信します。
- <prosody>、<say-as>、<sub>、<lang>、<voice>、<audio>などのタグはElevenLabsモデルではサポートされていませんが、それぞれに代替手段があります。音声設定、テキスト正規化、発音辞書、多言語モデル、別々の音声、そしてサウンドエフェクトです。
SSMLとは?
SSMLは、合成エンジンがテキストをどのように話すべきかを指示として記述できるマークアップ言語です。World Wide Web Consortium(W3C)が、プレーンテキストのテキスト読み上げモデルを拡張する標準として開発しました。SSMLは、プレーンテキストの解釈モデルに頼るのではなく、文章をどのように発音すべきかを明示的かつ機械可読な形で指示します。
SSMLは、特定のプロバイダーだけに閉じた独自のマークアップではありません。Amazon PollyとMicrosoft Azure Speechはどちらも、<break>や<emphasis>などのSSMLタグを主要な制御機構として使用しています。ほとんどのクラウドテキスト読み上げプラットフォームは、この標準の何らかのバージョンを受け入れています。SSMLは、生成音声モデルが登場するはるか前から、音声に注釈を付ける標準的な方法でした。
SSMLは基本的な標準であり続ける一方、最新の生成音声技術とともに、より新しいモデル固有の制御機能も発展しています。SSMLの背景にあるこのベンダー中立の仕様により、プロバイダーは共通のコアタグを実装できます。その上に各プロバイダー独自の拡張や制限を重ねることができます。
イントネーションを改善する代表的なSSMLタグとその機能
SSML実装には、合成音声を制御したい多くの人が探す基本的なタグセットがあります。
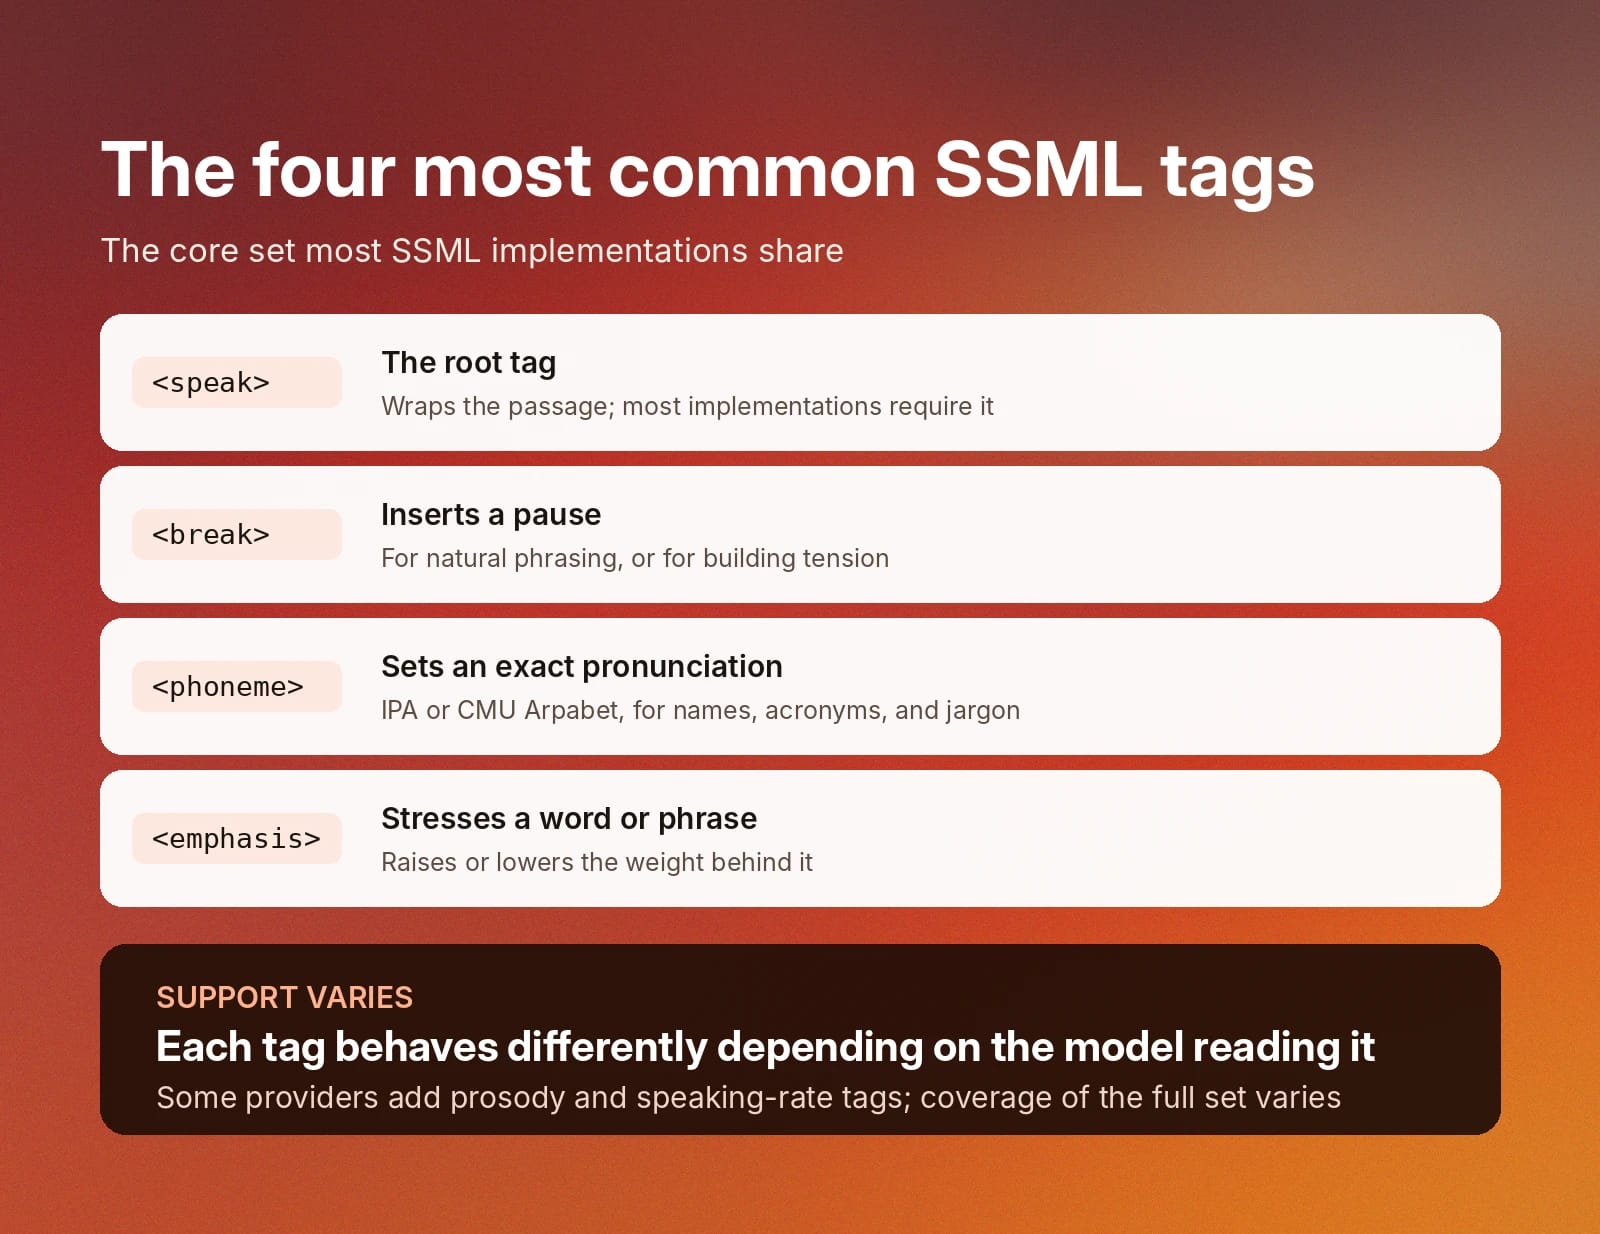
代表的なSSMLタグは次のとおりです。
- <speak>:文章全体を囲むルートタグです。ほとんどの実装では、囲まれた内容をSSMLとして認識するために必要です。
- <break>:指定した時間の間を挿入します。節や文の間に自然な間を作るときや、文章に緊張感を持たせるときに役立ちます。
- <phoneme>:IPAやCMU Arpabetなどの音声記号を使って単語の正確な発音を指定します。頭字語、名前、専門用語に便利です。
- <emphasis>:単語やフレーズを強調し、話者が自然に意味の重みを強めたり弱めたりする表現を再現します。
これら4つのタグは、読み上げるTTSモデルによって動作が異なります。一部のプロバイダーは、プロソディや話速のための追加タグに対応しています。どちらもSSML対応をうたっていても、完全なタグセットへの対応範囲は異なるため、あるTTSプロバイダー向けに書いたスクリプトが別のプロバイダーでも同じように動作するとは限りません。
最も大きく異なるのは、各テキスト読み上げモデルが実際に処理するタグです。ここでElevenLabsの実装固有の違いが生まれます。
ElevenLabsでSSMLを使用する
ElevenLabsのSSML対応は完全に一律ではありません。オーディオ生成に選択するモデルによって異なります。<break>タグは最も幅広くサポートされる要素で、<phoneme>はより限定されたモデルで利用できます。
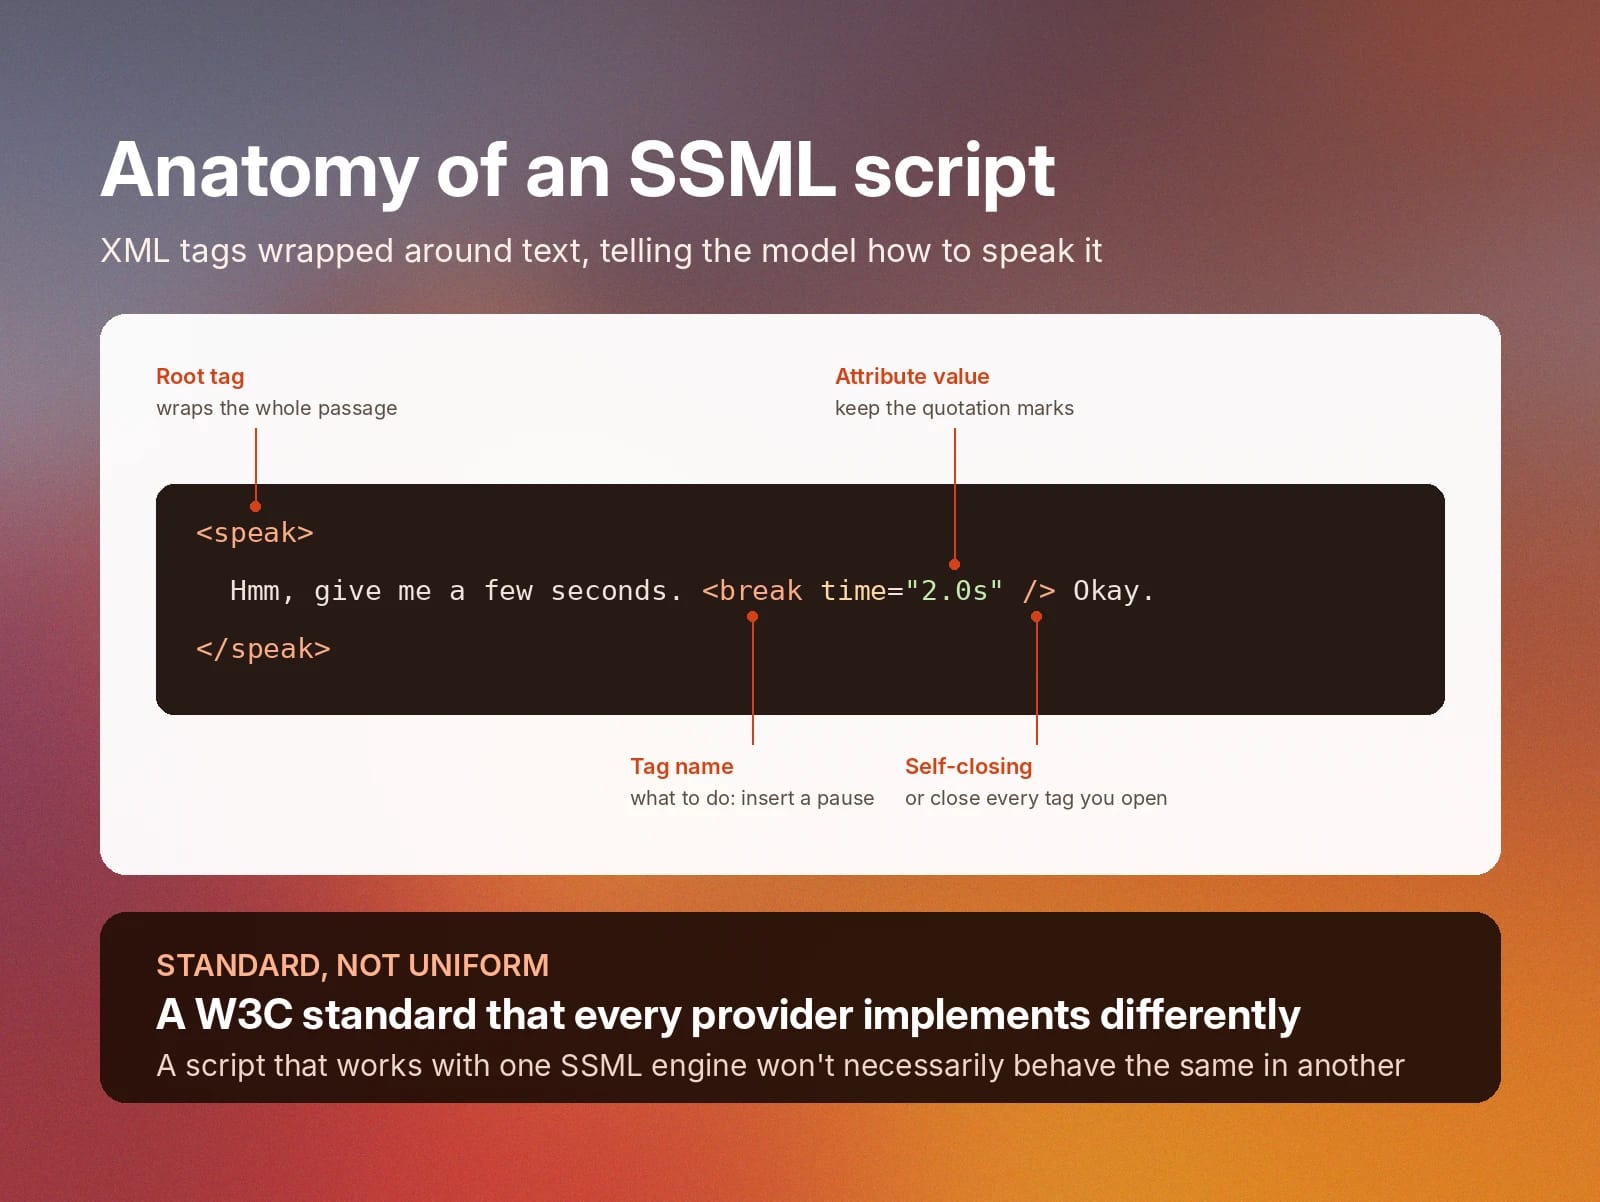
たとえばMultilingual v2のような旧世代のElevenLabs TTSモデルは、最大3秒の間を挿入する<break>タグに対応しています。たとえば、AIエージェントは「少し待って、考えさせて」と言った後、<break time="2.0s" />を使って聞き取れる間を作り、「わかりました、お手伝いできます」と続けられます。より自然な会話スタイルを再現できるため、多くのワークフローで最もよく使われるタグです。
SSMLタグを使う場合は、一度に使う数を少なくするのが最適です。1つの文や段落で多用すると、モデルが予期せず速度を変えたり、さまざまなオーディオアーティファクトが発生したりすることがあります。また、音声ごとに間の処理も異なります。特に「えー」や「あの」などのフィラーフレーズを含むサンプルで学習した音声ではその傾向が見られます。
ElevenLabsにおけるSSMLの実践
ElevenLabsのFlash v2およびTurbo v2モデルはさらに一歩進み、英語に限り、発音をカスタマイズする<phoneme>タグにも対応しています。このためphonemeタグは、名前、頭字語、専門用語、その他のビジネス関連用語の発音をモデルが誤る場合の修正に役立ちます。ただし、スクリプトをこの2つのモデルのいずれかで実行する必要があります。
一方、Eleven v3とEleven v4はこのパターンとは完全に異なります。発話の表現を制御するためにAudio Tagsを使用します。さらにEleven v4では、スラッシュで囲んだIPA記号をテキスト内で直接読み上げられる、ネイティブのインラインIPAサポートが導入されています。以下で、breakタグや発話制御の代替手段を説明します。
発音辞書やテキスト正規化を含む、ElevenLabsのテキスト読み上げ制御機能の詳細については、ベストプラクティスガイドをご覧ください。
ElevenLabsでのSSMLコード例
以下の例では、スクリプト内およびAPI呼び出しでのSSMLを紹介します。<break>はEleven v4とEleven v3を除くすべてのモデルで使用でき、<phoneme>はFlash v2とTurbo v2でのみ使用できます(英語のみ)。
SSMLで音声制御を実装して間を追加する
テキストとタグを<speak>ブロックで囲み、属性値を囲む引用符はそのまま残します。
間とElevenAPIでのSSML phonemeタグの詳細をご確認ください。
<phoneme>で発音を修正する
IPAまたはCMU Arpabetを使い、単語の聞こえ方を正確に指定します。ここでは、「Siobhan」という名前をIPAで指定し、「Madison」はCMU Arpabetで表記しています。
PythonでSSMLを使って音声を生成する
この呼び出しでは、breakタグを含むスクリプトを、対応するモデルに送信します。
JavaScriptでSSMLを使って音声を生成する
以下は、SSMLで音声を生成する同様の例をJavaScriptで記述したものです。
SSMLとWebSocket API:TTS APIでSSMLを使用する
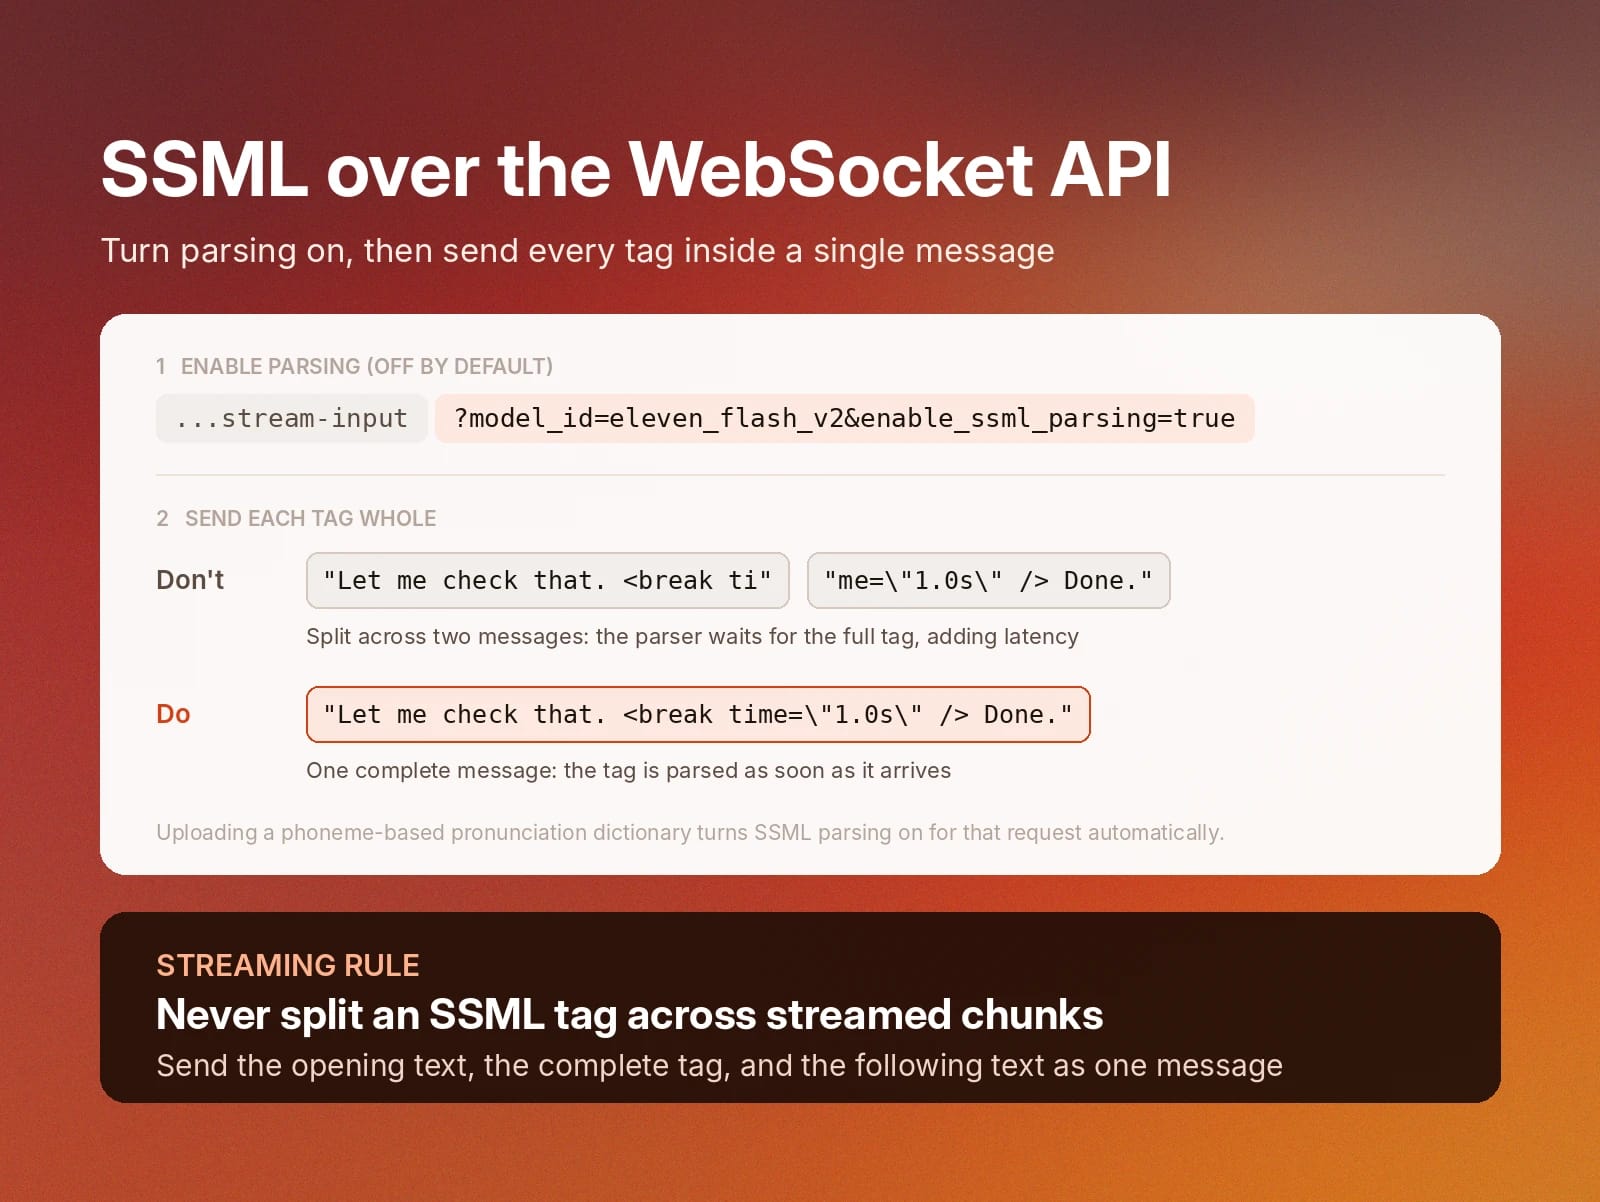
標準的なHTTPリクエストではなくElevenLabsのWebSocket APIでオーディオをストリーミングする場合、SSML解析を明示的に有効化する必要があります。これはデフォルトでは無効で、enable_ssml_parsingパラメータで制御できます。
最良の結果を得るには、各SSMLタグを複数のストリーミングチャンクに分割せず、完全に自己完結したメッセージとして送信することをおすすめします。パーサーは処理する前に完全なタグを必要とするため、メッセージの途中でタグを分割すると遅延が増加します。
音素ベースの発音辞書をアップロードすると、enable_ssml_parsingパラメータを明示的に設定していなくても、リクエストに対してSSML解析が自動的に有効になります。WebSocket APIで利用できるパラメータの詳細とメッセージ形式については、リアルタイムでのオーディオ生成に関するドキュメントガイドをご覧ください。
以下の例では、接続URLでSSML解析を有効にし、完全なbreakタグを1つのメッセージ内で送信します。
ElevenLabsが対応していないSSMLタグと代替方法
Audio Tagsシステムへの移行により、ElevenLabsのテキスト読み上げモデルは、オーディオ出力をより柔軟かつ細かく制御できます。Audio Tagsはすべて自然言語で記述するため、スクリプトにも非常に簡単に書き込めます。
旧世代のElevenLabsモデルを使用している場合は、どのSSMLタグがサポートされているかを知っておくと便利です。推奨される代替手段が多数あるため、旧世代のElevenLabsモデルが現在処理するのは<break>と<phoneme>のみで、その他のSSMLタグは別の方法でカバーされます。
W3C仕様で知られているその他のSSMLタグはマークアップとして読み取られないため、それぞれ異なる方法が必要です。ElevenLabsで他のSSMLタグの代わりに使う方法は次のとおりです。
SSMLタグ
機能
代替手段
<prosody>
ピッチ、話速、音量を設定する
速度と安定性の音声設定。Eleven v3およびEleven v4では、[slowly]や[rushed]などの発話用Audio Tags
<emphasis>
単語やフレーズを強調する
大文字や句読点による強調。Eleven v3およびEleven v4では、[shouts]などのタグ
<say-as>
数字、日付、頭字語の読み方を制御する
テキスト正規化、値を単語で書き出す方法、または発音辞書ルール
<sub>
書き言葉を読み上げ用の表現に置き換える
発音辞書のエイリアスルール
<lang>
フレーズの言語を切り替える
多言語モデルを使い、対象言語でフレーズを書く
<voice>
スクリプト途中で話者を切り替える
音声ごとに別々に生成するか、Eleven v3およびEleven v4の複数話者対話を使用する
<audio>
録音済みのオーディオファイルや音を挿入する
Eleven v3およびv4のサウンドエフェクトAudio Tags、ElevenLabsのサウンドエフェクトツール、または生成後のオーディオミキシング
プロソディ:SSMLでピッチ、話速、音量を調整する
SSMLの<prosody>タグは、テキストの一部に対してピッチ、話速、音量を調整します。旧世代のElevenLabsモデルでは、速度の音声設定でペースを、安定性の設定で表現力を制御します。どちらも単一フレーズではなく、生成全体に適用されます。
スクリプト内でペースを変えるには、テキストを別々の生成に分けるか、文の間に<break>タグを追加します。Eleven v3とv4では、上の表にある[slowly]、[rushed]、[whispers]などのAudio Tagsを行内に直接配置してください。
発音:SSMLの<phoneme>、<say-as>、<sub>
ElevenLabsでは、TTS出力の発音を制御するための方法が3つあります。
主な方法は次のとおりです。
- 上記の例のように、Flash v2またはTurbo v2で一度だけ修正する場合は<phoneme>を使用します。
- 多くのスクリプトで繰り返し登場する用語には、発音辞書を使用します。辞書にはphonemeルールのほか、たとえば「UN」を「United Nations」にマッピングするような、<sub>と同様に機能するエイリアスルールを保存できます。
- 数字、日付、通貨、電話番号など、<say-as>が扱う内容には、書き言葉の値を話し言葉に変換するテキスト正規化を使用します。確認番号のように、値を必ず特定の方法で読ませる必要がある場合は、単語で書き出すか、スクリプト内で数字の間にスペースを入れてください。
言語とロケール
SSMLの<lang>タグは、フレーズが別の言語に属することを示します。ElevenLabsのTTSモデルはこのタグを読み取りません。代わりに、多言語モデルを選択し、読み上げるべき言語でフレーズを記述してください。
Flash v2とTurbo v2は英語専用のため、複数言語が混在するスクリプトには、Multilingual v2、Flash v2.5、Eleven v3、またはEleven v4などの多言語モデルが必要です。Eleven v4とv3は、[French accent]のようなアクセントタグとIPA 転写にも70以上の言語で対応しています。
オーディオとサウンドエフェクト
SSMLの<audio>タグは、音声応答の中で録音済みクリップを再生します。ElevenLabsはこのSSMLタグに対応していません。TTSモデルが自然言語プロンプトから新しいサウンドエフェクトを生成できるためです。
音声そのものにサウンドを加えるには、[applause]や[door slamming]などのサウンドエフェクトタグを書くだけです。Eleven v4とEleven v3がそれを再現します。より長い、または細かなサウンドデザインには、サウンドエフェクトを生成してから、エディターや制作ワークフローで音声トラックとミックスしてください。
ElevenLabsでのSSMLベストプラクティス
旧世代のElevenLabs TTSモデルを使用している場合、SSMLタグは現在も部分的にサポートされています。ただし、いつでもEleven v4へ切り替えてAudio Tagsを最大限に活用できます。そうすれば、SSMLタグの正確な書き方を再び調べる必要はありません。
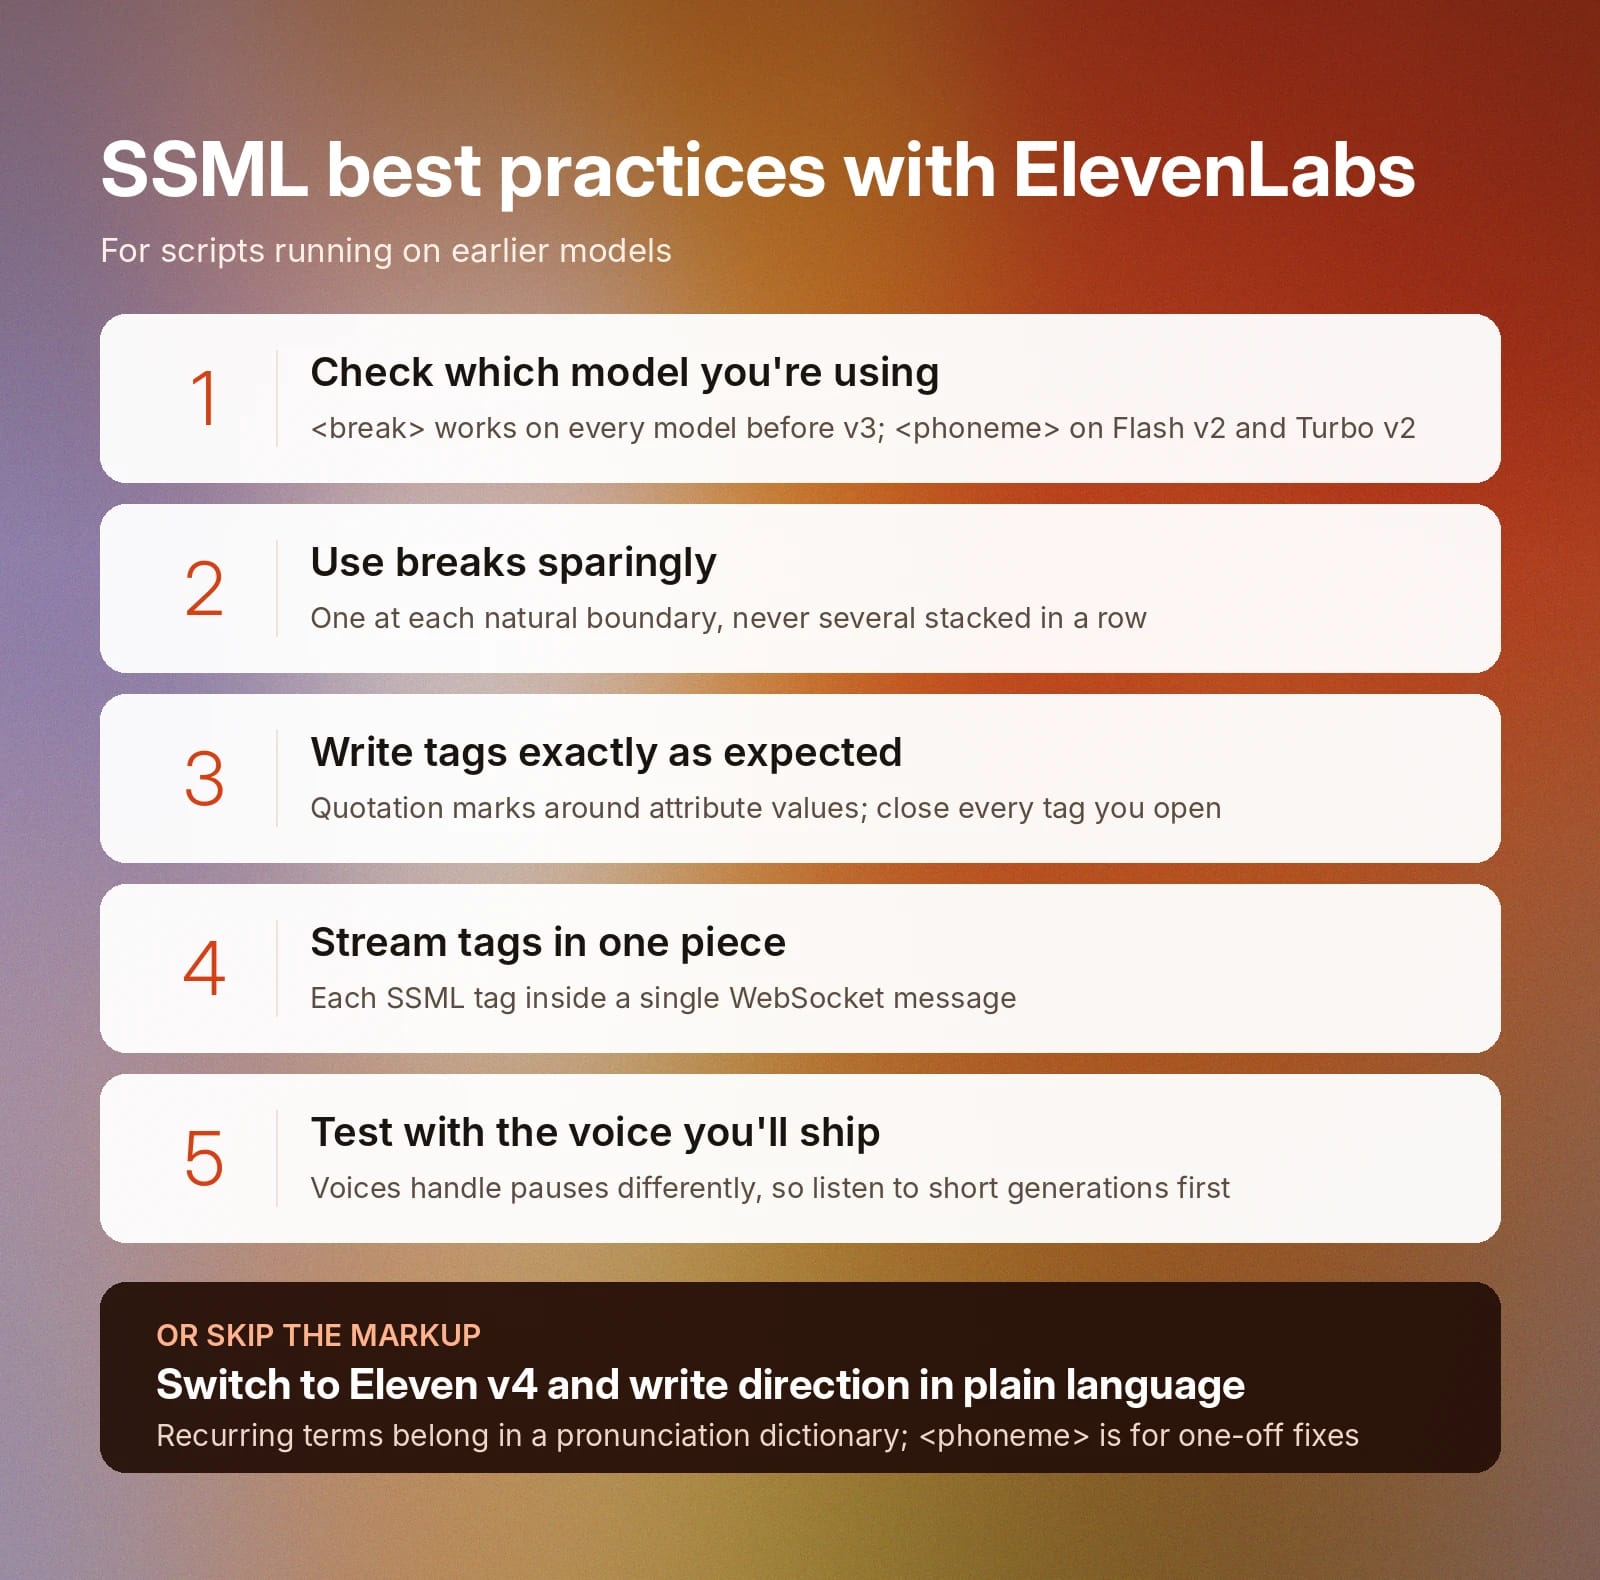
ElevenLabsでSSMLを使う際は、まず以下のポイントを押さえてください。
- 使用するモデルを確認する: <break>はEleven v3を除くすべてのモデルで機能し、<phoneme>はFlash v2とTurbo v2でのみ機能します。Audio TagsはEleven v4やEleven v3などの新しいモデルでのみ利用できます。
- breakは控えめに使う: 複数を連続して重ねるのではなく、自然な区切りごとに1つ配置してください。
- SSMLタグは正しい形式で書く: <break time="2.0s" />のように属性値を囲む引用符を残し、開いたすべてのタグを閉じてください。
- タグは1つのまとまりでストリーミングする: 各SSMLタグを1つのWebSocketメッセージ内で送信してください。
- 実際に使用する音声でテストする: 音声ごとに間の扱いが異なるため、完全なスクリプトを実行する前に短い生成で確認してください。ElevenLabsのボイスライブラリには、合計17,500以上の音声があります。
これらのSSMLベストプラクティスに加え、頻繁に登場する用語には発音辞書を使用することをおすすめします。一度だけ修正する場合は、<phoneme> が最適です。
SSMLの主なユースケースは?
音声合成マークアップ言語は主に、TTSエンジンがオーディオクリップを生成する方法を制御または微調整するために使用されます。間を挿入したり、特定の単語の発音を調整したり、AI生成音声にプロソディの感覚を加えたりするのに役立つツールです。
SSML標準が役立つ代表的なユースケースは次のとおりです。
- 自動音声応答(IVR)システム: IVRシステムが、プロンプトとメニューの間で間を置いたり、数字を明瞭に読み上げたりする際に役立ちます。
- 会話型エージェント:応答前に短い間を加え、やり取りを自然に聞かせます。
- オーディオブックと長編ナレーション:章の終わりや場面の間で間を置き、場面の前後を明確に区切ります。
- eラーニングとトレーニング:プロダクト名、専門用語、頭字語、業務固有の用語の発音を修正します。
- 通知とアラート:日付、時刻、参照コードの読み上げ方を制御します。
SSMLにはさまざまなユースケースがありますが、Audio Tagsを使えば、複雑になりがちなSSMLタグを覚えてスクリプトへ挿入しなくても、すべて実現できます。Eleven v4とEleven v3では、SSMLの手間をかけずにAI生成音声出力を完全に制御できるよう、Audio Tagシステムが作られました。
Eleven v4がSSMLではなくAudio Tagsを使う理由
Eleven v4では、発話を制御し発音を調整する別の仕組みとしてAudio Tagsを採用しています。スクリプトのテキストに直接記述された、角括弧付きのインライン指示を読み取り、自然言語で目的の出力を作成できます。これらのAudio Tagsは、次のような幅広い指示をカバーします。
- [sad]や[excited]などの感情や気分
- [whispers]や[rushed]などの話し方とペース
- [sighs]や[laughs]などの人間的な反応
- [French accent]などのアクセントやキャラクターボイス
- [applause]や[door shutting]を含むサウンドエフェクト
この設計の理由は、モデルが会話のコンテキストを読み取る方法にあります。Eleven v4のアーキテクチャは、以前のモデルよりも深くコンテキストを読み取るため、個別のパラメータや設定なしで、感情的な手がかり、トーンの変化、話者の切り替わり、文脈上のヒントに従えます。
SSMLはテキスト内の固定された位置で特定の指示を与えるため、発話が硬く不自然に感じられることがあります。基盤となるモデルが高品質でも、SSMLはAIテキストがロボットのように聞こえる主な理由の1つです。
[whisper]のようなキューは、周囲のすべてのプロソディに形作られ、周辺の行全体に適用される解釈上の指示をEleven v4に与えます。
ほとんどのSSML要素には、直接対応するv4の機能があります。
SSMLタグ
機能
Eleven v4での代替手段
<break time="1s">
間を挿入する
[pause]、省略記号、または改行
<prosody rate="slow">
話す速度を遅くする
[drawn out]または[slowly]
<prosody rate="fast">
話す速度を速くする
[rushed]
<emphasis>
特定の単語を強調する
[shouts]または単語を大文字にする
<prosody pitch="high">
ピッチを高くする
[excited]などの感情タグ
<prosody pitch="low">
ピッチを低くする
[sorrowful]などの感情タグ
発音も同じ置き換えパターンに従います。Eleven v4ではIPAがネイティブ対応しており、90以上の言語で転写できます。テキスト内にスラッシュで囲んだ転写を直接追加することで、必要だったXMLタグなしにチームで発音を制御できます。
ElevenCreativeで自然な音声を始める
Audio Tagsは、ボイスアクターがテキストに直接読み込むような間、感情、ペース、声のスタイルをスクリプトに加えます。Eleven v4はこの表現力を完全な制作ワークフローにもたらし、ElevenLabsの音声モデルを画像・ビデオモデルと組み合わせ、1つのワークスペースでスクリプトを完成したオーディオまたはビデオに変えます。
Audio TagsがEleven v4で完成したオーディオへどう変わるかをご覧いただくか、無料アカウントを作成して、今すぐご自身のスクリプトでSSMLとAudio Tagsを試してください。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。