テキスト読み上げの精度問題を解決する方法
- 公開日
大規模な音声データセットでトレーニングされ、安定して高品質なオーディオを生成できるモデルでも、ほとんどのテキスト読み上げ(TTS)モデルでは、単語の誤読などの音声上の問題が発生することがあります。TTSエンジンがトレーニングデータセットに含まれない単語やフレーズに遭遇すると、誤読が起こります。特に業界用語、ブランド名、固有名詞でよく見られます。
文章が長い場合や、音読向けではなく黙読向けの句読点が使われている場合、TTSエンジンの読み上げが速すぎたり、ぎこちなかったり、機械的になったりすることもあります。
APIを介してアプリケーションをTTSエンジンに接続する際には、一般的な技術的問題が発生することもあります。
この記事では、これら3種類の問題と、それぞれの一般的な解決方法を紹介します。
まとめ
- テキスト読み上げの問題は、一般に発音の誤り、不自然なテンポやリズム、API実行時の技術的エラーの3つに分類されます。
- 誤読を効果的に修正するには、W3C標準の発音辞書仕様(PLS)に準拠した辞書を使用するか、スクリプト内の発音記号タグで個別に調整します。
- スクリプトを適切に整形し、句読点を付けることで、自然な音声出力に調整できます。音読向けの文章は、黙読のみを想定した文章とは形式が異なることがあります。
- 標準のHTTPステータスコードを使ってAPIエラーを診断できます。
- ブランド名、固有名詞、新しいフレーズの発音を事前に単独でテストしておけば、後から大がかりなトラブルシューティングをせずに済みます。
テキスト読み上げが動作しないのはなぜですか?
テキスト読み上げの問題は、大きく3つに分類されます。
TTSの問題の種類
誤読
TTSモデルが、新しい単語やフレーズを誤って読み上げます。たとえば、ブランド名、業界用語、頭字語、同綴異音語などです。
不自然な読み上げ&リズム
出力音声が単調になったり、不自然な箇所で間が入ったり、ゆっくり読むべき部分を早口で読み上げたりします。
インテグレーション&APIのエラー
音声IDの指定漏れ、処理量の上限、無効なAPIキーなど、技術的な理由でアプリケーションが音声を生成できません。
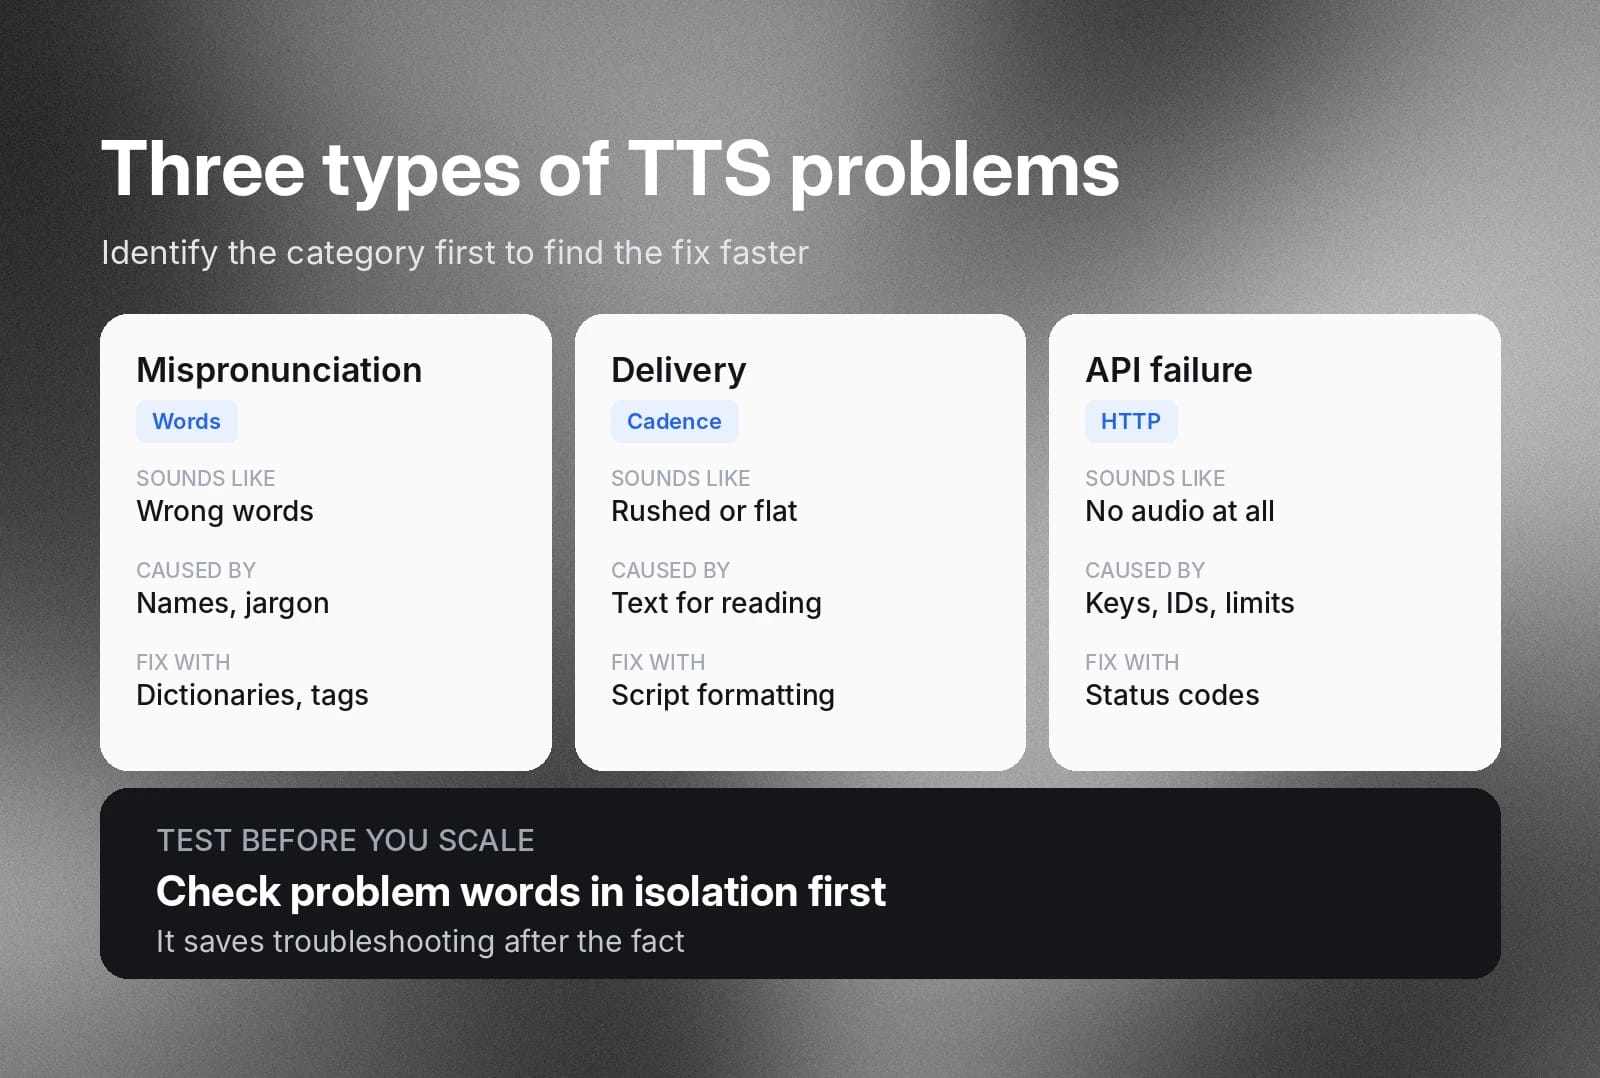
このガイドでは、出力品質または技術面で直面している問題を正確に把握できるよう、3つの問題を詳しく解説します。問題を理解すれば、適切な解決策をより早く見つけられます。
テキスト読み上げの精度問題を解決する方法:誤読と不自然な読み上げ
最新のニューラル音声モデルは、大規模な音声データセットでトレーニングされています。そのため、ほぼ無数の単語の組み合わせで自然な音声を生成できます。しかし、あらゆる内容を網羅できるトレーニングデータセットはありません。例外的な発音や、モデルが正しく読み上げられない珍しい単語、固有名詞は必ず存在します。
頻繁に起こる問題ではありませんが、TTSモデルを日常的に使うなら、発生時の対処方法を知っておく必要があります。まずは、誤読が発生する理由を理解することが重要です。
音声エラーの主な原因
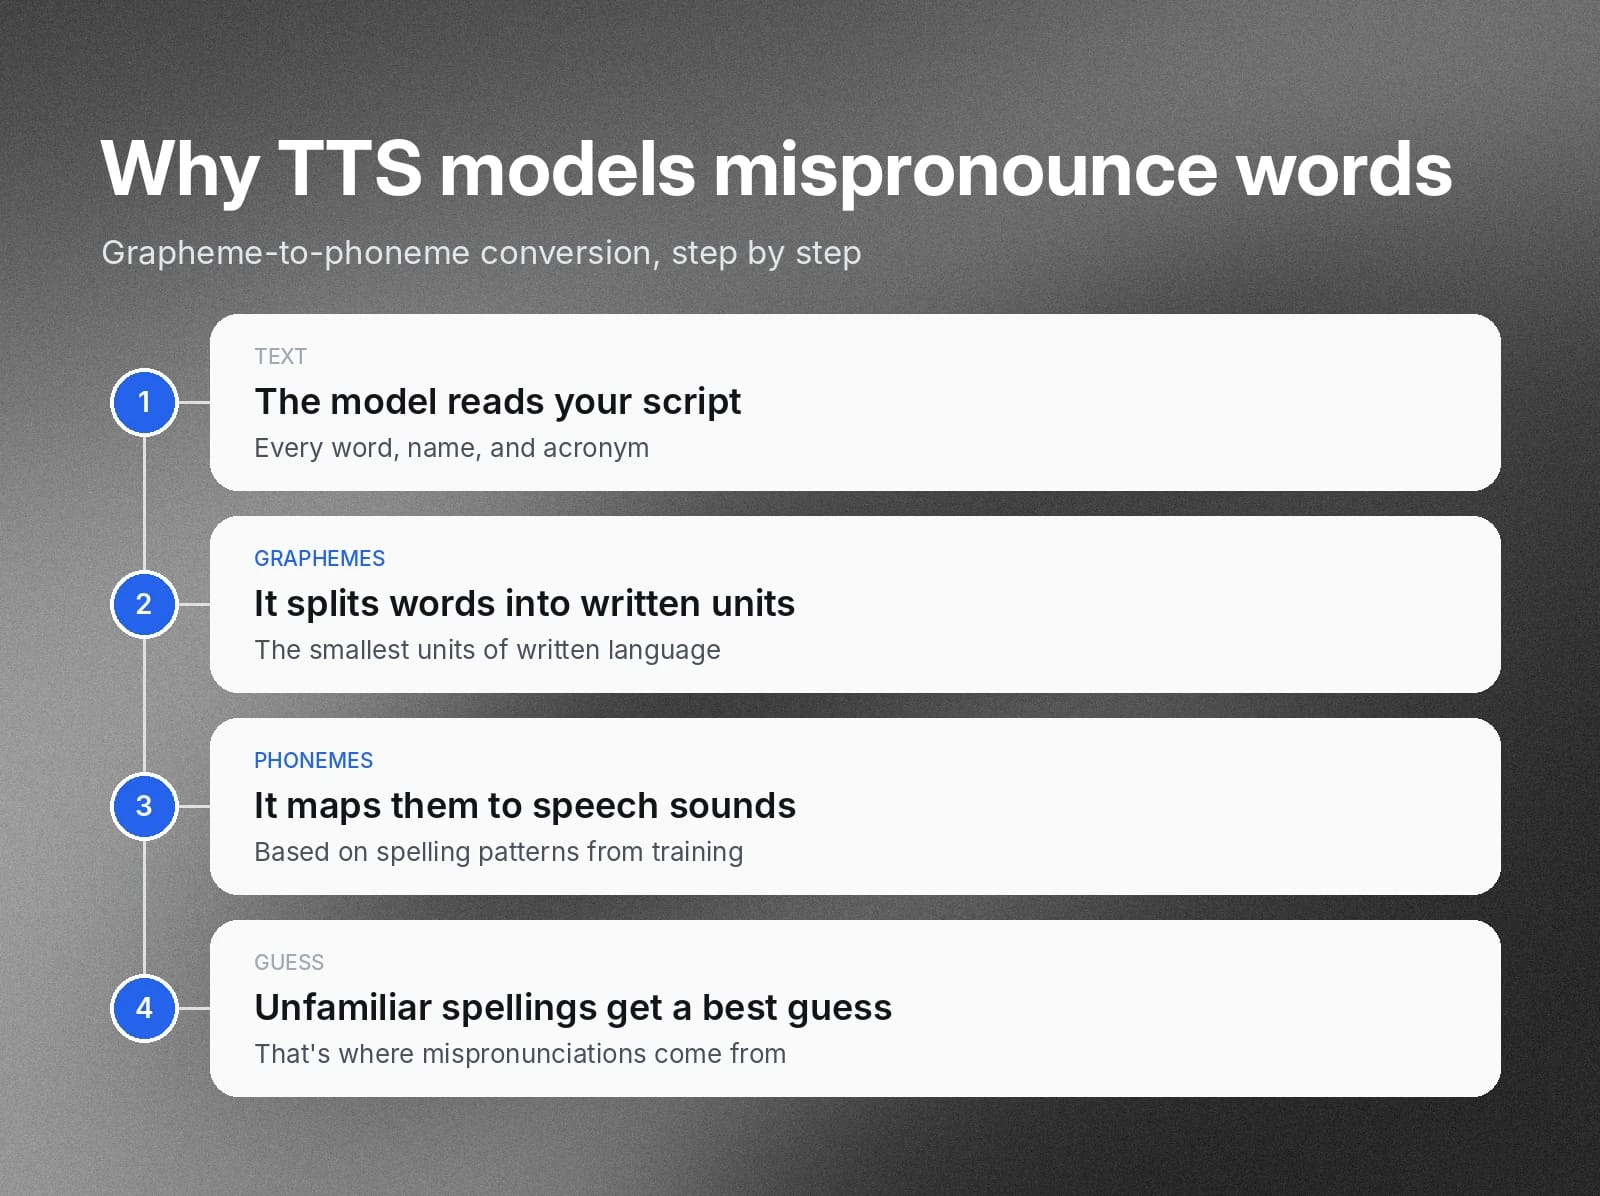
音声合成モデルは、書記素音素変換(G2P)と呼ばれる処理を使って、テキストを音声に変換します。音素は、話し言葉を構成する最小の音声単位です。書記素は文字言語の最小単位で、通常は1文字で音素を表します。
入力テキストがトレーニングデータで学習した綴りのパターンと一致しない場合、モデルは発音を推測します。その結果、誤読が生じることがあります。
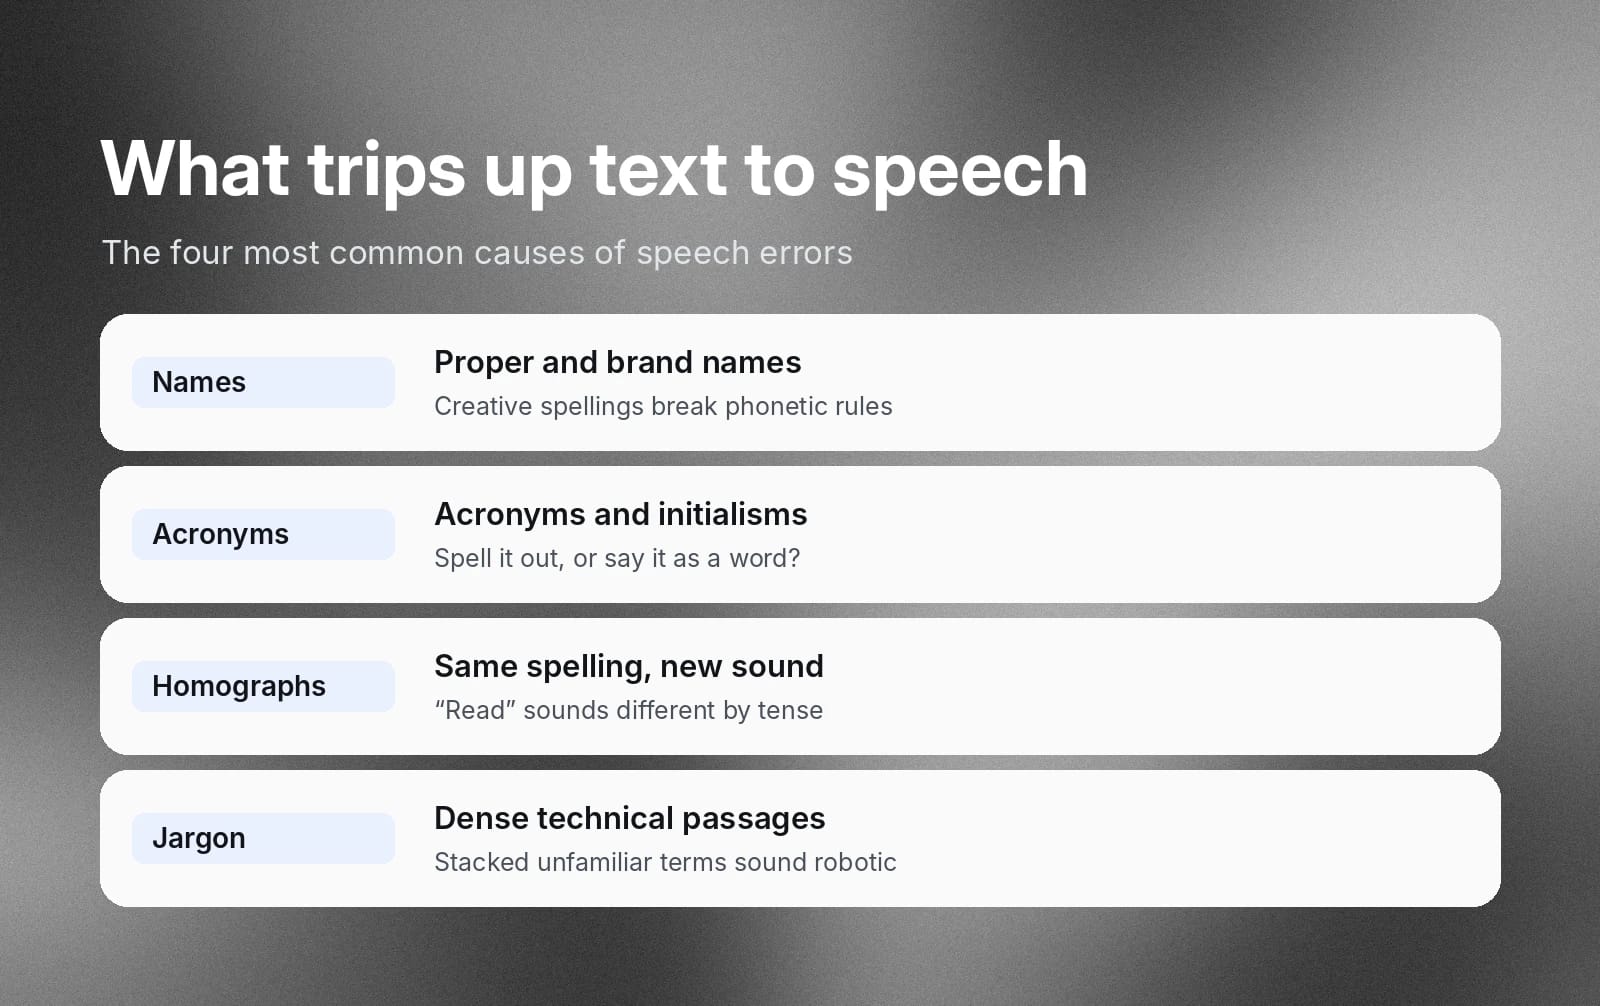
固有名詞とブランド名
ブランド名には独創的な綴りがよく使われます。人目を引く一方、音声合成モデルを混乱させることも少なくありません。同じ理由で、独特な名前や名字でも問題が起こることがあります。
モデルは見慣れない名前に遭遇すると、学習した基本的な発音規則を適用しようとします。その結果、意図とは大きく異なる音声が出力されることがあります。
頭字語&イニシャリズム
NASAという頭字語を考えてみましょう。音声モデルと同じように、初めて目にしたとします。「N.A.S.A.」と1文字ずつ読むでしょうか、それとも「ナサ」と読むでしょうか?ソフトウェアのAPIならどうでしょう。「A.P.I.」でしょうか、それとも「エイピー」でしょうか?新しい頭字語を持つまったく新しいソフトウェアツールを販売する場合、その語が音声モデルのトレーニングデータに含まれていないことは確実です。カスタム指示を与えなければ、モデルは意図する発音を推測するしかありません。
同綴異音語
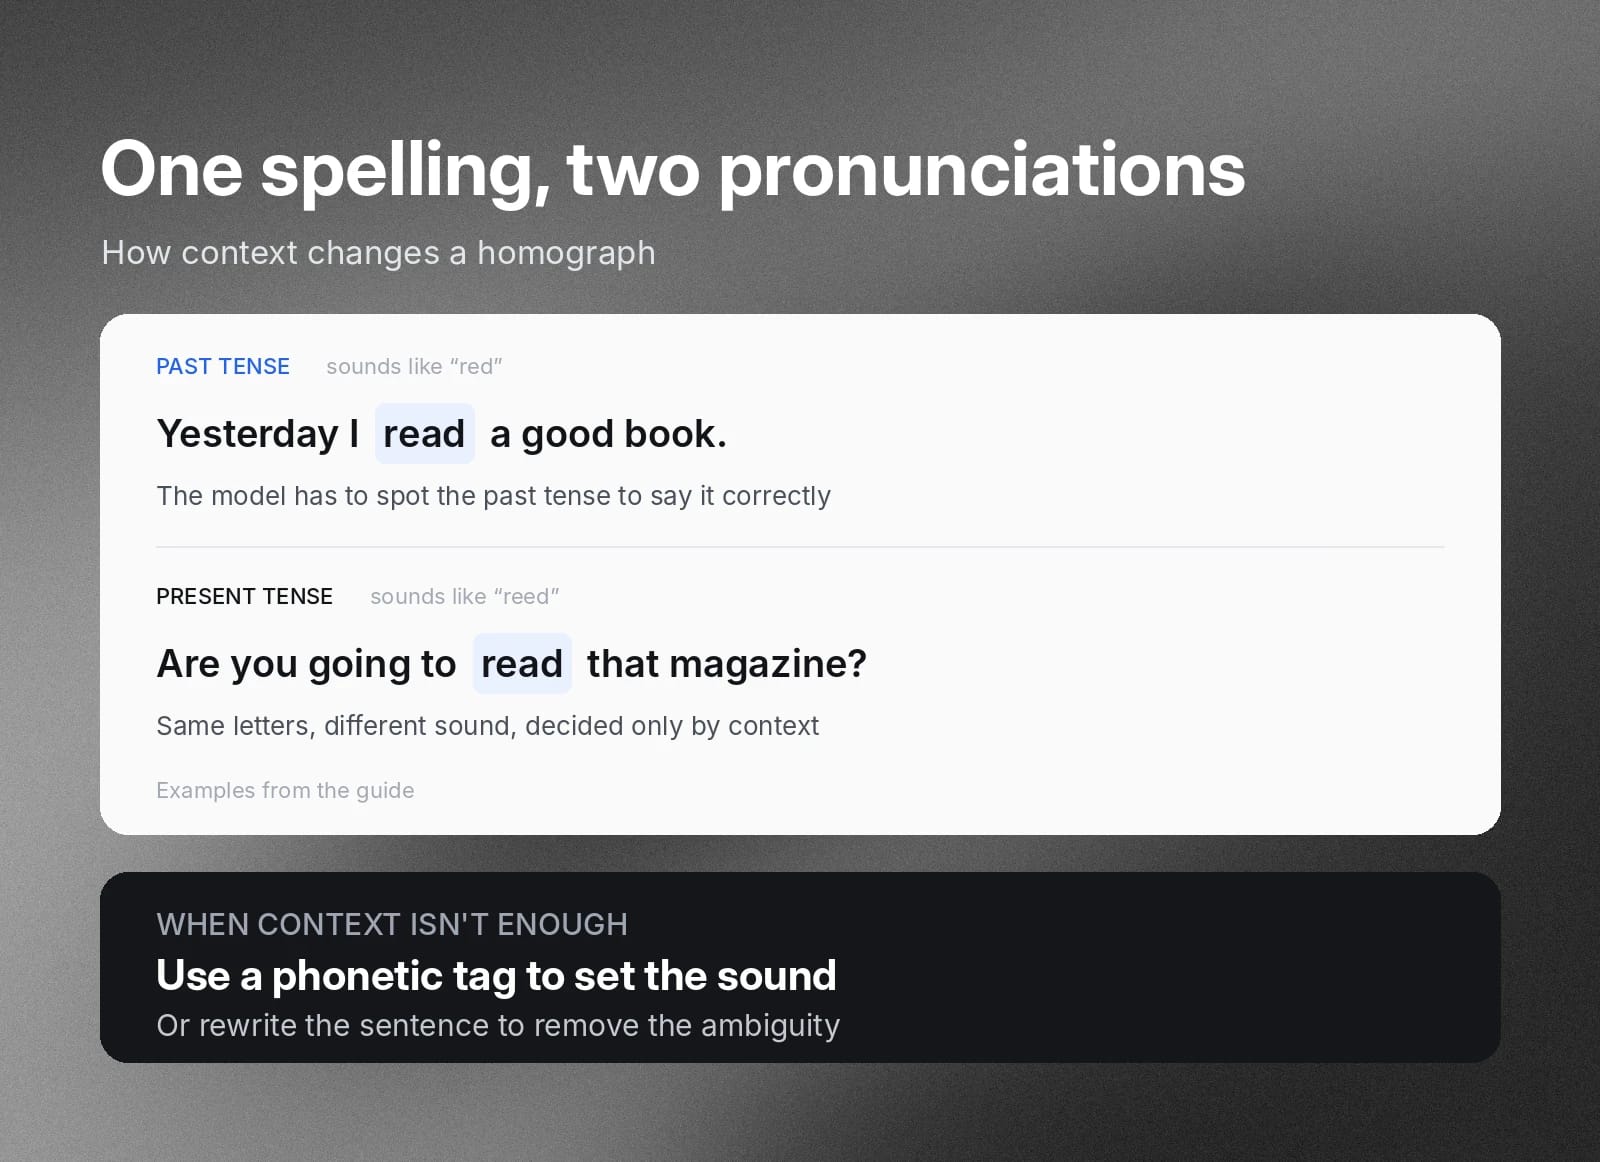
同綴異音語とは、綴りは同じでも、文脈によって発音が異なる単語です。たとえば英単語の「read」は、綴りは同じですが、過去形と現在形で発音が異なります。
- 「昨日、良い本を読みました。」
- 「その雑誌を読むつもりですか?」
同綴異音語を意図したとおりに発音するには、音声モデルが文脈を十分に理解する必要があります。
不自然なアクセントパターン
専門用語を含む長い文には、珍しい単語、特定の発音、頭字語が短い範囲に集中することがあります。単独では気づかないほどの小さな誤りでも、モデルが見慣れない単語や言い回しを次々と解析しようとすると、すぐに平板で機械的な音声につながります。
音声の発音を調整する2つの方法
こうした問題を避けるために、スクリプトを全面的に書き直す必要はありません。最新のニューラル音声モデルには、問題をケースごとに効率よく修正する2つのツールがあります。発音辞書と、スクリプト内の発音記号タグです。
テキスト読み上げの発音辞書
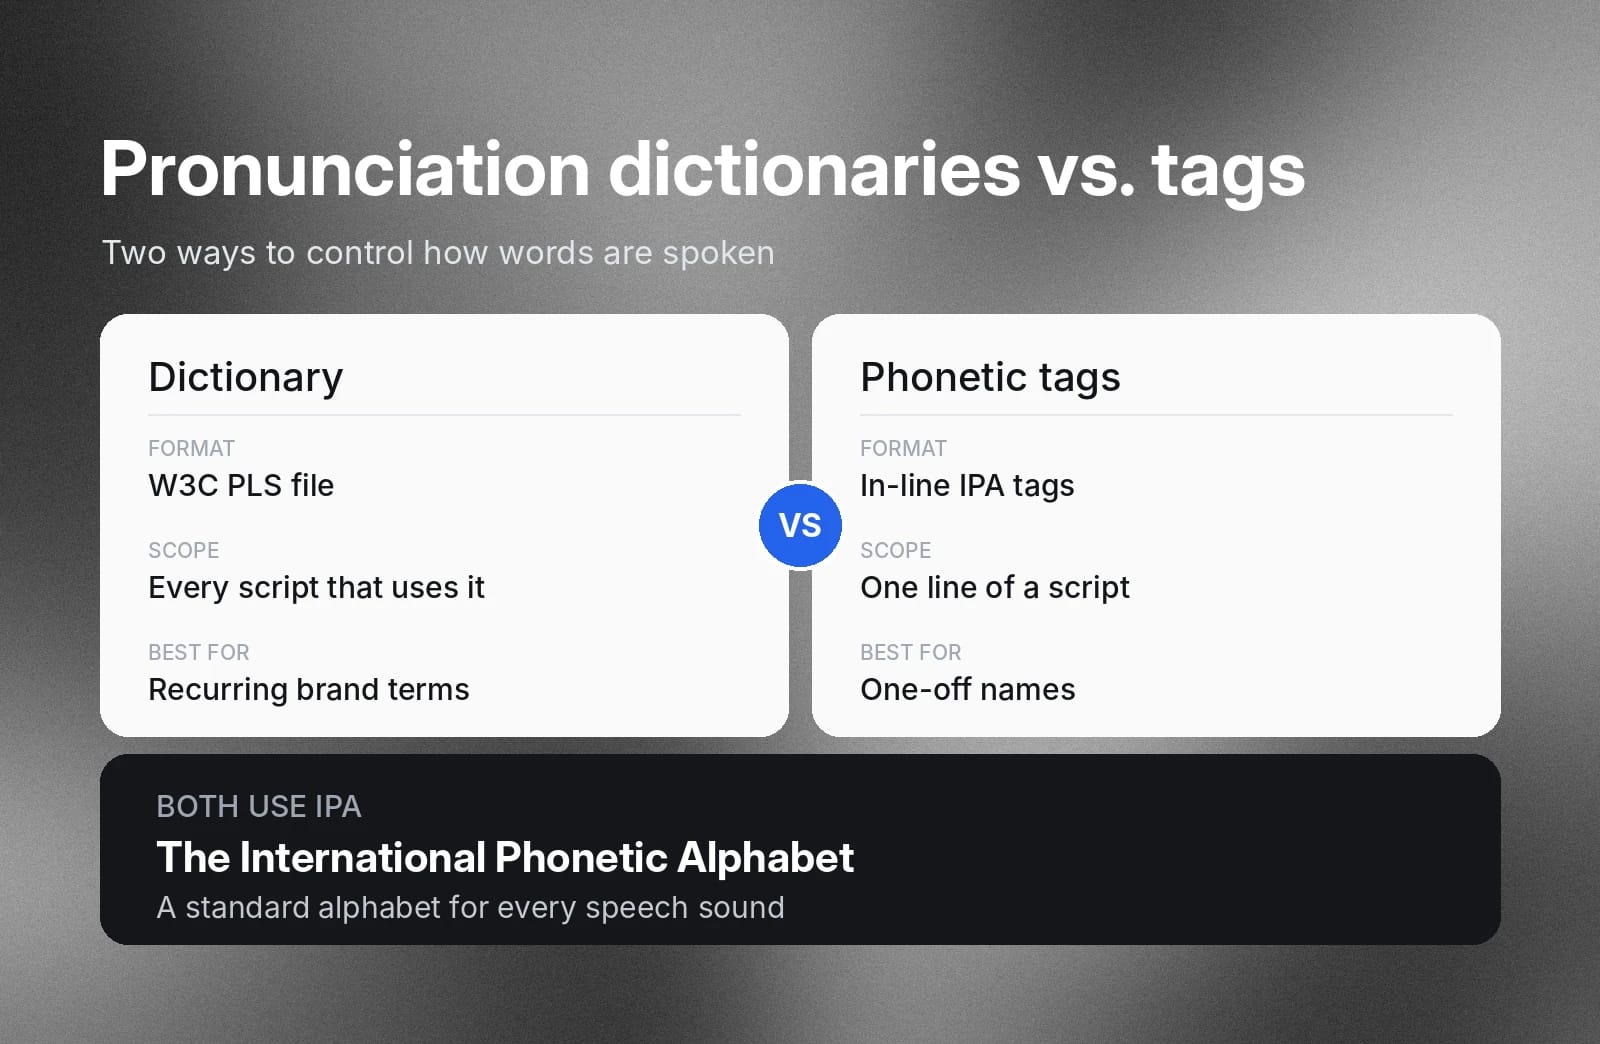
TTSプロジェクト全体で繰り返し使用する独自の発音が多数ある場合は、辞書が最適です。たとえば、医療機器を販売していて、スクリプトに専門用語、医療処置、その他の分野固有の内容が頻繁に登場する場合です。
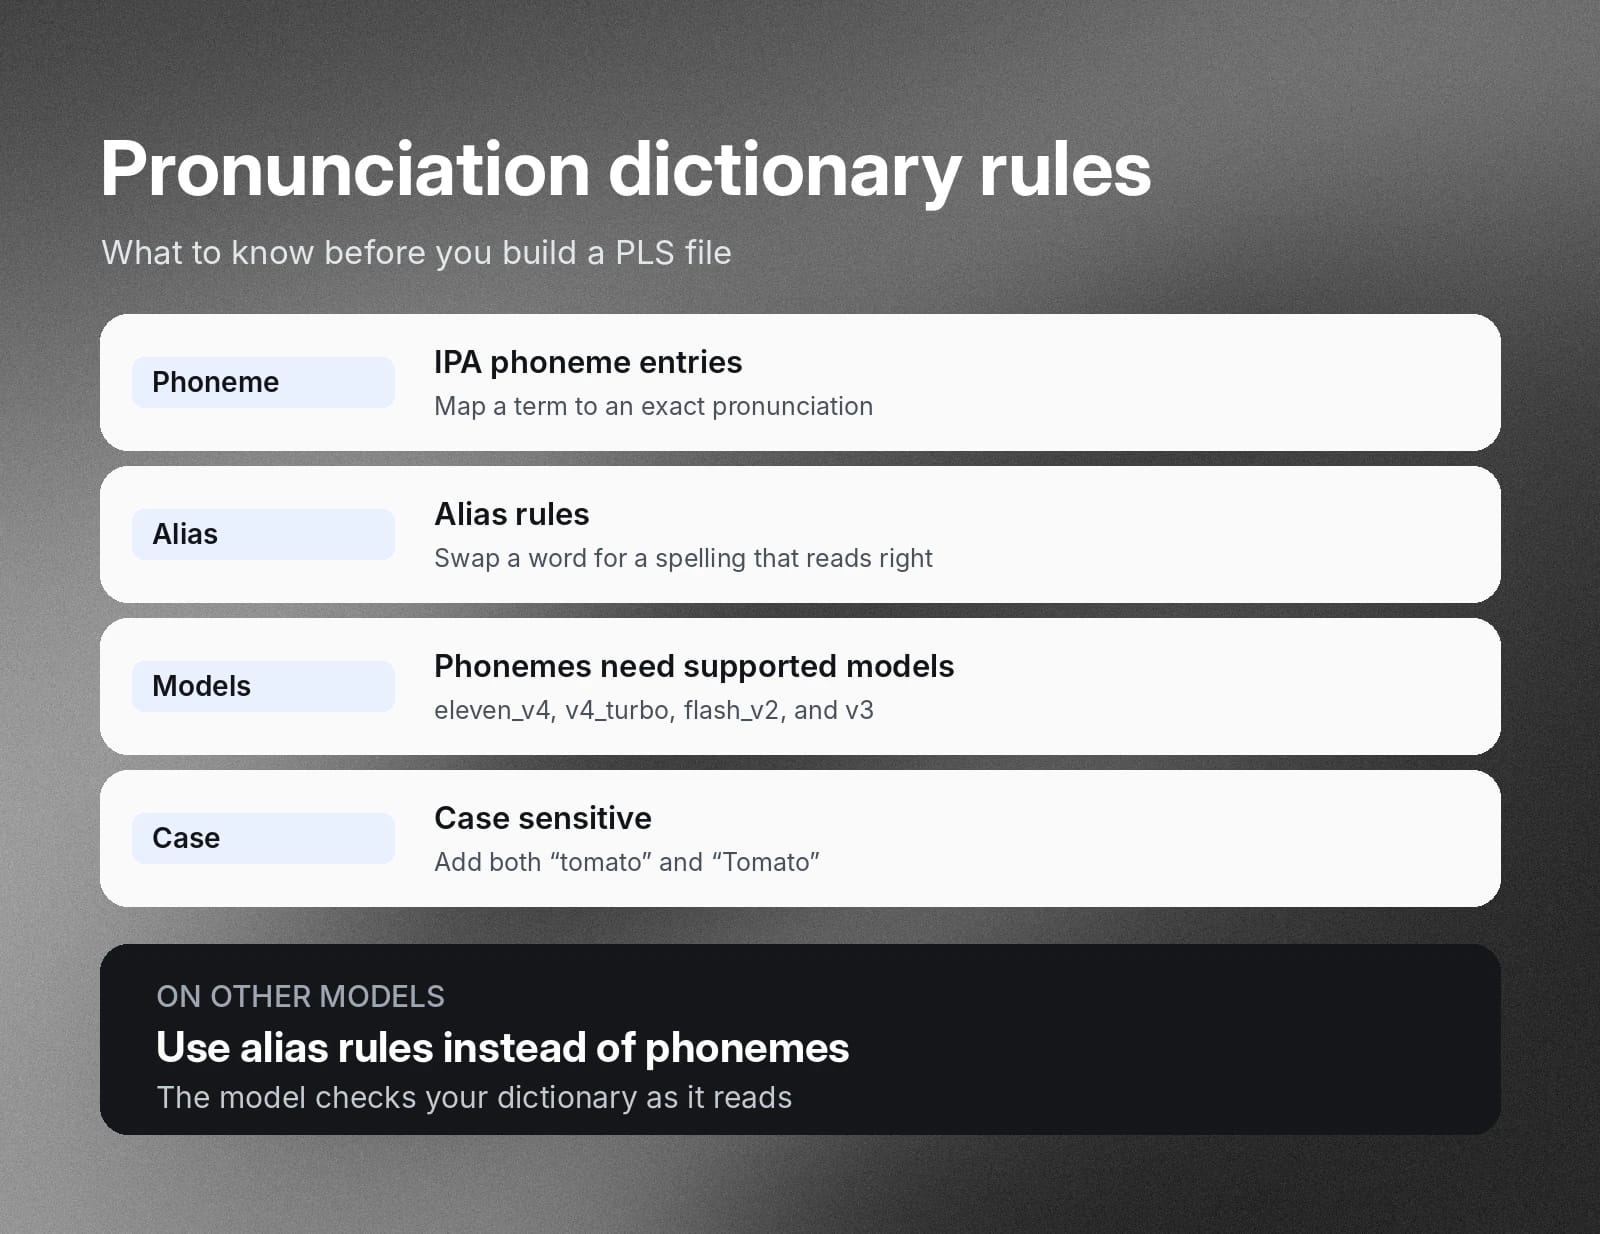
W3C標準の発音辞書仕様(PLS)形式では、国際音声記号(IPA)を使って、用語と特定の発音を対応付けられます。国際音声記号は、考えられるあらゆる音声を表す標準化された表記体系です。音声モデルはスクリプトを読み上げる際に辞書を確認し、登録された単語が出てくるたびに、指定された発音を参照します。音素エントリを使用できるのは、eleven_v4、eleven_v4_turbo、eleven_flash_v2、eleven_v3モデルのみです。その他のモデルでは、代わりにエイリアスルールを使用してください。PLSファイルでは大文字と小文字が区別されるため、両方が必要なら「tomato」と「Tomato」をそれぞれ追加してください。
スクリプト内の発音記号タグ
スクリプト内の特定の行だけを調整する場合は、通常、発音記号タグのほうが適しています。辞書を作成する代わりに、インラインの発音記号タグを使い、IPAに従って単語を意図したとおりに発音するよう音声モデルへ指示します。
たとえば、ポッドキャストのスクリプトで業界の専門家に2、3回言及するとします。社内の発音辞書に追加する代わりに、スクリプト内で名前を使うたびに、正しい発音を示すタグを付けるだけです。
音読したときに自然に聞こえるスクリプトの作成と整形
辞書やタグは、出力音声に含まれる個々の単語の問題を管理するのに役立ちますが、全体的な読み上げ方、リズム、音声の抑揚には対応できません。スクリプトを書く際は、実際に音読されることを前提に文章を組み立てることが重要です。単語の選び方、言い回し、句読点は、黙読だけを目的とした文章とは変える必要があります。
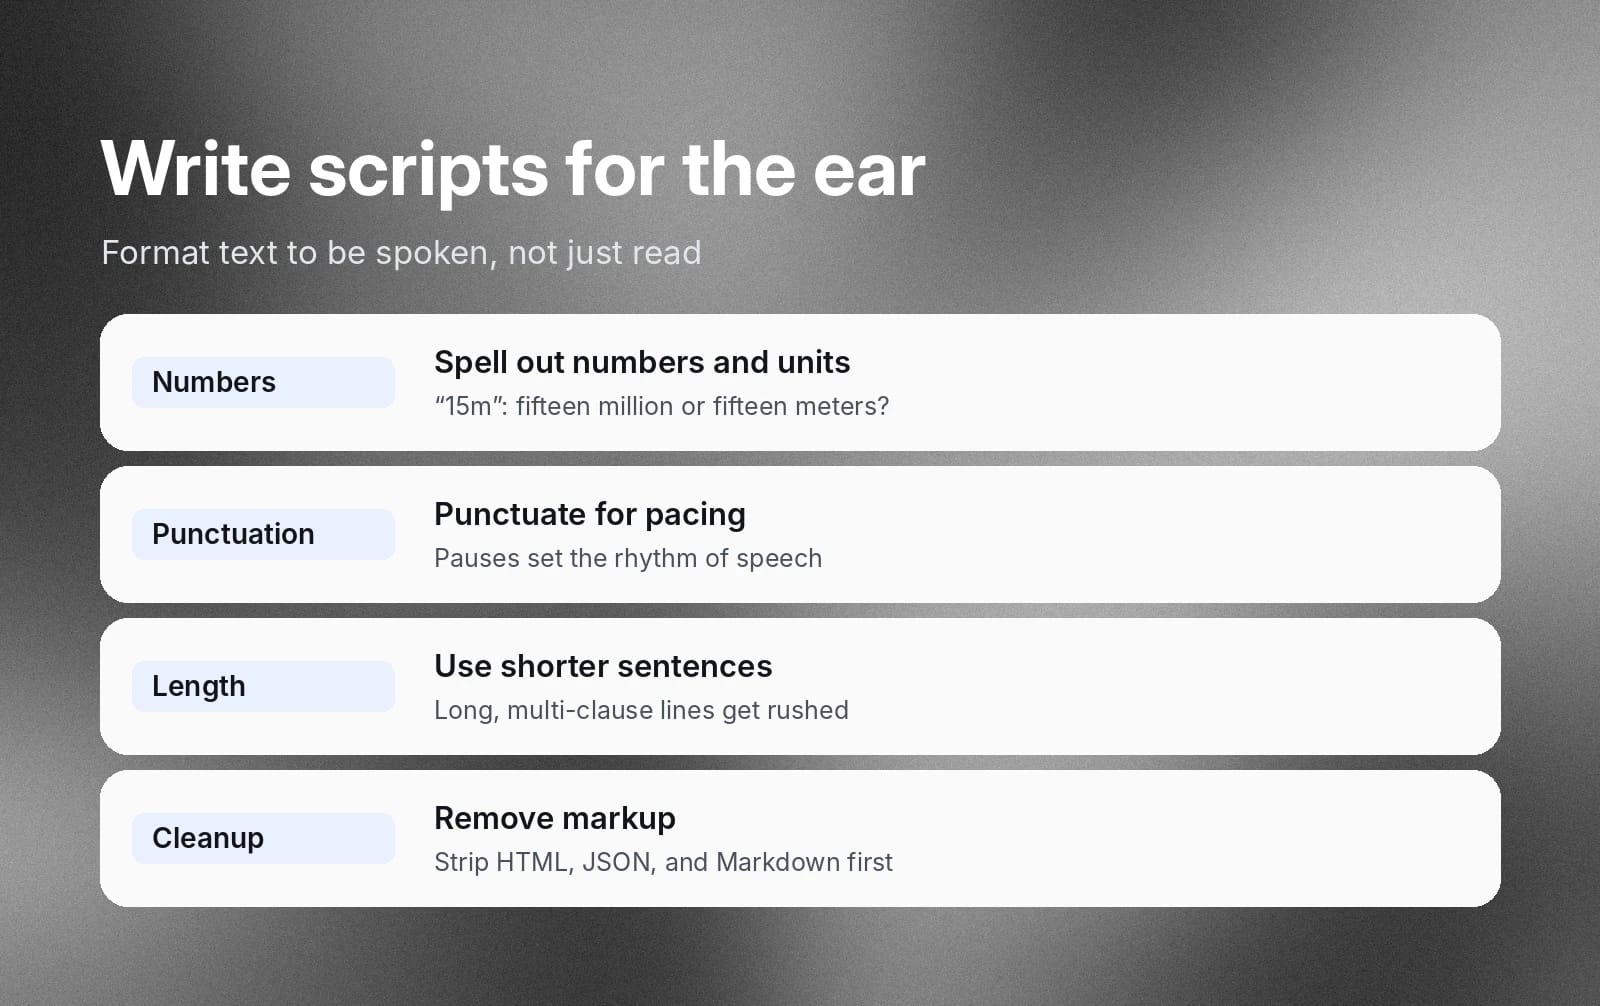
目で読むのではなく、耳で聞くために書く
スピーチ原稿を書くつもりでスクリプトを作成してください。「どのように音読してほしいか?どこで劇的な効果を出すために間を取るか?どこで速く読むか?」と考えます。高度なニューラル音声モデル向けのスクリプトでも、人が読むスクリプトと同じように、こうした問いが重要です。
数字、通貨、日付を省略せずに書く
スクリプトに曖昧さを残さないようにします。ニューラル音声モデルは文脈をよく理解しますが、推測する必要がないときに最も高い性能を発揮します。略語や省略表現は、モデルがつまずきやすい代表的な要素です。
たとえば、スクリプトに「15mに近い数値を探しています」と書かれているとします。TTSエンジンには「1,500万」と読ませたいのでしょうか、それとも「15メートル」でしょうか?モデルが文脈から推測しなくてもよいよう、省略せずに書いてください。
一般的な句読点で読み上げ速度を調整する
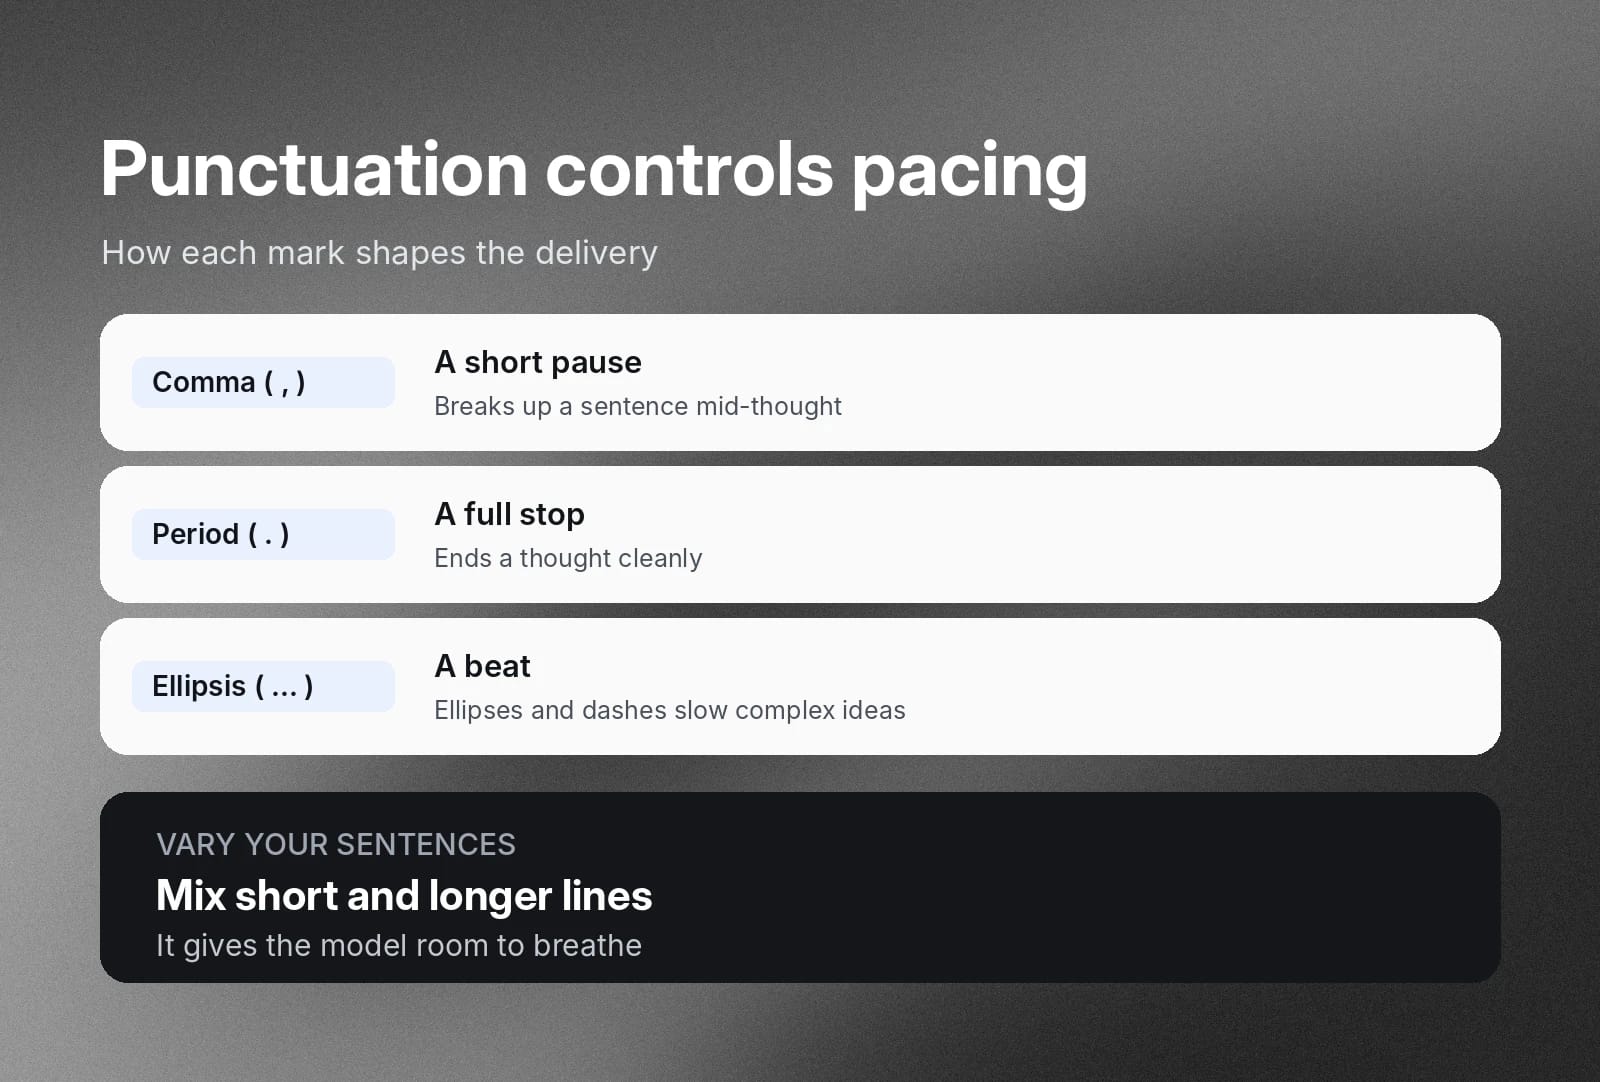
句読点は文章で重要な役割を果たしますが、テキスト読み上げの合成ではさらに重要です。句読点はリズムを調整します。複雑な考えを区切ったり、聞きやすく自然なリズムを保ったりするための、さまざまな間を表します。
- 文中の短い間には読点を使います。
- 考えの区切りには句点を使います。
- 複雑な考えの途中に間を入れるには、省略記号やダッシュを使い、モデルが早口にならないようにします。
短い文ほど読みやすい
条件や節が複数含まれる長い文では、モデルがつまずいたり、早口になったりしやすくなります。長さの異なる短い文に分けてください。これによりモデルに余裕が生まれ、長く続く文のリズムを探す際に早口になるのを防げます。
書式設定とMarkdownの不要要素を削除する
コンテンツ管理システムやその他の業務システムから取得した文章を音声合成する場合、HTML、JSON、Markdownなどの書式が含まれていることがあります。最も自然な音声を得るには、それらを削除してプレーンテキストに整えてください。音声モデルは、タグを無視するべきか、そのまま読み上げるべきか、文脈に合わせて出力へ組み込むべきかを判断できないことがあります。
誤読などの問題について詳しくは、ElevenLabsトラブルシューティングガイドをご覧ください。
ElevenLabs APIでよくあるエラーを解決する
音声オーディオを大規模に制作するチームは、通常、APIを介してアプリケーションを音声合成モデルに接続します。これにより制作全体の効率は向上しますが、モデルの音声出力に加えて、管理すべき技術レイヤーが増えます。
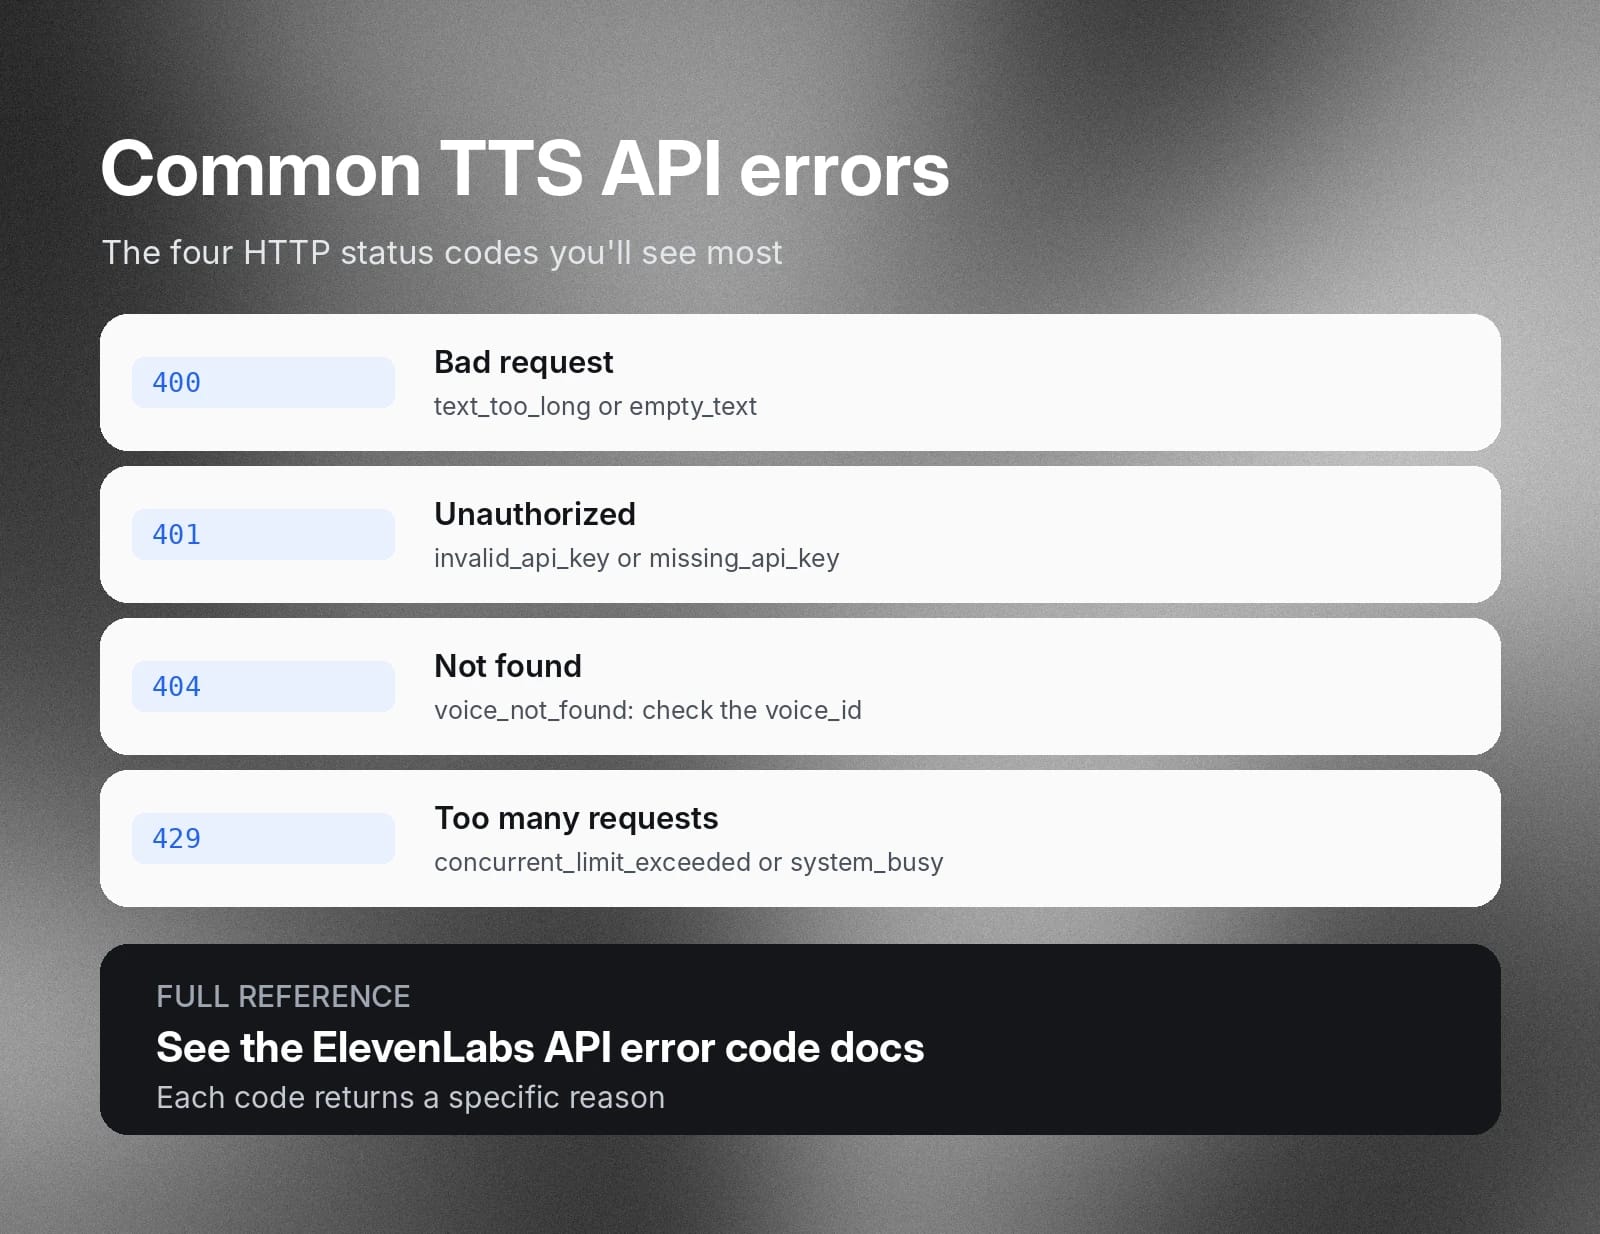
ElevenLabs APIエラーコードリファレンスではレスポンスコードを詳しく説明しています。ここでは、テキスト読み上げのインテグレーションをトラブルシューティングする際によく発生する4つのHTTPステータスコードと、その対処方法を紹介します。
400 Bad Request(ペイロードエラー)
音声モデルAPIから400ステータスコードが返された場合、アプリケーションがモデルで処理できないデータを送信したことを意味します。TTSワークフローでは、通常、文字数制限の超過や、空の入力の誤送信が原因です。
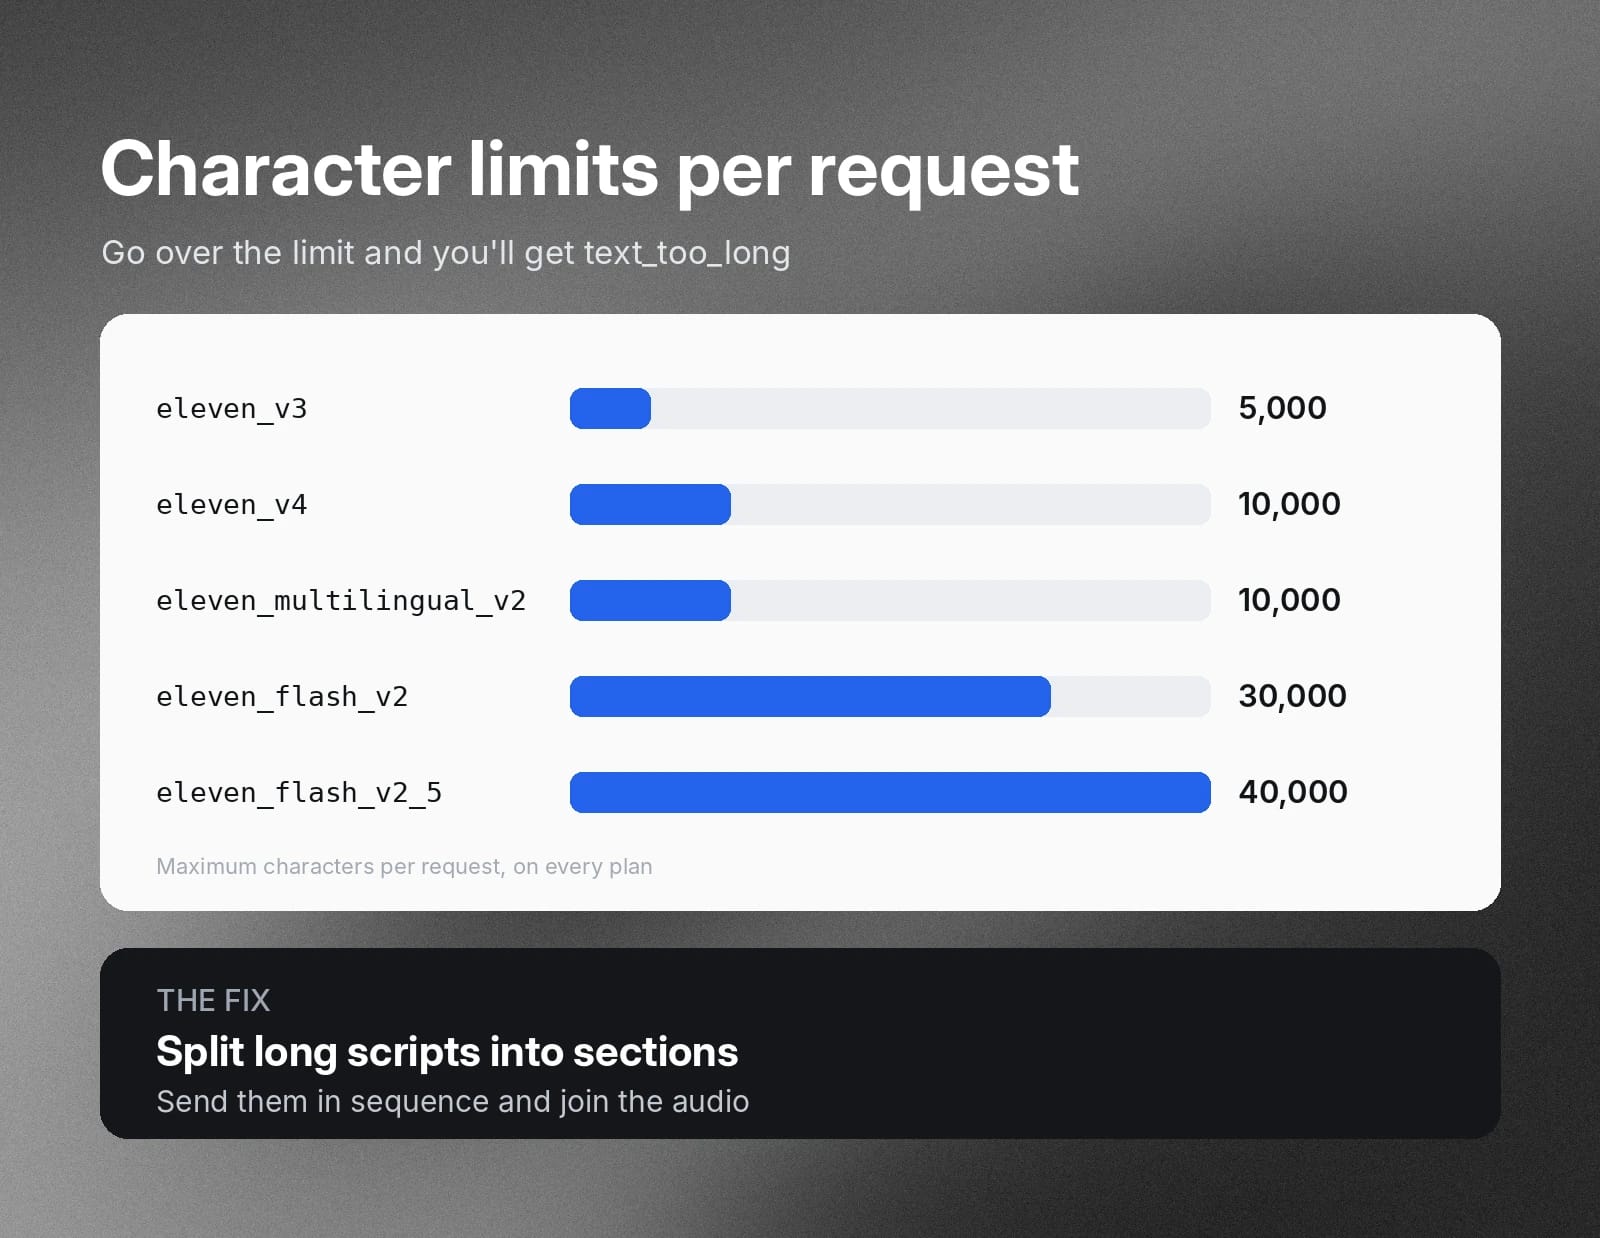
文字数制限の超過(text_too_long)
TTSリクエストには、モデルごとに文字数制限が設定されています。モデルの上限を超えるテキストを送信すると、TTSサーバーからこのエラーが返されます。すべてのプランで、1リクエストあたりの上限は、eleven_v4とeleven_multilingual_v2が10,000文字、eleven_v3が5,000文字、eleven_flash_v2が30,000文字、eleven_flash_v2_5が40,000文字です。解決するには、長いスクリプトをモデルが順番に処理できる複数のセクションに分割してください。
空の入力テキスト
TTSエンジンは、空文字列(empty_text)を含むペイロードを拒否します。本来は処理できるペイロードがサーバーに拒否されないよう、入力パイプラインに空行を削除するクリーニング処理を追加してください。
401 Unauthorized(認証の問題)
401エラーコードは、APIゲートウェイが認証情報を拒否し、ペイロードがモデルに渡されなかったことを意味します。APIキーに問題がある場合に発生します。
無効なAPIキー
モデルサーバーへのリクエストには、有効なxi-api-keyを含める必要があります。含まれていない場合、サーバーは401エラーを返します。キーが実際にリクエストに含まれていること、無効化または期限切れになっていないこと、デプロイ時にヘッダーから途中で切れていないことを確認してください。キーが間違っている場合はinvalid_api_key、キーが送信されていない場合はmissing_api_keyがAPIから返されます。
404 Not Found(音声識別子の不一致)
URLリクエストで指定されたTTSリソースをエンドポイントが見つけられない場合、404エラーが発生します。誤ったvoice_idパラメーターを送信した場合や、リクエストURLに含まれていない場合に起こります。使用するvoice_idが正しいことを確認してください。パスパラメーターに含まれていること、入力ミスがないことも確認します。音声IDが存在しない場合、APIはvoice_not_foundを返します。
429 Too Many Requests
このエラーには2つの原因があります。サービスプランの同時リクエスト数上限に達したか、トラフィックの急増を管理するためにTTSプラットフォームがリクエストを制限しています。
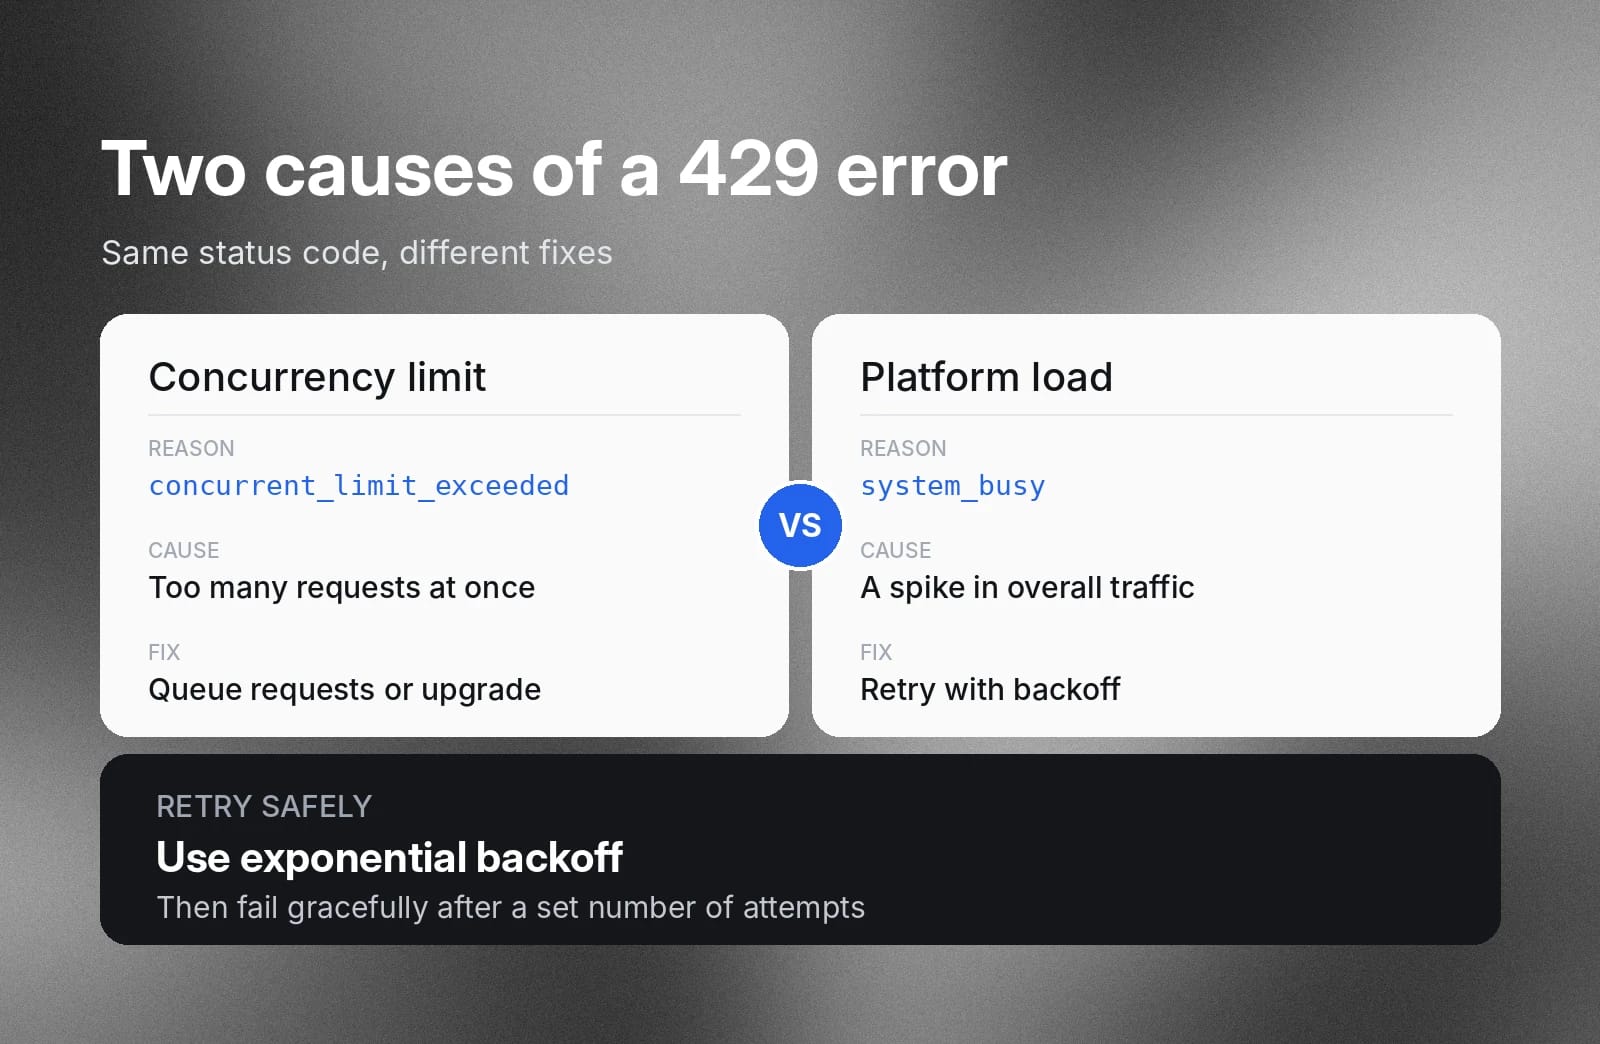
同時実行数の上限(concurrent_limit_exceeded)
TTSエンジンの各サブスクリプションプランでは、同時に送信できるリクエスト数が固定されています。アプリケーションがその上限を超えると、この種類の429エラーがサーバーから返されます。
Redisなどのサービスを使って非同期キューイングレイヤーを構築し、送信ペイロードがプランの上限を超えないよう調整してください。または、上位プランへの変更が費用対効果に見合うかを検討します。
プラットフォーム負荷の急増(system_busy)
負荷が高い場合、TTSサーバーはパフォーマンスを維持するため、受信リクエストを制限することがあります。アプリケーションのAPIクライアントに自動再試行ロジックを実装してください。指数バックオフで再試行し、最大試行回数に達した後は適切に処理を終了できるようにします。
公開前に音声、言語、設定をテストする
大規模なTTSペイロードでは、Webアプリでの簡単なテストだけでは通常、品質管理として不十分です。生成に失敗した場合のコストはすぐに膨らみます。送信前に、管理された条件でスクリプトを複数回テストしてください。この事前準備により、最高品質の音声オーディオを最も効率よく制作できます。
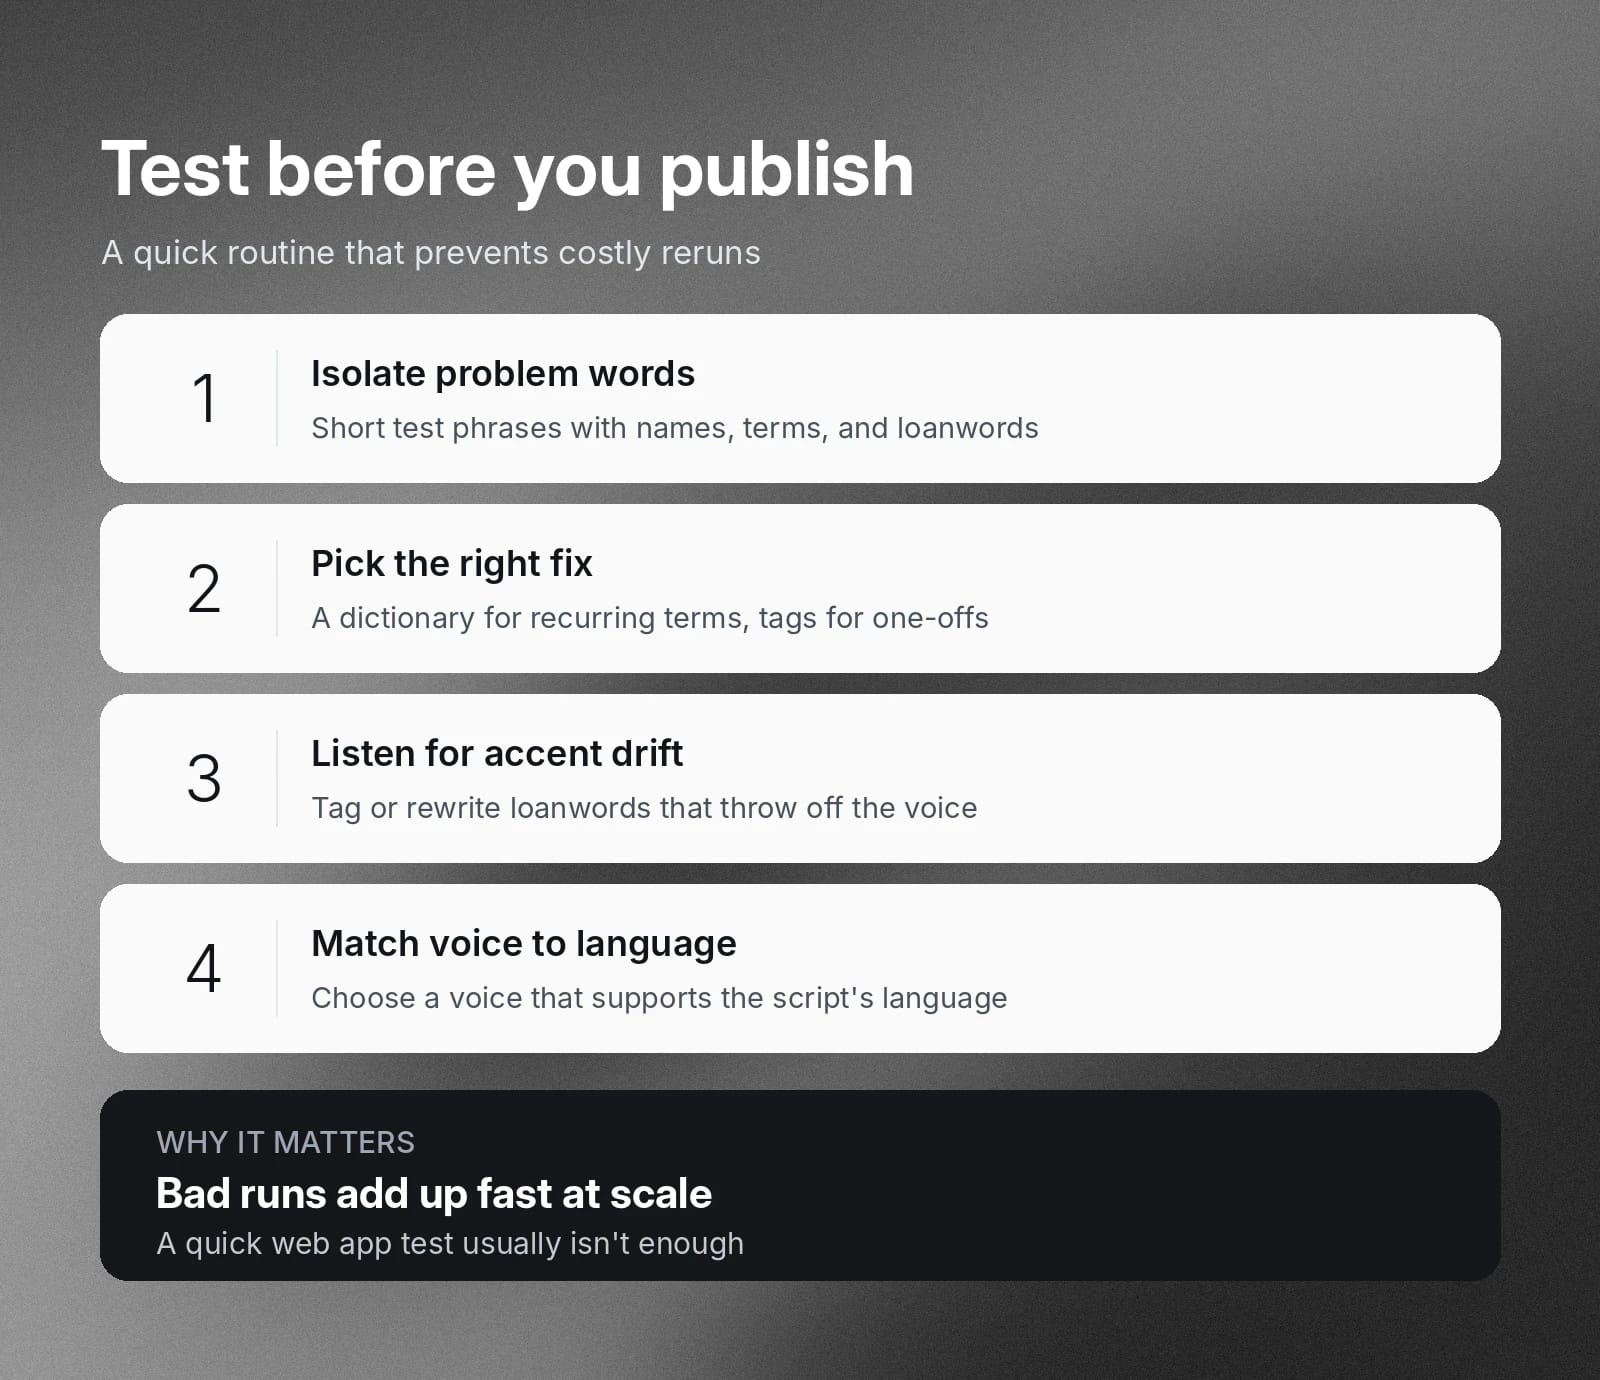
問題のある単語を単独でテストする
問題は全体に広がるのではなく、特定の一節や単語、名前だけに発生することがほとんどです。ブランド名、専門用語、外国語のフレーズを含む5~10語のテストフレーズを作成します。出力結果を基に、それぞれに発音辞書を使うか、発音記号タグだけを使うかを決めてください。
言語やアクセントの変化を特定する
音声モデルのリズムが、文の途中で不自然になったり遅くなったりすることがあります。モデルがトレーニング時に見たものとは異なる一節の発音を推測しなければならない場合によく発生します。
- 外来語:外国語由来の珍しい外来語を含む文章では、モデルの書記素マッピングが乱れ、その後の音声全体に不自然なアクセントが付くことがあります。外来語に発音記号タグを付けるか、文章を書き換えてください。
- ぎこちない英語以外の音声:英語向けに最適化されたモデルで翻訳済みスクリプトを読むと、音声が途切れたり、機械的に聞こえたりすることがあります。その言語にも対応した音声プロファイルを選択してください。
より安定した音声出力を実現するElevenAPIを使い始める
注意すべき点を理解すれば、高品質な音声コンテンツをより速く、少ない手間で生成できます。制作を止める可能性がある出力上の問題と技術的なAPIの問題に対処する方法を把握しておきましょう。
高品質で正確なTTSコンテンツを生成する方法についてElevenAPIで詳しく確認するか、今すぐAPIキーを取得して始めましょう。
テキスト読み上げの問題に関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。