实时转录与批量转录:核心区别
- 发布时间
选择 AI 驱动的转录模型时,有两种方案:实时转录和批量转录。两者都能将语音转为文本,但处理方式不同。
实时转录会在音频发生时处理,而批量转录会在录音结束后处理整段音频。实时转录可即时出结果,批量转录通常更准确。
本指南将对比实时转录与批量转录,帮助你为下个项目选择合适的模型。我们会介绍两类模型的工作原理、优缺点和常见应用场景。
概要
- 实时转录会在音频发生时进行处理。
- 批量转录一次处理整个音频文件。
- 实时转录更快,但批量转录更准确,因为模型可利用整个音频文件的双向上下文。
- 实时转录最适合实时 语音智能体、实时视频字幕或会议笔记等速度比准确性更重要的应用。
- 录音结束后需要批量转录音频时,批量转录更准确且更具成本效益。
STT 中的实时转录是什么?
实时转录是指 语音转文本(STT)模型在音频发生时将其转换为书面文本,有时也称为流式转录。
实时转录中,STT 模型会将音频分成小片段处理。说完话仅几毫秒后即可获得文本。随着对话推进,STT 模型会获取更多数据和上下文,并据此优化转录文本。
这种转录方式最适合速度比准确性更重要的场景。例如,这类模型通过实时字幕提升音视频流的可访问性。实时笔记平台也是常见应用场景。
STT 中的批量转录是什么?
批量转录会在录音结束后,一次性将整段录音从语音转换为文本。根据录音时长和复杂程度,处理过程可能需几秒到超过 10 分钟。
批量转录模型处理时会利用整段录音的上下文。完整上下文有助于模型准确理解包含复杂语言、背景噪音或打断的片段。批量转录模型还会添加标点和格式,而一些实时模型可能难以做到这一点。
批量转录最适合准确性优先的场景。许多组织使用批量模型转录较长的访谈、会议或播客,用于存档。
批量与流式架构如何影响转录
比较用于转录的批量处理与流式处理时,两类模型采用的流程存在根本差异,因而会影响最终输出。
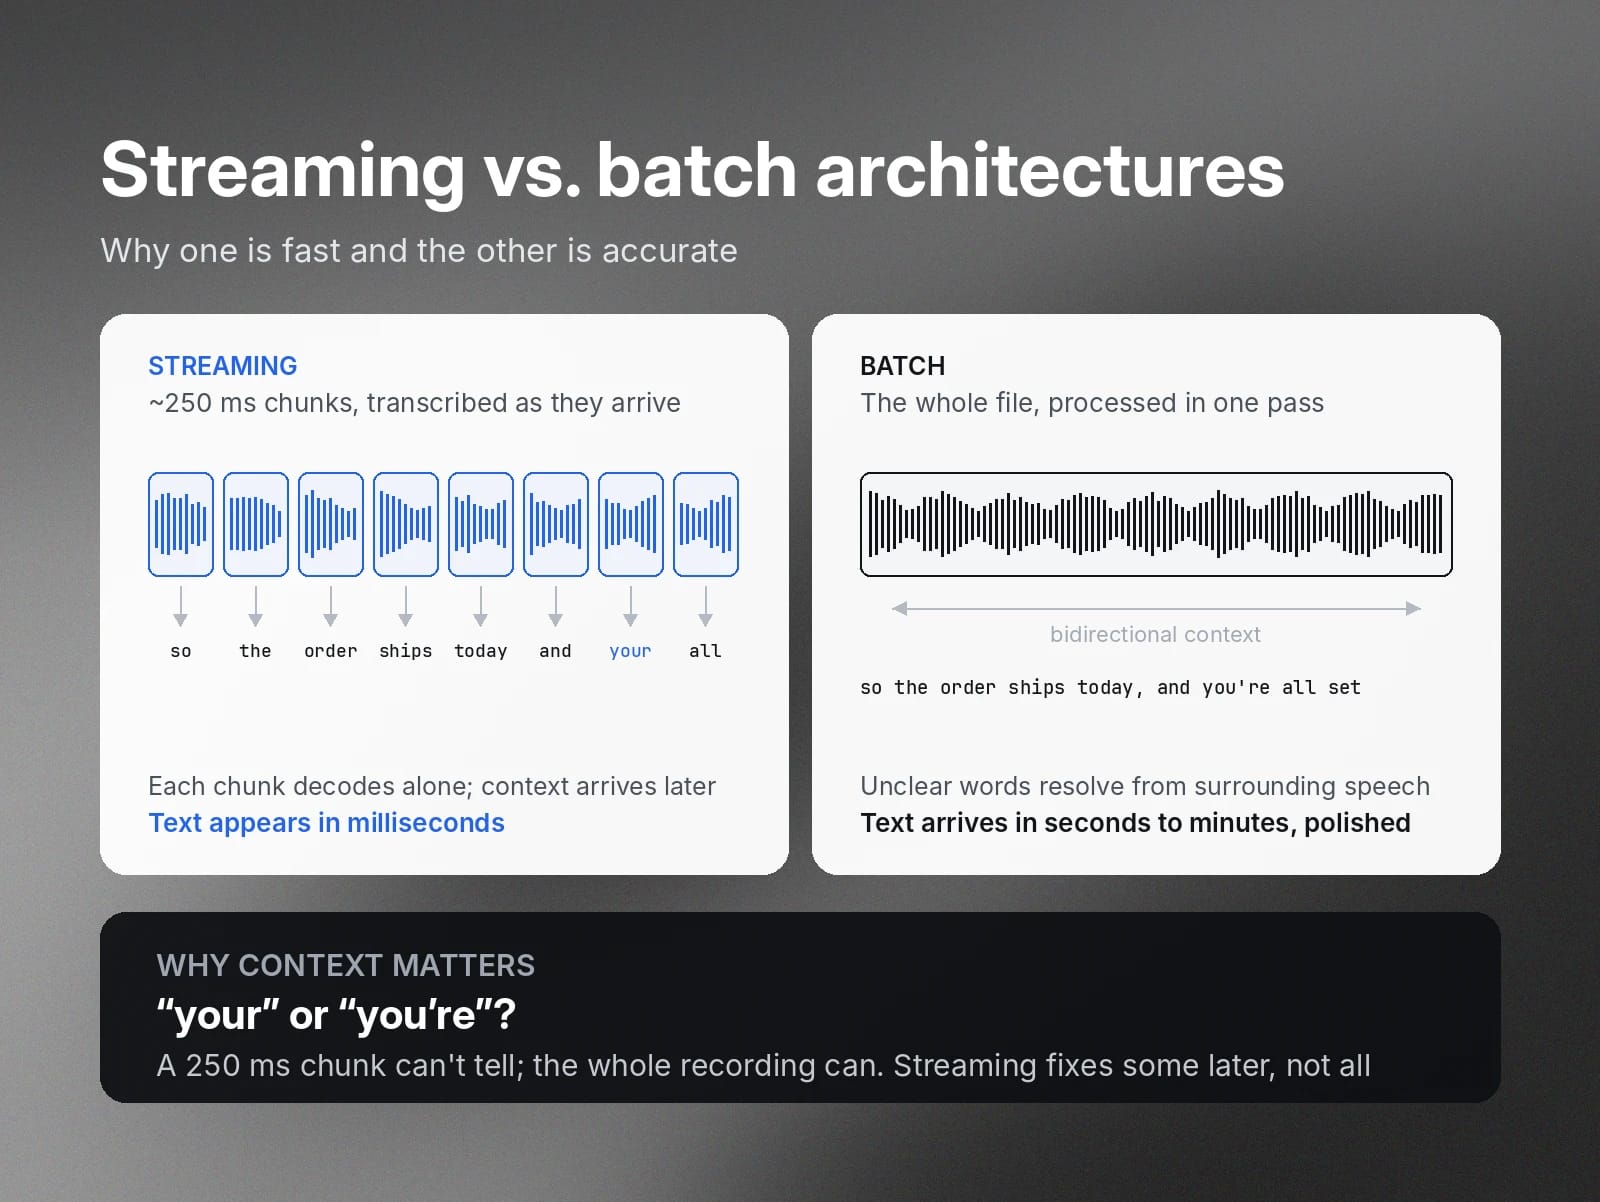
流式转录模型将音频拆分成片段,并在音频发生时逐段转录。这些片段很短,通常约 250 毫秒或更短。采用这种格式处理音频,转录模型可快速运行,让文本在音频发生后仅几秒出现。
由于这些音频片段很短,语音转文本模型无法获得完整的对话上下文,可能导致错误。例如,转录模型可能将 “you're” 识别成 “your”。
随着对话继续、上下文逐渐清晰,实时转录模型会修正其中一些错误。不过,通常没有足够时间或上下文来纠正每个错误,因此最终转录文本不一定能达到 100% 准确。
相比之下,批量转录模型会一次处理整个音频文件。这意味着转录模型拥有对话的双向上下文,可据此消除含义不明的词语或短语。当音频文件中的内容不清楚时,模型会分析其前后的词语,判断说了什么并准确转录。
这些额外上下文意味着批量转录模型比实时转录模型慢,但最终结果更准确、更完善。
实时转录与批量转录模型的核心特征:延迟、准确性和成本
实时和批量模型都能有效完成转录,关键取决于项目类型。有些项目需要即时结果,另一些则需要高准确率。
选择实时转录或批量转录时,可考虑以下因素:
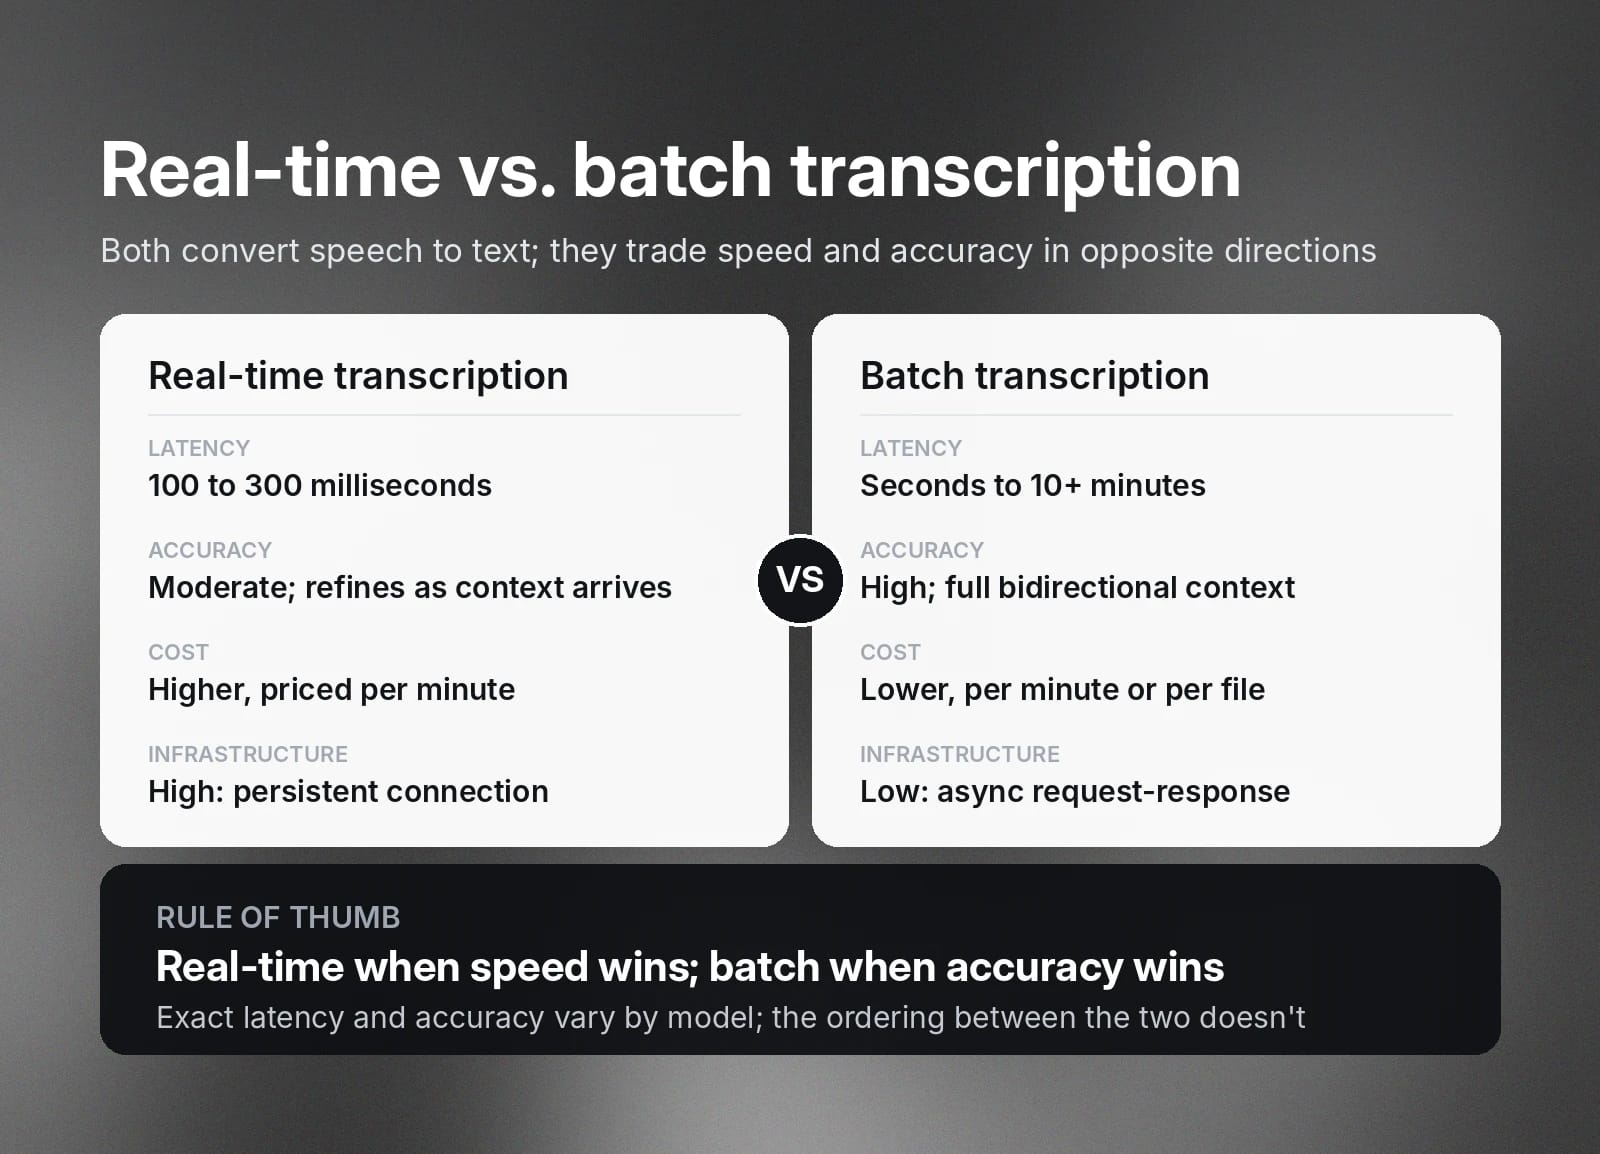
实时转录 | 批量转录 | |
延迟 | 100 至 300 毫秒 | 数秒至 10 多分钟,取决于文件时长 |
准确性 | 中等 | 高 |
成本 | 高,按分钟计费 | 中等,按分钟或文件计费 |
基础设施复杂度 | 高,需要稳定连接和负载均衡 | 低,采用异步请求—响应结构 |
具体延迟和准确率因所用转录模型而异。不过,实时转录始终更快,批量转录则更准确。
实时转录的成本高于批量转录,因为它需要更复杂的基础设施,运营开销也更高。实时模型需要稳定连接来维持速度,设置和维护时间也比批量模型更长。
对于实时对话中的无障碍需求,实时模型值得投入。对于速度并非优先事项的项目,批量转录可节省成本和设置时间。
实时转录与批量转录 API 对比:为项目选择最佳方案
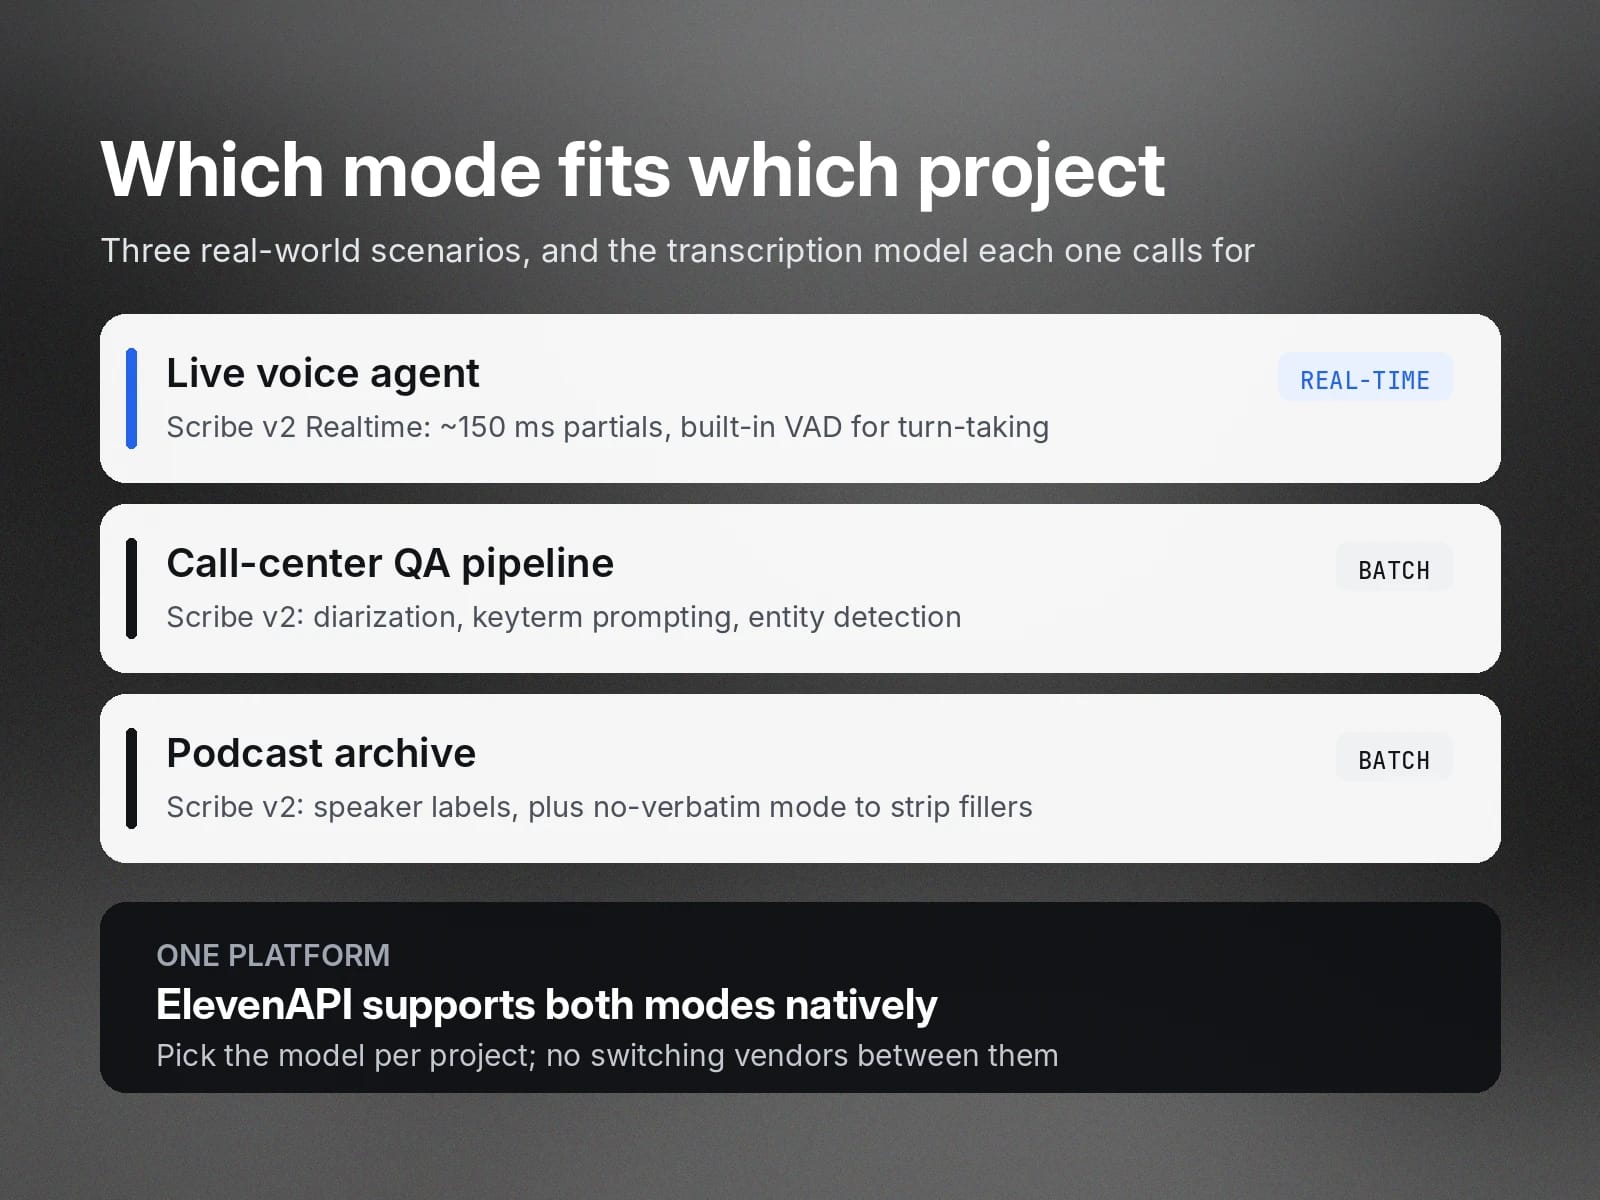
开始新的转录项目之前,需要评估批量和实时模型的优缺点,确定哪一种最符合目标。以下是 3 个真实场景中的决策过程。
实时语音智能体:实时转录
实时 对话式 AI模型需要近乎即时的转录来保障可访问性,尤其是在处理复杂运营或客户服务问题时。
以 Scribe v2 Realtime等实时模型为例,它可提供流畅自然对话所需的低延迟。Scribe v2 Realtime 大约可在 150 毫秒内提供部分转录结果。
用于实时语音智能体的转录模型还需要准确的轮次切换能力。这意味着它们需要能够 检测用户何时开始或结束说话,并立即响应。有效的轮次切换和打断管理有助于避免转录文本落后于对话。
实时转录模型优先保证准确的轮次切换,以快速提供结果。例如,Scribe v2 Realtime 内置 语音活动检测,因此检测到说话人之间的静音时,会自动划分转录文本。
呼叫中心 QA 流程:批量转录
质量保证的关键是准确性,因此在这种场景下,像 Scribe v2这样的批量转录模型最合适。
呼叫中心转录文本通常包含独特的人名和行业专属细节。如果转录不正确,分析人员很难判断通话是否真正成功。由于 批量模型会一次处理整段录音,因此具备准确转录和格式化所需的上下文。
Scribe v2 提供多项提升转录准确性的功能。说话人分离可确保即使发生交叉说话,也能始终正确标记客服人员和客户。关键词提示可预先向模型提供品牌名称和行业术语,确保准确转录。
呼叫中心转录文本还可能包含需要脱敏的敏感信息,例如社会保障号码和信用卡号。Scribe v2 的实体检测功能可找到这些敏感信息并添加时间戳,以便移除。
播客存档:批量转录
构建播客档案时,需要精修后的转录文本,方便团队和受众随时查阅。准确性和清晰格式至关重要,因此批量转录是合适选择。
使用批量转录,可在所有播客文件中获得准确的转录结果,以及说话人标签和说话人分离。Scribe v2 还提供 非逐字模式,可自动移除语气词、口吃和重复内容。这样可减少手动编辑时间,更快构建播客档案。
ElevenAPI 原生支持实时和批量模式。如果同时运行多个转录项目,可在同一平台上使用 ElevenAPI 管理全部项目。只需为每个项目选择合适的模型,无需在不同服务提供商之间来回切换。
混合转录模型:衔接实时与批量
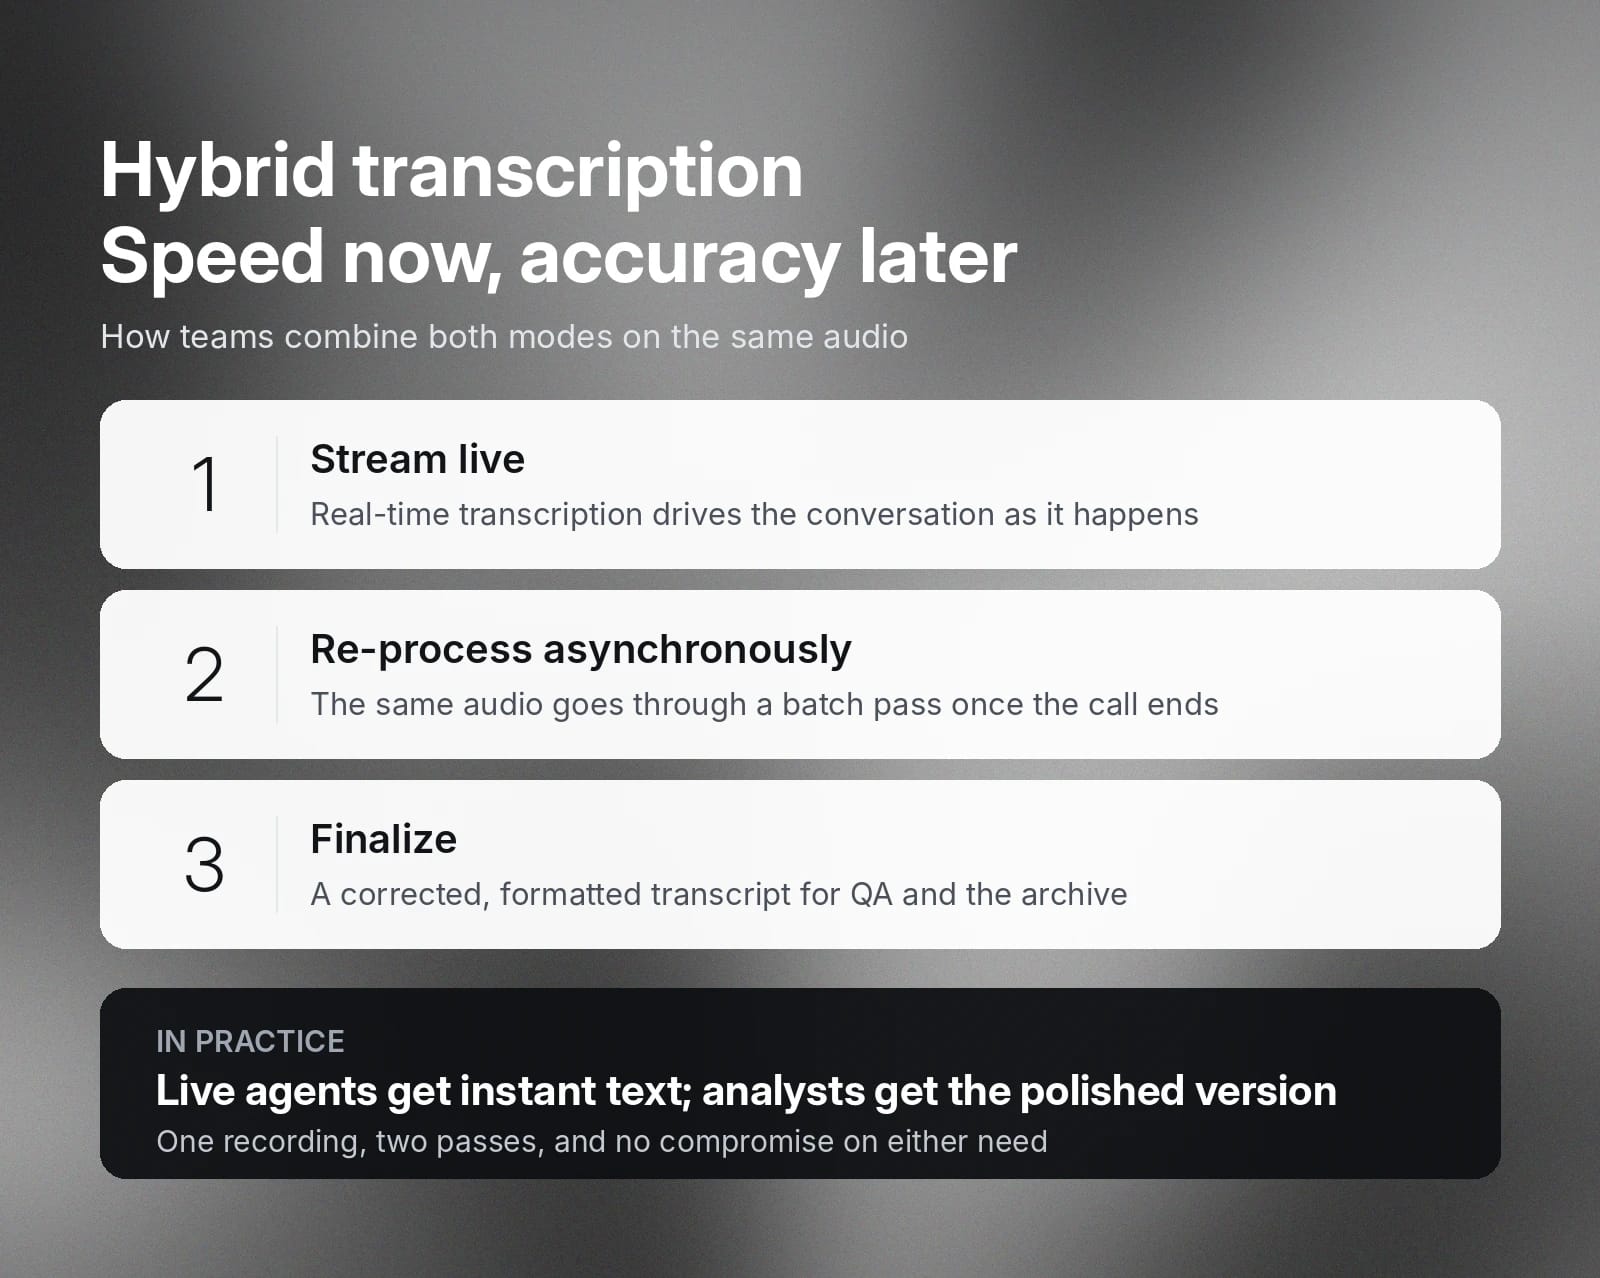
混合转录架构结合实时和批量模型,兼顾速度与准确性。
例如,客服团队可使用混合模型在实时对话中即时输出结果,随后优化转录文本,用于质量保证和存档。实时 智能体使用实时转录后,会将初始转录文本发送至批量模型进行异步重新处理。
流程如下:
使用 ElevenAPI 开始灵活的转录方案
ElevenAPI 提供实时和批量模型,可在超过 90 种语言中快速、准确地转录。即使音频质量较低、存在背景噪音或口音较重,ElevenAPI 的行业领先转录模型仍能提供准确结果。
ElevenAPI提供实时和批量模型,可快速、准确地转录,支持 90 多种语言。Scribe v2 提供行业领先的转录准确性,Scribe v2 Realtime 则为实时场景提供出色准确性。即使音频质量较低、存在背景噪音或口音较重,两者均可提供可靠结果。
两个模型均可在同一便捷平台中使用,帮助你构建满足需求的转录架构。探索 ElevenLabs 语音转文本 API,了解实际效果,或 创建 API 密钥,立即开始。



