
Python 语音识别教程:从音频文件到转写文本
- 发布时间
- 最近更新
过去,要为 Python 应用添加语音识别功能非常繁琐。Python 开发者必须自行处理转录流程,包括音频预处理、特征提取和模型集成。此外,工程团队还要应对底层音频处理、转录质量不佳,以及语音与实时字幕之间的延迟问题。
音频模型和语音识别 SDK 的进步改变了这一切。
本 Python 语音识别教程将教你把 ElevenLabs 文本转语音 音频模型集成到 Python 项目中,构建可商用的转录应用。
摘要
- 商用文本转语音模型提供说话人分离、词级时间戳和关键词提示等基础语音识别模型不具备的功能。
- ElevenAPI 通过 Scribe v2 和 Scribe v2 Realtime,为 Python 代码添加语音识别功能。
- 开发者可在 AI 编程平台安装 ElevenLabs skills,根据官方 API 文档生成准确的 Python 代码。
- 订阅付费方案用于商业开发前,可免费试用 ElevenLabs API。
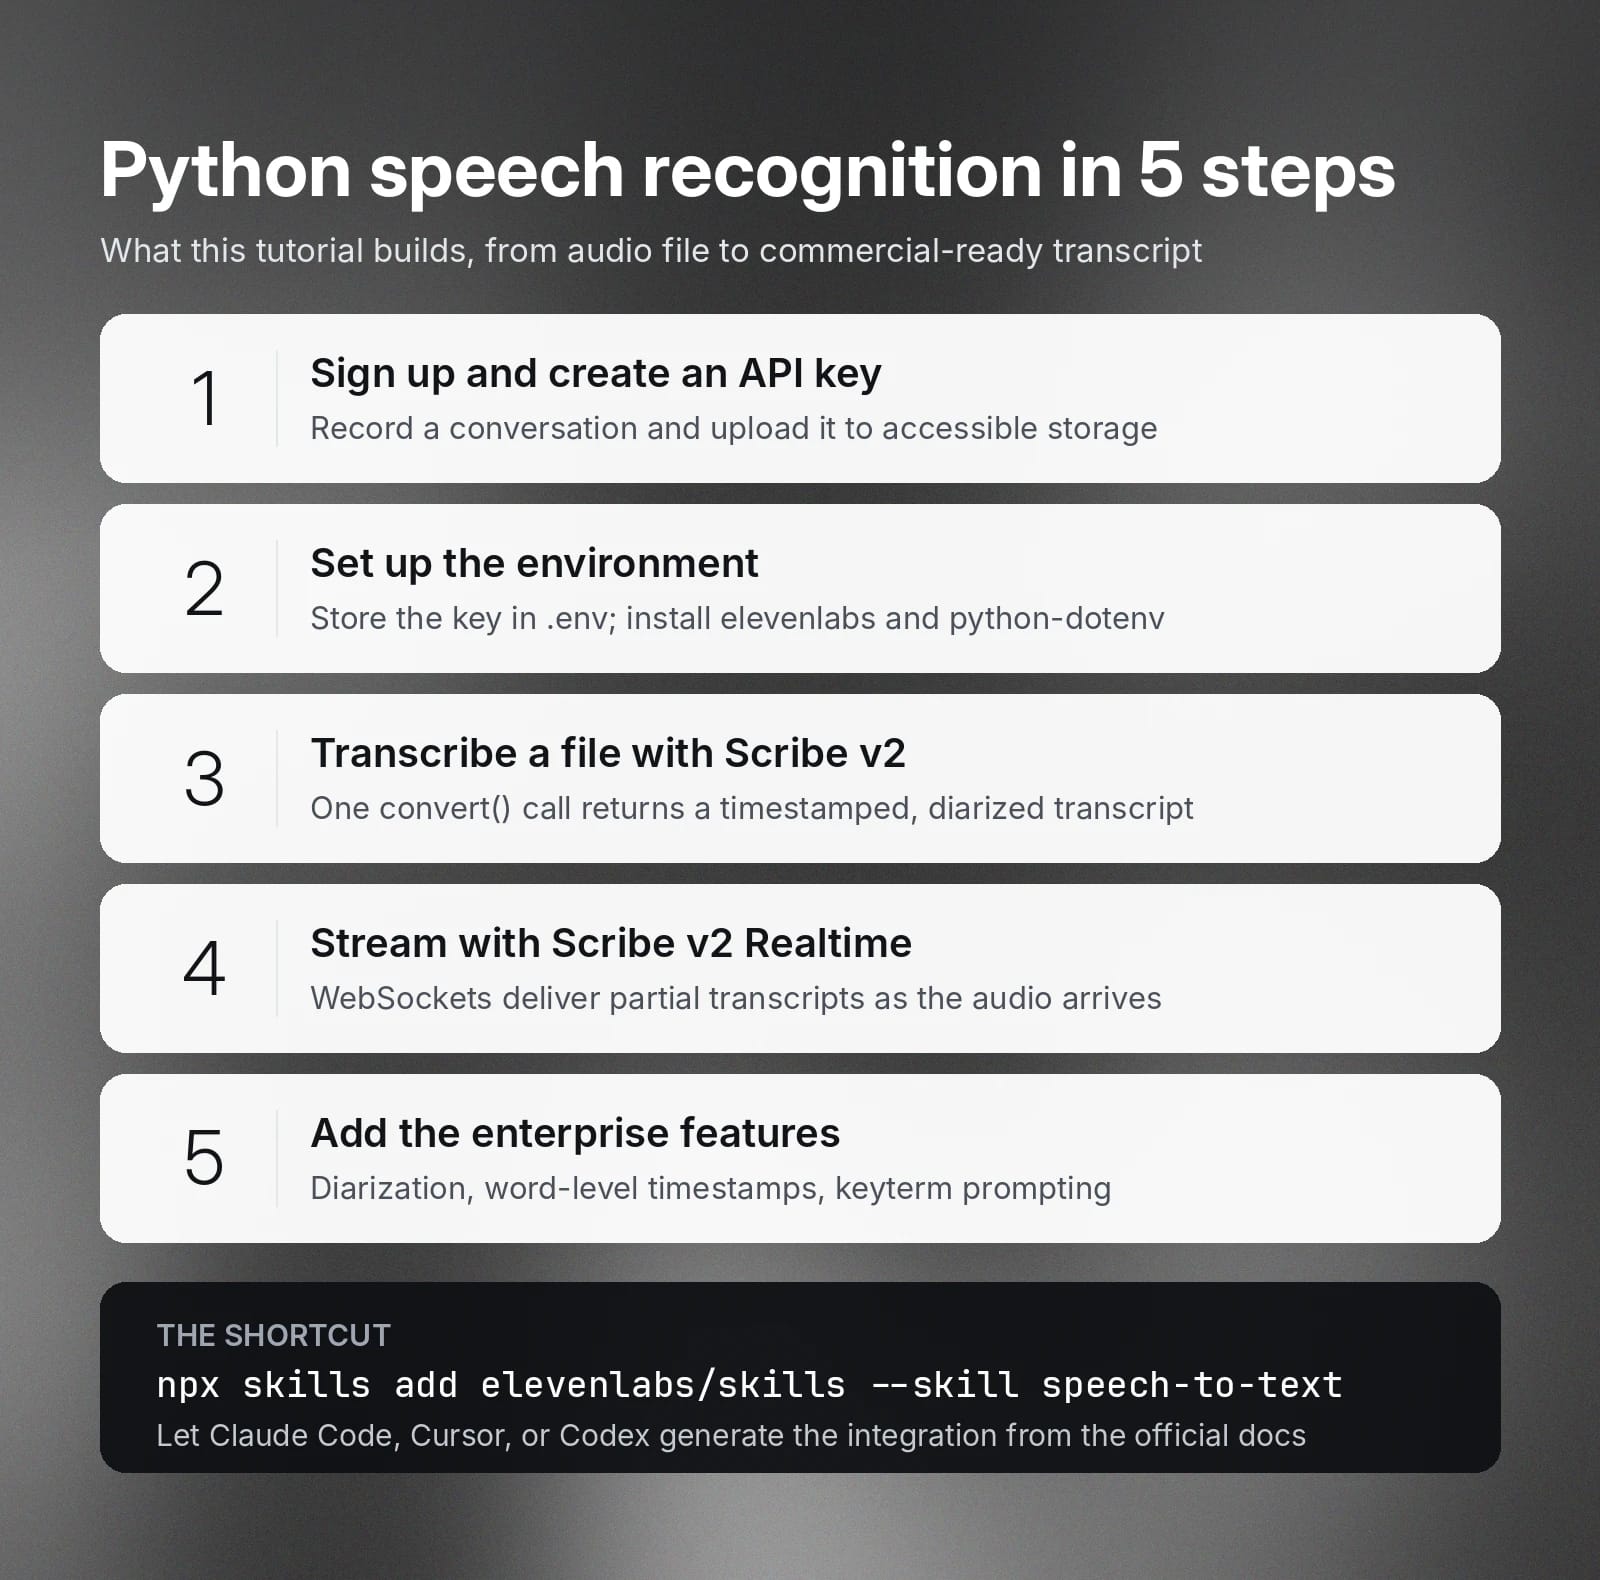
本 Python 语音识别教程涵盖的内容
本教程涵盖前提条件、API 集成及高级转录功能,帮助你构建适用于企业场景的 Python 语音识别应用。
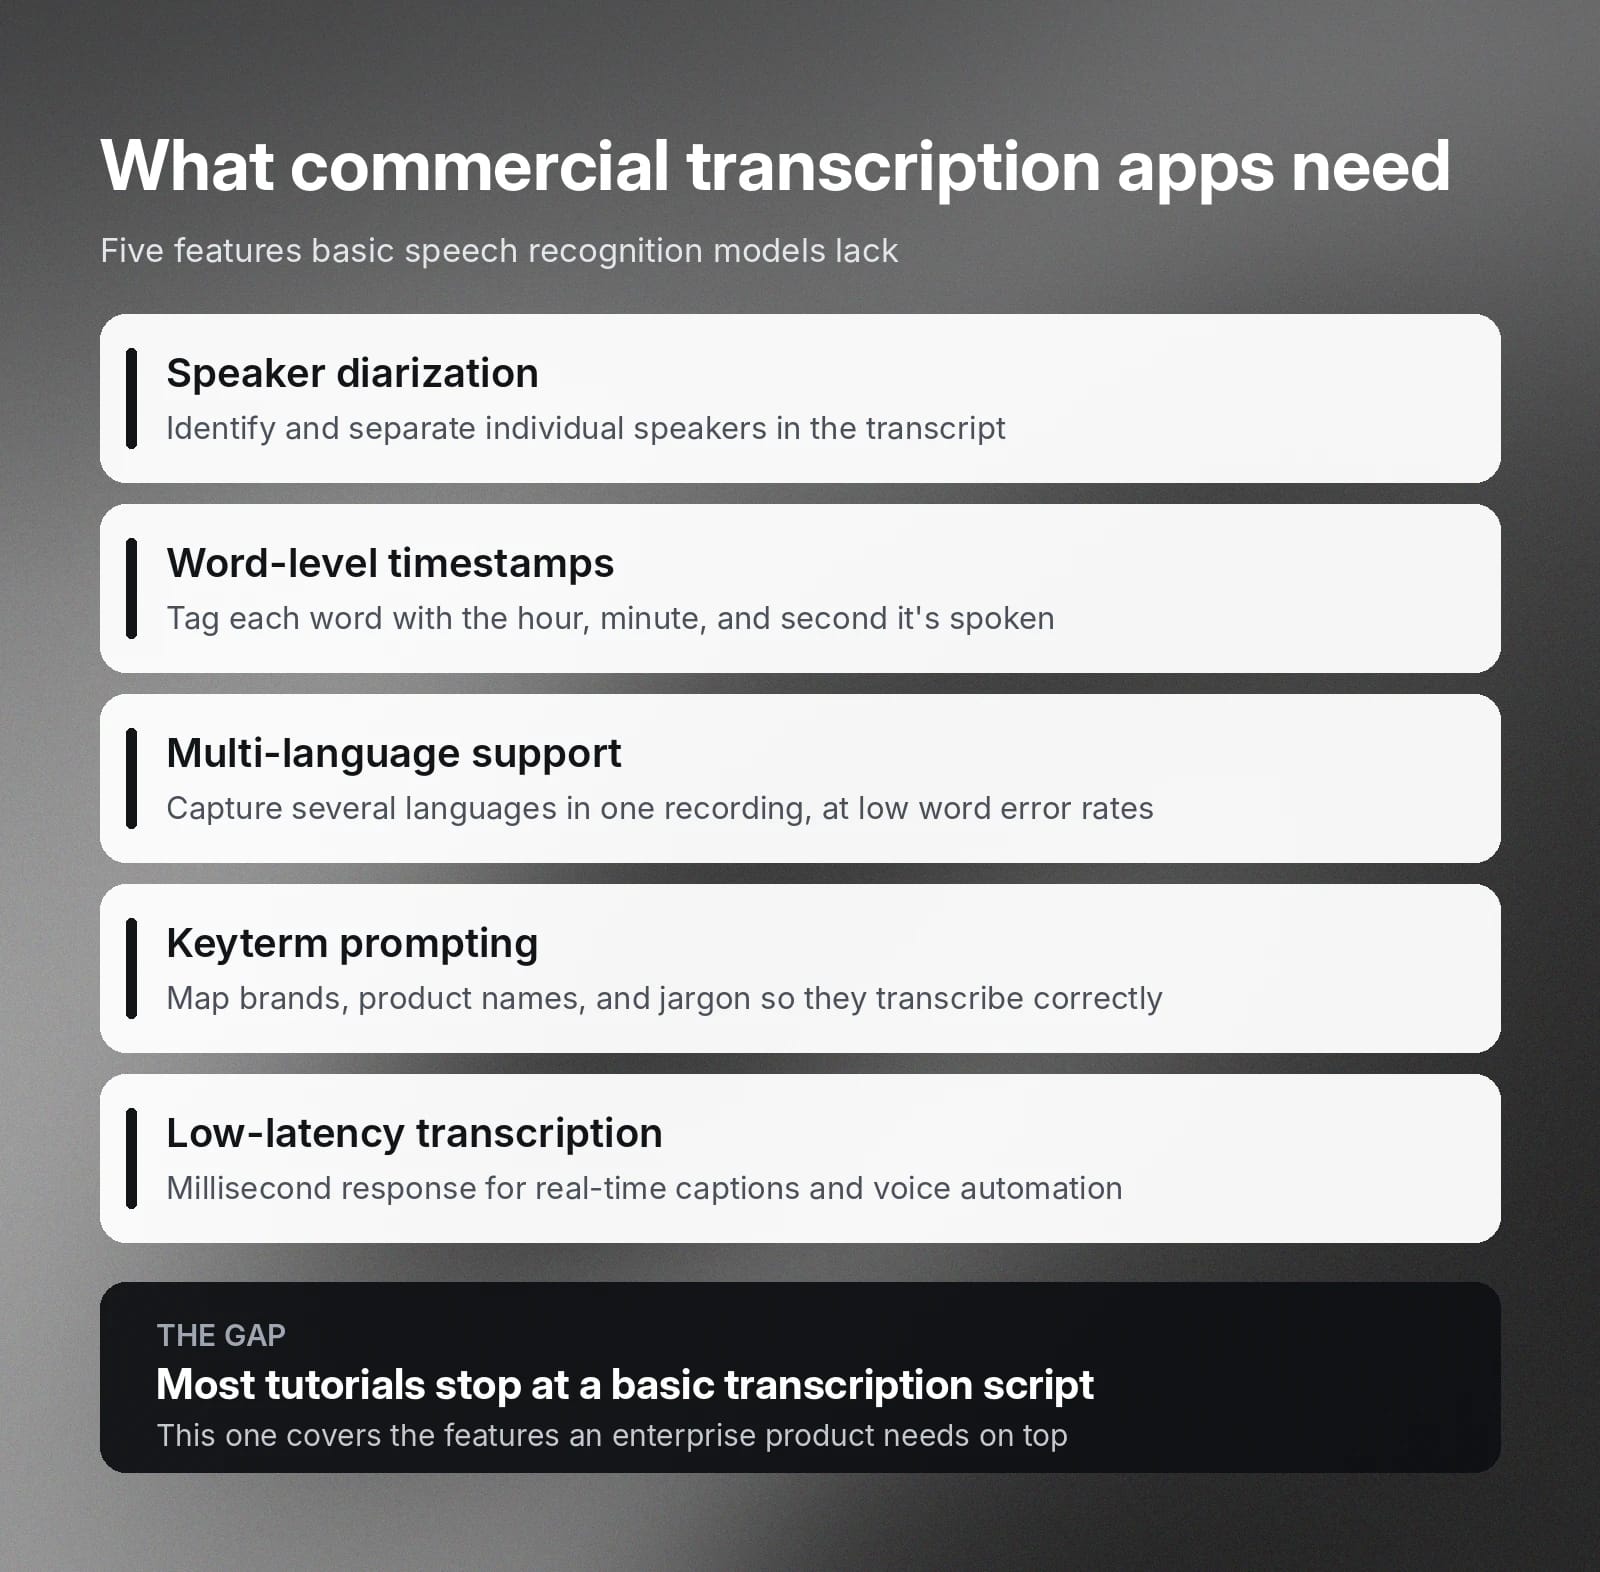
近年来,语音识别技术日趋成熟,尤其是大语言模型和深度学习神经网络改变了 Python 开发者使用转录 SDK 的方式。许多教程介绍如何构建基础转录应用,却很少涵盖可商用产品所需的功能。
我们编写本教程正是为了填补这一空白。
例如,许多企业转录解决方案需要以下功能:
- 说话人分离:识别并区分转录文本中的不同说话人。
- 时间戳:准确标记每个词说出时对应的小时、分钟和秒数。
- 多语言支持:以低词错误率捕捉单个录音或直播流中的多种语言语音。
- 关键词提示:映射品牌、产品名称和技术术语等特殊词汇,避免转录拼写错误。
- 低延迟转录:以毫秒级语音转文本响应驱动实时转录应用。
注意:本教程不止介绍如何为爱好或个人项目编写简单脚本。由于不同业务的需求不同,本文不包含构建于 文本转语音 API 集成之上的应用逻辑。
Python 语音识别集成前提条件
本教程围绕 ElevenAPI 展开。这是 ElevenLabs 提供的生产级 API,可简化代码中与语音模型的交互。借助 ElevenAPI,你可以使用 Scribe v2 和 Scribe v2 Realtime,这两款模型分别用于批量和实时转录。
无需直接访问 ElevenLabs 文本转语音模型,只需通过 API 调用传入录音、实时音频流和参数。随后,音频模型会将音频数据转换为文本。完成后,可在代码中或通过 webhook 接收转录结果。
开始前,请完成以下准备步骤。
- 注册 ElevenLabs。
- 创建 API 密钥。
- 录制一段对话,并上传至可公开访问的存储空间。
准备就绪后,继续阅读下一节。
设置环境
集成 ElevenLabs 模型前,先设置 Python 环境以安全存放 ElevenLabs API 密钥。与其他 API 密钥一样,建议将其作为环境变量(托管密钥)存储在 .env 文件中。
发起 API 调用时,传入该环境变量。这样可避免通过公共网络发起 API 请求时意外泄露 API 密钥。
接着,在 Python 环境中运行 Bash 命令安装 elevenlabs,即 ElevenLabs SDK。该 SDK 可让你使用多种语音模型。这里可选择 Scribe v2 或 Scribe v2 Realtime。
还需安装 python-dotenv,它可让 Python 代码访问存储在 .env 文件中的环境变量。
编写第一个转录脚本
设置好 Python 环境后,即可使用 ElevenLabs Scribe v2 转录音频文件。
ElevenLabs Scribe v2 是业界领先的语音识别模型,可大规模转录音频文件。即使录音中存在大量背景噪声,它也能高精度识别音素。要转录音频,请通过 ElevenLabs API 将录音发送给模型,再获取完成的转录文本。
以下 Python 代码片段可将音频文件转换为带时间戳和说话人分离标注的转录文本。
代码会加载所需的库,为代码提供必要功能,同时将声明的环境变量加载到程序环境中。
接着,它使用存储在环境变量中的 API 密钥创建 ElevenLabs 客户端,然后下载音频文件并转换为二进制数据。
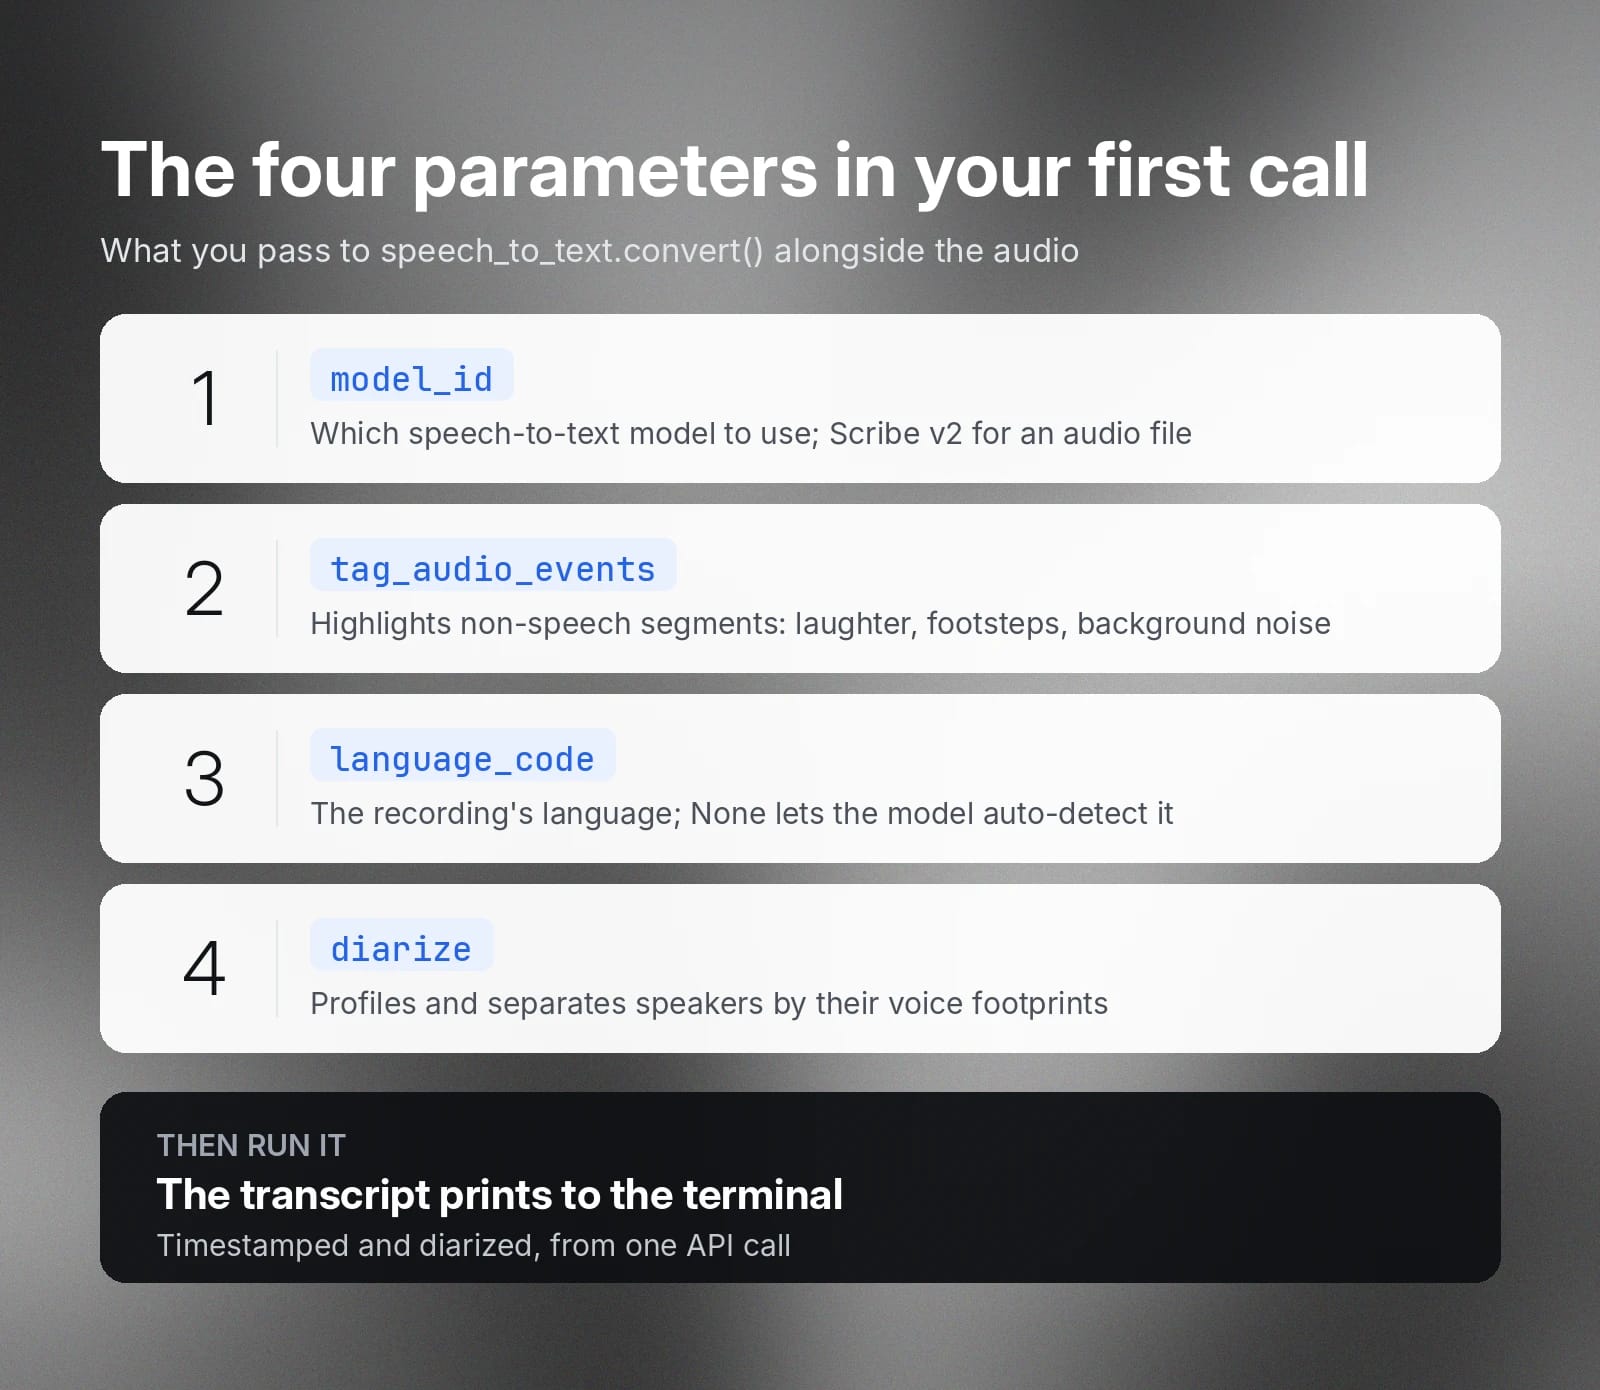
获得原始音频数据后,将其连同多个参数一起发送至 ElevenLabs API。
- model_id 表示要使用的语音转文本模型。由于传入的是音频文件,Scribe v2 是最佳选择。
- tag_audio_events 可用于标记笑声、脚步声及其他背景噪声等非语音片段。
- language_code 表示录音文件中对话的语言。设为 None 时,模型会自动检测语言。
- diarize 表示 是否要让模型根据声纹识别并区分不同说话人。
最后,运行代码,即可在终端看到转录后的音频文本。
在 Python 中进行流式语音识别
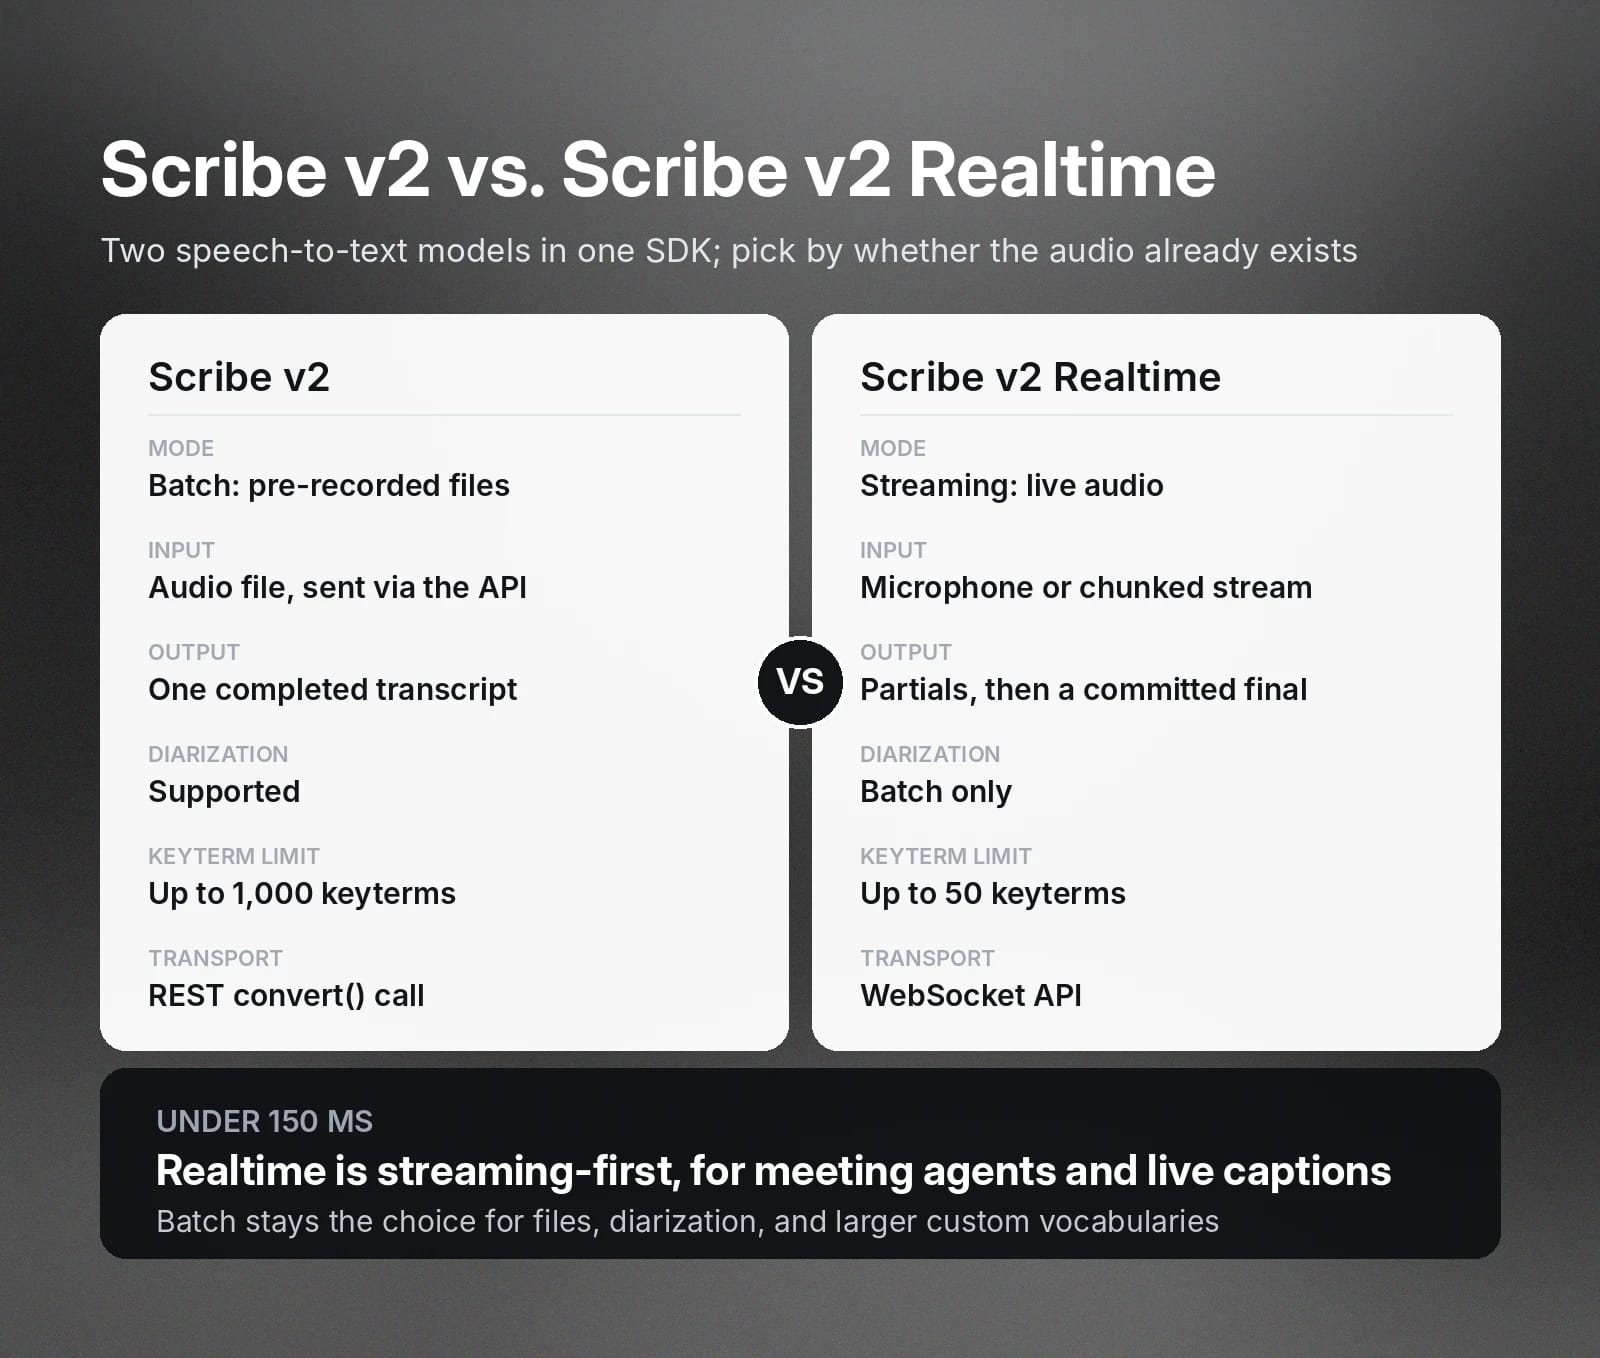
以上示例介绍了适用于预录文件的批量转录。不过,ElevenLabs 还提供可构建流式语音识别的 API。与批量处理不同,此模式会实时运行语音识别,在对话进行时生成转录文本。
为此,可通过 WebSocket API 将 Python 代码连接到 Scribe v2 Realtime 模型。
Scribe v2 Realtime 采用流式优先架构,转录延迟低于 150ms。可使用 Scribe v2 Realtime 构建会议 智能体、无障碍工具和语音激活自动化等应用。模型在处理音频流时会返回部分转录结果。只有当代码自动或手动提交音频片段时,才会返回最终转录文本。
根据音频来源和应用类型,可在服务端或客户端将语音识别与 ElevenLabs API 集成。
客户端和服务端流式传输都支持异步 workflow。无需持续轮询 API,可通过 WebSocket 处理结果。代码中需要创建用于接收部分转录和最终转录结果的处理程序。
进阶功能:说话人分离、时间戳和自定义词汇
除 自动语音识别 外,ElevenLabs 文本转语音模型还支持说话人分离、时间戳 和自定义词汇。
- 说话人分离:只有批量转录支持 说话人分离。设置 diarize 参数即可启用该功能。不过,批量转录中的多声道转录模式不支持说话人分离。
- 时间戳:进行批量转录时,可选择词级或字符级时间戳。使用 convert 方法时,设置 timestamps_granularity 参数即可。
- 自定义词汇: 实时和批量转录 都支持关键词提示。该功能会让模型倾向于转录你在列表中指定的关键词。Scribe v2 Realtime 最多支持 50 个关键词,Scribe v2 最多支持 1,000 个关键词。
在 AI 编程助手中使用 ElevenLabs skill
AI 编程助手可加快开发速度。如果你使用 Claude Code、Cursor、Codex 或类似的 AI 编程工具,可在编程环境中添加 ElevenLabs skills。
只需在平台终端运行以下命令:
AI 编程智能体会从 ElevenLabs 的 GitHub 仓库 下载文本转语音 skill,并将其安装到本地 skill 目录。这样便可根据 ElevenLabs 官方文档自动生成语音识别 Python 代码,无需从头编写完整的 API 集成。
安装后,只需用自然语言描述所需功能,即可生成语音识别 Python 代码。编程助手会根据描述,使用文本转语音 skill 及正确的模型和参数自动生成代码。
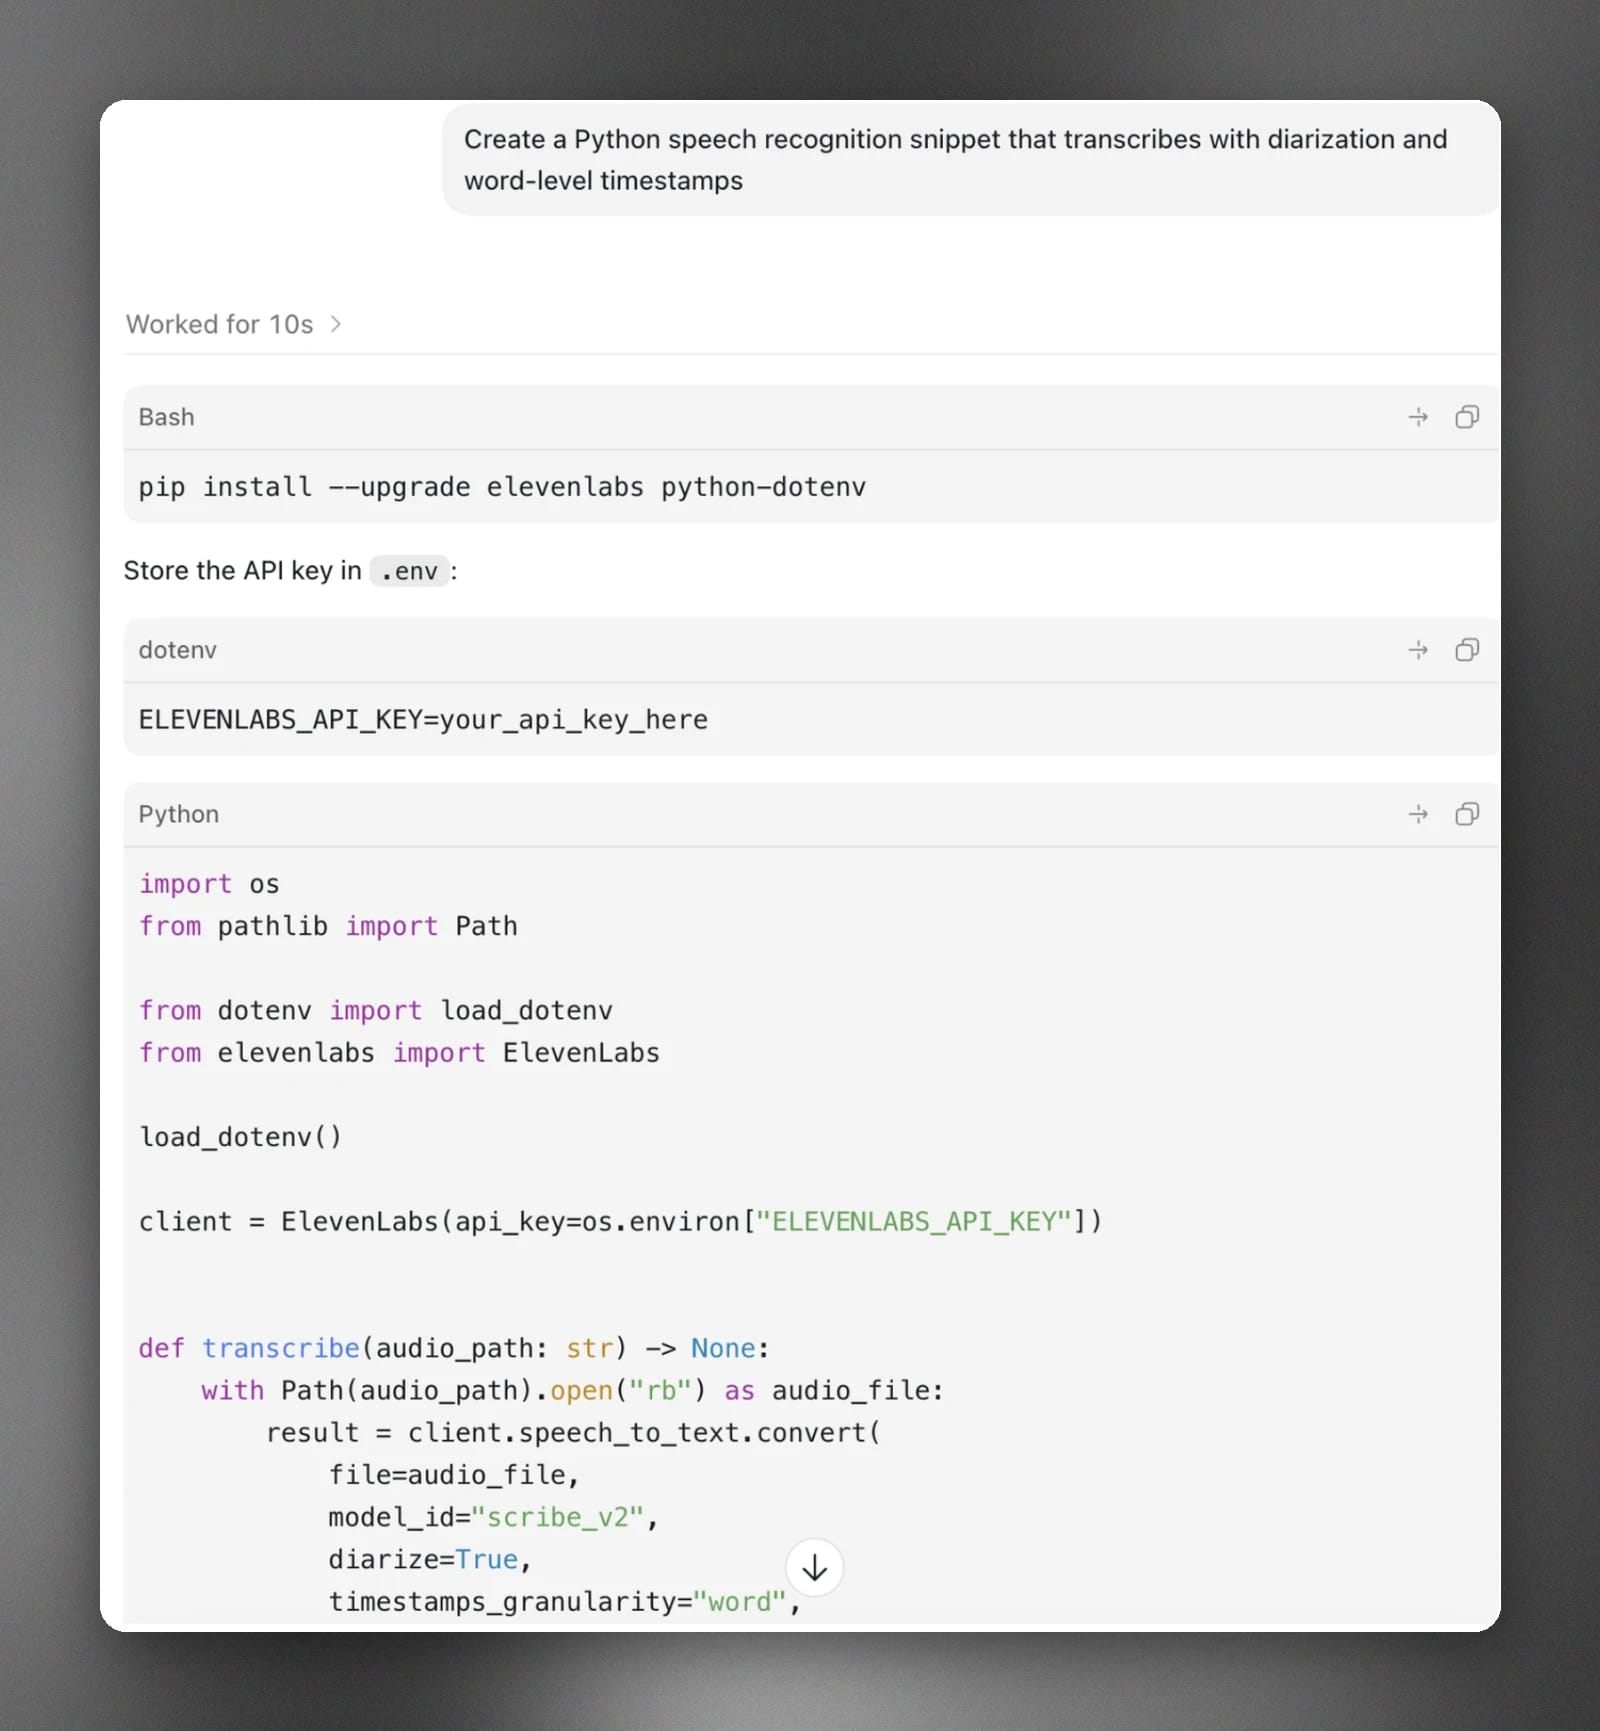
例如,在 Codex 中输入“创建一个使用说话人分离和词级时间戳进行转录的 Python 语音识别代码片段”,即可获得与下方类似的代码片段。
使用 ElevenAPI 开始构建语音识别应用
ElevenAPI 可让你使用高级文本转语音模型,在 Python 中构建语音识别应用。
使用 ElevenAPI,无需从头编写会拖慢产品创新的集成代码。你可以改用提供符合商用要求的文本转语音服务的 SDK,例如支持关键词提示、说话人分离和时间戳。
立即获取 ElevenLabs API 密钥,并查看我们的 官方文档,了解 API 的工作原理。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。


